Apuntes · Capítulo 2Fundamentos y atributos de calidad
Atributos de calidad: escribirlos, medirlos y priorizarlos
Atributos de calidad: escribirlos, medirlos y priorizarlos
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Lo que el sistema hace y qué tan bien lo hace, Requisitos funcionales, atributos de calidad y restricciones; de El problema de las palabras, Una palabra, muchos significados; de El escenario de seis partes, Las seis partes y Un escenario de Tinkuy; y de Percentiles, Definición y cálculo y Por qué no el promedio.
- En clase: Sesión A: Lo que el sistema hace y qué tan bien lo hace, El problema de las palabras, El escenario de seis partes y Los atributos que más veremos. Sesión B: Latencia, tiempo de respuesta y throughput, Percentiles, Medir sin engañarse, Disponibilidad, Priorizar: el utility tree y Trade-offs. Laboratorio: Laboratorio: escribir escenarios para Tinkuy y medirlos con k6.
- Después de clase: el Resumen y los Ejercicios. Para repasar antes de entregar P0: Cómo se escribe: el template y el revisor, Umbrales: la medida convertida en prueba y Cuánto varía una medición. Opcionales: ISO/IEC 25010: otra lista, Cómo calcula k6 un percentil, La omisión coordinada en una simulación y En paralelo: la redundancia.
La semana pasada terminó con una lista. Después de recorrer Tinkuy, cada pareja escribió tres candidatos a requisito significativo para la arquitectura (ASR) y, para cada uno, qué parte del diseño actual creía que no lo aguantaría. Vimos también el error más frecuente de esas listas: “debe ser escalable”, “debe ser seguro”. Si no se puede decir cuándo se incumple, todavía no es un requisito.
Esta semana esa lista se convierte en algo que se puede comprobar. Son tres pasos, y cada uno tiene su técnica:
- Escribir. Un atributo de calidad se escribe como un escenario de seis partes que termina en una medida. Con eso deja de importar si lo llamamos rendimiento o escalabilidad: importa si el número se cumple.
- Medir. La latencia se resume con percentiles, no con el promedio, y la disponibilidad con la fracción del tiempo en que el sistema responde bien. Medir tiene trampas, y una de ellas (la omisión coordinada) hace que una herramienta reporte 5 ms donde un usuario espera medio segundo. La vamos a reproducir.
- Priorizar. No todos los escenarios pesan igual ni cuestan lo mismo. El utility tree los ordena por su valor para el negocio y su dificultad técnica, y los pocos que salen arriba en las dos son los que definen la arquitectura.
El capítulo cierra con la idea que va a acompañar todo el curso: los atributos compiten entre sí, y decidir en arquitectura es elegir qué se sacrifica y dejarlo escrito. A eso se le llama un trade-off.
Todo lo que se mide de Tinkuy en este capítulo es la versión 0, tal como está. No se arregla nada todavía: primero hay que saber cuánto rinde lo que hay.
Lectura. Sesión A: Bass, Clements y Kazman, Software Architecture in Practice (4.ª ed.), cap. 3 Understanding Quality Attributes; lectura libre: Barbacci, Klein, Longstaff y Weinstock, Quality Attributes (reporte del SEI, 1995), secciones 1 y 2. Complementarias: el modelo de calidad de ISO/IEC 25010, y Software Architecture in Practice, cap. 14 Working with Other Quality Attributes.
Sesión B: Kleppmann y Riccomini, Designing Data-Intensive Applications (2.ª ed.), cap. 2 Defining Nonfunctional Requirements, secciones Describing Performance y Reliability and Fault Tolerance; Software Architecture in Practice, cap. 19, la sección del utility tree; lectura libre: Site Reliability Engineering, cap. 4, Service Level Objectives. Complementarias: Grafana k6, Metrics y Thresholds, y Software Architecture in Practice, cap. 9 Performance, el escenario general.
El código de este capítulo está en code/week-02. Todas las salidas que se muestran son de ejecuciones reales en el contenedor del curso. Las mediciones se hicieron en una laptop con Apple Silicon, dentro de Docker: en otra máquina los números serán otros, y por eso el texto se apoya en comparaciones hechas en la misma máquina.
Lo que el sistema hace y qué tan bien lo hace
Requisitos funcionales, atributos de calidad y restricciones
Lo que se le pide a un sistema cae en tres grupos, y conviene separarlos porque cada uno influye en el diseño de una manera distinta.
Un requisito funcional dice qué hace el sistema: qué recibe y qué responde. El comprador elige de 1 a 6 asientos de un evento y recibe una entrada por asiento es un requisito funcional de Tinkuy. Se comprueba con una prueba que da una entrada y mira la salida.
Un atributo de calidad (quality attribute) es una propiedad medible del sistema que indica qué tan bien satisface a sus stakeholders, más allá de lo que hace. Cuando se abre la venta de un concierto, la lista de asientos responde en menos de 300 ms no agrega ninguna función: el endpoint ya existe. Dice qué tan bien debe hacer lo que ya hace. Disponibilidad, rendimiento, modificabilidad y seguridad son atributos de calidad.
Una restricción (constraint) es una decisión que ya viene tomada. El equipo escribe en TypeScript, la pasarela de pagos es la que el negocio ya contrató, los datos personales se guardan en el país. No se negocia y no se mide: se diseña dentro de ella.
| Pregunta que responde | Ejemplo en Tinkuy | Cómo se comprueba | |
|---|---|---|---|
| Requisito funcional | ¿Qué hace? | Comprar de 1 a 6 asientos de un evento | Una prueba de entrada y salida |
| Atributo de calidad | ¿Qué tan bien lo hace? | La compra responde en menos de 1 s cuando hay 200 compradores a la vez | Una medición bajo un estímulo |
| Restricción | ¿Qué ya está decidido? | Todo corre en el contenedor del curso, sin paquetes nuevos | Se revisa; no hay nada que medir |
En muchos textos van a encontrar requisito no funcional para lo que aquí llamamos atributo de calidad. Es el mismo concepto con un nombre peor: dice lo que el requisito no es. En el curso usamos atributo de calidad, que es el término de Software Architecture in Practice.
La funcionalidad no determina la arquitectura
La semana pasada vimos que la misma funcionalidad se puede construir con muchas arquitecturas. Ahora podemos decir por qué eso importa.
Piensen en la función vender una entrada. Se puede construir como está en Tinkuy: un proceso de Node.js que abre una transacción en PostgreSQL, llama a la pasarela, guarda la entrada y envía el correo. Se puede construir con tres servicios y una cola entre ellos. Se puede construir con una hoja de cálculo compartida y una persona que contesta el teléfono. Las tres venden una entrada. Si lo único que se pidiera fuera la función, las tres serían correctas, y la hoja de cálculo sería la más barata.
Lo que descarta a la hoja de cálculo no es lo que hace, sino qué tan bien lo hace: cuántas ventas por minuto aguanta, qué pasa si dos personas piden el mismo asiento, qué pasa a las tres de la mañana. Los atributos de calidad son los que eligen entre arquitecturas que hacen lo mismo.
Idea clave. La funcionalidad dice qué tiene que existir. Los atributos de calidad dicen cómo tiene que estar organizado. Por eso un requisito significativo para la arquitectura casi nunca habla de lo que el sistema hace: habla de cuánto, qué tan rápido, con qué frecuencia cambia o qué pasa cuando algo falla.
Esto no quiere decir que la funcionalidad no importe. Un sistema que no hace lo que debe no sirve, por rápido que sea. Quiere decir que, una vez fijada la función, quedan muchas arquitecturas posibles, y entre ellas se elige con los atributos de calidad y dentro de las restricciones.
En Tinkuy. La versión 0 cumple todos sus requisitos funcionales:
make checkpasa. Si la arquitectura dependiera de la función, no habría nada que hacer en el resto del semestre. Cada entrega del proyecto llega con un atributo de calidad que la versión de ese momento no cumple, y la función casi no cambia.
El problema de las palabras
Una palabra, muchos significados
Pidan a cinco personas que definan escalable y van a recibir cinco respuestas. Para quien opera el sistema, es poder agregar máquinas sin apagarlo. Para quien paga la cuenta, que el costo crezca más despacio que los usuarios. Para un desarrollador, que el código aguante más funciones sin volverse inmanejable. Para el organizador de un concierto, que la página no se caiga el día de la venta.
Todas son lecturas razonables, y por eso la palabra sola no sirve como requisito. “Tinkuy debe ser escalable” no descarta ningún diseño, porque siempre hay un sentido de la palabra en que el diseño cumple. Lo mismo pasa con rápido, robusto, seguro, mantenible y fácil de usar.
El reporte del SEI de la lectura libre nace de ese problema. Su resumen declara el objetivo: avanzar hacia una forma unificada de razonar sobre varios atributos de calidad a la vez, para lo cual define qué es calidad de software, propone una taxonomía genérica de atributos y discute cómo se conectan entre sí. Es de 1995, y la dificultad que describe sigue siendo la misma: quien diseña tiene que razonar sobre todos los atributos en un mismo sistema, y con palabras que cada quien usa a su manera.
Un hecho, muchos nombres
El problema también corre en la otra dirección: un mismo hecho recibe varios nombres.
Supongan que un servidor recibe más pedidos de los que puede atender y empieza a rechazarlos. ¿Qué atributo falló?
- Rendimiento, dirá alguien: el servidor no atendió la carga a tiempo.
- Disponibilidad, dirá otro: para quien recibió el rechazo, el sistema estuvo caído.
- Seguridad, si los pedidos venían de un ataque de denegación de servicio.
- Escalabilidad, si la queja es que no se pudo agregar capacidad a tiempo.
Se puede discutir una tarde entera cuál es el nombre correcto, y al final de la tarde el servidor sigue rechazando pedidos. La discusión no produce ninguna decisión de diseño.
La salida que propone Software Architecture in Practice es dejar de discutir el nombre y escribir un escenario: qué llega, a qué parte del sistema, en qué condiciones, qué debe pasar y con qué número se comprueba. Cuando eso está escrito, el nombre del atributo pasa a ser una etiqueta para ordenar la lista, y dos personas que no se ponen de acuerdo en la etiqueta sí pueden ponerse de acuerdo en si el escenario se cumple.
En Tinkuy. Con
make load-sale, la prueba de carga de la apertura de ventas, 100 de los 5 770 pedidos de una corrida terminaron con este mensaje en el log del servidor:POST /orders 500 error: sorry, too many clients alreadyPostgreSQL acepta 100 conexiones a la vez y Tinkuy abre una conexión nueva por cada consulta. ¿Es un problema de rendimiento, de disponibilidad o de escalabilidad? Las tres respuestas se pueden defender. Lo que no se puede discutir es el hecho: 200 compradores a la vez, 100 errores. En el laboratorio van a escribir el escenario que lo describe.
El escenario de seis partes
Las seis partes
Un escenario de calidad (quality attribute scenario) describe una situación concreta y lo que el sistema debe hacer en ella. Tiene seis partes:
| Parte | Qué dice | Pregunta que contesta |
|---|---|---|
| Fuente del estímulo | Quién o qué produce el estímulo: una persona, otro sistema, un atacante, un desarrollador, una pieza del propio sistema | ¿De dónde viene? |
| Estímulo | Lo que llega al sistema: pedidos, una falla, un cambio que hay que hacer, un intento de acceso | ¿Qué pasa? |
| Artefacto | La parte del sistema que lo recibe: un endpoint, un módulo, la base de datos, el sistema completo | ¿A qué le pasa? |
| Entorno | El estado del sistema cuando llega el estímulo: carga normal o pico, datos cargados, algo degradado o caído, en desarrollo o en producción | ¿En qué condiciones? |
| Respuesta | Lo que el sistema hace, visto desde afuera | ¿Qué debe ocurrir? |
| Medida de la respuesta | El número que dice si la respuesta fue suficiente, con su unidad | ¿Cómo sabemos que se cumplió? |
Las tres primeras describen la situación. La cuarta la ubica. Las dos últimas dicen qué se espera, y la última es la que convierte una intención en algo que se puede comprobar.
Una forma de leer un escenario es como una prueba escrita en prosa. El estímulo y el entorno son la preparación (qué carga se genera, en qué estado está el sistema), la respuesta es lo que se observa y la medida es la aserción. De hecho, al final de la Sesión B vamos a escribir la medida como un umbral de k6 que hace fallar la prueba cuando no se cumple.
Idea clave. Sin medida no es un escenario. La medida es la diferencia entre “quisiéramos que sea rápido” y un requisito que alguien puede declarar cumplido o incumplido sin preguntarle nada a quien lo escribió.
Un escenario de Tinkuy
Tomemos uno de los candidatos a ASR de la semana 1, en la forma en que suele salir en la primera lista: “el catálogo debe aguantar la apertura de una venta”. Escrito como escenario:
| Parte | Texto |
|---|---|
| Fuente del estímulo | 5 000 compradores |
| Estímulo | Piden la lista de asientos de un mismo evento durante un minuto |
| Artefacto | El servicio de catálogo (GET /events/:id/seats) |
| Entorno | Operación normal, con la venta del evento recién abierta |
| Respuesta | El sistema responde todas las consultas |
| Medida de la respuesta | Latencia p95 menor que 300 ms y menos de 0,1 % de errores |
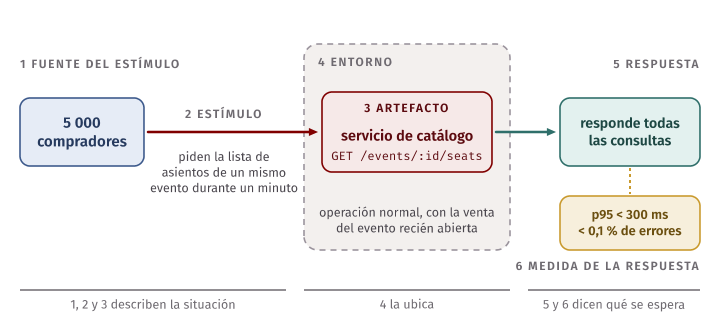
Comparen lo que dice cada versión. La primera no descarta nada. La segunda permite hacer preguntas de diseño: ¿cuántas consultas por segundo son 5 000 compradores en un minuto?, ¿cuánto pesa la respuesta de un evento con 2 000 asientos?, ¿qué hace esa consulta en la base de datos?, ¿la venta recién abierta significa que los asientos están cambiando mientras se leen?
También permite discutir el propio requisito, que es parte del trabajo. ¿Por qué 300 ms y no 500? ¿Por qué el p95 y no el p99? ¿De dónde salen los 5 000? Esas preguntas se le hacen al stakeholder, no al código, y el escenario es lo que permite hacerlas. (Qué es exactamente un p95 lo vemos en la Sesión B; por ahora, léanlo como “95 de cada 100 consultas”.)
Error común. Probar un escenario con otro estímulo y darlo por cumplido. Este escenario pide 5 000 compradores.
make load-browsesimula hasta 50 usuarios virtuales en una laptop: es otra situación. Lo que se mide en clase sirve para comparar dos diseños entre sí, no para afirmar que Tinkuy cumple o incumple un escenario de 5 000 compradores. Cuando reporten una medición, escriban el estímulo que de verdad generaron.
Escenario general y escenario concreto
El escenario de la tabla anterior es concreto: es de un sistema, de una situación, y tiene números. Sirve para diseñar y para probar.
Un escenario general es otra cosa: es, para un atributo, la lista de valores que puede tomar cada una de las seis partes, sin atarse a ningún sistema. Funciona como un menú. Software Architecture in Practice dedica un capítulo a cada atributo (del 4 al 13) y cada uno trae su escenario general en una tabla. Para rendimiento, por ejemplo, un escenario general se ve más o menos así (la tabla es nuestra, armada con las opciones habituales; la del libro está en su capítulo 9):
| Parte | Valores posibles para rendimiento |
|---|---|
| Fuente del estímulo | Usuarios, otros sistemas, un temporizador interno |
| Estímulo | Llegan eventos: de forma periódica, esporádica o impredecible; uno o muchos a la vez |
| Artefacto | El sistema completo, un servicio, un componente |
| Entorno | Operación normal, carga pico, sobrecarga, modo degradado |
| Respuesta | El sistema procesa los eventos, o rechaza algunos, o baja la calidad del servicio |
| Medida de la respuesta | Latencia (con percentil), throughput, tasa de errores, fracción de eventos no atendidos |
El escenario general se usa para dos cosas. Primero, para no olvidar partes: al recorrerlo uno nota que nadie preguntó qué pasa en sobrecarga. Segundo, para entrevistar a un stakeholder: en vez de “¿qué rendimiento necesita?”, que no tiene respuesta, se le pregunta “¿cuánta gente llega a la vez el día de una venta grande?” y “¿cuánto esperaría un comprador antes de irse?”.
De un escenario general salen muchos concretos. El de la lista de asientos es uno: fuente usuarios, estímulo muchos a la vez, artefacto un servicio, entorno carga pico, respuesta procesa todos, medida latencia p95 y tasa de errores, cada parte con el dato de Tinkuy.
Cómo se escribe: el template y el revisor
En el curso, los escenarios se escriben en Markdown con el template de code/week-02/scenario-template.md. Cada escenario es un título y una lista con las seis partes, más el atributo como etiqueta:
## La lista de asientos cuando se abre una venta

- **Atributo de calidad:** rendimiento
- **Fuente del estímulo:** 5 000 compradores
- **Estímulo:** piden la lista de asientos de un mismo evento durante un minuto
- **Artefacto:** el servicio de catálogo (`GET /events/:id/seats`)
- **Entorno:** operación normal, con la venta del evento recién abierta
- **Respuesta:** el sistema responde todas las consultas
- **Medida de la respuesta:** latencia p95 menor que 300 ms y menos de 0,1 % de
  errores, medidos desde quien llama durante ese minuto
Ese es el contenido de
scenarios/tinkuy-seat-list.md.
En el proyecto, los escenarios del sistema van en docs/scenarios.md del
repositorio de cada equipo, con este mismo formato, y el archivo crece con
cada entrega.
Junto al template hay un revisor, scenario-check.ts, que lee uno o más archivos y comprueba la forma de cada escenario:
node scenario-check.ts scenarios/tinkuy-seat-list.md scenarios/qhatu.mdscenarios/tinkuy-seat-list.md
✔ La lista de asientos cuando se abre una venta (línea 6)
scenarios/qhatu.md
✔ E1. Búsqueda de productos en la hora punta (línea 8)
✔ E2. Posición del repartidor (línea 18)
✔ E3. El procesador de pagos deja de responder (línea 28)
✔ E4. Se cae una instancia del servidor (línea 38)
✔ E5. Abrir el servicio en una ciudad nueva (línea 48)
✔ E6. Un comprador pide datos de otro (línea 58)(Qhatu es el segundo sistema de ejemplo de la semana; aparece en la Sesión B.) El revisor exige tres cosas:
- Que estén las seis partes.
- Que ninguna esté vacía o con la indicación del template sin reemplazar.
- Que la medida de la respuesta tenga al menos un número y ninguna palabra que no se pueda comprobar: rápido, pronto, aceptable, razonable, nunca, siempre y algunas más.
La regla que decide está en checkScenario:
const measure = scenario.parts.measure;
if (measure !== undefined && !isPlaceholder(measure)) {
  if (!/\d/.test(measure)) {
    problems.push({ part: 'measure', message: 'no tiene ningún número: ¿cómo se comprueba?' });
  }
  const vague = VAGUE.exec(measure);
  if (vague) {
    problems.push({ part: 'measure', message: `"${vague[1]}" no se puede comprobar: escriban el número` });
  }
}
Conviene tener claro qué no hace. El revisor comprueba la forma, no el fondo. No sabe si 300 ms es lo que necesita el stakeholder, ni si 5 000 compradores es una cifra realista, ni si el entorno que escribieron es el que importa. Un escenario puede pasar el revisor y ser un mal escenario. La prueba que vale es la del laboratorio: que otra pareja lo lea y pueda comprobar la medida sin preguntarles nada.
Trade-off. Un revisor automático así es deliberadamente tosco. La alternativa es revisar cada escenario a mano, que detecta mucho más (un número absurdo, un entorno que no viene al caso) y no se puede poner en un
make check. El revisor gana en que corre siempre y no se cansa; paga con falsos negativos (deja pasar “p95 menor que 300 ms” aunque nadie sepa de dónde salió el 300) y con algún falso positivo (rechaza “siempre en menos de 2 s”, que con buena voluntad se entiende). Por eso en el curso se usan los dos: el revisor para la forma, otra pareja para el fondo.
Dos errores: sin medida y sin entorno
El archivo
errors/vague-scenarios.md tiene
tres escenarios mal escritos a propósito. make errors los pasa por el
revisor:
errors/vague-scenarios.md
  ✖ Sin medida: "responde rápido" (línea 6)
      Medida de la respuesta: no tiene ningún número: ¿cómo se comprueba?
      Medida de la respuesta: "rápido" no se puede comprobar: escriban el número
  ✖ Con una medida que nadie puede comprobar: "nunca falla" (línea 16)
      Medida de la respuesta: "nunca" no se puede comprobar: escriban el número
  ✖ Sin entorno (línea 26)
      Entorno: falta
scenario-check terminó con código 1
Error común. Un escenario sin medida. “El sistema responde rápido” tiene la forma de un requisito y no descarta nada: no hay medición que lo incumpla, porque quien lo escribió siempre puede decir que 4 segundos le parecen rápidos. El arreglo es poner el número y la unidad, y decir sobre qué se mide: latencia p95 menor que 400 ms, medida desde quien llama.
El segundo escenario del archivo es más traicionero, porque tiene un número: “el sistema nunca falla y está disponible el 100 % del tiempo”.
Error común. Una medida que nadie podría comprobar. Nunca no se puede medir en ningún plazo: después de un año sin fallas, todavía no se sabe si se cumple. Y 100 % de disponibilidad no es un objetivo que un sistema real pueda sostener: toda máquina falla, toda red se corta, todo deploy tiene un riesgo. Una medida comprobable dice cuánto se tolera y en qué ventana: menos de 0,5 % de pedidos fallidos, medido cada 30 días.
El tercero tiene buena medida y le falta una parte:
Error común. Un escenario sin entorno. “La búsqueda responde con p95 menor que 400 ms” no dice nada si no se sabe con cuánta carga, con cuántos datos y en qué estado está el sistema. Casi cualquier sistema responde en 400 ms con un usuario y la base de datos vacía. El entorno es lo que distingue la demostración del día de la venta: en hora punta, con el catálogo de 800 bodegas cargado, con una réplica caída, durante un deploy.
El entorno importa todavía más en los escenarios de disponibilidad, donde el estado del sistema es la mitad del requisito. No es lo mismo pedir que la compra funcione en operación normal que pedir que funcione con la pasarela de pagos respondiendo en 5 segundos. El primero lo cumple casi cualquier diseño; el segundo obliga a decidir qué hace Tinkuy mientras espera.
Los atributos que más veremos
Un estímulo típico para cada uno
Una forma práctica de reconocer de qué atributo trata un escenario es mirar su estímulo. Cada atributo tiene uno característico:
| Atributo | Estímulo típico | La medida suele ser | Dónde vuelve en el curso |
|---|---|---|---|
| Disponibilidad (availability) | Una falla: se cae un proceso, no responde un sistema externo, se corta la red | Fracción del tiempo o de los pedidos atendidos; tiempo para recuperarse | Semanas 6 y 14 |
| Rendimiento (performance) | Llegan eventos: pedidos, mensajes, un temporizador | Latencia por percentil, throughput | Semanas 6 y 11 |
| Modificabilidad (modifiability) | Llega un cambio: una función nueva, otro proveedor, otra regla | Esfuerzo, cantidad de módulos tocados, si exige un deploy | Semanas 3 y 4 |
| Seguridad (security) | Un ataque: alguien intenta leer, cambiar o tumbar algo sin permiso | Datos expuestos, tiempo hasta detectarlo | Semana 6 |
| Capacidad de prueba (testability) | Alguien necesita probar una parte | Tiempo para preparar y correr la prueba; qué fracción se puede probar sin levantar todo | Semana 3, con las dependencias que se pueden invertir |
| Capacidad de despliegue | Hay una versión nueva que poner en producción | Tiempo desde el commit hasta producción; tiempo para volver atrás | Semana 5, con los estilos distribuidos |
| Escalabilidad (scalability) | La carga crece: diez veces más usuarios o datos | Qué recursos hay que agregar para mantener la misma medida de rendimiento | Semanas 10 y 11 |
Dos observaciones sobre la tabla.
La primera: los estímulos no son solo cosas que pasan mientras el sistema corre. En modificabilidad, capacidad de prueba y capacidad de despliegue, la fuente es una persona del equipo y el entorno es el tiempo de desarrollo. Un escenario como “un desarrollador agrega un medio de pago nuevo; el cambio toca un solo módulo y toma menos de tres días” es tan escenario como uno de latencia, y se comprueba igual: haciendo el cambio y contando.
La segunda: la escalabilidad no tiene una medida propia. Se define sobre otra: el sistema escala si, cuando la carga crece, se puede mantener la latencia o el throughput agregando recursos en una proporción razonable. Por eso un escenario de escalabilidad siempre lleva dentro un escenario de rendimiento.
La lista no es completa y los nombres importan menos que el escenario. Hay atributos que aquí no aparecen y que para algunos sistemas son decisivos: usabilidad, interoperabilidad, eficiencia de energía, costo de operación. El capítulo 14 del libro, Working with Other Quality Attributes, es la lectura complementaria para ese caso. La técnica no cambia cuando el atributo no está en ninguna lista: se escriben sus escenarios, con las mismas seis partes.
ISO/IEC 25010: otra lista
El estándar ISO/IEC 25010 propone otra clasificación: un modelo de calidad del producto con nueve características, cada una dividida en subcaracterísticas. Sus nombres no coinciden uno a uno con los del libro. Lo que el libro llama rendimiento, el estándar lo ubica en eficiencia de desempeño; la disponibilidad es una subcaracterística de la fiabilidad; la modificabilidad y la capacidad de prueba están dentro de la mantenibilidad.
Sirve para dos cosas: como lista de chequeo, para notar atributos que nadie mencionó, y como vocabulario común en contratos y auditorías, donde se pide que un informe siga un estándar. No sirve para decidir cuál importa en un sistema, y tampoco resuelve el problema de las palabras: fiabilidad sola es tan vaga como robusto. Con cualquier clasificación, el paso que sigue es el mismo: bajar cada nombre a escenarios.
Idea clave. Ninguna lista de atributos es completa, y dos listas distintas parten el mismo terreno de formas distintas. Lo que se traslada de un sistema a otro no es la lista, sino la técnica: estímulo, entorno, respuesta, medida.
Tácticas: una primera mención
Un escenario dice qué se necesita. No dice cómo lograrlo. La pieza que conecta las dos cosas se llama táctica (tactic): una decisión de diseño que influye sobre la respuesta del sistema a un estímulo.
Para el escenario de la lista de asientos, algunas tácticas posibles son guardar la respuesta en una cache, mantener abiertas las conexiones a la base de datos, o limitar cuántos pedidos se atienden a la vez. Cada una mueve la medida en una dirección, y cada una tiene un costo en otro atributo (lo veremos al final de este capítulo, en Trade-offs).
Las tácticas se estudian en la semana 6, con un catálogo por atributo. Por ahora basta con tener claro el orden: primero el escenario, después la táctica. Quien empieza por la táctica (“pongamos una cache”) no tiene cómo saber si la necesitaba ni si funcionó.
Latencia, tiempo de respuesta y throughput
Tres medidas
Para hablar de rendimiento hacen falta tres palabras, que en el uso diario se mezclan.
El tiempo de respuesta (response time) es lo que ve quien llama: desde que envía el pedido hasta que recibe la respuesta completa. Incluye el viaje por la red, el tiempo en cola y el tiempo en que el servidor trabaja.
La latencia (latency), en sentido estricto, es el tiempo que un pedido pasa esperando a que lo atiendan. En la práctica, casi todas las herramientas y casi todos los equipos dicen latencia para referirse al tiempo de respuesta, y en el curso también lo haremos: cuando escribimos “latencia p95 menor que 300 ms”, hablamos del tiempo de respuesta medido desde quien llama. La distinción vale la pena cuando se busca dónde se va el tiempo: un pedido que tarda 500 ms puede haber esperado 480 y trabajado 20.
El throughput es cuánto trabajo completa el sistema por unidad de tiempo: pedidos por segundo, órdenes por minuto.
Latencia y throughput no son dos caras de lo mismo. Un sistema puede tener buen throughput y mala latencia (procesa mucho, pero en lotes, y cada pedido espera su lote) o buena latencia y mal throughput (responde al instante a los pocos pedidos que acepta). Un escenario de rendimiento suele fijar los dos: el estímulo dice cuántos pedidos llegan y la medida dice cuánto puede tardar cada uno.
En el resumen de k6, las tres métricas que vamos a leer toda la semana son:
| Métrica de k6 | Qué mide |
|---|---|
http_req_duration |
El tiempo de respuesta de cada pedido HTTP, desde que k6 lo envía hasta que termina de recibir la respuesta. Es una distribución: k6 la resume con promedio, mediana, percentiles y máximo |
http_reqs |
Cuántos pedidos se hicieron en total y por segundo: el throughput que k6 logró generar |
http_req_failed |
Qué fracción de los pedidos falló (por omisión, los que respondieron con un código 4xx o 5xx, o no respondieron) |
El tiempo de respuesta es una distribución
Hagan el mismo pedido cien veces al mismo servidor y van a obtener cien tiempos distintos. No es un defecto de la medición: es como funcionan los sistemas. Entre un pedido y otro cambia quién más está usando el procesador, si el dato estaba en memoria o hubo que leerlo del disco, si justo corrió el recolector de basura, si la conexión ya estaba abierta, si otro pedido tenía tomado un lock.
Por eso “¿cuánto tarda este endpoint?” no tiene un número por respuesta. Tiene una distribución: la mayoría de los pedidos cae cerca de un valor típico, y algunos, pocos, tardan mucho más. Esa parte de la derecha, la de los pedidos lentos, se llama la cola de la distribución, y en casi todos los sistemas es larga: el pedido más lento no tarda un 20 % más que el típico, tarda diez o cien veces más.
Todo el problema de reportar rendimiento es cómo resumir una distribución con dos o tres números sin esconder la cola.
Percentiles
Definición y cálculo
El percentil de un conjunto de mediciones es un valor tal que al menos el de las mediciones es menor o igual que él. Se escribe p50, p95, p99.
- El p50 es la mediana: la mitad de los pedidos tardó eso o menos, y la otra mitad tardó eso o más. Describe el caso típico.
- El p95 deja por encima al 5 % más lento: uno de cada veinte pedidos tardó más.
- El p99 deja por encima al 1 % más lento: uno de cada cien.
Hay más de una forma de calcularlo cuando el no cae justo en una medición. En el curso usamos la más simple, y la decimos siempre de forma explícita: el método del rango más cercano (nearest-rank).
Se ordenan las mediciones de menor a mayor. El percentil es la que ocupa la posición , contando desde 1.
( es el techo de : el menor entero mayor o igual que .) Así está en stats.ts:
export function percentile(values: readonly number[], p: number): number {
  if (values.length === 0) throw new RangeError('No hay percentiles de una lista vacía');
  if (!(p > 0 && p <= 100)) throw new RangeError(`El percentil debe estar en (0, 100]: ${p}`);
  const sorted = [...values].sort((a, b) => a - b);
  const rank = Math.ceil((p / 100) * sorted.length);
  return sorted[rank - 1]!;
}
Un ejemplo a mano, con cinco mediciones: 15, 20, 35, 40 y 50 ms.
| Percentil | Posición | Valor | |
|---|---|---|---|
| p30 | 1,5 | 2 | 20 ms |
| p40 | 2,0 | 2 | 20 ms |
| p50 | 2,5 | 3 | 35 ms |
| p100 | 5,0 | 5 | 50 ms |
Con este método, el percentil siempre es una de las mediciones: “el p95 fue de 300 ms” quiere decir que hubo un pedido que tardó exactamente 300 ms y que al menos el 95 % tardó eso o menos. Las pruebas de stats.test.ts fijan esa propiedad y los valores de la tabla.
Tres cuidados con la definición:
- El p100 es el máximo. No existe el p0 con este método.
- Con pocas mediciones, los percentiles altos no dicen casi nada. Con 20 mediciones, el p99 es la posición : el máximo. Para que el p99 sea algo distinto del peor caso hacen falta bastante más de 100 mediciones.
- Un percentil habla de pedidos, no de usuarios. Si un comprador hace 40 pedidos durante una compra, lo más probable es que alguno de los suyos haya caído por encima del p95.
Cómo calcula k6 un percentil
k6 no usa el rango más cercano: cuando la posición no es entera, interpola entre las dos mediciones vecinas. Se puede ver sin hacer ningún pedido. El script load/percentiles.js carga en una métrica diez valores conocidos (10, 20, …, 100 ms) y deja que k6 los resuma:
    CUSTOM
    sample...............: avg=55ms    med=55ms    p(90)=91ms    p(95)=95.5ms  p(99)=99.1ms  max=100ms
Con los mismos diez valores, node calc.ts percentiles (rango más cercano)
responde:
n = 10
promedio = 55.0 ms
p50 = 50 ms   p95 = 100 ms   p99 = 100 ms   máx = 100 ms
Ninguno de los dos está mal: son dos definiciones. k6 reporta una mediana de 55 ms, que no es ninguna de las diez mediciones; el rango más cercano responde 50 ms, que sí lo es. Con diez valores la diferencia se nota; con los miles de pedidos de una prueba de carga, los dos métodos dan casi lo mismo, porque las mediciones vecinas están muy juntas. Lo que importa es saber con cuál se calculó un número antes de compararlo con otro, y no comparar el p95 de una herramienta con el de otra sobre muestras pequeñas.
Por qué no el promedio
El resumen que a todos se nos ocurre primero es el promedio. El problema es que el promedio responde una pregunta que casi nunca es la que interesa.
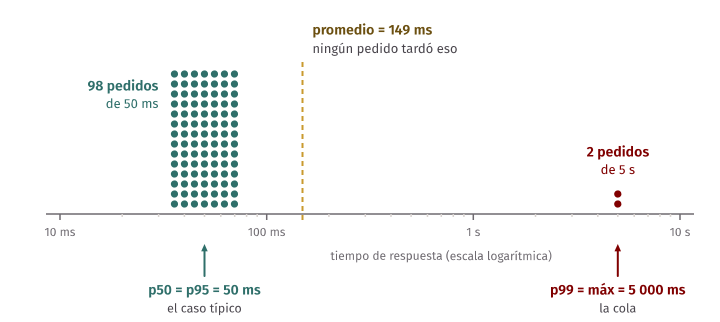
Un caso mínimo: de 100 pedidos, 98 tardan 50 ms y 2 tardan 5 segundos. Esos datos están en data/latencies.txt:
node calc.ts percentiles data/latencies.txtn = 100
promedio = 149.0 ms
p50 = 50 ms p95 = 50 ms p99 = 5000 ms máx = 5000 msEl promedio es 149 ms: . Y no describe a ningún usuario. Nadie esperó 149 ms. Noventa y ocho esperaron 50 ms, un tercio de lo que dice el promedio, y dos esperaron 5 segundos, más de treinta veces lo que dice. Quien lea “latencia promedio: 149 ms” va a imaginar un sistema parejo y algo lento, que es exactamente lo que este sistema no es.
Los percentiles cuentan otra historia, y es la correcta: el caso típico es de 50 ms (p50), 95 de cada 100 pedidos también (p95), y hay una cola de 5 segundos que aparece en el p99.
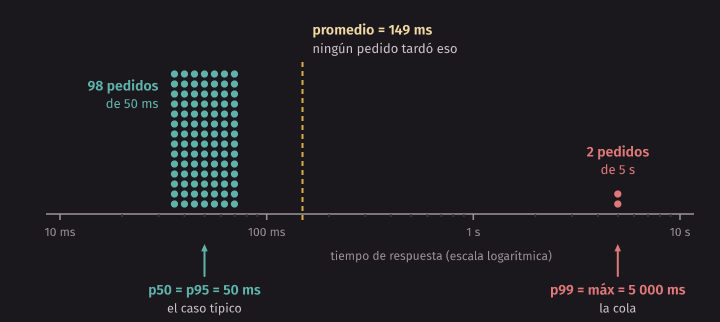
El promedio falla por dos razones, y las dos son propias de las distribuciones con cola larga:
- Unos pocos valores extremos lo arrastran. Dos pedidos de 100 triplican el promedio. La mediana ni se entera.
- Mezcla poblaciones. Cuando hay dos grupos de pedidos (los que encuentran el dato en memoria y los que no; los que compran y los que llegan tarde), el promedio cae en el medio, donde no hay nadie.
Idea clave. El promedio dice cuánto trabajo hizo el sistema en total. Los percentiles dicen qué le pasó a la gente. Para un escenario de calidad interesa lo segundo: la medida se escribe con un percentil.
Eso no vuelve inútil al promedio. Sirve para lo que mide: capacidad y costo. Si cada pedido usa en promedio 12 ms de procesador, 1 000 pedidos por segundo necesitan unos 12 núcleos, y ese cálculo se hace con el promedio. Lo que no se puede hacer con él es afirmar algo sobre la experiencia de quien espera.
Dos poblaciones en la venta de Tinkuy
El caso de las dos poblaciones no es un invento para la clase. Aparece al
medir Tinkuy con make load-sale: 200 compradores a la vez sobre el evento
1, durante 30 segundos, cada uno intentando comprar 1 o 2 asientos al azar.
Este es el resumen de una corrida, con la base de datos recién creada:
    CUSTOM
    orders_error...................: 100    3.165525/s
    orders_paid....................: 1427   45.172035/s
    orders_seat_taken..............: 4242   134.28155/s

    HTTP
    http_req_duration..............: avg=58.34ms min=3.8ms   med=6.01ms p(90)=210.3ms  p(95)=212.21ms p(99)=270.45ms max=404.59ms
      { expected_response:true }...: avg=58.37ms min=3.8ms   med=5.96ms p(90)=210.35ms p(95)=212.28ms p(99)=270.52ms max=404.59ms
    http_req_failed................: 1.73%  100 out of 5770
    http_reqs......................: 5770   182.650765/s
Miren la línea de http_req_duration. La mediana es de 6 ms y el p90 es de
210 ms: treinta y cinco veces más. No hay una cola que crece de a pocos; hay
un salto. Y el promedio, 58 ms, cae en el medio del salto.
Los contadores de arriba lo explican. De los 5 769 intentos de compra, 4 242 recibieron un 409 (el asiento ya estaba vendido) y 1 427 compraron. Son dos tipos de pedido que hacen trabajos muy distintos:
- El que llega tarde recibe su 409 en cuanto Tinkuy lee el asiento y ve que no está disponible: unos 6 ms.
- El que compra pasa por la pasarela de pagos (que en la configuración por omisión demora 80 ms) y por el servidor de correo simulado (120 ms): algo más de 200 ms.
El promedio de 58 ms no describe a ninguno de los dos grupos. Y hay algo
peor: como casi tres de cada cuatro pedidos son rechazos rápidos, la mediana
describe al que no pudo comprar. Si el escenario que interesa es “cuánto
espera quien compra”, ni el promedio ni la mediana de http_req_duration
sirven: hay que medir por separado los pedidos que terminaron en 201.
En Tinkuy. Cuando una métrica mezcla pedidos que hacen trabajos distintos, sepárenla antes de resumirla. k6 lo permite con etiquetas, como veremos en Métricas por endpoint. La medida de un escenario dice sobre qué pedidos se calcula: “p95 de las compras aceptadas” y “p95 de todos los
POST /orders” son números muy diferentes sobre la misma corrida.
Por qué importan los percentiles altos
Si el 99 % de los pedidos va bien, ¿por qué preocuparse por el 1 %? Hay dos razones, y ninguna es perfeccionismo.
Los pedidos lentos no se reparten al azar entre los usuarios. Suelen ser los de quienes tienen más datos: el organizador con cientos de eventos, la cuenta con años de historial, el evento con más asientos. Esos usuarios hacen los pedidos más pesados y son, con frecuencia, los que más valen para el negocio. Un p99 malo no molesta a un 1 % cualquiera: molesta siempre a los mismos, y son los que más usan el sistema.
Una página no hace un pedido: hace muchos. Si abrir una pantalla requiere varias llamadas al servidor y la pantalla está lista cuando llega la última, el tiempo de la pantalla es el de su llamada más lenta. La probabilidad de que al menos una de llamadas independientes caiga por encima del p99 del servicio es :
| Llamadas por pantalla | Probabilidad de que al menos una supere el p99 |
|---|---|
| 1 | 1 % |
| 10 | 9,6 % |
| 100 | 63,4 % |
Con 100 llamadas, casi dos de cada tres pantallas ven una respuesta de las
que el servicio considera raras. Lo que para el servicio es su 1 % peor, para
el usuario de esa pantalla es lo normal. La cuenta está en
probabilityOfSlowCall, con su prueba, y supone que las llamadas son
independientes; si los pedidos lentos vienen juntos (porque todos esperan al
mismo lock, por ejemplo), la probabilidad cambia.
¿Hasta qué percentil hay que mirar? Depende del sistema, y es una decisión con costo. Cada nueve adicional (p99, p99,9, p99,99) es más difícil de mejorar, porque los pedidos de esa zona son lentos por causas cada vez más raras y más ajenas al código: una pausa del sistema operativo, un paquete perdido. Y es más difícil de medir: para estimar un p99,9 con alguna confianza hacen falta decenas de miles de pedidos.
En la industria. El capítulo 4 del libro de SRE de Google, Service Level Objectives, recomienda trabajar con percentiles y no con la media, y da el motivo: los datos de latencia son asimétricos (ningún pedido tarda menos de 0 ms, y un timeout corta los valores altos), así que no se puede suponer que la media y la mediana se parezcan. El mismo capítulo cuenta que algunos de sus equipos miran solo percentiles altos, con el argumento de que si el comportamiento en el p99,9 es bueno, el del caso típico también lo es.
Los percentiles no se promedian
Supongan que Tinkuy corre en cuatro servidores y cada uno reporta su p95. ¿Cuál es el p95 del sistema? La tentación es promediar los cuatro. No funciona.
Un caso con dos servidores basta para verlo. Uno es rápido y atiende casi todo: 900 pedidos de 20 ms. El otro es lento y atiende poco: 100 pedidos de 800 ms.
- p95 del rápido: 20 ms. p95 del lento: 800 ms. Promedio de los dos: 410 ms.
- p95 real, con los 1 000 pedidos juntos: la posición . Las posiciones 1 a 900 son de 20 ms y las 901 a 1 000 son de 800 ms. El p95 es 800 ms.
El promedio de los percentiles dice 410 ms, un valor que ningún pedido tuvo y
que queda a la mitad del valor real. La prueba los percentiles no se promedian entre máquinas fija este ejemplo.
La razón es que un percentil es una posición en una lista ordenada, y para conocer una posición en la lista completa hace falta la lista completa (o algo equivalente). El promedio de dos p95 no conserva cuántos pedidos atendió cada servidor ni cómo se intercalan sus valores. Ponderar por la cantidad de pedidos tampoco lo arregla.
Lo que sí se puede combinar:
- Las mediciones crudas: se juntan todas y se calcula el percentil sobre el total. Es lo que hace k6 dentro de una corrida.
- Los histogramas: cada servidor cuenta cuántos pedidos cayeron en cada intervalo (de 0 a 10 ms, de 10 a 25 ms, …), los conteos de todos los servidores se suman, y el percentil se estima sobre el histograma sumado. Así trabajan los sistemas de monitoreo; las métricas de un sistema en operación son tema de la semana 14.
Lo mismo vale en el tiempo: el p95 de una hora no es el promedio de los p95 de sus sesenta minutos.
Error común. Un tablero que muestra “p95 promedio” de varias máquinas, o de varios intervalos. El número se ve razonable y no significa nada. Si en un reporte tienen que combinar percentiles de varias corridas, no los promedien: muéstrenlos todos, o junten las mediciones.
Medir sin engañarse
Medir Tinkuy con k6
k6 es un generador de carga: un script en JavaScript describe qué hace un
usuario virtual, las opciones dicen cuántos usuarios hay y durante cuánto
tiempo, y al terminar k6 imprime un resumen. Tinkuy trae dos scripts.
load/browse.js simula gente mirando el catálogo: la lista de eventos, el
detalle de uno y su mapa de asientos, con medio segundo de pausa entre un
pedido y otro. Sube hasta 50 usuarios virtuales en 10 segundos, se queda ahí
15 y baja.
Con Tinkuy y la pasarela corriendo (make db, make gateway y make start
en tinkuy/), make load-browse termina con este resumen. Es de una
corrida en una laptop con Apple Silicon, dentro de Docker:
  █ TOTAL RESULTS

    checks_total.......: 2205    71.351582/s
    checks_succeeded...: 100.00% 2205 out of 2205
    checks_failed......: 0.00%   0 out of 2205

    ✓ GET /events responde 200
    ✓ GET /events/:id responde 200
    ✓ GET /events/:id/seats responde 200

    CUSTOM
    duration_event_detail..........: avg=8.56ms  min=6.47ms  med=7.96ms  p(90)=10.74ms p(95)=12.06ms p(99)=16.73ms max=27.97ms
    duration_event_seats...........: avg=11.79ms min=8.73ms  med=10.94ms p(90)=14.81ms p(95)=17.07ms p(99)=24.31ms max=34.25ms
    duration_events_list...........: avg=61.47ms min=48.65ms med=57.66ms p(90)=76.05ms p(95)=82.72ms p(99)=111.8ms max=126.28ms

    HTTP
    http_req_duration..............: avg=27.27ms min=6.47ms  med=11.4ms  p(90)=64.56ms p(95)=71.18ms p(99)=91.85ms max=126.28ms
      { expected_response:true }...: avg=27.27ms min=6.47ms  med=11.4ms  p(90)=64.56ms p(95)=71.18ms p(99)=91.85ms max=126.28ms
    http_req_failed................: 0.00%  0 out of 2205
    http_reqs......................: 2205   71.351582/s

    EXECUTION
    iteration_duration.............: avg=1.58s   min=1.56s   med=1.58s   p(90)=1.6s    p(95)=1.61s   p(99)=1.63s   max=1.65s
    iterations.....................: 735    23.783861/s
    vus............................: 8      min=5         max=50
    vus_max........................: 50     min=50        max=50
Cómo se lee, de abajo hacia arriba:
vuseiterations. Hubo hasta 50 usuarios virtuales y completaron 735 iteraciones. Una iteración es una pasada completa por la función del script: tres pedidos y tres pausas de medio segundo. Por esoiteration_durationes de 1,58 s: 1,5 s son pausas.http_reqs. 2 205 pedidos, unos 71 por segundo. Ese es el throughput que el script generó, no el máximo que Tinkuy aguanta: con 50 usuarios que descansan medio segundo entre pedidos no se puede generar mucho más.http_req_failed. 0 %: ningún pedido falló.http_req_duration. La mediana es de 11,4 ms y el p95 de 71,18 ms. Otra vez hay un salto entre la mediana y el p90, y otra vez la causa es que la métrica mezcla pedidos distintos. Las tres métricas de la secciónCUSTOM, que el script define para separar los tres endpoints, lo muestran: el detalle y los asientos responden en unos 10 ms, y la lista de eventos en unos 60. El p95 global, 71 ms, es en realidad el tiempo de la lista de eventos: como uno de cada tres pedidos va a ese endpoint, todo lo que está por encima del percentil 67 es suyo.
Dos cosas que el resumen no dice, y que hay que anotar a mano junto al número: en qué máquina se midió y contra qué datos (aquí, los de la semilla 7, recién cargados).
En Tinkuy. Los scripts de la versión 0 no definen umbrales: solo miden. k6 termina con código 0 aunque el p95 sea de diez segundos, porque nadie le dijo cuánto es demasiado. Eso se agrega cuando hay un escenario que diga el número, y es el paso 5 del laboratorio.
Cuánto varía una medición
Antes de comparar dos diseños hay que saber cuánto cambia el número cuando no
se cambió nada. Estas son tres corridas seguidas de make load-browse, sin
tocar Tinkuy ni la base de datos entre una y otra, en la misma máquina:
| Corrida | Promedio | Mediana | p95 | p99 | Máximo |
|---|---|---|---|---|---|
| 1 | 27,27 ms | 11,4 ms | 71,18 ms | 91,85 ms | 126,28 ms |
| 2 | 39,21 ms | 12,96 ms | 105,05 ms | 352,83 ms | 817,36 ms |
| 3 | 30,75 ms | 12,52 ms | 81,78 ms | 107,19 ms | 249,19 ms |
(Los valores son los de la línea http_req_duration de cada resumen.)
El mismo sistema, la misma carga, la misma máquina: el p95 fue de 71 ms en una corrida y de 105 ms en otra, casi un 50 % más. El p99 se multiplicó por casi cuatro. La mediana fue lo más estable: se movió entre 11,4 y 13 ms. Y el promedio, que parecía un número tranquilo, varió tanto como el p95, porque los pocos pedidos lentos de la corrida 2 lo arrastraron.
Tres consecuencias prácticas:
- Una corrida no alcanza. Si después de un cambio el p95 baja de 105 a 80 ms, eso no prueba nada: la diferencia cabe dentro de lo que el sistema varía solo. Hay que repetir cada medición varias veces, antes y después, y mostrar todas las corridas.
- Un cambio cuenta cuando los rangos no se tocan. Si en tres corridas el diseño A da p95 de 71, 82 y 105 ms y el diseño B da 18, 21 y 24 ms, hay una diferencia. Si B da 68, 90 y 99 ms, no se puede afirmar nada.
- Cuanto más alto el percentil, más varía. El p99 de una corrida de 2 200 pedidos lo deciden unos 22 pedidos. Para comparar percentiles altos hacen falta corridas más largas, no solo más corridas.
La variación tiene causas concretas y algunas se pueden reducir: otros
programas usando la máquina, el estado de la base de datos (por eso se corre
make db antes de repetir una prueba que escribe), y el propio k6, que en la
laptop compite por el procesador con el sistema que mide.
Métricas por endpoint
http_req_duration junta todos los pedidos de la prueba. Para encontrar el
endpoint lento hay que separarlos. k6 lo hace con etiquetas: cada pedido
lleva una etiqueta name, y una métrica se puede filtrar por el valor de
una etiqueta.
El script load/by-endpoint.js recorre los cinco endpoints de lectura de Tinkuy con 20 usuarios virtuales durante 20 segundos:
function get(name, path) {
  const response = http.get(`${BASE_URL}${path}`, { tags: { name } });
  check(response, { [`${name} responde 200`]: (r) => r.status === 200 });
  sleep(0.2);
}
La etiqueta cumple además otra función: sin ella, k6 trataría /events/1 y
/events/2 como dos URLs distintas, y habría una métrica por evento.
k6 solo muestra en el resumen una métrica filtrada si tiene un umbral. El
script le pone a cada endpoint un umbral que se cumple siempre (max>=0),
que no juzga nada y solo pide la fila:
const thresholds = {};
for (const name of ENDPOINTS) {
  thresholds[`http_req_duration{name:${name}}`] = ['max>=0'];
}
Con Tinkuy corriendo, make endpoints da (misma laptop):
    HTTP
    http_req_duration..................: avg=29.02ms med=11.18ms p(95)=113.29ms p(99)=185.1ms  max=199.38ms
      { expected_response:true }.......: avg=29.02ms med=11.18ms p(95)=113.29ms p(99)=185.1ms  max=199.38ms
      { name:GET /events }.............: avg=99.84ms med=84.7ms  p(95)=185.16ms p(99)=195.74ms max=199.38ms
      { name:GET /events/:id }.........: avg=11.42ms med=9.9ms   p(95)=21.97ms  p(99)=29.89ms  max=33.11ms
      { name:GET /events/:id/seats }...: avg=15.22ms med=14.37ms p(95)=23.7ms   p(99)=29.54ms  max=31.14ms
      { name:GET /orders/:id }.........: avg=10.06ms med=9.43ms  p(95)=15.7ms   p(99)=17.7ms   max=25.94ms
      { name:GET /reports/sales }......: avg=8.58ms  med=8.12ms  p(95)=13.19ms  p(99)=16.74ms  max=20.07ms
    http_req_failed....................: 0.00%  0 out of 1800
    http_reqs..........................: 1800   85.821685/s
Cuatro endpoints tienen una mediana de entre 8 y 15 ms. Uno, GET /events,
tiene una mediana de 85 ms: entre seis y diez veces más que cualquiera de los
otros, en la misma corrida y en la misma máquina. Esa comparación sí se
puede llevar a otra computadora: los milisegundos van a cambiar, y la lista
de eventos va a seguir siendo varias veces más lenta que el resto.
El resultado tiene algo curioso. GET /events/:id/seats devuelve hasta 2 000
asientos y GET /events devuelve 24 eventos, y el que tarda es el segundo.
El tamaño de la respuesta no es lo que manda. Por qué tarda es el paso 4 del
laboratorio: la respuesta está en src/catalog/events.ts.
Error común. Comparar números de dos scripts distintos. En
load/browse.jsla mediana de la lista de eventos fue de 58 ms, y aquí de 85 ms. El endpoint es el mismo; cambió la carga: otro número de usuarios, otras pausas, otros endpoints compitiendo. Un número de latencia solo se compara con otro obtenido con el mismo script, los mismos datos y la misma máquina.
Carga realista, calentamiento y desde dónde se mide
Una medición responde la pregunta que le hace el script, que no siempre es la que uno cree estar haciendo. Tres cuidados, antes de llegar al más sutil.
Carga realista. La carga de la prueba tiene que parecerse al estímulo del escenario en lo que afecta al resultado:
- La mezcla de pedidos. Un script que solo pide el detalle de un evento mide un Tinkuy que no existe: la gente también lista, mira asientos y compra.
- Los datos. La consulta de asientos no tarda lo mismo con una base de
datos vacía que con los 13 080 asientos de los datos de ejemplo. Y el
estado cambia con la prueba: después de un
make load-sale, casi todos los asientos del evento 1 están vendidos y la siguiente corrida mide otra cosa. Por eso se corremake dbantes de repetir. - Las pausas. Una persona tarda en leer la pantalla antes del siguiente clic. Un script sin pausas con 50 usuarios virtuales no representa a 50 personas, sino a muchas más.
Calentamiento. Los primeros pedidos después de arrancar un sistema suelen
ser más lentos que los siguientes: el motor de JavaScript todavía no compiló
las funciones que más se usan, la base de datos no tiene en memoria las
páginas que va a leer, las conexiones no están abiertas. Si la prueba dura
pocos segundos, esos pedidos pesan en los percentiles altos. Hay dos formas
de tratarlo, según lo que diga el escenario: si el escenario es de operación
normal, se descarta el arranque (una corrida previa que no se anota, o una
rampa como los 10 segundos iniciales de load/browse.js); si el escenario es
justamente “el sistema acaba de reiniciarse”, el arranque es lo que se
mide.
Desde quien llama. El tiempo que importa es el que ve quien hizo el pedido. Un servidor que mide su propio tiempo de respuesta empieza a contar cuando empieza a atender el pedido: no ve lo que el pedido esperó en la cola antes de eso, ni la red. k6 mide desde afuera, que es lo correcto. En el contenedor del curso, k6 y Tinkuy corren en la misma máquina, así que la red casi no cuenta y los dos compiten por el procesador: otra razón por la que estos números no describen un sistema desplegado.
La omisión coordinada
Queda el error de medición más traicionero, porque no depende de descuidar nada: lo comete la herramienta, y el resumen sale limpio.
Un generador de carga puede trabajar de dos formas.
En el modelo cerrado, hay un número fijo de usuarios virtuales y cada uno
repite un ciclo: enviar un pedido, esperar la respuesta, descansar,
enviar el siguiente. Es lo que hacen vus y stages en k6 (los ejecutores
constant-vus y ramping-vus), y es lo que usan los dos scripts de Tinkuy.
En el modelo abierto, los pedidos salen a un ritmo fijo (200 por segundo,
por ejemplo) sin importar si los anteriores ya respondieron. En k6 son los
ejecutores constant-arrival-rate y ramping-arrival-rate.
Mientras el servidor responde rápido, los dos modelos generan cargas parecidas. La diferencia aparece cuando el servidor se pone lento. En el modelo cerrado, cada usuario virtual se queda esperando su respuesta y deja de enviar. El generador reduce la carga justo en el momento en que el sistema tiene problemas, y los pedidos que habrían llegado durante ese rato, y que habrían esperado, nunca se envían ni se miden. El generador y el servidor se coordinaron sin querer para omitir las peores mediciones: eso es la omisión coordinada (coordinated omission).
Para verla hace falta un servidor que se detenga. omission/stall-server.ts responde en 2 ms, salvo durante una ventana de 1 segundo que se repite cada 10: lo que llega durante la ventana espera hasta que termine. Es lo que le pasa a un servidor real durante una pausa larga del recolector de basura, o cuando todos los pedidos esperan el mismo lock.
Piensen primero qué debería reportar una medición honesta. El servidor está detenido el 10 % del tiempo. Si la gente llega a un ritmo parejo, el 10 % de los pedidos cae en una ventana, y espera entre 0 y 1 segundo según cuán tarde haya llegado. El p90 debería estar en el borde, el p95 cerca de medio segundo y el p99 cerca de 900 ms.
make omission levanta el servidor y lo mide con los dos modelos. Primero el
cerrado (load/closed-model.js): 10
usuarios virtuales que descansan 50 ms entre pedidos.
== Modelo cerrado: 10 usuarios virtuales (constant-vus)


  █ THRESHOLDS

    http_req_duration
    ✓ 'p(95)<300' p(95)=5.71ms


  █ TOTAL RESULTS

    HTTP
    http_req_duration..............: avg=9.84ms  med=3.57ms  p(90)=5.23ms  p(95)=5.71ms  p(99)=7.81ms  max=1s
      { expected_response:true }...: avg=9.84ms  med=3.57ms  p(90)=5.23ms  p(95)=5.71ms  p(99)=7.81ms  max=1s
    http_req_failed................: 0.00%  0 out of 4811
    http_reqs......................: 4811   160.250969/s
k6 terminó con código 0Después el abierto (load/open-model.js): 200 pedidos por segundo.
== Modelo abierto: 200 pedidos por segundo (constant-arrival-rate)


  █ THRESHOLDS

    http_req_duration
    ✗ 'p(95)<300' p(95)=502.9ms


  █ TOTAL RESULTS

    HTTP
    http_req_duration..............: avg=53.57ms med=3.43ms p(90)=14.72ms p(95)=502.9ms  p(99)=901.47ms max=1s
      { expected_response:true }...: avg=53.57ms med=3.43ms p(90)=14.72ms p(95)=502.9ms  p(99)=901.47ms max=1s
    http_req_failed................: 0.00%  0 out of 6002
    http_reqs......................: 6002   200.032801/s
time="2026-11-16T05:51:31Z" level=error msg="thresholds on metrics 'http_req_duration' have been crossed"
k6 terminó con código 99El mismo servidor, en la misma máquina, con un minuto de diferencia:
| Modelo cerrado | Modelo abierto | |
|---|---|---|
| Pedidos | 4 811 | 6 002 |
| Mediana | 3,57 ms | 3,43 ms |
| p95 | 5,71 ms | 502,9 ms |
| p99 | 7,81 ms | 901,47 ms |
| Máximo | 1 s | 1 s |
Umbral p(95)<300 |
se cumple | no se cumple |
Las medianas coinciden y los máximos también: los dos vieron un servidor que normalmente responde en 3 o 4 ms y que alguna vez tardó un segundo. En el medio, las conclusiones son opuestas. Según el modelo cerrado, 99 de cada 100 pedidos se atienden en menos de 8 ms. Según el abierto, 5 de cada 100 esperan más de medio segundo. El abierto es el que coincide con la cuenta que hicimos antes de medir.
La explicación está en cuántos pedidos lentos midió cada uno. En cada detención, los 10 usuarios del modelo cerrado quedan atrapados con un pedido cada uno, y no envían más hasta que el servidor vuelve. Tres detenciones en 30 segundos: a lo sumo 30 pedidos lentos entre 4 811, un 0,6 %. El p99 ni los toca. El promedio lo confirma: 30 pedidos de alrededor de un segundo repartidos entre 4 811 suman unos 6 ms a los 3,6 ms habituales, y el promedio reportado es 9,84 ms. En el modelo abierto, durante cada segundo de detención salieron los 200 pedidos que tocaban: 600 pedidos esperaron, el 10 % del total.
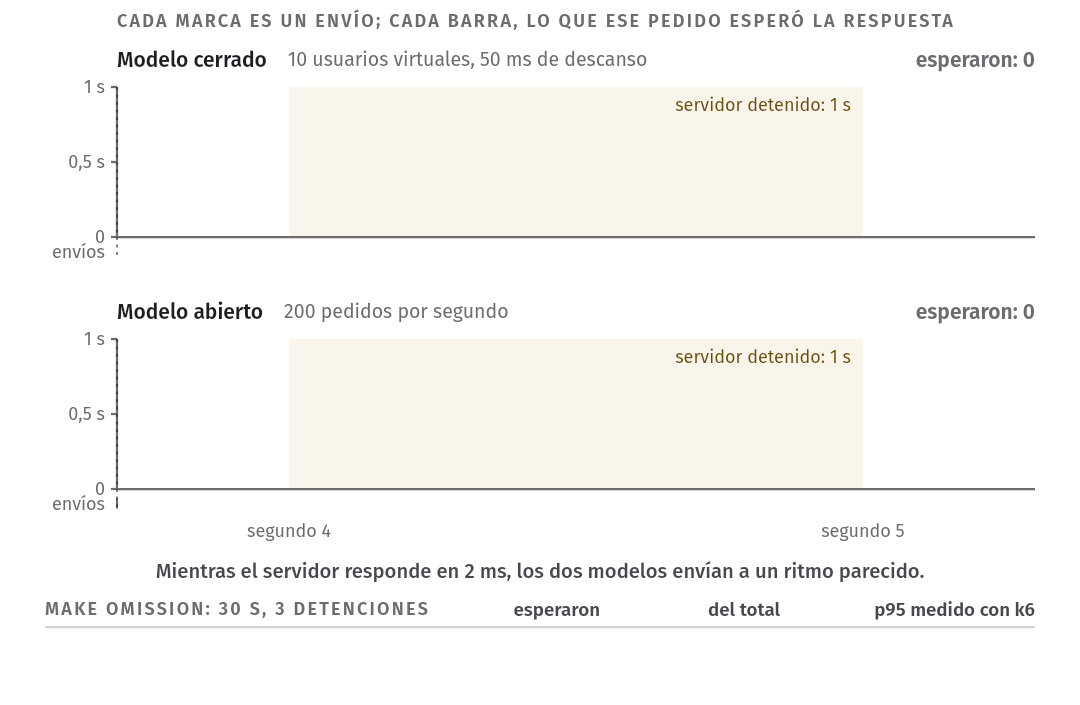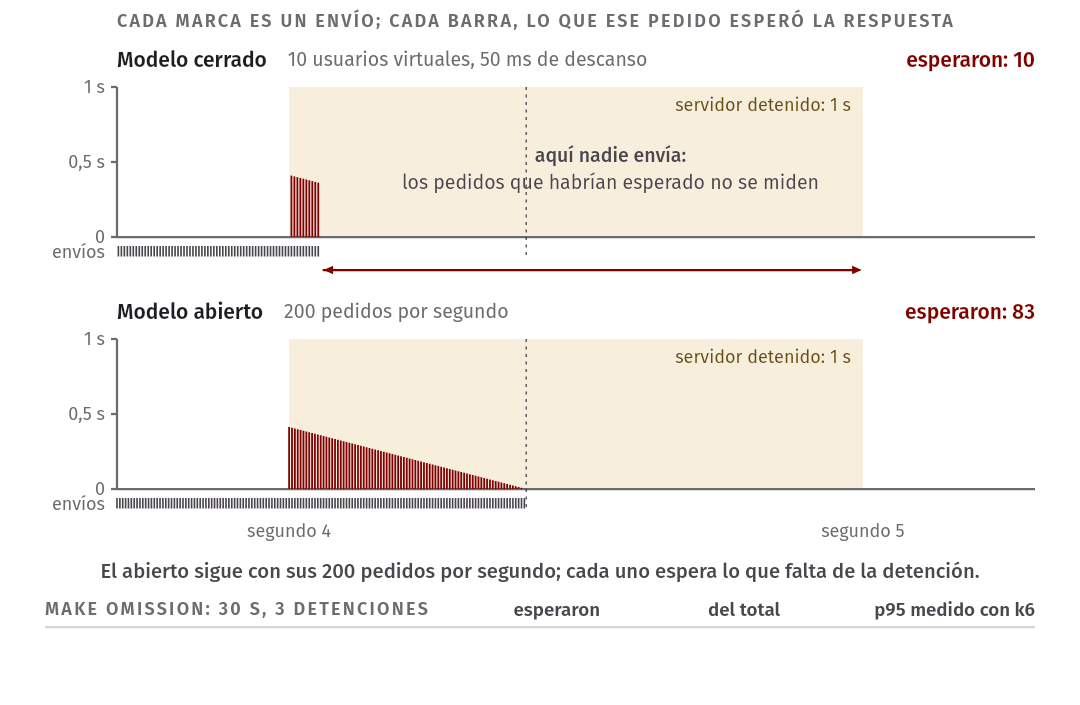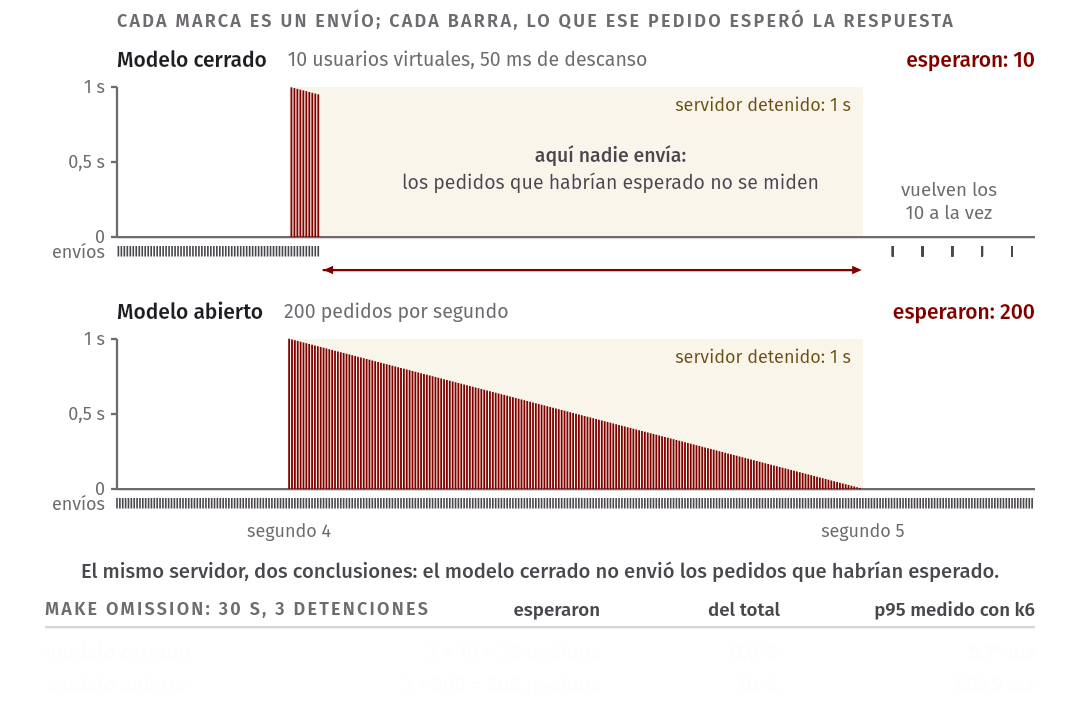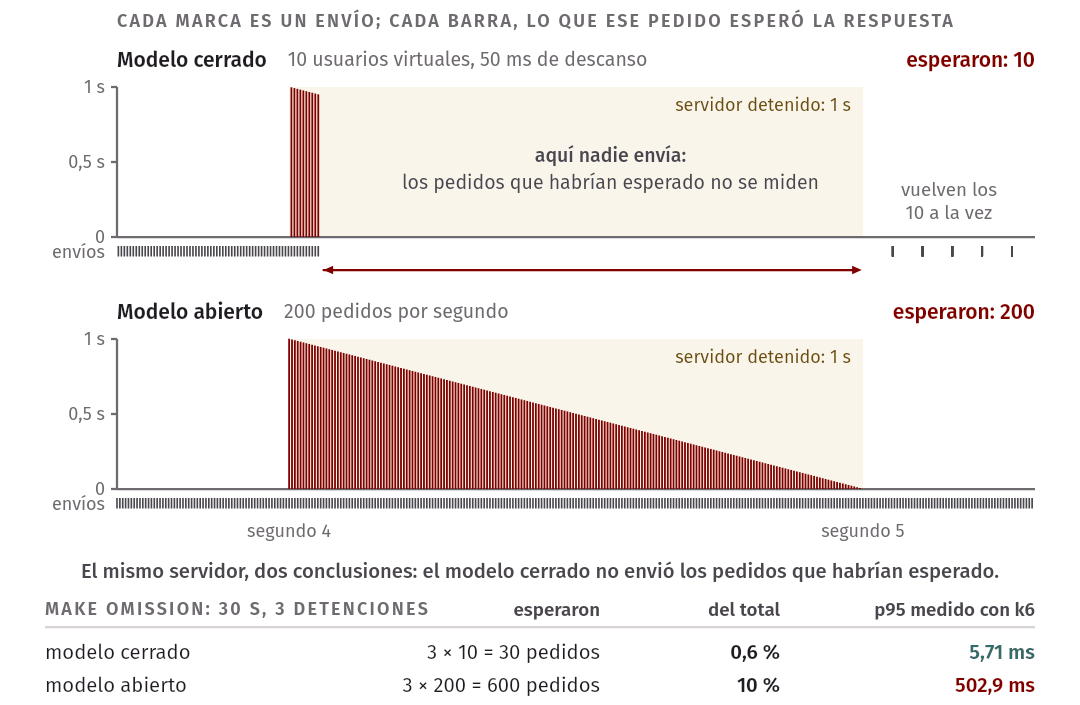
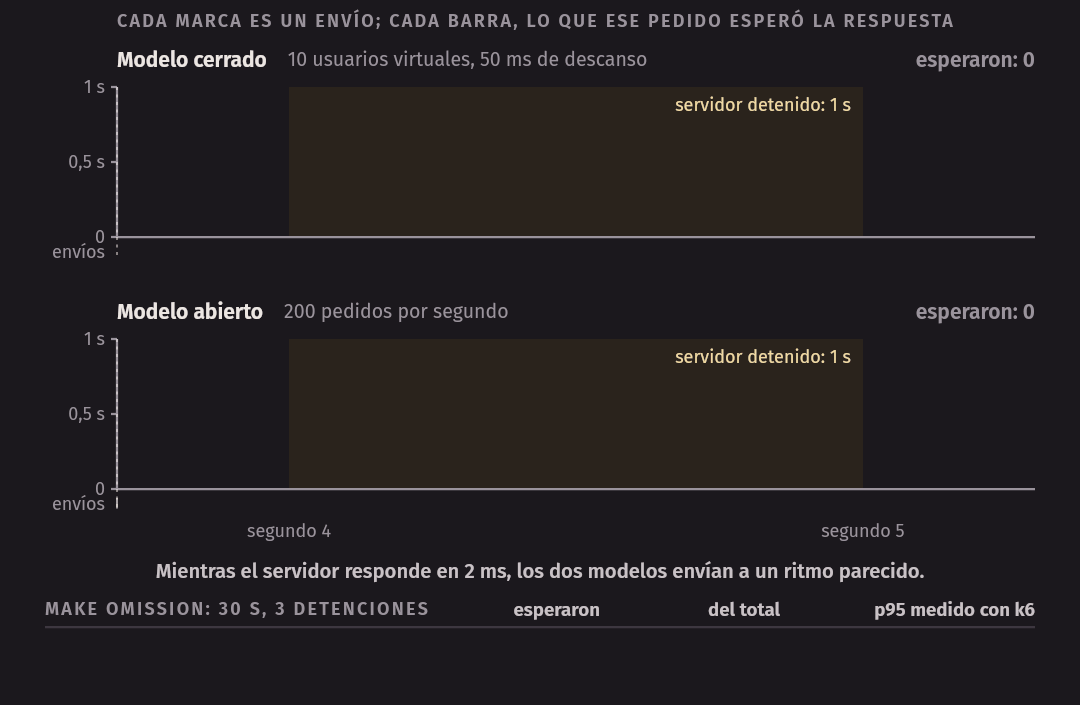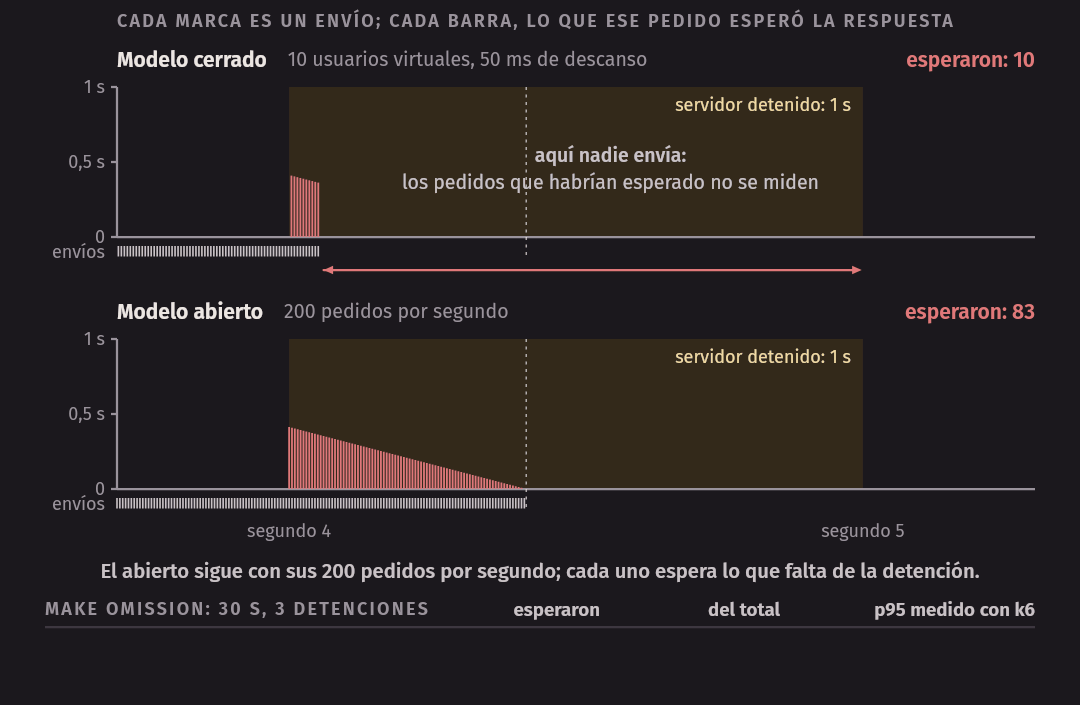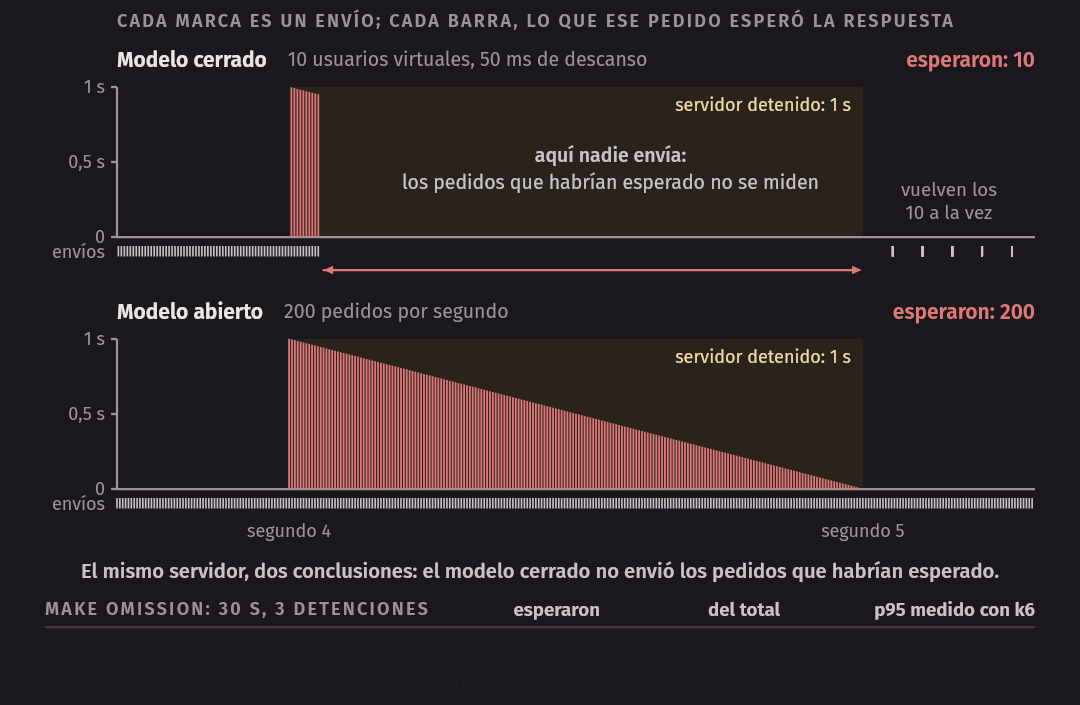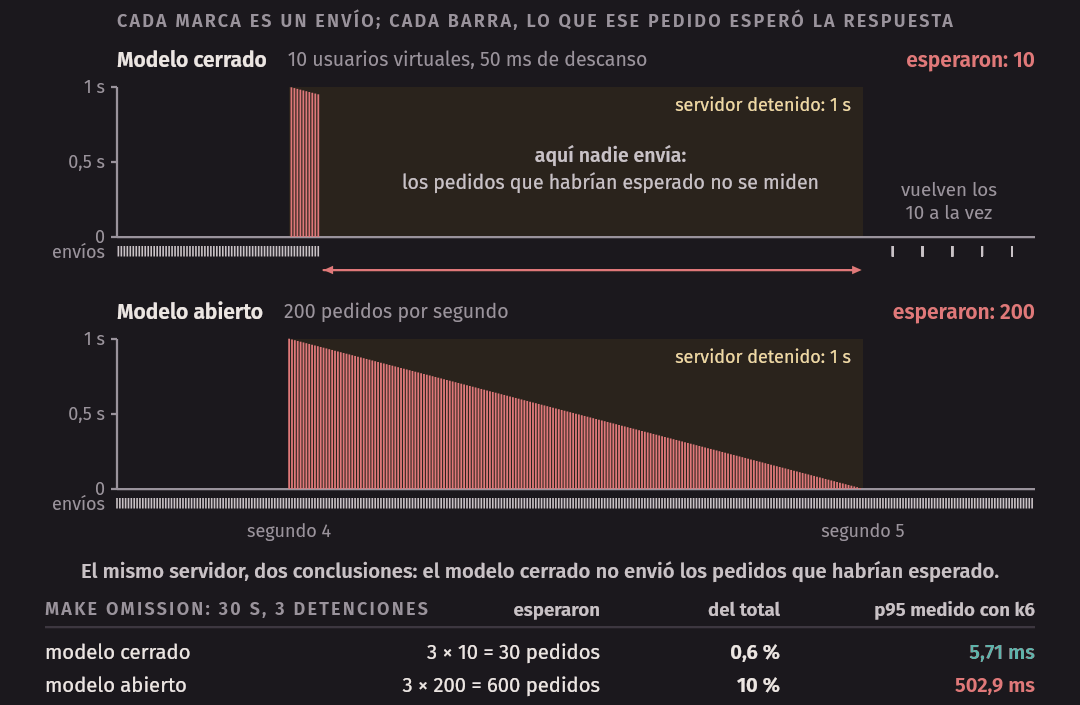
Fíjense también en la fila de pedidos. El modelo cerrado hizo menos (4 811 contra 6 002), y parte de los que faltan son exactamente los que omitió.
Idea clave. En el modelo cerrado, un servidor lento frena al generador de carga, y el generador deja de medir justo cuando había algo que medir. Un servidor detenido el 10 % del tiempo aparece con el 0,6 % de pedidos lentos. Los percentiles que salen de ahí no describen lo que viviría gente que llega sin saber cómo está el servidor.
En la industria. La documentación de k6 describe los dos modelos en Open and closed models y nombra el problema: en el modelo cerrado, el tiempo de respuesta del sistema influye sobre la carga que la prueba genera, y eso es lo que parte de la literatura de pruebas llama coordinated omission. Para simular un ritmo de llegadas, recomienda los ejecutores de tasa de llegada.
¿Cuál de los dos modelos es el correcto? Depende de a quién representa la carga.
- El modelo abierto representa a gente que llega por su cuenta: compradores en internet que no saben, ni les importa, si el servidor está ocupado. La apertura de una venta es eso.
- El modelo cerrado representa a una población fija que de verdad espera: 10 cajeros de una boletería que atienden a una persona a la vez, o 4 procesos que consumen una cola. Si el sistema se pone lento, ellos también, y la carga baja de verdad.
Trade-off. El modelo abierto mide bien la cola y cuesta más de usar. Hay que elegir la tasa de llegada, que es un dato que debe salir del escenario; hay que reservar suficientes usuarios virtuales; y si el sistema no da abasto, los pedidos se acumulan sin límite, que es lo que pasaría en la realidad, pero puede dejar la laptop sin memoria. El modelo cerrado es más simple y se regula solo, y paga con percentiles optimistas cuando el sistema se detiene. Los scripts de Tinkuy usan el modelo cerrado: sirven para comparar dos diseños, y hay que saber que, si uno de los dos se detiene de a ratos, la prueba lo va a disimular.
El modelo abierto de k6 tiene su propia forma de caer en el mismo error. Cada
pedido necesita un usuario virtual libre que lo envíe, y si no hay, el pedido
no sale. El script reserva 400 (preAllocatedVUs). Con solo 20, el resultado
es este (PRE_VUS=20 k6 run --quiet load/open-model.js, con el servidor
corriendo):
time="2026-11-16T05:56:39Z" level=warning msg="Insufficient VUs, reached 20 active VUs and cannot initialize more" executor=constant-arrival-rate scenario=open


  █ THRESHOLDS

    http_req_duration
    ✓ 'p(95)<300' p(95)=4.05ms


  █ TOTAL RESULTS

    HTTP
    http_req_duration..............: avg=13.77ms med=3.31ms p(90)=3.68ms p(95)=4.05ms p(99)=915.04ms max=1s
      { expected_response:true }...: avg=13.77ms med=3.31ms p(90)=3.68ms p(95)=4.05ms p(99)=915.04ms max=1s
    http_req_failed................: 0.00%  0 out of 5458
    http_reqs......................: 5458   181.872564/s

    EXECUTION
    dropped_iterations.............: 544    18.127276/s
El umbral vuelve a cumplirse y el p95 vuelve a ser de 4 ms. Durante cada
detención, los 20 usuarios virtuales quedaron ocupados y k6 no pudo enviar
los demás pedidos: los descartó. Esta vez, al menos, lo dice: 544
dropped_iterations y una advertencia al inicio. Un resumen con
dropped_iterations distinto de cero no midió la carga que dice haber
generado.
La omisión coordinada en una simulación
Los números de k6 dependen de la máquina. La causa del efecto no, y se puede aislar sin red ni reloj. omission/simulate.ts simula los dos generadores en tiempo virtual contra el mismo modelo de servidor (2 ms de servicio, 1 s detenido cada 10 s). El modelo cerrado es un ciclo por usuario en el que el instante del siguiente envío depende de la respuesta anterior:
while (now < durationMs) {
  const latency = responseTime(server, now);
  latencies.push(latency);
  now += latency + thinkMs; // no envía el siguiente hasta recibir este
}
El abierto calcula cada instante de envío sin mirar ninguna respuesta:
for (let i = 0; i < total; i++) {
  latencies.push(responseTime(server, (i * 1000) / ratePerSecond));
}
Esa es toda la diferencia. make simulate:
Servidor: 2 ms por pedido; detenido 1 s de cada 10 s. Simulación de 30 s.
modelo       pedidos  promedio       p50       p95       p99       máx  > 100 ms
cerrado         5220       7.5         2         2         2       998        30
abierto         6000      52.3         2       502       902      1002       543
Los percentiles (por rango más cercano) coinciden con lo que midió k6: p95 de 2 ms contra 502 ms. Las pruebas de omission/simulate.test.ts fijan los números que sostienen el argumento: el modelo cerrado ve exactamente 30 pedidos lentos (3 detenciones por 10 usuarios), en el abierto esperan exactamente 600 (3 detenciones por 200 pedidos por segundo), y la fracción de pedidos lentos del modelo cerrado queda por debajo del 1 % con un servidor detenido el 10 % del tiempo.
Umbrales: la medida convertida en prueba
En las salidas anteriores apareció una sección nueva, THRESHOLDS. Un
umbral (threshold) de k6 es una condición sobre una métrica que se evalúa
al terminar la prueba. Los dos scripts de la demostración tienen el mismo:
export const options = {
  // ...
  thresholds: { http_req_duration: ['p(95)<300'] },
};
Si la condición no se cumple, k6 lo marca con ✗ y termina con un código de
salida distinto de cero (99, como se vio arriba). Con eso, la prueba de
carga se comporta como cualquier otra prueba: un make o un pipeline que la
ejecute falla cuando el sistema no cumple.
Un umbral es la medida de un escenario escrita de forma que una máquina la compruebe. El escenario de la lista de asientos dice “latencia p95 menor que 300 ms y menos de 0,1 % de errores”. En k6:
thresholds: {
  'http_req_duration{name:GET /events/:id/seats}': ['p(95)<300'],
  'http_req_failed{name:GET /events/:id/seats}': ['rate<0.001'],
},
El filtro por etiqueta hace que el umbral juzgue solo al endpoint del escenario, y no a la mezcla. Las expresiones que acepta un umbral están en la documentación de k6 sobre Thresholds.
La demostración de la omisión coordinada deja una advertencia sobre los umbrales: el mismo servidor pasó el umbral con el modelo cerrado y lo incumplió con el abierto. Un umbral vale lo que vale la carga con que se evalúa. Si el estímulo del escenario es gente que llega a un ritmo, el script que lo comprueba tiene que generar ese ritmo.
Error común. Fijar el umbral después de medir. “Salió 420 ms, entonces el requisito es 500.” Así el escenario siempre se cumple, y no dice nada: describe lo que el sistema ya hace, no lo que alguien necesita. El umbral sale del stakeholder: de cuánto espera un comprador antes de irse, de lo que el organizador firmó, de lo que ofrece la competencia. Si no hay de dónde sacarlo, eso es lo que hay que averiguar, y mientras tanto se escribe como supuesto, a la vista. Medir primero sí sirve para otra cosa: para saber qué tan lejos está el sistema del umbral.
Error común. Medir en una laptop y presentar el número como una propiedad del sistema. “Tinkuy responde la lista de eventos en 85 ms” es falso en general: lo hizo en esa laptop, con esos datos, con esa carga y con k6 compitiendo por el procesador. Lo que se traslada a otra máquina es la comparación entre dos mediciones hechas en las mismas condiciones: “la lista de eventos tarda entre seis y diez veces más que los otros endpoints”, o “con el diseño B el p95 bajó a la cuarta parte”.
Disponibilidad
La fracción del tiempo en que el sistema responde bien
La disponibilidad (availability) de un sistema es la fracción del tiempo en que responde bien:
Si en un mes de 30 días (43 200 minutos) el sistema estuvo caído 43 minutos, su disponibilidad fue de .
La definición tiene dos puntos que hay que fijar en cada escenario, porque cambian el número:
- Qué cuenta como “responde bien”. Un servidor que acepta la conexión y
contesta con un error 500 está encendido y no está disponible. Uno que
responde bien en 40 segundos, para un comprador que ya se fue, tampoco.
Por eso muchos equipos miden la disponibilidad sobre pedidos y no sobre
tiempo: la fracción de los pedidos válidos que recibió una respuesta
correcta dentro de un plazo. Con esa definición, el
http_req_failedde k6 es una medida de disponibilidad durante la prueba. - Sobre qué ventana. 99,9 % medido por año permite una caída de varias horas seguidas; medido por día, no.
Con la definición sobre pedidos, la corrida de make load-sale que vimos
tuvo 100 pedidos fallidos de 5 770: durante esos 30 segundos, la compra en
Tinkuy estuvo disponible para el 98,27 % de los pedidos. Los 100 errores son
los del mensaje too many clients already, y en el log del servidor están
todos juntos al principio, cuando los 200 compradores llegan a la vez.
Los nueves
La disponibilidad se suele decir en “nueves”. make nines calcula cuánto
tiempo caído permite cada nivel (año de 365 días, mes de 30):
nueves  disponibilidad  caído al año   caído al mes
1       90 %            36.50 días     4320.0 min
2       99 %            3.65 días      432.0 min
3       99.9 %          8.76 h         43.2 min
4       99.99 %         52.56 min      4.3 min
5       99.999 %        5.26 min       0.4 min
La cuenta es horas. Tres nueves permiten unas 8,8 horas de caída al año; cuatro nueves, unos 53 minutos.
Cada nueve divide entre diez el tiempo permitido, y cambia de naturaleza lo que hay que hacer para cumplirlo. Con 8,8 horas al año, una persona puede recibir una alerta, despertarse, conectarse y arreglar un problema un par de veces. Con 53 minutos al año no: un solo incidente atendido a mano se lleva el presupuesto entero, así que la detección y la recuperación tienen que ser automáticas, y hace falta redundancia. Con 5 minutos al año, ni siquiera un reinicio lento cabe.
Trade-off. Un nueve más cuesta máquinas duplicadas, automatización, guardias y un diseño más complejo, que a su vez tiene más cosas que pueden fallar. Y lo que se gana puede no notarse: si el celular y la red del comprador están disponibles el 99 % del tiempo, llevar el servidor de 99,99 % a 99,999 % no cambia lo que el comprador ve. El nivel de disponibilidad es una decisión de negocio con un costo, no una virtud: se elige el que el negocio necesita y puede pagar.
En serie se multiplican
Casi ninguna operación depende de una sola pieza. Si una operación necesita que todas sus partes respondan, las partes están en serie, y la disponibilidad de la operación es el producto de las de sus partes.
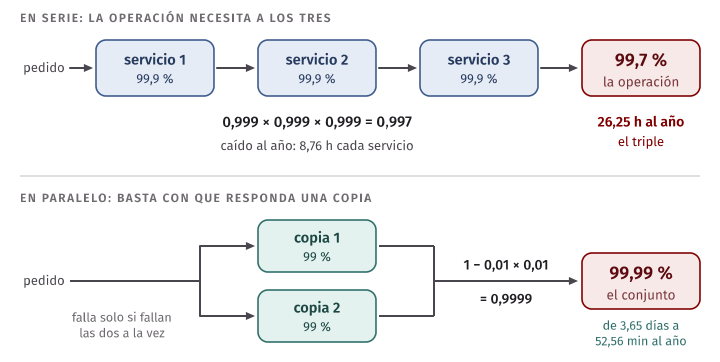
Un sistema que necesita tres servicios, cada uno con 99,9 %:
node calc.ts series 99.9 99.9 99.9En serie: 99.7003 %
caído al año: 26.25 h
caído al mes: 129.5 min. Tres piezas de tres nueves dan un sistema de 99,7 %: el tiempo caído se triplicó, de 8,76 a 26,25 horas al año.
Dos consecuencias:
- El conjunto siempre es peor que su peor parte. Un sistema que depende de un servicio de 99 % no puede pasar de 99 %, por bueno que sea lo demás.
- Cada dependencia que se agrega en el camino de una operación le resta disponibilidad. Agregar un servicio no es gratis aunque el servicio sea bueno.
La segunda consecuencia sugiere una pregunta de diseño que vale más que cualquier fórmula: de todo lo que una operación usa, ¿qué necesita de verdad para completarse? Lo que deja de ser necesario sale del producto.
Multiplicar supone algo: que las partes fallan de forma independiente. Si dos servicios corren en la misma máquina y se caen juntos, sus caídas se superponen y el conjunto es algo mejor que el producto. El supuesto pesa mucho más en el caso contrario, el de la redundancia, que viene enseguida.
En Tinkuy. Una compra en la versión 0 necesita, en serie, al proceso de Tinkuy, a PostgreSQL, a la pasarela de pagos y al servidor de correo:
createOrderenvía el correo de confirmación antes de confirmar la transacción, y si el envío falla, la compra falla. En el paso 7 del laboratorio van a calcular cuánto le cuesta eso a la disponibilidad de comprar.
En paralelo: la redundancia
Si para completar la operación basta con que responda una de varias copias, las copias están en paralelo. El conjunto falla solo cuando fallan todas a la vez: la disponibilidad es para copias de disponibilidad .
node calc.ts parallel 99 99En paralelo: 99.9900 %
caído al año: 52.56 min
caído al mes: 4.3 minDos copias de 99 % dan 99,99 %: de 3,65 días al año a 53 minutos. Es el argumento a favor de toda réplica.
Aquí el supuesto de independencia es todo el argumento. La fórmula vale si la caída de una copia no tiene que ver con la de la otra. Dos copias en la misma máquina, con la misma versión del mismo programa y la misma configuración, tienden a fallar juntas, por la misma causa, y entonces la segunda copia aporta mucho menos de lo que dice la cuenta. Además, la fórmula ignora la pieza que decide a qué copia mandar cada pedido y que detecta cuál está caída: esa pieza está en serie con todo lo demás. La replicación y el failover son temas de la semana 10.
MTBF y MTTR
La disponibilidad también se puede escribir con dos tiempos promedio:
- MTBF (mean time between failures): cuánto funciona el sistema, en promedio, entre una falla y la siguiente.
- MTTR (mean time to repair): cuánto tarda, en promedio, en volver a estar en servicio después de una falla. Incluye el tiempo que pasa hasta que alguien, o algo, detecta la falla.
(Algunos textos llaman MTTF, mean time to failure, al tiempo en funcionamiento y reservan MTBF para el ciclo completo; la fórmula es la misma: tiempo en servicio sobre tiempo total.)
Un servicio que falla en promedio una vez cada 30 días y tarda 43 minutos en volver tiene 99,9 %. La fórmula muestra que hay dos formas de mejorar:
| Cambio | MTBF | MTTR | Disponibilidad |
|---|---|---|---|
| Punto de partida | 30 días | 43,2 min | 99,90 % |
| Fallar la mitad de veces | 60 días | 43,2 min | 99,95 % |
| Recuperarse en la mitad del tiempo | 30 días | 21,6 min | 99,95 % |
Las dos llevan al mismo número (hay una prueba en stats.test.ts que lo
comprueba), y no cuestan lo mismo. Fallar menos significa encontrar y quitar
causas de falla, que son muchas y cada vez más raras. Recuperarse más rápido
significa detectar antes, reiniciar solo, poder volver a la versión
anterior con un comando. Cuál conviene depende del sistema; lo que la
fórmula deja claro es que la segunda vía existe, y muchas veces es la más
barata. Las tácticas de disponibilidad de la semana 6 se ordenan justamente
así: detectar fallas, recuperarse de ellas y prevenirlas.
La disponibilidad no lo dice todo. Un sistema que se cae una vez al año durante 8 horas y otro que se cae 500 veces al año durante un minuto tienen casi los mismos tres nueves, y para quien vende entradas no son el mismo sistema: uno pierde la apertura de una venta completa, el otro molesta a algunos compradores cada día. Un escenario de disponibilidad dice, además del porcentaje, cuánto puede durar una caída.
SLI, SLO y SLA
Cuando un escenario de calidad pasa de la etapa de diseño a un sistema en producción, cambia de nombre. Tres siglas, por ahora solo como vocabulario:
- SLI (service level indicator): el indicador que se mide. Por ejemplo, la fracción de las compras que respondió bien en menos de un segundo.
- SLO (service level objective): el objetivo que el equipo se fija sobre ese indicador, en una ventana. Por ejemplo, 99,5 % de las compras, medido cada 30 días.
- SLA (service level agreement): un contrato con quien usa el servicio, que incluye consecuencias si no se cumple: una devolución, una penalidad.
La forma de distinguir un SLO de un SLA es preguntar qué pasa si no se cumple. Si hay una consecuencia pactada, es un SLA. Por eso el SLO interno suele ser más exigente que el SLA: el equipo quiere enterarse antes de tener que pagar.
Un SLO es, en el fondo, un escenario de calidad que se vigila todo el tiempo: el estímulo es el tráfico real, el entorno es producción y la medida es el objetivo. Lo retomamos en la semana 14, con el concepto que lo vuelve útil para decidir: el error budget.
En la industria. El capítulo 4 del libro de SRE cuenta el caso de Chubby, el servicio de locks de Google. Su instancia global fallaba tan pocas veces que otros equipos empezaron a depender de ella como si no pudiera caerse, y cuando por fin se caía, sus servicios no sabían qué hacer. La respuesta fue asegurarse de que Chubby cumpliera su objetivo sin excederlo por mucho: si en un trimestre no había tenido una falla real que bajara su disponibilidad hasta el objetivo, el equipo provocaba una caída controlada. Un objetivo de disponibilidad es también una promesa hacia abajo: le dice a quien depende del servicio para cuánta falla tiene que estar preparado. Fuente: Service Level Objectives, recuadro The Global Chubby Planned Outage.
Priorizar: el utility tree
De muchos escenarios a los que definen la arquitectura
Con la técnica de la Sesión A, un equipo con buenos stakeholders junta veinte o treinta escenarios en una tarde. No se puede diseñar para todos a la vez, y no todos merecen el mismo esfuerzo. Hace falta ordenarlos.
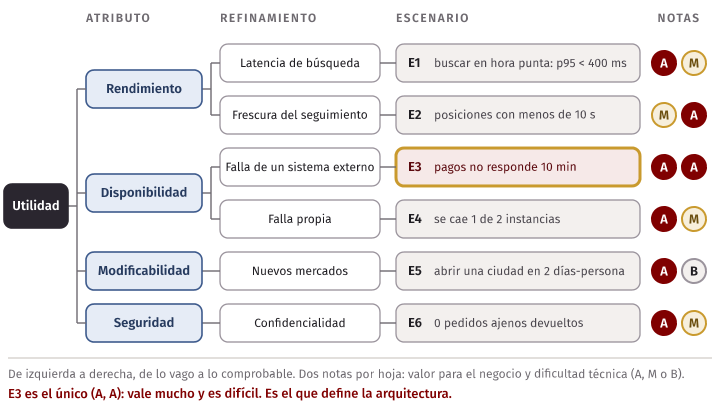
El utility tree es la herramienta de Software Architecture in Practice para eso. Es un árbol de cuatro niveles:
- La raíz es “utilidad”: qué tan bueno es el sistema en conjunto.
- Debajo, los atributos de calidad que importan en este sistema.
- Debajo de cada atributo, sus refinamientos: de qué aspecto del atributo se trata. Rendimiento se refina en “latencia de búsqueda” y “frescura del seguimiento”; disponibilidad, en “falla de un sistema externo” y “falla propia”.
- En las hojas, los escenarios, concretos y con sus seis partes.
El árbol va de lo vago a lo comprobable: arriba están las palabras que cada uno entiende a su manera y abajo, los números.
Cada hoja lleva dos notas, cada una Alta (A), Media (M) o Baja (B):
- Valor para el negocio: cuánto pierde el negocio si el escenario no se cumple. La ponen quienes conocen el negocio.
- Dificultad o riesgo técnico: cuánto cuesta cumplirlo, con lo que el equipo sabe y con el diseño que tiene. La pone el equipo técnico.
Que las dos notas las pongan personas distintas es parte de la técnica. El equipo técnico tiende a encontrar importante lo que le parece difícil, y el negocio tiende a creer que todo lo importante es fácil. Dos notas separadas obligan a decir las dos cosas.
Un ejemplo: Qhatu
El utility tree de Tinkuy es trabajo suyo: es el último paso del laboratorio y parte de P0. Para mostrar la técnica usamos otro sistema.
Qhatu (mercado, en quechua) es una aplicación para pedir abarrotes a las bodegas del barrio, con reparto en moto. La usan compradores, bodegas y repartidores, y cobra con tarjeta a través de un procesador de pagos externo o contra entrega. Sus seis escenarios están completos en scenarios/qhatu.md, y el árbol en utility-tree-example.md:
| Atributo | Refinamiento | Escenario (resumen) | Negocio | Técnica |
|---|---|---|---|---|
| Rendimiento | Latencia de búsqueda | E1. 2 000 compradores buscan en hora punta: p95 < 400 ms, errores < 0,5 % | A | M |
| Rendimiento | Frescura del seguimiento | E2. 3 000 repartidores reportan cada 5 s: el 99 % de las posiciones se ve con menos de 10 s de antigüedad | M | A |
| Disponibilidad | Falla de un sistema externo | E3. El procesador de pagos no responde 10 min: toda respuesta en 5 s o menos, 0 pedidos perdidos | A | A |
| Disponibilidad | Falla propia | E4. Se cae 1 de 2 instancias: errores < 0,5 % en 60 s o menos, 0 pedidos perdidos | A | M |
| Modificabilidad | Nuevos mercados | E5. Abrir una ciudad: 2 días-persona o menos, 1 módulo, sin interrumpir el servicio | A | B |
| Seguridad | Confidencialidad | E6. Un comprador pide pedidos ajenos 1 000 veces: 0 devueltos, alerta en 5 min o menos | A | M |
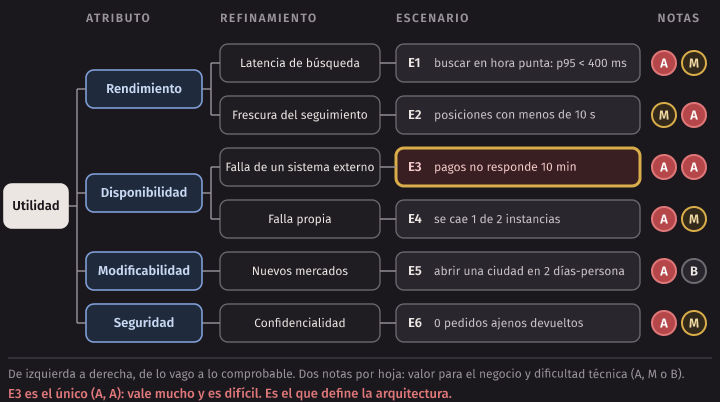
El escenario E3, completo, para ver que la hoja no es el resumen:
## E3. El procesador de pagos deja de responder

- **Atributo de calidad:** disponibilidad
- **Fuente del estímulo:** el procesador de pagos con tarjeta, un sistema externo
- **Estímulo:** deja de responder durante 10 minutos
- **Artefacto:** el flujo de confirmación de un pedido
- **Entorno:** hora punta, con unos 40 pedidos por minuto
- **Respuesta:** el sistema avisa al comprador que la tarjeta no está disponible y le ofrece pagar contra entrega; los pedidos pagados contra entrega siguen su curso
- **Medida de la respuesta:** el 100 % de los intentos de pago recibe una respuesta en 5 segundos o menos, y se pierden 0 pedidos ya confirmados
Cómo se lee
Las notas ordenan el trabajo:
- (A, A): E3. Vale mucho y es difícil. Estos son los escenarios que definen la arquitectura. E3 obliga a decidir cómo habla Qhatu con el procesador de pagos: cuánto lo espera, qué le dice al comprador mientras tanto, qué pasa con un pedido que quedó a medio confirmar. Esa decisión atraviesa el flujo central del sistema y es cara de cambiar después. Si el árbol tiene un solo (A, A), ahí va la primera semana de diseño.
- (A, M): E1, E4 y E6. Valen mucho y el equipo sabe cómo cumplirlos. Hay que diseñarlos y comprobarlos, y no deberían dar sorpresas.
- (M, A): E2. Es difícil y vale menos. Antes de pagarlo, conviene volver al negocio con una pregunta: ¿aceptarían 30 segundos de antigüedad en vez de 10? Los escenarios caros de valor medio son los primeros candidatos a negociar la medida.
- (A, B): E5. Vale mucho y es fácil. Se hace, y no condiciona el resto. Un escenario fácil puede dejar de serlo si una decisión tomada para otro lo complica: por eso se queda en el árbol.
- Los (B, …) casi siempre se dejan para después, y los (B, A) son una señal de alarma si alguien ya los está construyendo.
Tres advertencias sobre la técnica.
Las notas son de un momento y de un equipo. Si Qhatu firma con un segundo procesador de pagos, E3 baja de dificultad. Si el negocio decide competir por la precisión del seguimiento, E2 sube de valor. El árbol se revisa cuando cambia el negocio o cambia el diseño.
La dificultad depende del diseño que se tiene. E4 es de dificultad media porque el ejemplo supone que Qhatu ya corre con dos instancias. Para un sistema que guarda estado en la memoria de un solo proceso, el mismo escenario sería (A, A).
Si todo sale (A, A), el árbol no priorizó nada. Es el resultado más común la primera vez, porque a nadie le gusta decir que algo suyo vale “medio”. La salida es forzar el orden: de estos seis, ¿cuáles dos elegirían si solo pudieran cumplir dos?
Idea clave. El utility tree convierte “qué atributos importan” en una lista corta de escenarios con número, ordenada por lo que valen y lo que cuestan. Los (A, A) son los requisitos significativos para la arquitectura que la semana pasada buscábamos a ojo.
Trade-offs
Mejorar un atributo suele costar otro
Si los atributos de calidad fueran independientes, diseñar sería sumar: una táctica para cada escenario y listo. No lo son. Casi toda decisión que mejora la medida de un escenario empeora la de otro. Tres ejemplos que van a volver durante el semestre:
| Decisión | Mejora | Cuesta |
|---|---|---|
| Guardar en una cache la respuesta de una consulta | La latencia de las lecturas, y la carga sobre la base de datos | Consistencia: durante un rato, la cache responde con un dato que ya cambió. Y complejidad: hay que decidir cuándo se borra |
| Agregar una réplica de la base de datos | Disponibilidad (si una cae, queda la otra) y capacidad de lectura | Dinero y operación: otra máquina que pagar, vigilar y actualizar. Y la réplica puede ir atrasada respecto del principal |
| Cifrar, autenticar y autorizar cada pedido | Seguridad | Latencia (cada paso tarda), y fricción para quien usa y para quien desarrolla |
Un trade-off es eso: una decisión en la que ganar en un atributo se paga en otro. La palabra importa porque cambia la pregunta. Ya no es “¿es buena idea una cache?”, que no tiene respuesta, sino “¿cuánta latencia gano, cuánta consistencia pierdo, y a este sistema cuál de las dos le duele más?”.
Fíjense en que el ejemplo de la cache no se puede evaluar sin escenarios. “Durante un rato responde con un dato que ya cambió” es aceptable o inaceptable según el dato. En Qhatu, mostrar un precio de hace 30 segundos casi nunca importa. Mostrar como libre un asiento que se vendió hace 30 segundos es otra cosa: produce un comprador que elige, paga y recibe un rechazo. La misma táctica, con el mismo costo técnico, es buena en un escenario y mala en otro.
Idea clave. Decidir en arquitectura no es encontrar la opción sin costos, porque no existe. Es elegir qué se sacrifica, para este sistema, y escribirlo. Una decisión que no dice qué cuesta todavía no se analizó.
Los trade-offs que Tinkuy ya tomó
La versión 0 de Tinkuy también está llena de trade-offs, aunque nadie los haya escrito. Tres, vistos en el código:
- Una conexión nueva a PostgreSQL por cada consulta suelta y por cada
transacción (
src/db.ts). Gana simplicidad: no hay estado compartido ni nada que configurar o que se pueda agotar dentro del proceso. Cuesta latencia en cada consulta y un límite duro: con 200 compradores a la vez, PostgreSQL rechazó conexiones. - El cobro y el correo dentro de la transacción de la compra
(
src/orders/create-order.ts). Gana un razonamiento simple: todo lo de una compra se confirma o se deshace junto en la base de datos. Cuesta latencia (el comprador espera a la pasarela y al correo) y disponibilidad (la compra necesita que los dos respondan). - Un solo proceso con una sola base de datos. Gana facilidad para desarrollar, probar y desplegar: se levanta con dos comandos. Cuesta que todo falle junto y que todo escale junto.
Ninguna de las tres es un error en sí misma. Para un sistema con diez ventas al día, las tres son defendibles, y cambiarlas costaría más de lo que devuelve. Que sean un problema depende de los escenarios que lleguen, y durante el semestre van a llegar.
Cómo se escribe un trade-off
Una forma que sirve, y que en la semana 7 se convierte en el formato de un ADR:
Para cumplir [escenario], elegimos [decisión] en vez de [alternativa]. Ganamos [medida que mejora]. Aceptamos [medida que empeora, en qué escenario].
Con Qhatu y el escenario E3:
Para cumplir E3 (el procesador de pagos no responde durante 10 minutos), elegimos esperar al procesador 3 segundos como máximo y ofrecer pago contra entrega, en vez de esperar hasta que responda. Ganamos que todo intento de pago recibe respuesta en 5 segundos o menos. Aceptamos que, en un día normal, algunos pagos que habrían terminado bien en 4 segundos se den por fallidos, y que el pago contra entrega tiene más pedidos sin cobrar.
La frase tiene las cuatro cosas que pide la regla de trabajo del curso: el escenario, la decisión, la alternativa y el costo. Y deja ver el número que alguien tendrá que defender: ¿por qué 3 segundos?
Trade-off. Escribir cada decisión con su costo también tiene un costo: tiempo, y documentos que hay que mantener. La alternativa es decidir en una conversación y confiar en la memoria del equipo, que es más rápido y funciona mientras el equipo es chico y no cambia. Se justifica escribir cuando la decisión es cara de deshacer o cuando quien la va a sufrir todavía no está en el equipo. Con qué criterio se elige qué decisiones merecen un documento es tema de la semana 7.
El código de la semana
Todo está en code/week-02 y se usa dentro del contenedor del curso.
| Archivo | Qué es |
|---|---|
scenario-template.md |
El template de un escenario de seis partes |
scenario-check.ts |
El revisor: seis partes y una medida con número |
scenarios/tinkuy-seat-list.md |
El escenario de Tinkuy de la clase |
scenarios/qhatu.md, utility-tree-example.md |
Los seis escenarios de Qhatu y su utility tree |
errors/vague-scenarios.md |
Tres escenarios mal escritos a propósito |
stats.ts, calc.ts |
Percentiles por rango más cercano, promedio y disponibilidad; calc.ts es la calculadora de línea de comandos |
data/latencies.txt |
Las 98 respuestas de 50 ms y 2 de 5 s |
load/by-endpoint.js |
k6 contra Tinkuy, con las métricas separadas por endpoint |
load/percentiles.js |
Cómo calcula k6 un percentil, sin hacer pedidos |
omission/stall-server.ts, load/closed-model.js, load/open-model.js |
La omisión coordinada medida con k6 |
omission/simulate.ts |
La omisión coordinada en una simulación |
*.test.ts |
Las pruebas de lo que afirma este capítulo |
Los objetivos del Makefile:
make             # copia Tinkuy en build/tinkuy, para medirlo sin tocar tinkuy/
make test        # revisa los tipos y corre las pruebas
make scenarios   # el revisor sobre los escenarios de ejemplo
make errors      # el revisor sobre errors/ (falla a propósito)
make nines       # la tabla de nueves
make simulate    # la omisión coordinada en una simulación
make omission    # la omisión coordinada con k6 (unos 65 segundos)
make tinkuy-up   # crea la base de datos y levanta Tinkuy v0 y su pasarela en segundo plano
make endpoints   # k6 contra Tinkuy, con métricas por endpoint (20 segundos)
make tinkuy-down # detiene Tinkuy y la pasarela
make clean       # borra build/
make tinkuy-up es un atajo para no ocupar tres terminales: copia Tinkuy en
build/tinkuy, crea la base de datos y deja el servidor y la pasarela
corriendo en segundo plano, con sus logs en build/tinkuy.log y
build/gateway.log. Es el mismo Tinkuy v0, sin ningún cambio. Si ya lo
tienen levantado desde tinkuy/ con make start, no hace falta: make endpoints mide lo que haya en http://localhost:3000.
make test revisa los tipos con tsc y corre las 29 pruebas. No necesita
Tinkuy ni la base de datos, y termina en menos de un segundo:
tsc -p .
node --test "*.test.ts" "omission/*.test.ts"
✔ el servidor se detiene 1 s de cada 10 s (0.537916ms)
✔ los dos modelos envían una carga parecida mientras el servidor responde (1.636875ms)
✔ modelo cerrado: en cada detención queda atrapado un pedido por usuario, y nada más (0.56525ms)
✔ modelo abierto: todo lo que debía salir durante la detención sale, y espera (0.26725ms)
✔ el mismo servidor, dos conclusiones: el p95 y el p99 del modelo cerrado no ven la detención (1.821583ms)
✔ la fracción de pedidos lentos del modelo cerrado no se parece a la fracción de tiempo detenido (0.349625ms)
y, al final:
ℹ tests 29
ℹ suites 0
ℹ pass 29
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 258.110958
Las pruebas están escritas para leerse como la lista de afirmaciones del
capítulo: 98 respuestas de 50 ms y 2 de 5 s: el promedio es 149 ms y no describe a nadie, los percentiles no se promedian entre máquinas, en serie se multiplican: tres servicios de 99,9 % quedan en 99,7 %. Si alguna
cuenta de estos apuntes les parece dudosa, la prueba correspondiente es el
lugar para comprobarla o para cambiar los datos y ver qué pasa.
Las pruebas de carga no forman parte de make test: tardan, y sus números
dependen de la máquina. Se corren con sus propios objetivos.
Laboratorio: escribir escenarios para Tinkuy y medirlos con k6
El laboratorio es en parejas y tiene ocho pasos. Lo que produzcan es la segunda parte de P0: tres escenarios de calidad medidos con k6. Aquí va qué muestra cada paso y en qué fijarse; las respuestas son suyas.
Paso 1: de candidatos a escenarios. Tomen los tres candidatos a ASR que
escribieron la semana pasada y reescriban cada uno con el template. Pásenlos
por node scenario-check.ts. Después intercambien con otra pareja y háganse
la pregunta que el revisor no puede hacer: ¿podrían comprobar la medida sin
preguntarles nada a los autores? Las dudas típicas que salen en el
intercambio: sobre qué pedidos se calcula el percentil, durante cuánto
tiempo se sostiene la carga, y qué datos hay cargados. Cada duda es una parte
del escenario que estaba incompleta.
Paso 2: la primera medición. Levanten Tinkuy (make db, make gateway,
make start) y corran make load-browse. Lean en el resumen
http_req_duration (p50, que k6 llama med, y p95), http_reqs y
http_req_failed, como en Medir Tinkuy con k6. Anoten los números y la
máquina: modelo, procesador, memoria asignada a Docker. Un número sin
máquina no se puede comparar con nada.
Paso 3: cuánto varía. Repitan la corrida tres veces y armen su propia tabla, como la de Cuánto varía una medición. Comparen cuánto se mueve el p95 y cuánto el promedio. Con eso, decidan una regla para el resto del semestre: cuántas corridas van a hacer antes de afirmar que un cambio mejoró algo, y qué diferencia mínima van a exigir. Escríbanla: la van a necesitar en cada entrega.
Paso 4: el endpoint lento. Corran make endpoints en code/week-02/.
Identifiquen el endpoint más lento y expliquen por qué, leyendo su código en
Tinkuy: empiecen por el handler en src/http/ y sigan las llamadas. Una
pista sobre cómo leer: cuenten cuántas veces va a la base de datos para
armar una respuesta, y de qué depende esa cantidad. Todavía no lo arreglen;
lo que se pide es el diagnóstico.
Paso 5: la medida como prueba. Hagan una copia de load/browse.js de
Tinkuy y agréguenle un umbral que exprese uno de sus escenarios, con la
sintaxis de Umbrales: la medida convertida en prueba. Córranlo y miren el
código de salida (echo $?): k6 termina con un código distinto de cero si el
umbral no se cumple. Prueben también con un umbral que saben que no se va a
cumplir, para ver la falla. Ese umbral es la medida de su escenario,
convertida en algo que un make puede ejecutar.
Paso 6: la venta. Corran make load-sale y anoten latencia, throughput y
errores. Miren el log de Tinkuy para ver qué errores fueron. Después corran
make db y make oversell, que manda 50 órdenes a la vez para un mismo
asiento. En nuestra corrida, la salida fue:
Asiento 1 del evento 1 (fila A, número 1): 50 órdenes a la vez
  respuestas 201: 50
Órdenes aceptadas para el asiento 1: 50
Entradas emitidas para el asiento 1: 50
Para cada uno de los dos resultados, respondan: ¿qué atributo de calidad se
está incumpliendo? Van a notar que la respuesta no es obvia, sobre todo para
el segundo, y que es exactamente la discusión de Un hecho, muchos nombres.
No se queden en el nombre: escriban el escenario de seis partes que describe
cada problema, con una medida que hoy no se cumple. Una pregunta para
make load-sale: después de la corrida, ¿cuántas entradas se emitieron para
el evento 1 y para cuántos asientos distintos? Se responde con una consulta
en psql tinkuy sobre las tablas tickets y seats.
Paso 7: disponibilidad en serie. Calculen, con node calc.ts series o a
mano: si Tinkuy tiene 99,9 % de disponibilidad, la pasarela 99,5 % y el
servidor de correo 99 %, y una compra necesita a los tres, ¿cuál es la
disponibilidad de comprar? ¿Cuánto tiempo caído al mes significa? Después,
la pregunta de diseño: ¿qué cambia si el correo deja de ser necesario para
completar la compra? No tienen que implementar nada: solo rehacer la cuenta
y decir qué tendría que ser distinto en el flujo de la compra para que el
número nuevo sea verdad.
Paso 8: el utility tree de Tinkuy. Con sus escenarios, los de la otra
pareja y los que salieron de los pasos 4 y 6, armen el utility tree de
Tinkuy: al menos seis escenarios en tres atributos, cada uno con sus dos
notas, y marquen los (A, A). Usen el formato de utility-tree-example.md.
Para la nota de negocio, pónganse en el lugar de los stakeholders de la
semana 1 (el organizador de un concierto, quien atiende reclamos, quien
opera de madrugada). Para la nota técnica, usen lo que midieron hoy. Si les
salen más de dos o tres (A, A), vuelvan a discutir las notas.
Al terminar deberían tener: un archivo de escenarios que pasa el revisor, una tabla de mediciones con su máquina, una regla propia para comparar corridas, el diagnóstico del endpoint lento, un script de k6 con un umbral, y un utility tree. No hay entrega esta semana; todo esto entra en P0, que se entrega la semana 3.
Resumen
- Lo que se le pide a un sistema son requisitos funcionales (qué hace), atributos de calidad (qué tan bien lo hace) y restricciones (qué ya está decidido). La funcionalidad no determina la arquitectura; los atributos de calidad sí.
- Las palabras (“escalable”, “rápido”, “robusto”) no sirven como requisitos: cada persona las entiende distinto, y un mismo hecho puede llamarse de varias formas. En vez de discutir el nombre, se escribe un escenario.
- Un escenario de calidad tiene seis partes: fuente del estímulo, estímulo, artefacto, entorno, respuesta y medida de la respuesta. Sin medida no es un escenario, y sin entorno la medida no dice nada. El escenario general de un atributo es el menú de valores posibles; el concreto es el de un sistema, con números.
- Cada atributo tiene un estímulo típico: una falla (disponibilidad), eventos que llegan (rendimiento), un cambio (modificabilidad), un ataque (seguridad). Ninguna lista de atributos es completa. Una táctica es una decisión de diseño que influye sobre la respuesta a un estímulo.
- El tiempo de respuesta es una distribución. Se resume con percentiles (p50, p95, p99), que en el curso se calculan por rango más cercano: la medición en la posición . El promedio se deja arrastrar por pocos valores y mezcla poblaciones: con 98 respuestas de 50 ms y 2 de 5 s da 149 ms, que no describe a nadie.
- Los percentiles altos importan porque los pedidos lentos suelen ser de los usuarios con más datos y porque una página con muchas llamadas casi siempre cae en la cola de alguna. Los percentiles no se promedian.
- Para medir sin engañarse: carga realista, calentamiento, medir desde quien llama, repetir (el p95 de Tinkuy varió casi 50 % entre corridas iguales) y separar los pedidos que hacen trabajos distintos. Un generador de modelo cerrado deja de enviar cuando el servidor se detiene y omite las peores mediciones (omisión coordinada): el mismo servidor dio p95 de 5,71 ms con el modelo cerrado y de 502,9 ms con el abierto.
- Un umbral de k6 convierte la medida de un escenario en una prueba que falla. El umbral sale de lo que necesita el stakeholder, no de lo que se midió. Un número medido en una laptop no es una propiedad del sistema: lo que se traslada es la comparación.
- La disponibilidad es la fracción del tiempo (o de los pedidos) en que el sistema responde bien. Tres nueves son 8,76 horas caído al año; cuatro, 52,56 minutos. En serie se multiplican: tres servicios de 99,9 % dan 99,7 %. Se mejora fallando menos (MTBF) o recuperándose más rápido (MTTR). SLI, SLO y SLA son el indicador, el objetivo y el contrato.
- El utility tree ordena los escenarios bajo sus atributos y les pone dos notas: valor para el negocio y dificultad técnica. Los (A, A) definen la arquitectura.
- Los atributos compiten. Un trade-off es una decisión que mejora uno y cuesta otro; decidir es elegir qué se sacrifica para este sistema y escribirlo, con el escenario, la alternativa y el costo.
Ejercicios
-
Reescriban como escenario de seis partes, con el template, el requisito “el reporte de ventas de un evento debe ser rápido”. Pásenlo por
scenario-check.ts. Después escriban una segunda versión que cambie solo el entorno, de modo que un diseño que cumple la primera pueda no cumplir la segunda, y digan por qué. -
Para cada hecho, nombren dos atributos de calidad bajo los que alguien podría reportarlo y escriban la medida de un escenario que permitiría decidir si es o no un problema, sin usar el nombre de ningún atributo: (a) el detalle de un evento tarda 6 segundos cuando el evento tiene 800 asientos; (b) agregar un nuevo tipo de evento obligó a cambiar 14 archivos; (c) después de un reinicio, el primer minuto de pedidos responde con errores; (d) cualquiera que conozca el número de una orden puede ver el correo del comprador.
-
Estas son 20 latencias, en milisegundos: 12, 14, 15, 15, 16, 17, 18, 18, 19, 21, 22, 24, 25, 27, 31, 38, 45, 90, 240, 1200. Calculen a mano, por rango más cercano, el p50, el p90, el p95 y el p99, y el promedio. Comprueben con
node calc.ts percentiles(un valor por línea en un archivo). ¿Qué fracción de los pedidos tardó más que el promedio? ¿Por qué, con 20 mediciones, el p99 no agrega información? -
Construyan un conjunto de 1 000 latencias cuyo promedio sea de 80 ms y cuyo p99 sea de 2,4 s. Describan una situación real en Tinkuy que podría producir una distribución así y digan qué compradores serían los afectados. Después construyan otro conjunto con el mismo promedio y un p99 menor que 100 ms. ¿Qué número, además del promedio, habría permitido distinguirlos?
-
Un servidor A atendió 9 000 pedidos con p99 de 80 ms y un servidor B atendió 1 000 pedidos con p99 de 900 ms. Muestren, construyendo dos pares de conjuntos de datos que respeten esos reportes, que el p99 del conjunto completo puede tomar valores muy distintos. ¿Entre qué valores extremos puede estar? ¿Qué tendrían que reportar A y B para que el p99 conjunto se pudiera calcular?
-
Una operación necesita tres servicios en serie, con disponibilidades de 99,95 %, 99,9 % y 99,5 %. Calculen la disponibilidad de la operación y su tiempo caído al mes. Si solo pudieran mejorar uno de los tres servicios en un nueve, ¿cuál elegirían? Después supongan que el tercer servicio se reemplaza por dos copias suyas en paralelo: rehagan la cuenta y enumeren dos razones por las que el resultado real podría ser peor que el calculado.
-
Un servicio falla, en promedio, una vez cada 10 días y tarda 30 minutos en volver. Calculen su disponibilidad. El equipo tiene dos propuestas: (a) un mes de trabajo para reducir las fallas a la mitad; (b) una semana de trabajo para detectar la falla y reiniciar de forma automática en 5 minutos. Calculen la disponibilidad con cada una y elijan. ¿Qué dato del negocio podría hacer que la otra fuera la mejor?
-
En
omission/simulate.ts, antes de ejecutar nada, predigan cuántos pedidos lentos verá el modelo cerrado y qué fracción del total serán si se usan 100 usuarios virtuales en vez de 10 (con los mismos 50 ms de pausa). Hagan el cambio y comprueben. ¿Con cuántos usuarios virtuales el p99 del modelo cerrado empieza a ver la detención? Expliquen por qué “usar más usuarios virtuales” no es una solución a la omisión coordinada. -
Corran
make omissionen su máquina y armen la tabla comparativa de La omisión coordinada con sus números. Después cambien la tasa del modelo abierto a 50 pedidos por segundo. ¿Cambian el p95 y el p99? ¿Por qué? ¿Qué dice eso sobre de qué depende la latencia que ve un usuario de este servidor? -
Escriban los umbrales de k6 que corresponden a este escenario: “1 000 compradores piden el detalle de un evento durante 5 minutos, en hora punta; el sistema responde con p99 menor que 800 ms y menos de 0,5 % de errores”. Luego expliquen, con un conjunto de datos inventado, cómo un umbral escrito sobre el promedio (
avg<800) dejaría pasar a un sistema que incumple el escenario. ¿Qué ejecutor de k6 usarían para generar el estímulo y por qué? -
Armen el utility tree de un sistema que conozcan como usuarios (el sistema de matrícula de una universidad, una aplicación de taxis, la banca por celular): al menos seis escenarios en tres atributos, con sus seis partes y sus dos notas. Justifiquen cada (A, A) en dos líneas, y señalen un escenario cuya nota técnica cambiaría si el sistema tuviera otro diseño.
-
Para cada decisión, escriban el trade-off con la forma de Cómo se escribe un trade-off, inventando el escenario que mejora y nombrando el que empeora: (a) la lista de asientos de un evento se guarda 5 segundos en una cache; (b) Tinkuy corre en dos instancias detrás de un load balancer; (c) para ver los asientos de un evento hay que iniciar sesión. En cada caso, digan qué medición harían para saber cuánto se ganó y cuánto se pagó.