Apuntes · Capítulo 3Fundamentos y atributos de calidad
Modularidad: límites, acoplamiento y dependencias
Modularidad: límites, acoplamiento y dependencias
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Módulos y modificabilidad, Qué es un módulo y La modificabilidad se escribe como escenario; de El criterio de Parnas, El problema: un índice KWIC, Primera descomposición: por pasos y Segunda descomposición: por decisiones; y de El grafo de dependencias, De los imports al grafo y Ciclos.
- En clase: Sesión A: Módulos y modificabilidad, El criterio de Parnas, Ocultamiento de información, Cohesión y Acoplamiento. Sesión B: El grafo de dependencias, Inversión de dependencias, Ports y adapters y Reglas que se comprueban. Laboratorio: Laboratorio: reglas de dependencia y un ciclo que romper.
- Después de clase: el Resumen y los Ejercicios. Para repasar con calma: Llega un cambio, Cuatro maneras de romper el ciclo y Las cuatro violaciones de Tinkuy. Opcionales: Lo que el artículo dice además, El contrato de un port y Estabilidad: quién depende de quién.
En la semana 1 dijimos que la arquitectura de un sistema son sus estructuras,
y que una de ellas, la de módulos, responde la pregunta “¿qué toca un
cambio?”. En el laboratorio dibujaron la de Tinkuy a mano, contando imports
con grep. En la semana 2 aprendieron a escribir lo que se le pide a un
sistema como un escenario con su medida, y vieron que el estímulo de un
escenario de modificabilidad no es una avalancha de pedidos ni una falla: es
un cambio que llega.
Esta semana juntamos las dos cosas. La pregunta es cómo se divide un sistema en módulos para que los cambios probables toquen poco, y cómo se comprueba que esa división se sigue cumpliendo seis meses después, cuando ya nadie se acuerda de por qué se hizo así. No hay una división correcta para todos los sistemas; lo que hay es un criterio para elegir entre dos divisiones, un vocabulario para decir qué tan atados quedan dos módulos, y herramientas que leen el código y dicen si el dibujo de la pizarra todavía es verdad.
El capítulo sigue las dos sesiones. En la primera estudiamos el artículo con el que David Parnas, en 1972, cambió la manera de pensar los módulos: el mismo programa dividido de dos formas, y un cambio que en una toca casi todo y en la otra un solo archivo. Lo reproducimos en TypeScript y contamos los archivos. De ahí salen el ocultamiento de información, la cohesión y el acoplamiento. En la segunda sesión miramos las flechas entre los módulos: el grafo de dependencias, los ciclos, la inversión de dependencias para romperlos, la arquitectura de ports y adapters y las reglas de dependencia que una herramienta comprueba en cada build.
Lectura. Sesión A: David Parnas, On the Criteria To Be Used in Decomposing Systems into Modules (1972), completo: son seis páginas; Bass, Clements y Kazman, Software Architecture in Practice (4.ª ed.), cap. 8 Modifiability: el escenario general y las tácticas de cohesión y acoplamiento. Complementarias: Richards y Ford, Fundamentals of Software Architecture (2.ª ed.), cap. 3 Modularity; connascence.io, las formas de connascence con ejemplos; Software Architecture in Practice, cap. 15 Software Interfaces.
Sesión B: Alistair Cockburn, Hexagonal Architecture (ports y adapters); Brett Schuchert, DIP in the Wild, el principio de inversión de dependencias en casos reales. Complementarias: dependency-cruiser, Rules reference; Fundamentals of Software Architecture (2.ª ed.), cap. 8 Component-Based Thinking.
El código de este capítulo está en code/week-03. Todas las salidas que se muestran son de ejecuciones reales en el contenedor del curso.
Módulos y modificabilidad
Qué es un módulo
Un módulo es una unidad de código con una responsabilidad y una interfaz.
La responsabilidad dice de qué se ocupa; la interfaz dice qué pueden usar los
demás. En Tinkuy los módulos son las carpetas de src/: catalog se ocupa de
los eventos y los asientos, orders de la compra, payments de hablar con la
pasarela. En otro lenguaje serían paquetes, bibliotecas o proyectos. El
tamaño no define a un módulo: una función puede serlo y un servicio entero
también. Lo que lo define es que alguien pueda decir “esto es asunto de este
módulo y no de los otros”.
Parnas lo dice de una manera que conviene recordar todo el curso: en su artículo, un módulo es una asignación de responsabilidad antes que un subprograma. Se piensa en módulos cuando se reparte trabajo: qué puede hacer una persona (o un equipo) sin tener que preguntarle a otra.
De ahí salen los tres beneficios que el artículo espera de una buena división, y que siguen siendo los que se buscan hoy:
- Desarrollo en paralelo. Grupos distintos trabajan en módulos distintos con poca necesidad de comunicarse.
- Flexibilidad. Se puede cambiar mucho un módulo sin cambiar los demás.
- Comprensión. El sistema se puede estudiar un módulo a la vez.
Los tres dependen de lo mismo: de cuánto tiene que saber un módulo sobre los
otros. Si para cambiar orders hay que leer catalog, avisar al equipo de
reports y coordinar un despliegue, la división en carpetas existe y los
beneficios no.
La pregunta que responde la estructura de módulos
En la semana 1 vimos tres tipos de estructuras. La de componentes y conectores dice qué existe mientras el sistema corre; la de asignación, dónde cae cada cosa. La de módulos es la del código en reposo, y responde dos preguntas:
- ¿Qué toca un cambio? Cuando llega un requisito nuevo, cuántos módulos hay que abrir, entender y volver a probar.
- ¿Quién puede trabajar en paralelo? Qué partes pueden avanzar dos personas a la vez sin estorbarse.
Por eso la modularidad es la base de la modificabilidad. Los demás atributos de calidad se juegan sobre todo en la estructura que corre: la latencia depende de cuántas llamadas se hacen y la disponibilidad de qué pasa cuando una falla. La modificabilidad se juega en la estructura de módulos. Un sistema puede ser un solo proceso (un solo componente) y estar muy bien o muy mal dividido por dentro; Tinkuy es un solo proceso con cinco módulos, y lo que vamos a mirar esta semana son esos cinco.
La modificabilidad se escribe como escenario
“El sistema debe ser fácil de modificar” tiene el mismo problema que “debe ser rápido”: no se puede decir cuándo se incumple. Igual que con la latencia, la salida es escribir un escenario de seis partes. Lo que cambia es el estímulo (un cambio pedido, no una carga) y la medida (esfuerzo, no milisegundos):
| Parte | Escenario de modificabilidad para Tinkuy |
|---|---|
| Fuente | El área comercial |
| Estímulo | Pide aceptar un medio de pago nuevo |
| Artefacto | El código de Tinkuy |
| Entorno | En desarrollo, con el sistema ya en producción |
| Respuesta | El cambio se hace, se prueba y se despliega sin modificar la compra ni el catálogo |
| Medida | Toca un solo módulo y toma menos de dos días de una persona |
La medida tiene dos números y los dos importan. El tiempo es lo que le interesa al negocio. El número de módulos que hay que tocar es lo que puede controlar quien diseña, y es la medida que vamos a usar toda la semana:
Idea clave. La calidad de una división en módulos no se mide mirándola, sino haciéndole una pregunta: cuando llegue este cambio, que es probable, ¿cuántos módulos hay que tocar? Una división es buena o mala respecto de una lista de cambios, no en abstracto.
La consecuencia es incómoda y hay que decirla desde el comienzo: no existe la división que aguanta todos los cambios. Toda división hace baratos unos cambios y caros otros. Dividir bien es apostar por cuáles van a llegar, y la apuesta se puede perder.
El criterio de Parnas
El problema: un índice KWIC
El artículo de Parnas no argumenta con principios: toma un programa pequeño, lo divide de dos maneras y compara qué le pasa a cada división cuando llegan cambios. El programa es un índice KWIC (key word in context), que en 1972 se usaba para buscar títulos por cualquiera de sus palabras.
La especificación es corta:
- El sistema recibe un conjunto ordenado de líneas; cada línea es un conjunto ordenado de palabras, y cada palabra, de caracteres.
- Una línea se puede rotar: se quita la primera palabra y se pone al final. Repitiéndolo se obtienen todas las rotaciones de la línea (tantas como palabras tiene).
- El sistema produce el listado de todas las rotaciones de todas las líneas, en orden alfabético.
Con tres títulos de novelas peruanas en
kwic/titles.txt:
La ciudad y los perros
Los ríos profundos
El mundo es ancho y ajeno
el índice es este ( palabras, 14 rotaciones):
$ node kwic/decisions/main.ts kwic/titles.txt
ajeno El mundo es ancho y
ancho y ajeno El mundo es
ciudad y los perros La
El mundo es ancho y ajeno
es ancho y ajeno El mundo
La ciudad y los perros
los perros La ciudad y
Los ríos profundos
mundo es ancho y ajeno El
perros La ciudad y los
profundos Los ríos
ríos profundos Los
y ajeno El mundo es ancho
y los perros La ciudad
Quien busca “perros” encuentra el título en la P, aunque empiece con “La”.
Parnas aclara que el programa es pequeño a propósito: un buen programador lo escribe en una o dos semanas, y ninguna de las dificultades que motivan dividir en módulos aparece a esa escala. El ejercicio consiste en tratarlo como si fuera un proyecto grande, con un equipo por módulo. Nosotros hacemos lo mismo: cada archivo de las carpetas que siguen es “un equipo”.
Primera descomposición: por pasos
La primera división es la que haría casi cualquiera: se dibuja el diagrama de flujo del programa y cada paso es un módulo. Parnas la describe con cinco módulos:
- Entrada. Lee las líneas y las guarda en memoria.
- Rotaciones. Arma un índice con el lugar donde empieza cada rotación.
- Orden alfabético. Devuelve el mismo índice, ordenado.
- Salida. Escribe el listado a partir del índice ordenado y de las líneas.
- Control. Llama a los otros cuatro en orden.
Es una división razonable. Cada módulo es pequeño, tiene una tarea clara y se puede escribir por separado. Parnas dice expresamente que es una modularización “en el sentido que le dan todos los que proponen la programación modular”.
Para que los cuatro equipos puedan trabajar hay que acordar primero una cosa:
cómo quedan los datos en memoria. El módulo 1 los escribe y los otros
tres los leen. En el artículo, ese acuerdo son los formatos de la memoria de
la máquina (los caracteres empaquetados de a cuatro por palabra de memoria y
un índice con la dirección donde empieza cada línea). En nuestra versión, en
kwic/steps/, es un archivo de tipos:
// kwic/steps/formats.ts
/**
 * Las líneas, tal como las deja el módulo de entrada: todos los caracteres en
 * un solo texto, una línea tras otra, con un espacio entre palabra y palabra
 * (también entre la última palabra de una línea y la primera de la siguiente).
 * `lineStart[i]` es la posición donde empieza la línea i.
 */
export type Lines = {
  chars: string;
  lineStart: number[];
};

/**
 * Una rotación: el número de la línea original y la posición, dentro de
 * `chars`, del primer carácter de la palabra con la que empieza.
 */
export type Shift = {
  line: number;
  start: number;
};
Con los tres títulos, chars es
"La ciudad y los perros Los ríos profundos El mundo es ancho y ajeno" y
lineStart es [0, 23, 42]. La rotación “perros La ciudad y los” es
{ line: 0, start: 16 }: no se copia ningún texto, solo se anota dónde
empieza.
Cada módulo es una función que recibe y devuelve esos formatos. El de rotaciones recorre los caracteres buscando dónde empieza cada palabra:
// kwic/steps/circular-shift.ts
export function circularShifts(lines: Lines): Shift[] {
  const shifts: Shift[] = [];
  for (let line = 0; line < lines.lineStart.length; line++) {
    const from = lines.lineStart[line]!;
    const to = line + 1 < lines.lineStart.length ? lines.lineStart[line + 1]! - 1 : lines.chars.length;
    // Una palabra empieza al inicio de la línea y después de cada espacio.
    for (let position = from; position < to; position++) {
      if (position === from || lines.chars[position - 1] === ' ') {
        shifts.push({ line, start: position });
      }
    }
  }
  return shifts;
}
Y el control es, literalmente, el diagrama de flujo:
// kwic/steps/main.ts
export function kwic(text: string): string {
  const lines = readLines(text);
  const shifts = circularShifts(lines);
  const sorted = alphabetize(lines, shifts);
  return render(lines, sorted);
}
Fíjense en un detalle de alphabetize y de render: los dos reciben
lines. Para comparar dos rotaciones, o para escribirlas, hay que
reconstruir su texto, y eso solo se puede hacer sabiendo cómo están guardados
los caracteres. El formato de Lines no es un asunto del módulo de entrada:
lo conocen los cuatro.
Segunda descomposición: por decisiones
La segunda división no sale del diagrama de flujo. Sale de otra pregunta:
¿qué decisiones de diseño tomamos que podrían cambiar? Cada una se
encierra en un módulo, y la interfaz de ese módulo se escribe de modo que no
la delate. En el artículo son seis módulos; en
kwic/decisions/ son seis archivos:
| Módulo | La decisión que esconde |
|---|---|
line-storage.ts |
Cómo se guardan las líneas en memoria |
input.ts |
El formato de la entrada |
circular-shifter.ts |
Cómo se obtienen las rotaciones: guardadas, con un índice o calculadas al vuelo |
alphabetizer.ts |
Qué es “orden alfabético” y cuándo se ordena |
output.ts |
El formato del listado |
main.ts |
Cómo se arma y se arranca todo |
El primero no existía en la otra división. El almacén de líneas no es un paso del procesamiento: lo usan casi todos los pasos. Su interfaz no menciona caracteres empaquetados ni índices; ofrece operaciones:
// kwic/decisions/line-storage.ts
export interface LineStorage {
  /** Guarda una línea nueva, formada por estas palabras, al final. */
  addLine(words: readonly string[]): void;
  /** Cuántas líneas hay guardadas. */
  lineCount(): number;
  /** Cuántas palabras tiene la línea `line` (la primera es la 0). */
  wordCount(line: number): number;
  /** La palabra número `index` de la línea `line`. */
  word(line: number, index: number): string;
}
La interfaz de Parnas era de más bajo nivel, carácter por carácter
(CHAR(r,w,c) devuelve el carácter c de la palabra w de la línea r).
La nuestra trabaja con palabras, que en TypeScript son valores como cualquier
otro. La idea es la misma: se pregunta por posición
lógica (línea, palabra) y no se dice nada de dónde ni cómo está guardado.
Detrás de esa interfaz, el archivo guarda las líneas exactamente igual que la
primera descomposición: un solo texto y un índice de comienzos. La diferencia
es que ahora esas dos variables son locales de createLineStorage y nadie
más las ve.
El módulo de rotaciones se presenta hacia afuera como otro almacén de líneas, que en vez de las líneas originales tiene todas sus rotaciones:
// kwic/decisions/circular-shifter.ts
export interface CircularShifter {
  /** Cuántas rotaciones hay en total. */
  shiftCount(): number;
  /** Cuántas palabras tiene la rotación `shift`. */
  wordCount(shift: number): number;
  /** La palabra número `index` de la rotación `shift`. */
  word(shift: number, index: number): string;
}
Quien lo usa no puede saber si las rotaciones están guardadas una por una o
si se calculan cuando se piden. En nuestra implementación no se guarda
ninguna: hay un índice de pares (línea, primera palabra) y word hace la
cuenta con un módulo:
    word(shift, position) {
      const { line, firstWord } = entry(shift);
      return storage.word(line, (firstWord + position) % storage.wordCount(line));
    },
El módulo de orden alfabético ofrece una sola operación, ith(position): el
número de la rotación que queda en ese lugar del orden. Tampoco dice cuándo
ordena. La implementación ordena todo la primera vez que alguien pregunta, y
nadie de afuera puede notar la diferencia con ordenar al construirlo, o con
ir ordenando de a pocos.
Las dos descomposiciones producen el mismo listado. Hay una prueba que lo comprueba, y Parnas va más lejos: dice que los dos sistemas podrían ser idénticos una vez compilados, con los mismos algoritmos y las mismas estructuras de datos. Lo que cambia no es el programa que corre. Cambia cómo está repartido el conocimiento entre los archivos, y eso solo se nota cuando hay que modificarlo.
Idea clave. Dos divisiones en módulos del mismo programa pueden correr igual y costar muy distinto de cambiar. La estructura de módulos no es una propiedad de lo que el sistema hace: es una propiedad de cómo está escrito.
Llega un cambio
Ahora el experimento. Llega un cambio de los que Parnas anticipa: las líneas
se van a guardar de otra manera. En su artículo, la decisión de empaquetar
los caracteres de a cuatro por palabra de memoria deja de convenir. En el
nuestro, en vez de un solo texto con un índice, cada línea será una lista de
palabras (string[][]). Es un cambio interno: la entrada y el listado no
cambian.
Los archivos que hubo que reescribir en cada descomposición están en
kwic/change/. El programa
kwic/change.ts hace el cambio en dos
tiempos y cuenta. Primero reemplaza solo lo que le toca al responsable de
guardar las líneas y corre tsc; después reemplaza todo lo necesario y
compara el listado con el de antes:
$ make kwic-change
Descomposición 1, por pasos (kwic/steps/, 6 archivos)
  1. Cambia la forma de guardar las líneas: formats.ts, input.ts
  2. tsc encuentra errores en otros módulos:
       alphabetize.ts: 8
       circular-shift.ts: 7
       output.ts: 8
  3. Archivos reescritos para completar el cambio: 5 de 6 (alphabetize.ts, circular-shift.ts, formats.ts, input.ts, output.ts)
  4. El listado sale igual que antes: sí

Descomposición 2, por decisiones (kwic/decisions/, 6 archivos)
  1. Cambia la forma de guardar las líneas: line-storage.ts
  2. tsc: sin errores
  3. Archivos reescritos para completar el cambio: 1 de 6 (line-storage.ts)
  4. El listado sale igual que antes: sí
En la descomposición por pasos, el equipo de entrada cambia el formato y su propio módulo, y con eso rompe a los otros tres equipos: 23 errores de tipos en archivos que no tocó. Los errores son todos del mismo estilo:
alphabetize.ts(14,22): error TS2339: Property 'lineStart' does not exist on type 'Lines'.
circular-shift.ts(12,38): error TS2339: Property 'chars' does not exist on type 'Lines'.
output.ts(11,42): error TS2339: Property 'start' does not exist on type 'Shift'.
Cada módulo leía chars y lineStart directamente. Para terminar el cambio
hay que reescribir cinco de los seis archivos; el único que se salva es el
control, que solo pasa valores de una función a la siguiente sin mirar qué
llevan adentro. El artículo dice que este cambio obliga a modificar todos
los módulos de la primera descomposición; en la nuestra son los cuatro que
trabajan con los datos.
En la descomposición por decisiones se reescribe un archivo. Los demás no se
recompilan distinto, no fallan y no se enteran: lo único que conocían de las
líneas era wordCount y word, y eso sigue igual.
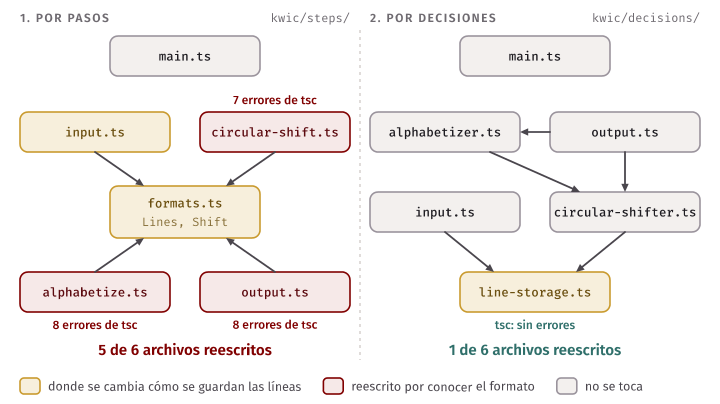
Hay que leer este resultado con cuidado, porque es fácil sacar la conclusión equivocada. La segunda descomposición no es mejor porque tenga interfaces, ni porque use funciones en vez de tipos de datos, ni porque sea “más orientada a objetos”. Es mejor para este cambio, porque alguien anticipó que la forma de guardar las líneas podía cambiar y la encerró. Si el cambio que llega es otro, la cuenta puede salir distinta, y por eso el artículo trae una lista.
Los cinco cambios del artículo
Parnas enumera cinco decisiones “cuestionables y con probabilidad de cambiar” y dice, para cada una, qué módulos tocaría en cada descomposición:
| Decisión que cambia | Por pasos | Por decisiones |
|---|---|---|
| 1. El formato de la entrada | Un módulo (entrada) | Un módulo (entrada) |
| 2. Tener todas las líneas en memoria | Todos | Solo el almacén de líneas |
| 3. Cómo se empaquetan los caracteres | Todos | Solo el almacén de líneas |
| 4. Hacer un índice de las rotaciones en vez de guardarlas | Rotaciones, orden alfabético y salida | Solo el módulo de rotaciones |
| 5. Ordenar todo de una vez, en vez de ordenar por partes o buscar cuando se pide | Difícil: la salida supone que el índice ya está completo | Solo el módulo de orden alfabético |
Nuestro experimento es el cambio 3. El primero empata: las dos divisiones tienen un módulo de entrada. La diferencia está en los otros cuatro, y todos tienen algo en común: son decisiones sobre representación (cómo se guarda algo) o sobre momento (cuándo se calcula algo). En la descomposición por pasos, esas decisiones quedaron en las interfaces entre los módulos. En la otra, quedaron adentro de uno.
Y de ahí el criterio, que es la frase más citada del artículo. Parnas concluye que casi siempre es incorrecto empezar la división de un sistema a partir de un diagrama de flujo, y propone empezar con una lista de las decisiones de diseño difíciles o que es probable que cambien: cada módulo se diseña para esconder una de esas decisiones de los demás.
Idea clave. El criterio de Parnas: se divide por lo que puede cambiar, no por el orden en que se ejecuta. Un módulo se justifica por la decisión que esconde.
Lo que el artículo dice además
Tres observaciones del artículo que suelen perderse en los resúmenes, y que vamos a usar más adelante.
La segunda descomposición también tiene un costo. Parnas lo dice sin rodeos: si cada operación de cada módulo es una llamada a un procedimiento, la segunda versión va a ser más lenta, porque el control salta todo el tiempo de un módulo a otro (pedir una palabra a la vez, en vez de leer el arreglo directamente). En 1972 eso pesaba mucho, y él propone resolverlo con herramientas que inserten el código en línea. Hoy un compilador o un motor de JavaScript hacen buena parte de ese trabajo, pero el costo no desaparece en todas las escalas: en la semana 5 lo vamos a ver volver cuando la frontera entre dos módulos sea una red.
Él mismo encuentra un error en su diseño. La especificación de su módulo
de rotaciones decía en qué orden quedaban (primero las de la línea 1, después
las de la línea 2…). Mirándolo después, Parnas nota que ese orden no hacía
falta para escribir los demás módulos, y que haberlo prometido impide, por
ejemplo, una implementación que produzca las rotaciones ya ordenadas
alfabéticamente. Lo llama un error de diseño: la interfaz reveló más de lo
necesario. Nuestra interfaz CircularShifter no promete ningún orden por
esa razón.
Una buena división y una jerarquía son cosas distintas. Al final del artículo, Parnas mira la relación “usa a” entre los módulos de la segunda descomposición y observa que forma una jerarquía: el almacén de líneas no usa a nadie; la entrada y las rotaciones lo usan a él; el orden alfabético y la salida usan a las rotaciones. No hay módulos de abajo que usen a los de arriba. Eso da un beneficio aparte: se puede cortar la parte de arriba y quedarse con un pedazo que sigue sirviendo (el almacén de líneas se puede reutilizar en otro programa). Y advierte qué pasa si los módulos “de abajo” usan a los “de arriba”: no hay jerarquía, cuesta mucho más sacar una parte del sistema, y “nivel” deja de significar algo. Es la primera descripción del problema de los ciclos, que es el tema de la segunda sesión.
Trade-off. Esconder una decisión detrás de una interfaz cuesta indirección: más llamadas, más archivos, y un lector que para entender cómo se guardan las líneas tiene que entrar a un módulo más. Se gana que el cambio de esa decisión toque un solo lugar. Vale la pena cuando el cambio es probable; cuando no lo es, se pagó el costo y no se cobró nada.
Ocultamiento de información
La interfaz es todo lo que los demás pueden suponer
El nombre que Parnas le dio a su criterio es ocultamiento de información (information hiding). Conviene definirlo por el lado de la interfaz, que es el que se puede revisar:
La interfaz de un módulo es todo lo que los demás módulos pueden suponer sobre él. Lo que no está en la interfaz se puede cambiar sin avisarle a nadie.
“Todo lo que pueden suponer” es más que la lista de funciones exportadas. Incluye los tipos de lo que se recibe y se devuelve, los errores que puede lanzar, el orden en que hay que llamar las operaciones, si una llamada es rápida o lenta, y cualquier otra cosa de la que otro módulo llegue a depender. Si el módulo de salida supone que las rotaciones vienen agrupadas por línea, ese orden es parte de la interfaz aunque nadie lo haya escrito, y cambiarlo rompe algo.
De la definición sale una prueba práctica. Para saber qué esconde un módulo, se hace una lista de sus decisiones internas (dónde guarda los datos, en qué formato, con qué algoritmo, en qué orden, con qué biblioteca) y se pregunta, para cada una: si mañana cambia, ¿algún otro módulo tiene que cambiar? Si la respuesta es sí, esa decisión no está escondida: está en la interfaz, se haya querido o no.
Tres maneras de no esconder nada
Un módulo puede tener su carpeta, su nombre y su index.ts, y no esconder
nada. Las tres formas más comunes:
Exponer sus tablas. Si otro módulo escribe su propio SQL contra las tablas de este, el esquema de esas tablas pasó a ser parte de la interfaz. Renombrar una columna o partir una tabla en dos ya no es una decisión interna.
Exponer sus tipos internos. Si el módulo devuelve la fila de la base de datos tal cual, o un objeto de la biblioteca que usa por dentro, quien lo llama queda atado a esa fila o a esa biblioteca. El módulo de entrada del KWIC por pasos hacía esto: devolvía su estructura de datos y la llamaba “formato”.
Exponer su orden de llamadas. Si para usar el módulo hay que llamar
setup() antes que todo lo demás, o llamar a() y después b() porque b
lee algo que a dejó preparado, el orden interno del módulo salió afuera. El
módulo de orden alfabético de Parnas tenía una operación ALPH que había que
llamar antes de poder preguntar; el nuestro ordena solo, la primera vez que
alguien pregunta, y con eso quitó una cosa que saber.
En Tinkuy. El reporte de ventas, en
src/reports/sales-report.ts, empieza así:import { findEvent } from '../catalog/events.ts'; import { withClient } from '../db.ts'; import { notFound } from '../errors.ts'; import { ORDER_STATUS } from '../orders/order-repository.ts';No usa
catalogniorderspor suindex.ts: entra a dos archivos internos. Y más abajo hace sus propias consultas conJOINsobresections,seats,order_itemsyorders, tablas que escriben otros módulos.reportsconoce el esquema de las tablas deorders, la constante con la queordersmarca una orden pagada y el archivo dondecatalogdefinefindEvent. Son tres decisiones internas de otros módulos que hoy no se pueden cambiar sin abrirreports.
Cohesión
Una razón para cambiar
La cohesión (cohesion) mira un módulo por dentro: qué tan relacionadas están las cosas que contiene. La definición que sirve para decidir vuelve a estar escrita en términos de cambio:
Un módulo es cohesivo cuando sus partes cambian juntas y por la misma razón.
line-storage.ts es cohesivo: todo lo que hay adentro existe por una
decisión (cómo se guardan las líneas) y, si esa decisión cambia, cambia todo
el archivo y nada más. En cambio, imaginen un archivo text-utils.ts que
tuviera la función que parte una línea en palabras, la que compara dos textos
sin distinguir mayúsculas y la que escribe el listado. Las tres “tratan de
texto”, pero cambian por razones que no tienen que ver: el formato de la
entrada, las reglas de orden alfabético y el formato de la salida. Están
juntas porque se parecen, no porque cambien juntas.
La cohesión y el criterio de Parnas son la misma idea vista desde dos lados. Parnas dice qué poner en módulos separados (decisiones distintas); la cohesión dice qué dejar junto (lo que responde a una misma decisión).
Señales de baja cohesión
No hay un número confiable para la cohesión, pero hay señales que se ven sin medir nada:
- El nombre no dice de qué se ocupa.
utils,common,helpers,manager,misc. Un módulo que no se puede nombrar por su responsabilidad probablemente tiene varias, o ninguna. - Los cambios tocan solo una mitad. Si en el historial de Git la mitad de los commits modifican unas funciones y la otra mitad modifica otras, y casi nunca coinciden, ahí hay dos módulos compartiendo carpeta.
- Quienes lo usan usan pedazos distintos. Si un módulo que lo importa usa solo las funciones y , y otro solo y , sus dos grupos de usuarios no tienen nada en común.
- Hay que decir “y” para describirlo. “Valida la orden y calcula la comisión y envía el correo.”
Ninguna señal es una prueba. Un módulo errors.ts con los errores que toda
la aplicación sabe explicar puede ser perfectamente cohesivo aunque lo usen
todos. La pregunta de fondo siempre es la misma: ¿qué cambio lo haría
cambiar, y cambiaría entero?
Error común: dividir por capa técnica
Error común. Dividir el sistema en
controllers/,services/yrepositories/y concluir que es modular.
Esa división agrupa por tipo técnico: todo lo que recibe pedidos HTTP junto, toda la lógica junta, todo el SQL junto. Tiene una virtud real, que es separar el protocolo y la base de datos de las reglas del negocio (lo retomamos en la semana 4, con la arquitectura en capas). Lo que no hace es lo que promete la palabra “modular”. Háganle la pregunta de la semana: llega un cambio de negocio, por ejemplo “las órdenes ahora llevan un código de descuento”. ¿Cuántas carpetas toca?
| División | “Las órdenes llevan un código de descuento” toca |
|---|---|
Por capa técnica: controllers/, services/, repositories/ |
Las tres carpetas: el controlador de órdenes, el servicio de órdenes y el repositorio de órdenes |
Por tema del negocio: orders/, catalog/, payments/ |
Una carpeta: orders/ |
En la división por capas, cada carpeta tiene baja cohesión respecto de los cambios de negocio (el controlador de órdenes y el de reportes no cambian juntos casi nunca) y hay acoplamiento alto entre carpetas (el controlador, el servicio y el repositorio de órdenes cambian juntos casi siempre). Es la descomposición por pasos de Parnas con otros nombres: recibir, procesar, guardar.
Esto no significa que las capas estén mal. Significa que las capas responden a un tipo de cambio (cambiar de base de datos, cambiar de protocolo) y los módulos por tema responden a otro (cambiar el negocio), y que en casi todos los sistemas el segundo tipo llega muchas más veces que el primero. Las dos divisiones se pueden combinar: módulos por tema y, dentro de cada uno, capas. Es lo que hace Tinkuy a medias, y lo que vamos a ordenar con ports y adapters más adelante en este capítulo.
Acoplamiento
Cuánto debe saber un módulo de otro
El acoplamiento (coupling) mira hacia afuera: cuánto debe saber un módulo de otro para funcionar. Dos módulos están acoplados cuando un cambio en uno puede obligar a cambiar el otro.
Acoplamiento cero no existe ni se busca: dos módulos que no saben nada uno del otro no forman un sistema. Lo que importa es de qué depende un módulo, porque no todo acoplamiento cuesta lo mismo:
reports depende de… |
Qué cambio lo rompe | Costo |
|---|---|---|
Una función pública y estable de orders |
Que cambie la firma de esa función | Bajo: es un cambio raro, visible y que el compilador detecta |
Un tipo interno de orders |
Cualquier reorganización de los tipos de orders |
Medio |
El esquema de las tablas de orders |
Renombrar una columna, partir una tabla, cambiar cómo se marca una orden pagada | Alto: nada avisa hasta que la consulta falla al ejecutarse |
El orden en que orders hace las cosas |
Que orders empiece a emitir las entradas antes o después de cobrar |
Alto: nada falla; el reporte simplemente da números distintos |
Las cuatro filas son “reports usa a orders”, y en un diagrama serían la
misma flecha. La diferencia está en cuánto de orders quedó prometido.
Connascence: un vocabulario
Para hablar de estas diferencias hace falta vocabulario. Uno muy útil es el de connascence: dos elementos tienen connascence cuando un cambio en uno exige un cambio en el otro para que el sistema siga siendo correcto. El sitio connascence.io cataloga sus formas y las separa en dos grupos. Las estáticas se ven leyendo el código:
| Forma | Los dos lados tienen que estar de acuerdo en… | Ejemplo |
|---|---|---|
| De nombre | Cómo se llama algo | Quien llama a lateFeeCents tiene que usar ese nombre |
| De tipo | El tipo de algo | El argumento es un string con un día, no un Date |
| De significado | Qué quiere decir un valor | 1 es estudiante y 2 es visitante; -1 quiere decir “sin límite” |
| De posición | El orden de los valores | El primer argumento es el día de vencimiento y el segundo el de devolución |
| De algoritmo | Cómo se calcula algo | Quien genera un código de verificación y quien lo comprueba usan la misma fórmula |
Las dinámicas solo se ven cuando el programa corre, y por eso son más difíciles de razonar:
| Forma | Los dos lados tienen que estar de acuerdo en… | Ejemplo |
|---|---|---|
| De ejecución | El orden en que ocurren las cosas | Hay que llamar ALPH antes de ITH; no se puede cambiar el asunto de un correo después de enviarlo |
| De tiempo | Cuándo ocurren | Un módulo supone que el otro responde antes de que venza su timeout |
| De valor | Valores que deben cambiar juntos | El total de la orden y la suma de sus ítems |
| De identidad | Que se trate del mismo objeto | Dos módulos tienen que estar usando la misma conexión para que lo que hace uno quede dentro de la transacción del otro |
El orden de las tablas es de la más débil a la más fuerte. Según el sitio, la
fuerza de una forma está dada por lo fácil que es de corregir: la de
nombre es débil porque un cambio de nombre se encuentra y se arregla con las
herramientas de siempre; la de significado es más fuerte porque nada en el
código dice dónde más se usa ese 2.
El ejemplo de
coupling/connascence.ts muestra
tres de ellas en una función que calcula la multa por devolver tarde un libro:
// --- De posición: quien llama tiene que saber el orden de los argumentos.
// Los dos días son `string`: si se pasan al revés, compila igual.
export function lateFeeByPosition(dueOn: string, returnedOn: string, category: number): number
Una prueba deja constancia de lo que pasa cuando el acuerdo se rompe:
test('connascence de posición: con los dos días al revés compila igual y la multa desaparece', () => {
  assert.equal(lateFeeByPosition('2026-03-16', '2026-03-20', 1), 200);
  // Los mismos datos, en el otro orden: ningún error, y el socio no paga.
  assert.equal(lateFeeByPosition('2026-03-20', '2026-03-16', 1), 0);
});
Y otra muestra la de significado: la categoría 3, que nadie definió, se
cobra como visitante sin avisar. El refactoring baja las dos a connascence de
nombre, la más débil, con un objeto de campos con nombre y una unión de
literales:
export type MemberCategory = 'student' | 'visitor';

export function lateFeeCents(loan: { dueOn: string; returnedOn: string; category: MemberCategory }): number
Ahora un día en el campo equivocado se lee en el código, y una categoría que no existe no compila. No se eliminó el acoplamiento (quien llama sigue dependiendo de la función); se cambió por una forma más barata.
La connascence de algoritmo ya la vieron sin nombrarla. En el KWIC por pasos,
alphabetize.ts y output.ts contienen, cada uno, las mismas líneas que
reconstruyen el texto de una rotación a partir de chars, lineStart y
start. Si una de las dos copias cambia y la otra no, el listado sale
ordenado por un texto y escrito con otro. En el KWIC por decisiones esa cuenta
existe una sola vez, dentro de circular-shifter.ts.
Fuerza, localidad y grado
Una forma de connascence no es mala por sí sola. El sitio propone mirar cada caso en tres ejes:
- Fuerza. Qué forma es: las de más abajo en las tablas cuestan más de encontrar y de corregir.
- Localidad. Qué tan lejos están los dos elementos. La misma connascence de posición entre dos funciones del mismo archivo es inofensiva; entre dos módulos de equipos distintos es un problema, y entre dos servicios, uno mayor.
- Grado. Cuántos elementos participan. Un valor mágico que conocen dos funciones es una molestia; uno que conocen doscientas es una decisión de arquitectura que nadie tomó.
La regla que sale de ahí:
Idea clave. Cuanto más lejos están dos elementos, más débil debe ser lo que los ata. Dentro de un módulo se puede tolerar acoplamiento fuerte, porque quien cambia un lado ve el otro. Entre módulos, lo deseable es depender solo de nombres y tipos de una interfaz pública.
Esto le da un contenido preciso a la frase de siempre, “alta cohesión y bajo acoplamiento”: lo que está fuertemente atado debe quedar junto (cohesión), y lo que quedó separado debe estar atado de la forma más débil posible (acoplamiento).
La medida que importa: cuántos módulos toca un cambio
Volvamos al escenario del comienzo: “agregar un medio de pago toca un solo módulo”. ¿Lo cumple Tinkuy hoy? Se puede averiguar buscando dónde decide el código según el medio de pago:
$ grep -rn "=== 'card'\|=== 'yape'" src tools
src/payments/gateway-client.ts:12:  if (payment.method === 'card') {
src/payments/gateway-client.ts:14:  } else if (payment.method === 'yape') {
src/orders/validation.ts:46:  if (method === 'card') {
src/orders/validation.ts:55:  } else if (method === 'yape') {
src/orders/fees.ts:9:  if (method === 'card') {
src/orders/fees.ts:11:  } else if (method === 'yape') {
tools/fake-gateway.ts:50:  if (method === 'card') {
tools/fake-gateway.ts:55:  if (method === 'yape') {
En Tinkuy. El mismo
ifpor medio de pago aparece en tres archivos de dos módulos:ordersvalida los datos de cada medio y calcula su comisión, ypaymentsarma el mensaje para la pasarela. A eso se suman los tiposPaymentMethodyPaymentDetailsdesrc/payments/types.ts, que listan los medios. Agregar un tercer medio de pago toca, como mínimo, cuatro archivos en dos módulos, y nada avisa si alguien se olvida de uno: enfees.tsy engateway-client.ts, el caso que nadie previó termina en unthrow new Error('Medio de pago desconocido')que solo aparece cuando un comprador intenta pagar.
Es connascence de significado (todos tienen que saber qué quiere decir
'yape' y qué datos trae), de grado cuatro y con localidad mala: está
repartida entre módulos. El escenario dice “un módulo”; el sistema dice dos.
Esa distancia es el requisito de la entrega P1, y cómo cerrarla es trabajo de
ustedes. Lo que importa aquí es el método: el escenario se comprueba contando,
antes de discutir ningún diseño.
Error común: más módulos no es menos acoplamiento
Error común. Creer que dividir en más módulos reduce el acoplamiento.
Dividir un módulo en dos no quita ninguna dependencia: convierte dependencias internas, que no molestaban a nadie, en dependencias entre módulos. Si las dos mitades siguen cambiando juntas, lo único que se agregó es una frontera que cruzar en cada cambio: dos carpetas que abrir, dos interfaces que mantener y, si son de equipos distintos, una reunión.
La prueba vuelve a ser el historial de cambios. Si dos módulos aparecen juntos en casi todos los commits, el sistema está diciendo que son uno. El KWIC por pasos tenía cinco módulos y el otro seis; la diferencia entre ellos nunca estuvo en la cantidad.
Trade-off. Un módulo grande y cohesivo cuesta de leer y de repartir entre varias personas. Varios módulos pequeños que cambian juntos cuestan en cada cambio. Se divide cuando las partes pueden cambiar por separado; si no, la frontera es puro costo.
El grafo de dependencias
De los imports al grafo
Hasta aquí miramos los módulos de a uno o de a dos. La segunda sesión mira el conjunto. El grafo de dependencias de un sistema tiene:
- un nodo por módulo;
- una flecha de a si importa algo de .
La flecha se lee ” depende de ”, ” conoce a ” o “si cambia, puede tener que cambiar”. Va de quien usa hacia lo usado.
Lo valioso de este grafo es que no hay que dibujarlo: se calcula. Cada
import es una flecha, y un programa puede leerlos todos. En la semana 1 lo
hicieron con grep; esta semana usamos dependency-cruiser, la herramienta que
viene en el contenedor, que entiende TypeScript y puede agrupar los archivos
por carpeta. El grafo que dibuja alguien en la pizarra es lo que el equipo
cree que es el sistema. El que sale de los imports es lo que el sistema es.
Cuando no coinciden, el que está equivocado es el de la pizarra.
Para el ejemplo pequeño de esta semana, una biblioteca que presentamos en la sección siguiente, el grafo de módulos sale así:
$ make graph
src/adapters → src/loans
src/adapters → src/members
src/loans → src/members
src/main.ts → src/adapters
src/main.ts → src/loans
src/main.ts → src/members
Cada línea es una flecha. El comando que lo produce está en el
Makefile y sirve para cualquier proyecto con la
misma disposición de carpetas:
depcruise src --config .dependency-cruiser.cjs --include-only '^src' \
  --collapse '^src/[^/]+' --output-type text
--include-only '^src' deja fuera lo que no es código propio (los paquetes
de node_modules), --collapse '^src/[^/]+' junta todos los archivos de una
misma carpeta de src/ en un solo nodo, y --output-type text escribe una
flecha por línea en vez de comprobar reglas.
El grafo de Tinkuy
El mismo comando, sobre una copia de Tinkuy:
$ make tinkuy-graph
src/catalog → src/db.ts
src/catalog → src/errors.ts
src/catalog → src/orders
src/db.ts → src/config.ts
src/http → src/catalog
src/http → src/errors.ts
src/http → src/db.ts
src/http → src/orders
src/http → src/reports
src/http → src/log.ts
src/log.ts → src/config.ts
src/main.ts → src/config.ts
src/main.ts → src/http
src/main.ts → src/log.ts
src/notifications → src/config.ts
src/notifications → src/db.ts
src/notifications → src/log.ts
src/orders → src/catalog
src/orders → src/db.ts
src/orders → src/errors.ts
src/orders → src/log.ts
src/orders → src/notifications
src/orders → src/payments
src/payments → src/config.ts
src/payments → src/errors.ts
src/payments → src/log.ts
src/reports → src/catalog
src/reports → src/db.ts
src/reports → src/errors.ts
src/reports → src/orders
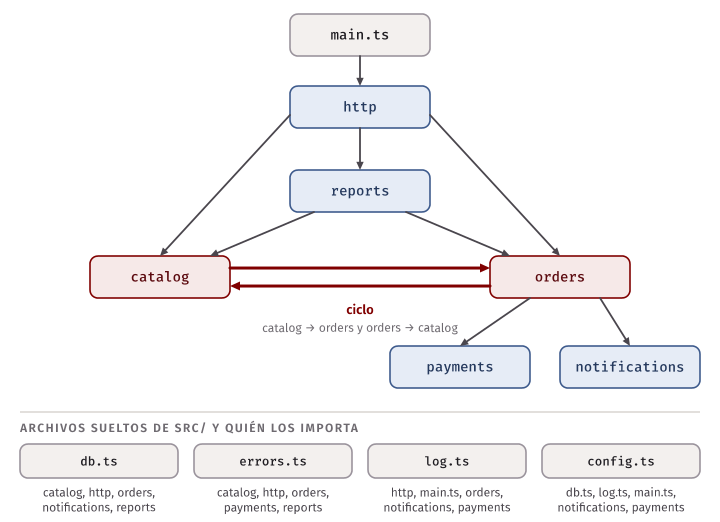
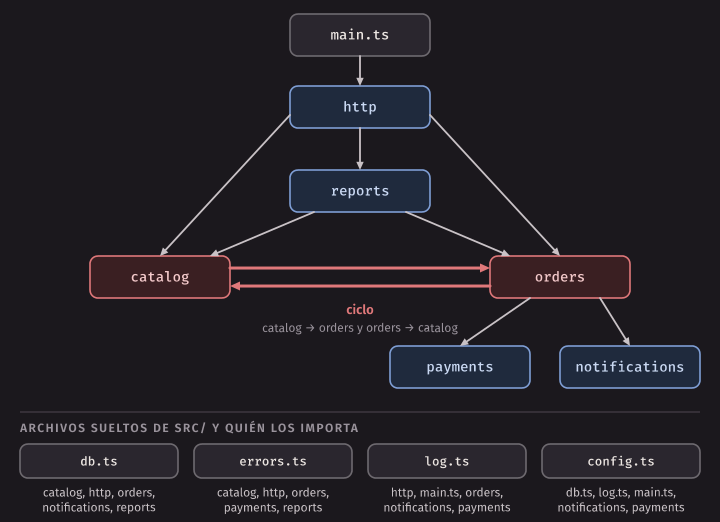
Treinta flechas para cinco módulos, la capa HTTP y cinco archivos sueltos. Aprendan a leer un listado así antes de dibujarlo, buscando tres cosas:
- Quién no depende de nadie.
config.tsyerrors.tsno aparecen nunca a la izquierda. Son las hojas del grafo. - De quién depende todo el mundo.
db.tsaparece a la derecha de cinco líneas:catalog,http,notifications,ordersyreportshablan directamente con la base de datos. - Pares que aparecen en los dos sentidos.
src/catalog → src/ordersysrc/orders → src/catalog. Eso es un ciclo.
Dibujadas, las flechas entre carpetas quedan así:
Ciclos
Hay un ciclo cuando, siguiendo las flechas, se puede salir de un módulo y volver a él. El más corto es de dos: depende de y depende de . Puede ser más largo () y entonces es más difícil de ver.
¿Por qué es un problema, si el programa funciona? Porque le quita a la división en módulos todo lo que prometía. Si y se necesitan mutuamente:
- No se pueden entender por separado. Para leer hay que saber qué hace , y para leer hay que saber qué hace . No hay por dónde empezar.
- No se pueden probar por separado. Una prueba de carga a , que carga a . No existe “la prueba de sola”.
- No se pueden reutilizar ni desplegar por separado. Quien quiera llevarse a otro proyecto se lleva también a . Si el día de mañana tiene que salir a su propio servicio (y en P4 un módulo de Tinkuy va a salir), sale con agarrado.
- Un cambio puede dar la vuelta. Un cambio en obliga a revisar , cuyo cambio obliga a revisar .
En la práctica, dos módulos en ciclo son un solo módulo con dos nombres. La estructura de carpetas dice que hay dos unidades y el grafo dice que hay una. Es exactamente lo que Parnas advertía al final de su artículo: cuando los módulos “de abajo” usan a los “de arriba”, ya no hay niveles, y no se puede cortar una parte del sistema y quedarse con algo que sirva.
En Tinkuy.
catalogyordersse importan mutuamente. Lo dice el grafo, y el archivosrc/catalog/events.tslo muestra en su tercera línea:import { countSeatsSoldSince } from '../orders/index.ts';El catálogo le pregunta a
orderscuántos asientos se vendieron en la última hora, para mostrarlo en el detalle de un evento. Por el otro lado,src/orders/create-order.tsempieza conimport { findEvent, findSeatsForSale, markSeatsSold } from '../catalog/index.ts';porque para vender hay que saber si el evento está en venta y marcar los asientos. Cada import, visto solo, es razonable. Juntos hacen que no se pueda cargar el catálogo sin cargar toda la compra, con la pasarela de pagos y el correo incluidos.
Un detalle de TypeScript que conviene saber: un ciclo entre módulos ES suele funcionar al ejecutarse, porque los imports se resuelven antes de correr el código y las funciones se llaman después. Por eso los ciclos no se anuncian con un error; se acumulan en silencio hasta que alguien intenta separar algo.
Estabilidad: quién depende de quién
Si los ciclos están prohibidos, toda flecha tiene que tener una dirección. La pregunta siguiente es hacia dónde conviene que apunte. La regla es:
Lo que cambia mucho debe depender de lo que cambia poco, y no al revés.
La razón es aritmética. Cada vez que cambia, todos los que dependen de pueden tener que cambiar. Si cambia todas las semanas y diez módulos dependen de él, cada semana hay diez módulos en riesgo. Si casi no cambia, que diez dependan de él no cuesta nada.
De aquí sale una noción de estabilidad que no habla de calidad sino de posición en el grafo: un módulo del que muchos dependen es caro de cambiar, le guste o no a su autor, porque cada cambio suyo se propaga. Entonces conviene que sea, además, uno que no necesite cambiar: que contenga lo más general y abstracto del sistema (las reglas del negocio, las interfaces), y no los detalles (el SQL, el formato de un mensaje, la URL de la pasarela).
dependency-cruiser calcula esto. Para cada módulo cuenta cuántos dependen de él (, acoplamiento aferente), de cuántos depende (, acoplamiento eferente) y la inestabilidad : 0 % es un módulo del que otros dependen y que no depende de nadie; 100 %, uno que depende de otros y del que nadie depende. Para las carpetas del ejemplo de la biblioteca:
$ make metrics
type    name                                                  N     Ca     Ce  I (%)        size   #tls
------- ------------------------------------------------ ------ ------ ------ ------ ----------- ------
module  src/main.ts                                           1      0      9   100%
module  src/loans/loan-desk.ts                                1      1      4    80%
module  src/members/member-desk.ts                            1      1      2    67%
folder  src/adapters/memory                                   3      3      3    50%
module  src/adapters/memory/fixed-clock.ts                    1      1      1    50%
module  src/adapters/memory/memory-loan-repository.ts         1      1      1    50%
module  src/adapters/memory/memory-member-repository.ts       1      1      1    50%
module  src/adapters/postgres/pg-loan-repository.ts           1      1      1    50%
module  src/adapters/postgres/pg-member-repository.ts         1      1      1    50%
module  src/adapters/system-clock.ts                          1      1      1    50%
module  src/loans/index.ts                                    1      5      5    50%
module  src/loans/policy.ts                                   1      1      1    50%
module  src/members/index.ts                                  1      4      4    50%
folder  src/adapters                                          7      7      6    46%
folder  src/adapters/postgres                                 3      3      2    40%
module  src/loans/ports.ts                                    1      2      1    33%
module  src/members/ports.ts                                  1      2      1    33%
folder  src/loans                                             5      5      1    17%
folder  src                                                  17      0      0     0%
module  src/adapters/postgres/pool.ts                         1      1      0     0%
module  src/loans/types.ts                                    1      4      0     0%
folder  src/members                                           4      4      0     0%
module  src/members/types.ts                                  1      3      0     0%
Hay una fila por archivo (module) y una por carpeta (folder); miren las
de las carpetas src/members, src/loans y src/adapters, y la de
main.ts. Léanlas de abajo hacia arriba. members no depende de
nadie: es lo más estable. loans depende solo de members. Los adapters
dependen de los dos, y main.ts depende de todos y nadie depende de él: es
el lugar donde un cambio no molesta a nadie. Todas las flechas del grafo van
de un módulo más inestable a uno más estable.
En Tinkuy, el mismo cálculo deja a src/orders con 81 % y a src/catalog con
63 %, y a db.ts con nueve archivos que dependen de él. La métrica no dice
qué está mal; dice dónde mirar.
Error común. Leer “estable” como “bueno” e “inestable” como “malo”. Un sistema necesita módulos inestables: son los que se pueden cambiar sin riesgo, y ahí conviene poner lo que cambia seguido. El problema no es que exista un módulo con , sino que algo que cambia mucho tenga muchos dependientes.
Inversión de dependencias
El ejemplo: una biblioteca con dos módulos
Para practicar sin tocar Tinkuy usamos un sistema mínimo, en
code/week-03/library/: el mostrador de una
biblioteca. Tiene dos módulos:
members, los socios: quién está inscrito y si su carné está activo o suspendido.loans, los préstamos: prestar un ejemplar a un socio y recibirlo de vuelta, con tres reglas. Un ejemplar prestado no se presta otra vez; un socio no puede tener más de tres libros; y quien tiene un préstamo vencido no se lleva otro. El plazo es de 14 días.
Cada módulo se usa a través de un objeto que llamamos mostrador (LoanDesk,
MemberDesk), que se crea con una función:
// library/src/loans/loan-desk.ts
export type LoanDesk = {
  lend(member: Member, copyCode: string): Promise<Loan>;
  giveBack(copyCode: string): Promise<Loan>;
  countActiveLoans(memberId: number): Promise<number>;
};
lend recibe al socio ya identificado, y por eso loans importa el tipo
Member del módulo members. Esa es la primera flecha: loans →
members. Es una dependencia natural: no se puede hablar de préstamos sin
hablar de socios.
El ciclo
Ahora llega un pedido: el carné que se muestra en el mostrador debe decir
cuántos libros tiene el socio en su poder. El carné es asunto de members;
contar préstamos es asunto de loans. La primera versión que se le ocurre a
cualquiera está en
errors/cycle/:
el mostrador de socios recibe el de préstamos y le pregunta.
// errors/cycle/src/members/member-desk.ts
import type { LoanDesk } from '../loans/index.ts';
import type { MemberRepository } from './ports.ts';

export function createMemberDesk(deps: { members: MemberRepository; activeLoans: LoanDesk }): MemberDesk {
  // ...
    async card(memberId) {
      const member = await find(memberId);
      return { member, activeLoans: await deps.activeLoans.countActiveLoans(memberId) };
    },
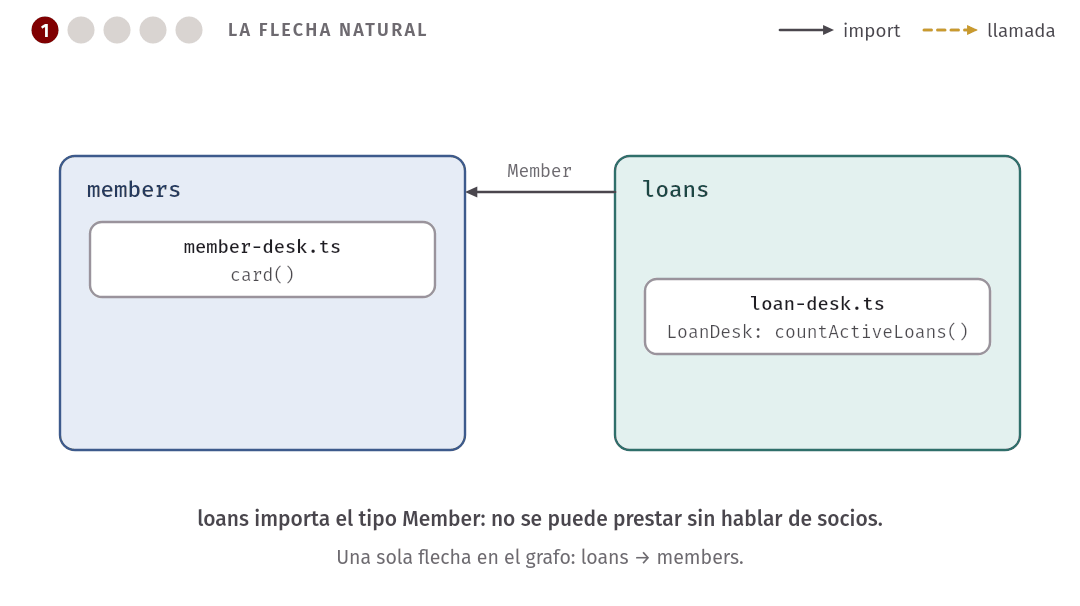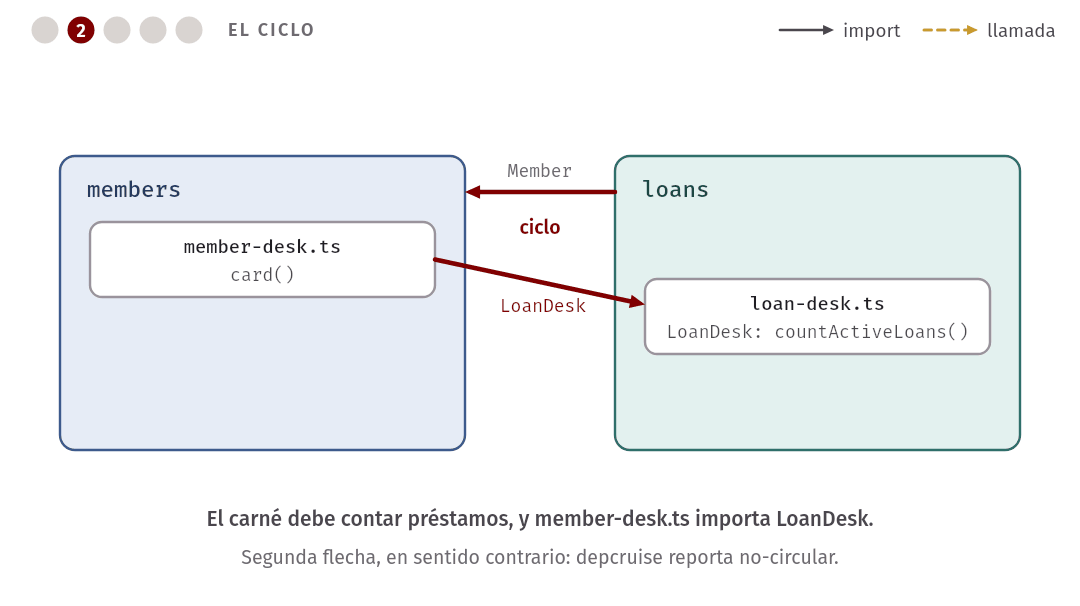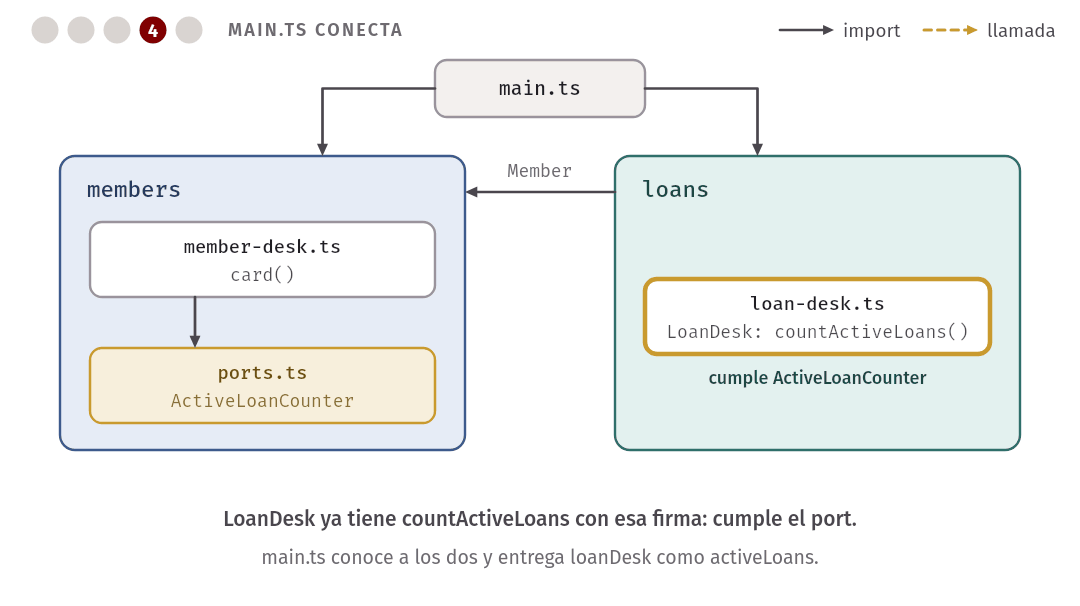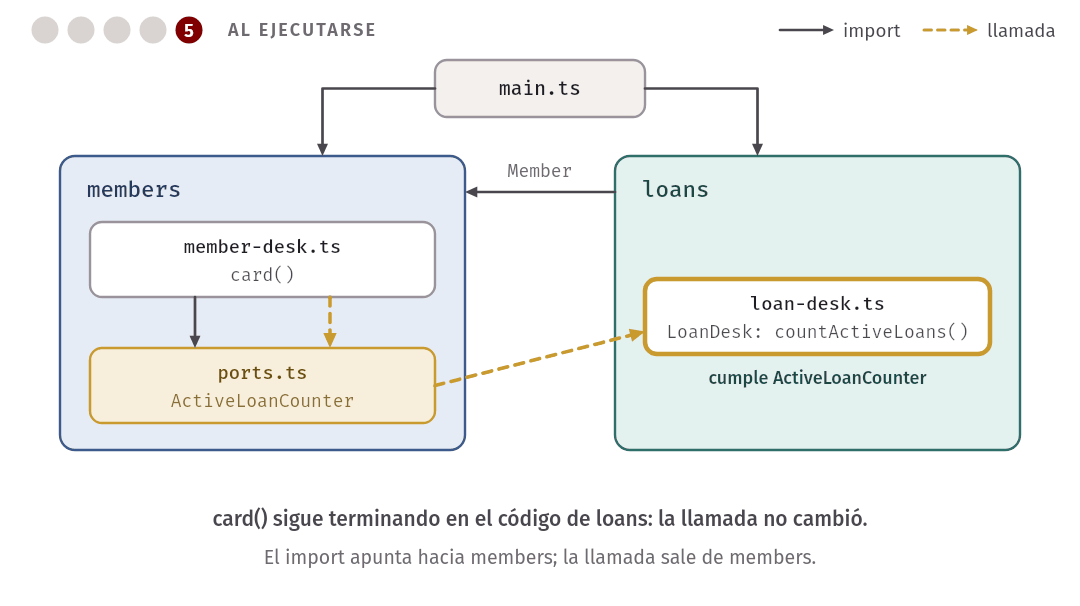
Funciona. Y con esa línea de import apareció la segunda flecha, members
→ loans, en sentido contrario a la primera. dependency-cruiser lo dice
así:
$ make errors
== errors/cycle

  error no-circular: src/loans/index.ts →
      src/loans/loan-desk.ts →
      src/members/index.ts →
      src/members/member-desk.ts →
      src/loans/index.ts

x 1 dependency violations (1 errors, 0 warnings). 18 modules, 37 dependencies cruised.

depcruise terminó con código 1
El mensaje recorre el ciclo archivo por archivo: el index.ts de loans
exporta loan-desk.ts, que importa el index.ts de members, que exporta
member-desk.ts, que importa el index.ts de loans. Vuelta completa.
Noten que los dos imports son import type: solo traen tipos, y al ejecutar
no queda nada de ellos. El ciclo existe igual. Para escribir, entender o
revisar los tipos de members hay que tener a loans, y para probar el
carné hay que construir un mostrador de préstamos completo, con su
repositorio y su reloj, aunque la prueba solo quiera comprobar que el carné
muestra un número.
Cuatro maneras de romper el ciclo
Antes de aplicar la que da nombre a la sección, las alternativas. Las cuatro quitan el ciclo; no las cuatro resuelven el problema.
1. Fusionar los dos módulos. Si members y loans cambian siempre
juntos, quizá son un módulo, y el ciclo solo lo estaba diciendo. Es la salida
honesta cuando la división nunca tuvo sentido. Aquí no parece el caso: las
reglas de préstamo cambian por razones que no tocan el registro de socios.
Cuesta un módulo más grande y con dos responsabilidades.
2. Subir la función que cruza. El carné con el conteo de préstamos
necesita a los dos módulos; entonces no pertenece a ninguno de los dos, sino
a algo que esté encima de ambos (un módulo front-desk, o el propio
main.ts), que le pregunta a members por el socio, a loans por la cuenta
y arma la respuesta. members deja de saber que existen los préstamos. Es
muchas veces la solución más simple y no necesita ninguna interfaz. Cuesta
que la operación “carné” ya no esté en el módulo donde uno la buscaría, y que
cada operación nueva que combine los dos módulos tenga que vivir arriba.
3. Mover lo compartido a un módulo shared. Se saca a un módulo nuevo lo
que los dos necesitan (aquí, la consulta que cuenta préstamos y los tipos que
usa) y los dos dependen de él. Tiene su propio recuadro más abajo, porque es
el error más frecuente.
4. Invertir una de las dos dependencias. Se elige cuál de las dos flechas no debería existir, y el módulo del que salía esa flecha deja de importar al otro: declara, en una interfaz propia, lo que necesita, y alguien se lo entrega desde afuera. Es lo que hacemos a continuación.
Error común. Romper un ciclo moviendo el código compartido a un módulo
shared(ocommon, ocore) del que todos dependen.El ciclo desaparece del grafo: ahora hay dos flechas hacia
sharedy ninguna entremembersyloans. La herramienta deja de quejarse. Pero miren qué quedó adentro deshared: la consulta sobre la tabla de préstamos, que es una decisión interna deloans. Siloanscambia cómo guarda un préstamo, hay que cambiarshared, y con él todo lo que dependa deshared. El acoplamiento es el mismo de antes, con dos agravantes: ya no se ve en el grafo, ysharedes ahora un módulo del que todos dependen y que cambia cada vez que cambia cualquiera de los otros, que es exactamente lo contrario de la regla de estabilidad. Con el tiempo,sharedtermina siendo el módulo más grande del sistema.Un módulo compartido se justifica cuando lo que contiene es de verdad independiente de los demás y cambia poco (los errores que la API sabe explicar, un tipo
Money). La señal de alarma es mover algo ahí para que la herramienta pase.
La inversión, paso a paso
Paso 1: decidir qué flecha sobra. Hay dos, loans → members y members → loans. Se aplica la regla de estabilidad: ¿cuál de los dos módulos cambia
menos y tiene más dependientes? El registro de socios es lo más básico del
sistema: lo van a usar los préstamos y, mañana, las reservas y las multas.
Las reglas de préstamo, en cambio, son política y cambian. Entonces
members debe ser el módulo estable, y la flecha que sobra es la que sale de
él: members no debería conocer a loans.
Paso 2: el módulo que queda abajo declara lo que necesita. members no
necesita un mostrador de préstamos. Necesita una sola cosa: que alguien le
diga cuántos préstamos vigentes tiene un socio. Lo escribe como una interfaz,
en su propia carpeta y con sus propias palabras:
// library/src/members/ports.ts
/**
 * Lo único que el carné necesita saber de los préstamos. Lo declara este
 * módulo y lo implementa quien sepa contar préstamos: así members no importa
 * nada de loans.
 */
export interface ActiveLoanCounter {
  countActiveLoans(memberId: number): Promise<number>;
}
Paso 3: usa esa interfaz en vez del otro módulo. El cambio en
member-desk.ts son dos líneas: el import y el tipo de la dependencia.
// library/src/members/member-desk.ts
import type { ActiveLoanCounter, MemberRepository } from './ports.ts';

export function createMemberDesk(deps: { members: MemberRepository; activeLoans: ActiveLoanCounter }): MemberDesk {
El cuerpo de card no cambia ni una letra: sigue llamando a
deps.activeLoans.countActiveLoans(memberId).
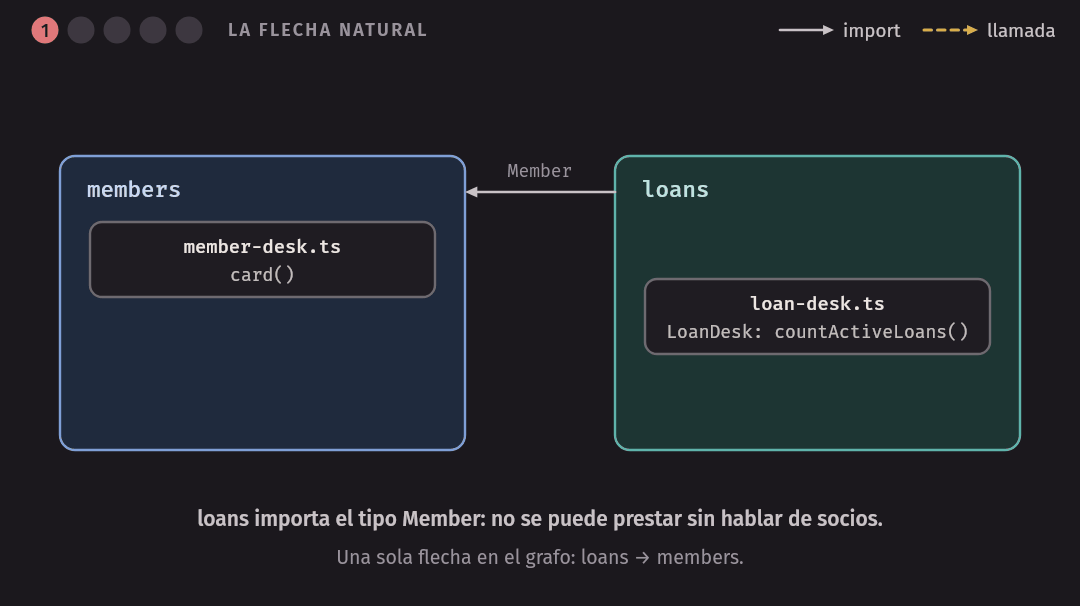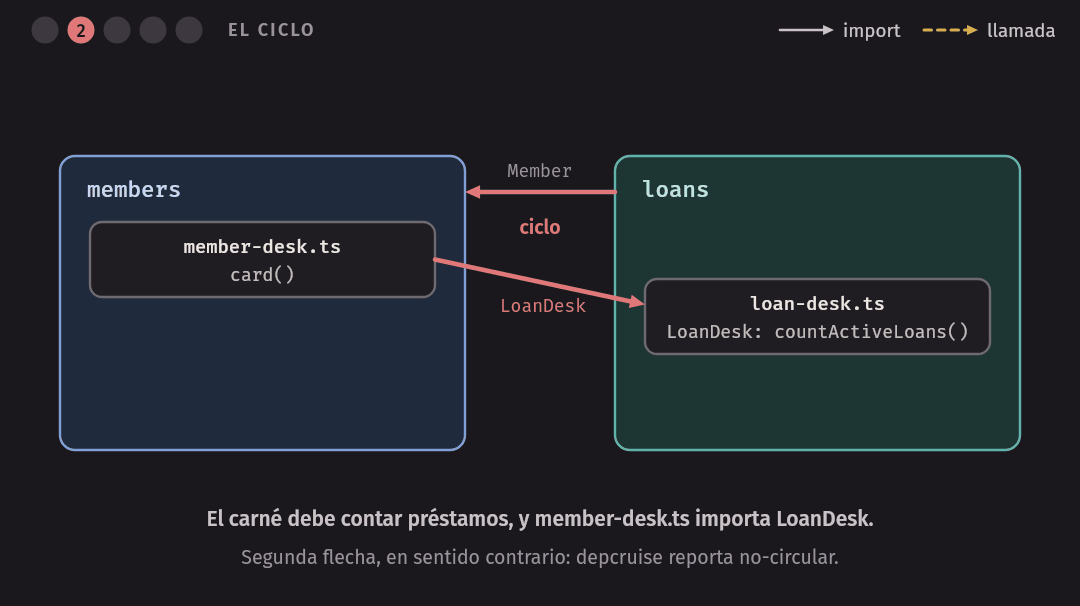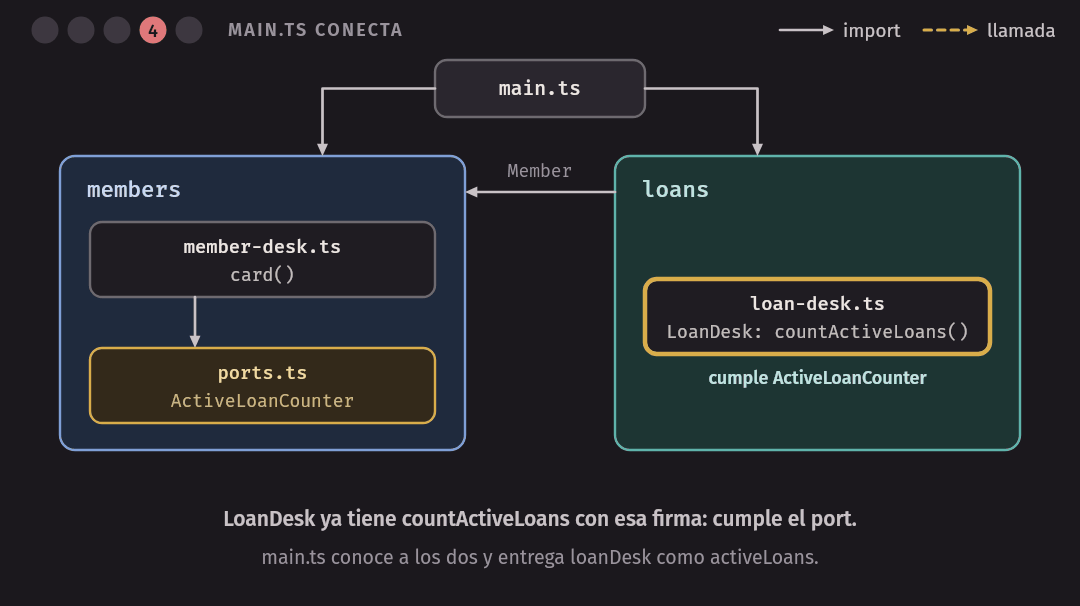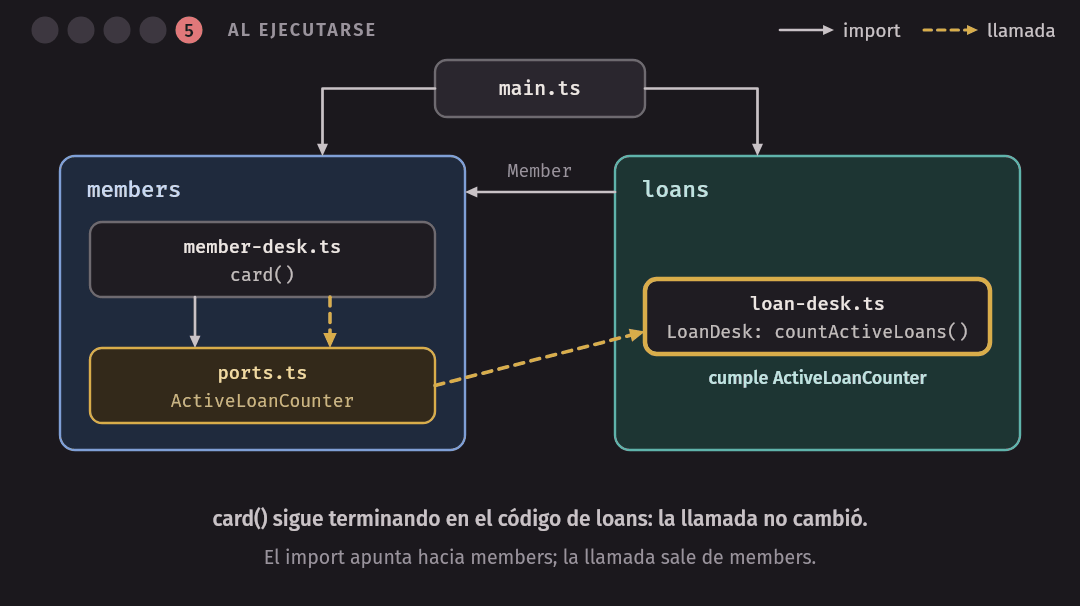
Paso 4: el otro módulo la implementa. LoanDesk ya tiene un método
countActiveLoans(memberId) con esa firma. En TypeScript eso basta: los
tipos son estructurales, y un objeto cumple una interfaz si tiene lo que la
interfaz pide, sin declarar implements.
Paso 5: alguien de afuera los conecta. Ese alguien es main.ts, que
conoce a los dos:
// library/src/main.ts
  const loanDesk = createLoanDesk({ loans: adapters.loans, clock: adapters.clock });
  // loanDesk sabe contar préstamos: cumple el port ActiveLoanCounter de members.
  const memberDesk = createMemberDesk({ members: adapters.members, activeLoans: loanDesk });
El resultado:
$ make deps
cd library && depcruise src --config .dependency-cruiser.cjs

✔ no dependency violations found (18 modules, 36 dependencies cruised)
Y la prueba del carné ya no necesita préstamos. El port se cumple con un objeto de una línea:
// library/test/member-desk.test.ts
test('el carné muestra los préstamos que le informa quien sabe contarlos', async () => {
  const memberDesk = createMemberDesk({
    members: createMemoryMemberRepository(),
    activeLoans: { countActiveLoans: async () => 2 },
  });
  const rosa = await memberDesk.register('  Rosa Quispe ');

  assert.deepEqual(await memberDesk.card(rosa.id), {
    member: { id: rosa.id, name: 'Rosa Quispe', status: 'active' },
    activeLoans: 2,
  });
});
Import hacia adentro, llamada hacia afuera
Lo que acaba de pasar tiene un nombre, inversión de dependencias (dependency inversion), y la palabra “inversión” confunde si no se separan dos cosas que antes iban juntas:
| Antes | Después | |
|---|---|---|
| ¿Quién llama a quién al ejecutarse? | members llama a loans |
members llama a loans (igual) |
| ¿Quién importa a quién en el código? | members importa a loans |
loans importa a members; members no importa a nadie |
La llamada no cambió de dirección; el import sí. Cuando el programa
corre, pedir el carné sigue terminando en el código de loans. Pero en el
código fuente members ya no nombra a loans: nombra una interfaz que es
suya. Quien se adapta a esa interfaz es loans.
Schuchert, en DIP in the Wild, resume el principio de varias maneras; dos
de ellas describen bien lo que hicimos: que la política de alto nivel no
dependa de los detalles de bajo nivel, y que las dependencias de bajo nivel
se capturen en abstracciones que tengan sentido para el dominio. La interfaz
no se llama LoanDeskLike ni copia los métodos del otro módulo: se llama
ActiveLoanCounter y tiene un solo método, porque eso es lo que members
necesita. Es un detalle que importa: la interfaz le pertenece a quien la
usa, no a quien la implementa, y por eso vive en la carpeta de members.
Idea clave. Invertir una dependencia es mover la propiedad de una interfaz. El módulo que necesita algo declara qué necesita; el que lo sabe hacer se adapta; un tercero los conecta. En el código, la flecha apunta hacia el módulo que declara. Al ejecutarse, la llamada sale de él.
Trade-off. La inversión cuesta una interfaz más, un lugar donde se conecta todo y una lectura menos directa: quien lee
cardya no puede saltar con un clic al código que cuenta los préstamos, porque ese código se decide enmain.ts. Frente a “subir la función” (alternativa 2), que no necesita interfaz, la inversión gana cuando el módulo de abajo necesita de verdad la operación para cumplir su propia responsabilidad, y pierde cuando la operación solo estaba ahí por comodidad.
Ports y adapters
La idea de Cockburn
La inversión de dependencias, aplicada con disciplina a todo lo que rodea a la lógica del negocio, da un estilo completo. Alistair Cockburn lo describió en 2005. En su artículo el patrón se llama ports y adapters, y arquitectura hexagonal es el nombre alternativo, que viene del dibujo.
El problema que quiere resolver lo plantea como dos caras de un mismo error. Por un lado, la lógica del negocio se mete en la interfaz de usuario, y entonces no se puede probar sin la pantalla ni usar desde otro programa. Por el otro, queda atada a la base de datos, y cuando la base de datos no está o cambia, nadie puede trabajar. La causa es una sola: el enredo entre la lógica y la interacción con lo que hay afuera. Y la asimetría que importa, dice, no es arriba y abajo ni izquierda y derecha: es adentro y afuera.
- Adentro está la aplicación: las reglas. En el curso lo llamamos el núcleo.
- Un port es una conversación con propósito entre el núcleo y algo de afuera, definida como una interfaz: “guardar y consultar préstamos”, “saber qué día es hoy”. El port se define por lo que el núcleo quiere conversar, no por la tecnología que hay del otro lado.
- Un adapter traduce entre un port y una tecnología concreta: PostgreSQL, HTTP, un archivo, la memoria. Para un mismo port puede haber varios adapters, y Cockburn destaca uno en particular: el que reemplaza a la base de datos por algo en memoria.
La intención del patrón, en palabras del artículo, es que la aplicación pueda ser manejada igual por usuarios, programas, pruebas automáticas o scripts, y que se pueda desarrollar y probar aislada de los dispositivos y las bases de datos con que va a correr.
Dos aclaraciones del propio Cockburn que ahorran discusiones:
- El hexágono no tiene que ver con el número seis. Es una figura con lados suficientes para dibujar varios ports sin que el dibujo sugiera “arriba” y “abajo”, como lo sugieren las capas.
- Cuántos ports es cuestión de criterio. Un port por caso de uso da cientos; uno solo para todo no dice nada. Él se inclina por pocos: dos, tres o cuatro.
Distingue además dos clases de ports. Los primarios son por donde
alguien maneja a la aplicación (un usuario, una prueba, otro programa): el
núcleo los ofrece. Los secundarios son por donde la aplicación maneja a
otro (una base de datos, una pasarela, un reloj): el núcleo los necesita.
Los que aparecen en el ejemplo de esta semana son secundarios. En Tinkuy, los
candidatos naturales son los que nombra la guía de la semana: PaymentGateway,
Clock, SeatRepository.
La regla que resume todo:
Idea clave. En ports y adapters, el núcleo no importa nada de afuera. Declara ports; los adapters lo importan a él. Todas las flechas del código apuntan hacia el núcleo.
Los dos ports del núcleo de préstamos
El núcleo de loans necesita dos cosas del mundo exterior: un lugar donde
guardar los préstamos, y saber qué día es hoy (para calcular el vencimiento y
para saber si un préstamo ya venció). Son sus dos ports:
// library/src/loans/ports.ts
/** Dónde se guardan los préstamos. */
export interface LoanRepository {
  add(loan: NewLoan): Promise<Loan>;
  /** El préstamo vigente de un ejemplar, si está prestado. */
  activeByCopy(copyCode: string): Promise<Loan | undefined>;
  /** Los préstamos vigentes de un socio, del más antiguo al más reciente. */
  activeByMember(memberId: number): Promise<Loan[]>;
  markReturned(loanId: number, returnedOn: Day): Promise<void>;
}

/** Qué día es hoy. */
export interface Clock {
  today(): Day;
}
Miren lo que no dicen. LoanRepository no menciona tablas, SQL,
conexiones ni transacciones: habla de préstamos, ejemplares y socios, en el
idioma del núcleo. Sus operaciones no son las de una tabla (insertar,
actualizar, buscar por cualquier columna) sino las que las reglas necesitan,
ni una más. Es lo que Schuchert recomienda al esconder una base de datos: que
la interfaz tenga los métodos que tienen sentido para el dominio, no para la
base de datos.
Clock parece exagerado: ¿una interfaz para llamar a new Date()? Es el
port que más rinde por línea. Una regla como “quien tiene un préstamo vencido
no se lleva otro” depende del día de hoy; con new Date() escrito dentro del
núcleo, la única manera de probarla es esperar quince días o manipular el
reloj de la máquina.
Y el núcleo, que recibe los dos ports como parámetro:
// library/src/loans/loan-desk.ts
export function createLoanDesk(deps: { loans: LoanRepository; clock: Clock }): LoanDesk {
  return {
    async lend(member, copyCode) {
      if (member.status !== 'active') {
        throw new LoanError('MEMBER_SUSPENDED', `${member.name} tiene el carné suspendido`);
      }
      if (await deps.loans.activeByCopy(copyCode)) {
        throw new LoanError('COPY_ON_LOAN', `El ejemplar ${copyCode} ya está prestado`);
      }

      const today = deps.clock.today();
      const current = await deps.loans.activeByMember(member.id);
      if (current.some((loan) => loan.dueOn < today)) {
        throw new LoanError('HAS_OVERDUE', `${member.name} tiene préstamos vencidos`);
      }
      if (current.length >= MAX_ACTIVE_LOANS) {
        throw new LoanError('LOAN_LIMIT', `${member.name} ya tiene ${MAX_ACTIVE_LOANS} libros en su poder`);
      }

      return deps.loans.add({ memberId: member.id, copyCode, lentOn: today, dueOn: dueDay(today) });
    },
    // ...
Las cuatro reglas del préstamo se leen de corrido. No hay una línea de SQL ni
un import de pg. Los únicos imports del archivo son tipos de members,
la política del propio módulo y sus ports.
Una advertencia para no llevarse una idea equivocada del ejemplo: entre
“¿está prestado?” y “guardar el préstamo” pasa tiempo, y dos pedidos
simultáneos por el mismo ejemplar podrían pasar los dos la revisión. El
esquema lo impide con un índice único sobre los préstamos vigentes de cada
ejemplar, así que el segundo terminaría en un error de la base de datos y no
en un LoanError. Hacer bien esa parte es tema de la semana 12; aquí el
ejemplo corre de a un pedido.
Adapters en memoria y de PostgreSQL
Para cada port hay dos adapters en
library/src/adapters/. El de
memoria es una lista:
// library/src/adapters/memory/memory-loan-repository.ts
export function createMemoryLoanRepository(): LoanRepository {
  const loans: Loan[] = [];

  return {
    async add(loan) {
      const saved: Loan = { ...loan, id: loans.length + 1, returnedOn: null };
      loans.push(saved);
      return { ...saved };
    },
    async activeByCopy(copyCode) {
      const found = loans.find((loan) => loan.copyCode === copyCode && loan.returnedOn === null);
      return found && { ...found };
    },
    // ...
El de PostgreSQL traduce cada operación a una consulta y cada fila a un
Loan:
// library/src/adapters/postgres/pg-loan-repository.ts
export function createPgLoanRepository(pool: pg.Pool): LoanRepository {
  return {
    // ...
    async activeByCopy(copyCode) {
      const result = await pool.query<LoanRow>(
        `SELECT ${COLUMNS} FROM loans WHERE copy_code = $1 AND returned_on IS NULL`,
        [copyCode],
      );
      return result.rows[0] && toLoan(result.rows[0]);
    },
Todo lo que el sistema sabe de la tabla loans (sus columnas, que una fecha
de devolución nula quiere decir “vigente”, que las fechas se piden como
texto) está en ese archivo. Es el line-storage.ts de la biblioteca: un
módulo que esconde una decisión de representación.
Para Clock también hay dos: systemClock, que lee el reloj de la
computadora, y createFixedClock(day), que marca el día que se le diga y
tiene un set para moverlo.
Las flechas, otra vez:
src/adapters → src/loans
src/adapters → src/members
Los adapters importan al núcleo (para conocer la interfaz que deben cumplir).
El núcleo no importa a los adapters. Si mañana la biblioteca guarda sus
préstamos en otra base de datos, se escribe un adapter nuevo y no se abre
loan-desk.ts.
El composition root y dependency injection
Alguien tiene que elegir los adapters, crearlos y pasárselos al núcleo. Esa
tarea se llama dependency injection: un objeto no crea lo que necesita;
lo recibe. Y el lugar del programa donde se hace se llama composition
root. En el ejemplo es main.ts:
// library/src/main.ts
function chooseAdapters(inMemory: boolean): Adapters {
  if (inMemory) {
    return {
      loans: createMemoryLoanRepository(),
      members: createMemoryMemberRepository(),
      clock: createFixedClock('2026-03-02'),
      close: async () => {},
    };
  }
  const pool = createPool();
  return {
    loans: createPgLoanRepository(pool),
    members: createPgMemberRepository(pool),
    clock: systemClock,
    close: () => pool.end(),
  };
}
Es el único archivo que conoce a todos: importa los dos módulos del núcleo y todos los adapters. No tiene reglas del negocio, y por eso no importa que sea el más inestable del sistema ( en la tabla de métricas): cambia cada vez que cambia el armado, y nadie depende de él.
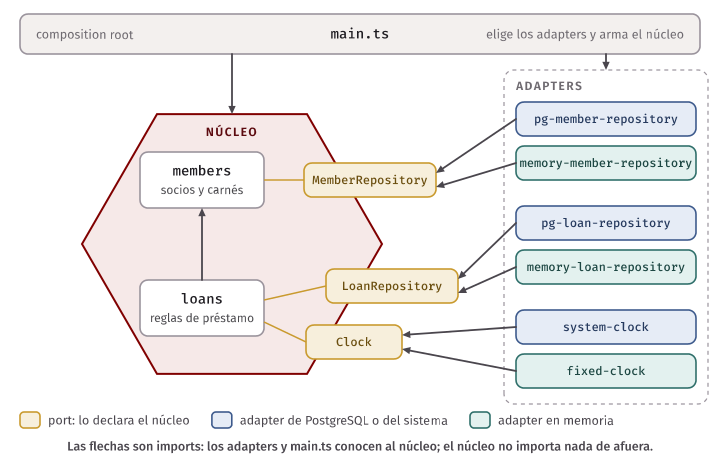
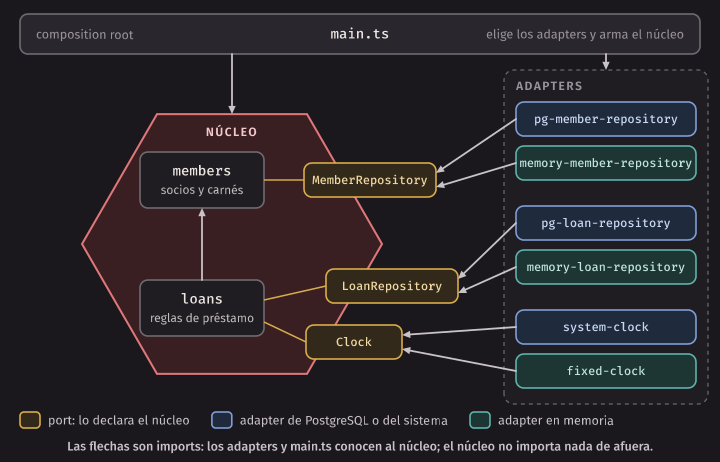
El mismo programa, armado de las dos maneras:
$ make run
== en memoria
Prestado YAW-001 a Rosa Quispe hasta el 2026-03-16
Prestado RIO-001 a Rosa Quispe hasta el 2026-03-16
Rechazado (COPY_ON_LOAN): El ejemplar YAW-001 ya está prestado
Carné de Rosa Quispe: 2 libros en su poder
== con PostgreSQL
Prestado YAW-001 a Rosa Quispe hasta el 2026-11-30
Prestado RIO-001 a Rosa Quispe hasta el 2026-11-30
Rechazado (COPY_ON_LOAN): El ejemplar YAW-001 ya está prestado
Carné de Rosa Quispe: 2 libros en su poder
Las fechas difieren porque la primera corrida usa el reloj fijo y la segunda el de la computadora, con el día en que se corrió. Las reglas son las mismas porque el código que las contiene es el mismo.
No hace falta un framework para esto. Un framework de dependency injection busca las implementaciones y las conecta solo, a partir de anotaciones o de configuración. Con una decena de objetos, parámetros y un archivo que arma todo alcanzan, y tienen una ventaja: el armado se puede leer de arriba abajo y el compilador lo revisa.
Trade-off. Un framework de dependency injection ahorra escribir el armado a mano cuando hay cientos de objetos con ciclos de vida distintos. A cambio, el grafo de objetos deja de estar escrito en un lugar: se arma al ejecutarse, y un error de conexión aparece al arrancar y no al compilar. Para el tamaño de los sistemas del curso, el armado a mano es más corto que la configuración del framework.
Probar el núcleo sin base de datos
La consecuencia práctica que Cockburn pone primero es la de las pruebas. Con el núcleo armado sobre adapters en memoria y un reloj fijo, una prueba de las reglas no necesita nada corriendo:
// library/test/loan-desk.test.ts
test('un préstamo vence 14 días después, según el reloj que recibe el núcleo', async () => {
  const { loanDesk, memberDesk } = memoryLibrary(); // el reloj marca 2026-03-02
  const rosa = await memberDesk.register('Rosa Quispe');

  const loan = await loanDesk.lend(rosa, 'YAW-001');

  assert.equal(loan.lentOn, '2026-03-02');
  assert.equal(loan.dueOn, '2026-03-16');
  assert.equal(await loanDesk.countActiveLoans(rosa.id), 1);
});memoryLibrary(), en library/wiring.ts,
es un composition root para pruebas: arma los dos mostradores con
repositorios en memoria y un reloj que empieza el 2 de marzo de 2026. La
prueba no crea una base de datos, no carga un esquema, no borra tablas al
terminar, no puede chocar con otra prueba que corra al mismo tiempo y no
depende del día en que se ejecute.
Lo último merece una pausa. Con el reloj como port, las reglas que dependen del tiempo se prueban moviendo el reloj:
  const { loanDesk, memberDesk, clock } = memoryLibrary();
  // ...
  clock.set('2026-03-17');
Escribir las pruebas de las reglas de vencimiento es parte del laboratorio.
Cuánto tarda cada prueba
Las mismas tres pruebas del núcleo existen también con los adapters de
PostgreSQL, en library/test/pg-loan-desk.test.ts. Los tiempos que reporta
node --test para la misma prueba, con cada juego de adapters (en una laptop
con Apple Silicon, dentro de Docker):
✔ un socio no se lleva un cuarto libro (0.31275ms)
✔ PostgreSQL: un socio no se lleva un cuarto libro (4.451792ms)
Para comparar con más de tres casos, library/timing.ts
corre el mismo escenario (un socio se lleva un libro, se consulta su carné y
lo devuelve) 200 veces con cada juego:
$ make timing
200 préstamos con consulta de carné y devolución
  adapters en memoria:     1.8 ms
  adapters de PostgreSQL:  147.0 ms
  PostgreSQL tarda 84 veces más
En otras dos corridas seguidas en la misma máquina la razón fue 54 y 81: el número exacto no importa y cambia de una corrida a otra. Lo que se sostiene es el orden de magnitud. En memoria, una operación es una búsqueda en una lista; con PostgreSQL, cada una cruza un socket, y la base de datos está en la misma máquina: con una red de por medio la distancia crece.
Dos precisiones para no exagerar el resultado:
- Con tres pruebas, la diferencia no se nota. Correr el archivo completo de pruebas del núcleo tomó 95 ms y el de PostgreSQL 122 ms, porque casi todo ese tiempo es arrancar Node. La diferencia pesa cuando hay cientos de pruebas, que es cuando un equipo empieza a dejar de correrlas.
- El tiempo no es el costo principal. Las pruebas con PostgreSQL necesitan
una base de datos creada con su esquema, vaciar las tablas antes de cada
una y correr un archivo después de otro para no pisarse (por eso el
Makefileusa--test-concurrency=1). Las del núcleo no necesitan nada de eso.
Idea clave. Ports y adapters no elimina las pruebas con base de datos: las reduce a las que prueban el adapter. Las reglas del negocio, que son las que más casos tienen, se prueban en memoria.
El contrato de un port
Hay una objeción seria a todo lo anterior: las pruebas del núcleo pasan con el repositorio en memoria, pero en producción corre el de PostgreSQL. ¿Qué garantiza que se comportan igual? Si el adapter en memoria devuelve los préstamos de un socio en un orden y el de PostgreSQL en otro, las pruebas del núcleo están comprobando un sistema que no existe.
La respuesta es escribir lo que el núcleo supone de cualquier adapter como
un conjunto de pruebas, y correr ese mismo conjunto contra cada uno. Es el
contrato del port, en
library/test/repository-contract.ts:
export function loanRepositoryContract(adapter: string, setup: ContractSetup): void {
  // ...
  test(`${adapter}: un préstamo devuelto deja de estar vigente`, async () => {
    const { loans, memberId } = await setup();
    const saved = await loans.add({ memberId, copyCode: 'YAW-001', lentOn: '2026-03-02', dueOn: '2026-03-16' });

    await loans.markReturned(saved.id, '2026-03-10');

    assert.equal(await loans.activeByCopy('YAW-001'), undefined);
    assert.deepEqual(await loans.activeByMember(memberId), []);
  });
Dos archivos de pocas líneas lo aplican, uno a cada adapter, y en la salida
de make test aparece cada comprobación dos veces:
✔ memoria: un préstamo devuelto deja de estar vigente (0.1235ms)
✔ PostgreSQL: un préstamo devuelto deja de estar vigente (6.510292ms)
El contrato es la interfaz del port en el sentido amplio de la primera
sesión: todo lo que el núcleo puede suponer. La firma en TypeScript dice que
activeByMember devuelve una lista de préstamos; el contrato dice además que
vienen del más antiguo al más reciente y que no incluyen los de otro socio.
Tiene un límite que hay que conocer: el contrato comprueba lo que a alguien se le ocurrió escribir. Lo que hace PostgreSQL y una lista no hace (restricciones, transacciones, dos pedidos a la vez) queda fuera, y por eso las pruebas con el sistema armado de verdad no desaparecen.
Cuándo un port no vale lo que cuesta
Trade-off. Cada interfaz es indirección que alguien tiene que leer. Un port agrega un archivo, un adapter, una línea en el composition root y un salto más para quien sigue el código. Eso se paga siempre. Lo que se gana depende de que el port se use.
Un port se justifica cuando hay, al menos, una de estas cosas:
- Un cambio probable del otro lado: otra pasarela de pagos, otro proveedor de correo.
- Una frontera que se quiere proteger: que las reglas del negocio no se llenen de SQL, o que un módulo no conozca a otro.
- Pruebas que lo aprovechan: reglas que dependen del tiempo, de un servicio externo lento o caro, o de fallas difíciles de provocar.
Y no se justifica cuando tiene una sola implementación, nadie espera otra, y
ninguna prueba usa un sustituto. Un StringFormatter con su interfaz y su
única clase, o un port por cada tabla en un sistema que solo hace altas y
consultas simples, son costo sin beneficio. En el ejemplo de la biblioteca,
pool.ts no tiene port: es un detalle de los adapters de PostgreSQL y nadie
más lo usa.
Schuchert cierra su artículo con la misma cautela: si el software va a vivir poco, depender directamente de esas dependencias puede ser lo mejor para ese contexto. Y Cockburn, sobre la cantidad de ports, admite que es cuestión de criterio. Ninguno de los dos propone poner una interfaz delante de todo.
En la industria. El sistema central de Shopify es un monolito grande, escrito en Ruby on Rails. En 2020 la empresa contó en su blog de ingeniería que haber ordenado el código en carpetas por dominio no bastó: las llamadas entre componentes seguían cruzando por cualquier parte porque no había, en sus palabras, ninguna pared, solo un acuerdo social fácil de romper. La respuesta fue Packwerk, una herramienta de análisis estático que comprueba dos clases de límites entre paquetes: de dependencia (un paquete solo usa a los que declaró) y de privacidad (desde afuera solo se usa lo que el paquete publica). Son las mismas dos ideas de la sección que sigue. Fuente: Maple Ong, Enforcing Modularity in Rails Apps with Packwerk (Shopify Engineering, 23 de septiembre de 2020).
Reglas que se comprueban
La interfaz pública: un index.ts
Todo lo de esta semana depende de que los límites se respeten, y un límite que solo está en la cabeza de quien lo diseñó dura hasta el primer apuro. Cockburn lo observa sobre las capas: se promete que “esta vez” no habrá lógica del negocio en la capa equivocada y, como no hay ningún mecanismo que detecte cuándo se viola la promesa, unos años después la capa está llena de lógica.
El primer paso para poder comprobar un límite es que esté escrito en el
código. En TypeScript no hay una palabra para “privado del módulo” cuando un
módulo es una carpeta: cualquier archivo puede importar cualquier otro. La
convención del curso es que cada módulo tiene un index.ts que exporta lo
que los demás pueden usar, y todo lo demás es interno:
// library/src/loans/index.ts
// Préstamos: prestar y devolver ejemplares. Esto es lo que los demás módulos
// pueden usar; la política (policy.ts) queda adentro.

export { createLoanDesk } from './loan-desk.ts';
export type { LoanDesk } from './loan-desk.ts';
export type { Clock, LoanRepository } from './ports.ts';
export { LoanError } from './types.ts';
export type { Day, Loan, LoanErrorCode, NewLoan } from './types.ts';
Ese archivo es la interfaz del módulo, en una pantalla. policy.ts, con el
plazo de 14 días y el máximo de tres libros, no aparece: es una decisión
escondida. El día que el plazo dependa del tipo de socio, policy.ts se
puede reescribir entero.
La regla “un módulo solo importa a otro por su index.ts” convierte el
ocultamiento de información en algo que un programa puede revisar.
Error común. Un
index.tsque haceexport * fromde todos los archivos de la carpeta. Cumple la regla al pie de la letra y no esconde nada: la interfaz pública es el módulo entero. Lo que se exporta se decide nombre por nombre, y la pregunta para cada uno es quién de afuera lo necesita.
dependency-cruiser
dependency-cruiser lee los imports de un proyecto, arma el grafo de archivos
y lo compara con una lista de reglas escritas en .dependency-cruiser.cjs.
Cada regla prohibida tiene un nombre, un from (qué archivos están sujetos a
la regla) y un to (qué no pueden importar). Si algún import coincide con
los dos, es una violación; depcruise las lista y termina con un código de
salida distinto de cero, que es lo que hace fallar un build.
Las condiciones más usadas dentro de from y to:
| Condición | Qué significa |
|---|---|
path |
La ruta del archivo coincide con esta expresión regular (o con alguna de una lista) |
pathNot |
La ruta no coincide |
circular: true (solo en to) |
El import forma parte de un ciclo |
$1, $2 en to |
El texto que capturó el primer (segundo) paréntesis del path de from |
Un from vacío ({}) quiere decir “cualquier archivo”.
Las tres reglas del ejemplo
El archivo
library/.dependency-cruiser.cjs
tiene una regla de cada una de las tres clases que van a usar todo el
semestre.
Sin ciclos.
    {
      name: 'no-circular',
      comment: 'Ningún archivo depende de sí mismo, ni directamente ni a través de otros.',
      severity: 'error',
      from: {},
      to: { circular: true },
    },
Una capa no toca lo que no le corresponde. Aquí, el núcleo no importa el driver de la base de datos ni ningún adapter:
const CORE = '^src/(loans|members)/';

    {
      name: 'core-does-not-touch-infrastructure',
      comment: 'El núcleo no importa el driver de la base de datos ni ningún adapter: declara ports.',
      severity: 'error',
      from: { path: CORE },
      to: { path: ['^pg$', 'node_modules/pg/', '^src/adapters/'] },
    },
from selecciona los archivos de src/loans/ y src/members/. to lista
tres rutas prohibidas: el paquete pg por su nombre, el paquete pg por la
carpeta donde está instalado (dependency-cruiser reporta la ruta real del
archivo, que en el contenedor termina en node_modules/pg/lib/index.js) y
cualquier archivo de src/adapters/.
A un módulo se entra solo por su index.ts.
    {
      name: 'modules-only-through-index',
      comment: 'A un módulo del núcleo se entra solo por su index.ts, nunca por sus archivos internos.',
      severity: 'error',
      // $1 es la primera carpeta (o archivo) bajo src/ de quien importa.
      from: { path: '^src/([^/]+)' },
      to: { path: CORE, pathNot: ['^src/$1/', '/index\\.ts$'] },
    },
Esta es la más difícil de leer, así que vale la pena desarmarla. El path de
from captura entre paréntesis el primer tramo después de src/: para
src/members/member-desk.ts captura members; para src/main.ts, captura
main.ts. El to dice: está prohibido importar un archivo del núcleo
(path: CORE) salvo que esté en la misma carpeta que quien importa
(^src/$1/, con $1 reemplazado por lo capturado) o que sea un index.ts.
Dentro de su propio módulo, un archivo importa lo que quiera; hacia otro
módulo, solo el índice.
Las opciones del final del archivo tienen una línea que importa:
    // Los imports de solo tipos también son dependencias.
    tsPreCompilationDeps: true,
Sin ella, dependency-cruiser miraría el código después de quitar los tipos, y
un import type no contaría. El ciclo de la sección anterior, hecho solo de
tipos, pasaría sin ser visto.
Tres maneras de romperlas
En errors/ hay tres variantes del ejemplo, cada
una con un archivo que rompe una regla. make errors copia el ejemplo a
build/, le pone encima el archivo de cada variante y corre depcruise. La
primera es el ciclo, que ya vimos. Las otras dos:
== errors/driver-in-core

  error core-does-not-touch-infrastructure: src/loans/loan-desk.ts → ../../../../../../../opt/course/node_modules/pg/lib/index.js

x 1 dependency violations (1 errors, 0 warnings). 18 modules, 37 dependencies cruised.

depcruise terminó con código 1
== errors/deep-import

  error modules-only-through-index: src/adapters/overdue-notice.ts → src/loans/policy.ts

x 1 dependency violations (1 errors, 0 warnings). 19 modules, 38 dependencies cruised.

depcruise terminó con código 1
En driver-in-core, alguien necesitaba contar los préstamos de un socio y
escribió la consulta dentro del núcleo:
// errors/driver-in-core/src/loans/loan-desk.ts
import pg from 'pg';
// ...
const pool = new pg.Pool({ database: process.env.LIBRARY_DB ?? 'arq_w03', max: 1 });
// ...
    // El atajo: el núcleo le habla a la tabla directamente.
    async countActiveLoans(memberId) {
      const result = await pool.query<{ total: number }>(
        'SELECT count(*)::int AS total FROM loans WHERE member_id = $1 AND returned_on IS NULL',
        [memberId],
      );
      return result.rows[0]!.total;
    },
Funciona, y es más corto que pasar por el port. Desde ese commit, el núcleo
ya no se puede probar sin base de datos (el archivo crea su propio pool de
conexiones con solo ser importado, y contar préstamos pasa por él), y hay dos
lugares que saben que returned_on IS NULL
quiere decir “vigente”.
En deep-import, un adapter nuevo que redacta el aviso de vencimiento
necesitaba el plazo del préstamo y lo importó de donde estaba:
// errors/deep-import/src/adapters/overdue-notice.ts
import type { Loan } from '../loans/index.ts';
import { LOAN_DAYS } from '../loans/policy.ts';
La primera línea está bien; la segunda entra a un archivo interno. El día que
el plazo dependa del tipo de socio y LOAN_DAYS deje de existir, se rompe un
archivo que el equipo de préstamos ni sabía que existía.
Las dos violaciones tienen el mismo origen: era el camino más corto. Las reglas no existen porque el equipo no sepa lo que está bien; existen porque bajo presión el camino corto gana, y un build que falla es más difícil de ignorar que un documento.
Las cuatro violaciones de Tinkuy
Con ese vocabulario, la salida de make deps en Tinkuy se puede leer línea
por línea:
$ make tinkuy-deps
depcruise src --config .dependency-cruiser.cjs

  error no-circular: src/catalog/events.ts →
      src/orders/index.ts →
      src/orders/create-order.ts →
      src/catalog/index.ts →
      src/catalog/events.ts
  error modules-only-through-index: src/reports/sales-report.ts → src/orders/order-repository.ts
  error modules-only-through-index: src/reports/sales-report.ts → src/catalog/events.ts
  error http-does-not-touch-db: src/http/order-handlers.ts → src/db.ts

x 4 dependency violations (4 errors, 0 warnings). 35 modules, 86 dependencies cruised.

make[1]: *** [Makefile:51: deps] Error 4| # | Regla | Qué dice |
|---|---|---|
| 1 | no-circular |
catalog/events.ts importa el índice de orders, que exporta create-order.ts, que importa el índice de catalog, que exporta events.ts. Es el ciclo entre catalog y orders |
| 2 | modules-only-through-index |
El reporte importa order-repository.ts, un archivo interno de orders, para usar la constante ORDER_STATUS |
| 3 | modules-only-through-index |
El reporte importa catalog/events.ts, otro archivo interno, para usar findEvent |
| 4 | http-does-not-touch-db |
El handler de GET /orders/:id importa db.ts y hace sus propias consultas con SQL, sin pasar por el módulo orders |
Las cuatro son del mismo tipo que las del ejemplo, y ninguna impide que
Tinkuy funcione: make check pasa. Por eso make deps todavía no forma
parte de make check. Una de ellas deja de violarse en P0, y desde P1 las
reglas se comprueban en cada build.
Fíjense en el código de salida: Error 4. depcruise termina con el número
de violaciones como código, así que cualquier valor distinto de cero corta
el build.
Escribir una regla nueva
Una regla se escribe cuando el equipo toma una decisión y quiere que se
sostenga. Ejemplo, sobre la biblioteca: se decide que solo los adapters de
PostgreSQL pueden importar pg. La regla del núcleo ya impide que loans
y members lo hagan, pero nada impide hoy que main.ts, o un adapter de
otra carpeta, abra su propia conexión.
El procedimiento es siempre el mismo, y el orden importa:
-
Escribir la regla. Se piensa primero el
to(qué es lo que se protege) y después elfrom(quién no puede tocarlo), casi siempre conpathNotpara dejar pasar a los únicos autorizados:{ name: 'only-postgres-adapters-use-pg', comment: 'La conexión a PostgreSQL es asunto de src/adapters/postgres.', severity: 'error', from: { pathNot: '^src/adapters/postgres/' }, to: { path: ['^pg$', 'node_modules/pg/'] }, } -
Comprobar que pasa con el código como está.
-
Comprobar que falla cuando alguien la viola: se agrega a propósito un
import pg from 'pg'enmain.ts, se corredepcruisey se lee el mensaje. Este paso es el que más se omite, y sin él no se sabe si la regla está comprobando algo. Una expresión regular mal escrita no coincide con nada, y una regla que no coincide con nada pasa siempre. -
Quitar el import y volver a correr.
Es el mismo ciclo que con una prueba: primero se la ve fallar.
Lo que la herramienta no puede comprobar
Una regla comprobada tiene una ventaja clara sobre la misma regla escrita en
el README: se revisa en cada cambio, sin depender de que alguien la recuerde,
y cuando se rompe dice el archivo y la línea. Es la primera fitness
function del curso, una comprobación automática que protege una decisión de
arquitectura; las retomamos en la semana 15, donde make deps se junta con
los umbrales de latencia y las pruebas de fallas.
Pero dependency-cruiser solo ve imports. No ve nada de esto:
- Acoplamiento por la base de datos. Dos módulos que no se importan y leen la misma tabla, cada uno con su SQL, no tienen ninguna flecha entre ellos. El grafo los muestra independientes.
- Acoplamiento a través de un módulo permitido. El
shareddel error común pasa todas las reglas. - Si la interfaz es buena. La herramienta comprueba que se entre por el
index.ts; no puede decir si ese índice exporta demasiado. - Si la división es la correcta. Un sistema puede cumplir todas sus reglas y estar dividido por pasos, como el primer KWIC.
- Connascence dinámica. Que un módulo suponga el orden o el momento en que otro hace las cosas no deja rastro en los imports.
Idea clave. Una regla de dependencia comprueba que se respete un límite que alguien decidió. Decidir dónde va el límite sigue siendo trabajo de diseño, y se hace con la pregunta de toda la semana: qué cambio se espera y cuántos módulos debería tocar.
El código de la semana
Todo está en code/week-03 y se usa dentro del contenedor del curso, desde esa carpeta.
| Carpeta o archivo | Qué contiene |
|---|---|
kwic/steps/ |
El índice KWIC dividido por pasos del procesamiento (la primera descomposición de Parnas) |
kwic/decisions/ |
El mismo programa, con un módulo por decisión de diseño (la segunda) |
kwic/change/ |
Los archivos que hubo que reescribir en cada una cuando cambió la forma de guardar las líneas |
kwic/change.ts, kwic/variants.ts |
El experimento: aplica el cambio, corre tsc y cuenta |
coupling/connascence.ts |
Connascence de posición, de significado y de nombre en una misma función |
library/src/loans/, library/src/members/ |
El núcleo de la biblioteca: dos módulos, cada uno con su index.ts y sus ports |
library/src/adapters/ |
Los adapters en memoria y de PostgreSQL, y los dos relojes |
library/src/main.ts |
El composition root |
library/.dependency-cruiser.cjs |
Las tres reglas de dependencia del ejemplo |
library/test/ |
Las pruebas del núcleo sin base de datos, las mismas con PostgreSQL, el contrato del repositorio y las de las reglas |
errors/cycle/, errors/driver-in-core/, errors/deep-import/ |
Un archivo por variante, cada uno rompe una regla |
lab/loan-desk.test.ts |
El archivo de partida del paso 5 del laboratorio |
Los comandos:
| Comando | Qué hace |
|---|---|
make |
Crea la base de datos arq_w03 con el esquema de la biblioteca y copia Tinkuy en build/tinkuy |
make test |
Revisa los tipos con tsc y corre todas las pruebas |
make kwic |
El índice KWIC con las dos descomposiciones |
make kwic-change |
El experimento de Parnas |
make run |
El ejemplo de la biblioteca, en memoria y con PostgreSQL |
make deps, make graph, make metrics |
Las reglas del ejemplo, su grafo de módulos como texto y sus métricas de estabilidad |
make errors |
Las tres variantes de errors/, cada una con su violación |
make timing |
El mismo escenario con adapters en memoria y de PostgreSQL |
make tinkuy-deps, make tinkuy-graph |
Las violaciones y el grafo de módulos de Tinkuy, sobre la copia de build/ |
make clean |
Borra build/ y la base de datos |
make test termina así:
ℹ tests 36
ℹ suites 0
ℹ pass 31
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 5
Los cinco pendientes (todo) son las pruebas que van a escribir en el paso 5
del laboratorio.
Cada afirmación del capítulo que se puede comprobar tiene su prueba. Algunas:
| Afirmación | Prueba |
|---|---|
| Las dos descomposiciones producen el mismo listado | kwic/kwic.test.ts |
| Por pasos, cambiar el formato rompe los otros tres módulos | kwic/kwic.test.ts (corre tsc sobre la copia a medio cambiar) |
| Por decisiones, el cambio reescribe un solo archivo | kwic/kwic.test.ts |
| Con los argumentos al revés, compila y la multa desaparece | coupling/connascence.test.ts |
| El carné se prueba sin el módulo de préstamos | library/test/member-desk.test.ts |
| Los dos adapters cumplen el mismo contrato | library/test/memory-repository.test.ts y pg-repository.test.ts |
El ejemplo cumple sus reglas y cada variante de errors/ rompe exactamente una |
library/test/deps.test.ts |
| El mismo escenario tarda menos en memoria que con PostgreSQL | library/test/timing.test.ts |
Laboratorio: reglas de dependencia y un ciclo que romper
El laboratorio se hace en parejas, sobre su copia de Tinkuy (el repositorio que crearon para el proyecto), y usa el material de code/week-03. La guía con los pasos está en la guía de la semana; aquí va qué muestra cada uno y en qué fijarse. Los pasos 3, 4 y 7 son trabajo que también pide el proyecto: por eso el capítulo los resolvió sobre la biblioteca y no sobre Tinkuy.
Paso 1: leer las violaciones. make deps en su Tinkuy debe dar las
cuatro de la sección Las cuatro violaciones de Tinkuy. No las arreglen
todavía. Para cada una, abran los dos archivos que nombra y encuentren la
línea del import. Clasificarlas por regla es fácil; lo que el paso busca es
que puedan decir, para cada una, qué cambio futuro la volvería un
problema.
Paso 2: leer las reglas y sacar el grafo. Abran .dependency-cruiser.cjs
de Tinkuy con la tabla de path, pathNot y $1 al lado. Después generen
el grafo de módulos como texto con el comando de la sección De los imports
al grafo (en code/week-03/, make tinkuy-graph lo corre sobre la copia de
build/; en su repositorio, copien el comando). Compárenlo con el que
dibujaron a mano en la semana 1: qué flechas les faltaron y cuáles dibujaron
que no existen. Las que más se escapan son las que llegan a archivos sueltos
como db.ts.
Paso 3: seguir el ciclo. El mensaje de no-circular da el recorrido
archivo por archivo. Anoten, con el nombre de cada función importada, qué
necesita catalog de orders y qué necesita orders de catalog. Después
discutan cuál de las dos dependencias no debería existir. Usen los dos
criterios del capítulo: cuál de los dos módulos debería ser el más estable, y
cuál de las dos necesidades es parte de la responsabilidad del módulo y cuál
está ahí por comodidad. Escriban la razón: va a ser el contexto de un ADR.
Paso 4: romper el ciclo. Aplíquenle a Tinkuy los cinco pasos de La
inversión, paso a paso. Antes de escribir código, repasen las Cuatro
maneras de romper el ciclo y decidan por qué eligen esa y no “subir la
función”. Dos comprobaciones al terminar: make deps reporta una violación
menos, y make test sigue pasando sin haber tocado ninguna prueba. Si
tuvieron que cambiar una prueba, cambió el comportamiento y no solo la
estructura.
Paso 5: el núcleo sin base de datos. Ahora con la biblioteca. Lean
library/test/loan-desk.test.ts y completen los cinco pendientes de
lab/loan-desk.test.ts:
node --test lab/loan-desk.test.tsDos de ellos necesitan mover el reloj con clock.set(...), y uno tiene una
trampa: lend recibe al socio ya identificado, así que después de suspender
un carné hay que volver a buscar al socio. Después corran make timing tres
veces y anoten los tiempos y la máquina. ¿Cuánto varía la razón entre una
corrida y otra? ¿Qué pueden afirmar y qué no con esos números?
Paso 6: una regla nueva. En su Tinkuy, escriban la regla que pide la
guía: ningún archivo fuera de src/payments puede importar el cliente HTTP
de la pasarela. Sigan el procedimiento de Escribir una regla nueva: que
pase, que falle con un import puesto a propósito, que vuelva a pasar. Cuando
la vean fallar, cuenten cuántas reglas reporta depcruise para ese mismo
import. Si son dos, piensen qué casos cubre la regla nueva que la otra no
cubría (pista: miren el from de modules-only-through-index y pregúntense
qué pasa con un archivo que está directamente en src/).
Paso 7: una violación de modules-only-through-index. Elijan una de las
dos del reporte y corríjanla sin exportar todo desde el index.ts. Hay
dos preguntas que hacerse antes de agregar un export: si lo que el reporte
necesita ya es público, y si lo que falta debería serlo o es una señal de que
el reporte está haciendo el trabajo de otro módulo. Anoten qué quedó expuesto
y qué dejó de estarlo.
Resumen
- Un módulo es una unidad de código con una responsabilidad y una interfaz. La estructura de módulos responde qué toca un cambio y quién puede trabajar en paralelo; por eso es la base de la modificabilidad.
- La modificabilidad se escribe como escenario. Su medida más útil para diseñar es cuántos módulos toca un cambio probable.
- Parnas (1972): el mismo programa dividido por pasos del procesamiento y dividido por decisiones de diseño. Las dos funcionan; cuando cambia la forma de guardar los datos, la primera se reescribe casi entera y la segunda en un solo módulo. El criterio: dividir por lo que puede cambiar, no por el orden en que se ejecuta.
- Ocultamiento de información: la interfaz de un módulo es todo lo que los demás pueden suponer de él. Un módulo que expone sus tablas, sus tipos internos o su orden de llamadas no esconde nada.
- Cohesión: un módulo cohesivo cambia entero y por una razón. Dividir por capa técnica da carpetas que no cambian juntas y cambios que las tocan todas.
- Acoplamiento: importa de qué se depende, no solo de quién. Connascence da el vocabulario (de nombre, de tipo, de significado, de posición, de algoritmo, y las dinámicas) y la regla: cuanto más lejos, más débil debe ser.
- El grafo de dependencias se calcula a partir de los imports. Un ciclo convierte a dos módulos en uno con dos nombres: no se entienden, prueban, reutilizan ni separan por separado.
- Las dependencias deben apuntar de lo que cambia mucho a lo que cambia poco.
- Inversión de dependencias: el módulo que necesita algo declara la
interfaz, el otro la implementa y un tercero los conecta. El
importcambia de dirección; la llamada, no. Alternativas: fusionar, subir la función, y la falsa solución del móduloshared. - Ports y adapters: el núcleo declara ports y no importa nada de afuera; los adapters lo conectan con cada tecnología; el composition root arma todo con dependency injection hecha a mano. Se gana probar las reglas sin base de datos y cambiar de tecnología con un adapter; se paga indirección.
- Un
index.tspor módulo y reglas en dependency-cruiser (sin ciclos, una capa no importa lo que no le corresponde, a un módulo se entra por su índice) convierten los límites en algo que el build comprueba. La herramienta ve imports: no ve el acoplamiento por la base de datos ni puede decir si el límite está bien puesto.
Ejercicios
-
En el artículo de Parnas, ¿qué cambio se resuelve en un solo módulo en las dos descomposiciones? Expliquen por qué ese cambio en particular no distingue a una de la otra, y qué tienen en común los cuatro que sí lo hacen.
-
En
kwic/steps/, el archivomain.tsfue el único que no hubo que reescribir cuando cambió el formato de las líneas. Expliquen por qué, mirando qué hace con los valores que recibe. Después propongan un cambio de requisitos que sí obligue a modificarlo y digan si ese mismo cambio toca elmain.tsdekwic/decisions/. -
Hagan el cambio 4 de la tabla de Parnas en
kwic/decisions/: que el módulo de rotaciones guarde cada rotación ya armada, en vez de calcular cada palabra cuando se pide. ¿Cuántos archivos tocaron? Corrannode --test kwic/kwic.test.tspara comprobar que el listado no cambió. ¿Qué se gana y qué se paga con esta implementación respecto de la original? -
Un equipo tiene el archivo
src/common/helpers.tscon estas funciones:formatSoles(cents),isValidEmail(text),retry(fn, times),seatLabel(row, number)ysha256(text). Para cada una, digan qué cambio la haría cambiar y en qué módulo de un sistema como Tinkuy la pondrían. ¿Queda alguna que justifique un módulo compartido? -
Dos módulos comparten una tabla:
ordersla escribe yreportsla lee con su propio SQL. No hay ningúnimportentre ellos. (a) ¿Qué forma de connascence los ata? (b) Den un cambio enordersque rompa areportssin quetscnidepcruisedigan nada. (c) Propongan dos maneras de hacer visible esa dependencia y digan qué cuesta cada una. -
Para cada par, digan qué forma de connascence hay y propongan un refactoring que la baje a una más débil, o expliquen por qué no vale la pena: (a) una función
createEvent(title, 1, true, false); (b) el servidor firma un token con HMAC-SHA256 y otro servicio lo verifica; (c) un módulo guardatotal_centsy otro calcula la suma de los ítems para un reporte; (d) dentro de una misma función, un arreglo[min, max]que se desarma dos líneas más abajo. -
Este es el grafo de módulos de un sistema, una flecha por línea:
api → billing
api → users
billing → users
billing → notifications
notifications → templates
templates → billing
users → audit
(a) Encuentren el ciclo y escriban su recorrido. (b) Calculen , e para cada módulo. (c) ¿Qué módulo es el más caro de cambiar? (d) Elijan una flecha del ciclo para eliminar y justifiquen con la regla de estabilidad.
-
Escriban el escenario de modificabilidad de seis partes para este pedido sobre la biblioteca: “los socios docentes pueden llevarse hasta cinco libros por 30 días”. Después compruébenlo: ¿qué archivos de
library/src/habría que tocar? ¿Cumple el escenario que escribieron? Si alguno de los archivos que hay que tocar está fuera deloans, expliquen qué dependencia lo causa y si es razonable. -
En
library/, agreguen un tercer adapter deClockque lea el día de la variable de entornoLIBRARY_TODAY(y, si no existe, use el reloj de la computadora). ¿Qué archivos tocaron? ¿Cuáles de las reglas de.dependency-cruiser.cjsles habrían avisado si lo ponían en el lugar equivocado? Corranmake deps. -
Agreguen a
library/.dependency-cruiser.cjsla reglaonly-postgres-adapters-use-pgde la sección Escribir una regla nueva y sigan los cuatro pasos. Después respondan: ¿la reglacore-does-not-touch-infrastructurequedó redundante? Den un import que viole una y no la otra, en cada sentido, o expliquen por qué no existe. -
Den un caso concreto, en Tinkuy o en otro sistema que conozcan, donde agregar un port no vale lo que cuesta, y otro donde no agregarlo salió caro. Para cada uno, digan cuál de los tres motivos de la sección Cuándo un port no vale lo que cuesta está presente o ausente.
-
Un compañero propone: “pongamos
tsPreCompilationDeps: false, así los imports de solo tipos no cuentan y desaparece el ciclo deerrors/cycle/”. (a) Comprueben si es cierto que la violación desaparece. (b) Expliquen qué sigue sin poder hacerse con los dos módulos aunque la herramienta ya no se queje. (c) ¿En qué se parece esta propuesta al móduloshared?