Apuntes · Capítulo 4Estilos, tácticas y decisiones
Estilos monolíticos: capas, modular monolith, pipeline y microkernel
Estilos monolíticos: capas, modular monolith, pipeline y microkernel
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Qué es un estilo de arquitectura, Elementos, conectores y restricciones y Lo que un monolito da y lo que cobra; de Arquitectura en capas, La regla; de Partir por rol técnico o por dominio, El mismo cambio, contado; y de Microkernel, El problema: un
ifpor variante y Núcleo, contrato y registro.- En clase: Sesión A: Qué es un estilo de arquitectura, Arquitectura en capas, Partir por rol técnico o por dominio y Modular monolith. Sesión B: Pipeline, Microkernel, Los estilos se combinan y Big ball of mud. Laboratorio: Laboratorio: un medio de pago como plug-in.
- Después de clase: el Resumen y los Ejercicios. Para repasar antes de seguir con P1: Tres condiciones que se pueden comprobar, El
JOINque cruza dos módulos y Cómo se diseña un contrato. Opcionales: Cómo se comunican los módulos, Registro estático o descubrimiento, El código de la semana ymake testy las lecturas complementarias del recuadro Lectura.
La semana pasada terminó con una herramienta en la mano. Ya saben leer el grafo de dependencias de un sistema, encontrar un ciclo, invertir una dependencia con una interfaz y escribir una regla que dependency-cruiser comprueba en cada build. Todo eso es trabajo a la escala de dos o tres módulos: este importa a aquel, y no debería.
Esta semana subimos de escala. La pregunta ya no es si una flecha está bien puesta, sino qué forma tiene el sistema completo: con qué criterio se divide, qué puede hablar con qué y qué queda prohibido. A esas formas, cuando se repiten lo suficiente como para tener nombre y propiedades conocidas, se les llama estilos de arquitectura. Hoy vemos cuatro, todos de sistemas que se despliegan como una sola unidad: la arquitectura en capas, el modular monolith, el pipeline y el microkernel. La próxima semana veremos los que se reparten en varios procesos.
El hilo que une los cuatro es el escenario de modificabilidad que escribieron en la semana 3: cuando llega tal cambio, ¿cuántos archivos, cuántos módulos y cuántas personas toca? Cada estilo hace barato un tipo de cambio y encarece otro. En este capítulo no nos vamos a quedar en decirlo: tomamos una aplicación pequeña, la escribimos de dos maneras, le aplicamos el mismo cambio a las dos y contamos.
Tinkuy aparece como está hoy, sin arreglarle nada. Volver a Tinkuy un modular monolith y convertir sus medios de pago en plug-ins es su entrega P1, y no tendría sentido que el capítulo la hiciera. Los ejemplos resueltos usan otro sistema, más chico: Qhatu (mercado, en quechua), una librería en línea.
Lectura. Sesión A: Richards y Ford, Fundamentals of Software Architecture (2.ª ed.), cap. 9 Foundations, cap. 10 Layered Architecture Style y cap. 11 The Modular Monolith Architecture Style; Martin Fowler, PresentationDomainDataLayering y MonolithFirst. Complementarias: Kirsten Westeinde, Deconstructing the Monolith (Shopify, 2019), sobre cómo un monolito grande se volvió modular sin partirse en servicios; Software Architecture in Practice, cap. 8 Modifiability, los patrones del final del capítulo (capas, plug-in).
Sesión B: Fundamentals of Software Architecture (2.ª ed.), cap. 12 Pipeline Architecture Style y cap. 13 Microkernel Architecture Style; The Architecture of Open Source Applications, vol. 1, Eclipse, una plataforma hecha de plug-ins; Brian Foote y Joseph Yoder, Big Ball of Mud, las secciones Introduction y Forces. Complementarias: The Architecture of Open Source Applications, vol. 1, Graphite, un pipeline de procesamiento de métricas y sus cuellos de botella; y, de nuevo, el artículo de David Parnas de 1972 que leyeron la semana pasada: el índice KWIC es un pipeline.
El código de este capítulo está en code/week-04/. Todas las salidas que se muestran son de ejecuciones reales en el contenedor del curso.
Qué es un estilo de arquitectura
Elementos, conectores y restricciones
Un estilo de arquitectura (architectural style) es un vocabulario y un reglamento. El vocabulario dice qué tipos de elementos hay (capas, módulos, filtros, plug-ins, servicios) y con qué tipos de conectores se unen (una llamada a función, un pipe, un mensaje, una petición HTTP). El reglamento son las restricciones: qué elemento puede conectarse con cuál y qué está prohibido.
Lo interesante de un estilo está en lo que prohíbe. “Cada capa usa solo la que
tiene debajo” prohíbe que la presentación consulte la base de datos. “Un
filtro solo conoce el formato de lo que entra y de lo que sale” prohíbe que un
filtro llame a otro. “El núcleo no importa a ningún plug-in” prohíbe el if
que pregunta por una variante. De cada prohibición sale una propiedad: si
nadie fuera del módulo de datos conoce las tablas, cambiar una tabla toca un
solo lugar. Y como las propiedades salen de las restricciones, un estilo que
no se hace cumplir no da nada. Por eso este capítulo sigue usando la
herramienta de la semana pasada: cada estilo que veamos va a venir con sus
reglas de dependency-cruiser.
Un estilo no es una receta. No dice cuántos módulos hacer ni cómo llamarlos, y dos sistemas con el mismo estilo pueden parecerse muy poco. Lo que da es un punto de partida con propiedades conocidas: quien elige capas sabe de antemano qué va a ser fácil (cambiar la tecnología de una capa) y qué va a doler (un cambio de negocio que atraviesa las tres). Elegir un estilo es elegir, con los ojos abiertos, qué atributos de calidad se favorecen y cuáles se sacrifican.
Idea clave. Un estilo se define por sus restricciones, y de ellas salen sus propiedades. La pregunta útil frente a un estilo no es “¿qué partes tiene?”, sino “¿qué prohíbe, y qué gano con que esté prohibido?”.
Estilo y patrón
Las palabras estilo y patrón se usan a veces como sinónimos, y hay libros que llaman patrón de arquitectura a lo que aquí llamamos estilo. En el curso las separamos por escala:
- Un estilo describe la forma global del sistema o de una parte grande de él: en capas, modular monolith, microservicios.
- Un patrón (pattern) resuelve un problema local dentro de esa forma: un repositorio que esconde el SQL, un circuit breaker delante de una llamada remota, un registro donde se inscriben los plug-ins.
La distinción no es exacta ni hace falta que lo sea. Sirve para no mezclar dos conversaciones: “¿qué forma tiene Tinkuy?” es una, y “¿cómo aíslo a Tinkuy de una pasarela lenta?” es otra.
La primera gran división: monolítico o distribuido
Los estilos se reparten en dos familias según una sola pregunta: ¿en cuántas unidades se despliega el sistema?
- Monolítico: una sola unidad de despliegue. Todo el código corre en un proceso (o en varias copias idénticas del mismo proceso), y las partes se hablan con llamadas a funciones.
- Distribuido: varias unidades que se despliegan por separado y se hablan por la red.
Fíjense en que la pregunta es sobre el despliegue, no sobre el orden. La palabra monolito se usa mucho como insulto, como si fuera sinónimo de código enredado, y eso confunde dos cosas distintas. Un monolito puede tener módulos con límites que una herramienta comprueba en cada build; y un sistema de veinte servicios puede ser un enredo donde todos leen las tablas de todos. El enredo tiene su propio nombre, big ball of mud, y lo vemos al final del capítulo. Monolito dice cuántas cosas se despliegan; big ball of mud dice que nadie cuidó los límites. Son ejes distintos.
Tinkuy, por ejemplo, es un monolito: un proceso de Node.js y una base de datos
PostgreSQL. Eso es una decisión de despliegue y, como veremos, tiene ventajas
concretas. Que además reports lea archivos internos de orders es otro
asunto, y ese sí es un problema.
Lo que un monolito da y lo que cobra
Lo que un monolito da, sin que nadie tenga que pedirlo:
- Una base de código. Un repositorio, un build, una suite de pruebas. Un cambio que toca dos módulos es un solo commit, y el compilador revisa los dos lados a la vez.
- Llamadas locales. Cuando un módulo llama a otro, la llamada tarda nanosegundos y solo tiene dos finales: devuelve un valor o lanza un error. No existe “no sé si llegó”.
- Transacciones simples. Con una sola base de datos, una operación que
toca datos de dos módulos se protege con un
BEGINy unCOMMIT. - Un despliegue. Una cosa que construir, que versionar y que vigilar.
La tercera se puede ver. En Qhatu, comprar descuenta el stock (un dato del catálogo) y guarda la orden (un dato de órdenes). Esta prueba pide un libro del que hay de sobra y dos ejemplares de otro del que queda uno:
test('si un producto no alcanza, la orden entera no se guarda', async () => {
  // Del libro 8 queda un ejemplar; del libro 2 hay de sobra.
  const rejected = await post('/orders', {
    buyerEmail: 'luis.mamani@correo.pe',
    items: [
      { productId: 2, quantity: 1 },
      { productId: 8, quantity: 2 },
    ],
  });
  assert.equal(rejected.status, 409);
  assert.equal(rejected.body.error.code, 'OUT_OF_STOCK');
  // El libro 2 ya se había descontado dentro de la transacción: el ROLLBACK lo devuelve.
  assert.equal(await stockOf(2), 8);
  assert.equal(await stockOf(8), 1);
});
El primer libro ya se había descontado cuando el segundo falló. El ROLLBACK
lo devuelve, y nadie tuvo que escribir código para deshacer nada. Guarden esta
prueba en la memoria: cuando en la semana 12 el catálogo y las órdenes vivan
en servicios distintos, conseguir este mismo comportamiento va a costar un
capítulo entero.
Lo que un monolito cobra:
- Todo se despliega junto. Corregir una coma en el reporte de ventas obliga a desplegar también el código que cobra. Si diez equipos comparten el despliegue, cada uno espera a los otros nueve.
- Una parte lenta afecta a todas. Los módulos comparten proceso, memoria y conexiones a la base de datos. Un reporte pesado que ocupa todas las conexiones deja sin atender a quien quiere comprar.
- Se escala entero. Si solo el catálogo recibe mil veces más tráfico, la única forma de darle más capacidad es levantar más copias de todo.
- Sin disciplina, los límites internos se borran. En un monolito, importar un archivo interno de otro módulo cuesta una línea y funciona a la primera. Nada lo impide, salvo una regla que alguien escribió y una herramienta que la comprueba.
Los tres primeros costos son el motivo por el que existen los estilos distribuidos, y cada uno corresponde a un escenario de calidad (de capacidad de despliegue, de disponibilidad, de escalabilidad). Mientras ese escenario no exista, el costo no se paga. El cuarto es distinto: se paga siempre, desde el primer mes, y es de lo que trata la mitad de este capítulo.
Trade-off. Un monolito cambia operación simple por despliegue acoplado. Mientras el equipo es chico y la carga cabe en una máquina, es casi todo ganancia: las llamadas no fallan a medias y las transacciones son gratis. El precio aparece cuando crecen el equipo (esperar el despliegue de otros) o la carga de una sola parte (escalar todo para escalar una). Pasar a un estilo distribuido antes de tener ese problema es pagar la red sin cobrar nada a cambio.
El ejemplo de la semana: Qhatu
Qhatu vende libros. Hace tres cosas:
GET /products?category=lista los libros, con su precio y su stock.POST /orderscompra de uno a cinco títulos distintos: descuenta el stock y guarda la orden con sus líneas.GET /orders/:idla devuelve.GET /reports/salesdice cuántos ejemplares y cuánto dinero se vendió por categoría.
Está escrita dos veces, en code/week-04/shop/: una organizada por capas
(by-layer/) y otra por dominio (by-domain/). Las dos usan PostgreSQL, las
dos responden lo mismo y las dos pasan exactamente las mismas seis pruebas, que
solo hablan con la API HTTP (shop/test/behaviour.ts; las corren
by-layer.test.ts y by-domain.test.ts, cada una contra su versión).
Esto importa para todo lo que sigue. Las dos versiones tienen la misma funcionalidad, y un comprador no podría distinguirlas. Lo que cambia entre una y otra es la estructura de módulos, y con ella, cuánto cuesta cada cambio futuro. Es la idea de la semana 1, ahora con dos carpetas para comparar: la funcionalidad no determina la arquitectura.
Arquitectura en capas
La regla
La arquitectura en capas divide el sistema por rol técnico. La versión clásica tiene tres capas (layers):
- Presentación: habla con el mundo. Recibe la petición HTTP, revisa que el JSON tenga la forma correcta, llama al dominio y convierte el resultado en una respuesta.
- Dominio: las reglas del negocio. Cuántos títulos lleva una orden, qué pasa si no hay stock, cómo se calcula el total.
- Datos: guarda y recupera. El SQL vive aquí y en ningún otro lugar.
La restricción del estilo es una sola: cada capa usa solo la que tiene debajo. La presentación llama al dominio; el dominio llama a los datos; nadie llama hacia arriba y nadie se salta una capa.
En Qhatu por capas, cada capa es una carpeta:
$ tree --noreport src
src
├── db
│   ├── order-repository.ts
│   ├── pool.ts
│   ├── product-repository.ts
│   └── report-repository.ts
├── errors.ts
├── http
│   ├── order-handlers.ts
│   ├── product-handlers.ts
│   ├── report-handlers.ts
│   ├── router.ts
│   └── server.ts
├── main.ts
├── services
│   ├── order-service.ts
│   ├── product-service.ts
│   └── report-service.ts
└── types.ts
Entre las carpetas, los import siguen la regla: http importa a
services, services importa a db, y no hay ninguno en sentido contrario.
(types.ts y errors.ts son el vocabulario que comparten las tres capas;
main.ts arma todo.)
El recorrido de una compra muestra para qué sirve cada capa. La presentación
(http/order-handlers.ts) traduce: revisa que el JSON tenga buyerEmail e
items con la forma correcta, y no decide nada del negocio. El dominio
decide. Aquí están las reglas (de uno a cinco títulos, sin repetir, todo o
nada) y ni una palabra de HTTP ni de SQL:
/** Descuenta el stock y guarda la orden, todo o nada. */
export async function placeOrder(order: NewOrder): Promise<Order> {
  checkItems(order);
  // Siempre en el mismo orden de producto: dos órdenes simultáneas con los
  // mismos libros no pueden quedar esperándose una a la otra.
  const items = [...order.items].sort((a, b) => a.productId - b.productId);

  return inTransaction(async (tx) => {
    const lines: OrderLine[] = [];
    for (const item of items) {
      const product = await findProduct(tx, item.productId);
      if (!product) throw notFound(`el producto ${item.productId}`);
      const taken = await takeStock(tx, item.productId, item.quantity);
      if (!taken) throw outOfStock(product.title);
      lines.push({
        productId: product.id,
        title: product.title,
        quantity: item.quantity,
        unitPriceCents: product.priceCents,
      });
    }
    return insertOrder(tx, order.buyerEmail, lines);
  });
}
Y la capa de datos (db/product-repository.ts, db/order-repository.ts) es
la única que sabe cómo se llaman las tablas y las columnas.
Idea clave. La arquitectura en capas separa por tipo de conocimiento: quien toca la presentación no necesita saber SQL, y quien toca los datos no necesita saber de HTTP. Cada capa esconde una tecnología.
Capas cerradas y capas abiertas
“Nadie se salta una capa” tiene nombre: la capa del medio es cerrada. Una petición que entra por la presentación tiene que pasar por el dominio para llegar a los datos. La alternativa es declarar una capa abierta: se permite saltarla.
¿Por qué alguien querría saltarla? Porque a veces la capa cerrada no hace nada. Miren el servicio que lista los productos:
export async function listProducts(category?: Category): Promise<Product[]> {
  return findProducts(category);
}
Recibe la llamada y la pasa. La tentación es obvia: que el handler llame
directo al repositorio. El ejemplo errors/handler-skips-service.ts hace
exactamente eso, y la regla de capas cerradas lo detecta:
$ make cruces
== errors/handler-skips-service.ts en Qhatu por capas

  error http-only-uses-services: src/http/handler-skips-service.ts → src/db/product-repository.ts

x 1 dependency violations (1 errors, 0 warnings). 18 modules, 37 dependencies cruised.

depcruise terminó con código 1
La regla http-only-uses-services prohíbe que algo de src/http/ importe
algo de src/db/ o el driver pg.
¿Cuál de las dos decisiones es la correcta? Depende de lo que se quiera proteger:
- Cerrada aísla los cambios. Si mañana cambia cómo se guardan los productos, la presentación no se entera, porque nunca conoció al repositorio. El precio son funciones que solo pasan la llamada.
- Abierta ahorra esas funciones. El precio es que la presentación ahora depende de dos capas, y que la próxima regla de negocio sobre los productos (“no mostrar los agotados”) no tiene un lugar único donde ponerse: habrá handlers que pasan por el servicio y handlers que no.
Si se abre una capa, se abre a propósito, se escribe (un ADR, en la semana 7) y la regla de dependencias se cambia para decir exactamente qué se permite. Lo que no vale es abrirla un handler a la vez, cada uno con su apuro.
Lo que las capas hacen bien
- Es simple y todo el mundo la conoce. Alguien que llega al equipo sabe dónde buscar un endpoint y dónde buscar una consulta sin que nadie se lo explique. Para un sistema chico o un equipo nuevo, eso vale mucho.
- Separa lo técnico. Cambiar de tecnología en una capa (otro formato de respuesta, otra forma de escribir las consultas) queda dentro de una carpeta.
- Reduce lo que hay que tener en la cabeza. Fowler, en PresentationDomainDataLayering, dice que para él esta es la mayor ventaja: al trabajar en el dominio puede ignorar casi por completo la interfaz y tratar los datos como funciones que se los entregan. Y agrega que esa razón le basta por sí sola, aunque nunca se reemplace una capa por otra.
- Ayuda a probar. El dominio se puede probar sin levantar HTTP, que es la parte más incómoda de probar.
El sumidero
La función listProducts de arriba es un caso del antipatrón que Richards y
Ford llaman sumidero (architecture sinkhole): peticiones que atraviesan
las capas sin que ninguna les haga nada. Cada capa recibe, pasa y devuelve.
Un sumidero aislado no es grave: es el costo de tener capas cerradas. El
problema es la proporción. En Qhatu por capas, la capa de dominio tiene cuatro
funciones públicas (listProducts, placeOrder, getOrder y
salesByCategory). Una pasa la llamada tal cual, dos agregan una línea (un
404 si no existe, ceros para las categorías sin ventas) y solo placeOrder
contiene reglas de verdad. Cuando la mayoría de las peticiones de un sistema
son sumideros, las capas están cobrando su costo (tres archivos por cada
operación) sin entregar su beneficio, y vale la pena preguntarse si ese
sistema necesita una capa de dominio o si es, en el fondo, un formulario sobre
una tabla.
Error común. Resolver el sumidero abriendo todas las capas. Si el handler puede llamar al repositorio cuando “el servicio no hace nada”, en seis meses habrá reglas de negocio repartidas entre handlers y servicios, y la capa de dominio ya no será el lugar donde están las reglas. Es preferible cargar con unas cuantas funciones que solo pasan la llamada.
Un cambio de negocio atraviesa las capas
La debilidad de fondo de las capas ya la conocen: fue un error común de la semana 3. Las capas parten por rol técnico, y los cambios que más llegan no son técnicos. Nadie pide “cambien la capa de datos”. Piden “que el comprador pueda escribir una dedicatoria”, y eso es un campo que hay que recibir (presentación), validar (dominio) y guardar (datos). Un cambio de negocio, tres capas.
En la siguiente sección lo contamos con un cambio de verdad.
Partir por rol técnico o por dominio
La misma aplicación, dos árboles de carpetas
La alternativa a partir por rol técnico es partir por dominio: una carpeta por cada parte del negocio, y dentro de cada una, lo que haga falta (sus rutas, su lógica, su acceso a datos). Esta es Qhatu por dominio:
$ tree --noreport src
src
├── app.ts
├── catalog
│   ├── index.ts
│   ├── products.ts
│   ├── repository.ts
│   ├── routes.ts
│   └── types.ts
├── main.ts
├── orders
│   ├── index.ts
│   ├── place-order.ts
│   ├── repository.ts
│   ├── routes.ts
│   └── types.ts
├── platform
│   ├── db.ts
│   ├── errors.ts
│   ├── http.ts
│   └── transaction.ts
└── reports
    ├── index.ts
    ├── routes.ts
    └── sales-report.ts
Los módulos son catalog, orders y reports. La carpeta platform tiene
lo técnico que todos necesitan (el router HTTP, la conexión a la base de
datos, los errores) y no sabe nada del negocio. Compárenlo con el árbol de la
sección anterior: están las mismas piezas (rutas, lógica, repositorio), pero
agrupadas con el otro criterio. Allá, los tres repositorios vivían juntos en
db/; aquí, cada repositorio vive con la lógica a la que sirve.
El grafo entre carpetas también cambia:
$ depcruise src --config .dependency-cruiser.cjs --collapse "^src/[^/]+" --output-type text
src/app.ts → src/catalog
src/app.ts → src/orders
src/app.ts → src/platform
src/app.ts → src/reports
src/app.ts → http
src/catalog → src/platform
src/main.ts → src/app.ts
src/main.ts → src/platform
src/orders → src/catalog
src/orders → src/platform
src/platform → ../../../../../opt/course/node_modules/pg/lib/index.js
src/platform → http
src/reports → src/platform
src/reports → src/catalog
src/reports → src/orders
Ahora las flechas hablan del negocio: orders → catalog (para vender hay que
saber qué hay), reports → orders y reports → catalog (el reporte combina
datos de los dos). Y ninguna en sentido contrario: el catálogo no sabe que
existen las órdenes. El mismo grafo, en la versión por capas, dice solo que
http usa a services y services a db, que es verdad en cualquier
sistema en capas, venda libros o entradas.
Dentro de cada módulo sigue habiendo capas: routes.ts es presentación,
place-order.ts es dominio, repository.ts es datos. Partir por dominio no
elimina las capas; las mete adentro. Es lo que recomienda Fowler en la misma
nota: la separación presentación-dominio-datos está bien a granularidad
pequeña, y cuando la aplicación crece conviene que los módulos de más arriba
sean de dominio, con las capas en su interior.
El mismo cambio, contado
El pedido: el comprador puede escribir una dedicatoria de hasta 140 caracteres, que se guarda con la orden y se muestra al consultarla. Es el cambio más común que existe: un campo nuevo que entra por un formulario, se valida, se guarda y se muestra.
El cambio está hecho para las dos versiones, como un .diff cada uno, en
shop/changes/. make cambio copia cada versión a build/, le aplica su
diff, crea una base de datos con la columna nueva y comprueba que la
dedicatoria funciona:
$ make cambio
== Por capas
 src/db/order-repository.ts    |   24 ++++++++++++++++--------
 src/http/order-handlers.ts    |    5 ++++-
 src/services/order-service.ts |    6 +++++-
 src/types.ts                  |    2 ++
 4 files changed, 27 insertions(+), 10 deletions(-)
== Por dominio
 src/orders/place-order.ts |    6 +++++-
 src/orders/repository.ts  |   19 +++++++++++++------
 src/orders/routes.ts      |    5 ++++-
 src/orders/types.ts       |    2 ++
 4 files changed, 24 insertions(+), 8 deletions(-)
== Las dos copias, con el cambio aplicado
dedicatoria: se guarda, se muestra, se valida y sigue siendo opcional
dedicatoria: se guarda, se muestra, se valida y sigue siendo opcional
Las dos versiones necesitaron cuatro archivos. Partir por dominio no redujo la cantidad de código que hay que escribir: el campo igual se recibe, se valida y se guarda. Lo que cambió es dónde quedan esos archivos:
| Por capas | Por dominio | |
|---|---|---|
| Archivos modificados | 4 | 4 |
| Carpetas tocadas | 4 (src/, http/, services/, db/) |
1 (orders/) |
| ¿Cambió la interfaz pública de algún módulo? | No hay interfaces declaradas | No: orders/index.ts no se tocó |
(Los dos números de la tabla los comprueba una prueba,
shop/test/change-cost.test.ts, que cuenta sobre los mismos .diff.)
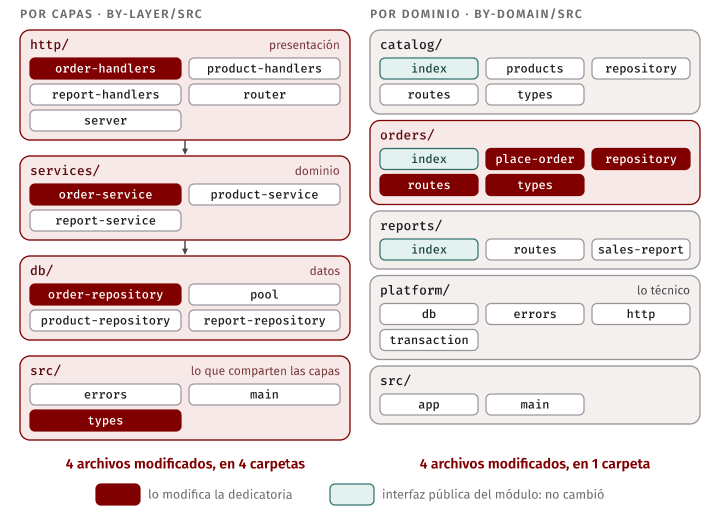
En una aplicación de quince archivos, que el cambio caiga en una carpeta o en cuatro parece un detalle estético. Deja de serlo cuando cada carpeta tiene un owner:
- Si los equipos están organizados por capa (uno de frontend o de API, uno de lógica, uno de base de datos), la dedicatoria necesita que tres equipos se pongan de acuerdo, revisen y desplieguen en orden. Fowler advierte contra esto en la misma nota: los desarrolladores no tienen que ser full-stack, pero los equipos sí.
- Si los equipos están organizados por dominio, la dedicatoria es trabajo de un equipo, el de órdenes, y nadie más se entera. El catálogo y los reportes no cambiaron ni tienen que volver a probarse.
La última fila de la tabla dice algo más fino. En la versión por dominio, el
cambio no tocó orders/index.ts, la interfaz pública del módulo. Eso es una
garantía: ningún otro módulo puede haberse roto, porque ninguno puede ver los
archivos que cambiaron. En la versión por capas no hay forma de decir eso: el
cambio tocó src/types.ts, que importan ocho archivos de las tres capas.
El cambio contrario
Sería deshonesto contar solo el cambio que favorece a un lado. Hay cambios técnicos, y esos caen al revés. Supongan que hay que revisar todo el SQL de la aplicación (porque se cambia de motor de base de datos, o porque una auditoría pide revisar todas las consultas):
$ make sql
== Por capas: archivos con SQL
src/db/order-repository.ts
src/db/product-repository.ts
src/db/report-repository.ts
== Por dominio: archivos con SQL
src/catalog/repository.ts
src/orders/repository.ts
Por capas, todo el SQL está en una carpeta, src/db/, y es trabajo de quien
más sabe de bases de datos. Por dominio, está repartido: un repository.ts
por cada módulo que tiene datos. Aquí son dos; en un sistema con cuarenta
módulos serían cuarenta archivos de cuarenta owners.
La pregunta que decide
Entonces, ¿por rol técnico o por dominio? La pregunta que decide es:
¿Qué tipo de cambio llega más seguido: uno que afecta a una parte del negocio a través de todas sus capas, o uno que afecta a una tecnología a través de todo el negocio?
En casi todos los sistemas de negocio, la respuesta es el primero. Un sistema como Tinkuy recibe pedidos como “aceptar Plin”, “vender abonos para toda la temporada” o “que el organizador vea las ventas por hora” todas las semanas, y cambia de motor de base de datos una vez en diez años, si acaso. Por eso los libros del curso, y la práctica de los equipos que mantienen sistemas grandes, se inclinan por partir primero por dominio.
Pero es una inclinación, no una ley, y tiene excepciones razonables:
- Un sistema pequeño, con un equipo que cabe en una mesa, no gana nada con módulos de dominio todavía: no hay equipos que separar. Las capas son más simples y alcanzan.
- Un sistema cuyo cambio dominante sí es técnico (una herramienta de migración entre bases de datos, por ejemplo, donde lo que varía es el motor) se parte por lo técnico, y con razón. Es el criterio de Parnas: dividir por lo que cambia.
- Un equipo que todavía no entiende el dominio no sabe dónde poner los límites. Partir por dominio con los límites equivocados es peor que partir por capas: volveremos a esto con Monolith first.
Trade-off. Partir por dominio hace que un cambio de negocio caiga en un módulo, y a cambio reparte lo técnico por todos los módulos. Partir por capas junta lo técnico y reparte cada cambio de negocio. No hay división que vuelva baratos todos los cambios: se elige cuál abaratar, mirando qué pide más seguido el negocio.
Modular monolith
Tres condiciones que se pueden comprobar
Un modular monolith es un monolito (un solo despliegue) dividido en módulos por dominio que cumplen tres condiciones:
- Cada módulo tiene una interfaz pública, y los demás lo usan solo por ella.
- Los datos de cada módulo son suyos. Sus tablas no las lee ni las escribe otro módulo con SQL propio.
- Las dependencias entre módulos están declaradas y no tienen ciclos.
Lo que distingue a un modular monolith de un monolito con carpetas es que las
tres se comprueban en cada build. Tener las carpetas catalog/, orders/
y reports/ es la parte fácil, y Tinkuy ya la tiene. Lo difícil es que
dentro de seis meses, con plazos encima, reports siga sin leer las tablas de
orders.
Error común. Llamar “modular” a un monolito porque tiene carpetas. Sin interfaz pública y sin regla que la proteja, una carpeta es solo un nombre: cualquier archivo puede importar cualquier otro, y con el tiempo lo hace.
Lo que se obtiene a cambio es buena parte de la modificabilidad que se suele buscar en los microservicios (un cambio cae en un módulo, un equipo es owner de un módulo, los módulos se entienden por separado) sin pagar la red: las llamadas siguen siendo locales y las transacciones siguen siendo de una sola base de datos. Lo que no se obtiene es lo que depende del despliegue: los módulos se siguen desplegando juntos, siguen compartiendo proceso y se siguen escalando juntos.
La interfaz pública y las reglas
La primera condición es la de la semana pasada: un index.ts por módulo que
exporta lo que los demás pueden usar. Este es el de catalog, completo:
// Catálogo: los libros, sus precios y su stock.
// Esto es todo lo que otro módulo puede usar de catalog.

export { getProducts, takeStock } from './products.ts';
export { catalogRoutes } from './routes.ts';
export { CATEGORIES } from './types.ts';
export type { Category, Product } from './types.ts';
Seis nombres. Todo lo demás (el repositorio, las filas de la tabla, cómo se descuenta el stock) es interno y se puede reescribir sin avisarle a nadie.
Las reglas de dependency-cruiser de Qhatu por dominio
(shop/by-domain/.dependency-cruiser.cjs) hacen cumplir las condiciones 1 y
3, y una parte de la 2. Son seis. Dos ya las conocen de Tinkuy: no-circular
y modules-only-through-index. Las otras cuatro son nuevas:
platform-does-not-know-modules: lo técnico no depende del negocio. Sin esta regla,platformse convierte en el módulosharedde la semana 3, donde termina todo lo que nadie supo dónde poner.only-platform-db-uses-pg: el driver de PostgreSQL se importa en un solo archivo.only-repository-queries: dentro de un módulo, solorepository.tspuede importarplatform/db.ts, que es la puerta a las tablas.reports-has-no-data: el módulo de reportes no tiene tablas, así que no tiene nada que hacer con la base de datos.
Las dos últimas, tal como están escritas:
{
  name: 'only-repository-queries',
  comment: 'Dentro de un módulo, solo repository.ts consulta la base de datos.',
  severity: 'error',
  from: { path: MODULES, pathNot: '/repository\\.ts$' },
  to: { path: '^src/platform/db\\.ts$' },
},
{
  name: 'reports-has-no-data',
  comment: 'reports no tiene tablas: lo que necesita lo pide por la interfaz de otro módulo.',
  severity: 'error',
  from: { path: '^src/reports/' },
  to: { path: '^src/platform/(db|transaction)\\.ts$' },
},
Los datos como límite
La segunda condición es la que más cuesta y la que más importa. Dos módulos
que comparten una tabla están acoplados por el esquema: si orders renombra
una columna, se rompe un reporte que nadie del equipo de órdenes sabía que
existía. Es el acoplamiento de la pregunta de repaso de la semana pasada, y es
invisible para dependency-cruiser, porque no hay ningún import entre los dos
módulos: el acoplamiento pasa por la base de datos.
En Qhatu por dominio, el límite se hace visible en la base de datos misma, con
un esquema de PostgreSQL por módulo: catalog tiene la tabla products,
y orders tiene orders y order_lines (shop/db/schema-modules.sql). Con
las tablas escritas como catalog.products y orders.order_lines, de quién
es cada tabla se lee en el nombre, y una consulta que cruza módulos se
nota a simple vista. El módulo reports no tiene esquema: no guarda nada.
Mirar no alcanza, así que hay una comprobación. shop/data-ownership.ts lee
los archivos de cada módulo, busca las tablas que nombra su SQL (después de
FROM, JOIN, INTO y UPDATE) y reporta las que están en el esquema de
otro módulo. Corre dentro de make deps, junto a dependency-cruiser:
$ make deps
cd shop/by-layer && depcruise src --config .dependency-cruiser.cjs

✔ no dependency violations found (17 modules, 35 dependencies cruised)

cd shop/by-domain && depcruise src --config .dependency-cruiser.cjs

✔ no dependency violations found (21 modules, 45 dependencies cruised)

node shop/data-ownership.ts shop/by-domain/src
Cada módulo nombra solo sus tablas
cd microkernel && depcruise src --config .dependency-cruiser.cjs

✔ no dependency violations found (11 modules, 17 dependencies cruised)
Es una comprobación modesta (un programa corto con una expresión regular, que no entendería SQL armado por partes), pero cubre justo lo que la herramienta de imports no puede ver. A las comprobaciones automáticas de una propiedad de la arquitectura se les llama fitness functions, y las estudiamos en la semana 15; esta y las reglas de dependency-cruiser son las primeras del curso.
Se puede ir más lejos y hacer que sea la base de datos la que lo impida: un rol de PostgreSQL por módulo, con permisos solo sobre su esquema. Es más fuerte (ni siquiera un SQL armado a mano pasa) y más caro: cada módulo necesita sus propias conexiones, y una transacción que toca dos módulos ya no puede usar una sola conexión. Para un monolito de un equipo, la comprobación en el build suele bastar.
Miren también lo que no hay en el esquema de órdenes:
-- product_id guarda el id de un producto del catálogo, pero no hay llave
-- foránea hacia catalog.products: una restricción que cruza dos esquemas
-- ataría las tablas de un módulo a las del otro. El título y el precio se
-- copian al momento de la venta: son los de ese día, aunque el catálogo cambie.
CREATE TABLE orders.order_lines (
  order_id         integer NOT NULL REFERENCES orders.orders (id),
  product_id       integer NOT NULL,
  title            text    NOT NULL,
  quantity         integer NOT NULL CHECK (quantity > 0),
  unit_price_cents integer NOT NULL CHECK (unit_price_cents > 0),
  PRIMARY KEY (order_id, product_id)
);
No hay llave foránea de orders.order_lines hacia catalog.products. En la
versión por capas sí la hay (REFERENCES products (id)), y es lo natural
cuando todas las tablas son de todos. Aquí, una restricción entre los dos
esquemas volvería a atar las tablas de un módulo a las del otro: el catálogo
no podría borrar un libro ni cambiar el tipo de su llave sin que la base de
datos consultara una tabla de órdenes.
Trade-off. Sin llave foránea entre módulos, la base de datos deja de garantizar que todo
product_idde una orden exista en el catálogo. Esa garantía pasa a ser responsabilidad del código:orderssolo guarda ids quecatalogle acaba de confirmar, yreportstiene que decidir qué hace con un producto que ya no está (lo verán en su código: no lo cuenta). Se gana que cada módulo pueda cambiar sus tablas solo; se paga con una garantía menos y unas líneas más. Es un adelanto, en pequeño, de lo que pasa cuando los datos se reparten entre servicios.
El JOIN que cruza dos módulos
El reporte de ventas por categoría necesita dos cosas: cuánto se vendió de
cada producto, que lo sabe orders, y de qué categoría es cada producto, que
lo sabe catalog. En la versión por capas eso es una consulta con un JOIN
entre order_lines y products (db/report-repository.ts), y nadie lo
pensaría dos veces.
En un modular monolith, ese JOIN es justo lo que la segunda condición
prohíbe. El ejemplo errors/report-with-join.ts lo escribe igual dentro del
módulo reports, y lo detectan las dos reglas y la comprobación de tablas:
$ make cruces
== errors/report-with-join.ts en Qhatu por dominio

  error reports-has-no-data: src/reports/report-with-join.ts → src/platform/db.ts
  error only-repository-queries: src/reports/report-with-join.ts → src/platform/db.ts

x 2 dependency violations (2 errors, 0 warnings). 22 modules, 46 dependencies cruised.

depcruise terminó con código 2
src/reports/report-with-join.ts: el módulo reports nombra la tabla orders.order_lines, que no es suya
src/reports/report-with-join.ts: el módulo reports nombra la tabla catalog.products, que no es suya
2 tabla(s) ajena(s)
data-ownership terminó con código 1
Hay tres formas de resolverlo sin que un módulo lea las tablas de otro, y cada una cuesta algo distinto.
1. Pedir el dato por la interfaz. El módulo que necesita el dato se lo pide al módulo que es su owner, y combina en memoria. Es lo que hace el reporte de Qhatu:
/** Ventas por categoría; las categorías sin ventas aparecen con cero. */
export async function salesByCategory(): Promise<CategorySales[]> {
  const sales = await salesByProduct();
  const products = await getProducts(sales.map((sale) => sale.productId));
  const categoryOf = new Map(products.map((product) => [product.id, product.category]));

  const totals = new Map<Category, CategorySales>(
    CATEGORIES.map((category) => [category, { category, units: 0, revenueCents: 0 }]),
  );
  for (const sale of sales) {
    const category = categoryOf.get(sale.productId);
    // Un producto retirado del catálogo ya no tiene categoría: no se cuenta.
    const total = category && totals.get(category);
    if (!total) continue;
    total.units += sale.units;
    total.revenueCents += sale.revenueCents;
  }
  return [...totals.values()];
}
reports no tiene SQL: llama a salesByProduct() de órdenes y a
getProducts() del catálogo. El costo se ve leyendo: lo que era una consulta
ahora son dos, y la combinación que la base de datos hacía con un JOIN la
hace el programa con un Map. Con ocho libros da igual. Con dos millones de
líneas de orden, traer todo a la memoria del proceso para sumarlo ahí es una
mala idea, y habría que pedirle a orders una función que ya entregue los
totales (como hace salesByProduct, que agrupa en SQL dentro de su módulo).
La regla práctica: que cada módulo haga en su SQL todo lo que pueda con sus
propias tablas, y que por la interfaz viaje lo ya resumido.
2. Duplicar un dato estable. Si un módulo necesita siempre el mismo dato
de otro, puede guardar una copia. Qhatu lo hace con el título y el precio:
cuando se vende un libro, orders copia ambos a la línea de la orden (lo
vieron en el esquema: orders.order_lines tiene una columna title). Por
eso GET /orders/:id no necesita al catálogo (en la versión por capas,
esa misma consulta hace un JOIN con products para traer el título). El
costo de duplicar es que la copia puede quedar vieja. Aquí eso es lo que se
quiere: una orden debe mostrar el precio al que se vendió, no el de hoy. Para
la categoría sería un problema: si el catálogo mueve un libro de ensayo a
novela, las copias quedarían mal y alguien tendría que corregirlas. Se
duplica lo que no cambia, o lo que debe quedar congelado.
3. Una vista de lectura declarada. El owner de los datos publica una vista
de la base de datos (por ejemplo, catalog.product_categories) y declara que
esa vista, y no sus tablas, es parte de su interfaz pública. Los reportes
pueden hacer JOIN contra ella. Se recupera el JOIN y su rendimiento; el
costo es que la interfaz del módulo ahora tiene una parte en SQL que hay que
mantener estable, y que la solución solo existe mientras los módulos
compartan base de datos. El día que catalog se vaya a un servicio con su
propia base, todos los JOIN contra la vista hay que reescribirlos. Qhatu no
la usa; es la opción a considerar cuando un reporte pesado no se puede
resolver bien con la primera.
| Opción | Se gana | Se paga |
|---|---|---|
| Pedir por la interfaz | Cero acoplamiento por el esquema | Más consultas; combinar en memoria |
| Duplicar un dato estable | Lecturas sin depender del otro módulo | La copia puede quedar vieja |
| Vista declarada | El JOIN y su rendimiento |
Una interfaz en SQL; ata los módulos a una misma base |
Cómo se comunican los módulos
Dentro de un modular monolith, un módulo le habla a otro de dos maneras.
Llamadas a la interfaz pública. Es la forma por omisión, y la que usa
Qhatu. orders llama a takeStock de catalog:
/**
 * Aparta `quantity` ejemplares dentro de la transacción de quien llama y
 * devuelve el producto con el precio de ese momento. Lanza 404 si el producto
 * no existe y 409 si no alcanza el stock.
 */
export async function takeStock(tx: Tx, productId: number, quantity: number): Promise<Product> {
  const taken = await decrementStock(tx, productId, quantity);
  if (taken) return taken;
  const [product] = await findProductsByIds([productId]);
  if (!product) throw notFound(`el producto ${productId}`);
  throw outOfStock(product.title);
}
Miren el primer parámetro. tx es la transacción de quien llama: orders la
abre, se la pasa a catalog para que descuente el stock dentro de ella, y
después guarda la orden con la misma. Así se consigue el todo o nada de la
prueba que vimos al comienzo, cruzando dos módulos.
Trade-off. Pasar la transacción por la interfaz es lo que hace simple al monolito, y también es un acoplamiento:
takeStock(tx, …)solo tiene sentido si los dos módulos usan la misma base de datos. Es una decisión consciente de aprovechar que hoy la comparten. Si algún díacatalogse separa, esa firma no sobrevive, y lo que hoy es unROLLBACKhabrá que conseguirlo de otra manera (semana 12). La alternativa, que cada módulo haga su propia transacción desde ahora, prepara esa separación y obliga a manejar hoy el caso “se descontó el stock y la orden no se guardó”. Para un sistema que no tiene un escenario que pida separar, es pagar por adelantado.
Eventos dentro del proceso. La otra forma invierte quién conoce a quién.
En vez de que orders llame a todos los interesados en una venta, publica un
evento, se hizo una orden, y los interesados se suscriben. El ejemplo está
en shop/events/event-bus.ts: un bus de cuarenta líneas, en memoria. Su
primera prueba publica el mismo evento dos veces desde la misma función; entre
una y otra, un segundo módulo se suscribe. La función que publica no cambió, y
sin embargo la segunda vez hubo un módulo más reaccionando. Es la misma inversión de
dependencias de la semana pasada, aplicada a la comunicación: el que publica
no importa al que escucha.
Antes de usarlo para todo, lean las otras dos pruebas del archivo, porque dicen lo que cuesta:
- Un suscriptor que falla no afecta a los demás, y quien publica se entera. Si un suscriptor falla, ¿quién se entera? Con una llamada directa, el error sube a quien llamó y la compra falla. Con un evento, hay que decidirlo: este bus junta los errores y se los devuelve a quien publicó, que casi siempre no sabrá qué hacer con ellos.
- Lo que nadie escuchaba a tiempo se pierde. El evento vive en la memoria del proceso. Si el proceso se cae entre la venta y la entrega del evento, el evento se pierde y nadie lo sabe. Un evento que no se puede perder necesita guardarse en algún lado, y eso ya es mensajería de verdad (semana 5 y, con más cuidado, semanas 12 y 13).
La regla práctica: una llamada cuando quien llama necesita el resultado para seguir (no se puede vender sin saber si había stock), y un evento cuando solo avisa de algo que ya pasó y no le importa quién reacciona (mandar el correo, actualizar una estadística).
Tinkuy: un monolito partido a medias
Con las tres condiciones en la mano, miren Tinkuy. Tiene carpetas por dominio
(catalog, orders, payments, notifications, reports) y cada una tiene
su index.ts. Parece un modular monolith. La herramienta opina otra cosa
(en tinkuy/):
$ make deps
depcruise src --config .dependency-cruiser.cjs

  error no-circular: src/catalog/events.ts →
      src/orders/index.ts →
      src/orders/create-order.ts →
      src/catalog/index.ts →
      src/catalog/events.ts
  error modules-only-through-index: src/reports/sales-report.ts → src/orders/order-repository.ts
  error modules-only-through-index: src/reports/sales-report.ts → src/catalog/events.ts
  error http-does-not-touch-db: src/http/order-handlers.ts → src/db.ts

x 4 dependency violations (4 errors, 0 warnings). 35 modules, 86 dependencies cruised.

make: *** [Makefile:51: deps] Error 4
En Tinkuy. Hoy Tinkuy es un monolito partido a medias: tiene los nombres de los módulos, pero no sus límites. La condición 3 falla (hay un ciclo entre
catalogyorders). La condición 1 falla (reportsentra a archivos internos deordersy decatalog). Y la condición 2 falla sin que la herramienta lo vea: las nueve tablas están en un solo esquema, y el SQL dereports/sales-report.tshaceJOINentresections,seats,order_itemsyorders, tablas de dos módulos que no son el suyo. P1 es convertirlo en un modular monolith con límites comprobados. Qué interfaz exporta cada módulo y qué hacer con eseJOINson decisiones suyas: las tres opciones de la sección anterior son el menú, y el ADR dice cuál eligieron y por qué.
Monolith first
Queda una pregunta: si al final muchos sistemas grandes terminan en microservicios, ¿por qué no empezar por ahí y ahorrarse el camino?
Martin Fowler respondió en 2015 con una nota corta, MonolithFirst, a partir de lo que veía en los equipos que conocía: casi todas las historias exitosas de microservicios habían empezado como un monolito que creció demasiado y se partió, y casi todos los sistemas que se construyeron como microservicios desde cero habían terminado en problemas serios. Da dos razones:
- La primera es no construir lo que todavía no hace falta. Al empezar un sistema nadie sabe si le va a servir a alguien; lo que importa es aprender rápido, y el costo de operar muchos servicios frena justo eso.
- La segunda es la que nos importa hoy: los servicios solo funcionan bien si sus límites son buenos y estables, y acertar los límites al comienzo es muy difícil, incluso para gente con experiencia en el dominio. Mover funcionalidad de un servicio a otro cuesta mucho más que moverla dentro de un monolito.
Dicho con el vocabulario de este capítulo: los límites de un dominio se
descubren usándolo. En un modular monolith, descubrir que una función estaba
en el módulo equivocado se arregla moviendo un archivo y ajustando dos
index.ts, en un commit, con el compilador revisando. Entre servicios, el
mismo descubrimiento es una migración de datos, dos despliegues coordinados y
una API que hay que mantener en dos versiones durante semanas.
Fowler no lo presenta como ley. En la misma nota dice que estaría más tranquilo recomendando “diseñar un monolito con cuidado y partirlo después” si hubiera oído más casos en que salió bien, y advierte que no se puede tomar un sistema cualquiera y partirlo: la mayoría acumula demasiadas dependencias entre sus módulos. Esa advertencia es el argumento a favor del modular monolith: el monolito que después se puede partir es el que mantuvo sus límites.
En la industria. Shopify contó en 2019 (Deconstructing the Monolith, de Kirsten Westeinde) cómo llevó este camino a una de las aplicaciones Ruby on Rails más grandes que existen, en la que habían trabajado más de mil personas. Hacia 2016 el monolito les pesaba: un cambio en un lugar rompía algo sin relación en otro. En vez de pasar a microservicios, eligieron un modular monolith. Primero reorganizaron el código: de carpetas por concepto de software (modelos, vistas, controladores, lo que este capítulo llama partir por rol técnico) a carpetas por concepto del negocio (órdenes, envíos, inventario, facturación), clasificando a mano unas seis mil clases y moviéndolas con scripts en un solo cambio. Después empezaron a aislar los componentes: cada uno con una interfaz pública y como owner exclusivo de sus datos. Y construyeron una herramienta interna, Wedge, que en cada corrida de integración continua arma el grafo de llamadas y lista las violaciones: llamadas a algo que no es público y asociaciones de datos entre componentes. Son las tres condiciones de esta sección, con una herramienta propia en el papel que aquí cumple dependency-cruiser.
Pipeline
Pipes y filtros
El estilo pipeline, o pipes and filters, tiene dos tipos de elementos:
- Filtros: cada uno recibe datos, hace una sola cosa con ellos y entrega el resultado.
- Pipes: los conectores. Llevan lo que sale de un filtro a la entrada del siguiente, en una sola dirección.
Y una restricción: un filtro no sabe nada de los demás. No sabe quién le manda los datos ni quién los recibe después. Lo único que conoce es el formato de lo que entra y el formato de lo que sale.
Lo han usado desde el primer curso de la carrera, cada vez que escribieron una
barra vertical en una terminal. Los comandos de Unix son filtros (leen texto,
escriben texto) y | es el pipe. Con el archivo de datos de esta semana, la
lista de precios de un distribuidor de libros:
$ tail -n +2 pipeline/data/supplier-books.csv | grep -v -e '^#' -e '^$' | cut -d';' -f3 | tr 'A-Z' 'a-z' | sort | uniq -c
      1 cuento
      3 ensayo
      5 novela
3 poesia(make pipeline corre este comando, después del pipeline que veremos
enseguida.) Seis programas que no se conocen entre sí (grep no sabe que después viene
cut), escritos por personas distintas en décadas distintas, resuelven juntos
“cuántos títulos hay por categoría”. Funciona porque todos respetan el mismo
formato: líneas de texto.
Otros dos pipelines que ya conocen: un compilador (el texto pasa por el analizador léxico, el sintáctico, el generador de código, y cada etapa entrega una representación a la siguiente) y un proceso de carga de datos (leer un archivo, limpiarlo, transformarlo, cargarlo).
Cuatro tipos de filtro
Según lo que hacen con los datos, los filtros se clasifican en cuatro tipos. Los nombres son los que usan Richards y Ford:
| Tipo | Qué hace | En el ejemplo de Unix |
|---|---|---|
| Productor | Inicia el pipeline: entrega datos y no recibe ninguno | tail leyendo el archivo |
| Transformador | Recibe un dato y entrega otro, con otra forma o contenido | cut, tr |
| Verificador (tester) | Recibe un dato y decide si pasa o se descarta | grep -v |
| Consumidor | Termina el pipeline: recibe datos y produce el resultado final | uniq -c escribiendo en la terminal |
La clasificación sirve para diseñar: un filtro que transforma y decide qué pasa está haciendo dos cosas, y casi siempre conviene partirlo en dos.
Un pipeline pequeño: la lista de precios del distribuidor
El distribuidor de Qhatu manda cada quincena un archivo así:
isbn;titulo;categoria;precio;stock
# Lista de precios del distribuidor, segunda quincena
978-612-0001;Yawar fiesta;novela;42,00;6
978-612-0002;Redoble por Rancas;NOVELA;48.50;4
978-612-0003;La casa de cartón;novela;35,00;0
978-612-0004;España, aparta de mí este cáliz;poesia;28,00;9
978-612-0005;Cinco metros de poemas;poesia;31,90;3

978-612-0006;El laberinto de la choledad;ensayo;;5
978-612-0007;Perú: problema y posibilidad;ensayo;39,00;2
978-612-0002;Redoble por Rancas;novela;48,50;4
978-612-0008;Canto ceremonial contra un oso hormiguero;poesia;27,00;-1
978-612-0009;Lima la horrible;ensayo;36,00;7
978-612-0010;Un mundo para Julius;cuento;55,00;2
978-612-0011;País de Jauja;novela;59,00;1;oferta
Es un archivo como los de verdad: tiene un comentario, una línea vacía, precios con coma y con punto, una categoría en mayúsculas, un precio que falta, un ISBN repetido, un stock negativo, una categoría que Qhatu no vende y una fila con un campo de más. (El pipeline de Unix de arriba no validó nada de eso: contó cinco novelas, entre ellas la repetida y la del campo sobrante, y una categoría cuento que no existe en la tienda.)
La carga está en code/week-04/pipeline/, escrita como un pipeline: un
archivo por filtro en src/filters/, los consumidores en src/consumers/ y
los formatos de los datos en src/formats.ts.
El pipe es un iterador asíncrono de JavaScript, y un filtro es una función que recibe una secuencia y devuelve otra. Todo el mecanismo cabe en veinte líneas:
// Pipes and filters con iteradores asíncronos. Un filtro recibe una secuencia
// y devuelve otra; el pipe es la secuencia misma, que entrega un elemento
// cada vez que el filtro siguiente lo pide.

export type Filter<In, Out> = (input: AsyncIterable<In>) => AsyncIterable<Out>;
export type Consumer<In, Result> = (input: AsyncIterable<In>) => Promise<Result>;

export type Pipeline<T> = {
  /** Conecta un filtro. El compilador exige que su entrada sea lo que sale del anterior. */
  through<U>(filter: Filter<T, U>): Pipeline<U>;
  /** Conecta el consumidor y pone todo en marcha: hasta aquí no se leyó nada. */
  into<Result>(consumer: Consumer<T, Result>): Promise<Result>;
};

export function from<T>(source: AsyncIterable<T>): Pipeline<T> {
  return {
    through: (filter) => from(filter(source)),
    into: (consumer) => consumer(source),
  };
}
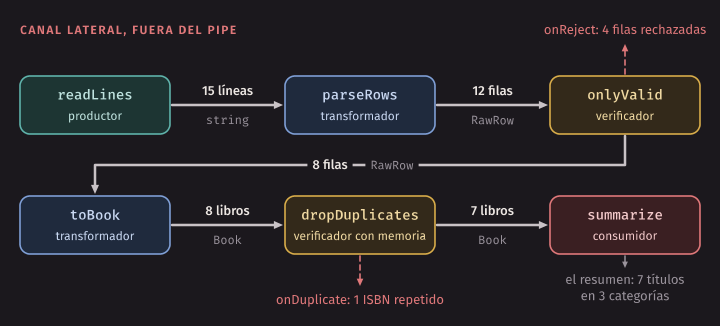
Y el programa principal es la lista de filtros, en orden:
const summary = await from(readLines(file))
  .through(parseRows(';'))
  .through(onlyValid((rejection) => rejected.push(rejection)))
  .through(toBook)
  .through(dropDuplicates((book) => duplicated.push(book.isbn)))
  .into(summarize);
readLines es el productor; parseRows y toBook, transformadores;
onlyValid y dropDuplicates, verificadores; summarize, el consumidor.
Corrido sobre el archivo:
$ node pipeline/src/main.ts
categoría  títulos  ejemplares  valor del stock
novela           3          10        S/ 446.00
poesia           2          12        S/ 347.70
ensayo           2           9        S/ 330.00

Filas rechazadas: 4
  línea 9: falta precio
  línea 12: stock no válido: -1
  línea 14: categoría desconocida: cuento
  línea 15: tiene 1 campo(s) de más
ISBN repetidos: 978-612-0002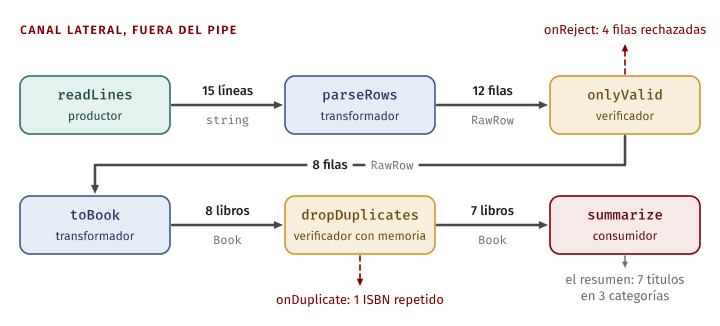
Filtros que se prueban, se reemplazan y se reordenan
Lo que el estilo favorece sale directo de su restricción. Como un filtro solo conoce su entrada y su salida:
Se prueba solo. toBook es el transformador que convierte una fila de
texto en un libro. Para probarlo no hace falta un archivo ni el resto
del pipeline: se le da un arreglo de filas hecho a mano y se mira lo que sale.
Todas las pruebas de pipeline/test/filters.test.ts son así:
test('toBook: categoría en minúsculas y precio en céntimos, con coma o con punto', async () => {
  const rows = [row(2, 'A', 'Uno', 'NOVELA', '48.50', '4'), row(3, 'B', 'Dos', 'poesia', '31,90', '3')];
  assert.deepEqual(await collect(toBook(fromArray(rows))), [
    { isbn: 'A', title: 'Uno', category: 'novela', priceCents: 4850, stock: 4 },
    { isbn: 'B', title: 'Dos', category: 'poesia', priceCents: 3190, stock: 3 },
  ]);
  assert.equal(parsePriceCents('42'), 4200);
  assert.equal(parsePriceCents('0,05'), 5);
});
Se reemplaza sin tocar a los vecinos. Cambiar de dónde vienen las líneas
(de un archivo a una respuesta HTTP) es cambiar el productor. Cambiar qué se
hace con los libros (de un resumen a cargarlos en la base de datos) es cambiar
el consumidor. Si el distribuidor empieza a separar con comas, cambia un
parámetro de parseRows.
Se reordena… con cuidado. Esta es la propiedad que más se exagera. Dos
filtros se pueden cambiar de orden cuando tienen el mismo tipo de entrada y de
salida y ninguno depende de lo que hizo el otro. En
pipeline/test/pipeline.test.ts hay una prueba de cada caso.
onlyInStock y onlyCategory miran cada libro por separado, así que da lo
mismo cuál va primero. dropDuplicates tiene memoria: se queda con la primera
aparición de cada ISBN, y cuál es “la primera” depende de qué filtró alguien
antes. La prueba construye el caso: el mismo ISBN aparece dos veces, con
categorías distintas, y los dos órdenes dan resultados distintos.
test('un filtro con memoria no siempre se puede cambiar de orden', async () => {
  // El mismo ISBN aparece dos veces, con categorías distintas.
  const source: Book[] = [
    { isbn: 'A', title: 'Primera', category: 'novela', priceCents: 100, stock: 1 },
    { isbn: 'A', title: 'Segunda', category: 'poesia', priceCents: 100, stock: 1 },
  ];
  const dedupeFirst = await from(fromArray(source)).through(dropDuplicates()).through(onlyCategory('poesia')).into(collect);
  const dedupeLast = await from(fromArray(source)).through(onlyCategory('poesia')).through(dropDuplicates()).into(collect);
  assert.deepEqual(dedupeFirst, []);
  assert.deepEqual(
    dedupeLast.map((book) => book.title),
    ['Segunda'],
  );
});
Error común. Creer que en un pipeline cualquier filtro se puede mover a cualquier posición. Los filtros sin memoria que comparten tipo, sí. Un filtro con memoria (quitar duplicados, numerar, acumular) tiene un lugar que importa, y ese lugar es una decisión que debería estar escrita en una prueba.
Las dos últimas pruebas de ese archivo muestran una propiedad de esta forma de implementar el
pipe: los datos se piden de uno en uno, desde el final. Nada se lee hasta que
se conecta el consumidor, y si el consumidor deja de pedir (take(2)), el
productor entrega dos elementos y se cierra, aunque tuviera mil. El archivo
nunca se carga entero en memoria: en cada momento hay una línea viajando por
el pipeline.
El formato es el acoplamiento
Los filtros no se conocen entre sí, pero todos conocen el formato de los datos. Ese es el acoplamiento del estilo, y es fuerte.
En el pipeline de Qhatu hay dos formatos, declarados en src/formats.ts: la
fila de texto (RawRow) y el libro:
/** Un libro listo para cargar al catálogo. */
export type Book = {
  isbn: string;
  title: string;
  category: Category;
  priceCents: number;
  stock: number;
};
¿Qué pasa si el precio deja de ser un número de céntimos y pasa a ser un monto con su moneda, porque el distribuidor empieza a vender en dólares? Hay que tocar todo filtro que lea ese campo:
$ grep -rln "priceCents" src | sort
src/consumers/summarize.ts
src/filters/to-book.ts
src/formats.ts
Tres de los once archivos de src/, que no se conocen entre sí, cambian
juntos por una decisión sobre el formato. Y el compilador ayuda solo porque
el formato está declarado como un tipo; en el pipeline de Unix, donde el
formato es “la tercera columna separada por punto y coma”, un cambio de
columnas rompe el pipeline entero sin que nadie avise.
Esto es lo que Parnas denunció en 1972, y vale la pena releerlo con ojos de esta semana. Su primera descomposición del índice KWIC (leer, rotar, ordenar, imprimir) es un pipeline: cada módulo es un paso del procesamiento, y todos conocen cómo están guardadas las líneas. Parnas mostró que un cambio en esa representación obligaba a tocar todos los módulos. No concluyó que los pipelines sean malos, sino que dividir por pasos deja sin esconder la decisión más propensa a cambiar: el formato.
Trade-off. El pipeline compra filtros independientes (probar, reemplazar, reordenar) y paga con un formato compartido que todos conocen. Conviene cuando el formato es estable y los pasos cambian seguido (las líneas de texto de Unix llevan cincuenta años iguales). No conviene cuando lo que cambia seguido es la forma de los datos: ahí cada cambio recorre todos los filtros.
Dónde no sirve
Además del formato, el estilo tiene límites que conviene conocer antes de elegirlo:
- No sirve para interacciones de ida y vuelta. Los datos van en una dirección. Un flujo en el que un paso tiene que preguntarle algo al anterior, o esperar la respuesta de una persona, no es un pipeline. Comprar una entrada (elegir asiento, pagar, quizá reintentar con otra tarjeta) no lo es.
- Los errores no tienen un camino natural. Si un filtro rechaza un dato,
¿adónde va? En el ejemplo,
onlyValidrecibe una funciónonRejecta la que le avisa: es un canal lateral, fuera del pipe. Funciona, pero ya no es cierto que el filtro solo se comunica por su entrada y su salida. La alternativa es que por el pipe viajen también los rechazos, marcados, y que cada filtro los deje pasar; es más puro y complica a todos los filtros. - Un filtro que necesita ver todo rompe el flujo. Ordenar exige tener todos los datos antes de entregar el primero. El pipeline sigue funcionando, pero ese filtro guarda todo en memoria y los de más adelante esperan.
En Tinkuy. Dos partes de Tinkuy tienen forma de pipeline, aunque hoy no estén escritas así. La validación de una orden es una cadena de verificadores (¿el cuerpo tiene la forma correcta?, ¿existe el evento?, ¿no pasa el límite de asientos?, ¿los asientos están libres?): cada uno deja pasar la orden o la detiene. Y el reporte de ventas es una cadena de transformaciones sobre las órdenes pagadas (agrupar por sección, agrupar por hora, totalizar). La compra completa, en cambio, no lo es: tiene una llamada de ida y vuelta a la pasarela en el medio.
Microkernel
El problema: un if por variante
Qhatu entrega los libros de dos formas: recojo en tienda (pickup) y envío a
domicilio (courier). Cada forma tiene sus datos de destino, su tarifa y su
línea en la etiqueta del paquete. La manera más directa de escribirlo es la de
code/week-04/microkernel/before/: junto a los tipos y al checkout.ts que
los usa, tres archivos, uno por cada cosa que hay que hacer, y en cada uno un
if que pregunta por la forma de entrega.
export function shippingQuote(
  method: MethodId,
  parcel: Parcel,
  destination: Destination,
): { costCents: number; businessDays: number } {
  if (method === 'pickup') {
    return { costCents: 0, businessDays: 1 };
  } else if (method === 'courier') {
    const zone = zoneOf(destination.district)!;
    if (parcel.subtotalCents >= FREE_SHIPPING_FROM_CENTS) return { costCents: 0, businessDays: BUSINESS_DAYS[zone] };
    const extraKg = Math.max(0, Math.ceil(parcel.weightGrams / 1000) - 1);
    return { costCents: BASE_CENTS[zone] + extraKg * EXTRA_KG_CENTS, businessDays: BUSINESS_DAYS[zone] };
  }
  throw new Error('Forma de entrega desconocida');
}
El mismo if está en validate-destination.ts y en dispatch-note.ts, y la
lista de formas válidas está en types.ts. Funciona, tiene pruebas, y para
dos formas de entrega es perfectamente razonable.
El costo aparece cuando llega la tercera. Qhatu quiere entregar en
casilleros de autoservicio (locker). El cambio está hecho, como un .diff,
y se puede contar:
$ make tercer-plugin
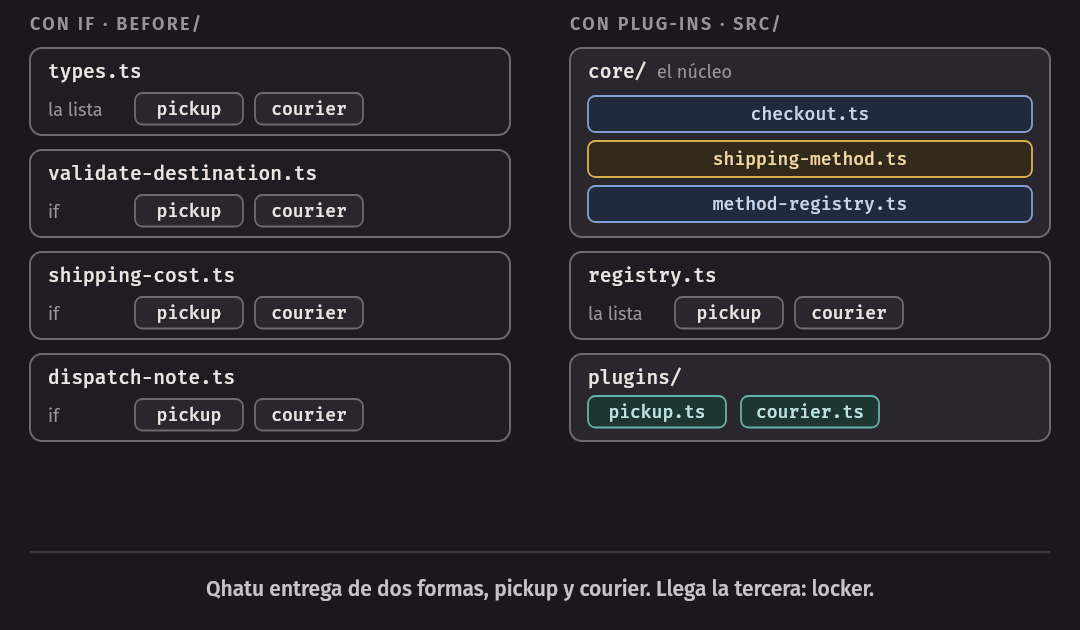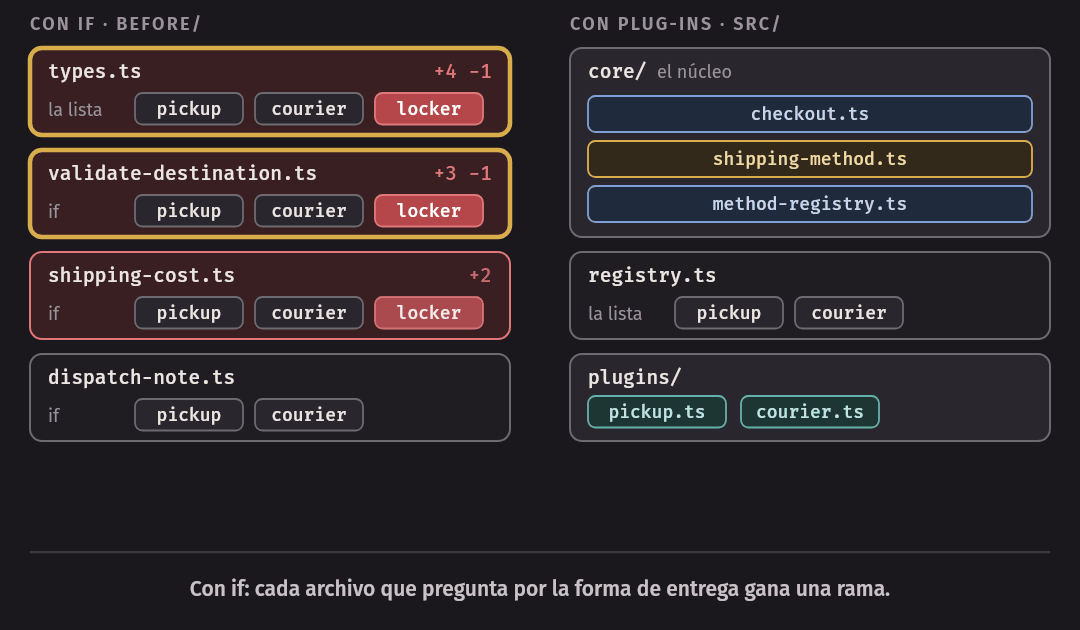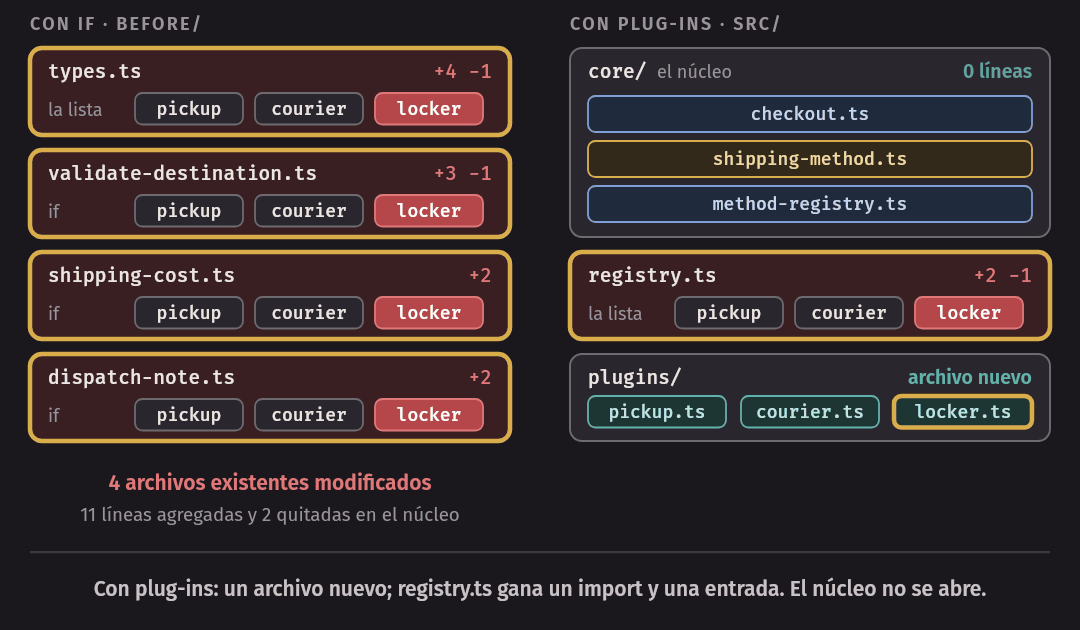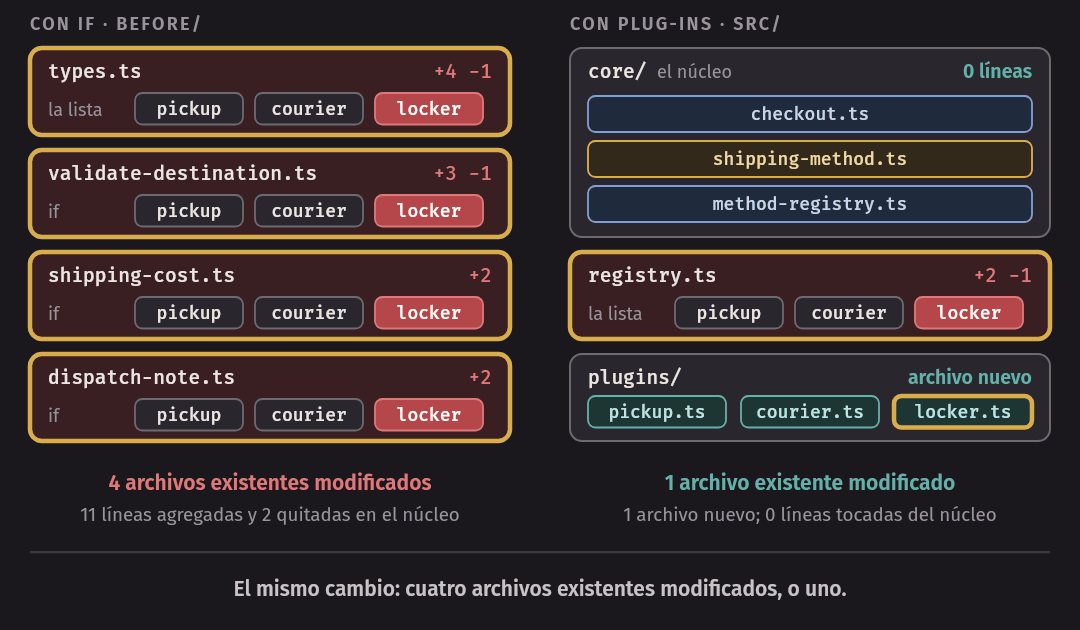
== Con ifs (before/): archivos existentes que cambian
 before/dispatch-note.ts        |    2 ++
 before/shipping-cost.ts        |    2 ++
 before/types.ts                |    5 ++++-
 before/validate-destination.ts |    4 +++-
 4 files changed, 11 insertions(+), 2 deletions(-)
Cuatro archivos existentes modificados para una variante nueva. Ninguna de las once líneas es difícil. El problema es otro:
- Hay que saber que son cuatro. Nada en el código dice “si agregas una
forma de entrega, estos son los lugares”. Se encuentran buscando el texto
'courier'y esperando que nadie haya escrito la pregunta de otra manera. - Los cuatro archivos son del núcleo de la aplicación. Quien agrega casilleros edita la función que calcula el costo del envío a domicilio, y puede romperla.
- Dos personas agregando dos formas de entrega a la vez editan las mismas líneas de los mismos archivos.
En Tinkuy. El primer paso del laboratorio es esta misma búsqueda, sobre los medios de pago (
make mediosla corre desdecode/week-04/):$ grep -rn "'card'\|'yape'" src src/payments/types.ts:1:export type PaymentMethod = 'card' | 'yape'; src/payments/types.ts:3:export const PAYMENT_METHODS: readonly PaymentMethod[] = ['card', 'yape']; src/payments/types.ts:7: | { method: 'card'; cardNumber: string; holder: string } src/payments/types.ts:8: | { method: 'yape'; phone: string; approvalCode: string }; src/payments/gateway-client.ts:12: if (payment.method === 'card') { src/payments/gateway-client.ts:14: } else if (payment.method === 'yape') { src/orders/validation.ts:46: if (method === 'card') { src/orders/validation.ts:55: } else if (method === 'yape') { src/orders/fees.ts:9: if (method === 'card') { src/orders/fees.ts:11: } else if (method === 'yape') {Cuatro archivos en dos módulos. Tres de ellos tienen un
ifpor medio de pago: uno valida los datos del pago, otro calcula la comisión y otro arma lo que se le envía a la pasarela. El cuarto declara la lista de medios. Es la misma forma quebefore/, y el requisito de P1 es que agregar el tercer medio no toque el núcleo.
Núcleo, contrato y registro
El estilo microkernel, también llamado arquitectura de plug-ins, parte el sistema en dos tipos de elementos:
- Un núcleo pequeño y estable, que contiene lo que es común a todas las variantes.
- Plug-ins, uno por variante, que agregan al núcleo un comportamiento específico.
Y dos piezas que los unen:
- El contrato: una interfaz, definida por el núcleo, que dice qué le puede pedir el núcleo a cualquier plug-in.
- El registro: el lugar donde los plug-ins se inscriben y donde el núcleo los busca.
Las restricciones: el núcleo no conoce a ningún plug-in concreto, solo el contrato; y un plug-in no conoce a los demás ni las partes internas del núcleo.
Ejemplos que usan todos los días: un editor de código con sus extensiones, un navegador con las suyas, un sistema operativo con sus drivers. En todos hay un programa que funciona solo y un mecanismo para que otros le agreguen variantes sin tocarlo.
La misma lógica de entregas, reescrita con este estilo, está en
microkernel/src/: el núcleo en core/ (el contrato, el registro y la
lógica), un archivo por forma de entrega en plugins/, y registry.ts.
Empecemos por el contrato, que es la decisión de diseño más importante:
// El contrato: lo único que el núcleo sabe de una forma de entrega, y lo
// único del núcleo que una forma de entrega puede importar.

/** El paquete que se va a enviar. */
export type Parcel = {
  weightGrams: number;
  subtotalCents: number;
};

/**
 * Los datos de destino que escribió el comprador, como campos de texto. Cada
 * forma de entrega pide los suyos (una tienda, una dirección, un casillero);
 * el núcleo los transporta sin mirarlos.
 */
export type Destination = Readonly<Record<string, string>>;

export type Quote = {
  costCents: number;
  businessDays: number;
};

export interface ShippingMethod {
  /** Identificador estable, en minúsculas: es lo que llega en el pedido. */
  readonly id: string;
  /** El nombre que ve el comprador. */
  readonly label: string;

  /** Los problemas del destino, en español; una lista vacía quiere decir que es válido. */
  validate(destination: Destination): string[];

  /** Costo y plazo. El núcleo solo la llama con un destino que pasó validate. */
  quote(parcel: Parcel, destination: Destination): Quote;

  /** La línea que se imprime en la etiqueta del paquete. Igual: solo con un destino válido. */
  dispatchNote(destination: Destination): string;
}
Tres operaciones, una por cada if de la versión anterior: validar el
destino, cotizar, armar la línea de la etiqueta. El contrato dice qué entra y
qué sale de cada una, y también el orden: el núcleo promete no pedir una
cotización con un destino que no pasó validate.
El núcleo usa el contrato y nada más:
export function planDelivery(registry: MethodRegistry, request: DeliveryRequest): DeliveryPlan {
  const method = registry.get(request.methodId);
  if (!method) {
    const known = registry.all().map((each) => each.id);
    throw new DeliveryError([`Forma de entrega desconocida: ${request.methodId} (hay: ${known.join(', ')})`]);
  }

  const problems = method.validate(request.destination);
  if (problems.length > 0) throw new DeliveryError(problems);

  const quote = method.quote(request.parcel, request.destination);
  // El núcleo no confía a ciegas en un plug-in: lo que devuelve tiene que ser un costo y un plazo.
  if (!Number.isInteger(quote.costCents) || quote.costCents < 0 || quote.businessDays < 1) {
    throw new Error(`La forma de entrega ${method.id} devolvió una cotización no válida`);
  }

  return {
    methodId: method.id,
    label: method.label,
    shippingCents: quote.costCents,
    totalCents: request.parcel.subtotalCents + quote.costCents,
    businessDays: quote.businessDays,
    dispatchNote: method.dispatchNote(request.destination),
  };
}
Busquen un if que pregunte por 'pickup' o por 'courier': no hay. El
núcleo no sabe cuántas formas de entrega existen ni cómo se llaman. Sí hay
algo que antes no estaba: una revisión de lo que devuelve el plug-in. Un
núcleo no debería confiar a ciegas en código que no es suyo.
Los dos plug-ins
Cada forma de entrega es un archivo que implementa el contrato. La más simple:
import type { ShippingMethod } from '../core/shipping-method.ts';

// Recojo en tienda: gratis, al día siguiente, en una de las dos tiendas.

const STORES: Readonly<Record<string, string>> = {
  centro: 'Jr. Camaná 615, Lima',
  miraflores: 'Av. Larco 345, Miraflores',
};

const pickup: ShippingMethod = {
  id: 'pickup',
  label: 'Recojo en tienda',

  validate(destination) {
    const store = destination.store ?? '';
    return store in STORES ? [] : [`store debe ser una de: ${Object.keys(STORES).join(', ')}`];
  },

  quote() {
    return { costCents: 0, businessDays: 1 };
  },

  dispatchNote(destination) {
    return `RECOJO EN TIENDA · ${STORES[destination.store ?? '']}`;
  },
};

export default pickup;
Todo lo que el sistema sabe sobre el recojo en tienda está en estas
veintiocho líneas: las tiendas, la validación, la tarifa, la etiqueta. En la
versión con if, eso mismo estaba repartido en cuatro archivos y mezclado
con lo del envío a domicilio. Es la cohesión de la semana pasada: las cosas
que cambian juntas ahora viven juntas.
El envío a domicilio (plugins/courier.ts) es más largo, porque su tarifa
depende de la zona y del peso, pero tiene la misma forma. Y el registro es
la lista:
import { createRegistry } from './core/method-registry.ts';
import courier from './plugins/courier.ts';
import pickup from './plugins/pickup.ts';

// El registro estático: la lista de formas de entrega que trae la aplicación.
// Es el único archivo que conoce a los plug-ins por su nombre.
export const registry = createRegistry([pickup, courier]);
$ make cotizar
Paquete de 2300 g, compra de S/ 97.00
pickup Recojo en tienda envío S/ 0.00 total S/ 97.00 1 día(s) [RECOJO EN TIENDA · Av. Larco 345, Miraflores]
courier Envío a domicilio envío S/ 16.00 total S/ 113.00 3 día(s) [DOMICILIO · Av. Túpac Amaru 1234, Comas]Para asegurarnos de que el cambio de estilo no cambió el comportamiento, una
prueba (microkernel/test/before-and-after.test.ts) compara las dos
versiones, la de los if y la de los plug-ins, sobre 54 pedidos: tres formas
de entrega, una de ellas inexistente, por tres paquetes y seis destinos. Dan
el mismo plan o el mismo error en los 54.
Las pruebas del núcleo (checkout.test.ts), además, no usan ningún plug-in de verdad: registran
un objeto de prueba que cumple el contrato y anota cómo lo llamaron. El núcleo
se puede probar sin que exista ninguna forma de entrega.
Quién llama a quién
Vale la pena detenerse en las flechas, porque el microkernel es la inversión de dependencias de la semana pasada convertida en estilo.
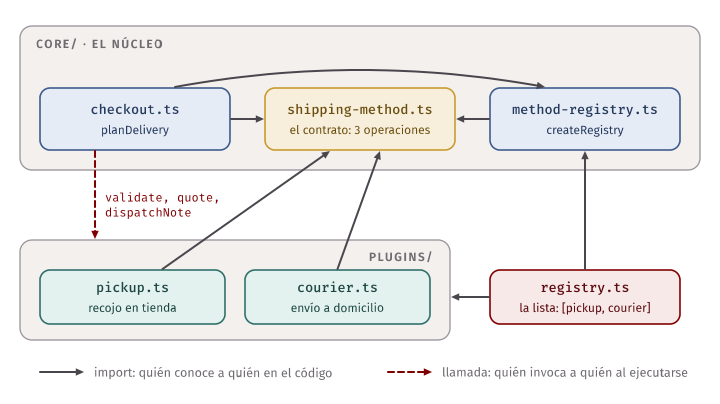
- Al ejecutarse, el núcleo llama al plug-in:
planDeliveryinvocamethod.validate(...)ymethod.quote(...). - En el código, el
importva al revés:plugins/pickup.tsimportacore/shipping-method.ts. El núcleo no importa nada deplugins/.
El núcleo declara la interfaz que necesita y los plug-ins la implementan. Y
registry.ts es el composition root: el único archivo que conoce a los dos
lados y los junta.
Las reglas de dependency-cruiser del ejemplo
(microkernel/.dependency-cruiser.cjs) escriben eso mismo. Son cuatro, además
de la de ciclos: el núcleo no importa plug-ins ni el registro; solo el
registro importa plug-ins; del resto de la aplicación, un plug-in solo importa
el contrato; y un plug-in no hace entrada ni salida. La primera:
{
  name: 'core-does-not-know-plugins',
  comment: 'El núcleo no importa ninguna forma de entrega concreta, ni la lista que las reúne.',
  severity: 'error',
  from: { path: '^src/core/' },
  to: { path: ['^src/plugins/', '^src/registry\\.ts$', '^src/discover\\.ts$'] },
},
Las que hablan de los plug-ins dicen qué le está prohibido a un plug-in,
que es tan parte del contrato como sus tres operaciones. En errors/ hay dos
archivos que rompen las reglas a propósito. Uno es un plug-in que abre la base de datos por
su cuenta para buscar su tarifa; el otro, una función del núcleo que importa
a courier para darle un trato especial:
$ make cruces
== errors/plugin-reads-db.ts y errors/core-knows-plugin.ts en el microkernel

  error plugins-do-no-io: src/plugins/plugin-reads-db.ts → ../../../../../../opt/course/node_modules/pg/lib/index.js
  error only-the-registry-imports-plugins: src/core/core-knows-plugin.ts → src/plugins/courier.ts
  error core-does-not-know-plugins: src/core/core-knows-plugin.ts → src/plugins/courier.ts

x 3 dependency violations (3 errors, 0 warnings). 14 modules, 21 dependencies cruised.

depcruise terminó con código 3
El segundo es el más instructivo. core-knows-plugin.ts es un if por forma
de entrega que volvió a entrar al núcleo, con una buena excusa (“solo para
courier, avisar si tarda más de dos días”). Así se deshace un microkernel: un
caso especial a la vez. La pregunta correcta ante ese pedido es qué le falta
al contrato para que el núcleo no tenga que preguntar quién es el plug-in.
La tercera forma de entrega
Ahora sí, el casillero. En la versión con plug-ins es un archivo nuevo,
locker.ts, con la misma forma que pickup.ts: un código de casillero que
validar, una tarifa única de S/ 5.00 y su línea de etiqueta. Esta es la
segunda mitad de la salida de make tercer-plugin, que antes cortamos:
$ make tercer-plugin
== Con plug-ins (src/): un archivo nuevo, y los existentes que cambian
 src/registry.ts |    3 ++-
 1 file changed, 2 insertions(+), 1 deletion(-)
== La copia con el tercer plug-in
Paquete de 2300 g, compra de S/ 97.00
  pickup   Recojo en tienda     envío  S/ 0.00  total  S/ 97.00  1 día(s)  [RECOJO EN TIENDA · Av. Larco 345, Miraflores]
  courier  Envío a domicilio    envío S/ 16.00  total S/ 113.00  3 día(s)  [DOMICILIO · Av. Túpac Amaru 1234, Comas]
  locker   Casillero            envío  S/ 5.00  total S/ 102.00  2 día(s)  [CASILLERO · LK-0420]

✔ no dependency violations found (12 modules, 19 dependencies cruised)

✔ locker: tiene un destino válido de ejemplo (0.109042ms)
✔ locker: un destino vacío se rechaza con un mensaje, sin lanzar (0.127667ms)
✔ locker: cotiza un costo entero no negativo y al menos un día (0.0745ms)
✔ locker: no modifica lo que recibe y responde lo mismo dos veces (0.060625ms)
ℹ tests 12
ℹ pass 12
ℹ fail 0
Agregar locker |
Con if |
Con plug-ins |
|---|---|---|
| Archivos nuevos | 0 | 1 (plugins/locker.ts) |
| Archivos existentes modificados | 4 | 1 (registry.ts: el import y la entrada en la lista) |
| Líneas tocadas del núcleo | 11 agregadas, 2 quitadas | 0 |
(Los archivos de la tabla los comprueba microkernel/test/change-cost.test.ts
sobre los mismos .diff.)
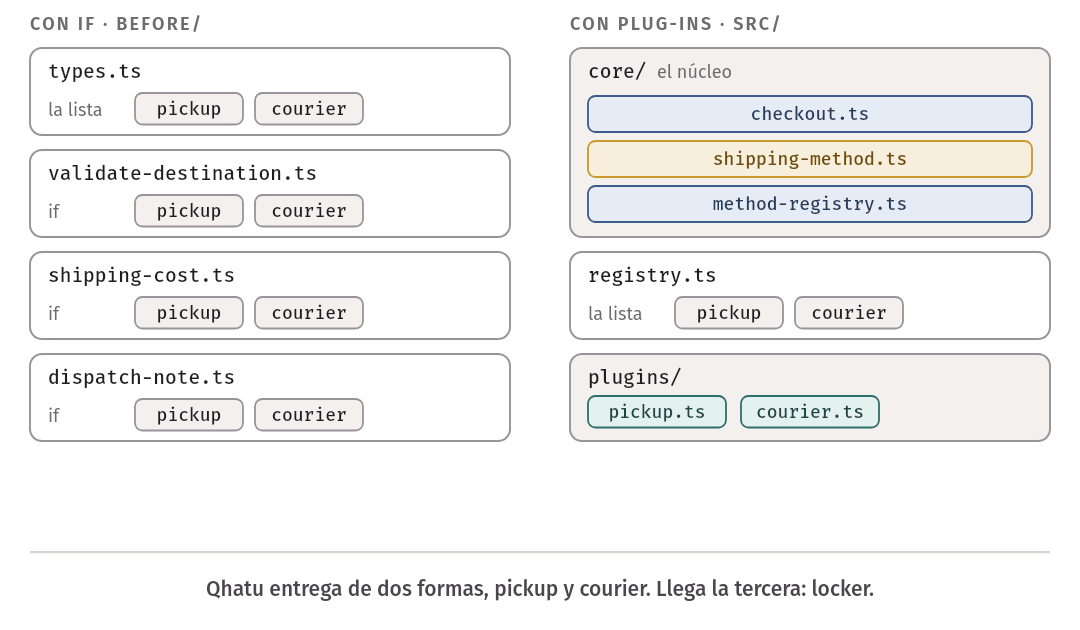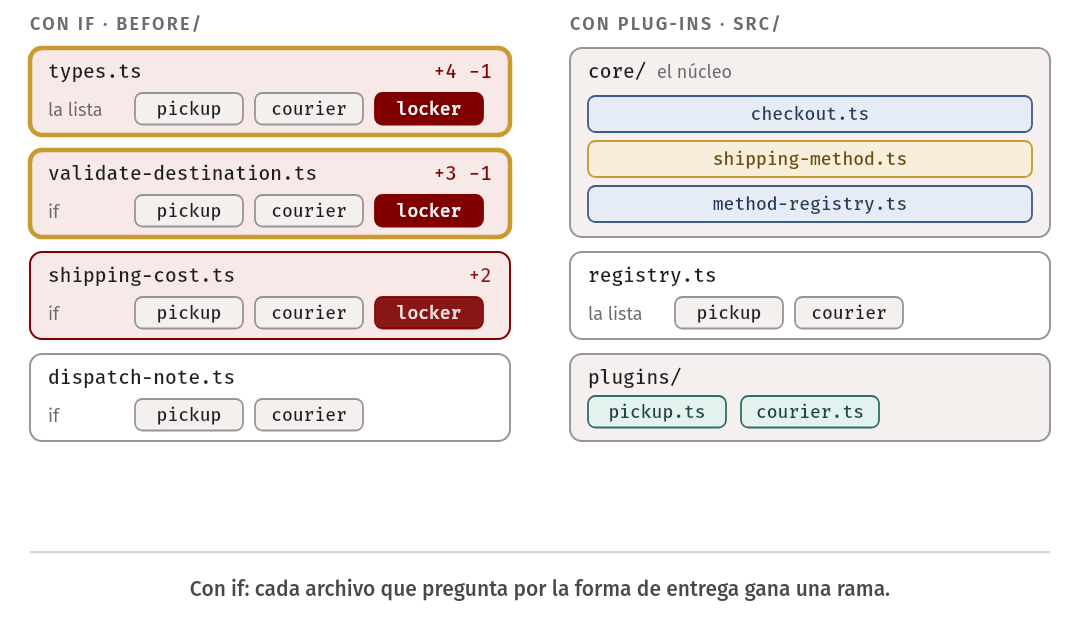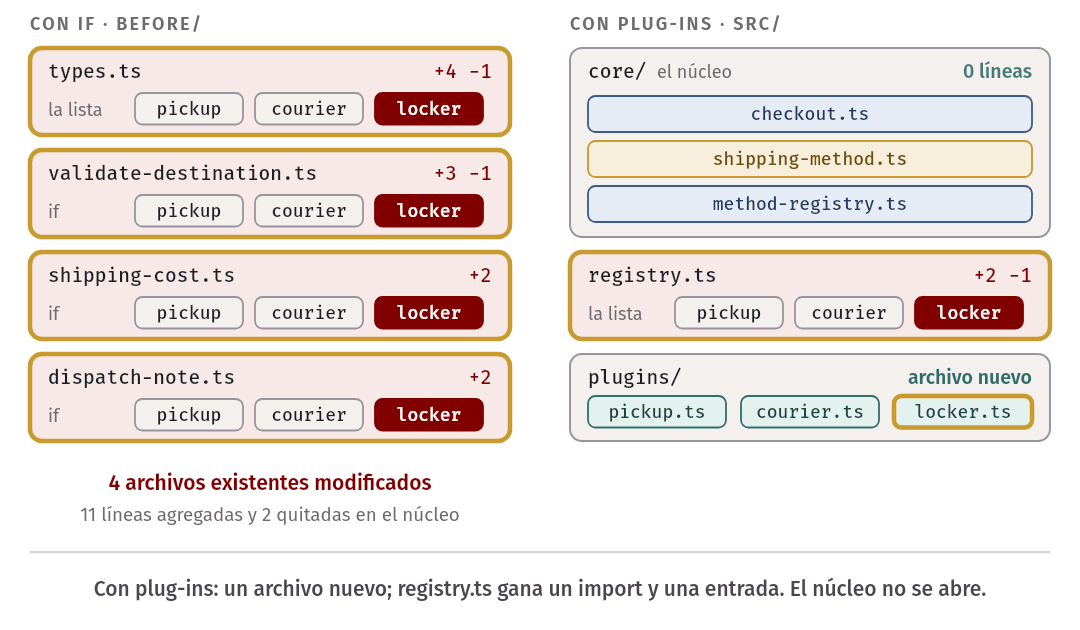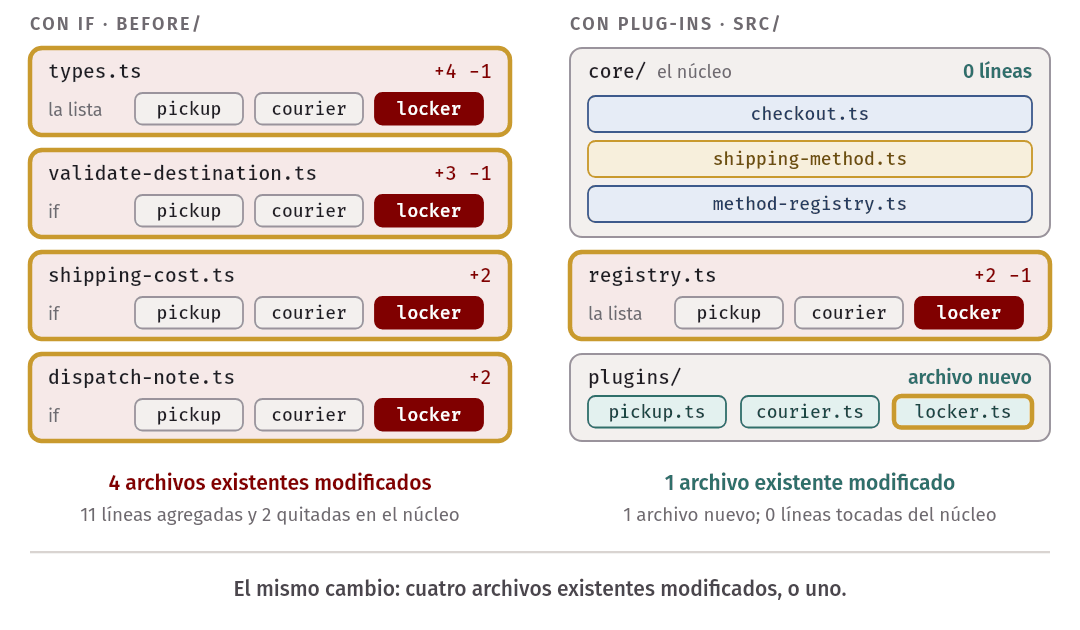
Tres cosas de esa salida merecen atención:
- El núcleo no cambió. Quien escribió
locker.tsno abriócheckout.ts, y por lo tanto no pudo romper ni el recojo en tienda ni el envío a domicilio. - dependency-cruiser pasa: el plug-in nuevo respeta las reglas.
- Las cuatro pruebas de
lockerque aparecen no las escribió nadie paralocker. Son las pruebas del contrato.
Pruebas del contrato
Si el núcleo supone cosas de cualquier plug-in (que validate devuelve una
lista y no lanza, que quote devuelve un entero no negativo, que nada
modifica lo que recibe), esas suposiciones se pueden escribir una vez y
correr contra todos los plug-ins registrados. El archivo recorre el registro
(for (const method of registry.all())) y define cuatro pruebas por cada
forma de entrega; esta es una:
test(`${method.id}: cotiza un costo entero no negativo y al menos un día`, () => {
  for (const parcel of parcels) {
    const quote = method.quote(parcel, validDestinations[method.id]!);
    assert.ok(Number.isInteger(quote.costCents) && quote.costCents >= 0);
    assert.ok(Number.isInteger(quote.businessDays) && quote.businessDays >= 1);
  }
});
Quien agrega un plug-in agrega una línea (su destino de ejemplo) y recibe
cuatro pruebas. Las pruebas del contrato no reemplazan a las pruebas propias
de cada plug-in (que la tarifa de courier sea la correcta lo comprueba
plugins.test.ts), pero convierten el contrato de un comentario en algo que
falla si alguien lo incumple.
Registro estático o descubrimiento
registry.ts es un registro estático: una lista escrita en el código.
Por eso agregar locker todavía tocó un archivo existente. La alternativa es
el descubrimiento: que la aplicación cargue, al arrancar, todo lo que
encuentre en una carpeta. src/discover.ts lo hace: lee los archivos .ts
de plugins/, los carga con import() y registra lo que cada uno exporta
por omisión.
$ node microkernel/src/main.ts --discover
Paquete de 2300 g, compra de S/ 97.00
  courier  Envío a domicilio    envío S/ 16.00  total S/ 113.00  3 día(s)  [DOMICILIO · Av. Túpac Amaru 1234, Comas]
  pickup   Recojo en tienda     envío  S/ 0.00  total  S/ 97.00  1 día(s)  [RECOJO EN TIENDA · Av. Larco 345, Miraflores]
Con descubrimiento, agregar una forma de entrega es copiar un archivo a
plugins/: cero archivos existentes modificados. Antes de concluir que es
mejor, miren lo que cambió:
- El orden. En la salida de arriba,
courieraparece antes quepickup: es el orden alfabético de los archivos. Con el registro estático, el orden en que se ofrecen las formas de entrega era una decisión visible en una línea; ahora depende de cómo se llama cada archivo. - El compilador ya no ve a los plug-ins. Nadie los importa por su nombre,
así que
tscno comprueba que cumplan el contrato. Por esodiscover.tstiene que revisarlo al cargar (isShippingMethod), y el error que antes era de compilación ahora aparece al arrancar. Hay una prueba que lo muestra: un archivo al que le faltadispatchNotese detecta recién cuando se carga. - Ya no se puede saber qué trae la aplicación leyendo el código. Hay que mirar la carpeta en la máquina donde corre.
| Registro estático | Descubrimiento | |
|---|---|---|
| Archivos existentes que toca un plug-in nuevo | 1 | 0 |
| ¿El compilador comprueba el contrato? | Sí | No: se revisa al arrancar |
| ¿Dónde se ve qué plug-ins hay? | En el código | En la carpeta |
| ¿Puede agregar un plug-in alguien sin acceso al código del núcleo? | No | Sí |
La última fila es la que decide. El descubrimiento se justifica cuando los plug-ins los escribe otra gente: otro equipo, otra empresa, los usuarios. Si todos los plug-ins viven en el mismo repositorio y los escribe el mismo equipo, una línea en una lista es un precio bajo por tener al compilador de su lado.
En la industria. Eclipse, el entorno de desarrollo, es el caso de manual del estilo llevado al extremo: según el capítulo sobre Eclipse de The Architecture of Open Source Applications (Kim Moir), una de sus ideas centrales es que todo es un plug-in, tanto lo que trae la plataforma como lo que escribe un tercero. Cada plug-in declara en un archivo de manifiesto qué puntos de extensión ofrece y a cuáles contribuye. Al arrancar, la plataforma lee los manifiestos de todos los plug-ins instalados y arma en memoria un registro que relaciona puntos de extensión con extensiones; es descubrimiento, no una lista en el código. Y el código de un plug-in no se carga hasta que se usa (el capítulo lo llama lazy activation), para que instalar más plug-ins no haga más lento el arranque. El capítulo también cuenta el precio: la consigna del proyecto era “API is forever”, porque otros construían sobre esos contratos, y cuando en la versión 3.0 cambiaron el runtime por uno basado en OSGi tuvieron que entregar una capa de compatibilidad para que los plug-ins existentes siguieran funcionando.
Cómo se diseña un contrato
El contrato es la parte del microkernel que más cuesta cambiar. Un plug-in se puede reescribir entero sin que nadie se entere; un cambio en el contrato obliga a tocar el núcleo y todos los plug-ins, incluidos los que escribió otra gente. Por eso se diseña con más cuidado que cualquier otra interfaz del sistema. Cuatro preguntas ordenan ese diseño:
¿Qué puede pedirle el núcleo a un plug-in? Una operación por cada decisión
que hoy depende de la variante. La forma de encontrarlas es mecánica: buscar
todos los if que preguntan por la variante y anotar qué decide cada uno. En
before/ eran tres (validar, cotizar, etiquetar) y el contrato tiene tres
operaciones. Si aparece un cuarto if después, al contrato le faltaba algo.
¿Qué datos cruzan la frontera? El núcleo le pasa al plug-in solo lo que
necesita (Parcel: el peso y el subtotal), no la orden completa ni una
conexión a la base de datos. Cada dato que se le entrega es un dato del que
algún plug-in va a depender, y que ya no se podrá cambiar libremente.
¿Qué le está prohibido? En el ejemplo: importar algo del núcleo que no sea
el contrato, importar a otro plug-in, y hacer entrada y salida (base de datos,
red, archivos). La última no es universal; es una decisión de este contrato,
que dice que quote es una función que calcula. Tiene un costo que veremos
enseguida.
¿Cómo se registra? Estático o por descubrimiento, como en la sección anterior.
Y una quinta pregunta, que es la del último paso del laboratorio: ¿qué
cambio futuro obligaría a modificar el contrato? Para ShippingMethod se
pueden nombrar al menos dos:
- Una forma de entrega que no está disponible para ciertos paquetes (un
motorizado que no lleva más de cinco kilos).
validatesolo recibe el destino; no puede decir “para este paquete, no”. Habría que agregar una operación, o pasarle el paquete avalidate. - Una tarifa que hay que consultarle a un servicio externo.
quotees síncrona y no puede esperar una respuesta de la red. Volverla asíncrona cambia su tipo de retorno a una promesa, y con él cambian el núcleo y todos los plug-ins, aunque apickuple siga bastando con devolver cero. (errors/plugin-reads-db.tses lo que pasa cuando un plug-in necesita eso y el contrato no lo permite: lo hace igual, por un costado.)
¿Vale la pena prever los dos ahora? El primero se puede agregar después sin romper nada: una operación opcional que los plug-ins viejos no implementan y que el núcleo trata como “siempre disponible”. El segundo no: cambiar una operación de síncrona a asíncrona rompe a todos. Si hay un escenario que diga que esa tarifa externa va a llegar, conviene decidirlo antes de que existan diez plug-ins. Si no lo hay, se anota en el ADR como una limitación conocida y se sigue.
Idea clave. En un microkernel, agregar un plug-in es barato y cambiar el contrato es caro. El diseño consiste en poner dentro del contrato lo que no va a cambiar, y dejar fuera, en los plug-ins, lo que sí.
Lo que cuesta un punto de extensión
Lo que el estilo favorece ya lo midieron: modificabilidad en un eje concreto. Agregar una variante no toca el núcleo ni las demás variantes, y puede hacerlo otro equipo sin entender el resto del sistema.
Lo que cuesta:
- Indirección. Para saber qué pasa cuando alguien pide un envío a
domicilio ya no basta leer una función de arriba abajo: hay que ir del
núcleo al registro y del registro al plug-in. La versión de
before/se entiende más rápido. - Un contrato difícil de cambiar, como acabamos de ver.
- Solo ayuda en el eje que se eligió. Un cambio que afecta a todas las
variantes a la vez (“toda etiqueta debe llevar un código de barras”) toca
todos los plug-ins, igual que antes tocaba todos los
if. Y un cambio en otro eje (un nuevo tipo de producto que no se puede enviar) no recibe ninguna ayuda. - Hay que adivinar bien el eje. El punto de extensión se construye antes de que lleguen las variantes. Si se construye para un cambio que nunca llega, queda una interfaz, un registro y un plug-in único: tres archivos donde bastaba una función.
Error común. Convertir todo en plug-in “por si acaso”: los medios de pago, los formatos de reporte, los tipos de evento, los idiomas. Cada punto de extensión es complejidad que alguien tiene que leer y mantener, y solo se recupera si las variantes llegan. La extensibilidad se compra para el cambio que un escenario de modificabilidad dice que va a llegar, con su medida (“agregar un medio de pago modifica a lo más un archivo existente”). Para dos variantes y ninguna tercera a la vista, el
ifes el diseño correcto.
Hay una regla práctica que ayuda a no adelantarse: la primera variante se
escribe directa; la segunda, con un if; cuando llega la tercera, o cuando
un escenario la anuncia, ya hay tres ejemplos reales de los que sacar el
contrato. Un contrato diseñado mirando tres casos sale mucho mejor que uno
diseñado imaginándolos.
Los estilos se combinan
Ninguno de los cuatro estilos de hoy pide el sistema entero. Un estilo se elige por parte del sistema y por atributo de calidad, y lo normal es que un sistema real tenga varios.
Piensen en una Qhatu completa. A la escala más grande es un modular monolith:
catalog, orders, shipping, reports. Dentro de shipping, las formas
de entrega son un microkernel, porque el negocio dice que van a llegar más.
Dentro de catalog, la carga quincenal de la lista del distribuidor es un
pipeline, porque es un proceso por pasos sobre un archivo. Y dentro de cada
módulo hay capas: rutas, lógica, repositorio. Cuatro estilos, cada uno donde
su restricción compra algo que esa parte necesita.
El microkernel y el pipeline casi nunca son la forma de todo un sistema de negocio. Son formas de una parte. Las capas y los módulos por dominio, en cambio, sí compiten por la división de más arriba, y de eso trató la primera mitad del capítulo.
| Estilo | Divide por | Hace barato | Hace caro |
|---|---|---|---|
| Capas | Rol técnico | Cambiar una tecnología; entender el sistema el primer día | Un cambio de negocio (atraviesa las capas) |
| Modular monolith | Dominio, con interfaces y datos propios | Un cambio de negocio (cae en un módulo); mover un límite | Lo que cruza módulos: reportes, cambios técnicos |
| Pipeline | Paso del procesamiento | Probar, reemplazar y agregar pasos | Cambiar el formato de los datos; ida y vuelta |
| Microkernel | Núcleo y variantes | Agregar una variante | Cambiar el contrato; cambios que afectan a todas las variantes |
Big ball of mud
Falta el estilo más común de todos, que no se elige nunca.
Brian Foote y Joseph Yoder le pusieron nombre en un artículo de 1997, Big Ball of Mud. Lo describen como un sistema estructurado de cualquier manera, cuya organización la dicta la urgencia más que el diseño. Y lo toman en serio: si es la arquitectura que más se despliega, dicen, quienes la construyen algo deben de estar haciendo bien, y hay que entender qué fuerzas la producen antes de proponer otra cosa.
En la sección Forces enumeran ocho fuerzas, reconocibles para cualquiera que haya entregado un proyecto. El tiempo: no alcanza para pensar en el largo plazo, y cuando la fecha se acerca, la arquitectura cede. El costo: cuidar la arquitectura es una inversión cuyo beneficio llega tarde. La experiencia: al comienzo, el equipo todavía no conoce bien el dominio. La habilidad, que no es la misma en todo el equipo. La visibilidad: el desorden interno de un programa no se ve desde afuera como se ve el de un edificio. La complejidad: a veces el enredo del software refleja el del problema. La escala: un proyecto grande es un problema distinto de uno chico. Y el cambio: una arquitectura es una hipótesis sobre el futuro, que supone que los cambios van a caer dentro de lo que previó; los que nadie previó la cruzan de lado a lado.
Lo importante es cómo se llega. Nadie decide construir un big ball of mud. Se
llega por muchas decisiones pequeñas, cada una razonable en su momento: un
import a un archivo interno “solo por esta vez”, un JOIN contra la tabla
de otro módulo porque el reporte era para mañana, un if más en el núcleo.
Ninguna rompe nada. Pasan las pruebas. Y cada una hace un poco más probable la
siguiente, porque el límite que se cruzó una vez ya no parece un límite.
Las cuatro violaciones que reporta make deps en Tinkuy son exactamente eso:
cuatro atajos razonables. Lo que separa a un modular monolith de un big ball
of mud no es que nadie haya tenido apuro, sino que había una regla escrita y
una herramienta que dijo “esto no” el día del apuro.
Idea clave. El big ball of mud es lo que queda cuando ningún estilo se hace cumplir. No es el resultado de una mala decisión sino de la ausencia de alguien, o de algo, que cuide los límites en cada cambio.
El código de la semana y make test
Todo lo que citó el capítulo está en code/week-04/:
shop/ (las dos versiones de Qhatu, sus esquemas, sus pruebas, el cambio de
la dedicatoria y el bus de eventos), pipeline/ (la carga de la lista del
distribuidor), microkernel/ (las formas de entrega con if en before/,
con plug-ins en src/, y la tercera en extra/) y errors/ (cuatro archivos
que rompen una regla a propósito).
Los comandos, dentro del contenedor del curso y desde code/week-04/:
| Comando | Qué hace |
|---|---|
make |
Crea las bases de datos de Qhatu: arq_w04 (por dominio) y arq_w04_layers (por capas) |
make test |
Revisa los tipos, corre make deps y todas las pruebas |
make deps |
dependency-cruiser sobre las dos Qhatu y el microkernel, y la comprobación de tablas |
make cambio |
Aplica la dedicatoria a una copia de cada versión y muestra qué archivos toca |
make sql |
Lista los archivos con SQL de cada versión |
make cruces |
Copia cada archivo de errors/ a su lugar y muestra la regla que lo detecta |
make cotizar |
El microkernel: el mismo paquete con cada forma de entrega |
make tercer-plugin |
Agrega locker a la versión con if y a la versión con plug-ins, y cuenta |
make pipeline |
La carga de la lista de precios, y el conteo con comandos de Unix |
make medios |
El paso 1 del laboratorio, sobre el Tinkuy del curso |
make clean |
Borra build/ y las bases de datos de la semana |
make cambio, make cruces y make tercer-plugin trabajan sobre copias en
build/: nunca modifican los archivos de la semana ni el Tinkuy del curso.
make test vuelve a crear las bases de datos cada vez, así que se puede
correr las veces que haga falta. Termina así:
$ make test 2>&1 | tail -n 8
ℹ tests 60
ℹ suites 2
ℹ pass 60
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 1067.044126
Laboratorio: un medio de pago como plug-in
El laboratorio aplica el microkernel a Tinkuy. Se trabaja en parejas, sobre la copia de Tinkuy que dejaron la semana pasada (la que ya tiene el ciclo roto), y lo que hagan es la segunda mitad de P1. Los pasos están en la guía de la semana; aquí va qué muestra cada uno y en qué fijarse. El capítulo no lo resuelve: el ejemplo de las formas de entrega está para que vean la técnica completa en chico, no para copiarlo. Los medios de pago tienen sus propias decisiones, y son suyas.
Paso 1: encontrar los if. La búsqueda es la que vimos en El problema:
un if por variante. Lo que hay que producir es una tabla: archivo, función,
y qué decide ese if. La tercera columna es la que importa: de ella sale
el contrato en el paso 4. Fíjense también en lo que la búsqueda no encuentra.
¿Hay algún lugar que dependa del medio de pago sin nombrar 'card' ni
'yape'? Revisen la pasarela de prueba (tools/fake-gateway.ts), que no está
en src/.
Paso 2: el escenario. Antes de cambiar nada, escriban el escenario de modificabilidad con sus seis partes y una medida que se pueda contar: cuántos archivos existentes se modifican para agregar un medio de pago. Midan primero el Tinkuy de hoy con esa medida (lo acaban de hacer en el paso 1). El número al que quieren llegar se decide ahora, no después de ver cuánto salió: es el error común de la semana 2.
Paso 3: estudiar el microkernel pequeño. Corran make test, make cotizar y make tercer-plugin en code/week-04/. Identifiquen en
microkernel/src/ el contrato, el registro, y hacia dónde apunta cada
import. Una buena prueba de que lo entendieron: sin mirar el capítulo,
expliquen por qué las pruebas de locker pasan sin que nadie las haya
escrito.
Paso 4: diseñar el contrato. Con la tabla del paso 1, escriban la
interfaz PaymentMethod en TypeScript antes de tocar nada más: una operación
por cada decisión. Usen las preguntas de Cómo se diseña un contrato: qué
datos recibe cada operación, qué devuelve, qué le está prohibido al plug-in.
No esperen que les salga igual a ShippingMethod: los datos de un pago no son
campos de texto libres, y lo que se le manda a la pasarela tiene una forma
precisa. Discutan el contrato con otra pareja antes de implementarlo; cambiar
una interfaz en la pizarra cuesta menos que cambiarla con dos plug-ins
escritos.
Paso 5: mover card y yape. Cada medio pasa a un plug-in, y cada if
del núcleo se reemplaza por una llamada al plug-in registrado. La condición
del paso es la red de seguridad: make test debe seguir pasando sin
cambiar ninguna prueba. Las pruebas de Tinkuy hablan con la API, así que no
saben cómo está organizado el código por dentro; si alguna falla, cambiaron
el comportamiento, no solo la estructura. Vayan de a un if por vez y corran
las pruebas entre uno y otro.
Paso 6: agregar plin. Aquí se cobra el trabajo: el tercer medio debería
ser un archivo nuevo y una línea en el registro. Cuenten los archivos
existentes que modificaron y compárenlo con la medida del paso 2. Si
tuvieron que tocar algo más, no lo escondan: anoten qué fue y por qué, porque
eso dice qué le falta a su contrato o qué if no encontraron en el paso 1.
Un dato que van a necesitar: la pasarela de prueba ya acepta plin
(plin: { phone }, rechazado si el celular termina en 000), aunque Tinkuy
todavía no lo ofrezca. A un cobro con un medio que no conoce le responde con
un error 400, que Tinkuy convierte en un 502.
Paso 7: las reglas. Dos reglas de dependency-cruiser: el núcleo no importa
un plug-in concreto (solo el registro puede), y un plug-in no importa pg.
Las del ejemplo están en microkernel/.dependency-cruiser.cjs, pero las rutas
de Tinkuy son otras y su núcleo no es una sola carpeta: piensen bien el
from y el to. Como la semana pasada, una regla no está terminada hasta
que la vieron fallar: hagan el import prohibido a propósito, vean el error y
quítenlo.
Paso 8: discusión. ¿Qué cambio futuro obligaría a modificar el contrato y, con él, todos los plug-ins? Piensen en medios de pago de verdad: uno que cobra en cuotas, uno que no responde en el momento sino minutos después, uno que permite devolver el dinero. Para cada uno: ¿cabe en su contrato?, ¿se podría agregar sin romper los plug-ins que ya existen? Y la pregunta de fondo: ¿vale la pena preverlo ahora, o es el “por si acaso” del que habla el capítulo?
Resumen
- Un estilo de arquitectura es un vocabulario de elementos y conectores más un conjunto de restricciones. Sus propiedades salen de las restricciones, así que un estilo que no se hace cumplir no da nada.
- Monolítico o distribuido es una pregunta sobre el despliegue, no sobre el orden. Un monolito da llamadas locales, transacciones simples y un solo despliegue; cobra despliegue acoplado, recursos compartidos y escalado en bloque. Monolito no es sinónimo de big ball of mud.
- La arquitectura en capas divide por rol técnico (presentación, dominio, datos) y cada capa usa solo la de abajo. Es simple y aísla tecnologías. Un cambio de negocio atraviesa todas las capas, y las capas cerradas producen sumideros: funciones que solo pasan la llamada.
- Por rol técnico o por dominio: el mismo cambio de negocio tocó cuatro archivos en ambas versiones de Qhatu, pero cuatro carpetas en una y una en la otra. El cambio técnico cae al revés. Decide qué tipo de cambio llega más seguido; en los sistemas de negocio, casi siempre el de negocio.
- Un modular monolith es un monolito con módulos por dominio que cumplen tres condiciones comprobables: interfaz pública, datos propios y dependencias sin ciclos. Da buena parte de la modificabilidad de los microservicios sin el costo de la red.
- Los datos son el límite más difícil. Un
JOINentre tablas de dos módulos se resuelve pidiendo el dato por la interfaz, duplicando un dato estable o con una vista declarada; cada opción tiene su costo. - Monolith first: los límites de un dominio se descubren con el uso, y moverlos entre módulos cuesta mucho menos que entre servicios.
- El pipeline conecta filtros que solo conocen su entrada y su salida. Se prueban y se reemplazan por separado; se reordenan si no tienen memoria. El acoplamiento es el formato de los datos, y no sirve para flujos de ida y vuelta.
- El microkernel separa un núcleo estable de plug-ins que implementan un contrato y se inscriben en un registro. Agregar una variante no toca el núcleo; cambiar el contrato toca todo. Un punto de extensión se compra para un cambio que un escenario anuncia.
- Los estilos se combinan: se eligen por parte del sistema y por atributo de calidad.
- El big ball of mud no se elige: es lo que queda cuando nadie cuida los límites, cambio a cambio.
Ejercicios
-
En Qhatu por capas, sigan
GET /reports/salesdesde el handler hasta la consulta. ¿Cuántas funciones atraviesa y qué agrega cada una? ¿Es un sumidero? Hagan lo mismo conGET /orders/:idy comparen. -
Clasifiquen cada cambio según caiga en una carpeta o en varias, en Qhatu por capas y en Qhatu por dominio, y digan qué archivos tocaría: (a) el listado de productos acepta un parámetro
maxPrice; (b) todas las respuestas de error incluyen un camporequestId; (c) el reporte de ventas agrega el título más vendido de cada categoría; (d) las consultas a la base de datos tienen un tiempo máximo de dos segundos. -
Escriban dos comprobaciones, distintas de las del capítulo, que permitan decidir si un monolito con carpetas
users/,billing/yshipping/es un modular monolith. Para cada una, digan con qué herramienta o comando la harían y qué resultado esperarían. -
El equipo de reportes de Qhatu necesita un reporte nuevo: los diez compradores que más gastaron, con el título del libro más caro que compró cada uno. Resuélvanlo en papel con cada una de las tres opciones de El
JOINque cruza dos módulos. Para cada una: qué cambia en la interfaz deorderso decatalog, cuántas consultas se hacen y qué puede salir mal. -
En
shop/by-domain/,ordersle pasa su transacción acatalog(takeStock(tx, …)). Reescriban en papelplaceOrdersuponiendo que eso está prohibido y cada módulo abre su propia transacción. Enumeren los estados intermedios en que puede quedar el sistema si el proceso se cae a la mitad, y digan cuál de ellos vería un comprador. -
Agreguen al pipeline un filtro
withDiscount(percent)que rebaje el precio de los libros de una categoría, con su prueba. Después respondan sin ejecutar y comprueben ejecutando: ¿da lo mismo ponerlo antes o después dedropDuplicates? ¿Y antes o después deonlyInStock? ¿De qué depende? -
El distribuidor avisa que desde el próximo mes cada fila traerá el precio en soles o en dólares, con una columna
moneda. Listen los archivos depipeline/src/que cambian y los que no, y expliquen por quéparseRowsestá en el grupo que le toca. ¿Qué habría que haber hecho distinto enformats.tspara que cambiaran menos archivos, y qué habría costado? -
Llega el pedido de una cuarta forma de entrega: un motorizado que entrega el mismo día, pero solo paquetes de hasta 5 kg. Con el contrato
ShippingMethodactual no se puede expresar “no disponible para este paquete”. Propongan dos cambios al contrato, uno que rompa los plug-ins existentes y uno que no, e implementen el segundo en una copia. ¿Qué pruebas del contrato agregarían? -
Su equipo mantiene Tinkuy y alguien propone convertir en plug-ins los tipos de evento (
concert,match), “porque después vendrán teatro y festivales”. Escriban el escenario de modificabilidad que justificaría hacerlo y el que justificaría no hacerlo. ¿Qué dato del negocio necesitarían para decidir entre los dos? ¿Qué buscarían en el código para estimar el costo de hoy? -
Un sistema de matrícula universitaria tiene tres equipos (alumnos, cursos, pagos), cambios de reglas de negocio cada semestre y un proceso nocturno que carga las notas desde archivos de las facultades. Propongan qué estilo usar a la escala del sistema y dentro de cada parte, con el atributo de calidad que justifica cada elección y lo que se sacrifica. Indiquen una parte donde no pondrían un punto de extensión y por qué.