Apuntes · Capítulo 5Estilos, tácticas y decisiones
Estilos distribuidos: servicios, microservicios y eventos
Estilos distribuidos: servicios, microservicios y eventos
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Lo que cambia al cruzar la red, Una llamada local y una remota, medidas y Fallas parciales: lo que ve quien llama; de Microservicios, La forma y Cada servicio es owner de sus datos; de Eventos y comandos, todo; y de El caso de la semana: después de una compra, La versión síncrona, La versión con eventos y Quién conoce a quién.
- En clase: Sesión A: Por qué distribuir un sistema, Lo que cambia al cruzar la red, Service-based: pocos servicios grandes, Microservicios, Cómo se comunican los servicios y Dos errores al distribuir. Sesión B: Eventos y comandos, El estilo event-driven, El caso de la semana: después de una compra, Dos topologías: broker y mediator, Los cuatro usos de «event-driven» y Cómo se elige un estilo. Laboratorio: Laboratorio: el mismo caso en dos estilos.
- Después de clase: el Resumen y los Ejercicios. Vale la pena releer Lo que la versión con eventos no resuelve antes de las semanas 12 y 13. Opcionales: NATS JetStream en una página, La disponibilidad de una cadena síncrona y El código de la semana.
La semana pasada estudiamos los estilos monolíticos: capas, modular monolith, pipeline y microkernel. Todos comparten una propiedad que no hizo falta mencionar porque nunca falló: cuando un módulo llama a otro, la llamada llega, tarda casi nada y termina con un resultado o con un error. Con P1, que se entrega esta semana, Tinkuy quedó además con módulos que se hablan por una interfaz pública y con reglas de dependencia que una herramienta comprueba.
Esta semana rompemos esa propiedad a propósito. Un estilo distribuido reparte el sistema en varias unidades de despliegue que se comunican por la red, y la red no es una llamada a función más lenta: es un lugar donde los mensajes se pierden, se demoran y se repiten, y donde quien llama muchas veces no puede saber cuál de esas cosas pasó. Distribuir un sistema es aceptar esos problemas a cambio de algo. La pregunta de toda la semana es a cambio de qué, y si lo que se recibe vale lo que se paga.
El capítulo sigue las dos sesiones. En la primera vemos por qué se distribuye un sistema, qué cambia al cruzar la red (con las ocho falacias de la computación distribuida) y los dos estilos distribuidos más usados: el service-based y los microservicios. En la segunda vemos el estilo event-driven, con sus dos topologías, broker y mediator, y cerramos la parte de estilos con un procedimiento para elegir uno. En medio hay un caso que van a correr en el laboratorio: lo que pasa después de una compra, implementado dos veces, con llamadas y con eventos, y medido en las dos.
Una advertencia sobre las palabras. En Tinkuy, un evento es un concierto o un partido. En este capítulo, un evento es un mensaje que dice que algo ya pasó. Para no mezclarlos, el ejemplo de la semana vende entradas para conciertos, y la palabra evento queda para los mensajes.
Lectura. Sesión A: Richards y Ford, Fundamentals of Software Architecture (2.ª ed.), cap. 14 Service-Based Architecture Style y cap. 18 Microservices Architecture; James Lewis y Martin Fowler, Microservices (2014). Complementarias: Software Architecture in Practice, cap. 17 The Cloud and Distributed Computing; Chris Richardson, microservices.io, los patrones Database per Service y API Gateway; Kleppmann y Riccomini, Designing Data-Intensive Applications (2.ª ed.), cap. 1, la sección Distributed Versus Single-Node Systems.
Sesión B: Fundamentals of Software Architecture (2.ª ed.), cap. 15 Event-Driven Architecture Style y cap. 19 Choosing the Appropriate Architecture Style; Martin Fowler, What do you mean by “Event-Driven”? (2017). Complementarias: Fundamentals of Software Architecture (2.ª ed.), cap. 16 Space-Based Architecture Style y cap. 17 Orchestration-Driven Service-Oriented Architecture, para ver dos estilos que el curso no desarrolla; Fallacies of distributed computing, con el origen de cada falacia. Para el laboratorio, la documentación de NATS.
El código de este capítulo está en code/week-05/. Todas las salidas que se muestran son de ejecuciones reales en el contenedor del curso, en una laptop con Apple Silicon, dentro de Docker. Los números cambian de una máquina a otra; lo que se traslada es la comparación entre dos diseños medidos en la misma.
Por qué distribuir un sistema
Un monolito bien hecho resuelve muchos problemas. Antes de partirlo conviene decir con precisión qué problema ya no resuelve.
Cada razón es un escenario
Las razones para distribuir un sistema son pocas, y todas se pueden escribir como un escenario de calidad de los de la semana 2:
| Razón | El escenario que hay detrás |
|---|---|
| Escalar una parte sin escalar todo | Durante una apertura de ventas, las compras se multiplican por cincuenta y los reportes no. Se quiere dar más máquinas solo a lo que las necesita. |
| Desplegar una parte sin desplegar todo | Un cambio en el reporte de ventas llega a producción en menos de un día sin volver a desplegar la compra ni interrumpirla. |
| Aislar una falla | Si el envío de correos se cae o se queda sin memoria, la compra sigue funcionando. |
| Que varios equipos trabajen sin pisarse | Dos equipos cambian y despliegan sus partes la misma semana sin coordinarse. |
| La carga ya no cabe en una máquina | Ni la máquina más grande que se puede pagar atiende el pico. |
La tabla sirve en las dos direcciones. Si un equipo quiere distribuir y puede señalar el escenario, la discusión es concreta: se mide el sistema actual, se ve por cuánto incumple y se compara lo que cuesta cada forma de cumplirlo. Si no puede señalar ninguno, lo que tiene no es una razón: es una preferencia.
Idea clave. Distribuir no es un objetivo. Es el precio que se paga por un escenario de calidad que el monolito no cumple. Sin escenario, no hay razón.
Conviene notar que varias de esas razones admiten respuestas que no distribuyen nada. Un monolito se puede escalar corriendo varias copias iguales detrás de un load balancer: eso atiende más carga, aunque escala todo junto. El modular monolith de la semana 4 ya permite que dos equipos trabajen sin pisarse en el código, aunque sigan desplegando juntos. La pregunta honesta no es “¿monolito o microservicios?” sino “¿qué escenario no cumplo, y cuál es la forma más barata de cumplirlo?”.
Lo que se deja atrás
Para saber lo que cuesta distribuir hay que recordar lo que un monolito da sin que nadie lo pida:
- Llamadas locales. Rápidas, y que no fallan a medias: una función devuelve un valor o lanza un error.
- Una transacción. Con una sola base de datos, varias escrituras ocurren
todas o ninguna. Si la compra falla en el último paso, un
ROLLBACKdeja todo como estaba. - Un
JOIN. Cualquier dato se puede combinar con cualquier otro en una consulta. - Un despliegue y un proceso que mirar. Cuando algo anda mal, hay un solo log que leer y un solo lugar donde poner un punto de interrupción.
Cada estilo de este capítulo renuncia a una parte de esa lista. El resto del capítulo es, en el fondo, un inventario de a qué renuncia cada uno.
Lo que cambia al cruzar la red
Una llamada local y una remota, medidas
Empecemos por lo más fácil de medir. El programa
network/local-vs-remote.ts
llama a la misma función de dos maneras: dentro del proceso, y por HTTP a un
servidor que corre en la misma máquina. La función calcula el precio de una
entrada con la comisión de la tarjeta:
function priceWithFee(cents: number): number {
  return Math.round(cents * 1.035) + 30;
}
$ make remote
llamada local: 7 ns por llamada (promedio de 1000000 llamadas)
llamada remota: 65 µs por llamada (mediana de 2000; p99 635 µs)
la remota tarda unas 9538 veces más, sin salir de la máquinaTres cosas se ven en esa salida.
La primera es la escala. La llamada local se mide en nanosegundos; la remota, en decenas de microsegundos, cuatro órdenes de magnitud más. Y esta es la red más favorable que existe: las dos puntas están en la misma máquina, no hay cable, no hay otro centro de datos, no hay cifrado. Entre dos servicios reales, una llamada se mide en milisegundos.
La segunda es que la llamada remota ya no tiene un tiempo: tiene una distribución. El p99 es casi diez veces la mediana. La llamada local hace siempre lo mismo; la remota depende de lo que estén haciendo en ese momento el sistema operativo, el otro proceso y todo lo que haya en el camino. Es la razón por la que desde la semana 2 medimos con percentiles.
La tercera no sale en la salida, y es la más importante: en esta corrida las 2000 llamadas remotas respondieron. En una red de verdad, algunas no lo hacen.
Error común. Diseñar la interfaz de un servicio como si fuera la de un módulo. Dentro de un proceso no cuesta nada pedir un dato en cien llamadas pequeñas. Por la red, cien llamadas son cien esperas y cien oportunidades de fallar. Lewis y Fowler lo dicen en su artículo: las llamadas remotas son más caras que las llamadas dentro del proceso, y por eso una API remota necesita operaciones más gruesas, que hagan más en cada llamada. Una buena interfaz entre módulos casi nunca es una buena interfaz entre servicios.
Fallas parciales: lo que ve quien llama
Una llamada local tiene dos finales: devuelve un resultado o lanza un error. Una llamada remota tiene más, y el problema es que varios de ellos son indistinguibles para quien llama.
Supongan que Tinkuy le pide a la pasarela que cobre S/ 320 y no recibe respuesta. Pudo pasar cualquiera de estas cosas:
- El pedido no llegó: la red lo perdió, o la pasarela estaba caída.
- El pedido llegó y la pasarela murió antes de cobrar.
- La pasarela cobró y murió antes de responder.
- La pasarela cobró y respondió, y la respuesta se perdió en el camino.
- La pasarela está viva y trabajando, solo que más lento de lo que Tinkuy está dispuesto a esperar. Va a cobrar dentro de un momento.
En los casos 1 y 2 no hubo cobro. En los casos 3, 4 y 5 sí lo hubo, o lo va a haber. Desde Tinkuy, los cinco se ven igual: silencio.
El programa
network/lost-reply.ts lo demuestra
con un servicio de cobros de juguete al que se le puede pedir que falle de
tres maneras. El cliente hace un cobro con un timeout de 300 ms y reporta lo
que vio; después el programa mira cuántos cobros registró el servidor.
$ make lost-reply
none          el cliente ve: respuesta 200                                 cobros en el servidor: 1
lost-request  el cliente ve: sin respuesta (TypeError, UND_ERR_SOCKET)     cobros en el servidor: 0
lost-reply    el cliente ve: sin respuesta (TypeError, UND_ERR_SOCKET)     cobros en el servidor: 1
slow          el cliente ve: sin respuesta (TimeoutError)                  cobros en el servidor: 1
Miren la segunda y la tercera fila. El cliente recibe exactamente el mismo error, y el servidor quedó en dos estados distintos: en uno no se cobró y en el otro sí. No hay nada que el cliente pueda inspeccionar en ese error para saber en cuál está. La cuarta fila agrega otra lección: un timeout no cancela nada. El cliente dejó de esperar a los 300 ms; el servidor ya había cobrado y siguió con lo suyo hasta responder, a nadie.
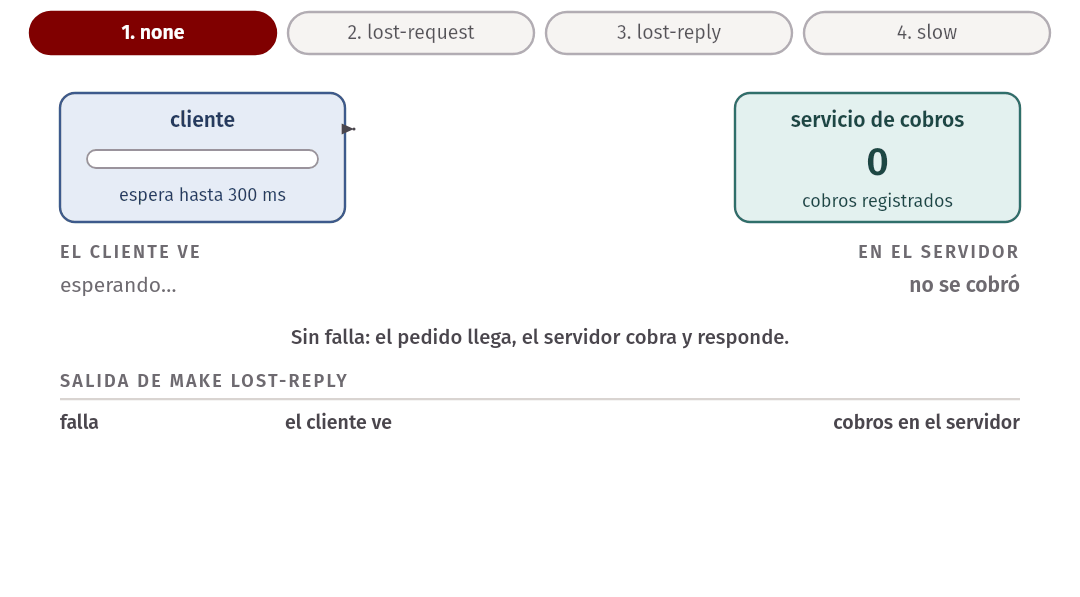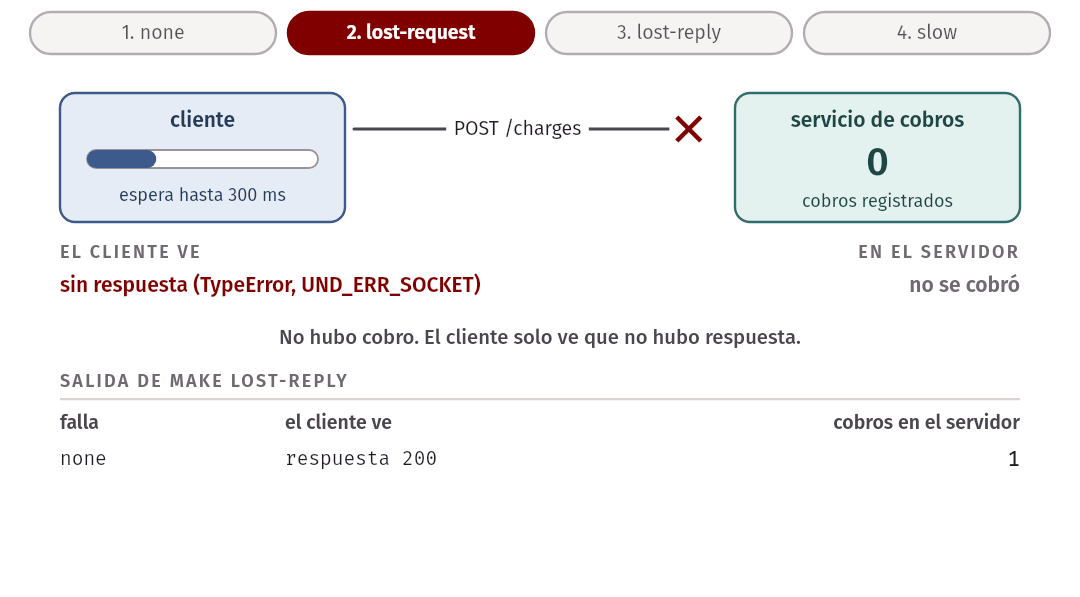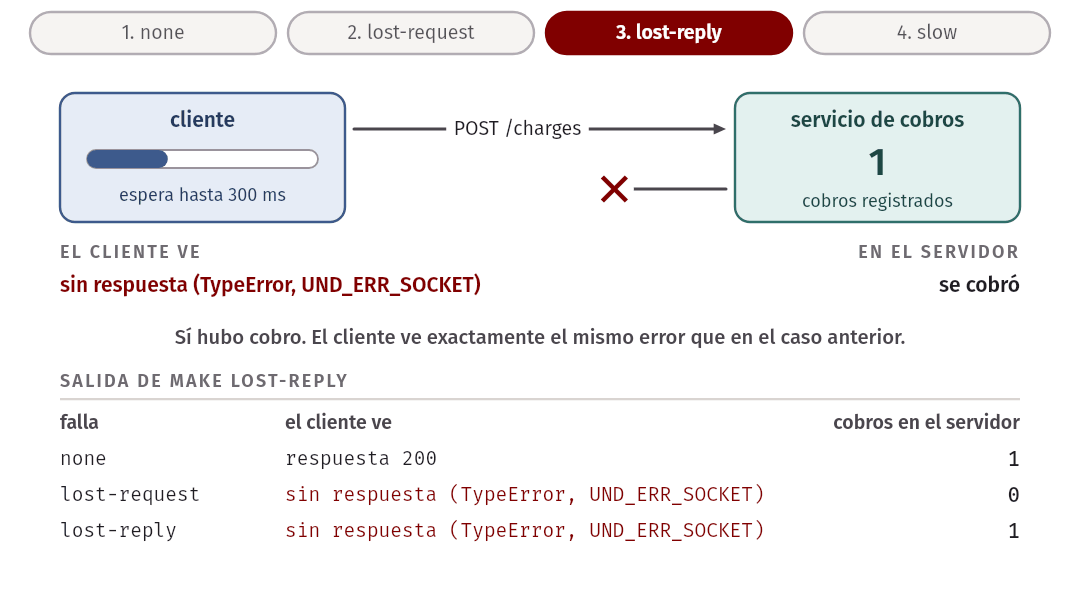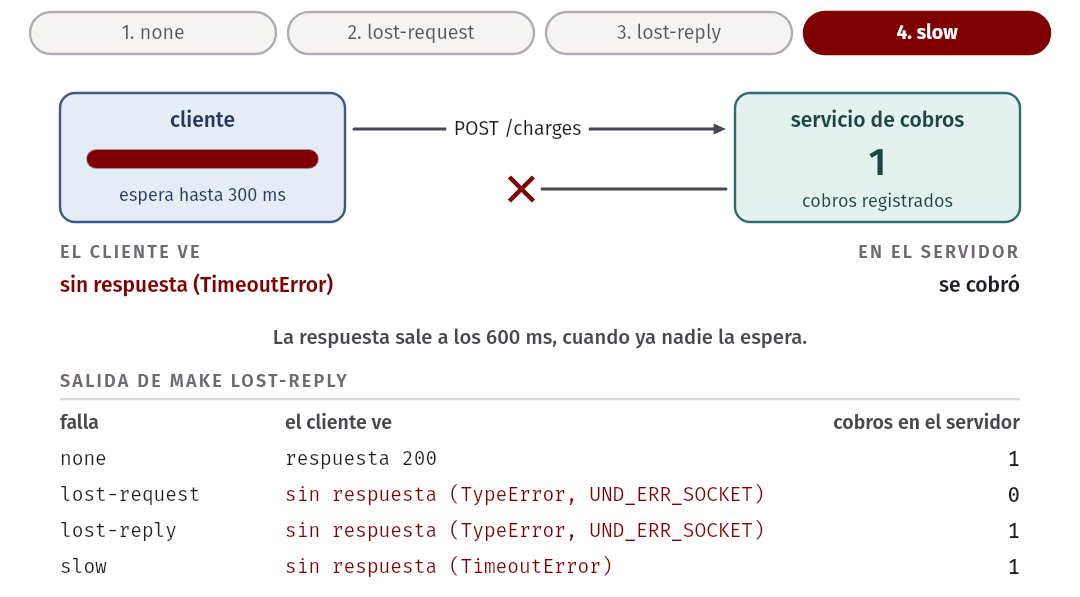
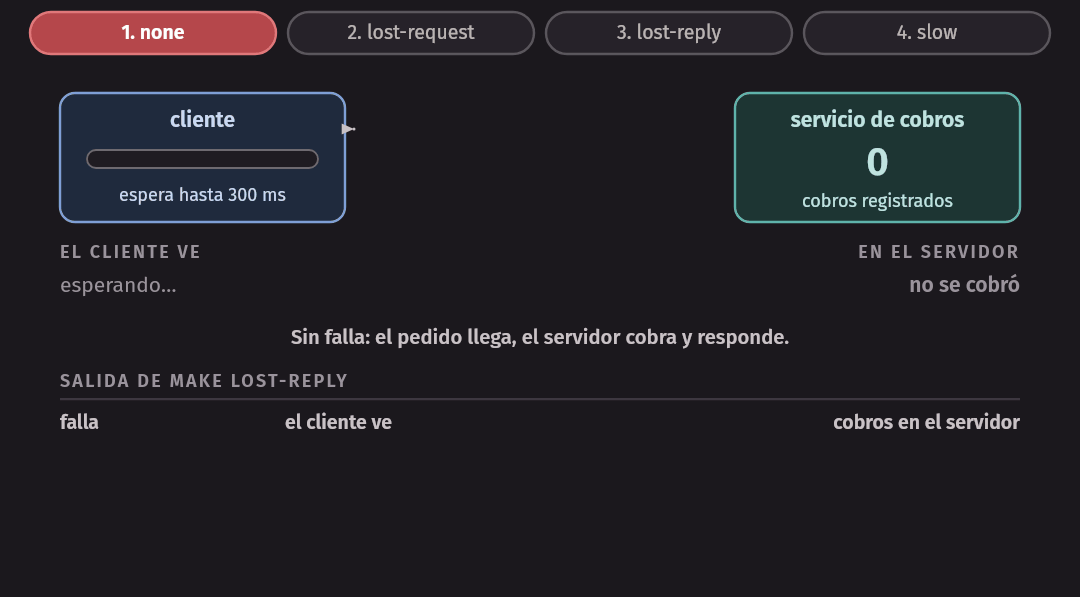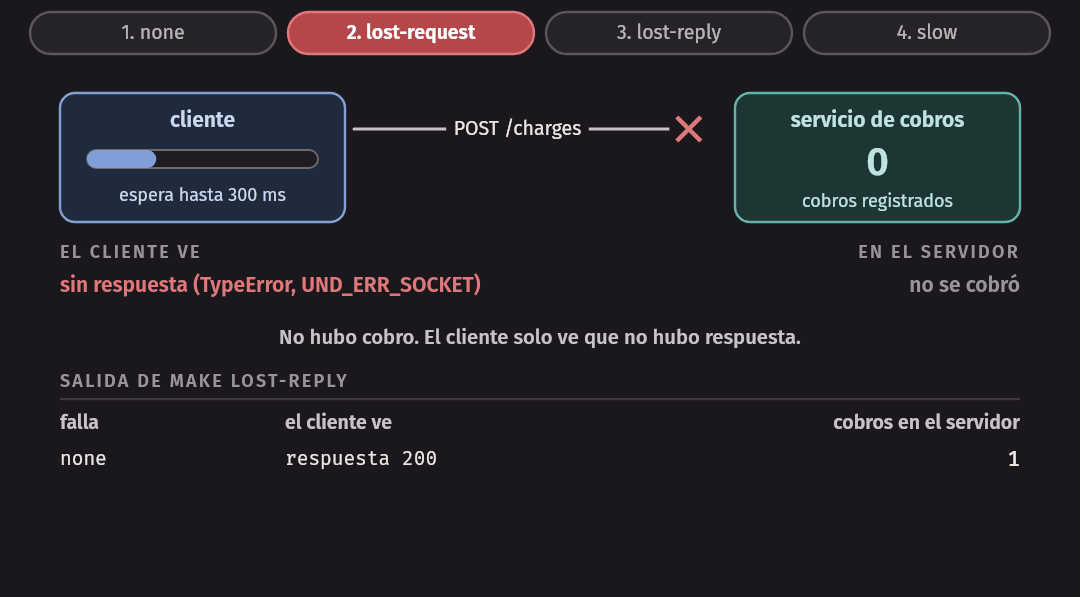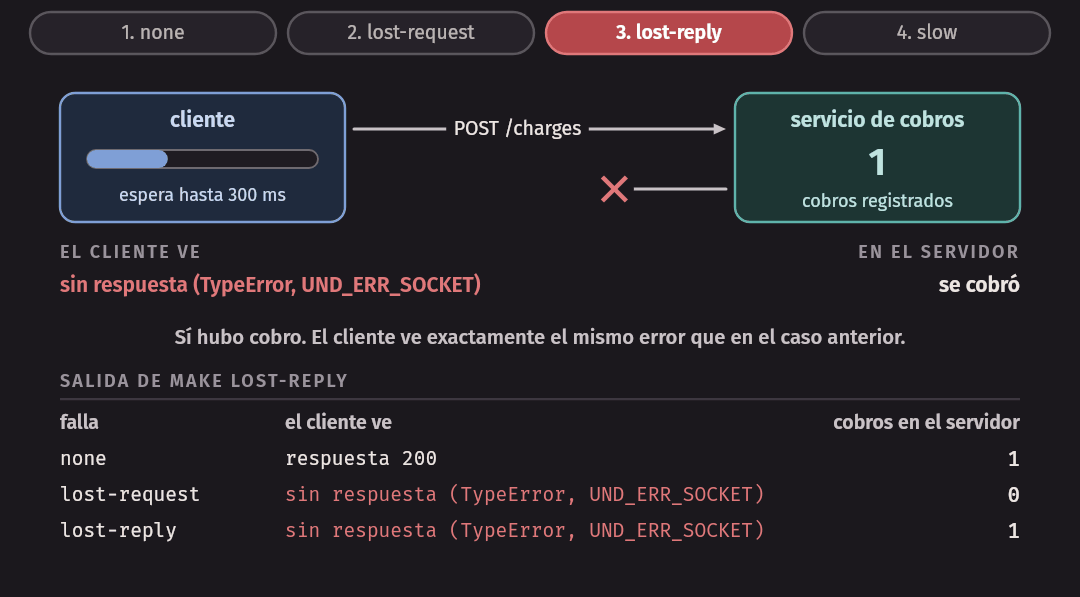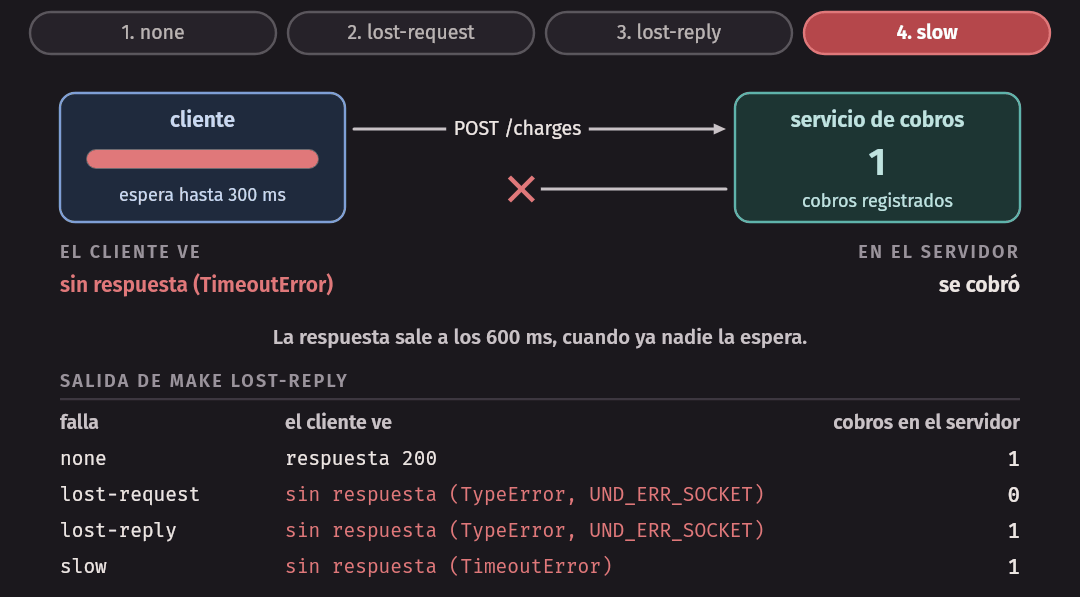
Idea clave. Ante una llamada remota sin respuesta, quien llama no puede distinguir “no llegó” de “llegó y la respuesta se perdió”. Solo sabe que no sabe. A eso se le llama falla parcial: una parte del sistema falló y la otra no tiene cómo enterarse de cuál.
De ahí sale un dilema que va a aparecer en todo lo que queda del curso. Si Tinkuy no reintenta, puede quedarse con una compra sin cobrar. Si reintenta, puede cobrar dos veces. Ninguna de las dos opciones es segura por sí sola. La salida es que la operación se pueda repetir sin daño, es decir, que sea idempotente, y eso se diseña: es el tema de la semana 12. Los timeouts, los retries y el circuit breaker, que deciden cuánto esperar y cuándo dejar de insistir, son el tema de la semana 14.
Concurrencia real
Hay un tercer cambio, menos visible. En un proceso de Node.js, entre un
await y el siguiente nadie más toca las variables del programa. En un sistema
distribuido hay varios procesos trabajando al mismo tiempo de verdad, en
máquinas distintas, cada uno con su propio reloj y sin memoria compartida. Dos
servicios pueden leer el mismo dato, decidir sobre él y escribir, cada uno sin
saber del otro. Y no hay un “ahora” común: decir que algo pasó antes que otra
cosa exige ponerse de acuerdo sobre el orden, y eso también cuesta mensajes.
Lo retomaremos con la replicación (semana 10) y con el consenso (semana 13).
Las ocho falacias de la computación distribuida
En los años noventa, Peter Deutsch y otros ingenieros de Sun Microsystems juntaron los supuestos falsos que hace quien empieza a construir sistemas distribuidos. Según la historia que recoge el artículo de Wikipedia citado en las lecturas, Deutsch armó en 1994 una lista de siete, que incluía cuatro que Bill Joy y Dave Lyon ya habían identificado, y James Gosling agregó la octava alrededor de 1997. Se las conoce como las falacias de la computación distribuida.
Lo útil de la lista es leerla al revés. Cada falacia es algo que dentro de un monolito es verdad, y por eso nadie lo piensa. Al distribuir deja de serlo, y el diseño tiene que pagarlo.
| Falacia | En un monolito es gratis porque… | Lo que el diseño distribuido tiene que pagar |
|---|---|---|
| 1. La red es confiable | Una llamada a función llega siempre | Timeouts, reintentos e idempotencia en cada llamada |
| 2. La latencia es cero | Una llamada tarda nanosegundos | Menos llamadas y más gruesas; llamadas en paralelo; un presupuesto de latencia por petición |
| 3. El ancho de banda es infinito | Pasar un objeto es pasar una referencia | Cada dato se serializa y viaja: paginar, comprimir, no enviar lo que no se usa |
| 4. La red es segura | Nadie se mete entre dos funciones | Autenticar y cifrar entre servicios; decidir quién puede llamar a quién |
| 5. La topología no cambia | Las funciones no cambian de dirección | Las máquinas aparecen y desaparecen: descubrimiento de servicios, nada de direcciones fijas en el código |
| 6. Hay un solo administrador | Hay un solo proceso y un solo equipo | Cada servicio lo opera alguien distinto, con sus horarios, versiones y políticas |
| 7. El costo de transporte es cero | Llamar no cuesta | Serializar gasta CPU, y el tráfico entre servicios y entre zonas se factura |
| 8. La red es homogénea | Todo corre en el mismo lenguaje y la misma versión | Protocolos y formatos acordados; versiones distintas conviviendo durante un despliegue |
Para que la lista no quede en abstracto, tres errores de diseño concretos, uno por cada una de las primeras tres falacias, tomados del sistema del curso:
- La red es confiable. El cliente de la pasarela de Tinkuy hace un
fetchsin fijar un timeout. Mientras la pasarela responda, no se nota. El día que la pasarela reciba el pedido y se quede callada, la compra se queda esperando todo lo que la plataforma esté dispuesta a esperar, con su transacción abierta y su conexión a la base de datos ocupada. - La latencia es cero.
GET /eventshace una consulta para la lista y una más por cada evento. Con la base de datos en el mismo contenedor cuesta poco; con la base de datos en otra máquina, cada una de esas consultas es un viaje de ida y vuelta. - El ancho de banda es infinito.
GET /events/1/seatsdevuelve los 2000 asientos del estadio en cada llamada. Dentro del proceso es un arreglo; por la red son 2000 objetos serializados cada vez que alguien abre el mapa.
Ninguno de los tres es un bug en el sentido habitual: las pruebas pasan. Son supuestos que dejaron de cumplirse.
Error común. Tratar las falacias como una lista de cosas que “la plataforma ya resuelve”. Una biblioteca puede reintentar por ustedes, pero no puede saber si la operación que reintenta se puede repetir sin cobrar dos veces. Eso lo sabe solo quien diseñó la operación.
Service-based: pocos servicios grandes
La forma
El estilo service-based es el paso más corto desde un modular monolith. Se toman los módulos de dominio y se convierten en servicios: unidades que se despliegan por separado, cada una en su propio proceso. Son pocos y grandes, del orden de cuatro a doce, cada uno un dominio completo del negocio (el catálogo, las órdenes, los pagos, los reportes), con sus propias capas adentro. Delante de ellos suele haber una interfaz común (la aplicación web o un API gateway) que recibe los pedidos y los reparte. Y, en la forma más frecuente del estilo, todos siguen usando la misma base de datos, a veces partida en un esquema por servicio.
Lo que distingue a este estilo del siguiente es esa combinación: servicios gruesos y datos todavía juntos.
Qué se gana y qué se paga
Se ganan, con poco esfuerzo, las dos primeras razones de la tabla del inicio:
- Despliegue por partes. Un cambio en los reportes se despliega sin tocar la compra.
- Escalado por partes. Se pueden correr cuatro copias del servicio de órdenes y una del de reportes.
- Aislamiento parcial de fallas. Si el servicio de reportes se queda sin memoria, se cae él solo.
Y se conserva lo más valioso del monolito: como la base de datos es una, una
operación que cae entera dentro de un servicio sigue protegida por una
transacción, y los datos se siguen pudiendo combinar con un JOIN. Como los
servicios son gruesos, casi todas las operaciones del negocio caen enteras
dentro de uno, y las llamadas entre servicios son pocas.
Se paga con todo lo de la sección anterior, en pequeño: ahora hay llamadas remotas (pocas), varios despliegues que operar (pocos) y una petición que puede pasar por dos procesos.
Trade-off. Service-based compra despliegue y escalado por partes sin renunciar todavía a las transacciones de una sola base de datos. Lo que no compra es independencia de datos: la base de datos sigue siendo un punto único de falla, un límite de escalado y un contrato compartido por todos. Para un equipo pequeño cuyo problema es desplegar y escalar por partes, es con frecuencia el estilo que más da por lo que cuesta. Para una organización que necesita que veinte equipos no dependan del esquema de nadie, no alcanza.
La base de datos compartida
La base de datos compartida es a la vez la ventaja y el riesgo de este estilo. El riesgo se ve con un cambio. Si el servicio de reportes lee con SQL propio las tablas de órdenes, el día que órdenes quiera cambiar una columna tiene que coordinar con reportes y desplegar los dos a la vez. Los servicios se despliegan por separado en el papel y juntos en la práctica.
La defensa es la misma de la semana 4, ahora con más en juego: cada tabla
tiene un servicio que es su owner, los demás no la leen directamente, y el
reparto se hace visible con un esquema por servicio. Lo que en el modular
monolith era una regla de depcruise aquí se puede reforzar con permisos de la
base de datos: el usuario con el que se conecta reportes no tiene acceso al
esquema de órdenes.
Microservicios
La forma
Lewis y Fowler describen el estilo así en el artículo de 2014 que le dio difusión al nombre: una forma de construir una aplicación como un conjunto de servicios pequeños, cada uno corriendo en su propio proceso y comunicándose con mecanismos livianos, con frecuencia una API HTTP; construidos alrededor de capacidades del negocio, y que se despliegan de manera independiente con automatización. Ellos mismos aclaran que no hay una definición formal, y lo que ofrecen es una lista de características que suelen aparecer juntas. Las que más pesan en una decisión de arquitectura son estas:
- Los componentes son servicios. La unidad que se reemplaza y se actualiza no es una biblioteca que se enlaza, sino un proceso que se despliega solo.
- Organización alrededor de capacidades del negocio. Un servicio no es “la capa de datos”; es “pagos”, con su interfaz, su lógica y sus datos, y con un equipo que responde por él.
- Endpoints inteligentes y conductos tontos (smart endpoints and dumb pipes). La lógica vive en los servicios. Lo que los conecta, HTTP o un sistema de mensajes sencillo, solo transporta.
- Gestión descentralizada de los datos. Cada servicio administra su propia base de datos.
- Diseño para la falla. Como cualquier llamada puede fallar, cada servicio se diseña suponiendo que sus vecinos van a fallar.
- Despliegue automatizado. Sin automatización, operar muchos servicios no es viable.
Frente a service-based, cambian dos cosas: los servicios son más pequeños, cada uno con un solo propósito, y cada uno tiene sus propios datos.
Cada servicio es owner de sus datos
Esta es la regla que define el estilo y la que más cuesta: nadie más lee la base de datos de un servicio. Si reportes necesita saber qué se vendió, se lo pide a órdenes por su API, o se entera por los eventos que órdenes publica. No abre una conexión a las tablas de órdenes.
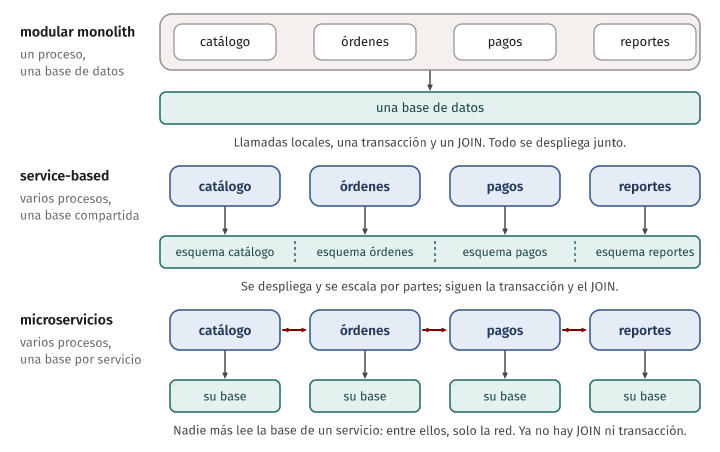
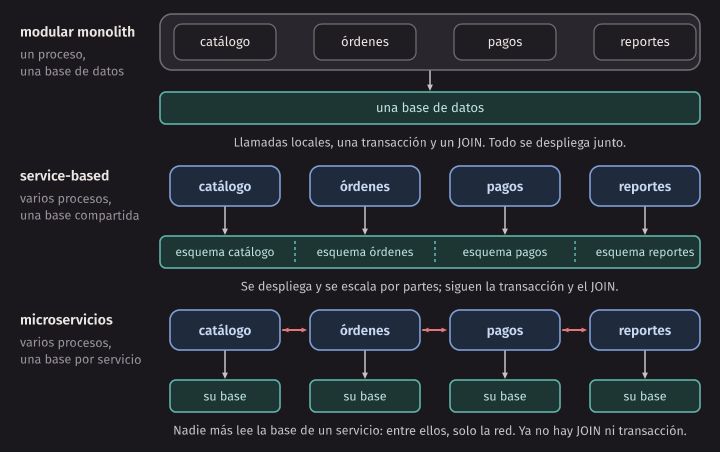
El motivo es el ocultamiento de información de la semana 3, llevado hasta el final. Mientras otro servicio lea mis tablas, mi esquema es parte de mi interfaz pública y no lo puedo cambiar sin avisar. Cuando nadie más las lee, puedo cambiar el esquema, el motor de base de datos o la forma de guardar, y desplegar el cambio hoy, sin coordinar con nadie. La independencia de despliegue, que es la promesa del estilo, solo existe si los datos también son independientes.
El costo es inmediato y es grande:
- Ya no hay
JOIN. “Las ventas por ciudad” combinaba órdenes con locales en una consulta. Ahora esos datos están en dos bases distintas. Hay que pedirlos por la red y combinarlos en el código, o mantener una copia de unos dentro del otro servicio. - Ya no hay transacción. “Marcar el asiento como vendido y registrar el
pago” era un
BEGIN … COMMIT. Si asientos y pagos son dos servicios, no hay unROLLBACKque deshaga los dos.
Lewis y Fowler lo reconocen sin rodeos: las transacciones distribuidas son difíciles de implementar, y por eso estas arquitecturas prefieren coordinarse sin transacciones, aceptando de manera explícita que la consistencia puede ser solo eventual y que los problemas se corrigen con operaciones de compensación. Cómo se hace eso, con sagas, es el tema de la semana 12.
Idea clave. En microservicios, el límite de un servicio no lo define su código, sino sus datos. Si dos servicios comparten tablas, por separado que se desplieguen, son un solo servicio con dos procesos.
Bounded context: el límite de un servicio
Si cada servicio tiene sus datos, hay que decidir qué datos van con qué servicio. La herramienta que usa el estilo viene del diseño guiado por el dominio: el bounded context, un modelo del dominio con un significado propio y un límite dentro del cual ese significado vale.
El ejemplo clásico es una palabra que significa cosas distintas según quién la use. En Tinkuy, “asiento”:
- Para el catálogo, un asiento es un lugar físico de un local: sección, fila, número. Existe aunque no haya ningún evento.
- Para órdenes, un asiento es algo que se vende para una fecha: tiene precio y un estado, disponible o vendido.
- Para el control de acceso en la puerta, un asiento es un código de entrada que se valida una sola vez.
Un solo modelo Seat que sirva a los tres termina con campos que solo le
importan a uno y con reglas que se estorban. Tres contextos, cada uno con su
propio modelo de “asiento” y con una traducción explícita entre ellos, cambian
por separado. Lewis y Fowler señalan que la división en bounded contexts sirve
tanto para un monolito como para microservicios, y que hay una correspondencia
natural entre el límite de un contexto y el de un servicio.
Fíjense en que esos límites no son los sustantivos del sistema. No hay un “servicio de asientos” que guarde todo lo que se sabe de un asiento. Volveremos sobre esto en los errores comunes.
Lo que cuestan
Los microservicios pagan el precio completo de la distribución:
- Los datos. Sin
JOINy sin transacciones entre servicios (semanas 12 y 13). - Las fallas. Cada llamada entre servicios puede fallar o tardar, y hay que decidir qué hace el que llama en cada caso (semana 14).
- La operación. Cada servicio tiene su despliegue, su configuración, su base de datos, sus respaldos y sus alertas. Con veinte servicios, todo eso se multiplica por veinte, y sin automatización no se puede sostener.
- La observabilidad. Una compra que antes era una traza de llamadas en un proceso ahora cruza cinco. Para saber dónde se demoró o dónde falló hace falta poder seguir una petición a través de todos (semana 14).
- Los límites se vuelven caros de mover. Mover una función entre dos módulos es un refactoring. Moverla entre dos servicios exige cambiar dos APIs, migrar datos entre dos bases y coordinar dos despliegues. Lewis y Fowler lo listan entre las razones por las que el estilo podría envejecer mal: cuando los componentes son servicios, el refactoring es mucho más difícil que con bibliotecas dentro de un proceso.
Los mismos autores cierran su artículo con una cautela que conviene recordar cada vez que alguien presente este estilo como el destino natural de todo sistema: escriben con “optimismo cauteloso”, admiten que todavía no ha pasado el tiempo suficiente para juzgar cómo envejecen estas arquitecturas, y recogen como razonable el consejo de empezar con un monolito, mantenerlo modular y partirlo cuando el monolito se vuelva un problema. Es la estrategia monolith first de la semana 4.
Granularidad: qué empuja a partir y qué empuja a unir
¿Qué tan pequeño debe ser un servicio? No hay un tamaño correcto. Hay fuerzas en dos direcciones, y el tamaño sale de ponerlas en la balanza para un caso.
Empujan a partir una pieza en dos:
- Tasas de cambio distintas. Una parte cambia todas las semanas y la otra una vez al año. Juntas, cada cambio de la primera obliga a volver a probar y desplegar la segunda.
- Escalado distinto. Una parte recibe mil veces más carga que la otra.
- Aislamiento. Una parte depende de algo inestable, o maneja datos con requisitos de seguridad propios, y no se quiere que arrastre o exponga al resto.
Empujan a unir dos piezas en una:
- Transacciones. Si dos datos tienen que cambiar juntos o no cambiar,
separarlos convierte un
COMMITen una saga. - Flujos que conversan mucho. Si para atender un pedido dos servicios se llaman diez veces, la frontera está en el lugar equivocado: se paga latencia y fallas parciales por algo que era una llamada local.
- Datos compartidos. Si los dos necesitan leer y escribir las mismas tablas, no son dos.
Trade-off. Partir más fino da más independencia de despliegue y de escalado, y cuesta más llamadas remotas, más operaciones que ya no caben en una transacción y más despliegues que operar. Unir da consistencia y simpleza, y cuesta que más cosas cambien y se desplieguen juntas. La granularidad correcta es la que deja las transacciones y las conversaciones frecuentes dentro de un servicio y los cambios independientes entre servicios.
Service-based y microservicios, lado a lado
| Service-based | Microservicios | |
|---|---|---|
| Cuántos servicios | Pocos y grandes: del orden de cuatro a doce | Muchos y pequeños: decenas o cientos |
| Qué es un servicio | Un dominio completo | Un solo propósito dentro de un dominio |
| Datos | Una base compartida, a lo más partida por esquemas | Una base por servicio; nadie más la lee |
| Transacciones | Las de la base de datos, casi siempre dentro de un servicio | Entre servicios no hay: sagas y consistencia eventual |
| Consultas que cruzan dominios | Un JOIN, con disciplina sobre quién es owner de qué |
Llamadas por la red, o copias de los datos |
| Despliegue y escalado | Por servicio | Por servicio, con más detalle |
| Costo de operación | Moderado | Alto: exige automatización y observabilidad |
| Quién lo sostiene | Un equipo, o unos pocos | Muchos equipos, uno por servicio o por grupo de servicios |
Lo que se pierde al pasar de la primera columna a la segunda está en las filas de datos, transacciones y consultas. Lo que se gana es que ningún equipo depende del esquema de otro. Si ese no es el problema que el sistema tiene, el paso no compra nada.
Cómo se comunican los servicios
Síncrona: petición y respuesta
En la comunicación síncrona, quien llama envía una petición y espera la respuesta para continuar. Los dos protocolos habituales son HTTP con JSON y gRPC. Es el modelo más fácil de entender, porque se parece a llamar a una función, y esa es también su trampa: se parece, pero tiene todos los finales de la sección Fallas parciales: lo que ve quien llama.
Su consecuencia de arquitectura es el acoplamiento en el tiempo: para que la petición funcione, los dos servicios tienen que estar vivos y con capacidad en el mismo instante. Si el que responde está lento, el que llama está lento. Si está caído, el que llama falla.
La disponibilidad de una cadena síncrona
En la semana 2 vimos que las disponibilidades de componentes en serie se multiplican. Una cadena de llamadas síncronas es exactamente eso. Si atender una compra exige que respondan bien cuatro componentes (órdenes y tres servicios a los que llama) y cada uno tiene 99,9 % de disponibilidad, la compra tiene
es decir, 99,6 %. En horas al año: un componente con 99,9 % puede estar caído horas; la cadena de cuatro, horas. Cada servicio cumple su objetivo y el conjunto falla cuatro veces más. (El cálculo supone que los componentes fallan de manera independiente, que es el supuesto habitual y también el más optimista.)
En la industria. Lewis y Fowler describen este efecto en Microservices: con varias llamadas síncronas entre servicios, los tiempos de caída se multiplican, y la elección es entre hacer las llamadas asíncronas o administrar esa caída. Cuentan que el sitio del diario The Guardian adoptó en su plataforma nueva una regla sencilla, una sola llamada síncrona por petición de usuario, y que Netflix rediseñó la API de su plataforma para que fuera asíncrona. Son datos de 2014, de dos organizaciones con muchos más servicios y más ingenieros que el equipo de Tinkuy; lo que se traslada es el razonamiento, no la regla.
Asíncrona: mensajes
En la comunicación asíncrona, quien envía deja un mensaje en un sistema de mensajería y sigue con lo suyo. El receptor lo procesa cuando puede. Entre los dos hay un tercero, el broker, que guarda el mensaje mientras tanto.
Esto rompe el acoplamiento en el tiempo: el receptor puede estar lento o caído sin que el emisor lo note. A cambio, el emisor ya no recibe un resultado, y hay un componente más que operar y del que ahora depende todo. La segunda mitad del capítulo desarrolla este modelo y lo mide.
| Síncrona | Asíncrona | |
|---|---|---|
| Quien llama | Espera la respuesta | Deja el mensaje y sigue |
| Si el otro está lento | Quien llama está lento | Los mensajes se acumulan; quien llama no se entera |
| Si el otro está caído | Quien llama falla | Los mensajes esperan en el broker |
| Resultado | Inmediato: se sabe si salió bien | No hay; el efecto ocurre después |
| Para seguir una petición | Una cadena de llamadas | Hay que reconstruir quién reaccionó a qué |
| Sirve cuando | Quien llama necesita la respuesta para continuar | Quien llama solo necesita que el trabajo se haga |
API gateway
Si hay diez servicios, la aplicación web no debería conocer las diez direcciones, ni autenticarse diez veces. Un API gateway es una entrada única delante de los servicios que hace tres cosas: enruta cada petición al servicio que le toca, autentica a quien llama una sola vez, en el borde, y limita cuántas peticiones acepta de cada cliente (rate limiting).
Trade-off. Un API gateway esconde la topología interna (se puede partir o unir servicios sin que los clientes se enteren) y concentra en un lugar lo que de otro modo se repetiría en cada servicio. A cambio, todo el tráfico pasa por él: es un salto más de red en cada petición y un punto único de falla que hay que hacer redundante. Y tiene una tentación: como todo pasa por ahí, es fácil ir metiéndole lógica del negocio, hasta que el gateway se vuelve el monolito que se quería dejar atrás. Un gateway enruta, autentica y limita; no decide precios.
La alternativa, que los clientes llamen directamente a cada servicio, evita el salto y el punto único, y expone la estructura interna a todos los clientes: razonable con dos servicios, difícil de sostener con veinte.
Tinkuy: qué parte saldría del monolito
Con todo lo anterior, miremos Tinkuy. Tiene cinco módulos: catálogo, órdenes, pagos, notificaciones y reportes. ¿Cuál se beneficiaría de salir del monolito? La respuesta sale de aplicar las fuerzas de granularidad a cada candidato.
Los pagos son el mejor candidato, por dos de las tres fuerzas que empujan a partir. La primera es el aislamiento frente a algo inestable: dependen de un servicio externo, la pasarela, que puede estar lento o caído, y hoy esa lentitud ocurre dentro de la transacción de la compra. La segunda es la seguridad: son la única parte que ve los datos de la tarjeta, y un servicio aparte permite un límite de confianza nítido, con menos código y menos personas dentro. En contra está la fuerza más fuerte de las que empujan a unir: hoy, cobrar y marcar los asientos como vendidos están en una sola transacción. Separar los pagos obliga a rediseñar eso. Es el trabajo de P4, y por eso llega después de las semanas 12 y 13.
El catálogo parece un candidato por escalado: se lee muchísimo más de lo que se escribe. Pero hay respuestas más baratas para “muchas lecturas” que un servicio: una réplica de lectura y una cache resuelven ese escenario sin una sola llamada remota nueva entre módulos. Es lo que se hace en P3, con las semanas 10 y 11.
Las notificaciones son el caso del resto del capítulo.
En Tinkuy. Después de pagar, el Tinkuy inicial envía el correo de confirmación dentro de la petición, y dentro de la transacción de la compra.
make tinkuy-emaillo mide sobre una copia (enbuild/tinkuy), con cinco compras de un asiento. Primero con el servidor de correo simulado en su valor por omisión, 120 ms, y luego con 800 ms:$ make tinkuy-email Tinkuy inicial, EMAIL_LATENCY_MS=120 EMAIL_FAIL_EVERY=0 compra del asiento 1: 201 en 0.234284 s compra del asiento 2: 201 en 0.216629 s compra del asiento 3: 201 en 0.217946 s compra del asiento 4: 201 en 0.214998 s compra del asiento 5: 201 en 0.219356 s órdenes nuevas en la base de datos: 5 cobros que la pasarela aprobó antes de esta sonda: 5 (la sonda recibió ch_00000006) $ EMAIL_LATENCY_MS=800 make tinkuy-email Tinkuy inicial, EMAIL_LATENCY_MS=800 EMAIL_FAIL_EVERY=0 compra del asiento 1: 201 en 0.913168 s compra del asiento 2: 201 en 0.903385 s compra del asiento 3: 201 en 0.896794 s compra del asiento 4: 201 en 0.894027 s compra del asiento 5: 201 en 0.898149 s órdenes nuevas en la base de datos: 5 cobros que la pasarela aprobó antes de esta sonda: 5 (la sonda recibió ch_00000006)Cada milisegundo que tarda el correo es un milisegundo que espera el comprador: la compra pasó de unos 0,22 s a unos 0,90 s, los 680 ms que se le agregaron al correo. Y cuando el servidor de correo rechaza los mensajes es peor:
$ EMAIL_FAIL_EVERY=1 make tinkuy-email
Tinkuy inicial, EMAIL_LATENCY_MS=120 EMAIL_FAIL_EVERY=1
compra del asiento 1: 500 en 0.237319 s
compra del asiento 2: 500 en 0.216168 s
compra del asiento 3: 500 en 0.212930 s
compra del asiento 4: 500 en 0.213226 s
compra del asiento 5: 500 en 0.213978 s
órdenes nuevas en la base de datos: 0
cobros que la pasarela aprobó antes de esta sonda: 5 (la sonda recibió ch_00000006)
Cinco compradores recibieron un error, no hay ninguna orden, y la pasarela aprobó cinco cobros. El
ROLLBACKdeshizo lo que estaba en la base de datos de Tinkuy y no pudo deshacer lo que ya había pasado en otro sistema. Es la falla parcial de la sección anterior, dentro de un monolito: basta con que haya un sistema externo para tenerla. Que la compra no pueda completarse porque no salió un correo es además una decisión de disponibilidad que nadie tomó a propósito.
Dos errores al distribuir
El monolito distribuido
Un monolito distribuido es un sistema partido en servicios que conserva los acoplamientos del monolito. Tiene los costos de los dos mundos (llamadas remotas, fallas parciales, muchos despliegues) y los beneficios de ninguno (no se puede desplegar ni escalar una parte sola).
Se reconoce por tres señales, y cualquiera de ellas basta:
- Los servicios comparten tablas. Dos servicios leen y escriben las mismas tablas, de modo que un cambio de esquema obliga a cambiar los dos.
- Hay que desplegarlos juntos. Si la versión 12 de órdenes solo funciona con la versión 8 de pagos, y hay que subirlas a la vez y en orden, no son independientes. La prueba es sencilla: ¿se puede desplegar un servicio un martes cualquiera sin avisarle a nadie?
- Se llaman en cadena de forma síncrona. A llama a B, que llama a C, que llama a D, y la petición del usuario espera a todos. La latencia es la suma de todas y la disponibilidad es el producto de todas, como en el cálculo de más arriba. Si D se cae, se caen todos.
El monolito distribuido casi nunca se diseña: se llega a él partiendo un monolito por donde fue más fácil cortar el código, sin partir los datos y sin cambiar la forma en que las partes se hablan.
Error común. Creer que un sistema es de microservicios porque tiene muchos repositorios y muchos contenedores. Lo que define el estilo no es cuántos procesos hay, sino qué puede hacer cada uno sin los demás: desplegarse, escalar, seguir atendiendo cuando su vecino se cae.
Partir por sustantivos
El segundo error ocurre antes, al elegir los límites. Es mirar el modelo de datos, tomar los sustantivos (usuario, orden, asiento, pago) y declarar un servicio por cada uno: “servicio de usuarios”, “servicio de órdenes”, “servicio de asientos”.
Parece ordenado, y produce servicios que no pueden hacer nada solos. Una compra necesita al usuario, la orden, los asientos y el pago: toca los cuatro servicios, con llamadas entre ellos y sin una transacción que la proteja. Los límites cortaron justo por donde pasan los flujos más frecuentes del negocio. Es el mismo error de la semana 3, dividir por estructura y no por lo que cambia junto, con un costo mucho mayor.
Los límites buenos siguen capacidades del negocio y bounded contexts: “vender entradas”, “cobrar”, “controlar el acceso”. Cada uno tiene dentro los sustantivos que necesita, con el significado que tienen para él.
Error común. Decidir los límites entre servicios antes de entender el dominio. Un límite equivocado entre dos módulos se corrige moviendo archivos. Un límite equivocado entre dos servicios se corrige migrando datos entre dos bases, cambiando dos APIs y coordinando a dos equipos. Por eso conviene descubrir los límites dentro de un monolito, donde moverlos es barato, y partir cuando ya dejaron de moverse.
Eventos y comandos
La segunda sesión empieza con una distinción entre dos tipos de mensaje. Parece de vocabulario y decide la estructura de dependencias de un sistema.
Un comando pide que algo pase. Se nombra con un verbo en imperativo:
ChargeCard, SendConfirmationEmail, ReserveSeat. Va dirigido a un
destinatario concreto, del que se espera que lo haga y, casi siempre, que diga
cómo le fue. Un comando puede ser rechazado.
Un evento dice que algo ya pasó. Se nombra con un participio, en pasado:
OrderPaid, SeatReserved, RefundRequested. No va dirigido a nadie: quien
lo publica no sabe quién lo escucha, ni cuántos son, ni le importa. Un evento
no se puede rechazar, porque es un hecho. Lo más que puede hacer quien lo
recibe es ignorarlo.
| Comando | Evento | |
|---|---|---|
| Dice | “Haz esto” | “Pasó esto” |
| Nombre | Imperativo: ChargeCard |
Pasado: OrderPaid |
| Destinatario | Uno, conocido | Cero, uno o muchos, desconocidos |
| Quien envía espera | Que se haga, y un resultado | Nada |
| Se puede rechazar | Sí | No: ya pasó |
| Quién conoce a quién | Quien envía conoce al que recibe | Quien recibe conoce al que publica |
La última fila es la que importa para la arquitectura. Con un comando, la
dependencia va del que envía hacia el que recibe: órdenes tiene que saber que
existe un servicio de correo y qué sabe hacer. Con un evento, la dependencia se
invierte: órdenes publica OrderPaid y no sabe nada del correo; es el
servicio de correo el que sabe que existe un evento OrderPaid y qué trae.
Es la inversión de dependencias de la semana 3, hecha con mensajes en vez de
interfaces.
RefundRequested merece un comentario, porque parece un pedido. Es un evento:
dice que un comprador ya pidió un reembolso, un hecho que ocurrió y que varios
pueden querer conocer (pagos, soporte, reportes). El comando correspondiente
sería RefundPayment, dirigido a pagos. La pregunta para clasificar no es si
el nombre suena a pedido, sino si el mensaje describe un hecho que ya ocurrió o
le encarga un trabajo a alguien.
Error común. El comando disfrazado de evento. Si órdenes publica
OrderPaidpara que el servicio de correo envíe la confirmación, y el sistema está mal si eso no pasa, entonces órdenes sí espera algo de un destinatario concreto: lo que tiene es un comando con nombre de evento. Fowler lo llama un comando pasivo-agresivo. No es solo un problema de nombres: el flujo real del sistema (después de pagar se envía un correo) quedó sin escribir en ninguna parte del código.
El estilo event-driven
La forma: productor, broker, consumidores
En el estilo event-driven, los componentes no se llaman entre sí: reaccionan a eventos. Tiene tres tipos de elementos.
- El productor publica un evento cuando algo pasa en su dominio, y sigue.
- El broker recibe el evento, lo guarda y lo entrega a quien esté interesado. En este curso el broker es NATS con JetStream.
- Los consumidores se suscriben a los eventos que les interesan y reaccionan a cada uno cuando pueden.
La restricción del estilo es que el productor no conoce a los consumidores. Lo único que comparten es el evento: su nombre y la forma de sus datos. Ese es el contrato.
Qué se gana
- Desacoplamiento en el tiempo. El consumidor puede estar lento, caído o en medio de un despliegue. El productor no se entera, y los eventos esperan en el broker.
- Capacidad de absorber picos. Si llegan mil compras en un segundo y el servidor de correo acepta diez mensajes por segundo, los eventos se acumulan y el correo los va despachando a su ritmo. El pico lo absorbe la cola, no el comprador.
- Agregar un consumidor no toca al productor. Un efecto nuevo es un componente nuevo que se suscribe. El código del productor no cambia.
- Aislamiento de fallas. Un consumidor que falla no hace fallar al productor ni a los otros consumidores.
Qué se paga
- Consistencia eventual. Cuando el productor responde, los efectos todavía no ocurrieron. Durante un rato el sistema está en un estado intermedio: la orden está pagada y el reporte todavía no la cuenta. Ese rato puede ser de milisegundos o de horas, y el diseño tiene que decir qué pasa mientras dura.
- Flujos difíciles de seguir. “¿Qué pasa después de una compra?” ya no se responde leyendo una función. Hay que saber quién está suscrito a qué. Fowler lo señala como la trampa de este estilo: es muy fácil armar sistemas bien desacoplados sin notar que se perdió de vista el flujo de conjunto, que ya no está escrito en ningún programa y muchas veces solo se puede reconstruir observando el sistema en producción.
- El manejo de errores hay que diseñarlo. En una llamada, un error sube por la pila hasta quien llamó. Con eventos no hay a quién subirle: el productor ya respondió. Qué pasa con un evento que no se pudo procesar es una decisión que alguien tiene que tomar.
- Un componente más. El broker hay que operarlo, y pasa a estar en el camino de todo.
La mejor manera de entender esta lista es verla en un caso. Es lo que sigue.
El caso de la semana: después de una compra
El caso de code/week-05/ es un sistema mínimo de venta de
entradas, separado de Tinkuy, con una sola operación: POST /orders. Después
de cada compra tienen que pasar tres cosas, que llamaremos efectos:
- enviar el correo de confirmación al comprador;
- actualizar el reporte de ventas del concierto;
- sumar puntos al comprador (un punto por cada sol pagado).
Los tres efectos están en la carpeta effects/, un archivo por efecto, y cada
uno escribe en su propia tabla. El correo no tiene un proveedor de verdad:
simula la demora de uno con EMAIL_LATENCY_MS (100 ms por omisión) y deja el
envío registrado. El programa de puntos se puede hacer fallar con
POINTS_FAIL=1. El cobro no es el tema de la semana: toda orden válida queda
pagada.
El sistema viene implementado dos veces. Las dos versiones comparten los efectos, el servidor HTTP y la base de datos. Lo único que cambia es cómo se entera cada efecto de que hubo una compra.
La versión síncrona
En sync/, el módulo de órdenes llama a los tres efectos, uno tras otro. Todo
el diseño cabe en
sync/place-order.ts:
import { sendConfirmationEmail } from '../effects/email.ts';
import { addLoyaltyPoints } from '../effects/loyalty-points.ts';
import { addToSalesReport } from '../effects/sales-report.ts';
import { savePaidOrder } from '../shared/orders-store.ts';
import type { NewOrder, PaidOrder } from '../shared/types.ts';

export async function placeOrder(input: NewOrder): Promise<PaidOrder> {
  const order = await savePaidOrder(input);
  await sendConfirmationEmail(order);
  await addToSalesReport(order);
  await addLoyaltyPoints(order);
  return order;
}
Se lee de arriba abajo y dice todo lo que pasa después de una compra, en qué orden. Esa es su virtud, y es grande. La compra responde cuando termina la última línea.
La versión con eventos
En events/, el módulo de órdenes guarda la orden, publica un evento
OrderPaid y responde. Este es
events/place-order.ts:
import { randomUUID } from 'node:crypto';
import { savePaidOrder } from '../shared/orders-store.ts';
import type { NewOrder, PaidOrder } from '../shared/types.ts';
import { publishOrderPaid } from './bus.ts';

export async function placeOrder(input: NewOrder): Promise<PaidOrder> {
  const order = await savePaidOrder(input);
  await publishOrderPaid({
    type: 'OrderPaid',
    id: randomUUID(),
    occurredAt: new Date().toISOString(),
    order,
  });
  return order;
}
Los efectos corren en tres procesos aparte, los consumidores. Cada uno es un
archivo de tres líneas. Este es el del correo,
events/consumers/email.ts:
import { sendConfirmationEmail } from '../../effects/email.ts';
import { runConsumerProcess } from '../consumer-process.ts';

await runConsumerProcess('email', (event) => sendConfirmationEmail(event.order));
Lo único que el productor y los consumidores tienen en común es el tipo del
evento, en
events/order-paid.ts:
export type OrderPaid = {
  type: 'OrderPaid';
  id: string;
  occurredAt: string;
  order: PaidOrder;
};
El evento lleva dentro los datos de la orden (comprador, concierto, cantidad, total). Es una decisión, y tiene alternativa: el evento podría llevar solo el identificador de la orden, y cada consumidor le preguntaría a órdenes por el resto. Lo veremos con nombre propio en Los cuatro usos de «event-driven».
Quién conoce a quién
Miren los import de los dos place-order.ts. Es el primer paso del
laboratorio, y la diferencia entre los dos estilos está completa ahí.
sync/place-order.ts importa |
events/place-order.ts importa |
|
|---|---|---|
| El correo | effects/email.ts |
no |
| El reporte | effects/sales-report.ts |
no |
| Los puntos | effects/loyalty-points.ts |
no |
| El bus de eventos | no | events/bus.ts |
En la versión síncrona, órdenes conoce a los tres efectos: tres flechas salen
de órdenes. En la versión con eventos, órdenes solo conoce el bus y el evento,
y son los consumidores los que conocen el evento: las flechas apuntan hacia
OrderPaid. Las dependencias se invirtieron.
Tiene una consecuencia que se puede contar. Para agregar un cuarto efecto a la
versión síncrona hay que modificar sync/place-order.ts, el archivo central
del módulo de órdenes. Para agregarlo a la versión con eventos no se toca
ningún archivo existente: se escribe un consumidor nuevo. Lo harán en el paso 6
del laboratorio.
Idea clave. Pasar de llamadas a eventos no elimina el acoplamiento: lo cambia de lugar y de dirección. Órdenes ya no depende de los efectos; ahora los efectos dependen del contrato del evento, y todos dependen del broker. Cambiar la forma de
OrderPaides ahora el cambio caro, porque quien lo publica no sabe a quién le rompe.
NATS JetStream en una página
Para leer las salidas que siguen hacen falta cuatro conceptos de NATS
JetStream. Todo lo que el ejemplo sabe de NATS está en un archivo,
events/bus.ts.
- Un subject es el nombre con el que se publica un mensaje. Aquí,
w05.orders.paid. - Un stream guarda en disco los mensajes publicados en sus subjects, en
orden, cada uno con un número de secuencia. El de la semana se llama
W05_ORDERS. Cuandopublishtermina bien, el mensaje ya está guardado: no depende de que haya algún consumidor vivo. - Un consumer durable es un cursor sobre el stream, guardado en el
servidor, con nombre. Recuerda hasta dónde llegó cada consumidor. Hay uno
por efecto:
email,reportypoints. Como cada uno tiene su propio cursor, los tres reciben todos los mensajes, cada uno a su ritmo. - Un ack es la confirmación de que un mensaje se procesó. Mientras un consumidor no confirme un mensaje, el servidor lo considera pendiente y lo vuelve a entregar.
El ciclo de un consumidor está en la función startConsumer:
for await (const message of messages) {
  const event = message.json<OrderPaid>();
  try {
    await handler(event);
    await message.ackAck();
  } catch (error) {
    log(name, `orden ${event.order.orderId}: intento ${message.info.deliveryCount} falló (${String(error)})`);
    message.nak(settings.redeliveryDelayMs);
  }
}
Si el efecto termina bien, el mensaje se confirma. Si lanza un error, se
devuelve con nak y el servidor lo entrega de nuevo dos segundos después. No
hay límite de intentos. Y si el proceso muere sin decir nada, el servidor
espera 30 segundos (el ack_wait del consumer) y lo reenvía. Fíjense en el
orden: primero el trabajo, después la confirmación. Tiene una consecuencia que
veremos al final de la sección.
Cuánto tarda la compra
make sync levanta la versión síncrona y make events la versión con eventos
(el servidor de órdenes y los tres consumidores), las dos en el puerto 3000 y
siempre con datos nuevos. Desde otra terminal, make measure N=10 hace diez
compras, una después de otra, mide cuánto tarda en responder cada una desde el
lado de quien compra, y luego espera a que todos los efectos hayan ocurrido.
Versión síncrona:
$ make measure N=10
compra  1: 201 en   144 ms
compra  2: 201 en   107 ms
compra  3: 201 en   107 ms
compra  4: 201 en   107 ms
compra  5: 201 en   112 ms
compra  6: 201 en   108 ms
compra  7: 201 en   108 ms
compra  8: 201 en   113 ms
compra  9: 201 en   109 ms
compra 10: 201 en   111 ms
10 compras, 0 con error. Tiempo de respuesta: mín 107 ms · p50 108 ms · p95 144 ms · máx 144 ms
Los tres efectos de todas las órdenes estaban hechos 0.0 s después de la última respuesta.
órdenes pagadas         10
correos enviados        10 de 10     correos (completo)
reporte de ventas       10 de 10     órdenes (completo)
puntos sumados        1590 de 1590   puntos (completo)
Versión con eventos:
$ make measure N=10
compra  1: 201 en    34 ms
compra  2: 201 en     4 ms
compra  3: 201 en     3 ms
compra  4: 201 en     2 ms
compra  5: 201 en     2 ms
compra  6: 201 en     2 ms
compra  7: 201 en     2 ms
compra  8: 201 en     2 ms
compra  9: 201 en     2 ms
compra 10: 201 en     2 ms
10 compras, 0 con error. Tiempo de respuesta: mín 2 ms · p50 2 ms · p95 34 ms · máx 34 ms
Los tres efectos de todas las órdenes estaban hechos 1.0 s después de la última respuesta.
órdenes pagadas         10
correos enviados        10 de 10     correos (completo)
reporte de ventas       10 de 10     órdenes (completo)
puntos sumados        1590 de 1590   puntos (completo)
Tres observaciones antes de sacar conclusiones.
Cómo leer estos números. Con diez muestras, el p95 coincide con el máximo: no hay muestras suficientes para distinguirlos. Y el máximo es siempre la primera compra, que paga el arranque (entre otras cosas, abrir la primera conexión a la base de datos). Por eso la comparación se hace con la mediana. Una segunda tanda de diez compras sobre los mismos servidores dio una mediana de 108 ms en la versión síncrona y de 2 ms en la de eventos, igual que la primera. Son compras de una en una: esto mide el tiempo de respuesta sin carga, no el throughput.
La mediana pasó de 108 ms a 2 ms. En la versión síncrona, la compra tarda lo que tarda guardar la orden más lo que tardan los tres efectos, y casi todo es el correo (100 ms). En la versión con eventos tarda lo que tarda guardar la orden y publicar un mensaje.
El trabajo no desapareció. La última línea antes de la tabla lo dice: en la versión con eventos, los efectos terminaron un segundo después de la última respuesta. Diez correos de 100 ms, despachados de uno en uno por el consumidor, son un segundo. El correo tarda exactamente lo mismo que antes. Lo que cambió es quién espera: antes esperaba el comprador; ahora espera el evento, en el stream.
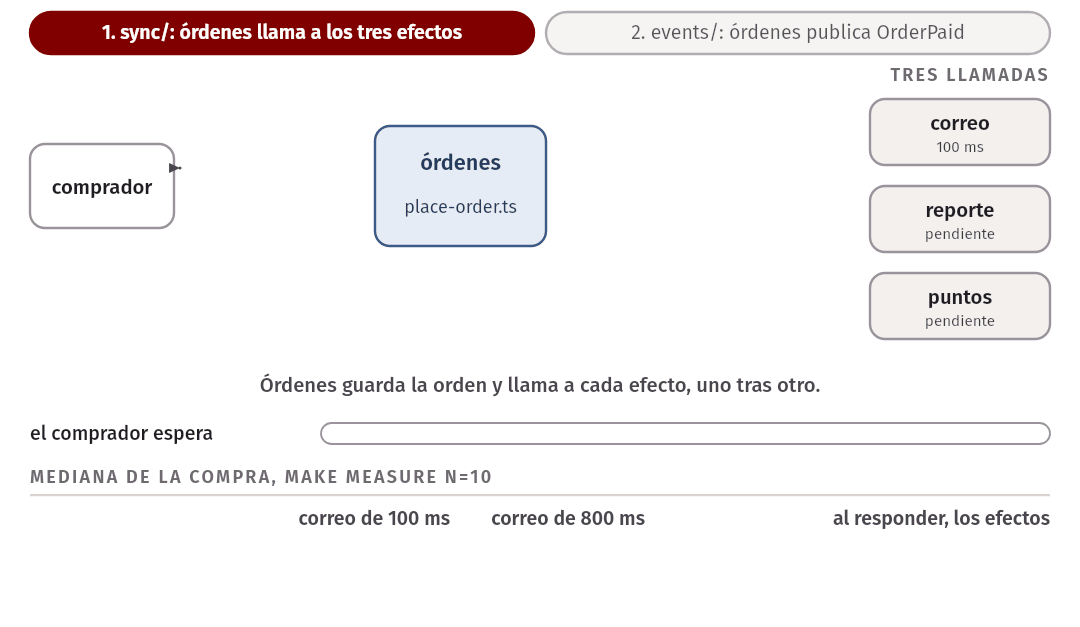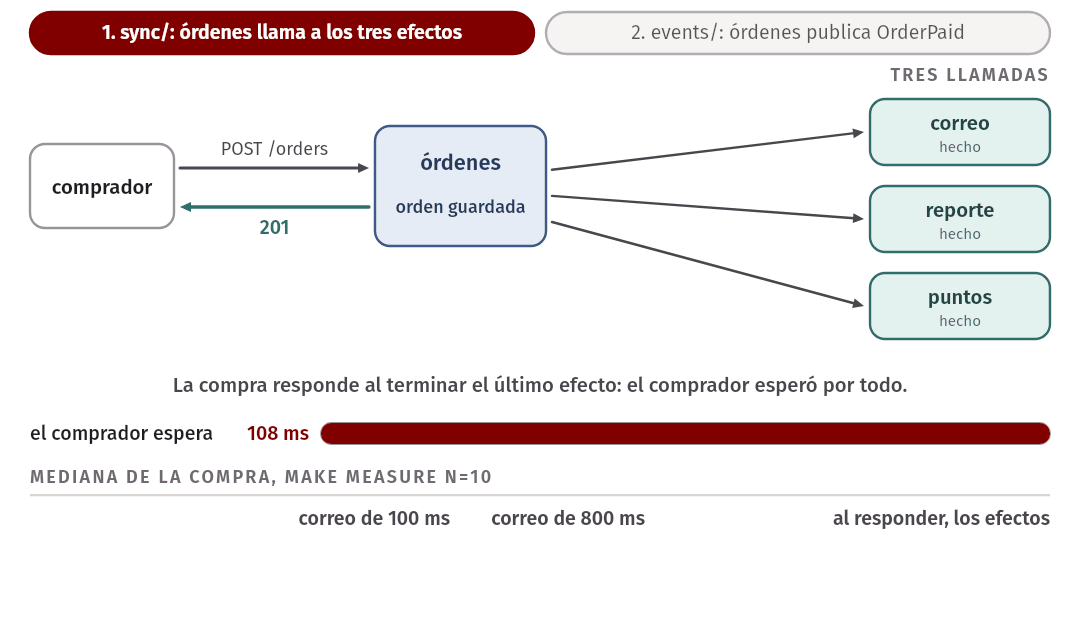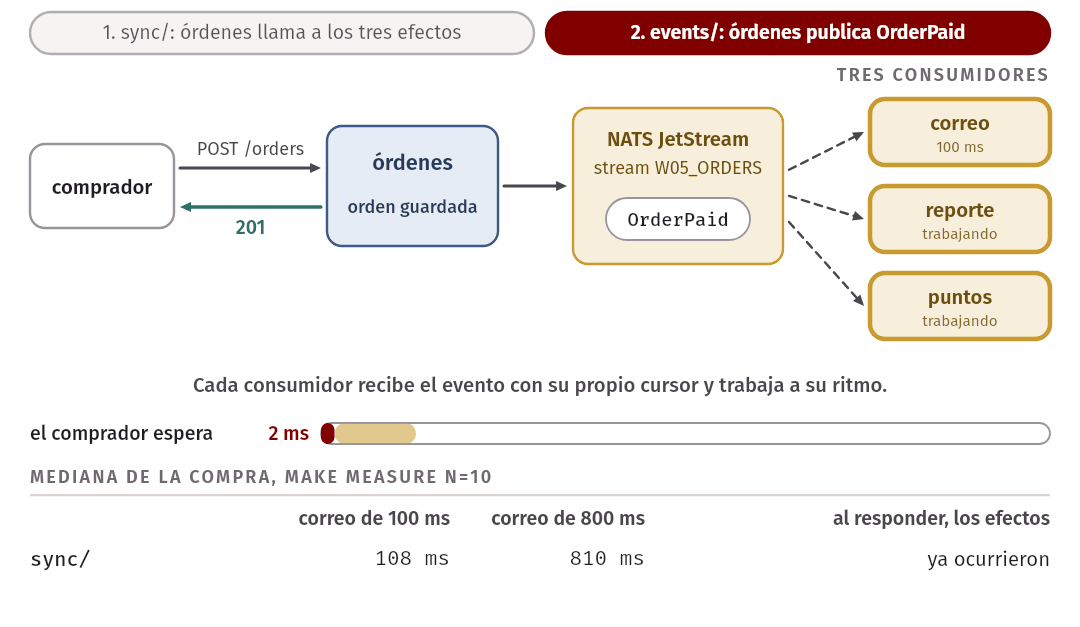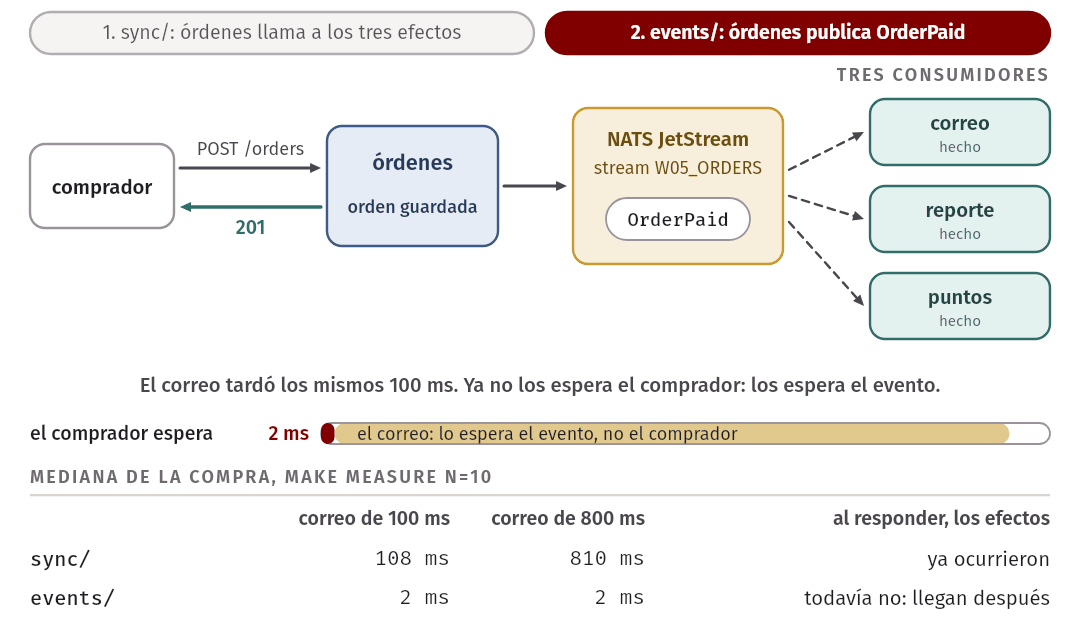
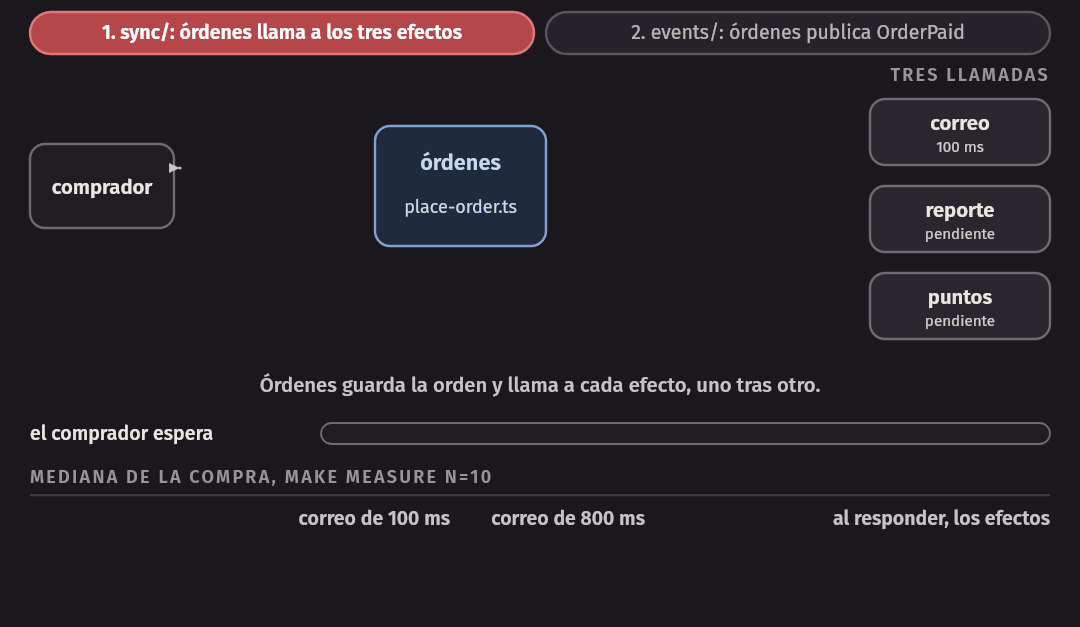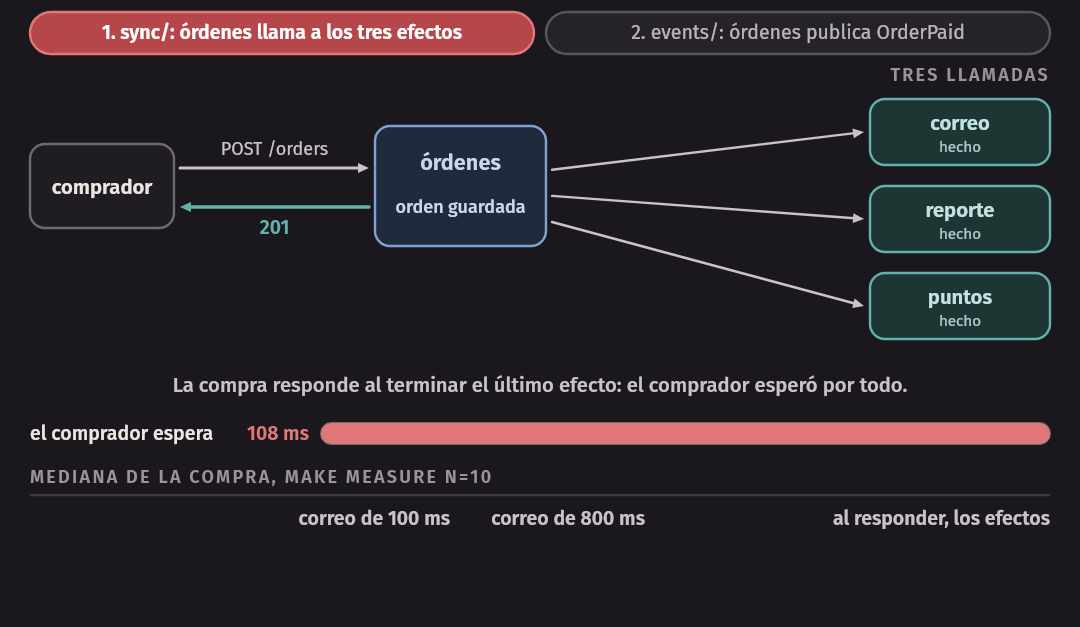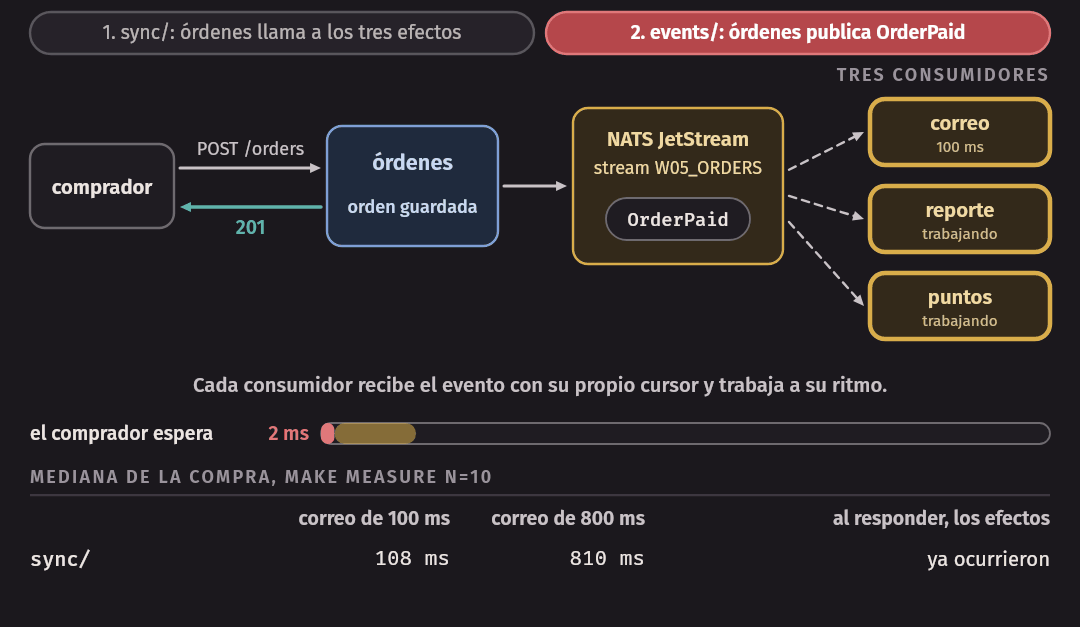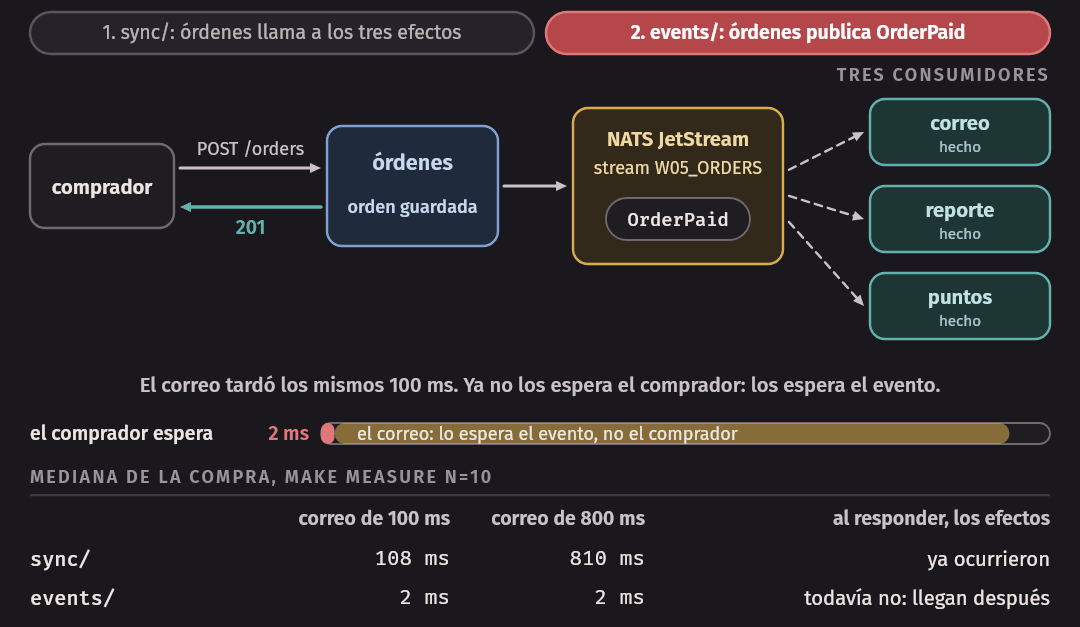
Idea clave. Los eventos no hacen el trabajo más rápido. Lo sacan del camino de la respuesta. La latencia que ve quien llama baja; el tiempo hasta que el sistema queda completo no baja, y ahora hay un intervalo en que la respuesta ya salió y los efectos todavía no ocurrieron.
Un paso lento
El paso 3 del laboratorio repite la medición con el correo ocho veces más
lento: EMAIL_LATENCY_MS=800 make sync y EMAIL_LATENCY_MS=800 make events.
Versión síncrona:
$ make measure N=10
compra  1: 201 en   848 ms
compra  2: 201 en   810 ms
compra  3: 201 en   810 ms
compra  4: 201 en   810 ms
compra  5: 201 en   813 ms
compra  6: 201 en   814 ms
compra  7: 201 en   808 ms
compra  8: 201 en   810 ms
compra  9: 201 en   818 ms
compra 10: 201 en   809 ms
10 compras, 0 con error. Tiempo de respuesta: mín 808 ms · p50 810 ms · p95 848 ms · máx 848 ms
Los tres efectos de todas las órdenes estaban hechos 0.0 s después de la última respuesta.
órdenes pagadas         10
correos enviados        10 de 10     correos (completo)
reporte de ventas       10 de 10     órdenes (completo)
puntos sumados        1590 de 1590   puntos (completo)
Versión con eventos:
$ make measure N=10
compra  1: 201 en    31 ms
compra  2: 201 en     3 ms
compra  3: 201 en     3 ms
compra  4: 201 en     2 ms
compra  5: 201 en     2 ms
compra  6: 201 en     2 ms
compra  7: 201 en     2 ms
compra  8: 201 en     2 ms
compra  9: 201 en     2 ms
compra 10: 201 en     2 ms
10 compras, 0 con error. Tiempo de respuesta: mín 2 ms · p50 2 ms · p95 31 ms · máx 31 ms
Los tres efectos de todas las órdenes estaban hechos 8.1 s después de la última respuesta.
órdenes pagadas         10
correos enviados        10 de 10     correos (completo)
reporte de ventas       10 de 10     órdenes (completo)
puntos sumados 1590 de 1590 puntos (completo)| Mediana de la compra | Correo de 100 ms | Correo de 800 ms |
|---|---|---|
sync/ |
108 ms | 810 ms |
events/ |
2 ms | 2 ms |
Efectos completos, en events/ |
1,0 s después | 8,1 s después |
En la versión síncrona, la latencia del correo es la latencia de la compra: los 700 ms que se agregaron al correo aparecen enteros en la mediana. En la versión con eventos, la compra no se enteró. La demora aparece en otra parte: el último comprador recibió su correo ocho segundos después de comprar.
Durante esos ocho segundos el sistema está a medio camino, y se puede ver.
Esta es la salida de make status dos segundos y medio después de empezar las
compras:
$ make status
órdenes pagadas         10
correos enviados         3 de 10     correos (faltan 7)
reporte de ventas       10 de 10     órdenes (completo)
puntos sumados        1590 de 1590   puntos (completo)
Y la del consumer email en el mismo momento (se muestra la sección de
estado):
$ make info C=email
nats consumer info W05_ORDERS email
...
State:

            Host Version: 2.15.3
      Required API Level: 0 hosted at level 5
  Last Delivered Message: Consumer sequence: 4 Stream sequence: 4 Last delivery: 53ms ago
    Acknowledgment Floor: Consumer sequence: 3 Stream sequence: 3 Last Ack: 54ms ago
        Outstanding Acks: 1 out of maximum 1,000
    Redelivered Messages: 0
    Unprocessed Messages: 6
           Waiting Pulls: 0 of maximum 512
Se lee así. Acknowledgment Floor en 3: los tres primeros mensajes están
confirmados (tres correos enviados). Outstanding Acks: 1: hay un mensaje
entregado y todavía sin confirmar, el cuarto, que el consumidor está
procesando. Unprocessed Messages: 6: quedan seis en el stream que este
consumer todavía no recibió. Tres más uno más seis son los diez eventos. Los
consumers report y points, que tienen su propio cursor, ya terminaron.
Eso es la consistencia eventual con números: las órdenes dicen diez, el
correo dice tres, y los dos tienen razón. Unprocessed Messages es además el
número que se vigila en producción: si crece sin parar, el consumidor no da
abasto.
Trade-off. La versión con eventos protege la latencia de la compra de un efecto lento. A cambio, el efecto llega tarde y la tardanza crece con la cola: con un correo de 800 ms y un solo consumidor, el sistema despacha 1,25 correos por segundo (), y si las compras llegan más rápido que eso de manera sostenida, la cola no deja de crecer. La cola absorbe un pico; no arregla un consumidor que es más lento que la llegada promedio. Para eso hay que agregar consumidores o hacer más rápido el efecto.
Un paso que falla
El paso 4 del laboratorio hace fallar el programa de puntos: POINTS_FAIL=1.
En la versión síncrona, cada compra recibe un error:
$ make buy N=3
compra  1: 500 en   144 ms  {"error":{"code":"INTERNAL_ERROR","message":"Ocurrió un error inesperado"}}
compra  2: 500 en   108 ms  {"error":{"code":"INTERNAL_ERROR","message":"Ocurrió un error inesperado"}}
compra  3: 500 en   111 ms  {"error":{"code":"INTERNAL_ERROR","message":"Ocurrió un error inesperado"}}
3 compras, 3 con error. Tiempo de respuesta: mín 108 ms · p50 111 ms · p95 144 ms · máx 144 ms
El comprador ve un 500 y concluye, con razón, que su compra no se hizo. Pero miren el estado en que quedó el sistema:
$ make status
órdenes pagadas          3
correos enviados         3 de 3      correos (completo)
reporte de ventas        3 de 3      órdenes (completo)
puntos sumados           0 de 385    puntos (faltan 385)
Las tres órdenes están pagadas, los tres correos de confirmación salieron y el reporte las cuenta. Lo único que no pasó es lo menos importante de todo, los puntos, y eso bastó para decirle al comprador que la compra falló. El log del servidor muestra la secuencia de una de ellas:
[email] orden 1: correo enviado a rosa.quispe@correo.pe
[report] orden 1: reporte del concierto 1 actualizado
[points] orden 1: el programa de puntos no responde
[orders] POST /orders 500 Error: El programa de puntos no responde
Rosa recibió un error en pantalla y un correo de confirmación en su bandeja. Si
hace lo natural, que es intentar de nuevo, queda con dos órdenes pagadas. Y los
puntos de la primera no van a llegar nunca: nadie quedó encargado de
reintentarlos. Las dos cosas están comprobadas en
test/sync.test.ts.
Podría objetarse que el ejemplo está mal hecho, y que bastaría con envolver
todo en una transacción para que el error deshaga la orden. Es lo que hace el
Tinkuy inicial, y ya vimos el resultado: el ROLLBACK deshace las filas, no
el correo que ya salió ni el cobro que ya se hizo. Otra salida es atrapar el
error de los puntos y seguir (un try/catch alrededor de la llamada): la
compra responde bien, y los puntos se pierden en silencio. Cualquiera de las
variantes síncronas obliga a elegir entre fallar la compra por un efecto
secundario o perder el efecto.
En la versión con eventos, las compras no se enteran:
$ make buy N=3
compra  1: 201 en    34 ms
compra  2: 201 en     3 ms
compra  3: 201 en     2 ms
3 compras, 0 con error. Tiempo de respuesta: mín 2 ms · p50 3 ms · p95 34 ms · máx 34 ms
El correo y el reporte ocurrieron, y los puntos no:
$ make status
órdenes pagadas          3
correos enviados         3 de 3      correos (completo)
reporte de ventas        3 de 3      órdenes (completo)
puntos sumados           0 de 385    puntos (faltan 385)
Es el mismo estado que en la versión síncrona, con dos diferencias. La
primera: el comprador recibió un 201, que es la verdad sobre su compra. La
segunda: los mensajes que no se pudieron procesar siguen ahí. El
consumidor de puntos los recibe, falla, los devuelve, y el servidor se los
entrega otra vez. Estas son, del log de make events, las líneas en que el
consumidor de puntos reporta un intento:
[points] orden 1: intento 1 falló (Error: El programa de puntos no responde)
[points] orden 2: intento 1 falló (Error: El programa de puntos no responde)
[points] orden 3: intento 1 falló (Error: El programa de puntos no responde)
[points] orden 1: intento 2 falló (Error: El programa de puntos no responde)
[points] orden 2: intento 2 falló (Error: El programa de puntos no responde)
[points] orden 3: intento 2 falló (Error: El programa de puntos no responde)
[points] orden 1: intento 3 falló (Error: El programa de puntos no responde)
nats consumer info muestra lo mismo desde el lado del servidor:
$ make info C=points
nats consumer info W05_ORDERS points
...
  Last Delivered Message: Consumer sequence: 9 Stream sequence: 3 Last delivery: 1.11s ago
    Acknowledgment Floor: Consumer sequence: 0 Stream sequence: 0
        Outstanding Acks: 3 out of maximum 1,000
    Redelivered Messages: 3
    Unprocessed Messages: 0
           Waiting Pulls: 1 of maximum 512
Acknowledgment Floor en 0: no se ha confirmado ningún mensaje. Outstanding Acks: 3: los tres están entregados y sin confirmar. Redelivered Messages: 3: los tres se entregaron más de una vez. Y la primera línea cuenta la
historia completa: el consumer hizo nueve entregas (Consumer sequence: 9) de
solo tres mensajes del stream (Stream sequence: 3).
nats consumer report pone a los tres consumidores lado a lado, y se ve que el
problema es de uno solo:
$ nats consumer report W05_ORDERS
╭─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────╮
│                                   Consumer report for W05_ORDERS with 3 consumers                                   │
├──────────┬──────┬────────────┬──────────┬─────────────┬─────────────┬─────────────┬───────────┬───────────┬─────────┤
│ Consumer │ Mode │ Ack Policy │ Ack Wait │ Ack Pending │ Redelivered │ Unprocessed │ Ack Floor │ API Level │ Cluster │
├──────────┼──────┼────────────┼──────────┼─────────────┼─────────────┼─────────────┼───────────┼───────────┼─────────┤
│ email    │ Pull │ Explicit   │ 30.00s   │ 0           │ 0           │ 0           │ 3         │ 0         │         │
│ points   │ Pull │ Explicit   │ 30.00s   │ 3           │ 3           │ 0           │ 0         │ 0         │         │
│ report   │ Pull │ Explicit   │ 30.00s   │ 0           │ 0           │ 0           │ 3         │ 0         │         │
╰──────────┴──────┴────────────┴──────────┴─────────────┴─────────────┴─────────────┴───────────┴───────────┴─────────╯
Ahora se “arregla” el programa de puntos: se detiene el consumidor que falla
(make stop C=points) y se inicia de nuevo sin la variable
(make consumer C=points):
$ make consumer C=points
node events/consumers/points.ts
[points] esperando eventos OrderPaid
[points] orden 1: 160 puntos para rosa.quispe@correo.pe
[points] orden 2: 180 puntos para luis.mamani@correo.pe
[points] orden 3: 45 puntos para carmen.huaman@correo.pe
$ make status
órdenes pagadas 3
correos enviados 3 de 3 correos (completo)
reporte de ventas 3 de 3 órdenes (completo)
puntos sumados 385 de 385 puntos (completo)Los puntos llegaron, tarde y sin que nadie volviera a comprar. El stream hizo de memoria del trabajo pendiente. En la versión síncrona, esa memoria no existe: cuando la llamada falló, lo único que sabía que había que sumar esos puntos era una petición HTTP que ya terminó.
Error común. Concluir que “con eventos las fallas se arreglan solas”. Se arreglan solas las fallas transitorias, las que desaparecen si se intenta más tarde. Si el mensaje falla porque el consumidor tiene un bug, o porque el mensaje mismo está mal, va a fallar en el intento mil igual que en el primero, y aquí se reintenta para siempre. Qué hacer con un mensaje que nunca se va a poder procesar (apartarlo en una dead letter queue después de cierto número de intentos) es parte del diseño, y lo veremos en la semana 13.
Un consumidor detenido
El paso 5 del laboratorio: con la versión de eventos corriendo y diez compras
ya procesadas, se detiene el consumidor del correo (make stop C=email), se
hacen cinco compras y se mira el estado.
$ make status
órdenes pagadas         15
correos enviados        10 de 15     correos (faltan 5)
reporte de ventas       15 de 15     órdenes (completo)
puntos sumados        2385 de 2385   puntos (completo)
$ make info C=email
nats consumer info W05_ORDERS email
...
  Last Delivered Message: Consumer sequence: 10 Stream sequence: 10 Last delivery: 3.57s ago
    Acknowledgment Floor: Consumer sequence: 10 Stream sequence: 10 Last Ack: 3.44s ago
        Outstanding Acks: 0 out of maximum 1,000
    Redelivered Messages: 0
    Unprocessed Messages: 5
           Waiting Pulls: 0 of maximum 512
Las cinco compras respondieron bien, el reporte y los puntos están al día, y
el consumer email tiene cinco mensajes sin procesar: su cursor se quedó en el
mensaje 10, el último que confirmó. Se inicia de nuevo el proceso:
$ make consumer C=email
node events/consumers/email.ts
[email] esperando eventos OrderPaid
[email] orden 11: correo enviado a rosa.quispe@correo.pe
[email] orden 12: correo enviado a luis.mamani@correo.pe
[email] orden 13: correo enviado a carmen.huaman@correo.pe
[email] orden 14: correo enviado a rosa.quispe@correo.pe
[email] orden 15: correo enviado a luis.mamani@correo.pe
No se perdió ninguno, y tampoco se repitió ninguno de los diez anteriores. La razón está en dos decisiones de diseño, y si cualquiera de las dos faltara, los cinco eventos se habrían perdido:
- El stream guarda los mensajes en disco, haya o no alguien escuchando. El evento no viaja del productor al consumidor: viaja del productor al stream, y ahí se queda.
- El cursor vive en el servidor, no en el proceso. El consumer durable
emailsiguió existiendo mientras el proceso estaba detenido, con su posición en el mensaje 10. El proceso nuevo retomó ese cursor.
Hay un sistema de mensajes más simple, el de publicar y suscribirse sin persistencia (el NATS básico, sin JetStream, funciona así): el mensaje se entrega a quien esté conectado en ese instante y a nadie más. Es más rápido y no guarda nada. Con ese modelo, los cinco eventos se habrían perdido. Que un consumidor pueda estar caído es una propiedad de este diseño, no de “los eventos” en general.
El mismo mecanismo explica algo más: tal como está configurado aquí, un
consumer nuevo empieza por el primer mensaje del stream, así que un efecto que se agrega hoy puede procesar las
compras de ayer. Está comprobado en
test/events.test.ts.
Lo que la versión con eventos no resuelve
Hasta aquí la versión con eventos ganó todas las comparaciones. Es momento de mirar su cuenta, que tiene cuatro partidas. Ninguna se resuelve esta semana, y todas vuelven en las semanas 12 y 13.
1. Guardar y publicar son dos operaciones. events/place-order.ts guarda
la orden en PostgreSQL y después publica en NATS. No hay una transacción que
cubra las dos. Si el proceso muere entre una y otra, o si el broker no está, la
orden existe y el evento no: ningún efecto va a ocurrir, y nada en el sistema
sabe que falta. Se puede provocar. Con la versión de eventos corriendo y dos
compras hechas, se mata NATS (svc kill nats) y se compra dos veces más:
$ make buy N=2
compra  1: 500 en  5033 ms  {"error":{"code":"INTERNAL_ERROR","message":"Ocurrió un error inesperado"}}
compra  2: 500 en  5011 ms  {"error":{"code":"INTERNAL_ERROR","message":"Ocurrió un error inesperado"}}
2 compras, 2 con error. Tiempo de respuesta: mín 5011 ms · p50 5011 ms · p95 5033 ms · máx 5033 ms
$ make status
órdenes pagadas          4
correos enviados         2 de 4      correos (faltan 2)
reporte de ventas        2 de 4      órdenes (faltan 2)
puntos sumados         340 de 680    puntos (faltan 340)
Dos cosas malas a la vez. El comprador esperó cinco segundos (el timeout de la
publicación) para recibir un error. Y las órdenes 3 y 4 quedaron pagadas, sin
evento. Después de levantar NATS de nuevo (svc start nats), las compras
vuelven a funcionar, y esas dos órdenes siguen incompletas:
$ make buy N=2
compra  1: 201 en    28 ms
compra  2: 201 en     4 ms
2 compras, 0 con error. Tiempo de respuesta: mín 4 ms · p50 4 ms · p95 28 ms · máx 28 ms
$ make status
órdenes pagadas          6
correos enviados         4 de 6      correos (faltan 2)
reporte de ventas        4 de 6      órdenes (faltan 2)
puntos sumados         680 de 1020   puntos (faltan 340)
Esos dos correos no van a salir nunca. El broker, que se introdujo para aislar a la compra de las fallas de los efectos, es ahora una dependencia síncrona de la compra. La solución, guardar el evento en la misma transacción que la orden en una tabla outbox y publicarlo después, es tema de la semana 12.
2. Un mensaje puede llegar dos veces. El consumidor hace el trabajo y después confirma. Si muere entre las dos cosas, el servidor no recibió la confirmación y entrega el mensaje de nuevo: el efecto se repite. Los consumidores de esta semana son ingenuos a propósito: no hacen nada para detectar duplicados. El de puntos suma sobre lo que haya; el de correo envía otro correo. La prueba sin idempotencia, un mensaje que se entrega dos veces suma los puntos dos veces lo demuestra con un consumidor que aplica el efecto y falla antes de confirmar: una orden de S/ 320 deja 640 puntos.
Invertir el orden (confirmar primero, trabajar después) cambia el problema por
otro: si el proceso muere después de confirmar, el mensaje se pierde. Con
confirmación después del trabajo, el mensaje se entrega al menos una vez;
con confirmación antes, a lo más una vez. No hay una tercera opción que el
broker pueda dar por sí solo. Lo que sí se puede es hacer que procesar dos
veces el mismo mensaje deje lo mismo que procesarlo una: idempotencia, semanas
12 y 13. El campo id del evento está ahí para eso, y nadie lo usa todavía.
3. Los mensajes pueden llegar en otro orden. Cuando un mensaje falla y se
reintenta dos segundos después, los que venían detrás ya se procesaron. Para
sumar puntos no importa: la suma da lo mismo en cualquier orden. Para otros
efectos sí importa: si los eventos fueran OrderPaid y OrderRefunded de la
misma orden y se procesaran al revés, el resultado sería otro. Garantizar el
orden por clave tiene su costo, y es tema de la semana 13.
4. Nadie sabe si los tres efectos ya ocurrieron. En la versión síncrona,
un 201 significa que todo pasó. En la versión con eventos, un 201 significa
que la orden está pagada y que el evento está en el stream. ¿Ya salió el
correo de la orden 7? Órdenes no lo sabe ni tiene cómo saberlo, y eso era
justamente lo que se buscaba. Para responder hay que ir a preguntarle a cada
efecto, que es lo que hace make status: compara lo que dicen las órdenes con
lo que registró cada uno. Esa comparación la tuvimos que escribir; no vino con
el estilo. Es el costo que se anota en la última fila de la tabla del
laboratorio.
Idea clave. Las tres preguntas que todo diseño con eventos debe responder son: ¿qué pasa si el consumidor falla a la mitad?, ¿qué pasa si el mensaje llega dos veces?, y ¿qué pasa si llegan en otro orden? Un diseño que no las responde no las evitó: las respondió por omisión, y casi siempre mal.
Dos topologías: broker y mediator
Dentro del estilo event-driven hay dos formas de organizar un proceso de varios pasos. Para verlas hace falta un caso con más pasos que el de la semana. Tomemos una compra completa: reservar los asientos, cobrar, emitir las entradas y notificar.
Broker
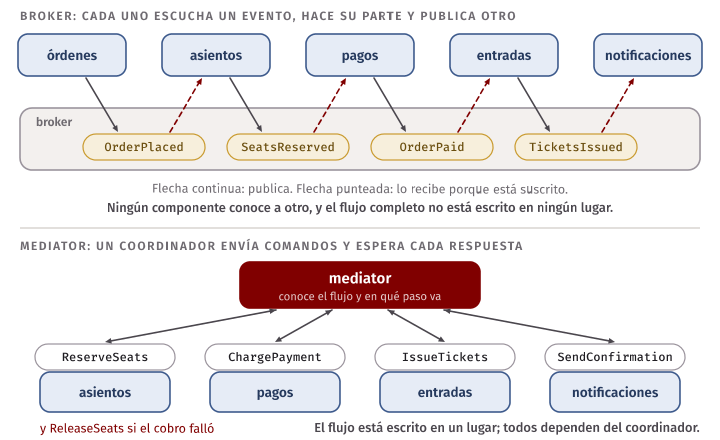
En la topología broker no hay coordinador. Cada componente escucha los eventos que le interesan, hace su parte y publica otro evento, que a su vez escucha el siguiente:
- Órdenes recibe la compra y publica
OrderPlaced. - Asientos escucha
OrderPlaced, reserva y publicaSeatsReserved. - Pagos escucha
SeatsReserved, cobra y publicaOrderPaid. - Entradas escucha
OrderPaid, emite y publicaTicketsIssued. - Notificaciones escucha
TicketsIssuedy envía el correo.
Es una cadena de reacciones. El caso de la semana, con un solo evento y tres consumidores, es la versión más pequeña de esta topología.
Se gana el máximo desacoplamiento: ningún componente conoce a otro, cada uno se despliega y se escala por separado, y agregar un paso que reaccione a un evento existente no toca a nadie.
Se paga con que nadie tiene el flujo completo. El proceso “comprar” no está escrito en ningún lugar: es lo que resulta de cinco suscripciones en cinco servicios. Tres preguntas se vuelven difíciles:
- ¿En qué estado está la compra 4812? Hay que preguntarle a cada servicio, o reconstruirlo a partir de los eventos.
- Falló el cobro: ¿quién libera los asientos? Pagos tiene que publicar
PaymentFailed, y asientos tiene que estar suscrito a ese evento y saber qué hacer. Cada camino de error es otro evento y otra suscripción, y nadie comprueba que estén todos. - ¿Qué pasa si agrego un paso entre cobrar y emitir? Hay que cambiar a qué evento reacciona el que emite: el flujo se modifica tocando a los vecinos.
Mediator
En la topología mediator hay un coordinador que conoce el flujo. Recibe el pedido inicial y va enviando comandos a cada componente, espera su respuesta y decide el siguiente paso:
- El mediator recibe la compra.
- Envía
ReserveSeatsa asientos y esperaSeatsReserved. - Envía
ChargePaymenta pagos y espera el resultado. - Si el cobro falló, envía
ReleaseSeatsa asientos y termina la compra como fallida. - Si salió bien, envía
IssueTicketsa entradas y luegoSendConfirmationa notificaciones.
Fíjense en que el vocabulario cambió: el mediator no publica hechos, da órdenes. Usa comandos.
Se gana control. El flujo está escrito en un lugar, se puede leer, probar y cambiar ahí. El mediator sabe en qué paso va cada compra, así que puede decirlo, puede reanudar un proceso que quedó a medias después de una caída, y puede manejar los errores con la lógica que haga falta (el paso 4).
Se paga con acoplamiento: el mediator conoce a todos los participantes y el orden en que actúan, y cada cambio en el flujo pasa por él. Todo el tráfico del proceso pasa también por él, así que puede volverse un cuello de botella y hay que hacerlo redundante. Y tiene la misma tentación del API gateway: como conoce todo el flujo, es fácil que termine conteniendo la lógica del negocio que debería estar en los servicios.
Cuál elegir
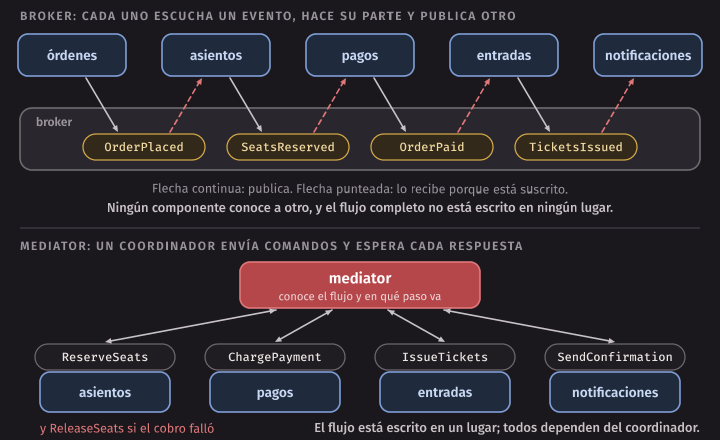
| Broker | Mediator | |
|---|---|---|
| Quién conoce el flujo | Nadie: emerge de las suscripciones | El mediator |
| Mensajes | Eventos | Comandos y sus respuestas |
| Acoplamiento | Mínimo entre componentes | De todos con el mediator |
| Agregar una reacción a un hecho | No toca a nadie | Hay que cambiar el mediator |
| Saber en qué estado quedó un proceso | Difícil | Directo: el mediator lo sabe |
| Manejo de errores y compensación | Repartido en eventos de error | Centralizado |
| Riesgo | Flujos que nadie entiende completos | Un coordinador que lo sabe todo y lo hace todo |
La regla práctica que sale de la tabla: cuando los pasos son reacciones independientes a un hecho (enviar un correo, actualizar un reporte, sumar puntos) y ninguno necesita deshacer a otro, la topología broker da lo que promete a bajo costo. Cuando los pasos forman un proceso que tiene que terminar completo o deshacerse, con un orden y con caminos de error, alguien tiene que saber en qué va, y ese alguien es un mediator.
Para la pregunta de repaso de la guía (un proceso de cinco pasos falla en el tercero): con un mediator es más fácil saber qué pasó y compensar, porque el mediator registró que los pasos 1 y 2 terminaron y sabe qué comandos deshacen cada uno. Lo que se paga es que los cinco servicios dependen ahora de ese coordinador.
El mismo par vuelve en la semana 12 con otros nombres: una saga se puede coordinar por coreografía (como la topología broker) o por orquestación (como la topología mediator).
Trade-off. No hay que elegir una sola topología para todo el sistema. Un diseño frecuente usa un mediator para el proceso central, donde el orden y la compensación importan (reservar, cobrar, emitir), y eventos sin coordinador para todo lo que solo reacciona a que ese proceso terminó (notificar, reportar, sumar puntos).
Los cuatro usos de «event-driven»
“Usamos eventos” puede significar cosas bastante distintas. Martin Fowler cuenta en What do you mean by “Event-Driven”? que, en un taller con sus colegas de Thoughtworks, lo principal que descubrieron fue eso: que cuando la gente habla de “eventos” se refiere a patrones diferentes, y que mezclarlos es la fuente de muchas discusiones inútiles. Distingue cuatro.
1. Notificación de eventos (event notification). Un sistema avisa a otros de que algo cambió en su dominio, y no espera respuesta. El evento puede llevar muy poco: un identificador y poco más. Si el receptor necesita los datos, se los pide al emisor con una llamada. Da poco acoplamiento y es simple de montar. Su riesgo es el que ya vimos: el flujo de conjunto deja de estar escrito en algún programa.
2. Transferencia de estado en el evento (event-carried state transfer). El evento lleva los datos que el receptor necesita, de modo que no tiene que volver a llamar al emisor. El receptor puede incluso guardar su propia copia. Fowler anota lo que se gana: resiliencia (el receptor funciona aunque el emisor esté caído), menos latencia (no hay llamada remota para leer) y menos carga sobre el emisor. Y lo que se paga: los datos quedan copiados en varios lugares y el receptor tiene que mantener ese estado.
El OrderPaid de la semana es de este segundo tipo: lleva al comprador, el
concierto, la cantidad y el total. Por eso los tres consumidores trabajan sin
llamar nunca a órdenes. La alternativa, un OrderPaid con solo el
identificador, habría obligado a cada consumidor a consultar la orden: menos
datos duplicados y un contrato más pequeño, a cambio de una llamada síncrona de
vuelta por cada evento, que es justo el acoplamiento en el tiempo que se quería
evitar.
3. Event sourcing. Cada cambio de estado del sistema se registra como un evento, y el estado actual se puede reconstruir volviendo a procesar esos eventos. El log de eventos pasa a ser la fuente de verdad, y el estado, algo derivado. El ejemplo de Fowler es un sistema de control de versiones: el historial de commits es el log, y la copia de trabajo es el estado.
4. CQRS. Tener estructuras de datos separadas para leer y para escribir. Fowler aclara que, en rigor, CQRS no trata de eventos (se puede usar sin ninguno), aunque en la práctica suele combinarse con los patrones anteriores.
Los dos últimos se estudian en la semana 13. Por ahora basta con no
confundirlos con los dos primeros: publicar OrderPaid para que otros
reaccionen no es event sourcing, y no obliga a nada de lo que event sourcing
exige.
Error común. Decir “event-driven” sin decir cuál de los cuatro. Un equipo que adopta “eventos” pensando en notificaciones y otro que entiende event sourcing están hablando de dos arquitecturas con costos muy distintos. Antes de discutir si conviene, hay que decir cuál.
Cómo se elige un estilo
Con esta semana termina el recorrido por los estilos: capas, modular monolith, pipeline, microkernel, service-based, microservicios y event-driven. Falta la pregunta que importa: dado un sistema, ¿cuál?
No hay un estilo mejor. Cada uno puntúa distinto en cada atributo de calidad, y los atributos que importan dependen del sistema. Lo que sí hay es un procedimiento.
El procedimiento
- Tomar los escenarios (A, A) del utility tree. Son los de alto valor para el negocio y alta dificultad técnica (semana 2). Tres o cuatro. Si no hay escenarios, no hay cómo elegir: se elegiría por gusto.
- Para cada estilo candidato, decir cómo cumple cada escenario, o por qué no. Con una frase concreta, no con una calificación: “se cumple porque el correo sale del camino de la compra”, no “bueno en rendimiento”.
- Sumar el costo. Qué hay que operar, cuántas personas hacen falta, qué sabe hacer el equipo hoy y qué tendría que aprender.
- Elegir, y escribir qué se sacrifica. La elección va con su trade-off a la vista. En la semana 7 eso tomará la forma de un ADR.
Dos precisiones. La primera: un sistema puede usar un estilo distinto en cada parte. La pregunta no es “¿qué estilo es Tinkuy?”, sino “¿qué estilo le conviene a esta parte, para este escenario?”. La segunda: los candidatos se comparan siempre contra la opción de no cambiar nada, que es la más barata y a veces la correcta.
Un ejemplo: los efectos después de la compra
Apliquemos el procedimiento a la parte del sistema que medimos esta semana, con tres escenarios escritos como en la semana 2 (abreviados a estímulo, respuesta y medida):
- E1, rendimiento. Con el proveedor de correo respondiendo en 800 ms, un comprador hace una compra; la compra responde en menos de 300 ms.
- E2, disponibilidad. Con el programa de puntos caído, un comprador hace una compra; la compra se completa, y los puntos se acreditan dentro de los diez minutos siguientes a que el programa vuelva.
- E3, modificabilidad. Se pide un efecto nuevo después de la compra; se agrega sin modificar el módulo de órdenes.
Llamadas síncronas (sync/) |
Eventos con broker (events/) |
|
|---|---|---|
| E1 | No: la mediana fue 810 ms, porque la compra espera al correo | Sí: la mediana fue 2 ms; el correo no está en el camino |
| E2 | No: la compra respondió 500 y los puntos se perdieron | Sí: la compra respondió 201 y los puntos llegaron al volver el consumidor |
| E3 | No: hay que modificar sync/place-order.ts |
Sí: un consumidor nuevo, sin tocar archivos existentes |
| Costo | Ninguno nuevo | Un broker que operar y del que depende la compra; un proceso por consumidor; consistencia eventual; duplicados y orden por resolver; hace falta una forma de saber si los efectos ocurrieron |
Leída deprisa, la tabla dice “eventos”. Leída completa, dice algo más interesante: los eventos cumplen los tres escenarios y traen una fila de costos que la otra columna no tiene. La decisión depende de si esos tres escenarios son de verdad los que importan. Si el proveedor de correo responde siempre en 100 ms, si no existe ningún programa de puntos y si nadie ha pedido efectos nuevos, entonces E1, E2 y E3 son hipotéticos, y la columna de la izquierda, con su costo nulo, gana.
Hay además candidatos que la tabla no incluye y que un buen análisis consideraría. Por ejemplo, responder la compra y ejecutar los efectos después dentro del mismo proceso, sin esperar: cumple E1 y no necesita broker, pero si el proceso se cae o se reinicia en ese instante, los efectos pendientes se pierden sin dejar rastro, así que no cumple E2. O guardar los efectos pendientes en una tabla de la misma base de datos y que un proceso los vaya ejecutando: cumple E1 y E2 sin un broker, y usa la base de datos como cola, con los límites que eso tiene cuando el volumen crece. Cada alternativa es un punto distinto en el mismo trade-off.
En Tinkuy. Con un evento
OrderPaid, las notificaciones, los reportes y un futuro programa de puntos se enteran de la compra sin que órdenes sepa que existen. Que eso le convenga a Tinkuy hoy es la discusión con la que termina el laboratorio, y no tiene una respuesta única: depende de los escenarios que su equipo haya puesto como (A, A) y de si puede operar un broker.
¿El equipo puede operar esto?
Hay una pregunta que descarta más candidatos que cualquier análisis de atributos: ¿el equipo puede operar esto?
Veinte microservicios son veinte despliegues, veinte tableros, veinte cosas que pueden despertar a alguien de madrugada. Lewis y Fowler describen equipos que construyen un servicio y además lo operan, día y noche, y una infraestructura de despliegue automatizado que da eso por supuesto. Esa organización existe en empresas con cientos de ingenieros. Un equipo de cinco personas no la tiene, y no porque le falte talento: no tiene las manos. Si cinco personas mantienen veinte servicios, cada persona atiende cuatro, nadie conoce bien ninguno, y el tiempo que debía ir al producto se va en operar.
La relación entre la forma de un sistema y la forma de la organización que lo construye tiene nombre, ley de Conway, y la veremos en la semana 15. Aquí basta su consecuencia práctica: la arquitectura tiene que caber en el equipo que hay, no en el que se quisiera tener.
Dos errores al elegir
Error común. Usar eventos donde quien llama necesita la respuesta para continuar. Si el comprador tiene que saber ahora si su pago fue aprobado para ver sus entradas, publicar
PaymentRequestedy quedarse esperando unPaymentApprovedno desacopla nada: es una llamada síncrona disfrazada. Se pagan los costos de los dos modelos. Quien llama sigue bloqueado hasta que llegue la respuesta, así que sigue acoplado en el tiempo; y ahora, además, tiene que emparejar cada respuesta con su pedido, decidir cuánto esperar y depurar un flujo que pasa por el broker. La prueba es sencilla: si después de publicar el evento el código se queda esperando otro evento para poder responder, era una llamada.
Error común. Elegir el estilo por la empresa que lo hizo famoso. “Netflix usa microservicios” es verdad, y describe una decisión tomada por una organización muchísimo más grande, con muchos equipos que despliegan a diario, para la que coordinar a toda esa gente sobre una sola base de código era el problema principal. Ese contexto es parte de la decisión. Copiar la arquitectura sin tener el problema es comprar el costo sin el beneficio. La pregunta útil no es “¿qué usan ellos?”, sino “¿qué escenario tenían ellos, y lo tengo yo?”.
El código de la semana
Todo está en code/week-05/ y se usa dentro del contenedor del curso.
| Carpeta o archivo | Qué contiene |
|---|---|
db/schema.sql |
Las tablas: concerts y orders (de órdenes), y una por efecto: emails, sales_report, loyalty_points |
shared/ |
Lo que es igual en las dos versiones: configuración, acceso a la base de datos, el servidor HTTP y la función que guarda la orden |
effects/ |
Los tres efectos, un archivo por efecto. Los usan las dos versiones |
sync/ |
La versión síncrona: place-order.ts y el programa que la sirve |
events/ |
La versión con eventos: place-order.ts, el contrato order-paid.ts, bus.ts (todo lo de NATS) y los tres consumidores en consumers/ |
tools/ |
measure.ts (compra y mide), status.ts (compara las órdenes con los efectos) y tinkuy-email.sh |
network/ |
Los dos programas de Lo que cambia al cruzar la red |
test/ |
Las pruebas, que comprueban lo que afirma este capítulo |
Los comandos:
| Comando | Qué hace |
|---|---|
make |
Crea la base de datos arq_w05 y borra el stream W05_ORDERS |
make sync |
Levanta la versión síncrona en el puerto 3000 |
make events |
Levanta la versión con eventos: órdenes y los tres consumidores, en una terminal |
make buy N=5 |
Hace N compras y mide el tiempo de respuesta de cada una |
make measure N=10 |
Lo mismo, y además espera a que los efectos terminen |
make status |
Compara las órdenes con lo que registró cada efecto |
make info C=points |
El estado de un consumer, con nats consumer info |
make stop C=points |
Detiene un consumidor de make events |
make consumer C=points |
Inicia un consumidor en la terminal actual |
make remote, make lost-reply |
Los ejemplos de la primera sesión |
make tinkuy-email |
Mide la compra del Tinkuy inicial, sobre una copia |
make test |
Revisa los tipos y corre las pruebas |
make clean |
Borra las bases de datos, los streams y build/ |
make sync y make events usan el mismo puerto y la misma base de datos, y
cada uno empieza con datos nuevos: se corre uno a la vez. Las variables
EMAIL_LATENCY_MS y POINTS_FAIL se ponen delante del comando que levanta los
procesos (EMAIL_LATENCY_MS=800 make events), no delante de make buy.
make test no necesita nada corriendo: usa su propia base de datos y su propio
stream, y levanta los servidores y los consumidores dentro del proceso de
pruebas.
$ make test
tsc -p .
W05_DB=arq_w05_test W05_STREAM=W05_TEST_ORDERS W05_SUBJECT=w05test.orders.paid W05_LOG=off \
  REDELIVERY_DELAY_MS=100 node --test --test-concurrency=1 "test/*.test.ts"
✔ la compra responde aunque no haya ningún consumidor, y el evento espera en el stream (68.59775ms)
✔ la compra no espera al correo: responde antes de que el correo termine (516.331209ms)
✔ si un consumidor falla, la compra y los demás consumidores no se enteran, y el mensaje se entrega de nuevo (223.564042ms)
✔ un consumidor detenido no pierde eventos: al volver sigue donde se quedó (73.20075ms)
✔ un consumidor nuevo recibe los eventos publicados antes de que existiera (35.794625ms)
✔ sin idempotencia, un mensaje que se entrega dos veces suma los puntos dos veces (127.48775ms)
✔ el pedido perdido y la respuesta perdida se ven igual desde el cliente, y el servidor quedó distinto (15.937334ms)
✔ un timeout no cancela nada: el cliente se rinde y el servidor cobra igual (158.491834ms)
✔ percentil por rango más cercano (0.43975ms)
✔ cuando la compra responde, los tres efectos ya ocurrieron (38.903625ms)
✔ la compra tarda por lo menos lo que tarda el correo (315.250458ms)
✔ si falla el último efecto, el comprador recibe un 500 y la orden queda pagada, con correo y sin puntos (13.918125ms)
✔ el comprador que reintenta después del 500 queda con dos órdenes pagadas y dos correos (14.72625ms)
ℹ tests 13
ℹ suites 0
ℹ pass 13
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 2453.643585
Cada prueba lleva en el nombre la afirmación del capítulo que comprueba. Vale
la pena leer test/events.test.ts
junto con Lo que la versión con eventos no resuelve: la última prueba de ese
archivo es la demostración de que estos consumidores no toleran duplicados.
Laboratorio: el mismo caso en dos estilos
El laboratorio se hace en parejas, con el material de
code/week-05/. Necesitan dos terminales en el mismo
contenedor: una para el sistema (make sync o make events) y otra para
comprar y mirar. El objetivo no es decidir qué versión es mejor, sino terminar
con una tabla que diga qué cumple cada una y cuánto cuesta.
Paso 1: quién conoce a quién. Lean sync/place-order.ts,
events/place-order.ts y los tres archivos de events/consumers/. Dibujen,
para cada versión, una caja por módulo y una flecha por cada import que
cruza de un módulo a otro. Lo que deben poder responder al terminar: en cada
dibujo, ¿qué cajas se enteran si se borra el programa de puntos?
Paso 2: medir. Corran cada versión y hagan diez compras con
make measure N=10. Anoten la mediana de cada una. Repitan la medición una
vez más sin cambiar nada, para ver cuánto varía sola. Este paso da la línea de
base contra la que se comparan los siguientes.
Paso 3: un paso lento. Repitan con EMAIL_LATENCY_MS=800. Además de la
mediana de la compra, anoten en la versión con eventos cuánto después
terminaron los efectos, y corran make status y make info C=email mientras
el consumidor todavía trabaja. Este paso muestra a dónde va la latencia cuando
sale de la respuesta.
Paso 4: un paso que falla. Repitan con POINTS_FAIL=1 y tres compras
(make buy N=3). En cada versión respondan: ¿qué recibió el comprador?, ¿en
qué estado quedó la compra (make status)?, ¿qué haría el comprador a
continuación, y qué pasaría entonces? En la versión con eventos miren
make info C=points y expliquen cada número de la sección de estado. Luego
detengan el consumidor que falla e inícienlo sin la variable. Este paso
muestra la diferencia entre un error que le llega a quien llamó y un trabajo
que queda pendiente.
Paso 5: un consumidor detenido. Con la versión de eventos, detengan un consumidor, hagan cinco compras e inícienlo de nuevo. Antes de iniciarlo, predigan qué va a pasar y por qué. Este paso muestra qué guarda el stream y qué guarda el consumer durable.
Paso 6: un cuarto efecto. Agreguen a cada versión un efecto que registre cada compra en un archivo de auditoría (una línea por compra). Cuenten, en cada versión, cuántos archivos que ya existían tuvieron que modificar, y cuántos archivos nuevos crearon. Anoten también lo que no es código: en la versión con eventos, ¿qué hay que hacer para que el efecto nuevo esté corriendo? Y una pregunta para la versión síncrona: ¿en qué lugar de la secuencia pusieron la llamada, y qué pasa con la auditoría si falla un efecto anterior?
Paso 7: la tabla. Escriban tres escenarios con sus seis partes, uno de rendimiento, uno de disponibilidad y uno de modificabilidad, con medidas que sus propios números de los pasos 2 a 6 puedan confirmar o refutar. Llenen una tabla con una fila por escenario y una columna por versión: lo cumple o no, y a qué costo. Agreguen una cuarta fila para lo que la versión con eventos hace más difícil: saber si los tres efectos de una compra ya ocurrieron. Para esa fila, piensen qué tuvieron que usar ustedes para saberlo durante el laboratorio.
Paso 8: discusión. Con otra pareja: para Tinkuy, hoy, ¿cuál elegirían? ¿Qué tendría que cambiar (en la carga, en el negocio, en el equipo) para elegir la otra? No hay una respuesta esperada; hay respuestas con escenario y respuestas sin escenario.
Resumen
- Se distribuye un sistema para cumplir un escenario que el monolito no cumple: escalar o desplegar una parte sola, aislar una falla, dejar que varios equipos trabajen sin pisarse, o repartir una carga que no cabe en una máquina. Sin escenario, no hay razón.
- Al cruzar la red, una llamada tarda órdenes de magnitud más, su tiempo se vuelve una distribución, y puede fallar de maneras que quien llama no puede distinguir: “no llegó” y “llegó y la respuesta se perdió” se ven igual. Un timeout no cancela nada.
- Las ocho falacias son los supuestos que en un monolito son verdad y en un sistema distribuido hay que pagar.
- Service-based: pocos servicios grandes, por dominio, normalmente sobre una base de datos compartida. Da despliegue y escalado por partes sin renunciar a las transacciones.
- Microservicios: servicios pequeños, cada uno owner de sus datos, con un
bounded context como límite. Dan independencia entre equipos y cuestan los
JOIN, las transacciones, la operación y la facilidad de mover los límites. - La granularidad sale de dos fuerzas: tasas de cambio, escalado y aislamiento empujan a partir; transacciones, conversaciones frecuentes y datos compartidos empujan a unir.
- El monolito distribuido (tablas compartidas, despliegues atados, cadenas síncronas) tiene los costos de los dos mundos. Partir por sustantivos lo produce casi siempre.
- Un comando pide que algo pase y va dirigido a alguien; un evento dice que algo pasó y no va dirigido a nadie. La diferencia decide quién conoce a quién.
- Event-driven saca el trabajo del camino de la respuesta: en el caso de la semana, la mediana de la compra pasó de 108 ms a 2 ms, y con un correo de 800 ms, de 810 ms a 2 ms. El trabajo no desaparece: llega después.
- Lo que el estilo cobra: consistencia eventual, flujos que no están escritos en ningún lugar, un broker del que todo depende, y tres preguntas (falla a la mitad, duplicados, orden) que el diseño tiene que responder.
- Broker: sin coordinador, muy desacoplado, nadie tiene el flujo. Mediator: un coordinador que envía comandos; se gana control y se paga acoplamiento.
- “Event-driven” puede querer decir notificación, transferencia de estado en el evento, event sourcing o CQRS. Hay que decir cuál.
- Un estilo se elige con escenarios (A, A), diciendo cómo los cumple cada candidato, sumando el costo de operarlo y escribiendo lo que se sacrifica. La pregunta que más descarta es si el equipo lo puede operar.
Ejercicios
-
Corran
make remotetres veces y anoten las tres salidas. ¿Cuál de los dos números, el de la llamada local o el de la remota, varía más entre corridas? ¿Y dentro de una misma corrida, qué relación hay entre la mediana y el p99 de la llamada remota? Expliquen qué consecuencia tiene esa variación para un servicio que hace veinte llamadas remotas para atender un pedido. -
Un servicio de reservas llama a un servicio de pagos con un timeout de dos segundos, y el timeout se cumple. Enumeren todas las cosas distintas que pudieron pasar. Marquen cuáles puede distinguir quien llamó, usando solo lo que recibió. Para las que no puede distinguir, digan qué información adicional necesitaría y de dónde podría sacarla.
-
Modifiquen
network/lost-reply.tspara que el cliente reintente una vez cuando no recibe respuesta. Córranlo con las cuatro fallas y anoten cuántos cobros registra el servidor en cada una. ¿En qué casos el reintento ayudó y en cuáles hizo daño? No lo arreglen: expliquen qué tendría que saber el servidor para que el reintento fuera seguro. -
Elijan tres falacias distintas de las tres que el capítulo ejemplifica con Tinkuy. Para cada una, describan un error de diseño concreto que produciría en un sistema de venta de entradas partido en servicios, y cómo se notaría en producción.
-
Una empresa tiene estos cuatro “microservicios”:
users,orders,seatsypayments. Los cuatro leen y escriben en la misma base de datos; para hacer una compra,ordersllama ausers, luego aseats, luego apayments, y espera cada respuesta; y los cuatro se despliegan juntos cada jueves. (a) ¿Qué señales de monolito distribuido tiene? (b) Si cada servicio tiene 99,9 % de disponibilidad, ¿cuál es la de la compra? Muestren el cálculo. (c) Propongan una división distinta y digan qué transacción queda ahora dentro de un solo servicio. -
Clasifiquen cada mensaje como evento o comando, justifiquen, y para los que estén mal nombrados propongan un nombre mejor:
SendConfirmationEmail,SeatReserved,RefundRequested,ReserveSeat,EmailShouldBeSent,NotifyBuyer,PaymentDeclined. -
En la versión con eventos, con
EMAIL_LATENCY_MS=800, hagan veinte compras conmake measure N=20. Antes de correrlo, calculen cuánto después de la última respuesta deberían terminar los efectos, y comparen con lo medido. Luego respondan sin correr nada: si llegaran dos compras por segundo durante una hora, ¿cuántos mensajes sin procesar tendría el consumeremailal final? ¿Qué dos cambios distintos evitarían que la cola crezca, y qué problema nuevo trae cada uno? -
El consumidor de
events/bus.tsconfirma el mensaje después de aplicar el efecto. Describan paso a paso una ejecución en la que un comprador recibe dos correos por una sola compra, sin que ningún efecto lance un error. Luego describan qué pasaría, en la misma situación, si el consumidor confirmara antes de aplicar el efecto. ¿Cuál de los dos comportamientos prefieren para el correo? ¿Y para los puntos? -
events/bus.tspide los mensajes de uno en uno (max_messages: 1) y el consumer tiene unack_waitde 30 segundos. Supongan que se cambia para pedir 100 mensajes de una vez y procesarlos en orden, con un correo que tarda 800 ms. ¿Qué le pasa al mensaje número 50, y qué ve el comprador? Calculen a partir de qué mensaje empieza el problema. -
Rediseñen en papel el caso de la semana con topología mediator: un coordinador que, después de la compra, se encarga de los tres efectos. Escriban los mensajes que envía, con nombre de comando. Comparen con la versión broker en tres preguntas: ¿quién sabe si los tres efectos de la orden 7 ya ocurrieron?, ¿qué archivos se tocan para agregar un cuarto efecto?, ¿qué pasa si el coordinador se cae a la mitad?
-
El evento
OrderPaidde la semana lleva todos los datos de la orden. Supongan que llevara soloorderId. (a) ¿Qué tendría que hacer cada consumidor, y qué nueva dependencia aparece? (b) ¿Qué pasa con el consumidor de correo si órdenes está caído? (c) Den un caso en que el evento con solo el identificador sea la mejor decisión, y digan por qué. -
Un equipo de seis personas mantiene un sistema de matrícula de una universidad: se usa intensamente dos semanas por semestre y casi nada el resto del tiempo; tiene inscripción en cursos (con cupos), pagos, emisión de constancias y reportes para las facultades. Escriban tres escenarios de calidad que podrían ser (A, A). Elijan dos estilos candidatos, apliquen el procedimiento de Cómo se elige un estilo y decidan. Digan qué sacrifica su elección y qué dato nuevo los haría cambiar de opinión.