Apuntes · Capítulo 6Estilos, tácticas y decisiones
Tácticas: modificabilidad, rendimiento, disponibilidad y seguridad
Tácticas: modificabilidad, rendimiento, disponibilidad y seguridad
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Qué es una táctica, Una decisión que mueve una medida y Táctica, patrón y estilo; de Rendimiento: a dónde se va el tiempo, Tiempo de procesamiento y tiempo bloqueado y El caso de la semana: Qillqa; y de Disponibilidad: que una falta no llegue a ser una falla, Falta, error y falla.
- En clase: Sesión A: Qué es una táctica, Tácticas de modificabilidad, Rendimiento: a dónde se va el tiempo, Las tácticas de rendimiento, El pool de conexiones, N+1: reducir el costo de cada pedido y Cache, primera vista. Sesión B: Disponibilidad: que una falta no llegue a ser una falla, Degradar en vez de caer, El retry: táctica y riesgo, Seguridad y Una táctica para un atributo cuesta otro. Laboratorio: Laboratorio: pool de conexiones y cache, medir antes y después.
- Después de clase: el Resumen y los Ejercicios. Antes de empezar P2 conviene releer Cómo se elige el tamaño y Qué táctica dio más. Opcionales: El cliente que espera en silencio, Los principios de Saltzer y Schroeder y El código de la semana.
Las dos semanas pasadas fueron de estilos: capas, modular monolith, pipeline y microkernel primero; service-based, microservicios y event-driven después. Un estilo es una decisión grande, que da forma a todo el sistema y que se toma pocas veces. Pero la mayor parte de las decisiones de arquitectura son más pequeñas. Tinkuy seguirá siendo un monolito durante varias entregas, y aun así hay que decidir cómo consigue sus conexiones a la base de datos, cuántas consultas hace para armar una lista, qué pasa cuando el servidor de correo no responde y quién puede hablar con la pasarela de pagos.
A esas decisiones más pequeñas se les llama tácticas. En la semana 2 las mencionamos de pasada y dejamos una regla: primero el escenario, después la táctica. Esta semana las estudiamos con orden. Para cada uno de cuatro atributos de calidad (modificabilidad, rendimiento, disponibilidad y seguridad) vemos el catálogo de tácticas que el campo ha ido reuniendo, y aplicamos algunas a un sistema pequeño, midiendo antes y después. Lo segundo importa tanto como lo primero: una táctica que no se midió es una opinión.
El capítulo sigue las dos sesiones. La primera repasa las tácticas de modificabilidad, que ya usaron en las semanas 3 y 4 sin llamarlas así, y dedica casi todo su tiempo al rendimiento, con tres tácticas medidas: un pool de conexiones, quitar un N+1 y una cache. La segunda trata la disponibilidad y la seguridad, y cierra con lo que todas las tácticas tienen en común: lo que se gana en un atributo se paga en otro.
Lectura. Sesión A: Bass, Clements y Kazman, Software Architecture in Practice (4.ª ed.), cap. 8 Modifiability y cap. 9 Performance: en cada uno, el escenario general, el árbol de tácticas y el cuestionario. Complementarias: node-postgres, Pooling; Software Architecture in Practice, cap. 12 Testability y cap. 5 Deployability.
Sesión B: Software Architecture in Practice, cap. 4 Availability y cap. 11 Security: el escenario general, el árbol de tácticas y el cuestionario; Saltzer y Schroeder, The Protection of Information in Computer Systems (1975), la sección de principios de diseño. Complementarias: OWASP Top 10; Site Reliability Engineering, cap. 22, Addressing Cascading Failures. Para el laboratorio: k6, Thresholds, y la documentación de Redis.
El código de este capítulo está en code/week-06/. Todas las salidas que se muestran son de ejecuciones reales en el contenedor del curso, en una laptop con Apple Silicon, dentro de Docker, mientras la máquina atendía otras cargas. Los milisegundos cambian de una máquina a otra y de una corrida a otra; lo que se traslada es la comparación entre dos diseños medidos en la misma máquina, uno después del otro.
Qué es una táctica
Una decisión que mueve una medida
Un escenario de calidad, como los de la semana 2, tiene un estímulo, una respuesta y una medida de la respuesta. Una táctica (tactic) es una decisión de diseño que influye sobre esa respuesta. Nada más: una decisión, y una medida que se mueve.
Tomemos un escenario de Tinkuy:
Cincuenta personas miran el catálogo a la vez (estímulo), en operación normal (entorno).
GET /events(artefacto) responde con la lista de eventos (respuesta), con un p95 menor de 300 ms y sin errores (medida).
Tres decisiones distintas pueden mover ese p95: mantener abiertas las conexiones a la base de datos en vez de abrir una por consulta; obtener la disponibilidad de todos los eventos en una consulta en vez de una por evento; guardar la respuesta durante unos segundos y devolver la copia. Las tres son tácticas de rendimiento. Cada una ataca una causa distinta de la latencia, y cuál conviene depende de cuál sea la causa en este sistema. Por eso el orden de trabajo de toda la semana es el mismo:
- El escenario, con su medida.
- Medir el sistema como está, y encontrar dónde se pierde la medida.
- Elegir la táctica que corresponde a esa causa, mirando también lo que cuesta.
- Medir de nuevo, con el mismo script, en la misma máquina.
Una táctica tiene dos propiedades que la distinguen de las decisiones que vimos hasta ahora.
Apunta a un solo atributo. Un pool de conexiones es una táctica de rendimiento. No fue pensado para la seguridad ni para la modificabilidad. Eso no quiere decir que no los afecte: quiere decir que su efecto sobre los demás atributos no es su propósito, sino su costo o su efecto secundario, y hay que mirarlo aparte. Ese efecto sobre los demás es el trade-off de la táctica.
Es pequeña. No da forma al sistema entero. Se puede aplicar en un módulo y no en otro, y se puede combinar con otras.
Idea clave. Una táctica es una decisión de diseño que influye sobre la respuesta a un estímulo de un atributo de calidad. Su efecto sobre los otros atributos no viene incluido en el nombre: es el trade-off, y hay que buscarlo.
Táctica, patrón y estilo
En la semana 4 distinguimos estilo de patrón. Falta ubicar la táctica.
| Qué es | Tamaño | Ejemplo | |
|---|---|---|---|
| Táctica | Una decisión que influye sobre la respuesta de un atributo | Una decisión | Restringir dependencias; mantener un pool; detectar con un heartbeat |
| Patrón | Una solución con nombre a un problema que se repite, hecha de varias decisiones que se toman juntas | Varias tácticas empaquetadas | Microkernel; réplicas detrás de un load balancer; cache-aside |
| Estilo | La forma del sistema completo: qué elementos hay, cómo se conectan y qué restricciones cumplen | Todo el sistema | Modular monolith; microservicios; event-driven |
La relación entre táctica y patrón se ve bien al desarmar un patrón conocido. El microkernel de la semana 4, con su núcleo y sus plug-ins, junta al menos tres tácticas de modificabilidad: encapsular (cada variante queda detrás de un contrato), usar un intermediario (el registro, que está entre el núcleo y los plug-ins) y diferir el enlace (qué plug-ins existen se decide al arrancar, no al escribir el núcleo). Otro: varias instancias de un servidor detrás de un load balancer con health checks junta una táctica de rendimiento (mantener varias copias del cómputo), una de disponibilidad para detectar (monitor, con ping y eco) y una para prevenir (sacar de servicio a la instancia que no responde).
El segundo ejemplo muestra algo más: un patrón puede servir a varios atributos a la vez, porque empaqueta tácticas de atributos distintos. Una táctica sola, no.
Pensar en tácticas sirve para dos cosas. Para diseñar: cuando ningún patrón conocido calza con el problema, se puede armar una solución a partir de tácticas, sabiendo qué aporta cada una. Y para analizar: frente a un patrón, un framework o un producto, preguntar qué tácticas trae dentro es la forma de saber qué atributos mejora y cuáles no toca. “Usamos Redis” no dice nada sobre la arquitectura; “mantenemos una copia de los datos de lectura, con un TTL de 5 segundos” dice qué se gana y qué se arriesga.
El árbol y el cuestionario
Las tácticas de un atributo no forman una lista plana. Se agrupan según cómo influyen sobre la respuesta, y el resultado es un árbol de dos o tres niveles. El de rendimiento, por ejemplo, tiene dos ramas: las tácticas que reducen el trabajo que llega (controlar la demanda) y las que hacen rendir más lo que se tiene para atenderlo (administrar los recursos). El libro del curso organiza así las tácticas de cada atributo, y este capítulo sigue esos mismos grupos.
El árbol se usa de dos maneras. Al diseñar, se recorre como una lista de opciones: para este escenario, ¿sirve algo de la primera rama?, ¿de la segunda? Obliga a considerar alternativas antes de quedarse con la primera idea. Al revisar un diseño que ya existe, cada táctica se convierte en una pregunta: ¿el sistema hace esto?, ¿dónde?, ¿qué riesgo queda si no lo hace? A esa lista de preguntas se le llama cuestionario de tácticas, y el libro trae uno por atributo. En el laboratorio van a usar uno de seguridad sobre Tinkuy.
Una advertencia sobre los catálogos. Son un inventario de lo que se sabe hacer, no una lista de tareas. Un sistema no es mejor por usar más tácticas: cada una cuesta algo, y la que no responde a un escenario es solo costo.
Tácticas de modificabilidad
El estímulo es un cambio
En modificabilidad el estímulo no es un pedido ni una falla: es un cambio que alguien quiere hacer. La medida, como vimos en la semana 3, es lo que cuesta hacerlo: cuántos módulos hay que tocar, cuánto tiempo toma, cuánto hay que volver a probar y a desplegar.
Las tácticas de modificabilidad ya las conocen. Las semanas 3 y 4 fueron, vistas desde hoy, un recorrido por este árbol sin usar la palabra táctica. Lo que sigue les pone nombre y las ubica en sus tres ramas.
Aumentar la cohesión
Si un módulo tiene varias razones para cambiar, cada cambio lo toca aunque no tenga que ver con el resto de lo que hace.
| Táctica | Qué se hace | Dónde lo vimos |
|---|---|---|
| Dividir un módulo | Un módulo con varias responsabilidades se parte en varios, cada uno con una | La descomposición por decisiones del índice KWIC (semana 3) |
| Redistribuir responsabilidades | Una responsabilidad repartida entre varios módulos se junta en uno, o se mueve al módulo al que pertenece | El paso de carpetas por rol técnico a carpetas por dominio (semana 4) |
Las dos buscan lo mismo desde lados opuestos: que un cambio de negocio caiga dentro de un solo módulo.
Reducir el acoplamiento
Si un módulo sabe mucho de otro, un cambio en uno se propaga al otro.
| Táctica | Qué se hace | Dónde lo vimos |
|---|---|---|
| Encapsular | El módulo se usa solo por una interfaz explícita; lo demás queda oculto | Ocultamiento de información y los index.ts de los módulos (semanas 3 y 4) |
| Usar un intermediario | Entre dos módulos que dependen uno del otro se pone un tercero que rompe la dependencia directa | Los ports y adapters; el registro del microkernel; el broker de la semana 5 |
| Abstraer servicios comunes | Lo que varios módulos hacen de forma parecida se saca a un servicio general que todos usan | Un solo módulo de acceso a la base de datos, o de log, en vez de uno por módulo |
| Restringir dependencias | Se limita quién puede depender de quién, y una herramienta lo comprueba | Las reglas de depcruise; las capas cerradas (semanas 3 y 4) |
Diferir el enlace
La tercera rama es distinta de las otras dos. No reduce lo que hay que cambiar: cambia cuándo se fija una decisión. Enlazar (to bind) un valor es fijarlo. Si el tamaño de un pool está escrito como un número en el código, quedó enlazado al escribir el programa, y cambiarlo exige editar, revisar, probar y desplegar. Si sale de una variable de entorno, queda enlazado al arrancar, y cambiarlo es reiniciar el proceso con otro valor.
| Momento del enlace | Mecanismo | Cambiar el valor exige |
|---|---|---|
| Al escribir el código | Una constante, un import directo |
Editar, revisar, probar y desplegar |
| Al construir o desplegar | Un archivo de configuración que se empaqueta, una opción del build | Volver a construir o a desplegar |
| Al arrancar | Variables de entorno, un registro de plug-ins que se llena al inicio | Reiniciar el proceso |
| En ejecución | Feature flags, descubrimiento de servicios, plug-ins que se cargan en caliente | Nada: el sistema lo toma mientras corre |
El servicio de ejemplo de esta semana usa esta táctica para sus propias
variantes. Cómo consigue las conexiones, cómo arma la lista y si hay cache
se eligen al arrancar, con variables de entorno
(src/variant.ts):
export type Variant = {
  database: string;
  /** connect: una conexión nueva por consulta. pool: un pg.Pool. */
  db: 'connect' | 'pool';
  poolSize: number;
  /** nplus1: una consulta por título. single: una sola consulta con GROUP BY. */
  list: 'nplus1' | 'single';
  cache: 'off' | 'redis';
  cacheTtlSeconds: number;
  /** Qué hacer si Redis no responde: fallar o consultar la base de datos. */
  onCacheError: 'fail' | 'degrade';
  redisUrl: string;
  keyPrefix: string;
};
Gracias a eso, probar un pool de 2, de 10 o de 50 no es un cambio de código:
es POOL_SIZE=50 make serve. Para que el enlace se pudiera diferir hicieron
falta antes las otras dos ramas: la capa de datos está encapsulada detrás
de una interfaz (Db, en src/db.ts) con dos
implementaciones, y el resto del servicio depende solo de la interfaz. Sin
eso no habría un punto donde elegir.
Trade-off. Cuanto más tarde se enlaza, más barato es cada cambio y más cara es la infraestructura que lo permite. Un valor configurable hay que validarlo, documentarlo y probarlo en sus combinaciones: este servicio tiene combinaciones de sus cuatro opciones, sin contar los tamaños del pool, y las pruebas de la semana levantan siete para comprobar que responden lo mismo. Un sistema con cien opciones tiene más configuraciones posibles de las que nadie va a probar. La alternativa, enlazar temprano, es la correcta para todo lo que no hay evidencia de que vaya a cambiar.
Hay dos atributos emparentados con la modificabilidad que el libro trata en capítulos propios y que aquí solo ubicamos. La capacidad de prueba (testability) pide poder controlar y observar un componente: los ports de la semana 3, que permitían probar el núcleo sin base de datos, son una táctica de ese atributo. La facilidad de despliegue (deployability) pide que un cambio llegue a producción rápido y con poco riesgo; la semana 15 la toca de cerca, al sacar un servicio de un monolito poco a poco.
Rendimiento: a dónde se va el tiempo
El estímulo y la medida
En rendimiento el estímulo es la llegada de eventos: pedidos de usuarios, mensajes de otros sistemas, un temporizador que se dispara. (Aquí evento es algo que llega y hay que atender, no un concierto de Tinkuy.) Importa cómo llegan, porque el diseño cambia según el patrón:
- Periódica: a intervalos regulares. Un proceso que recalcula un reporte cada minuto.
- Esporádica o estocástica: sin un ritmo fijo, pero con una tasa promedio que se puede estimar. La gente que mira el catálogo un martes por la tarde.
- En ráfaga: muchos en muy poco tiempo y después casi nada. La apertura de ventas de un concierto, a las 10:00:00.
La respuesta se mide con lo que vimos en la semana 2: latencia (con percentiles), throughput (pedidos atendidos por segundo) y, cuando la demanda supera a la capacidad, la tasa de pedidos perdidos: los que se rechazaron, vencieron o nunca se atendieron.
Tiempo de procesamiento y tiempo bloqueado
Para elegir una táctica hay que saber en qué se gasta el tiempo de un pedido. La división que más sirve es en dos partes:
El tiempo de procesamiento es el que el sistema pasa trabajando para ese pedido: ejecutando código, corriendo una consulta. El tiempo bloqueado es el que el pedido pasa esperando sin que nadie trabaje para él: en una cola, esperando un recurso que otro está usando (una conexión, un lock, un procesador libre) o esperando la respuesta de otro componente.
La división importa porque cada parte se ataca con tácticas distintas, y equivocarse de parte no sirve de nada. Un ejemplo, que es la segunda pregunta de repaso de la guía: un pedido tarda 400 ms, de los cuales 30 ms son de procesamiento y 370 ms son de espera por una conexión a la base de datos. Hacer el código el doble de rápido ahorra 15 ms de 400. Agregar servidores de aplicación no ahorra nada: los servidores nuevos van a hacer la misma cola por las mismas conexiones, y si cada uno abre las suyas, la base de datos queda peor que antes. Lo que hay que atacar es la espera, y eso es administrar ese recurso.
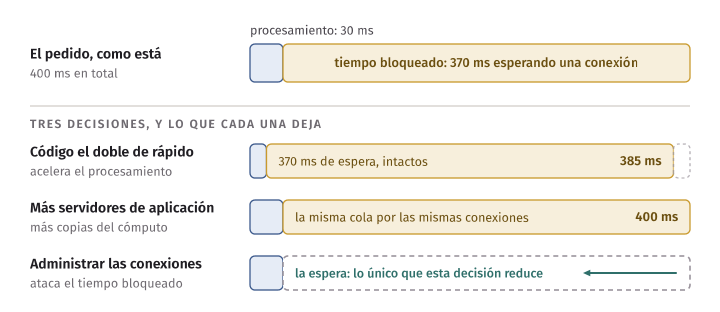
Idea clave. Primero se mide dónde se va el tiempo; después se elige la táctica. Si el tiempo se va en esperar, las tácticas que aceleran el procesamiento no mueven la medida.
El caso de la semana: Qillqa
Para practicar sin tocar Tinkuy usamos un servicio pequeño, en
code/week-06/: Qillqa (escritura, en quechua), el
catálogo de una red de bibliotecas. Tiene tres tablas
(db/schema.sql): las sedes (branches),
los títulos (titles) y los ejemplares de cada título (copies), cada uno
disponible o prestado. make crea la base de datos:
$ make
Base de datos arq_w06: 4 sedes, 31 títulos, 11605 ejemplares (8700 disponibles)
Y tiene cuatro endpoints:
| Método y ruta | Qué hace |
|---|---|
GET /titles?city= |
La lista de títulos, con los ejemplares disponibles de cada uno. Filtro opcional por ciudad |
GET /titles/:id |
Un título, con sus ejemplares disponibles |
POST /titles/:id/loans |
Presta un ejemplar disponible del título |
GET /stats |
Contadores internos: consultas y conexiones a PostgreSQL, aciertos de la cache |
El parecido con Tinkuy es a propósito. La lista de títulos con sus ejemplares disponibles tiene la misma forma que la lista de eventos con sus asientos libres, y la primera versión de Qillqa la resuelve igual que el Tinkuy inicial. El escenario que vamos a perseguir:
Cincuenta personas consultan el catálogo a la vez (estímulo), en operación normal (entorno).
GET /titles(artefacto) responde con la lista completa (respuesta), con un p95 menor de 100 ms y sin errores (medida).
El script de carga es load/titles.js: 50
usuarios virtuales piden la lista durante 15 segundos, con una pausa de
50 ms entre un pedido y el siguiente. El script no cambia en toda la semana;
lo que cambia es el servicio. Con esas pausas, 50 usuarios no pueden hacer
más de 1 000 pedidos por segundo entre todos, así que el throughput de las
tablas tiene ese techo: es un generador de modelo cerrado, como los de la
semana 2.
Con el servicio en su línea de base (make serve en una terminal y
make load en otra):
$ make load
k6 run --quiet load/titles.js
…
    ✓ GET /titles responde 200

    HTTP
    http_req_duration..............: avg=561.91ms med=561.11ms p(95)=629.29ms p(99)=668.46ms max=706.68ms
      { expected_response:true }...: avg=561.91ms med=561.11ms p(95)=629.29ms p(99)=668.46ms max=706.68ms
    http_req_failed................: 0.00%  0 out of 1240
    http_reqs......................: 1240   80.804375/s
…
La mediana es de 561 ms y el p95 de 629 ms, con 81 pedidos por segundo. El escenario pide un p95 menor de 100 ms: el servicio lo incumple por un factor de seis. No hay errores; simplemente es lento. (El resumen de k6 trae más líneas; aquí y en adelante mostramos las que usamos.)
Dónde se pierde
La tentación, con un endpoint lento que consulta una base de datos, es suponer que la consulta es lenta y ponerle un índice o una cache. Antes de suponer, se mira. Primero, la consulta que cuenta los ejemplares de un título:
$ psql -d arq_w06 -c "EXPLAIN (ANALYZE, BUFFERS OFF) SELECT count(*)::int AS available FROM copies WHERE title_id = 1 AND status = 'available'"
                                                              QUERY PLAN
---------------------------------------------------------------------------------------------------------------------------------------
 Aggregate  (cost=14.47..14.48 rows=1 width=4) (actual time=0.036..0.036 rows=1.00 loops=1)
   ->  Index Scan using copies_title_idx on copies  (cost=0.29..14.03 rows=178 width=0) (actual time=0.009..0.029 rows=178.00 loops=1)
         Index Cond: (title_id = 1)
         Filter: (status = 'available'::text)
         Rows Removed by Filter: 59
         Index Searches: 1
 Planning Time: 0.188 ms
 Execution Time: 0.063 ms
(8 rows)
Seis centésimas de milisegundo. La consulta usa el índice, lee los 237 ejemplares del título y descarta los 59 prestados. No hay nada que arreglar ahí: la consulta, sola, es cuatro órdenes de magnitud más rápida que el pedido que la usa.
Segundo, cuántas veces se ejecuta. El servicio lleva la cuenta en
GET /stats. Después de un solo pedido a GET /titles:
$ curl -s localhost:3600/titles > /dev/null; curl -s localhost:3600/stats | jq .db
{
  "queries": 32,
  "connectionsOpened": 32
}
Treinta y dos consultas y treinta y dos conexiones nuevas para un pedido.
El código que lo explica está en dos archivos. La lista
(src/titles.ts) pide los títulos y
después, uno por uno, cuenta sus ejemplares:
export async function listTitlesNPlusOne(db: Db, filter: TitleFilter = {}): Promise<TitleSummary[]> {
  const rows = await db.query<TitleRow>(
    `SELECT t.id, t.name, t.author, t.year, b.name AS branch_name, b.city AS branch_city
       FROM titles t
       JOIN branches b ON b.id = t.branch_id
      WHERE ($1::text IS NULL OR b.city = $1)
      ORDER BY t.name, t.id`,
    [filter.city ?? null],
  );
  const titles: TitleSummary[] = [];
  for (const row of rows) {
    titles.push(toSummary(row, await countAvailableCopies(db, row.id)));
  }
  return titles;
}
Y la capa de datos (src/db.ts) abre una
conexión para cada consulta y la cierra al terminar:
    async query<Row extends pg.QueryResultRow>(text: string, params: unknown[] = []): Promise<Row[]> {
      const client = new pg.Client({ database, application_name: APPLICATION_NAME });
      await client.connect();
      counters.connectionsOpened += 1;
      try {
        counters.queries += 1;
        const result = await client.query<Row>(text, params);
        return result.rows;
      } finally {
        await client.end();
      }
    },
Hay entonces dos causas distintas, y conviene no mezclarlas:
- Cada consulta paga una conexión nueva. Es un problema de cómo se administra un recurso.
- El pedido hace 32 consultas donde bastaría una. Es un problema de cuánto trabajo pide cada pedido.
A cada causa le corresponde una táctica de una rama distinta del árbol. Antes de aplicarlas, el catálogo completo.
En Tinkuy. El Tinkuy inicial tiene las dos mismas causas:
src/db.tsabre una conexión por consulta, ylistEventshace unCOUNTpor evento. Con una copia de Tinkuy levantada (make tinkuy-up),make tinkuy-endpointssepara la latencia por endpoint, en la misma máquina:$ make tinkuy-endpoints … http_req_duration..................: avg=45.69ms med=15.64ms p(95)=188.18ms p(99)=262.15ms max=317.69ms { name:GET /events }.............: avg=165.55ms med=163.49ms p(95)=262.34ms p(99)=304.39ms max=317.69ms { name:GET /events/:id }.........: avg=17.57ms med=14.31ms p(95)=35.41ms p(99)=68.03ms max=98.78ms { name:GET /events/:id/seats }...: avg=20.16ms med=17.84ms p(95)=34.49ms p(99)=58.94ms max=67ms { name:GET /orders/:id }.........: avg=12.29ms med=11.5ms p(95)=20.32ms p(99)=25.6ms max=30.18ms { name:GET /reports/sales }......: avg=12.9ms med=10.59ms p(95)=24.68ms p(99)=30.4ms max=49.29ms http_req_failed....................: 0.00% 0 out of 1270 http_reqs..........................: 1270 78.735356/s
GET /eventses varias veces más lento que cualquier otro, igual que en la semana 2. Ymake tinkuy-explainmuestra que su consulta de disponibilidad, sola, es rápida:$ make tinkuy-explain … Aggregate (cost=76.52..76.53 rows=1 width=4) (actual time=0.261..0.262 rows=1.00 loops=1) -> Bitmap Heap Scan on seats (cost=4.55..76.52 rows=1 width=0) (actual time=0.039..0.199 rows=2000.00 loops=1) … Execution Time: 0.292 msDurante
make load-browse(hasta 50 usuarios virtuales), mirandopg_stat_activityvarias veces por segundo, PostgreSQL llegó a tener entre 5 y 15 conexiones de Tinkuy abiertas a la vez, según la corrida (y más de 20 con la máquina ocupada). Ninguna dura más que una consulta. Con la carga demake load-sale, de 200 usuarios, se pasan de las 100 que PostgreSQL acepta, como vieron en la semana 2.
Error común. Optimizar sin medir. Quien hubiera empezado por “la consulta debe estar lenta” habría agregado un índice a una consulta que tarda menos de un milisegundo, y el p95 no se habría movido. La táctica correcta para un cuello de botella que no es el que limita no cambia nada, y además deja la sensación de que “ya se optimizó”.
Las tácticas de rendimiento
Controlar la demanda
La primera rama reduce el trabajo: que lleguen menos pedidos, o que cada uno cueste menos.
| Táctica | Qué se hace | Qué cuesta |
|---|---|---|
| Limitar la tasa de llegada | No se aceptan más pedidos por segundo de los que se pueden atender (rate limiting); el resto recibe un rechazo rápido | Algunos usuarios reciben un error. Hay que decidir a quién se rechaza |
| Limitar la respuesta a eventos | Los pedidos que no se pueden atender ya esperan en una cola de tamaño máximo; con la cola llena, se descartan o se rechazan | Latencia para los que esperan y pérdida para los que no entran |
| Priorizar | Cuando no alcanza para todos, se atiende primero lo que más importa: la compra antes que el reporte | Lo de baja prioridad puede no atenderse nunca |
| Reducir el costo de cada pedido | Un algoritmo mejor, menos idas y vueltas a la base de datos, menos datos en la respuesta | Suele costar claridad: la versión eficiente es menos directa que la ingenua |
| Acotar el tiempo de ejecución | Un pedido que pasa de su límite se corta y devuelve lo que tenga, o un error | Respuestas incompletas o fallidas para los pedidos caros |
Las tres primeras y la última aceptan no atender del todo a alguien para proteger al resto. Son las tácticas de una apertura de ventas, y vuelven en la semana 14 con el nombre de load shedding. La cuarta es la única que no le quita nada a nadie, y por eso conviene mirarla primero.
Administrar los recursos
La segunda rama deja la demanda como está y hace rendir más lo que se tiene para atenderla.
| Táctica | Qué se hace | Qué cuesta |
|---|---|---|
| Aumentar los recursos | Una máquina más grande (escalar hacia arriba) o más máquinas (escalar hacia los lados) | Dinero. Y hacia los lados, todo lo de la semana 5 |
| Introducir concurrencia | Atender varios pedidos a la vez en vez de uno tras otro | Los errores de concurrencia: dos pedidos sobre el mismo dato |
| Mantener varias copias del cómputo | Varias instancias del servicio detrás de un load balancer | El estado que estaba en la memoria de un proceso ya no sirve; hay que sacarlo |
| Mantener varias copias de los datos | Una cache, o réplicas de lectura de la base de datos | Las copias pueden no coincidir con el original: datos viejos, invalidación |
| Acotar el tamaño de las colas | Toda cola tiene un máximo: de pedidos, de mensajes, de espera por una conexión | Con la cola llena hay que rechazar; sin tope, la espera crece sin límite |
| Planificar el uso de un recurso | Cuando varios compiten por un recurso escaso, una política decide el orden: por llegada, por prioridad, por plazo | La política que favorece a unos demora a otros |
Un pool de conexiones no aparece con ese nombre en ninguna de las dos tablas, porque no es una táctica: es un mecanismo pequeño que aplica varias. Reutilizar las conexiones reduce el costo de cada pedido. Tener un número fijo de ellas acota cuánto trabajo recibe la base de datos a la vez. Y la cola de los que esperan una conexión libre planifica un recurso escaso, por orden de llegada. Vale la pena desarmarlo así, porque cada una de esas tres cosas se puede medir por separado.
El pool de conexiones
Lo que cuesta una conexión
Abrir una conexión a PostgreSQL no es gratis. Hay una negociación entre el cliente y el servidor (versión del protocolo, autenticación, parámetros de la sesión; cifrado, si la conexión va por la red), y PostgreSQL crea un proceso del sistema operativo para atender a cada cliente. La documentación de node-postgres, en la lectura complementaria de esta sesión, estima entre 20 y 30 ms para una conexión por la red con contraseña y cifrado, y advierte de lo segundo: el servidor solo puede atender a un número limitado de clientes a la vez.
En el contenedor del curso la conexión es de las más baratas posibles: va
por un socket local, sin contraseña y sin cifrado. Aun así,
make connect-cost muestra la diferencia entre abrir una conexión para cada
consulta y usar una que ya estaba abierta
(tools/connect-cost.ts):
$ make connect-cost
200 consultas, una después de otra (host: /var/run/postgresql)
conectar + consulta + cerrar           p50   2.18 ms   p95   2.87 ms
consulta sobre una conexión abierta    p50   0.13 ms   p95   0.18 ms
razón entre las medianas: 16.6
La consulta sola tarda 0,13 ms. Con la conexión, 2,18 ms: unas diecisiete
veces más. En otras corridas la razón estuvo entre 14 y 43, según cuán
ocupada estaba la máquina, pero nunca cerca de 1. Para una consulta corta,
casi todo lo que el servicio paga es la conexión. Y un pedido a GET /titles
paga 32.
Esa medición es con una consulta detrás de otra. Cuando llegan cincuenta a la vez es peor, porque el servidor tiene que crear y destruir decenas de procesos por segundo mientras intenta, además, responder consultas.
Reutilizar y poner un tope
Un pool de conexiones es un conjunto de conexiones que se abren una vez
y se quedan abiertas. Quien necesita hacer una consulta toma una conexión
libre, la usa y la devuelve. Si todas están ocupadas, espera su turno. La
segunda implementación de la capa de datos de Qillqa usa el pool que trae el
paquete pg:
export function pooled(database: string, size: number): Db {
  const counters: DbCounters = { queries: 0, connectionsOpened: 0 };
  const pool = new pg.Pool({ database, max: size, application_name: APPLICATION_NAME });
  pool.on('connect', () => {
    counters.connectionsOpened += 1;
  });
  // Una conexión ociosa que se rompe no debe tumbar el proceso.
  pool.on('error', () => {});
  return {
    counters,
    async query<Row extends pg.QueryResultRow>(text: string, params: unknown[] = []): Promise<Row[]> {
      counters.queries += 1;
      const result = await pool.query<Row>(text, params);
      return result.rows;
    },
    async close(): Promise<void> {
      await pool.end();
    },
  };
}
pool.query hace las tres cosas: toma una conexión, ejecuta la consulta y
la devuelve. El pool.end() de close también importa: un programa que no
cierra su pool no termina.
Como la capa de datos está detrás de la interfaz Db, cambiar de una
implementación a otra no toca ni una consulta. Con el mismo script y la
misma carga, make measure levanta cada variante, la mide y escribe una
fila:
$ make measure V="baseline pool-10"
k6: 50 usuarios virtuales durante 15s, GET /titles
variante                                        p50        p95        máx  pedidos   errores conexiones consultas
Sin pool, N+1 (línea de base)              571.4 ms   721.2 ms   985.7 ms     78/s    0.00 %         34      32.0
Pool de 10, N+1                             23.5 ms    43.3 ms    78.7 ms    664/s    0.00 %         10      32.0
conexiones: el máximo que el servicio tuvo abiertas a la vez en PostgreSQL
consultas: consultas a PostgreSQL por pedido HTTP, en promedio
Con las mismas 32 consultas por pedido, la mediana baja de 571 ms a 24 ms y el p95 de 721 ms a 43 ms: el escenario ya se cumple. El throughput sube de 78 a 664 pedidos por segundo, porque en este script cada usuario virtual espera su respuesta antes de pedir otra vez. La columna de consultas confirma que lo único que cambió es de dónde salen las conexiones.
Una advertencia que vale para todas las tablas del capítulo: cada bloque es una corrida distinta, y la misma variante no da el mismo número dos veces. El pool de 10 con N+1, por ejemplo, tiene una mediana de 24 ms en esta tabla y aparece más abajo con 9 ms y con 31 ms. Por eso se comparan filas de un mismo bloque, medidas una detrás de otra, y solo se sacan conclusiones de diferencias grandes: la de esta tabla es de más de veinte veces, y en ninguna corrida bajó de diez.
La columna de conexiones muestra el segundo efecto del pool, que es
independiente del primero: es un tope. Con max: 10, PostgreSQL nunca
ve más de diez conexiones de este servicio, lleguen cincuenta pedidos a la
vez o lleguen cinco mil. La prueba
test/pool.test.ts lo comprueba con un
pool de 2 y 40 pedidos simultáneos: se atienden los 40, con 2 conexiones.
El tope se aprecia cuando la carga sube. PostgreSQL acepta un máximo de
conexiones (max_connections, 100 en el contenedor), y sin pool nada impide
pedirle más. Con 200 usuarios virtuales en vez de 50:
$ VUS=200 make measure V="baseline pool-10"
k6: 200 usuarios virtuales durante 15s, GET /titles
variante                                        p50        p95        máx  pedidos   errores conexiones consultas
Sin pool, N+1 (línea de base)              325.5 ms  1589.2 ms  3039.7 ms    351/s   97.76 %         98       6.0
Pool de 10, N+1                            107.1 ms   133.5 ms   201.9 ms   1256/s    0.00 %         10      32.0
conexiones: el máximo que el servicio tuvo abiertas a la vez en PostgreSQL
consultas: consultas a PostgreSQL por pedido HTTP, en promedio
Sin pool, el 98 % de los pedidos falla. El servicio intenta abrir más
conexiones de las que PostgreSQL acepta (llegó a tener 98 a la vez), y el
resto recibe sorry, too many clients already. Las 6,0 consultas por pedido
son el promedio de unos pocos pedidos que completaron sus 32 y muchos que
murieron en el camino. Y no falla solo este servicio: cualquier otro
programa que quiera conectarse a esa base de datos en ese momento recibe el
mismo rechazo.
Con el pool, los mismos 200 usuarios se atienden con diez conexiones y sin un solo error. Son más lentos que con 50 usuarios, porque ahora hay cola, pero todos reciben su respuesta.
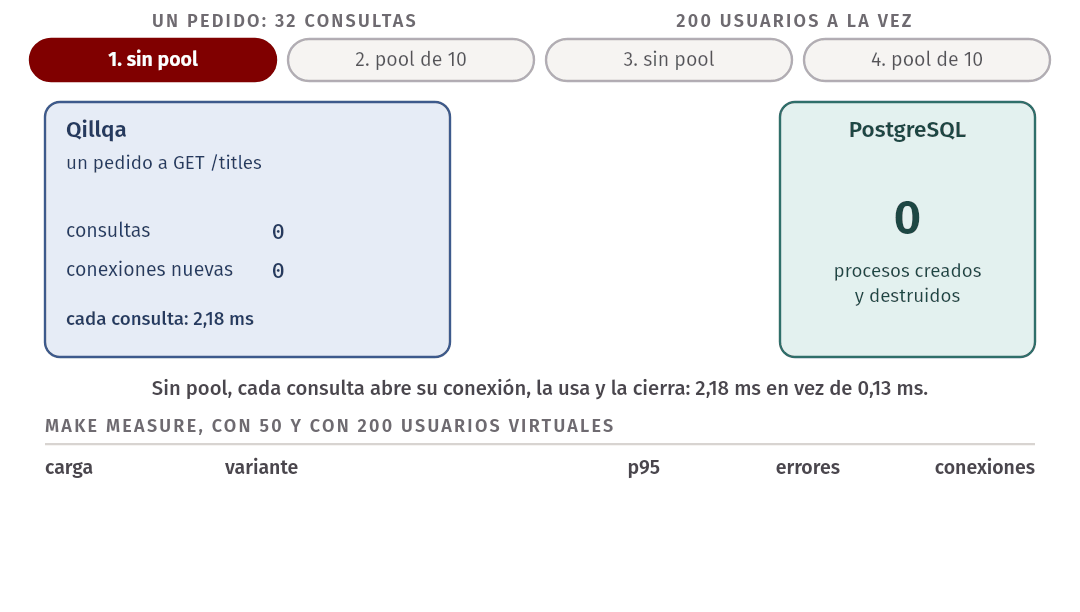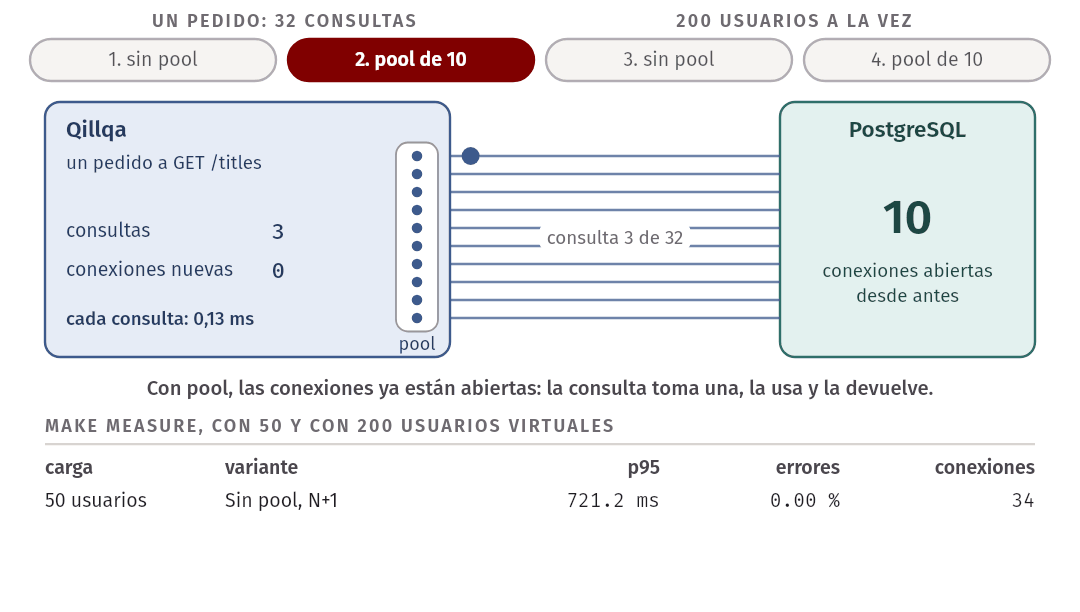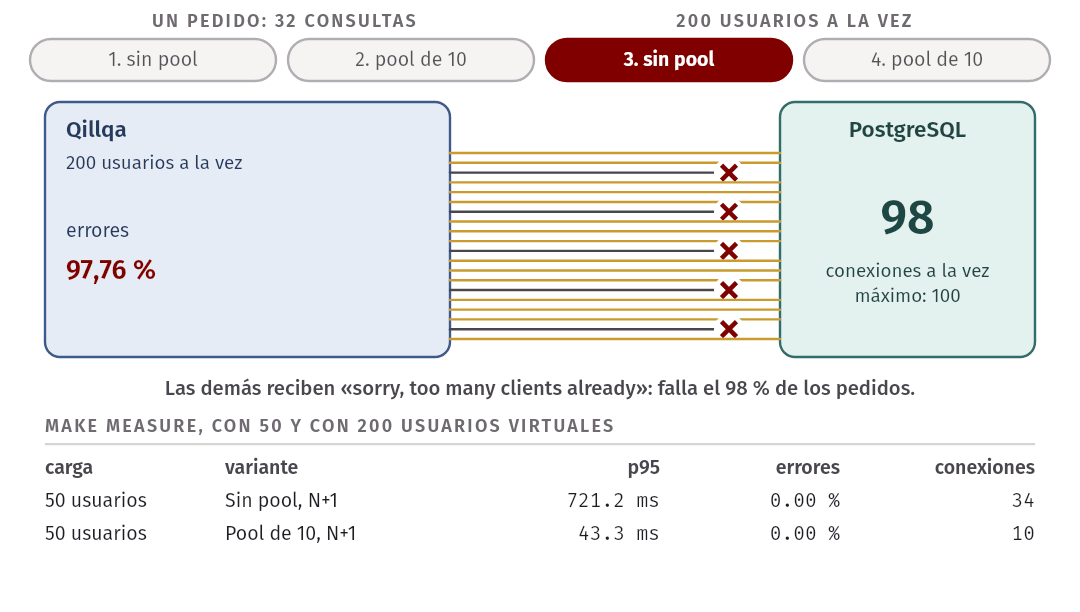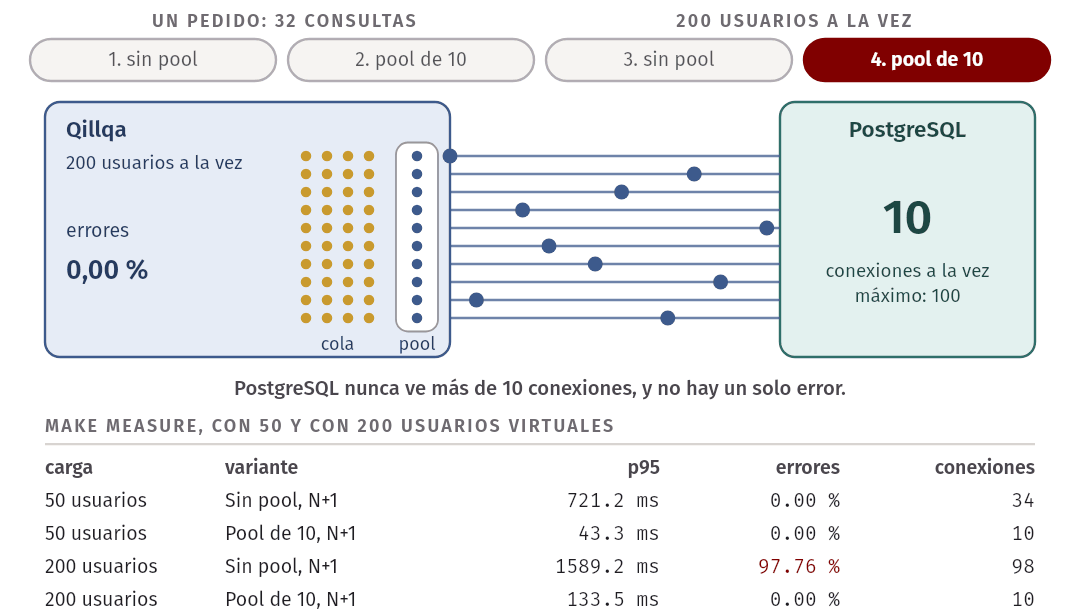
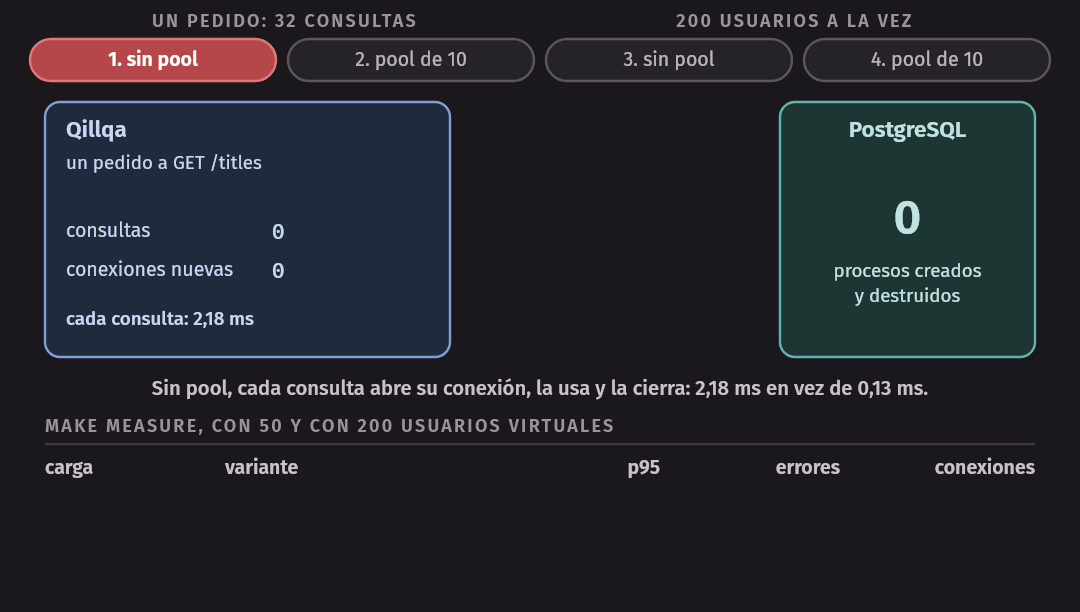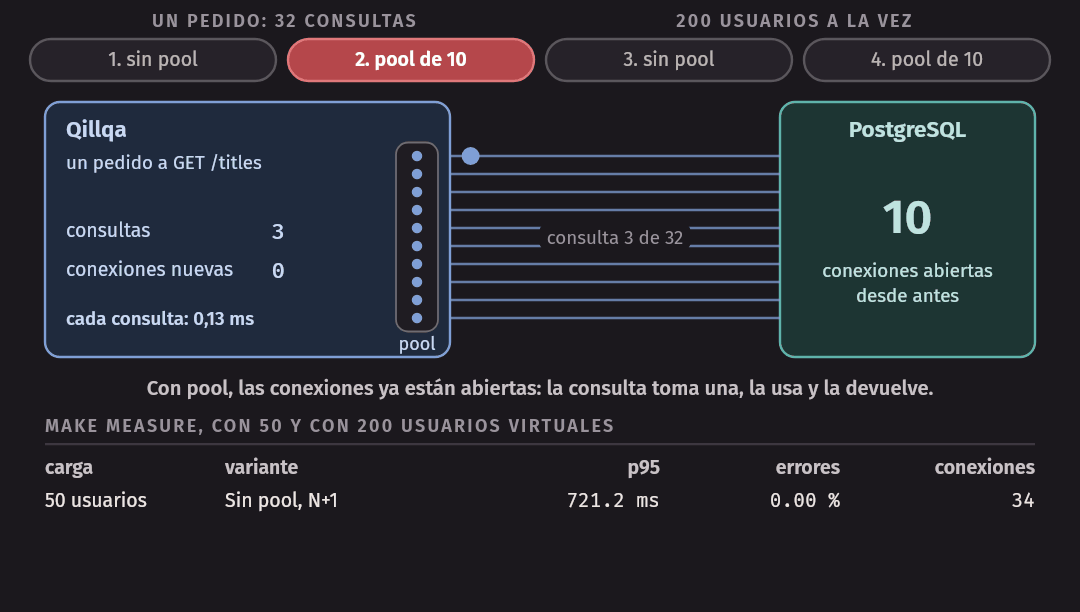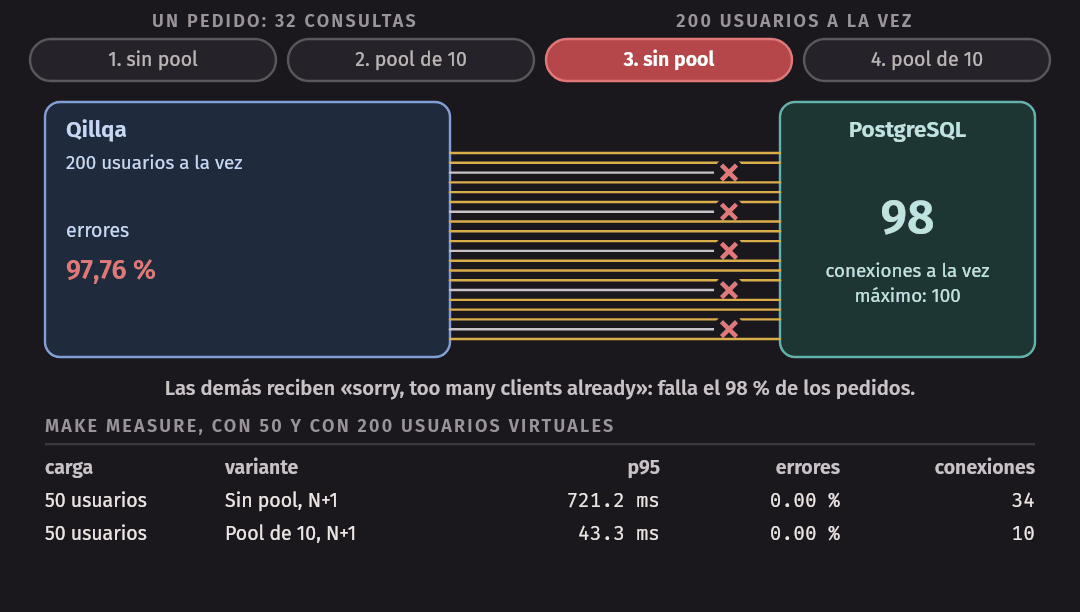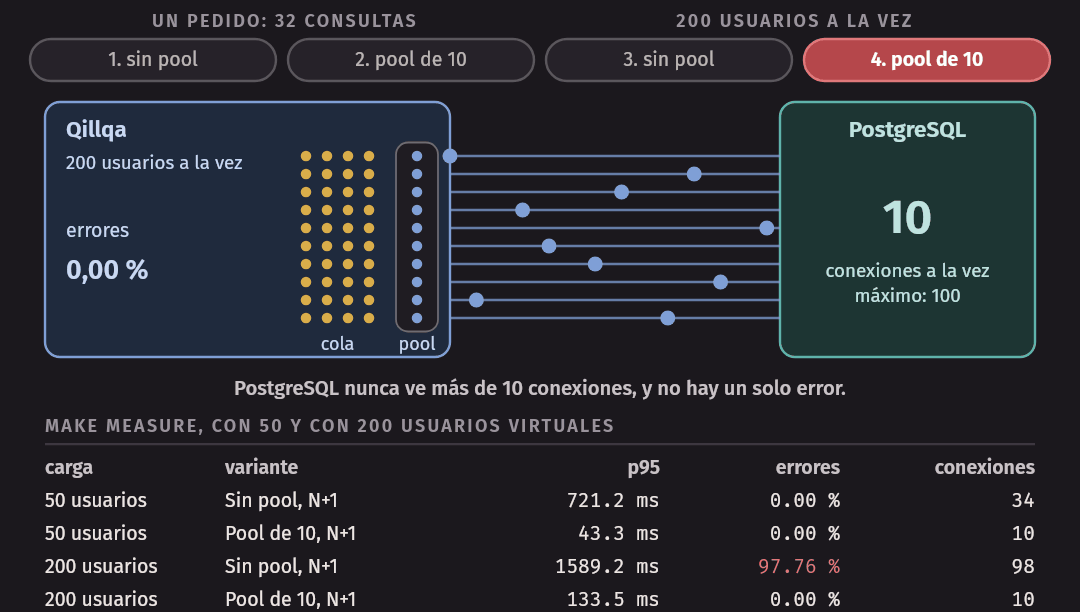
Idea clave. Un pool hace dos cosas distintas: ahorra el costo de abrir una conexión en cada consulta, y limita cuántas consultas recibe la base de datos a la vez. Lo primero mejora la latencia; lo segundo protege a la base de datos de su propia aplicación.
Cómo se elige el tamaño
Si diez conexiones son mejores que ninguna, ¿cincuenta serán mejores que
diez? make curve mide el servicio con 200 usuarios virtuales y pools de
seis tamaños:
$ make curve
k6: 200 usuarios virtuales durante 15s, GET /titles
variante                                        p50        p95        máx  pedidos   errores conexiones consultas
Sin pool, N+1 (línea de base)              424.9 ms  1996.1 ms  4761.2 ms    273/s   97.35 %         95       5.8
Pool de 2, N+1                             343.4 ms   388.8 ms   444.0 ms    502/s    0.00 %          2      32.0
Pool de 5, N+1                             156.1 ms   231.2 ms   288.2 ms    937/s    0.00 %          5      32.0
Pool de 10, N+1                             79.2 ms   151.6 ms   248.7 ms   1457/s    0.00 %         10      32.0
Pool de 20, N+1                             75.2 ms   107.5 ms   195.6 ms   1559/s    0.00 %         20      32.0
Pool de 50, N+1                             84.4 ms   130.3 ms   322.5 ms   1422/s    0.00 %         50      32.0
Pool de 90, N+1                             98.4 ms   135.8 ms   501.5 ms   1296/s    0.00 %         90      32.0
conexiones: el máximo que el servicio tuvo abiertas a la vez en PostgreSQL
consultas: consultas a PostgreSQL por pedido HTTP, en promedio
De 2 a 10 conexiones la mejora es grande: la mediana baja de 343 ms a 79 ms y el throughput casi se triplica. De 10 a 20 mejora poco. Y de ahí en adelante empeora: con 90 conexiones el servicio atiende 1 296 pedidos por segundo, un 17 % menos que con 20, y su peor pedido tarda más del doble (502 ms contra 196 ms). Graficado, el p95 contra el tamaño del pool tiene forma de U: alto a la izquierda, un mínimo en el medio, y otra vez hacia arriba.
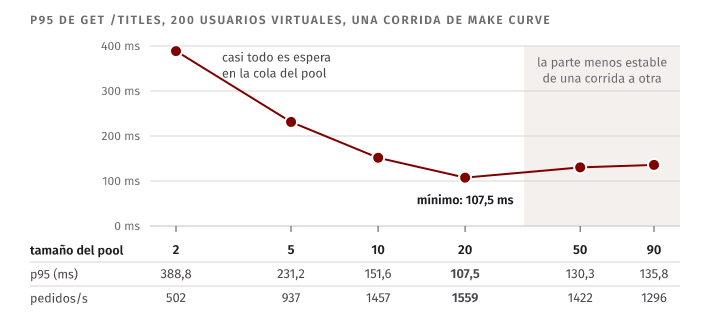
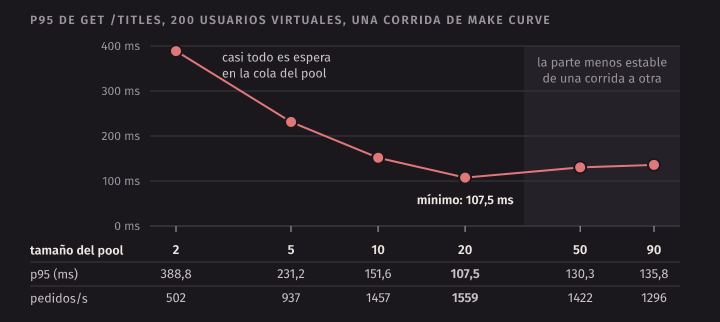
Repetimos esta curva cuatro veces. En tres, los pools de 50 y de 90 salieron peores que el de 20; en una de esas tres, con la máquina ocupada por otras cargas, el de 90 fue ocho veces más lento. En la cuarta, los tres salieron parecidos. La parte derecha de la curva es la menos estable de la tabla, y la conclusión prudente es la que sostienen las cuatro corridas: más allá de cierto tamaño, más conexiones no dan más rendimiento, y con frecuencia dan menos.
Para ver por qué, conviene sacar del medio al servidor HTTP y preguntarle
directamente a la base de datos. make db-curve lanza la misma consulta,
una que recorre toda la tabla de ejemplares, con 1, 2, 4… 64 conexiones
trabajando a la vez durante dos segundos
(tools/db-curve.ts):
$ make db-curve
Procesadores que ve el contenedor: 14
conexiones  consultas/s  p50 por consulta  p95 por consulta
         1          781           1.25 ms           1.38 ms
         2         1534           1.28 ms           1.42 ms
         4         3020           1.29 ms           1.50 ms
         8         4178           1.91 ms           2.22 ms
        16         5095           2.62 ms           6.08 ms
        32         5035           5.80 ms          12.24 ms
        64         5201          11.06 ms          25.01 ms
Hasta 4 conexiones, el doble de conexiones es el doble de consultas por
segundo, y cada consulta tarda lo mismo. Hacia 16, el total deja de subir:
ronda las 5 000 consultas por segundo con 16, con 32 y con 64. Lo que sí
sigue creciendo es lo que tarda cada consulta: 2,6 ms con 16 conexiones y
11 ms con 64. Cuatro veces más conexiones, el mismo trabajo total, y cada
consulta cuatro veces más lenta. (El límite no es del programa que mide: el
mismo programa, con un SELECT 1, pasa de 40 000 consultas por segundo.)
La explicación es de recursos. Una consulta necesita un procesador (y a veces el disco) mientras se ejecuta. Si la máquina de la base de datos tiene procesadores, no puede ejecutar más de consultas de este tipo a la vez. La conexión número no agrega capacidad: agrega un competidor. El sistema operativo reparte los procesadores entre todos, cada consulta avanza a ratos, y todas tardan más. Además, cada conexión abierta cuesta memoria en el servidor aunque no esté haciendo nada.
Entonces, cuando hay más pedidos que capacidad, alguien tiene que esperar, y la decisión de diseño es dónde. Con un pool pequeño esperan en la cola del pool, dentro de la aplicación, donde esperar es barato: un pedido en esa cola no ocupa nada en la base de datos, y la base de datos trabaja a su mejor ritmo con los que sí entraron. Con un pool enorme esperan dentro de la base de datos, como procesos que compiten entre sí.
En la industria. La wiki de PostgreSQL, en Number Of Database Connections, explica que muchas veces se atiende a más usuarios concurrentes reduciendo el número de conexiones, y da como punto de partida para el número de conexiones activas una fórmula basada en los procesadores del servidor: cerca de dos por núcleo, más los discos que de verdad se usan. La documentación de HikariCP, un pool muy usado en Java, cita la misma fórmula en About Pool Sizing e insiste en que es un punto de partida: el tamaño se confirma midiendo con la carga esperada. Las dos páginas hablan de pools de decenas de conexiones, no de cientos.
Tres cosas más entran en la cuenta:
- El pool es por proceso. Si mañana corren cuatro instancias del
servicio, cada una con un pool de 50, la base de datos puede recibir 200
conexiones. El tamaño se elige mirando la base de datos, no la instancia:
el total de todos los pools, más lo que usen los demás clientes, tiene que
caber con holgura en
max_connections. - Un pool demasiado pequeño también cuesta. En la curva, el pool de 2 no da errores, pero casi todo su tiempo de respuesta es espera en la cola. Es tiempo bloqueado puro.
- Una conexión retenida no la usa nadie más. Quien toma una conexión para una transacción y, con ella en la mano, llama a un servicio lento, le quita esa conexión a todos los demás durante toda la llamada. Con un pool de 10, bastan diez pedidos así para detener el servicio entero.
Trade-off. Un pool cambia latencia y protección por un parámetro que hay que elegir y volver a elegir cuando cambia el despliegue, y por un modo de falla nuevo: un pool agotado, donde los pedidos esperan una conexión que nadie devuelve. La alternativa, una conexión por consulta, no tiene nada que configurar ni que se agote dentro del proceso; es lo que eligió el Tinkuy inicial, y es defendible mientras la carga sea de unos pocos pedidos por segundo. Una tercera opción es poner el pool fuera de la aplicación, en un proxy delante de la base de datos, compartido por todas las instancias: resuelve la cuenta del primer punto y agrega una pieza que operar.
Error común. Subir el tamaño del pool cada vez que aparece una espera por conexiones. Si las conexiones se agotan porque la base de datos ya no da más, un pool más grande le manda más trabajo a un servidor saturado, y la curva de arriba dice lo que pasa. Antes de subirlo hay que mirar qué están haciendo las conexiones ocupadas.
N+1: reducir el costo de cada pedido
Una consulta por elemento
Con el pool, cada pedido a GET /titles sigue haciendo 32 consultas: una
para la lista y una por cada uno de los 31 títulos. Ese patrón tiene nombre,
N+1: una consulta para obtener elementos y consultas más, una
por elemento, para completar cada uno. Es uno de los problemas de
rendimiento más frecuentes en aplicaciones con base de datos, por una razón
de modularidad: aparece cuando se compone código limpio. Hay una función
que lista títulos y otra que cuenta los ejemplares de un título; cada una
está bien, tiene sus pruebas y se usa en otros lados. El N+1 nace en el
for que las junta, y no se ve en ninguna de las dos.
Tampoco se ve al desarrollar. Con cinco títulos de prueba son seis consultas, y nadie nota la diferencia. El costo crece con los datos: con elementos son viajes de ida y vuelta a la base de datos, uno detrás de otro, y cada viaje tiene un costo fijo (enviar la consulta, que el servidor la analice y la planifique, recibir la respuesta) que no depende de lo fácil que sea la consulta.
Una sola consulta
La base de datos sabe contar por grupos. La segunda versión de la lista le pide todo de una vez:
export async function listTitlesSingleQuery(db: Db, filter: TitleFilter = {}): Promise<TitleSummary[]> {
  const rows = await db.query<TitleRow & { available: number }>(
    `SELECT t.id, t.name, t.author, t.year, b.name AS branch_name, b.city AS branch_city,
            count(c.id) FILTER (WHERE c.status = 'available')::int AS available
       FROM titles t
       JOIN branches b ON b.id = t.branch_id
       LEFT JOIN copies c ON c.title_id = t.id
      WHERE ($1::text IS NULL OR b.city = $1)
      GROUP BY t.id, b.id
      ORDER BY t.name, t.id`,
    [filter.city ?? null],
  );
  return rows.map((row) => toSummary(row, row.available));
}
Esta táctica cambia el código que produce la respuesta, y con eso aparece un
riesgo que el pool no tenía: que la respuesta ya no sea la misma. La consulta
de arriba tiene dos detalles puestos para evitarlo. El LEFT JOIN conserva
los títulos que no tienen ningún ejemplar, y el FILTER cuenta solo los
disponibles sin descartar la fila de un título cuyos ejemplares están todos
prestados. Sin ellos, la versión que a cualquiera se le ocurre primero es
esta (errors/list-inner-join.ts):
SELECT t.id, count(*)::int AS available
  FROM titles t
  JOIN copies c ON c.title_id = t.id
 WHERE c.status = 'available'
 GROUP BY t.id
No da ningún error y devuelve números correctos para casi todos los títulos.
Pero los datos de ejemplo tienen un título recién catalogado, sin
ejemplares, y esa consulta lo deja fuera: la lista sale con 30 títulos en
vez de 31. Por eso, antes de medir la versión nueva, hay que comprobar que
es equivalente a la anterior. La prueba
test/equivalence.test.ts
levanta todas las variantes y compara sus respuestas, texto contra texto,
para la lista completa, para cada filtro y para una ciudad que no existe.
Idea clave. Una táctica de rendimiento no debe cambiar lo que el sistema responde. Antes de medir cuánto más rápida es la versión nueva, se comprueba que responde lo mismo, incluidos los casos de borde: el elemento sin hijos, la lista vacía.
Con la equivalencia comprobada, la medición:
$ make measure V="pool-10 single"
k6: 50 usuarios virtuales durante 15s, GET /titles
variante                                        p50        p95        máx  pedidos   errores conexiones consultas
Pool de 10, N+1                              9.0 ms    30.8 ms   120.8 ms    794/s    0.00 %         10      32.0
Pool de 10, una consulta                     4.8 ms    11.6 ms    50.4 ms    867/s    0.00 %         10       1.0
conexiones: el máximo que el servicio tuvo abiertas a la vez en PostgreSQL
consultas: consultas a PostgreSQL por pedido HTTP, en promedio
La columna de consultas pasa de 32 a 1, la mediana baja a cerca de la mitad (de 9,0 ms a 4,8 ms) y el p95 a cerca de un tercio (de 31 ms a 12 ms). Con el pool ya puesto, la mejora es mucho menor que la del paso anterior, y eso tiene una explicación: las 31 consultas de más eran rápidas una vez que dejaron de pagar una conexión cada una. Pero no es poca cosa. Cada pedido ocupa ahora una conexión del pool durante una consulta, no durante 32, de modo que el mismo pool alcanza para mucha más carga.
Qué táctica dio más
Tenemos dos causas y dos tácticas, y hasta aquí las aplicamos en un orden: primero el pool, después la consulta. Para saber cuánto aporta cada una hay que medir las cuatro combinaciones:
$ make measure V="baseline pool-10 single-nopool single"
k6: 50 usuarios virtuales durante 15s, GET /titles
variante                                        p50        p95        máx  pedidos   errores conexiones consultas
Sin pool, N+1 (línea de base)              572.3 ms   651.9 ms   709.6 ms     79/s    0.00 %         38      32.0
Pool de 10, N+1                             30.8 ms    47.1 ms   100.0 ms    611/s    0.00 %         10      32.0
Sin pool, una consulta                       8.1 ms    14.1 ms    95.3 ms    832/s    0.00 %         21       1.0
Pool de 10, una consulta                     4.7 ms    11.6 ms    38.2 ms    872/s    0.00 %         10       1.0
conexiones: el máximo que el servicio tuvo abiertas a la vez en PostgreSQL
consultas: consultas a PostgreSQL por pedido HTTP, en promedio
Leída por filas, la tabla dice algo que el orden en que aplicamos las tácticas escondía. Cualquiera de las dos, sola, se lleva casi toda la mejora. Sin pool y con una sola consulta (tercera fila), la mediana es de 8 ms: el pedido abre una conexión en vez de 32. La razón es que las dos causas no eran independientes: el N+1 multiplicaba por 32 el costo de no tener pool. Quitar cualquiera de los dos factores deshace el producto.
Las dos juntas dan el mejor número, y no son equivalentes en lo que dejan. La tercera fila sigue abriendo una conexión por pedido y no tiene tope: llegó a 21 conexiones con 50 usuarios, y con 200 volvería a pasarse de las que PostgreSQL acepta. La segunda tiene tope y hace 32 veces más trabajo del necesario. En otras corridas, la segunda y la tercera intercambiaron su orden; la primera y la cuarta, nunca.
¿Cuál dio más por menos? Depende de qué se cuente como costo. El pool fue un cambio en un solo archivo que no tocó ninguna consulta ni puede cambiar una respuesta, y a cambio trajo un parámetro que elegir. La consulta única no agregó nada que configurar, y a cambio hubo que reescribir la lógica de un endpoint y comprobar su equivalencia. Esa es la pregunta 6 del laboratorio, y la respuesta para Tinkuy la tienen que dar sus propias mediciones.
Trade-off. Quitar el N+1 cuesta modificabilidad: la consulta única sabe a la vez de títulos, de sedes y de ejemplares, y la función
countAvailableCopies, que antes se reutilizaba, ya no participa. Si los ejemplares vivieran en otro módulo, o en otro servicio, eseJOINcruzaría un límite: es el problema de la semana 4, y con servicios separados elJOINni siquiera es posible. La alternativa intermedia es pedir los conteos de todos los títulos en una segunda consulta (WHERE title_id = ANY(...) GROUP BY title_id) y juntarlos en el código: dos viajes en vez de 32, y cada módulo sigue consultando solo sus tablas.
Cache, primera vista
Guardar el resultado de algo caro
La tercera táctica es de la otra rama: mantener varias copias de los
datos. Una cache guarda el resultado de algo caro para no repetirlo. La
forma más simple, y la que usa Qillqa, se llama cache-aside: antes de
calcular la respuesta se busca en la cache; si está, se devuelve; si no
está, se calcula, se guarda con un tiempo de vida (el TTL, time to
live) y se devuelve. Pasado el TTL, Redis borra la entrada sola y el
siguiente pedido la vuelve a calcular. El núcleo, sin el manejo de errores
que veremos en la segunda sesión
(src/cache.ts):
      cached = await client.get(fullKey);
      // ...
      if (cached !== null) {
        counters.hits += 1;
        return { body: cached, outcome: 'hit' };
      }
      counters.misses += 1;
      const body = await compute();
      // ...
        await client.set(fullKey, body, { EX: ttl });
      // ...
      return { body, outcome: 'miss' };
Un pedido que encuentra su respuesta en la cache es un acierto (hit); el
que no, un fallo de cache (miss). El servicio lo informa en la cabecera
x-cache de cada respuesta. La clave lleva el filtro: la lista de Cusco y
la lista completa son entradas distintas (w06:titles:Cusco,
w06:titles:*).
Lo que se gana
$ make measure V="single cache"
k6: 50 usuarios virtuales durante 15s, GET /titles
variante                                        p50        p95        máx  pedidos   errores conexiones consultas
Pool de 10, una consulta                     4.7 ms    10.7 ms    47.7 ms    876/s    0.00 %         10       1.0
Pool de 10, una consulta, cache de 5 s       1.0 ms     2.5 ms    43.0 ms    905/s    0.00 %         10       0.0
conexiones: el máximo que el servicio tuvo abiertas a la vez en PostgreSQL
consultas: consultas a PostgreSQL por pedido HTTP, en promedio
La mediana baja de 4,7 ms a 1,0 ms y el p95 de 10,7 ms a 2,5 ms. La columna
más llamativa es la última: 0,0 consultas por pedido. Con un TTL de 5
segundos, de los cerca de 13 500 pedidos de la corrida solo unos pocos
llegaron a PostgreSQL; el resto se respondió con un GET a Redis.
En números absolutos la ganancia es de menos de 4 ms por pedido, sobre un endpoint que ya cumplía el escenario con holgura. Vale la pena notarlo: la cache es la táctica con el mejor número de la tabla y, en este caso, la que menos hacía falta.
Se gana en dos medidas a la vez: la latencia de quien pide, y la carga sobre la base de datos, que queda libre para lo que no se puede guardar en una cache, como los préstamos.
Lo que se abre: el dato viejo
Lo que se guarda es una copia, y el original puede cambiar. make stale
levanta el servicio con cache, presta un ejemplar del título 1 y mira cada
segundo dos cosas: la lista, que sale de la cache, y el detalle del título,
que consulta la base de datos
(tools/stale.sh):
$ make stale
antes del préstamo    lista: 178 (x-cache: miss)   detalle: 178
{"loan":{"titleId":1,"copyId":1}}
0 s después           lista: 178 (x-cache: hit)   detalle: 177
1 s después           lista: 178 (x-cache: hit)   detalle: 177
2 s después           lista: 178 (x-cache: hit)   detalle: 177
3 s después           lista: 178 (x-cache: hit)   detalle: 177
4 s después           lista: 178 (x-cache: hit)   detalle: 177
5 s después           lista: 177 (x-cache: miss)   detalle: 177
6 s después           lista: 177 (x-cache: hit)   detalle: 177
Durante cinco segundos, el sistema da dos respuestas distintas a la misma pregunta según por dónde se le pregunte. La lista dice 178; el detalle, 177. Nadie invalidó la entrada: se corrigió sola cuando venció.
¿Es grave? Depende del escenario, que es lo que dijimos en la semana 2. Para quien hojea el catálogo, un ejemplar de diferencia durante cinco segundos no cambia nada. Para el último ejemplar es distinto: la lista puede mostrar “queda 1” de un libro que ya no está, y alguien va a ir a pedirlo. Lo que salva al diseño es que la lista solo informa; la decisión de prestar se toma contra la base de datos, que es la que tiene el dato verdadero. Una cache en el camino de una decisión es otro problema, mucho más delicado.
Trade-off. Una cache cambia latencia y carga por consistencia: durante el TTL puede responder con un dato que ya cambió. Las alternativas son un TTL más corto (menos tiempo con el dato viejo y menos aciertos), o borrar la entrada cuando el dato cambia (invalidar), que acorta la ventana y obliga a que todo el código que escribe sepa qué entradas tocar. Cuánto dato viejo se tolera no es una decisión técnica: se le pregunta a quien conoce el negocio. La semana 11 desarrolla la invalidación y los demás patrones de cache.
La cache que esconde una consulta
Queda una combinación por medir, y es la más tentadora en un proyecto real: dejar el servicio como estaba, sin pool y con su N+1, y ponerle la cache encima. Es un cambio en un solo lugar y no toca ninguna consulta.
$ make measure V="cache-nplus1 cache"
k6: 50 usuarios virtuales durante 15s, GET /titles
variante                                        p50        p95        máx  pedidos   errores conexiones consultas
Sin pool, N+1, cache de 5 s                  0.9 ms     2.7 ms  1087.0 ms    754/s    0.00 %         30       0.4
Pool de 10, una consulta, cache de 5 s       1.0 ms     2.6 ms    30.7 ms    912/s    0.00 %         10       0.0
conexiones: el máximo que el servicio tuvo abiertas a la vez en PostgreSQL
consultas: consultas a PostgreSQL por pedido HTTP, en promedio
La mediana y el p95 son tan buenos como los de la versión completa: 0,9 ms y 2,7 ms. Quien mire solo esas dos columnas dará el problema por resuelto. Pero el máximo es de 1 087 ms contra 31 ms, y el servicio llegó a tener 30 conexiones abiertas a la vez. Lo que pasa es esto: cada cinco segundos la entrada vence, y todos los pedidos que llegan mientras nadie la ha vuelto a guardar la recalculan a la vez, cada uno con sus 32 consultas y sus 32 conexiones. Durante ese instante el servicio es exactamente el de la línea de base, con toda la carga encima. Las 0,4 consultas por pedido son el promedio de muchos pedidos con cero y unos pocos con 32.
Error común. Poner una cache para esconder una consulta mal escrita. La consulta sigue ahí y aparece con cada fallo de cache: cuando vence el TTL, después de un reinicio, con una clave que nadie había pedido, o cuando la cache se cae. Y aparece de la peor manera, porque todos los pedidos que llegan mientras la entrada no está la recalculan a la vez (la semana 11 le pone nombre: estampida). Primero se reduce el costo del pedido; la cache se pone después, sobre algo que ya es razonable sin ella.
make table mide las seis variantes de esta sesión una detrás de otra y
escribe las seis filas juntas. Es la tabla que van a llenar en el laboratorio
para su propio sistema, con una columna más, que aquí fuimos escribiendo en
prosa: lo que costó cada táctica.
Disponibilidad: que una falta no llegue a ser una falla
Falta, error y falla
En la semana 2 definimos la disponibilidad como la fracción del tiempo en que el sistema responde bien, y vimos que depende de dos cosas: cada cuánto falla y cuánto tarda en volver. Para diseñar hace falta un vocabulario más fino, con tres palabras que en el habla diaria se usan como sinónimos.
- Una falta (fault) es la causa: un disco dañado, un bug, un proceso que se quedó sin memoria, una pasarela que no responde, un Redis que alguien mató.
- Un error es el estado incorrecto que la falta produce dentro del sistema: una excepción que sube, un dato a medias, un pedido que espera algo que no va a llegar.
- Una falla (failure) es lo que ve quien usa el sistema cuando este deja de cumplir su especificación: un 500, una página que no carga, una entrada cobrada y no emitida.
La cadena va en ese orden: la falta produce un error, y el error, si nadie lo detiene, llega hasta el usuario como una falla. En español, además, la palabra falla se usa para las dos puntas (decimos tolerancia a fallas para fault tolerance); cuando la diferencia importe, este capítulo dice falta para la causa.
La distinción no es un tecnicismo, porque define el objetivo. Las faltas no se pueden eliminar: los discos se dañan, las redes se cortan y todo programa tiene bugs. Lo que sí se puede diseñar es lo que pasa después.
Idea clave. La disponibilidad no se diseña para que no haya faltas, sino para que las faltas no lleguen a ser fallas, o para que las fallas duren poco.
Las tácticas de disponibilidad se agrupan según en qué punto de esa cadena actúan: detectar la falta, recuperarse de ella y prevenir que ocurra o que tenga efecto.
Detectar
Nada de lo que sigue funciona si el sistema no se entera de que algo anda mal. Un proceso que se quedó colgado no avisa.
| Táctica | Qué se hace |
|---|---|
| Monitor | Un componente dedicado a vigilar el estado de los demás: procesos, memoria, colas, tiempos de respuesta |
| Ping y eco | El monitor le manda un mensaje al componente y espera la respuesta. Si no llega a tiempo, lo da por caído |
| Heartbeat | Al revés: el componente avisa cada cierto tiempo que sigue vivo. Si el aviso deja de llegar, se lo da por caído |
| Timestamp | Los mensajes llevan una marca de tiempo o un número de secuencia, para detectar los que llegan fuera de orden o repetidos |
| Monitoreo de condiciones | Se comprueban condiciones del propio componente (una suma de verificación, un invariante) para detectar que produjo algo incorrecto |
| Comprobación de cordura (sanity check) | Se revisa que un resultado sea razonable antes de usarlo: un total negativo, un evento con más asientos vendidos que capacidad |
| Votación | Varios componentes hacen el mismo cálculo y se comparan los resultados; el que difiere está mal |
| Detección de excepciones | Se detecta una condición que interrumpe el flujo normal: una excepción del lenguaje, un código de error, un tiempo de espera vencido |
| Autoprueba | El componente se prueba a sí mismo, al arrancar o cada cierto tiempo |
La forma más simple de detectar que algo no respondió es un timeout: esperar hasta un límite y, pasado el límite, tratar el silencio como un error. Sin timeout, quien llama a un componente colgado se queda colgado con él, y la falta se propaga hacia arriba sin que nadie la haya detectado todavía.
En Tinkuy. La versión 0 llama a la pasarela con
fetchy sin timeout. Si la pasarela acepta la conexión y no responde, la compra espera lo que haga falta, con una transacción abierta. Detecta bien una pasarela caída (elfetchfalla y la compra responde un 502), y no detecta una pasarela lenta. La semana 14 mide ese caso con Toxiproxy.
Recuperarse
Detectada la falta, hay que hacer algo. El catálogo separa dos momentos: prepararse y reparar, y volver a poner en servicio lo que falló.
Preparación y reparación:
| Táctica | Qué se hace |
|---|---|
| Redundancia | Hay más de una copia del componente. Activa: todas las copias reciben y procesan todo, y el reemplazo es casi instantáneo. Pasiva: una procesa y le va pasando su estado a las otras, que toman su lugar con un pequeño retraso. De repuesto: la copia está apagada o sin estado, y hay que iniciarla y cargarla |
| Rollback | Se vuelve a un estado bueno conocido: una transacción que se deshace, un despliegue que se revierte |
| Manejo de excepciones | Detectada la excepción, se hace algo con ella: se traduce, se corrige, se responde otra cosa |
| Retry | Se repite la operación, con la esperanza de que la falta haya sido transitoria |
| Ignorar el comportamiento defectuoso | Se descartan los mensajes de una fuente que se sabe que está fallando |
| Degradación | Se sigue ofreciendo lo esencial y se suspende lo demás |
| Reconfiguración | Se reasignan las responsabilidades del componente caído a los que quedan |
Reintroducción (cuando el componente que falló vuelve):
| Táctica | Qué se hace |
|---|---|
| Modo sombra | El componente reparado corre un tiempo recibiendo pedidos reales sin que sus respuestas se usen, hasta comprobar que se comporta bien |
| Resincronización del estado | Antes de volver al servicio, el componente se pone al día con el estado que se perdió |
| Reinicio escalonado | Se reinicia lo menos posible: primero una parte pequeña y, solo si no basta, una mayor |
Las tres formas de redundancia son un trade-off entre lo que cuesta y lo que tarda la recuperación. La activa paga varias copias trabajando todo el tiempo para recuperarse en milisegundos; la de repuesto paga casi nada mientras todo va bien y tarda minutos cuando hace falta. La semana 10, de replicación, es en buena parte el estudio de esta táctica aplicada a una base de datos.
Prevenir
El tercer grupo actúa antes de que la falta ocurra o de que tenga efecto.
| Táctica | Qué se hace |
|---|---|
| Sacar de servicio | Se retira un componente antes de que falle, para repararlo o reiniciarlo: una instancia que el load balancer deja de usar porque su health check empeora |
| Transacciones | Varias operaciones se agrupan para que ocurran todas o ninguna, de modo que una falta a la mitad no deje el estado a medias |
| Modelos predictivos | Se vigila una medida que anticipa la falta (la memoria que crece, el disco que se llena) y se actúa antes de llegar al límite |
| Prevención de excepciones | Se diseña para que la condición de error no pueda darse: validar antes de operar, tipos que no admiten el valor inválido |
| Aumentar el conjunto de competencias | El componente aprende a manejar más casos como parte de su operación normal, en vez de tratarlos como fallas |
La última es la menos conocida y la que más vamos a usar esta semana. El conjunto de competencias de un componente es el conjunto de situaciones en las que sabe operar. Un servicio que solo sabe responder cuando su cache está arriba tiene un conjunto de competencias pequeño. Si aprende a responder también con la cache caída, la caída de la cache dejó de ser, para él, una falta.
Degradar en vez de caer
Qué es esencial
Degradar es decidir, de antemano, qué parte del servicio se puede perder sin perder el servicio. Esa decisión tiene dos mitades. La técnica es de estructura: lo prescindible tiene que estar separado de lo esencial de modo que su falta no se propague. La otra mitad no es técnica.
En Tinkuy. Si el servidor de correo no responde, la compra podría completarse y el correo salir después: el comprador tiene su entrada, y el correo es una copia. Si el reporte de ventas no responde, la venta no debería enterarse. En la versión 0 ninguna de las dos cosas se cumple: el correo se envía dentro de la transacción de la compra, y si falla, la compra se deshace. Qué es esencial (¿se puede vender sin enviar el correo?, ¿se puede vender sin poder cobrar, anotando la deuda?) no lo decide quien programa: es una decisión de negocio, y el arquitecto la tiene que preguntar.
Qillqa, el servicio de esta semana, nos da un caso más pequeño para medir.
Con la cache puesta, GET /titles depende ahora de dos cosas: PostgreSQL y
Redis. En la semana 2 vimos que las disponibilidades en serie se
multiplican, así que, tal cual, el endpoint quedó menos disponible que
antes de la cache. Y es una dependencia rara: los datos están en PostgreSQL.
Redis solo tiene una copia. ¿Qué debe pasar cuando Redis se cae?
La cache caída, medida
make cache-down responde con un experimento. Levanta el servicio con
cache, le manda 40 pedidos por segundo durante 9 segundos, mata Redis en el
segundo 3 con svc kill redis y lo vuelve a iniciar en el segundo 6. Lo
hace dos veces, con las dos respuestas posibles a una cache que no responde.
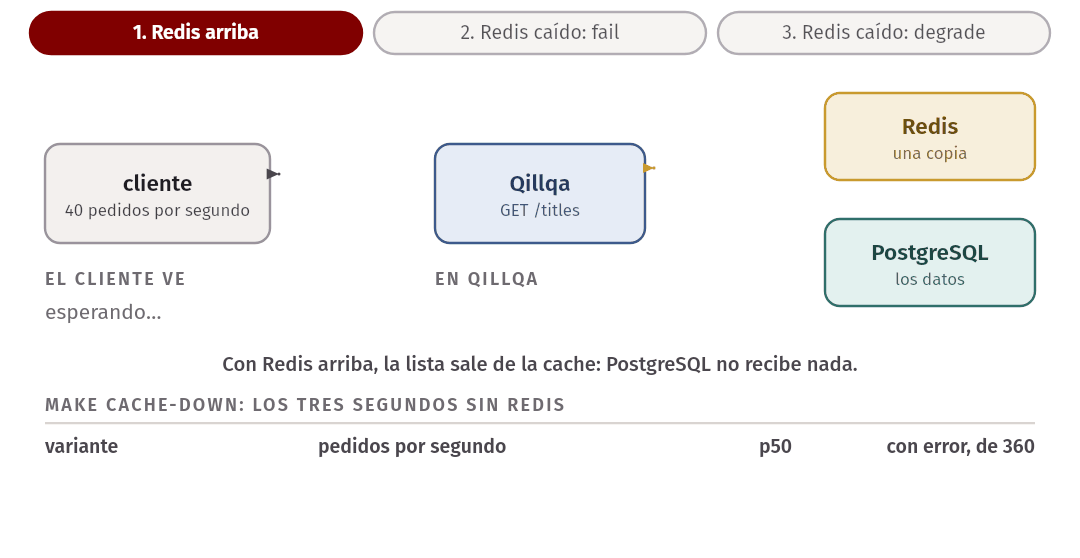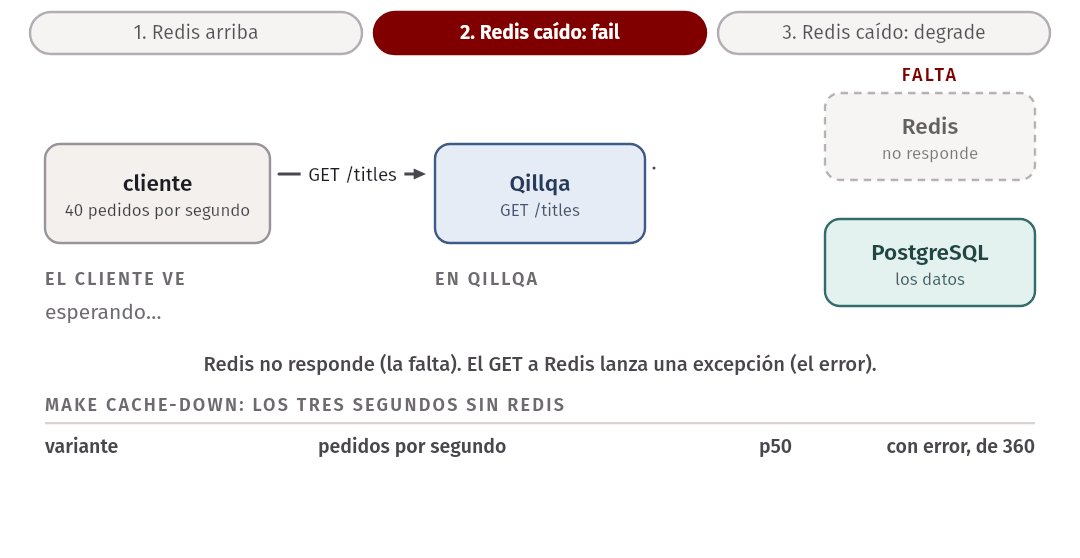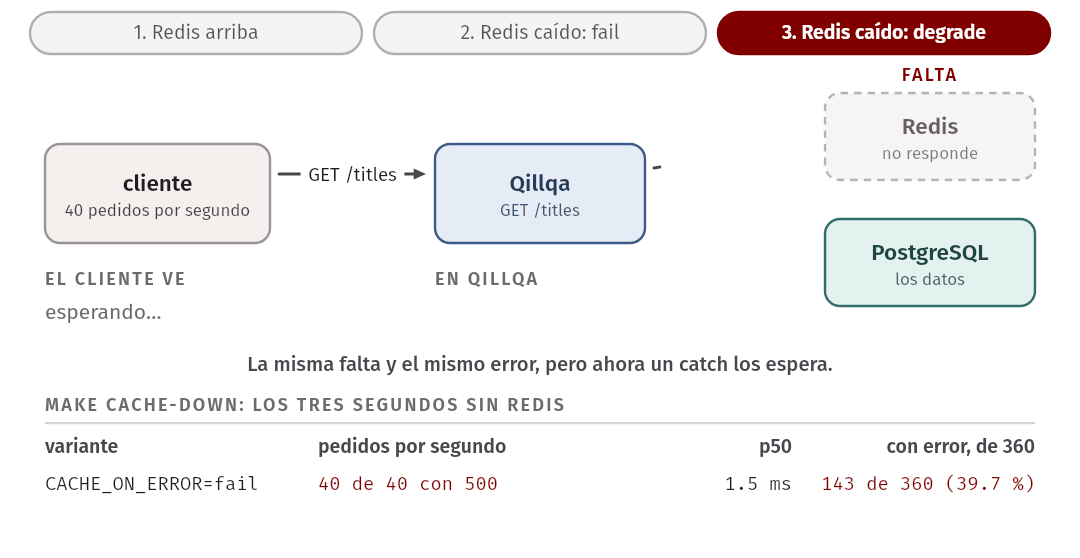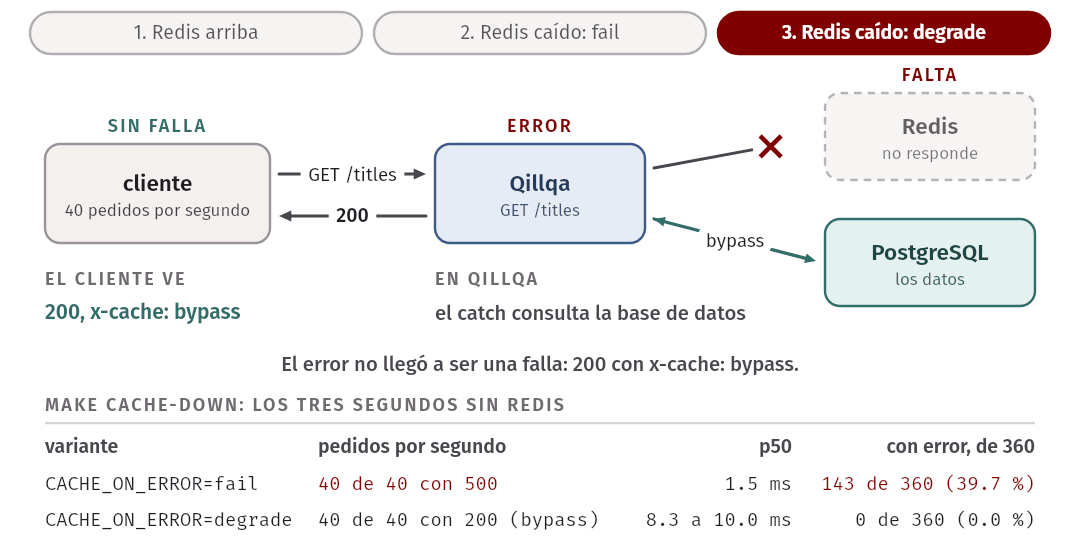
La primera es la que sale sola si nadie lo piensa: el error de Redis sube como cualquier excepción y termina en un 500.
$ make cache-down
CACHE_ON_ERROR=fail: 40 pedidos por segundo a GET /titles
  s   200   500   hit  miss  bypass   p50      suceso
  0    40     0    40     0     0    2.1 ms
  1    40     0    39     1     0    1.8 ms
  2    40     0    40     0     0    1.5 ms
  3     0    40     0     0     0    1.5 ms   svc kill redis
  4     0    40     0     0     0    1.5 ms
  5     0    40     0     0     0    1.5 ms
  6    17    23    16     1     0    2.4 ms   svc start redis
  7    40     0    40     0     0    2.4 ms
  8    40     0    40     0     0    2.2 ms
pedidos: 360, con error: 143 (39.7 %)
Durante los tres segundos sin Redis, todos los pedidos fallan. PostgreSQL estuvo sano todo el tiempo y tenía la respuesta; el servicio no se la pidió. Una falta en un componente opcional se convirtió en una falla total del endpoint.
La segunda respuesta trata el error de Redis como un caso que el servicio
sabe manejar: si la cache no responde, se consulta la base de datos
(src/cache.ts):
      let cached: string | null;
      try {
        cached = await client.get(fullKey);
      } catch (error) {
        if (variant.onCacheError === 'degrade') {
          // Degradar: sin cache el pedido es más lento, pero se responde.
          counters.bypasses += 1;
          return { body: await compute(), outcome: 'bypass' };
        }
        counters.failures += 1;
        throw new CacheUnavailableError(error);
      }
CACHE_ON_ERROR=degrade: 40 pedidos por segundo a GET /titles
s 200 500 hit miss bypass p50 suceso
0 40 0 40 0 0 2.4 ms
1 40 0 39 1 0 2.1 ms
2 40 0 40 0 0 3.3 ms
3 40 0 0 0 40 10.0 ms svc kill redis
4 40 0 0 0 40 8.7 ms
5 40 0 0 0 40 8.3 ms
6 40 0 17 1 22 7.9 ms svc start redis
7 40 0 40 0 0 2.1 ms
8 40 0 40 0 0 2.3 ms
pedidos: 360, con error: 0 (0.0 %)Ningún error. Durante la caída las respuestas salen de la base de datos
(columna bypass) y la mediana sube a varias veces la de antes: el servicio
está degradado, no caído. Cuando Redis vuelve, el cliente se reconecta solo
y la cache se llena otra vez. Quien miraba el catálogo no vio nada, salvo
una lista algo más lenta.
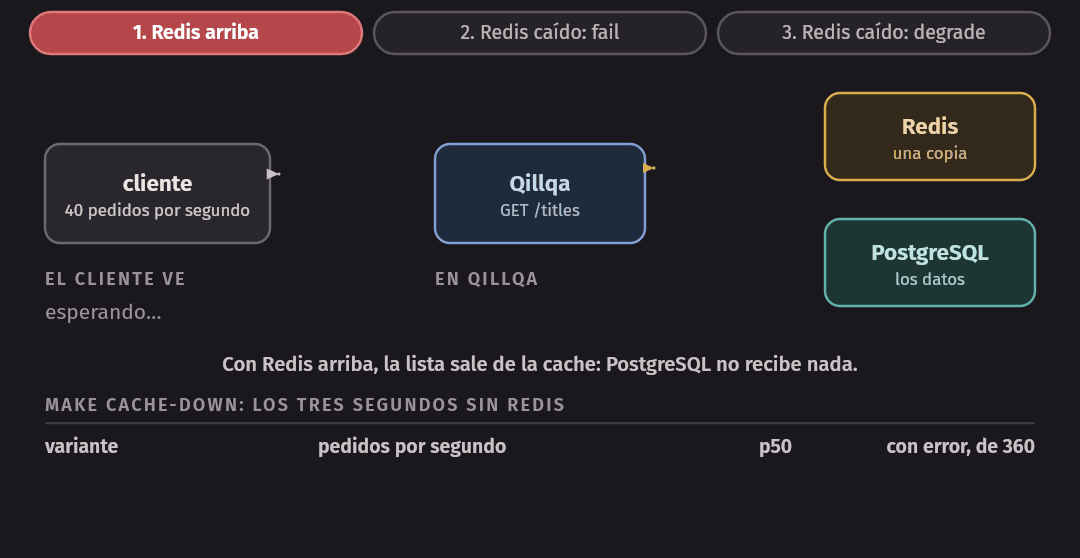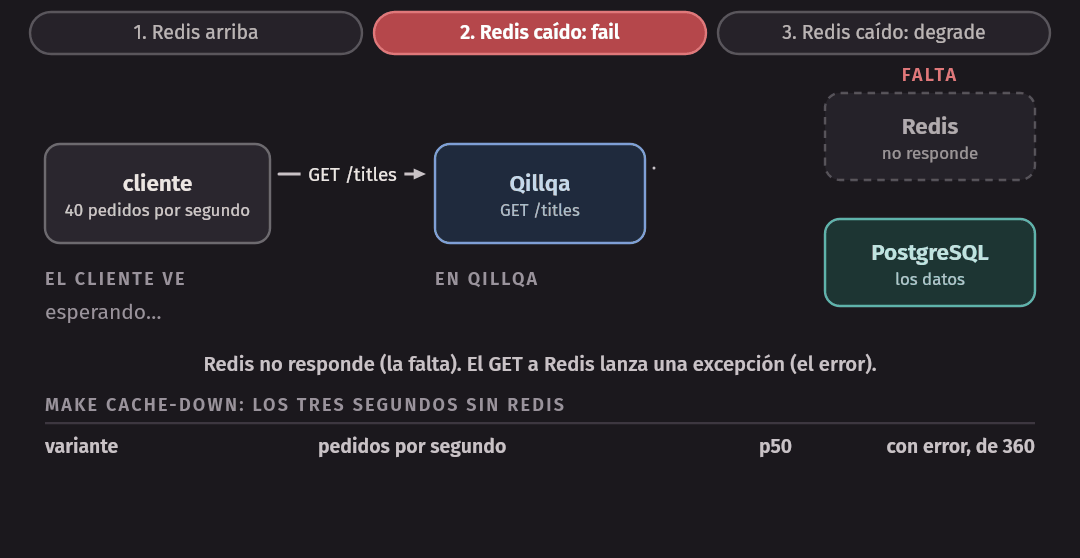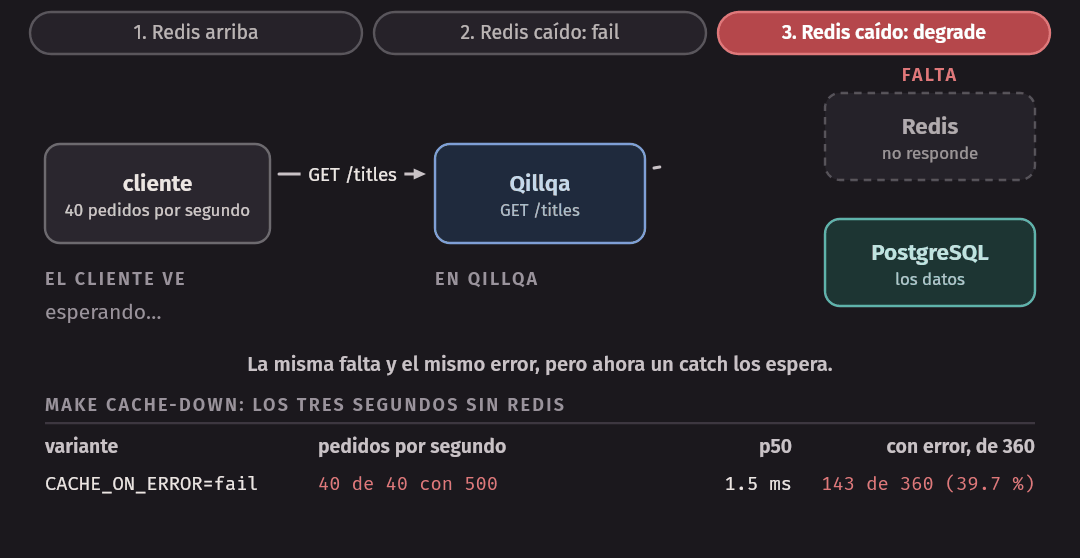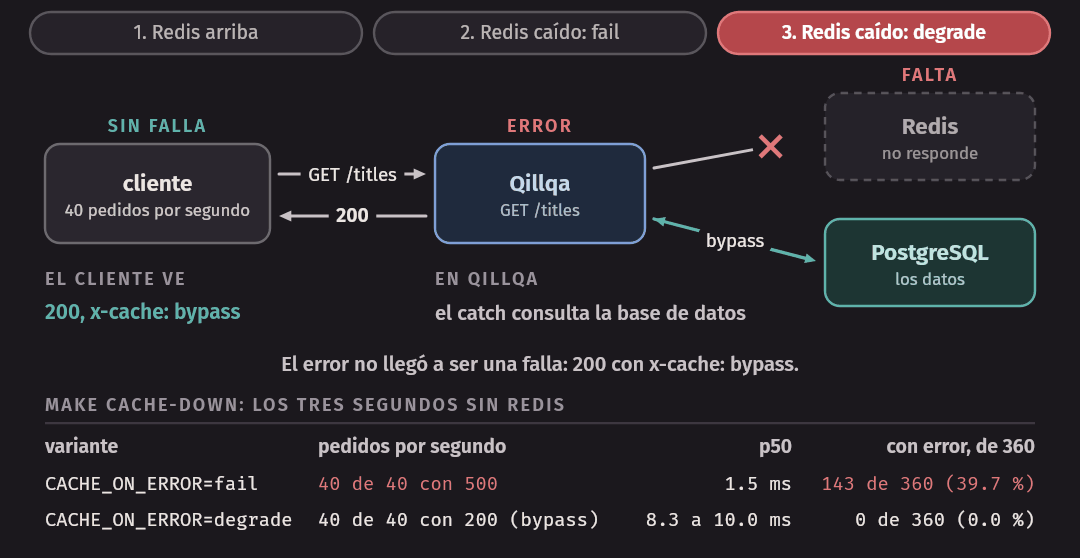
En términos del catálogo se usaron tres tácticas: detección de
excepciones (el catch), degradación (responder por el camino lento) y
aumentar el conjunto de competencias (la cache caída pasó a ser un caso
normal). La prueba
test/redis-down.test.ts mata
Redis de verdad y comprueba las dos variantes, además de que el cuerpo de la
respuesta degradada es idéntico al de la versión sin cache.
Trade-off. Degradar a la base de datos no es gratis: cuando la cache se cae, la base de datos recibe de golpe toda la carga que la cache le ahorraba. A 40 pedidos por segundo no se nota. Si el origen solo aguanta el tráfico real con la cache puesta, degradar le traslada la caída a la base de datos, que es peor, porque de ella dependen también las compras. La alternativa, fallar rápido en las lecturas para proteger el origen, puede ser la decisión correcta: es lo que hace
CACHE_ON_ERROR=fail, y por eso es una opción y no un error del código. Cuál conviene depende de una medición que ya saben hacer: ¿qué p95 y qué errores da el servicio sin cache con la carga del escenario? La semana 11 vuelve sobre esto.
El cliente que espera en silencio
El experimento anterior esconde un detalle que en el laboratorio les puede
costar un rato. Para poder decidir entre fallar y degradar, primero hay
que enterarse de que Redis no responde. Y el cliente de Redis para Node.js,
con su configuración por omisión, no avisa: guarda en una cola los comandos
que se envían mientras no hay conexión, y los manda cuando la conexión
vuelve. make offline-queue lo muestra
(errors/redis-offline-queue.ts):
$ make offline-queue
Por omisión (con cola):
  con Redis caído, el GET sigue pendiente después de 2000 ms
  con Redis de vuelta, ese mismo GET respondió null a los 2219 ms
  un GET nuevo, ya reconectado, respondió null
Con disableOfflineQueue:
  con Redis caído, el GET falló a los 0 ms: The client is offline
  un GET nuevo, ya reconectado, respondió null
Con la cola, el GET ni falla ni responde: espera. Para un programa por
lotes eso es cómodo. Para un pedido HTTP es la peor de las tres
posibilidades: el catch que degrada nunca se ejecuta, porque no hay
excepción, y los pedidos se acumulan esperando a un Redis que puede tardar
minutos. Con disableOfflineQueue: true, el comando falla de inmediato y el
servicio puede decidir.
Es la lección de la rama detectar en pequeño: sin detección no hay recuperación. Y vale más allá de Redis. Un cliente de cualquier servicio tiene una política para cuando el servicio no está (esperar, reintentar, fallar), casi siempre elegida por quien escribió la biblioteca pensando en otro caso de uso. Hay que saber cuál es. Queda además un caso que esta configuración no cubre: un Redis que acepta la conexión y no responde. Para ese hace falta un timeout por comando, y es la misma situación de la pasarela lenta.
El retry: táctica y riesgo
Reintentar es la táctica de recuperación más barata de escribir: un bucle. Si la falta fue transitoria (un paquete perdido, un reinicio de dos segundos), el segundo intento sale bien y nadie se entera. Por eso aparece en todas partes, muchas veces sin que nadie lo haya decidido: lo trae el cliente HTTP, el driver de la base de datos, el SDK del proveedor.
Tiene dos riesgos, y cada uno tiene su semana.
Puede duplicar la operación. En la semana 5 vimos que, desde quien llama, un pedido perdido y una respuesta perdida se ven igual. Si lo que se perdió fue la respuesta, la operación ya se hizo, y reintentar la hace otra vez: dos cobros, dos órdenes, dos correos. Un retry solo es seguro sobre operaciones que se pueden repetir sin cambiar el resultado, y lograr eso para una compra es el tema de la idempotencia, en la semana 12.
Puede multiplicar la carga sobre un servicio que ya no da más. Si un servicio está lento porque está saturado, cada cliente que se cansa de esperar y reintenta le agrega trabajo justo cuando menos puede atenderlo. Y si hay varias capas que reintentan, los intentos se multiplican entre sí. Con capas, cada una con hasta intentos, un solo pedido del usuario puede llegar a producir, en la última capa,
Con tres intentos en cada una de tres capas (el navegador, el API y el cliente de la pasarela), son llamadas a la pasarela por cada clic, todas sobre un servicio que falló precisamente porque tenía demasiado trabajo. Así una falta transitoria, que habría pasado sola en unos segundos, se vuelve una falla que se sostiene a sí misma: el servicio no se recupera porque los reintentos no lo dejan.
En la industria. El capítulo 22 del libro de SRE de Google, Addressing Cascading Failures, describe ese mecanismo con un ejemplo: un backend que recibe un poco más de lo que puede atender rechaza el exceso, los clientes reintentan lo rechazado, y los reintentos se suman a la carga del segundo siguiente, que a su vez produce más rechazos. Entre las medidas que recomienda están limitar los intentos por pedido, poner un tope de reintentos por cliente y reintentar en una sola capa, no en todas.
Trade-off. El retry mejora la disponibilidad frente a faltas transitorias y puede empeorar el rendimiento, y con él la disponibilidad, frente a una sobrecarga. La alternativa, no reintentar y devolver el error, traslada la decisión a quien llamó, que suele tener menos información. El punto medio (pocos intentos, espera creciente entre ellos, en una sola capa) es el tema de la semana 14.
Seguridad
Tres propiedades y un escenario
La seguridad se suele resumir en tres propiedades, que en inglés forman la sigla CIA:
- Confidencialidad: los datos solo los ve quien está autorizado a verlos. Un extraño no puede leer la orden de otra persona.
- Integridad: los datos y el sistema solo los cambia quien está autorizado, y de las formas permitidas. Nadie se pone a sí mismo el precio de una entrada.
- Disponibilidad: el sistema sigue respondiendo a sus usuarios legítimos aunque alguien intente impedirlo. Es la misma disponibilidad de la sección anterior, con una diferencia: aquí la falta es intencional, y quien la causa se adapta a las defensas.
Un escenario de seguridad tiene las mismas seis partes que cualquier otro, con contenido propio. La fuente es un atacante, que puede venir de fuera o de dentro de la organización (un empleado, un servicio propio que fue tomado). El estímulo es el ataque: un intento de leer, cambiar o tumbar algo. La medida responde tres preguntas: cuánto daño se hizo (qué datos se expusieron o se alteraron), cuánto tardó en detectarse y cuánto tardó la recuperación.
Un atacante externo (fuente) envía pedidos a
GET /orders/:idrecorriendo los ids (estímulo) contra la API pública (artefacto), en operación normal (entorno). El sistema rechaza los pedidos de órdenes que no son de quien las pide y registra el intento (respuesta); ningún dato de otro comprador sale del sistema, y el recorrido se detecta en menos de un minuto (medida).
Como en rendimiento, sin la medida no hay escenario: “el sistema debe ser seguro” no se puede comprobar ni refutar.
Detectar, resistir, reaccionar y recuperarse
Las tácticas de seguridad se agrupan en cuatro ramas, que siguen la historia de un ataque. Sirve la analogía con un edificio: una alarma (detectar), una cerradura (resistir), un vigilante que actúa cuando suena la alarma (reaccionar) y un seguro para después (recuperarse).
Detectar ataques:
| Táctica | Qué se hace |
|---|---|
| Detectar intrusos | Se compara el tráfico o el comportamiento con patrones conocidos de ataque, o con lo que es normal para ese sistema |
| Detectar denegación de servicio | Se compara el volumen y la forma de los pedidos que llegan con el perfil habitual |
| Verificar la integridad de los mensajes | Sumas de verificación, hashes o firmas permiten saber si un mensaje o un archivo fue alterado |
Resistir ataques:
| Táctica | Qué se hace |
|---|---|
| Identificar actores | Saber de quién viene cada pedido: un usuario, un servicio, una dirección |
| Autenticar actores | Comprobar que quien dice ser alguien lo es: una contraseña, un token, un certificado |
| Autorizar actores | Comprobar que ese actor puede hacer esa operación sobre ese recurso |
| Limitar el acceso | Que cada actor y cada componente lleguen solo a los recursos que necesitan |
| Limitar la exposición | Reducir la superficie de ataque: menos puntos de entrada, menos componentes que ven los datos sensibles |
| Cifrar los datos | En tránsito y guardados, para que quien los intercepte o los robe no los pueda leer |
| Separar entidades | Poner lo sensible aparte de lo demás: otro proceso, otra base de datos, otra red |
| Validar la entrada | Comprobar todo lo que llega de afuera antes de usarlo |
| Cambiar las credenciales por defecto | No dejar ningún usuario, contraseña o clave con el valor con que vino instalado |
Reaccionar a ataques:
| Táctica | Qué se hace |
|---|---|
| Revocar el acceso | Cortar el acceso de un actor o de una credencial cuando se sospecha un ataque |
| Restringir el inicio de sesión | Limitar los intentos fallidos: bloquear por un tiempo después de varios |
| Informar | Avisar a quien opera el sistema, y a los afectados cuando corresponde |
Recuperarse de ataques:
| Táctica | Qué se hace |
|---|---|
| Auditoría | Guardar un registro de quién hizo qué, para reconstruir el ataque, medir el daño y encontrar al responsable |
| Las tácticas de disponibilidad | Volver a un estado bueno conocido: las de la sección anterior sirven aquí tal cual |
Tinkuy ya usa dos tácticas de la rama de resistir, y conviene reconocerlas
antes del laboratorio: valida la entrada de POST /orders campo por campo
(src/orders/validation.ts) y todas sus consultas son parametrizadas.
Cuáles faltan es el paso 8.
Validar la entrada, medido
La regla de la guía de estilo del curso, “nunca se arma SQL concatenando
texto de quien llama”, es la táctica validar la entrada aplicada al punto
donde más daño hace no aplicarla. El programa
errors/sql-concat.ts busca los
títulos de una ciudad de las dos maneras:
// MAL: el texto de quien llama pasa a ser parte de la consulta.
`… WHERE b.city = '${city}' ORDER BY 1`
// BIEN: la consulta es fija y el texto viaja aparte, como un dato.
`… WHERE b.city = $1 ORDER BY 1`, [city]
Con una ciudad de verdad dan lo mismo, y por eso el error no se nota en las pruebas habituales. Con un texto escrito por un atacante, no:
$ make sql-concat
city = Cusco
  concatenando: 6 filas; la primera: {"name":"Agua","author":"José María Arguedas"}
  con parámetro: 6 filas   (una ciudad)
city = x' OR '1'='1
  concatenando: 31 filas; la primera: {"name":"Agua","author":"José María Arguedas"}
  con parámetro: 0 filas   (todo el catálogo)
city = x' UNION SELECT rolname, 'superusuario: ' || rolsuper FROM pg_roles WHERE rolcanlogin --
  concatenando: 1 filas; la primera: {"name":"postgres","author":"superusuario: true"}
  con parámetro: 0 filas   (otra tabla)
El segundo texto cierra la comilla y agrega una condición que siempre es verdadera: la consulta devuelve todo el catálogo. El tercero es peor: une a la respuesta el contenido de otra tabla, una del sistema, y el “título” que vuelve es el nombre de un usuario de la base de datos. En la versión parametrizada, los mismos textos son solo nombres de ciudades que no existen.
La categoría a la que pertenece este ataque, la inyección, figura desde hace años en el OWASP Top 10, la lista de los riesgos más frecuentes en aplicaciones web que mantiene la fundación OWASP. Es una buena lectura complementaria por una razón de arquitectura: casi todas sus categorías corresponden a una táctica de la rama de resistir que faltó.
Los principios de Saltzer y Schroeder
En 1975, Jerome Saltzer y Michael Schroeder publicaron The Protection of Information in Computer Systems, que incluye una lista de principios de diseño para mecanismos de protección. El artículo trae ocho; seis se siguen citando casi sin cambios medio siglo después.
| Principio | Qué dice | En un sistema como Tinkuy |
|---|---|---|
| Economía de mecanismo | El mecanismo de protección debe ser tan simple y pequeño como se pueda, porque sus errores no se ven en el uso normal y hay que encontrarlos revisándolo | Un solo lugar donde se decide el acceso, no una comprobación distinta en cada handler |
| Valores por defecto seguros | El acceso se decide por permiso y no por exclusión: lo que nadie autorizó está prohibido | Un endpoint nuevo exige sesión salvo que alguien lo declare público, y no al revés |
| Mediación completa | Todo acceso a todo objeto se comprueba, cada vez | No basta comprobar al iniciar sesión: GET /orders/:id comprueba que la orden es de quien la pide |
| Diseño abierto | La seguridad no debe depender de que el diseño sea secreto, sino de claves que sí se pueden proteger y cambiar | Que los ids de las órdenes sean difíciles de adivinar no reemplaza a la autorización |
| Separación de privilegios | Un mecanismo que exige dos llaves es más robusto que uno que exige una | Un reembolso grande lo pide una persona y lo aprueba otra |
| Mínimo privilegio | Cada programa y cada usuario opera con el menor conjunto de privilegios que necesita para su trabajo | El servicio de reportes se conecta con un usuario que solo puede leer |
El de valores por defecto seguros trae un argumento que vale la pena conocer. Un error en un mecanismo que da permisos tiende a fallar negando el acceso, y alguien se queja pronto. Un error en un mecanismo que quita permisos tiende a fallar permitiendo el acceso, y puede pasar inadvertido durante años. De los dos diseños, conviene el que falla haciendo ruido.
El de mediación completa trae, en el propio artículo, una advertencia que toca lo que hicimos en la primera sesión: toda propuesta de ganar rendimiento recordando el resultado de una comprobación de autorización debe mirarse con desconfianza, porque si los permisos cambian, lo recordado queda viejo. Es el dato viejo de la cache, con consecuencias de seguridad.
Mínimo privilegio, medido
En el contenedor del curso todo se conecta a PostgreSQL con el usuario
postgres, que es administrador. Para un curso es cómodo. Como diseño,
significa que cualquier error en cualquier parte del código, o cualquier
inyección como la de arriba, se ejecuta con permiso para todo. El ataque
anterior leyó pg_roles porque el usuario de la conexión podía.
make privilege crea un rol para un servicio de reportes, que solo necesita
leer, y prueba qué puede hacer
(security/least-privilege.sql):
$ make privilege
…
SET ROLE w06_reports;
SET
SELECT count(*) AS prestados FROM copies WHERE status = 'loaned';
 prestados
-----------
      2905
(1 row)

UPDATE copies SET status = 'available';
psql:security/least-privilege.sql:24: ERROR:  permission denied for table copies
DROP TABLE copies;
psql:security/least-privilege.sql:25: ERROR:  must be owner of table copies
SELECT rolname, rolpassword FROM pg_authid LIMIT 1;
psql:security/least-privilege.sql:26: ERROR:  permission denied for table pg_authid
RESET ROLE;
RESET
El rol lee lo que necesita. El UPDATE que habría marcado todos los
ejemplares como disponibles, el DROP TABLE y la lectura de las contraseñas
guardadas son rechazados por la base de datos. Lo importante es quién los
rechaza: no depende de que el código del servicio de reportes esté bien
escrito, ni de que alguien haya revisado todas sus consultas. La táctica es
limitar el acceso, y el principio que la justifica es el de mínimo
privilegio: limita el daño de un accidente o de un error, además del de un
ataque.
Eso contesta la sexta pregunta de repaso de la guía: un servicio de reportes que se conecta como administrador viola el mínimo privilegio, y lo corrige limitar el acceso con un rol propio. Lo que cuesta: un rol por servicio hay que crearlo, darle permisos cuando el esquema cambia y guardar su credencial en algún lado. Con un solo usuario para todo, ese trabajo no existe.
La seguridad es estructura
Las tácticas de la rama de resistir tienen algo en común: casi todas necesitan un lugar donde aplicarse. Autenticar y autorizar suponen un punto por el que pasan todos los pedidos. Limitar el acceso supone que los componentes están separados y que se sabe cuál necesita qué. Limitar la exposición supone poder contar cuántos componentes ven un dato. Ese lugar se llama límite de confianza (trust boundary): la línea que separa lo que el sistema controla y da por bueno de lo que no. Todo lo que cruza un límite de confianza se identifica, se autentica, se valida.
Las preguntas de seguridad de un arquitecto son por eso preguntas sobre la estructura:
- ¿Dónde están los límites de confianza? ¿Solo en el borde del sistema, o también entre sus partes?
- ¿Qué componentes ven los datos más sensibles? Cada uno de ellos hay que auditarlo, protegerlo y vigilarlo.
- ¿Quién puede hablar con quién, y con qué credenciales?
En Tinkuy. El número de la tarjeta entra por el servidor HTTP, pasa por el módulo de órdenes y llega al de pagos, que lo envía a la pasarela. Los tres viven en el mismo proceso y usan la misma conexión a la base de datos, de modo que un error en cualquier parte del monolito ocurre “al lado” de la tarjeta. Que solo el módulo de pagos hable con la pasarela ya reduce el código que hay que auditar. Sacarlo a un servicio propio lo reduce más, porque entonces el límite deja de ser una convención entre módulos y pasa a ser un proceso con sus propias credenciales: es la táctica separar entidades, y una razón más, que no es de rendimiento ni de despliegue, para la extracción de P4.
Error común. Tratar la seguridad como una capa que se agrega al final: “primero que funcione, después lo aseguramos”. Se puede agregar al final lo que no depende de la estructura: cifrar una conexión, cambiar una contraseña por defecto. No se puede agregar al final un límite de confianza, porque un límite de confianza es estructura: decide qué componentes existen, qué datos pasan por cada uno y con qué credenciales corre cada cual. Y la estructura, lo sabemos desde la semana 1, es lo que más cuesta cambiar.
Una táctica para un atributo cuesta otro
Al definir la táctica dijimos que apunta a un solo atributo y que su efecto sobre los demás hay que buscarlo. Con el catálogo recorrido, la tabla se puede llenar con casos de esta misma semana:
| Táctica | Atributo que mejora | Lo que cuesta |
|---|---|---|
| Diferir el enlace (variantes por configuración) | Modificabilidad | Capacidad de prueba: más combinaciones que comprobar. Y una configuración mal puesta es una falla nueva |
| Pool de conexiones | Rendimiento | Un parámetro que elegir y que depende del despliegue. Y los pedidos que no alcanzan conexión esperan en una cola que hay que vigilar |
| Cache con TTL | Rendimiento | Consistencia: datos viejos durante el TTL. Disponibilidad, si la cache caída tumba el endpoint. Y una pieza más que operar |
| Redundancia | Disponibilidad | Dinero (otra máquina) y consistencia: dos copias de un dato pueden no decir lo mismo (semana 10) |
| Retry | Disponibilidad ante faltas transitorias | Rendimiento y disponibilidad ante una sobrecarga; corrección, si la operación no se puede repetir |
| Degradar a la base de datos | Disponibilidad de las lecturas | Carga sobre el origen, justo cuando la cache falta |
| Autenticar, autorizar y cifrar cada llamada | Seguridad | Latencia en cada pedido, y fricción para quien usa y para quien desarrolla |
| Mínimo privilegio | Seguridad | Operación: roles y credenciales que crear, rotar y mantener al día con el esquema |
La columna de la derecha no es un argumento contra ninguna de estas tácticas. Es lo que hay que escribir junto a la decisión, con el formato de la semana 2: para cumplir tal escenario elegimos esto en vez de aquello; ganamos tanto; aceptamos tal costo. La próxima semana ese párrafo se convierte en un documento con nombre, el ADR.
Idea clave. No hay tácticas gratis. Si al elegir una no encuentran qué cuesta, todavía no terminaron de analizarla.
El código de la semana
Todo está en code/week-06/ y se usa dentro del contenedor del curso.
| Carpeta o archivo | Qué contiene |
|---|---|
db/schema.sql, db/seed.sql |
Las tablas de Qillqa (branches, titles, copies) y sus datos, sin números al azar |
src/variant.ts |
Las variantes y cómo se leen del entorno |
src/db.ts |
La interfaz Db y sus dos implementaciones: una conexión por consulta, y un pool |
src/titles.ts |
La lista de títulos, con N+1 y con una sola consulta; el detalle y el préstamo |
src/cache.ts |
Cache-aside sobre Redis, con las dos respuestas a una cache caída |
src/app.ts, src/main.ts |
El servidor HTTP de una variante, y el programa que lo levanta |
load/titles.js, load/endpoints.js |
Los dos scripts de k6: carga sobre la lista, y latencia por endpoint (para Qillqa y para Tinkuy) |
tools/ |
measure.ts (mide variantes y escribe la tabla), connect-cost.ts, db-curve.ts, stale.sh y cache-down.ts |
errors/ |
Tres ejemplos que fallan a propósito: el JOIN que pierde un título, el SQL concatenado y el cliente de Redis con su cola |
security/least-privilege.sql |
El rol que solo puede leer |
results-template.md, security-checklist.md |
La tabla de resultados y la lista de preguntas de seguridad del laboratorio |
test/ |
Las pruebas, que comprueban lo que afirma este capítulo |
Los comandos:
| Comando | Qué hace |
|---|---|
make |
Crea la base de datos arq_w06 con sus datos |
make serve |
Levanta Qillqa en el puerto 3600 con la variante del entorno |
make load, make endpoints |
k6 contra el Qillqa de make serve |
make connections |
Las conexiones de PostgreSQL, cada segundo |
make measure V="baseline single" |
Levanta cada variante, la mide y escribe su fila |
make table, make curve |
Las tablas de este capítulo |
make connect-cost, make db-curve |
Las dos mediciones directas sobre PostgreSQL |
make stale, make cache-down, make offline-queue |
Los experimentos de la cache |
make sql-concat, make privilege |
Los dos ejemplos de seguridad |
make tinkuy-up, make tinkuy-endpoints, make tinkuy-explain, make tinkuy-down |
Una copia del Tinkuy inicial en build/tinkuy, para medirla |
make test |
Revisa los tipos y corre las pruebas |
make clean |
Borra las bases de datos, las claves w06:* de Redis y build/ |
Las variables de make serve son DB_MODE (connect o pool),
POOL_SIZE, LIST_MODE (nplus1 o single), CACHE (off o redis),
CACHE_TTL_S y CACHE_ON_ERROR (fail o degrade). Sin ninguna, el
servicio arranca en la línea de base: sin pool, con N+1 y sin cache.
make test no necesita nada corriendo: usa su propia base de datos y sus
propias claves de Redis, y levanta las variantes dentro del proceso de
pruebas. La prueba de redis-down.test.ts mata Redis y lo vuelve a iniciar,
así que no conviene correrla mientras otra terminal del mismo contenedor
mide algo con cache.
$ make test
tsc -p .
redis listo.
W06_DB=arq_w06_test W06_PREFIX=w06test: node --test --test-concurrency=1 "test/*.test.ts"
✔ el primer pedido calcula y guarda (miss); el segundo sale de Redis (hit) sin tocar la base de datos (360.616501ms)
✔ cada filtro tiene su entrada: la lista de Cusco no sale de la entrada de la lista completa (82.494708ms)
✔ después de un préstamo, la lista en cache sigue mostrando el número viejo hasta que vence el TTL (1133.496459ms)
✔ todas las variantes responden lo mismo a GET /titles (3105.092334ms)
…
✔ la lista tiene los 31 títulos, también el que no tiene ejemplares (740.148376ms)
✔ N+1 hace 32 consultas por pedido (1 + 31 títulos) y la versión de una consulta hace 1 (39.36625ms)
✔ errors/list-inner-join.ts no es equivalente: pierde el título sin ejemplares (4.212042ms)
✔ sin pool, cada consulta abre una conexión: un pedido a GET /titles abre 32 (774.505293ms)
✔ con un pool de 2, 40 pedidos a la vez se atienden con 2 conexiones y PostgreSQL nunca ve más (925.753167ms)
✔ el pool cierra sus conexiones al cerrar el servicio (98.089166ms)
✔ con Redis caído, degrade responde desde la base de datos y fail responde 500; al volver Redis, la cache vuelve (683.425583ms)
✔ una consulta armada concatenando texto devuelve lo que el atacante quiera; la parametrizada, nada (95.816001ms)
✔ mínimo privilegio: el rol de reportes puede leer y no puede modificar ni borrar (129.74025ms)
✔ percentil por rango más cercano (1.877ms)
ℹ tests 18
ℹ pass 18
ℹ fail 0
…
ℹ duration_ms 15351.195007
Cada prueba lleva en el nombre la afirmación que comprueba. La que más
conviene leer antes del laboratorio es
test/equivalence.test.ts:
levanta siete variantes a la vez y exige que respondan byte por byte lo
mismo. Es la red que permite cambiar la capa de datos sin miedo, y es lo
primero que les va a hacer falta cuando apliquen estas tácticas a su propio
sistema.
Laboratorio: pool de conexiones y cache, medir antes y después
El laboratorio se hace en parejas, sobre su copia de Tinkuy (el
repositorio del equipo), con el material de
code/week-06/ como referencia. En este capítulo cada
táctica se aplicó a Qillqa; en el laboratorio la aplican ustedes a un sistema
más grande, con transacciones y con más endpoints, donde las mismas ideas
piden decisiones que aquí no hizo falta tomar. Lleven la tabla de
results-template.md desde el primer
paso. No hay entrega esta semana, pero lo que midan y decidan es el punto de
partida de P2.
Necesitan tres terminales en el mismo contenedor: Tinkuy y su pasarela, la carga, y una para mirar.
Paso 1: la línea de base. Con su Tinkuy recién levantado (make db,
make gateway, make start), corran make load-browse tres veces y anoten
p50, p95, throughput y errores de cada corrida. Durante una de ellas, miren
cuántas conexiones tiene PostgreSQL: make connections, desde
code/week-06/, las muestra cada segundo. Lo que este paso da es el número
contra el que se compara todo lo demás, y una idea de cuánto varía solo: si
entre dos corridas iguales el p95 cambia 20 %, una mejora de 10 % en un paso
posterior no es una mejora.
Paso 2: dónde se va el tiempo. Corran el script por endpoint contra su
Tinkuy (TARGET=tinkuy k6 run --quiet load/endpoints.js, o
make tinkuy-endpoints) y el EXPLAIN ANALYZE de la consulta de
disponibilidad (make tinkuy-explain). Comparen las dos cosas: lo que tarda
el endpoint más lento y lo que tarda una de sus consultas. Luego lean el
código de ese endpoint y cuenten cuántas consultas y cuántas conexiones usa
un pedido. Antes de cambiar nada, escriban en la tabla cuál creen que es
el cuello de botella, qué táctica le corresponde y qué esperan ver si tienen
razón. Este es el paso que separa medir de adivinar.
Paso 3: mantener un pool. Cambien la capa de datos de su Tinkuy para que
use un pg.Pool. La lectura complementaria de node-postgres muestra la API.
Hay dos cosas que Qillqa no tiene y Tinkuy sí: las transacciones, que
necesitan que varias consultas vayan por la misma conexión, y las pruebas,
que necesitan que el proceso termine. Midan con tamaños 2, 10 y 50, y
dibujen el p95 contra el tamaño. Este paso muestra las dos caras del pool:
lo que ahorra y lo que limita. Miren otra vez make connections.
Paso 4: reducir el costo por pedido. Reescriban la lista de eventos para que obtenga la disponibilidad de todos los eventos en una sola consulta. Antes de medir, comprueben que la respuesta no cambió: las pruebas de Tinkuy tienen que seguir pasando, y conviene comparar la respuesta completa de antes y de después. Este paso muestra cuánto del tiempo era trabajo que no hacía falta.
Paso 5: mantener una copia de los datos. Guarden la respuesta de
GET /events en Redis con un TTL de cinco segundos y midan. Después compren
una entrada y consulten la lista y el detalle del evento durante esos cinco
segundos. Escriban el trade-off con el formato de la semana 2: qué ve el
comprador, para qué uso de la lista eso es aceptable y para cuál no.
Paso 6: la tabla. Completen una fila por táctica: p95, throughput, qué mejoró y qué costó. Respondan con sus números: ¿cuál dio más por menos? Y una pregunta que la tabla no responde sola: si solo pudieran quedarse con dos de las tres, ¿cuáles?
Paso 7: la cache se cae. Con la carga corriendo, ejecuten
svc kill redis. Anoten qué le pasa a GET /events: ¿errores?, ¿pedidos
que no vuelven? Lean El cliente que espera en silencio si el resultado los
sorprende. Cambien su código para que una cache caída degrade a consultar la
base de datos, repitan el experimento y llenen la sección La cache caída
de la tabla. Vuelvan a iniciar Redis con svc start redis. Este paso
muestra que agregar una pieza para el rendimiento cambió la disponibilidad,
y que recuperarla fue una decisión aparte.
Paso 8: seguridad. Revisen su Tinkuy con
security-checklist.md (o con el
cuestionario del capítulo 11 del libro, si lo tienen). Para cada táctica,
busquen la evidencia en el código, no en la memoria. Anoten las tres
tácticas ausentes que más importan, ordenadas por el daño que evitarían, y
para la primera escriban el escenario de seguridad completo.
Resumen
- Una táctica es una decisión de diseño que influye sobre la respuesta a un estímulo de un atributo de calidad. Es más pequeña que un patrón, que empaqueta varias, y apunta a un solo atributo: su efecto sobre los demás es el trade-off.
- El orden de trabajo es escenario, medición, táctica, medición. La táctica correcta para un cuello de botella que no es el que limita no cambia nada.
- Modificabilidad: aumentar la cohesión (dividir un módulo, redistribuir responsabilidades), reducir el acoplamiento (encapsular, usar un intermediario, abstraer servicios comunes, restringir dependencias) y diferir el enlace. Cuanto más tarde se enlaza, más barato el cambio y más cara la infraestructura.
- Rendimiento: el tiempo de un pedido es tiempo de procesamiento más tiempo bloqueado. Las tácticas controlan la demanda (limitar la tasa de llegada, limitar la respuesta, priorizar, reducir el costo de cada pedido, acotar el tiempo de ejecución) o administran los recursos (más recursos, concurrencia, copias del cómputo, copias de los datos, colas acotadas, planificación).
- Un pool de conexiones ahorra el costo de abrir una conexión en cada consulta y pone un tope a la concurrencia sobre la base de datos. Más grande no es más rápido: pasado el punto en que la base de datos tiene todos sus recursos ocupados, más conexiones solo reparten el mismo trabajo entre más competidores.
- Quitar un N+1 reduce el costo de cada pedido, y suele rendir más que una cache encima. Una cache ahorra latencia y carga, y abre el dato viejo y la invalidación. Una cache sobre una consulta mal escrita la esconde, no la arregla: vuelve en cada fallo de cache.
- Disponibilidad: una falta es la causa, una falla es lo que ve el usuario. Las tácticas detectan (un timeout es la más simple), recuperan (redundancia, retry, degradación) y previenen (transacciones, sacar de servicio, aumentar el conjunto de competencias). Sin detección no hay recuperación.
- Degradar es seguir ofreciendo lo esencial. Qué es esencial es una decisión de negocio. El retry recupera de faltas transitorias, y puede duplicar una operación y multiplicar la carga.
- Seguridad: confidencialidad, integridad y disponibilidad. Las tácticas detectan, resisten, reaccionan y recuperan. Los límites de confianza son estructura, y por eso no se agregan al final.
- No hay tácticas gratis: lo que una gana en un atributo lo paga en otro, y eso se escribe junto a la decisión.
Ejercicios
-
Para cada decisión, digan si es una táctica, un patrón o un estilo, y por qué: (a) poner un timeout de 2 segundos en la llamada a la pasarela; (b) organizar el sistema en servicios que se comunican por eventos; (c) réplicas de lectura con failover automático; (d) prohibir con
depcruisequehttp/importe dedb.ts. Para la que sea un patrón, nombren dos tácticas que empaqueta y el atributo de cada una. -
Un pedido tarda 400 ms: 30 ms de procesamiento y 370 ms esperando una conexión a la base de datos. (a) ¿Qué grupo de tácticas de rendimiento aplica, y cuál táctica en particular? (b) Alguien propone duplicar los servidores de aplicación. Expliquen qué pasaría con los 370 ms, y en qué caso el cambio empeoraría las cosas. (c) ¿Qué medición harían para confirmar su respuesta antes de tocar nada?
-
Corran
make curvetres veces en su máquina y anoten, para cada tamaño de pool, la mediana de los tres p95. (a) ¿A partir de qué tamaño deja de mejorar? (b) Corranmake db-curvey comparen ese tamaño con el punto en que las consultas por segundo dejan de subir. (c) Su servicio va a correr con cuatro instancias contra una base de datos conmax_connectionsde 100, que también usan un proceso de reportes y las herramientas de administración. ¿Qué tamaño de pool le pondrían a cada instancia? Muestren la cuenta. -
En
errors/list-inner-join.tshay un intento de quitar el N+1 que pierde un título. (a) Expliquen qué fila se pierde y en qué paso de la consulta. (b) Cambien solo elJOINpor unLEFT JOIN, sin tocar elWHERE, y corran la consulta enpsql: ¿se arregló? ¿Por qué? (c) ¿Qué dato de ejemplo tendría que existir para que una prueba distinga la versión correcta de una que solo falla cuando todos los ejemplares de un título están prestados? -
Levanten Qillqa con
DB_MODE=connect LIST_MODE=nplus1 CACHE=redisy corranmake loadmientras miranmake connectionsen otra terminal. (a) Describan lo que pasa con las conexiones cada cinco segundos. (b) Expliquen por qué el p50 no lo muestra y qué columna del resumen de k6 sí. (c) Propongan dos formas de evitar que muchos pedidos recalculen la misma entrada a la vez, y digan qué cuesta cada una. No hace falta implementarlas: la semana 11 las desarrolla. -
La lista de Qillqa se guarda en la cache con una clave por ciudad. (a) Después de un préstamo en Cusco, ¿cuántas entradas de la cache quedaron con un dato viejo? (b) Alguien propone borrar la entrada al registrar el préstamo, en vez de esperar el TTL. ¿Qué entradas hay que borrar? ¿Qué módulo tendría que conocer las claves de la cache, y qué táctica de modificabilidad usarían para que ese conocimiento no se riegue? (c) ¿Qué pasa si el préstamo se confirma en la base de datos y el borrado de la clave falla?
-
Den una táctica de detección, una de recuperación y una de prevención para cada una de estas faltas de Tinkuy, y digan qué cuesta cada una: (a) el servidor de correo tarda 30 segundos en responder; (b) el proceso de Tinkuy se queda sin memoria y muere durante una apertura de ventas.
-
Un navegador reintenta hasta 2 veces, el API gateway hasta 3 y el servicio de órdenes hasta 3 al llamar a pagos (el número incluye el primer intento). (a) En el peor caso, ¿cuántas llamadas recibe pagos por un solo clic? (b) Si pagos atiende 100 pedidos por segundo y recibe 120, describan segundo a segundo qué pasa con la carga que recibe, suponiendo que todo lo rechazado se reintenta. (c) ¿En cuál de las tres capas dejarían el retry, y por qué en esa?
-
Con
make cache-downvieron las dos respuestas a una cache caída. (a) Midan Qillqa sin cache y con cache a la carga demake load, y calculen cuántas consultas por segundo recibiría PostgreSQL si la cache se cayera en ese momento conCACHE_ON_ERROR=degrade. (b) Escriban un escenario de disponibilidad, con sus seis partes, para el quedegradesea la decisión correcta, y otro para el que lo seafail. (c) Propongan una tercera opción, intermedia, y digan qué táctica del catálogo es. -
Un servicio de reportes de Tinkuy se conecta a la base de datos con el usuario administrador y arma una de sus consultas concatenando el nombre de la ciudad que llega en la URL. (a) ¿Qué principios de Saltzer y Schroeder se violan, y qué táctica corrige cada violación? (b) Con
make sql-concatymake privilegea la vista, expliquen qué puede hacer un atacante con cada una de las dos correcciones aplicada sola. (c) ¿Por qué conviene aplicar las dos, si cualquiera detiene el ataque del ejemplo? -
Dibujen los límites de confianza de Tinkuy v0: qué procesos hay, qué datos cruzan cada límite y con qué credenciales. Después dibujen los de un Tinkuy con los pagos en un servicio propio. Para cada dibujo, cuenten cuántos componentes ven el número de la tarjeta, y escriban qué táctica de seguridad hizo posible la diferencia y qué atributo la pagó.