Apuntes · Capítulo 7Estilos, tácticas y decisiones
Decidir, documentar y evaluar una arquitectura
Decidir, documentar y evaluar una arquitectura
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): Para quién se documenta; de El sistema de la semana: Yupana, todo; de ADR: una decisión, un documento, El formato de Nygard, Las alternativas consideradas y Un ADR no se reescribe; y de ATAM, Los nueve pasos y Lo que produce.
- En clase: Sesión A: Para quién se documenta, Vistas, C4: cuatro niveles de zoom, arc42: el documento completo y ADR: una decisión, un documento. Sesión B: Diseñar con un método: ADD, Evaluar antes de construir, ATAM, Una versión liviana para un equipo pequeño y Risk storming. Laboratorio: Laboratorio: un ATAM reducido sobre Tinkuy.
- Después de clase: el Resumen y los Ejercicios. Antes de entregar P2, relean El template del curso y su revisor y Dos errores al escribir un ADR. Opcionales: Los diagramas complementarios: dinámico y de despliegue, Risk storming y El código de la semana.
Llevamos seis semanas tomando decisiones. En la 3 y la 4 decidieron dónde van los límites entre los módulos de Tinkuy y qué reglas de dependencia los protegen. En la 5 compararon estilos con escenarios en la mano. La semana pasada eligieron tácticas (un pool de conexiones, una consulta en vez de muchas, una cache con TTL) y midieron antes y después. Cada una de esas decisiones tuvo alternativas, una razón y un costo, y casi todo eso está hoy en un solo lugar: la memoria de quienes estuvieron en el laboratorio.
Esta semana no agrega decisiones nuevas. Trata de tres cosas que se hacen con las decisiones:
- Documentarlas, para que alguien que no estuvo pueda entender el sistema y por qué es así. Veremos qué es una vista, los cuatro niveles de C4, el template arc42 y el ADR, el documento de una decisión.
- Tomarlas con un método, en vez de empezar por la tecnología que está de moda. Veremos el diseño guiado por atributos (ADD).
- Evaluarlas antes de construir, o antes de seguir construyendo. Veremos ATAM, el método de evaluación más conocido, y una versión reducida que cabe en una sesión de laboratorio.
Las tres dependen de lo mismo: los escenarios de calidad de la semana 2. Un ADR sin escenario no dice para qué se decidió; un diseño sin escenarios no sabe cuándo terminó; una evaluación sin escenarios es una discusión de gustos.
Como el laboratorio evalúa el Tinkuy de cada pareja, y lo que encuentren ahí es trabajo suyo, el capítulo usa otro sistema para todos sus ejemplos: Yupana, el juez de tareas de programación de una facultad. Sus diagramas, sus ADR, su documento de arquitectura y su evaluación están completos en la carpeta de la semana.
Lectura. Sesión A: Software Architecture in Practice, cap. 22 Documenting an Architecture; Michael Nygard, Documenting Architecture Decisions (2011); Simon Brown, C4: diagramas. Complementarias: MADR, un template de ADR con alternativas consideradas, y adr.github.io; arc42, las doce secciones con ejemplos; Richards y Ford, Fundamentals of Software Architecture (2.ª ed.), cap. 21 Architectural Decisions y cap. 23 Diagramming Architecture.
Sesión B: Software Architecture in Practice, cap. 20 Designing an Architecture y cap. 21 Evaluating an Architecture; Kazman, Klein y Clements, ATAM: Method for Architecture Evaluation (SEI, 2000), secciones 3 y 7 (PDF). Complementarias: Fundamentals of Software Architecture (2.ª ed.), cap. 22 Analyzing Architecture Risk; Simon Brown, Risk-storming.
El código de este capítulo está en code/week-07/. Esta semana casi todo son documentos y los programas que los revisan; las salidas que se muestran son de ejecuciones reales en el contenedor del curso.
Para quién se documenta
Cuatro lectores
La documentación de una arquitectura no se escribe para cumplir. Se escribe para que alguien la lea, y ese alguien casi nunca es quien la escribió. Hay por lo menos cuatro lectores, y cada uno llega con una pregunta distinta:
| Lector | Qué quiere saber | Qué necesita ver |
|---|---|---|
| Quien construye | Qué me toca hacer, con qué puedo contar y qué no puedo tocar | Los módulos con sus interfaces y sus reglas de dependencia |
| Quien llega al equipo dentro de un año | Por qué esto está así, y si puedo cambiarlo | Las decisiones con su contexto y lo que se descartó |
| Quien evalúa | Si este diseño cumple sus escenarios | Lo que corre, cómo se comunica y qué pasa cuando algo falla |
| Quien opera | Qué tiene que estar corriendo, dónde, y qué hago si se cae | Los procesos, las máquinas y de qué depende cada uno |
De ahí sale el error más frecuente al documentar: el diagrama único. Una sola figura con las carpetas del código, los procesos, las tablas, las máquinas y las pantallas, unidas por flechas que a veces significan “llama a”, a veces “contiene” y a veces “se despliega en”. Tiene de todo y no responde ninguna de las cuatro preguntas, porque para responder una hay que adivinar qué significa cada flecha.
Idea clave. Antes de dibujar o de escribir, digan quién va a leer y qué pregunta trae. La documentación de una arquitectura es un conjunto de respuestas a preguntas de lectores distintos. No es una descripción completa del sistema: la descripción completa es el código.
Lo que el código no dice
Se podría objetar que el código ya lo dice todo. Dice qué hace el sistema, con precisión absoluta. No dice tres cosas:
- Por qué. En el código de Tinkuy se ve que el cobro ocurre dentro de la transacción de la compra. No se ve si alguien lo decidió, contra qué alternativa, ni qué habría que saber para cambiarlo.
- Lo que no está. Las alternativas descartadas no dejan rastro en el código. Sin ellas, cada persona nueva las vuelve a proponer.
- El conjunto. Qué procesos existen y quién le habla a quién se puede reconstruir leyendo todo. Un diagrama de contenedores lo dice en un minuto.
Trade-off. Documentar cuesta dos veces: al escribir y cada vez que el sistema cambia. Un documento que ya no coincide con el sistema es peor que ninguno, porque alguien le va a creer. La alternativa, no documentar, funciona mientras el equipo es pequeño, estable y se sienta junto. Por eso la regla de esta semana es escribir poco: lo que alguien va a leer, cerca del código, en un formato que se pueda revisar en el mismo cambio que lo vuelve falso.
Vistas
Una vista es una estructura para un lector
En la semana 1 definimos la arquitectura como un conjunto de estructuras, y vimos tres tipos: de módulos (las unidades de código y sus dependencias), de componentes y conectores (lo que existe mientras el sistema corre) y de asignación (cómo se reparte el software en máquinas, carpetas y equipos).
Una vista (view) es la representación de una de esas estructuras, hecha para un lector. La estructura está en el sistema; la vista está en el documento. El mismo sistema tiene muchas estructuras, y de cada una se pueden escribir vistas con más o menos detalle.
Los tres tipos de estructura dan tres tipos de vista, y cada uno responde preguntas distintas:
| Tipo de vista | Qué muestra | Preguntas que responde | Lector típico |
|---|---|---|---|
| De módulos | Unidades de código, qué contiene cada una y de qué depende | ¿Qué toca este cambio? ¿Quién puede importar a quién? | Quien construye |
| De componentes y conectores | Procesos, almacenes de datos y los caminos por los que se hablan | ¿Cuánto tarda? ¿Qué pasa si esto se cae? ¿Por dónde entra un atacante? | Quien evalúa |
| De asignación | En qué máquina corre cada cosa, qué equipo mantiene cada módulo | ¿Qué desplegamos? ¿Qué comparte hardware? | Quien opera |
La propuesta del libro del curso es documentar las vistas que sean
relevantes y, aparte, lo que aplica a más de una: cómo se relacionan entre
sí, las decisiones que las atraviesan, el glosario. Lo segundo importa
porque las vistas no son independientes. El módulo orders de una vista de
módulos corre dentro de algún proceso de la vista de componentes y
conectores, y ese proceso corre en alguna máquina de la vista de asignación.
Quien lee tiene que poder pasar de una a otra.
Lo que lleva una vista
Una vista no es solo un dibujo. Para que alguien la pueda usar sin tener al autor al lado, lleva cuatro cosas:
- El diagrama principal: los elementos y sus relaciones. En el curso, las dos tablas del formato de la semana 1.
- El catálogo de elementos: qué es cada caja, de qué es responsable, qué interfaz ofrece y cómo se comporta. El diagrama dice que existe un contenedor llamado API; el catálogo dice qué recibe, qué responde y qué promete.
- La leyenda: qué significa cada forma, cada color y cada tipo de flecha.
- La justificación: por qué la estructura es así. En el curso, un enlace a los ADR que le dieron forma.
Error común. El diagrama sin leyenda. Si una flecha puede significar “llama a”, “importa” o “le envía datos” y el diagrama no dice cuál, cada lector elige una, y eligen distinto. Un dibujo así no es documentación: son cajas y flechas con un significado privado, que solo entiende quien lo dibujó, y solo durante unas semanas.
El formato de diagramas del curso resuelve la leyenda por construcción: cada caja tiene una columna Tipo con un valor de una lista cerrada, y cada flecha tiene las columnas Qué viaja y Protocolo. No hay nada que interpretar. Es una de las razones por las que usamos tablas.
Qué vistas elegir
No hay una lista fija. Se listan los stakeholders que van a leer, se escribe para cada uno las dos o tres preguntas que trae, y se elige la vista que responde cada pregunta. Lo que nadie pidió no se escribe.
Para un equipo pequeño el resultado suele ser el mismo: una vista de componentes y conectores a grano grueso (qué corre y quién le habla a quién), una vista de módulos del proceso principal, y una nota sobre dónde se despliega. Es, casi exactamente, lo que propone C4.
El sistema de la semana: Yupana
Yupana es el nombre del ábaco de los incas. Aquí es el juez de tareas de programación de una facultad: un estudiante sube el archivo con su solución, el sistema lo compila, lo ejecuta contra casos de prueba que el estudiante no ve y le devuelve un veredicto: aceptado, respuesta incorrecta, tiempo excedido, error de compilación o error en ejecución. Lo usan seis cursos. Lo mantienen dos jefes de práctica a tiempo parcial, y corre en una máquina virtual de la facultad con cuatro núcleos.
Es un sistema inventado para la clase, con una propiedad útil: es pequeño y tiene los tres problemas clásicos a la vez. Recibe un pico de carga predecible (todos envían la última media hora antes del cierre), ejecuta código que no es suyo (el de los estudiantes), y lo opera un equipo mínimo.
Sus escenarios de calidad están en
scenarios.md, con las
seis partes de la semana 2. El utility tree los resume:
| Atributo | Refinamiento | Escenario (resumen) | Negocio | Técnica |
|---|---|---|---|---|
| Rendimiento | Espera del veredicto | E1. 600 envíos en los 30 min antes de un cierre: confirmación en 1 s o menos (p95) y veredicto en 2 min o menos (p95) | A | A |
| Seguridad | Aislamiento del código enviado | E2. Un programa intenta leer fuera de su carpeta, usar la red y crear procesos sin límite: 0 bytes leídos, 0 conexiones, 0 envíos ajenos afectados | A | A |
| Disponibilidad | Falla propia | E3. Un worker muere a mitad de una calificación: veredicto en 5 min o menos, 0 envíos perdidos, 0 con dos veredictos | A | A |
| Modificabilidad | Lenguajes | E4. Agregar Java: 3 días-persona o menos, 1 módulo y la imagen del sandbox | M | B |
| Disponibilidad | Falla de un sistema externo | E5. El proveedor de identidad no responde 15 min: quien tiene sesión sigue enviando; error de inicio de sesión en 3 s o menos | A | M |
Los tres escenarios (A, A) son E1, E2 y E3. Van a aparecer en todo el capítulo: en el contexto de los ADR, como objetivo de una iteración de diseño y como entrada de la evaluación.
Una palabra del ejemplo necesita cuidado. Un sandbox es un entorno aislado donde se ejecuta un programa del que no se confía: sin red, sin acceso a los archivos del sistema y con límites de CPU, memoria y número de procesos. Y un worker, aquí, es un proceso que toma trabajos pendientes y los ejecuta, separado del proceso que atiende a las personas.
C4: cuatro niveles de zoom
Contexto y contenedores, otra vez
En la semana 1 dibujaron Tinkuy con los dos primeros niveles de C4, el modelo de Simon Brown. Los repasamos con Yupana, porque los otros dos niveles se apoyan en ellos.
El diagrama de contexto muestra el sistema como una sola caja, con las
personas que lo usan y los sistemas externos con los que habla. El de Yupana,
en c4/context.md, tiene
cinco elementos: dos personas (estudiante y docente), Yupana y dos sistemas de
la universidad, el proveedor de identidad y el sistema de matrícula. Responde
tres preguntas: dónde termina el sistema, quién lo usa y de quién depende. Su
lector es cualquiera, también quien no programa.
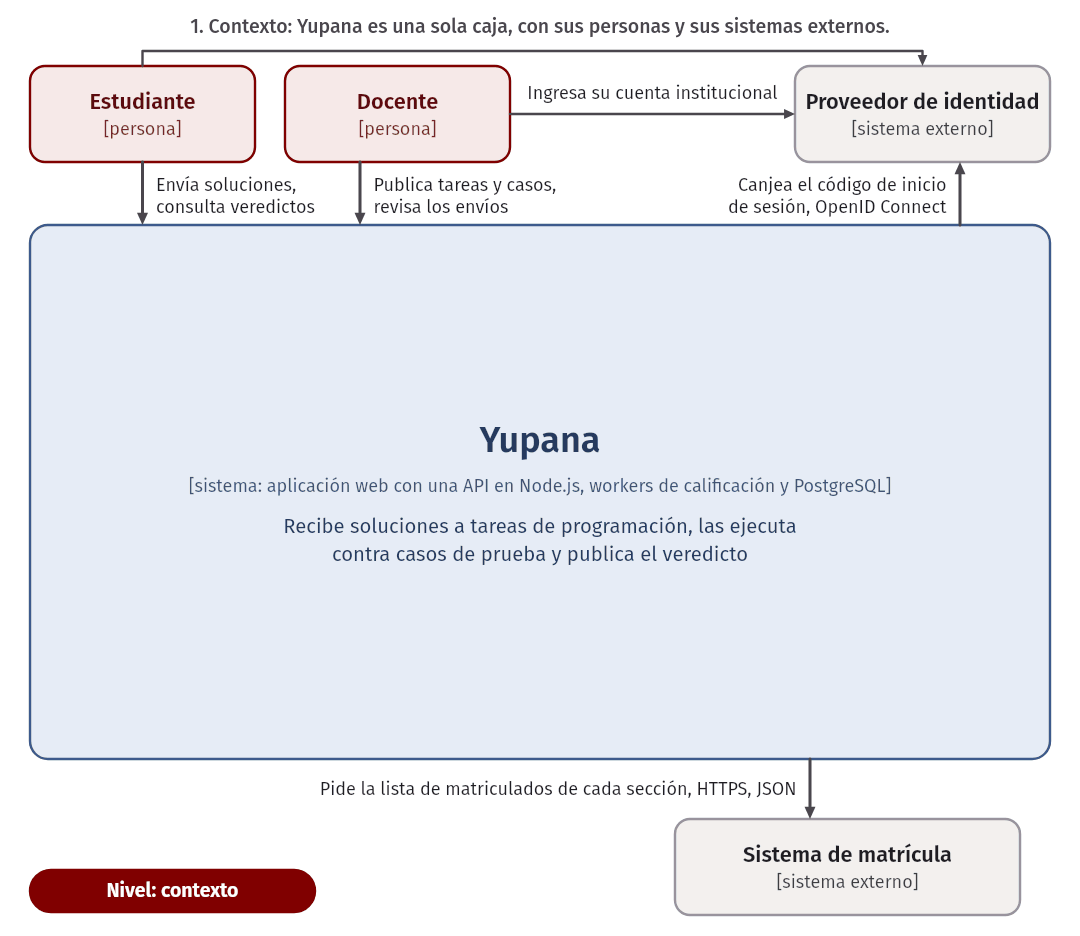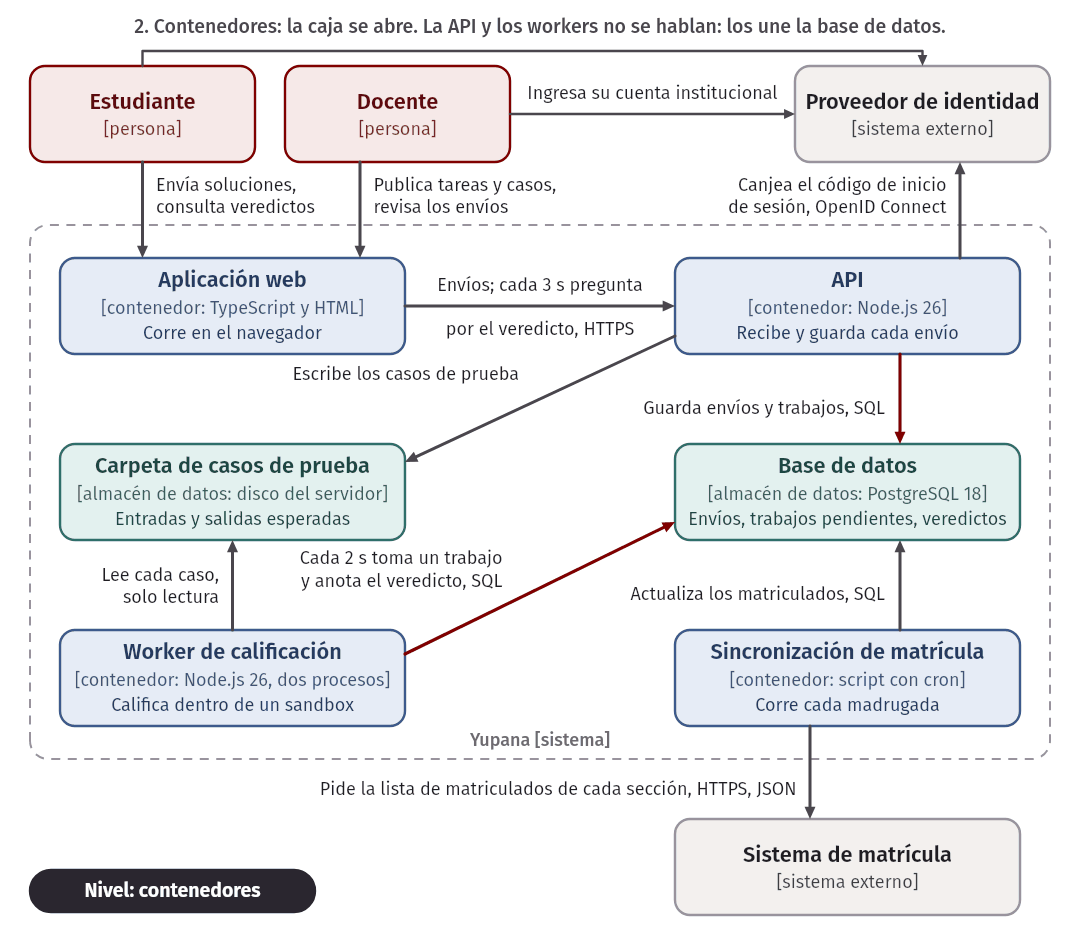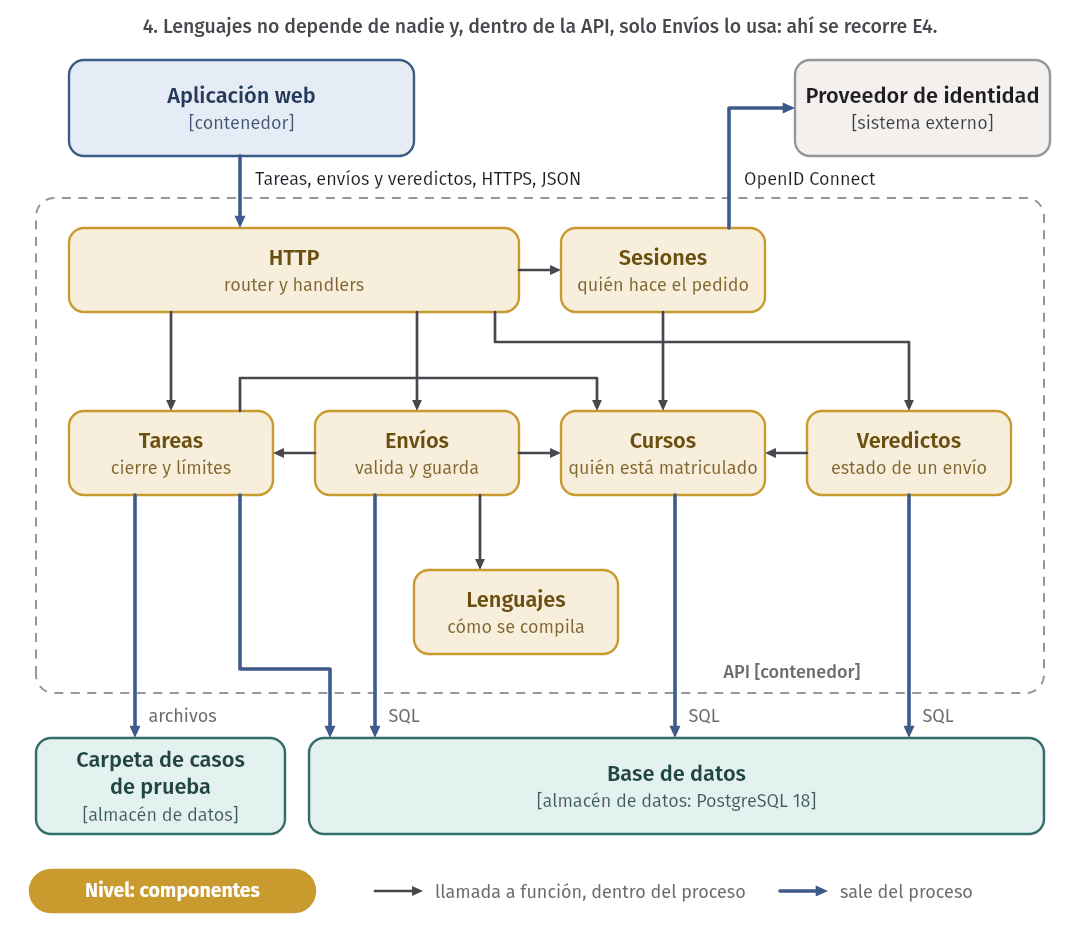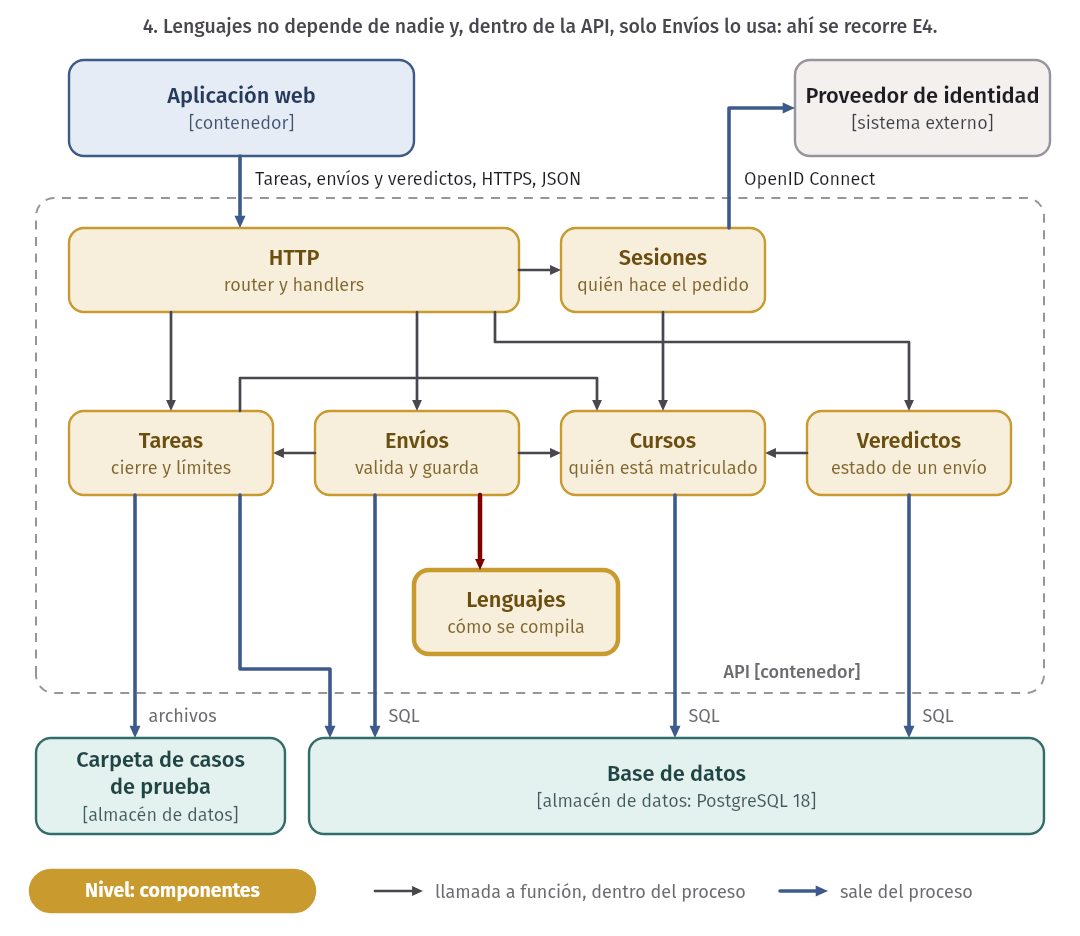
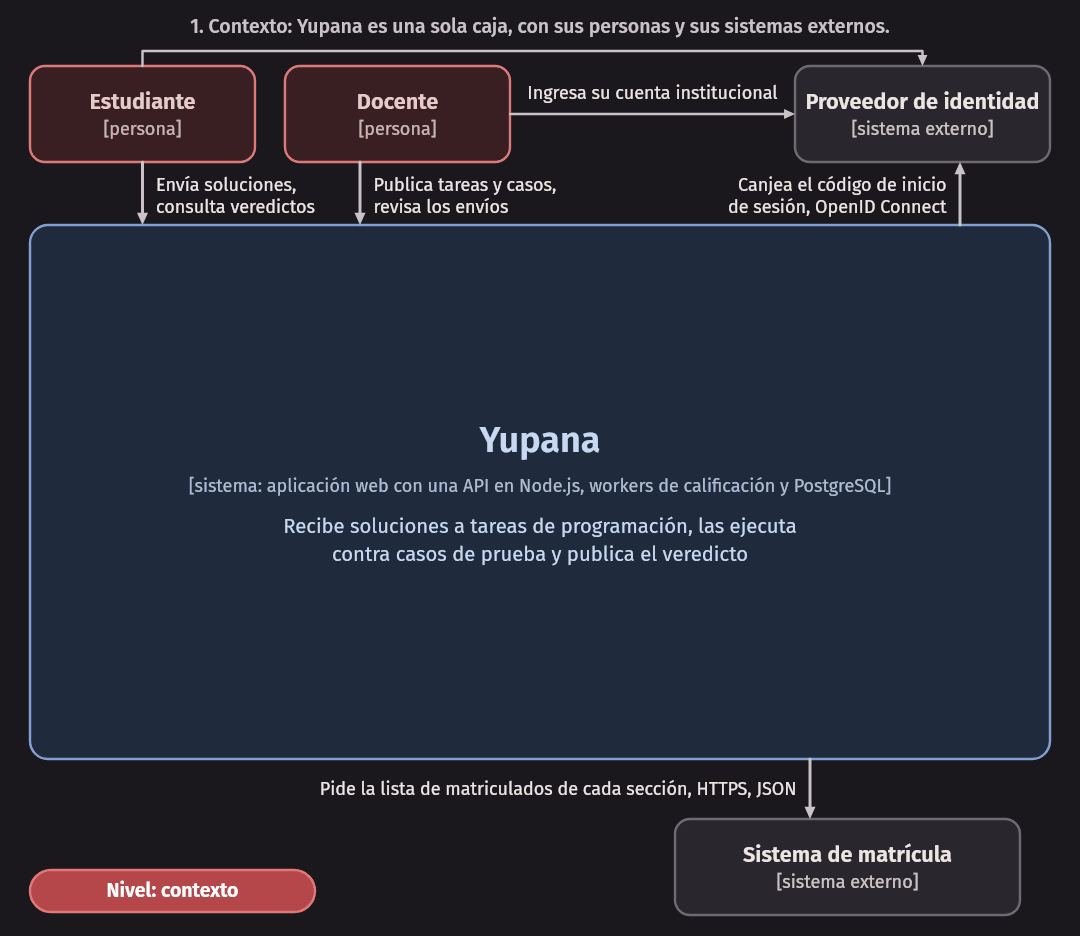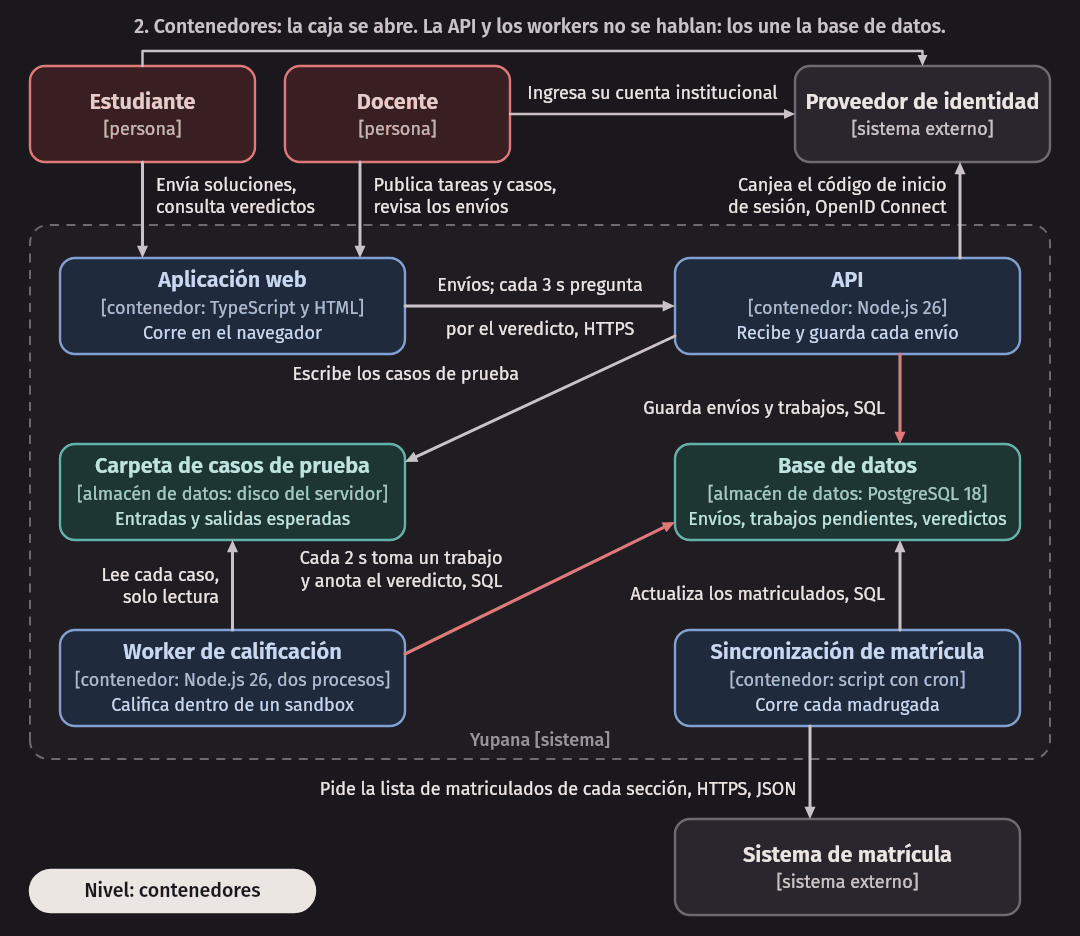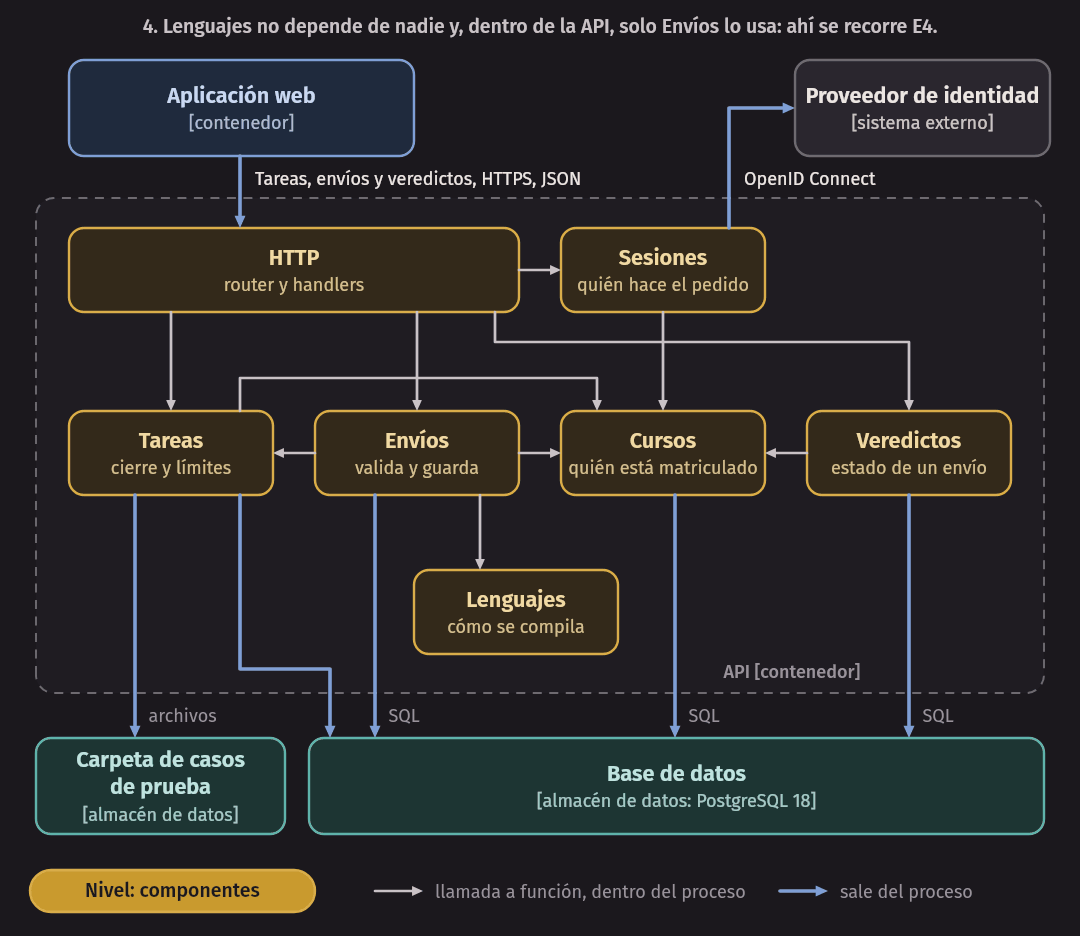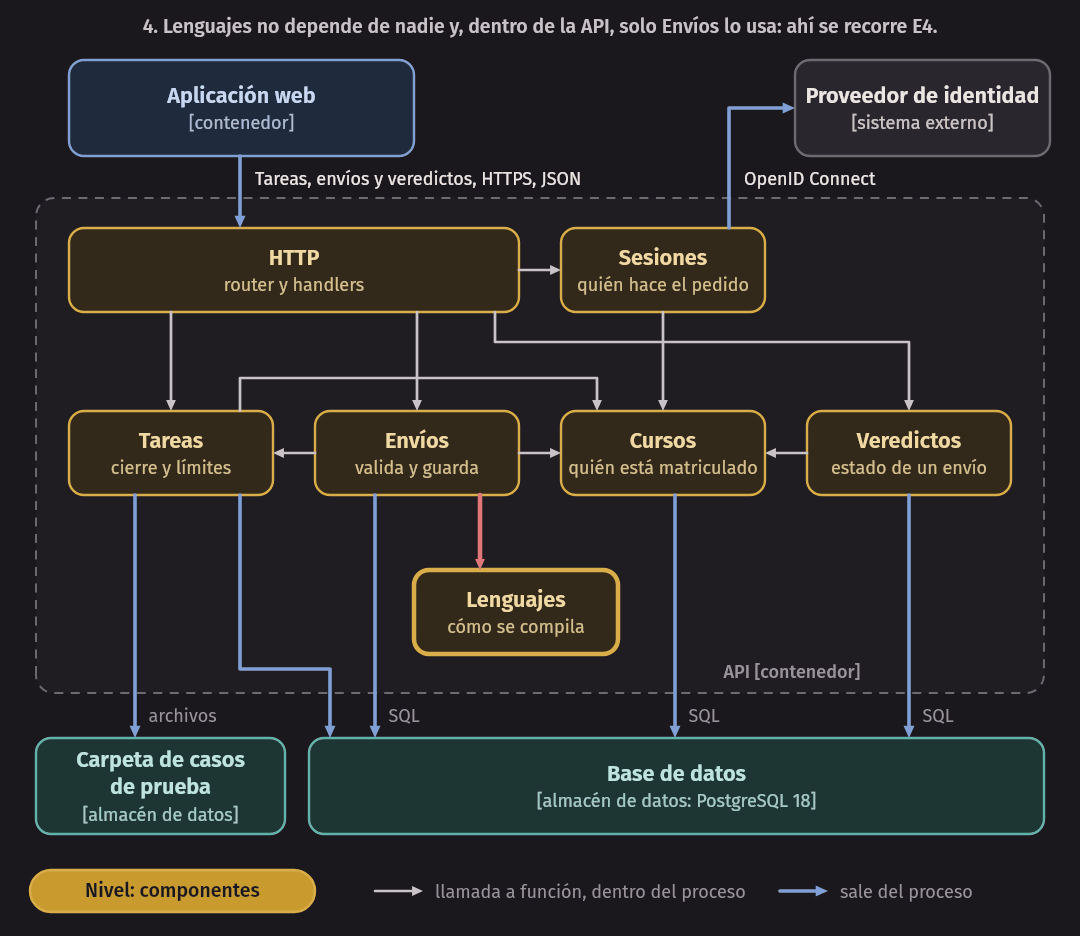
El diagrama de contenedores abre la caja y muestra lo que tiene que
estar corriendo o existir para que el sistema funcione. En Yupana
(c4/containers.md),
dentro de la caja hay seis cosas:
| Nombre | Tipo | Descripción | Tecnología |
|---|---|---|---|
| Aplicación web | contenedor | Las páginas de tareas, de envío y de veredictos; corre en el navegador de cada persona | TypeScript y HTML, sin framework |
| API | contenedor | Recibe cada envío, lo guarda y lo deja pendiente de calificar; entrega tareas y veredictos; mantiene las sesiones | Node.js 26, node:http |
| Worker de calificación | contenedor | Toma un envío pendiente, lo compila y lo ejecuta contra cada caso de prueba dentro de un sandbox, y anota el veredicto. Corren dos procesos iguales | Node.js 26; el sandbox usa los namespaces y cgroups de Linux |
| Sincronización de matrícula | contenedor | Programa que corre cada madrugada: trae la lista de matriculados de cada sección y actualiza quién puede enviar a qué tarea | Script de Node.js que lanza cron |
| Base de datos | almacén de datos | Cursos, secciones, matriculados, tareas, envíos con su código fuente, la tabla de trabajos pendientes y los veredictos | PostgreSQL 18 |
| Carpeta de casos de prueba | almacén de datos | Los archivos de entrada y de salida esperada de cada tarea, que los estudiantes no deben ver | Carpeta en el disco del servidor |
Y las relaciones que más importan para lo que sigue:
| De | Hacia | Qué viaja | Protocolo |
|---|---|---|---|
| Aplicación web | API | Pide tareas, manda envíos y pregunta cada 3 s por el veredicto de un envío pendiente | HTTPS, JSON |
| API | Base de datos | Guarda envíos y trabajos pendientes; lee tareas, matriculados y veredictos | Protocolo de PostgreSQL sobre TCP (SQL) |
| Worker de calificación | Base de datos | Pregunta cada 2 s por el siguiente trabajo pendiente, lo toma y anota el veredicto | Protocolo de PostgreSQL sobre TCP (SQL) |
| Worker de calificación | Carpeta de casos de prueba | Lee la entrada y la salida esperada de cada caso | Sistema de archivos, solo lectura |
Fíjense en lo que el diagrama deja ver sin que nadie lo explique: la API y los workers no se hablan. Los une la base de datos. Esa forma no es un accidente: es el resultado de una decisión que veremos como ADR.
El diagrama de contenedores responde qué corre, qué guarda datos y quién le habla a quién por qué protocolo. Sus lectores son quien evalúa y quien opera. Es el diagrama sobre el que se recorre un escenario de rendimiento o de disponibilidad.
El diagrama de componentes
El tercer nivel hace con un contenedor lo que el segundo hizo con el sistema: lo abre. Un diagrama de componentes muestra las partes de un contenedor, la responsabilidad de cada una y cómo se relacionan.
Un componente, en C4, es un grupo de funcionalidad detrás de una
interfaz, que vive dentro de un contenedor y no se despliega por
separado. En el código del curso casi siempre es un módulo: una carpeta de
src/ con su index.ts.
Tres reglas lo distinguen de los otros niveles:
- Abre un solo contenedor. Si el sistema tiene tres contenedores que vale la pena abrir, son tres diagramas.
- Alrededor quedan solo los vecinos directos: los otros contenedores, almacenes de datos, sistemas externos y personas con los que algún componente habla. El contenedor abierto ya no aparece como caja.
- Las flechas entre componentes son llamadas dentro de un proceso. No cruzan la red, no fallan a medias y cuestan nanosegundos. Las flechas que salen hacia un almacén o un sistema externo sí la cruzan.
El de la API de Yupana está en
c4/components.md.
El archivo empieza diciendo qué abre:
# Yupana: diagrama de componentes de la API

- Nivel: componentes
- Sistema: Yupana
- Contenedor: API
Sus componentes:
| Nombre | Tipo | Descripción | Tecnología |
|---|---|---|---|
| HTTP | componente | Router y handlers: convierte cada pedido en una llamada a un módulo, y cada resultado o error en una respuesta JSON | TypeScript sobre node:http |
| Sesiones | componente | Inicia sesión contra el proveedor de identidad y mantiene la sesión propia de Yupana, que dura 8 horas; dice quién hace cada pedido | Módulo de TypeScript; cookie firmada |
| Cursos | componente | Cursos, secciones y matriculados: responde si una persona es docente o estudiante de una sección | Módulo de TypeScript; SQL con pg |
| Tareas | componente | Las tareas con su enunciado, su cierre, sus límites de tiempo y memoria, y sus casos de prueba | Módulo de TypeScript; SQL con pg |
| Envíos | componente | Valida un envío (tamaño, lenguaje, tarea abierta), y guarda su código y su trabajo pendiente en una sola transacción | Módulo de TypeScript; SQL con pg |
| Veredictos | componente | Entrega el estado y el veredicto de un envío a quien lo hizo y a su docente | Módulo de TypeScript; SQL con pg |
| Lenguajes | componente | La tabla de lenguajes aceptados: extensión, cómo se compila y cómo se ejecuta cada uno. Los workers usan el mismo módulo | Módulo de TypeScript sin dependencias |
Y algunas de sus diecisiete relaciones:
| De | Hacia | Qué viaja | Protocolo |
|---|---|---|---|
| Aplicación web | HTTP | Pide tareas, manda envíos y pregunta por veredictos | HTTPS, JSON |
| HTTP | Envíos | Entrega cada envío recibido | Llamada a función |
| Envíos | Cursos | Pregunta si la persona está matriculada en la sección de la tarea | Llamada a función |
| Envíos | Tareas | Pide el cierre y los límites de la tarea | Llamada a función |
| Envíos | Lenguajes | Pregunta si el lenguaje del archivo está aceptado | Llamada a función |
| Envíos | Base de datos | Guarda el envío, su código y su trabajo pendiente en una transacción | Protocolo de PostgreSQL sobre TCP (SQL) |
| Sesiones | Proveedor de identidad | Canjea el código de inicio de sesión por la identidad de la persona | OpenID Connect sobre HTTPS |
Este diagrama es una vista de módulos con las flechas de uso: quién llama a quién. Sirve para dos cosas. Para recorrer un escenario de modificabilidad: E4 pide agregar un lenguaje tocando un solo módulo, y el diagrama deja ver que Lenguajes no depende de nadie y que solo Envíos lo usa dentro de la API. Y para encontrar a quién afecta un cambio: si cambia la forma de saber quién está matriculado, los componentes que apuntan a Cursos son los que hay que mirar.
Sus lectores son quienes construyen. A quien opera no le dice nada, porque todas esas cajas son un solo proceso.
Error común. Dibujar el diagrama de componentes como un inventario de archivos, o de clases. Un componente es una responsabilidad con una interfaz. Si el diagrama tiene cuarenta cajas, o una caja por archivo, ya es el cuarto nivel, y nadie lo va a mantener al día.
En la industria. El sitio de C4 no trata los cuatro niveles por igual. Recomienda el diagrama de contexto y el de contenedores a todos los equipos. Del de componentes dice que se haga solo si aporta, y que para documentación que va a durar conviene generarlo de forma automática. Fuente: c4model.com/diagrams/component. En el curso lo pedimos una vez, para el proceso principal de Tinkuy, porque es el diagrama sobre el que se discuten los límites entre módulos que ustedes ya escribieron como reglas de
depcruise.
Si ya tienen reglas de dependencia que una herramienta comprueba, el diagrama de componentes y las reglas dicen lo mismo de dos maneras, y vale la pena compararlos: una flecha del diagrama que las reglas prohíben, o una dependencia permitida que el diagrama no muestra, significa que uno de los dos está equivocado.
Código: el nivel que casi nunca se dibuja
El cuarto nivel abre un componente y muestra sus clases, funciones o tablas. Casi nunca vale la pena dibujarlo a mano: cambia con cada commit, y un editor lo muestra cuando hace falta. El propio modelo no lo recomienda salvo para los componentes más importantes o más complejos, y aun ahí sugiere generarlo con una herramienta.
Los cuatro niveles, juntos:
| Nivel | Qué abre | Qué muestra | Quién lo lee | ¿Se dibuja? |
|---|---|---|---|---|
| 1. Contexto | Nada: el sistema es una caja | Personas y sistemas externos | Todos | Siempre |
| 2. Contenedores | El sistema | Lo que se ejecuta o guarda datos por separado | Quien construye, evalúa y opera | Siempre |
| 3. Componentes | Un contenedor | Las partes de ese contenedor | Quien construye | Si aporta |
| 4. Código | Un componente | Clases, funciones, tablas | Quien construye | Casi nunca; se genera |
Los diagramas complementarios: dinámico y de despliegue
Los cuatro niveles son estáticos: dicen qué hay, no qué pasa. C4 agrega diagramas complementarios; dos importan aquí.
El diagrama dinámico muestra una interacción paso a paso: los mismos elementos de un diagrama estático, con las flechas numeradas en el orden en que ocurren. Es el diagrama de un recorrido. El de un envío en Yupana, tal como está en la sección 6 de su documento de arquitectura:
- La aplicación web manda el archivo a la API (HTTPS).
- HTTP le pregunta a Sesiones quién es, y le entrega el envío a Envíos.
- Envíos comprueba con Cursos, Tareas y Lenguajes que la persona está matriculada, la tarea sigue abierta y el lenguaje está aceptado.
- Envíos guarda el envío, su código y un trabajo pendiente en una transacción. La API responde 202 con el identificador del envío.
- Un worker, en su consulta de cada 2 s, toma el trabajo y lo marca “en calificación”.
- El worker compila el código y lo ejecuta contra cada caso de prueba dentro de un sandbox, y anota el veredicto.
- La aplicación web, que pregunta cada 3 s, recibe el veredicto de Veredictos y lo muestra.
Como texto, un diagrama dinámico es una lista numerada. No hace falta más. El modelo recomienda usarlo con moderación, para las interacciones que son interesantes o complicadas. Una buena regla: se escribe uno por cada escenario (A, A), porque es justo el recorrido que una evaluación va a pedir.
El diagrama de despliegue muestra en qué máquinas o entornos corre cada contenedor: es una vista de asignación. El diagrama de contenedores no lo dice a propósito, porque el despliegue cambia de un entorno a otro (la laptop de quien desarrolla, el servidor de pruebas, producción) y los contenedores no. El de Yupana cabe en un párrafo: una máquina virtual de la facultad con cuatro núcleos donde corren la API, los dos workers, PostgreSQL y el cron; la carpeta de casos de prueba en el disco de la misma máquina; y delante, un proxy de la facultad que termina HTTPS.
Ese párrafo tiene información que ningún otro diagrama tiene: todo comparte cuatro núcleos. Volveremos a él en la evaluación.
Las reglas de notación
C4 no impone una notación. Lo que pide es que cada diagrama se entienda solo, y lo concreta en unas recomendaciones que el formato del curso ya convirtió en reglas:
| C4 recomienda | En el formato del curso |
|---|---|
| Todo diagrama tiene un título que dice su tipo y su alcance | El título y las líneas Nivel:, Sistema: y Contenedor: |
| Todo elemento dice de qué tipo es | La columna Tipo, con una lista cerrada |
| Todo elemento tiene una descripción corta de su responsabilidad | La columna Descripción; el revisor rechaza las de dos palabras |
| Todo contenedor y componente dice su tecnología | La columna Tecnología |
| Toda línea es una relación en un solo sentido | Una fila tiene un De y un Hacia |
| Toda línea tiene una etiqueta específica, no “usa” | La columna Qué viaja; el revisor rechaza “usa”, “llama a” y parecidas |
| Las relaciones entre contenedores dicen su protocolo | La columna Protocolo, en todos los niveles |
En una frase: toda caja dice qué es, qué hace y con qué tecnología; toda flecha tiene una dirección, un verbo y un protocolo.
El revisor de la semana 1 ya aceptaba el nivel de componentes, y el Makefile
de esta semana lo usa sin copiarlo (make check-c4). Recuerden lo que dijimos
entonces sobre ese programa: comprueba que el diagrama esté completo, no
que sea cierto. Que la API de Yupana no le hable a los workers no lo puede
saber un revisor; lo sabe quien mira qué conexiones abre cada proceso.
Diagramas como texto
Los diagramas del curso viven en docs/c4/, dentro del repositorio. No es
una preferencia de formato: es lo que permite las tres cosas que mantienen
vivo un diagrama.
- Se versiona con el código. El diagrama de cualquier commit es el del sistema en ese commit.
- Se revisa con el código. Un pull request que agrega un proceso y no
toca
containers.mdse nota, y quien revisa lo puede pedir. - Se compara entre versiones.
git diffmuestra qué caja apareció y qué flecha cambió de protocolo.
Un dibujo guardado como imagen no permite ninguna. Nadie puede ver qué cambió entre dos versiones de un PNG, así que nadie lo revisa, y un diagrama que no se revisa envejece sin que nadie lo note. El día que alguien lo necesita, describe un sistema que ya no existe.
arc42: el documento completo
Las doce secciones
Los diagramas son una parte de la documentación. Falta dónde poner los objetivos, las restricciones, los escenarios, las decisiones y los riesgos, y en qué orden. arc42 es un template para ese documento completo: un índice de doce secciones, con una explicación de qué va en cada una. Es libre y no depende de ninguna herramienta ni notación.
| N.º | Sección | Qué lleva | En Yupana |
|---|---|---|---|
| 1 | Introducción y objetivos | Qué hace el sistema, sus objetivos de calidad más importantes y sus stakeholders | Tres objetivos, en orden, y una tabla de cuatro stakeholders |
| 2 | Restricciones | Lo que el equipo no puede decidir: técnicas, de organización, convenciones | La máquina de 4 núcleos, el inicio de sesión de la universidad, el respaldo |
| 3 | Contexto y alcance | Los vecinos del sistema y sus interfaces; qué queda dentro y qué fuera | El diagrama de contexto |
| 4 | Estrategia de solución | Las pocas decisiones que le dan forma a todo lo demás | Tres frases, cada una atada a un escenario |
| 5 | Vista de bloques | La descomposición estática, por niveles | Los diagramas de contenedores y de componentes |
| 6 | Vista de ejecución | Cómo colaboran los bloques en los casos que importan | El recorrido de un envío |
| 7 | Vista de despliegue | La infraestructura y qué corre en cada parte | La máquina virtual y lo que corre en ella |
| 8 | Conceptos transversales | Reglas y soluciones que se repiten en todo el sistema | Sesiones, formato de errores, estados de un envío, horas |
| 9 | Decisiones de arquitectura | Las decisiones importantes, caras, riesgosas o discutidas | La lista de los ADR, con su estado |
| 10 | Requisitos de calidad | Los requisitos de calidad y sus escenarios | El utility tree y los escenarios |
| 11 | Riesgos y deuda técnica | Los problemas y riesgos conocidos | Los temas de riesgo de la última evaluación |
| 12 | Glosario | Los términos del negocio y del equipo | Envío, caso de prueba, veredicto, cierre, trabajo, sandbox |
Casi todo esto ya lo conocen, con otro nombre:
- Las secciones 1, 2 y 10 son las semanas 1 y 2: stakeholders, restricciones, escenarios y utility tree.
- Las secciones 3, 5, 6 y 7 son vistas. La 3 es el diagrama de contexto de C4. La 5 son los niveles de contenedores y de componentes: arc42 la llama vista de bloques y también la organiza por niveles de zoom. La 6 es el diagrama dinámico y la 7, el de despliegue.
- La sección 9 son los ADR, y la 11 es lo que deja una evaluación como la de la segunda sesión.
Las que no habíamos nombrado son la 4 y la 8. La estrategia de solución es el resumen de una página que alguien lee antes que todo lo demás: las tres o cuatro decisiones de las que se deriva el resto. Los conceptos transversales son las reglas que no viven en ningún módulo porque valen para todos: cómo se manejan los errores, qué formato tienen las horas, cómo se identifica a quien hace un pedido.
El documento de Yupana está en
arc42.md. Su sección 4
completa:
## 4. Estrategia de solución

- Recibir y calificar son procesos distintos, unidos por una tabla de
  trabajos en PostgreSQL (ADR 0003): atiende E1 sin agregar infraestructura.
- Todo código de estudiantes corre dentro de un sandbox sin red y con
  límites, en los workers y nunca en la API: atiende E2.
- El envío y su código se guardan en una transacción antes de confirmar
  (ADR 0002): atiende E3.
Tres líneas, y cada una nombra el escenario que atiende. Quien solo lea esa sección ya sabe por qué Yupana tiene la forma que tiene.
Llenar lo que alguien va a leer
Doce secciones parecen mucho, y lo serían si hubiera que llenarlas todas. No hay que. arc42 es un índice: dice dónde iría cada cosa si alguien la escribe. La regla del curso es llenar una sección cuando alguien ya vino a preguntar lo que esa sección responde, y en las demás decir en una línea por qué todavía no.
El documento de Yupana lo hace en dos lugares. En la sección 5 dice que el worker no tiene diagrama de componentes porque son tres archivos, que se leen más rápido que un diagrama. Y en la 6:
Falta escribir el recorrido de un worker que muere en el paso 6: hoy no está
decidido (ver la sección 11).
Las dos notas son información. La primera dice que la omisión fue una decisión. La segunda dice que hay un hueco en el diseño, y lo dice justo donde alguien lo buscaría.
Otra regla que el ejemplo sigue: enlazar, no copiar. La sección 9 no repite los ADR: es una tabla con el número, el título y el estado de cada uno. La sección 10 son dos enlaces. Lo que se copia se desactualiza por partida doble.
La carpeta trae el esqueleto
(arc42-template.md) y un revisor
pequeño, arc42.ts, que comprueba que estén las doce secciones, numeradas y
en orden, y que ninguna esté vacía.
Trade-off. Un template da un índice conocido: quien ya leyó un documento arc42 sabe dónde buscar en el siguiente. Cuesta que invita a llenar por llenar, y un documento con doce secciones de relleno se lee menos que una página bien escrita. La alternativa es un
READMEde arquitectura con la forma que el equipo quiera. Para un sistema del tamaño de Tinkuy las dos opciones son defendibles; el proyecto del curso pide los diagramas y los ADR, no un documento arc42.
ADR: una decisión, un documento
El formato de Nygard
De todo lo que se puede documentar, lo que más rápido se pierde es el porqué. El código dice qué se hizo; los diagramas, cómo quedó. Ninguno dice por qué se eligió eso y no otra cosa.
Michael Nygard describió en 2011 lo que le pasa a quien llega a un proyecto y encuentra una decisión que no entiende. Sin el porqué, tiene dos opciones, y las dos son malas. Puede aceptarla a ciegas: está bien si la decisión sigue vigente, y está mal si el contexto cambió y había que revisarla; un equipo que acumula decisiones aceptadas sin entenderlas termina con miedo de tocar cualquier cosa. O puede cambiarla a ciegas: está bien si había que cambiarla, y está mal si sostenía algo que nadie había probado todavía.
Su propuesta es un ADR (architecture decision record): un documento corto por cada decisión significativa para la arquitectura, guardado en el repositorio del proyecto. Tiene cinco partes:
| Parte | Qué lleva |
|---|---|
| Título | Una frase nominal corta, con el número del ADR |
| Contexto | Las fuerzas en juego: técnicas, del negocio, del equipo. Se describen como hechos, sin opinar |
| Decisión | La respuesta a esas fuerzas, en frases completas y en voz activa: “Vamos a…” |
| Estado | Propuesto, si todavía no hay acuerdo; aceptado, cuando lo hay; obsoleto o reemplazado, con la referencia a quien lo reemplaza |
| Consecuencias | Cómo queda el contexto después de aplicar la decisión. Todas: las buenas, las malas y las neutras |
Y unas pocas reglas de uso, todas del mismo artículo:
- Los ADR se numeran en secuencia y los números no se reutilizan.
- Viven en el repositorio, como archivos de texto con un formato liviano.
- Cada uno ocupa una o dos páginas, y se escribe como una conversación con quien llegue después al proyecto: en frases completas, no en listas de fragmentos.
- Si una decisión se revierte, el ADR anterior se queda y se marca como reemplazado.
Una observación del artículo explica por qué el formato funciona como conjunto: las consecuencias de un ADR suelen convertirse en el contexto de los siguientes. Lo vamos a ver en Yupana.
En la industria. El artículo de Nygard está escrito con su propio formato (tiene secciones de contexto, decisión, estado y consecuencias) y termina con un reporte de experiencia. Cuenta que su equipo llevaba unos meses usando ADR en varios proyectos, por los que habían pasado entre seis y diez desarrolladores, y que todos dijeron apreciar el contexto que recibían al leerlos. Fuente: Documenting Architecture Decisions (2011). Desde entonces el formato se extendió y tiene variantes; el sitio adr.github.io reúne templates y herramientas.
Las alternativas consideradas
El formato de Nygard no tiene una sección para las alternativas: las fuerzas van en el contexto y la respuesta en la decisión. En la práctica, muchos ADR escritos así terminan diciendo qué se eligió y callando qué se descartó.
El curso agrega una sección obligatoria, Alternativas consideradas, como hacen otros templates. MADR, por ejemplo, tiene una sección Considered Options y otra con los pros y contras de cada opción.
La razón es práctica. Un ADR se lee, sobre todo, cuando alguien quiere cambiar la decisión. Esa persona trae una alternativa en la cabeza, y necesita saber una de tres cosas:
- Si su alternativa se consideró y se descartó, y por qué. Si la razón sigue en pie, se ahorró el trabajo. Si ya no (el equipo creció, la carga cambió, apareció una herramienta), tiene el argumento para reabrir la decisión.
- Si nadie la consideró. Entonces vale la pena discutirla.
- Qué costo aceptó el equipo al elegir, para no descubrirlo como si fuera un defecto.
Sin alternativas, el ADR solo responde “qué se decidió”, que es lo que el código ya decía.
Cada alternativa dice tres cosas: qué gana, qué cuesta y, si se descartó, por qué no. La que se eligió también dice qué cuesta. Una alternativa elegida que no cuesta nada es una alternativa que nadie analizó.
Idea clave. Un ADR es la frase de trade-off de la semana 2 con formato: para cumplir este escenario, elegimos esto en vez de aquello; ganamos esto; aceptamos esto otro. El contexto lleva el escenario, las alternativas llevan el “en vez de”, y las consecuencias llevan lo que se gana y lo que se acepta.
El template del curso y su revisor
El template está en
adr-template.md. Un ADR del curso es un
archivo docs/adr/NNNN-titulo-en-kebab-case.md con esta forma:
# ADR 0000: <la decisión, como una frase corta>

## Contexto

<Qué está pasando y por qué hay que decidir algo ahora.>

**Escenario:** <el escenario de calidad, en una o dos frases, con su medida>

## Alternativas consideradas

### A. <nombre de la alternativa>

- **Gana:** <qué mejora, y para qué atributo de calidad>
- **Cuesta:** <qué empeora o qué obliga a hacer>
- **Por qué no:** <por qué se descartó; la elegida no lleva este ítem>

### B. <nombre de la alternativa>
...

## Decisión

- **Alternativa elegida:** <letra>

<Vamos a... porque...>

## Estado

Propuesto

## Consecuencias

- **Buena:** <qué queda mejor>
- **Mala:** <qué queda peor, o qué trabajo nuevo aparece>
- **Neutra:** <qué cambia sin ser mejor ni peor>
Tiene dos diferencias con el formato original, además de las alternativas. El contexto lleva un párrafo que empieza con Escenario:, con su medida: es la regla de trabajo del curso, que ata cada decisión a un escenario. Y la decisión nombra con su letra cuál de las alternativas se eligió, para que no haya que deducirlo de la prosa.
Los estados permitidos son cinco:
| Estado | Cuándo |
|---|---|
Propuesto |
Está escrito y se está discutiendo. Todavía no vale |
Aceptado |
El equipo lo acordó. Es la decisión vigente |
Rechazado |
Se propuso y el equipo decidió que no. Se conserva, para que nadie lo proponga de nuevo sin saberlo |
Obsoleto |
Dejó de aplicar y nada lo reemplaza: por ejemplo, la parte del sistema sobre la que decidía ya no existe |
Reemplazado por el ADR NNNN |
Otra decisión ocupó su lugar. Dice cuál |
La carpeta tiene un revisor, check-adr.ts,
que comprueba la forma. Entre corchetes, el nombre con el que aparece cada
regla en su salida:
[titulo]El archivo empieza con# ADR NNNN: ..., con un número de cuatro dígitos.[secciones]Están las cinco secciones, una vez cada una y en orden.[vacia]y[template]Ninguna sección está vacía ni conserva el texto entre ángulos del template.[escenario]El contexto tiene su párrafo Escenario:, y el escenario tiene al menos un número.[alternativas]Hay por lo menos tres alternativas, la elegida y dos más. Todas dicen qué ganan y qué cuestan, y las descartadas dicen por qué no.[decision]La decisión nombra una de las alternativas consideradas y explica por qué.[estado]El estado es uno de los cinco.[consecuencias]Hay por lo menos una consecuencia buena y una mala.[numeracion]El número del archivo es el del título, y no hay dos ADR con el mismo número.[reemplazo]Un ADR reemplazado apunta a otro que existe, que es posterior, que ya fue aceptado y que dice en su contexto a quién reemplaza.
Las dos últimas solo se pueden revisar con todos los ADR juntos, así que al revisor se le pasa la carpeta:
$ node check-adr.ts example/yupana/docs/adr
example/yupana/docs/adr/0001-calificar-dentro-del-pedido-http.md: ADR 0001, Reemplazado por el ADR 0003, 3 alternativas (elegida: A): sin errores
example/yupana/docs/adr/0002-guardar-el-codigo-de-los-envios-en-postgresql.md: ADR 0002, Aceptado, 3 alternativas (elegida: A): sin errores
example/yupana/docs/adr/0003-tabla-de-trabajos-y-workers-de-calificacion.md: ADR 0003, Aceptado, 3 alternativas (elegida: B): sin errores
Como el revisor de diagramas, este comprueba que el ADR esté completo. No sabe si las alternativas son las que había que considerar, ni si la razón para descartar una es cierta. Un ADR puede pasar el revisor y ser malo. Lo que no puede es ser bueno y que le falte el escenario.
Un ADR completo: la tabla de trabajos de Yupana
El ADR 0003 de Yupana es el que explica por qué la API y los workers no se
hablan. Vale la pena leerlo entero, en
0003-tabla-de-trabajos-y-workers-de-calificacion.md.
Aquí va por partes.
El contexto cuenta qué cambió y da el escenario:
## Contexto

Reemplaza al ADR 0001. Desde el piloto cambiaron tres cosas. Yupana se usa en
6 cursos, con tareas de hasta 300 estudiantes. Las tareas de Algoritmos
tienen casos de prueba grandes, y calificar un envío tarda en promedio 12 s.
Y en los cierres la aplicación entera se vuelve lenta, porque la API compite
por los 4 núcleos con los compiladores y con los programas de los
estudiantes: es la consecuencia mala que el ADR 0001 dejó anotada.

…

**Escenario:** en los 30 minutos antes de un cierre llegan 600 envíos (20 por
minuto) que tardan en promedio 12 s en calificarse; la API confirma cada
envío en 1 s o menos (p95), el veredicto aparece en 2 min o menos (p95) y no
se pierde ningún envío.

A ese ritmo llegan 240 s de trabajo de calificación por cada minuto de reloj:
cuatro procesadores ocupados todo el tiempo, sin contar la API ni la base de
datos.
No hay opiniones. Hay hechos (cuántos cursos, cuánto tarda un envío, quién opera), una restricción (dos personas, una máquina) y un escenario con medida. El último párrafo hace una cuenta: 20 envíos por minuto por 12 s cada uno son 240 s de trabajo por minuto. Esa cuenta es parte del contexto, porque es lo que hace insostenible la decisión anterior.
Las alternativas son tres: seguir calificando en la API con un tope, la tabla de trabajos y un broker. La tercera es la que muchos habrían elegido después de la semana 5:
### C. Un broker de mensajes (NATS JetStream) y workers suscritos

- **Gana:** el broker entrega cada trabajo a un worker sin consultas
  periódicas, y vuelve a entregar el que no fue confirmado.
- **Cuesta:** un servicio más que instalar, vigilar y respaldar. Y el envío
  (en PostgreSQL) y su mensaje (en el broker) ya no se escriben en una
  transacción: un reinicio entre los dos deja un envío confirmado que nadie
  va a calificar.
- **Por qué no:** frente a una medida de 2 min, los 2 s de la consulta
  periódica no importan; el servicio adicional y la escritura en dos lugares
  sí, para un equipo de dos personas.
Fíjense en la forma del “por qué no”. No dice que un broker sea malo. Dice que para este escenario (una medida de 2 minutos) y con este equipo (dos personas a tiempo parcial) lo que el broker gana no compensa lo que cuesta. Quien lea esto dentro de dos años sabrá exactamente cuándo reabrir la decisión: si la medida baja a pocos segundos o si el equipo ya opera un broker por otra razón. La decisión lo dice de forma explícita:
## Decisión

- **Alternativa elegida:** B

Vamos a separar recibir de calificar. La API guarda el envío y un trabajo
pendiente en una transacción y responde. Los workers de calificación son
procesos aparte: cada uno toma un trabajo pendiente, lo marca como suyo en
una transacción para que ningún otro lo tome, lo califica dentro del sandbox
y anota el veredicto.

Cuántos workers corren es configuración del despliegue y no forma parte de
esta decisión. Vamos a revisarla si la medida del veredicto baja de 2 min a
pocos segundos, o si el equipo llega a operar un broker por otra razón.
Y las consecuencias. Son cinco; estas son las dos malas:
- **Mala:** aparecen los estados "pendiente" y "en calificación". La
  aplicación web tiene que mostrarlos y preguntar por el veredicto.
- **Mala:** la tabla de trabajos trae decisiones que antes no existían y que
  este ADR no toma: cuántos workers, qué se hace con un trabajo que un worker
  tomó y no terminó, y si todos los trabajos valen lo mismo.
La segunda es la más honesta del documento: admite que la decisión abre tres preguntas y no responde ninguna. Guárdenla. En la segunda sesión, una evaluación de Yupana va a encontrar cinco riesgos, y tres son esas preguntas.
Error común. Vender la decisión en las consecuencias. Una sección de consecuencias donde todo es bueno no convence a nadie y, peor, esconde lo que el próximo en llegar necesita saber. Si la decisión no tuviera costos, no habría hecho falta decidir.
Los otros dos ADR del ejemplo son más cortos. El 0002 decide dónde se guarda el código de cada envío (en PostgreSQL, y no en archivos ni en un almacenamiento de objetos), y es un buen ejemplo de una decisión empujada por una restricción: la facultad solo respalda la base de datos. El 0001 es la decisión que el 0003 reemplazó.
Un ADR no se reescribe
El ADR 0001 de Yupana decidió, durante el piloto, calificar cada envío dentro del mismo pedido HTTP que lo recibe. Hoy esa decisión ya no vale. ¿Qué se hace con el archivo?
Lo que no se hace es editarlo para que diga lo que el equipo piensa ahora, ni borrarlo. Un ADR aceptado es un registro de lo que se decidió con lo que se sabía. El procedimiento es otro:
- Se escribe un ADR nuevo, con el siguiente número, que dice en su contexto a cuál reemplaza y qué cambió desde entonces.
- Cuando el nuevo se acepta, en el anterior cambia una sola línea: el estado.
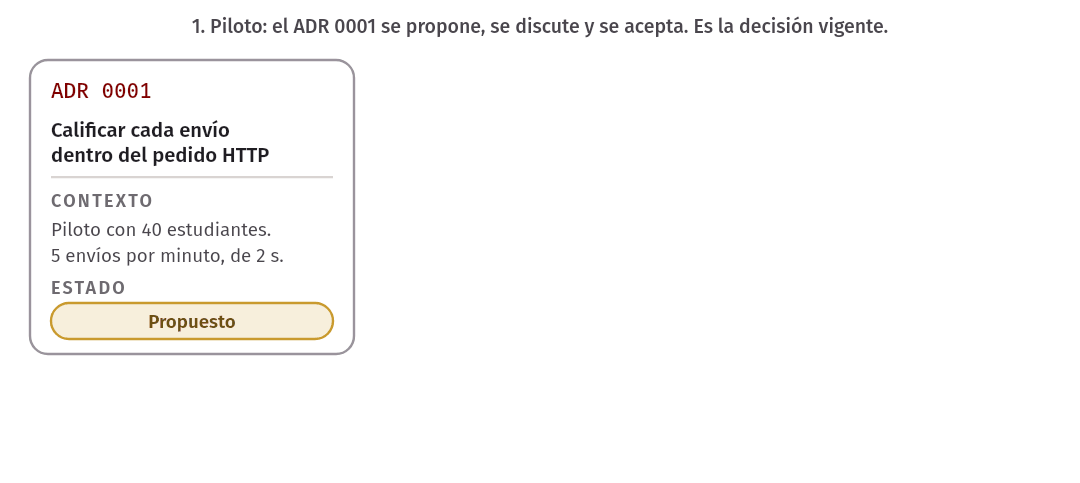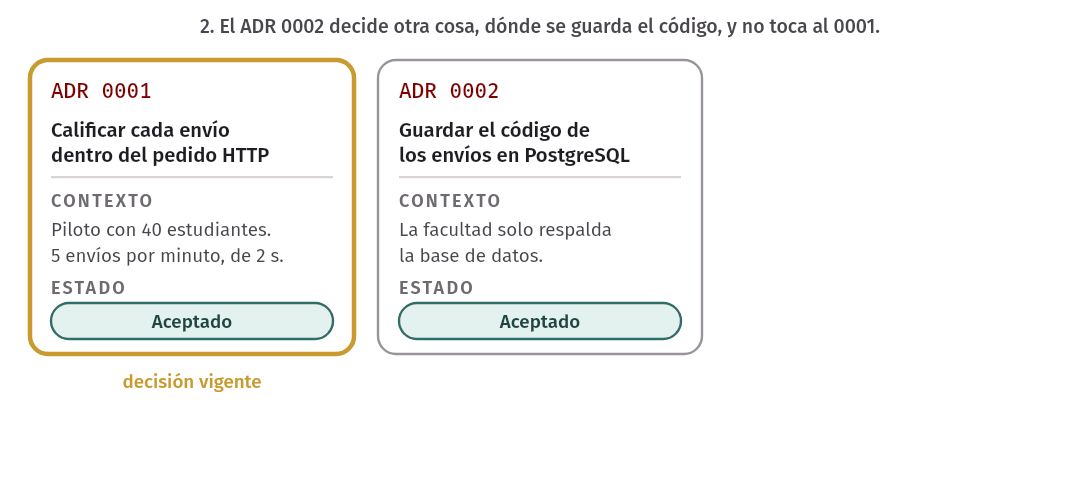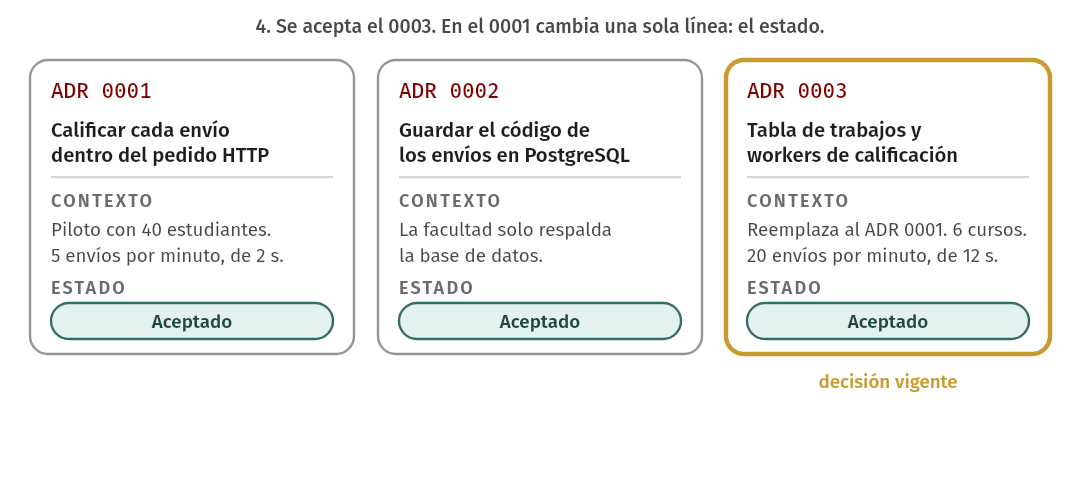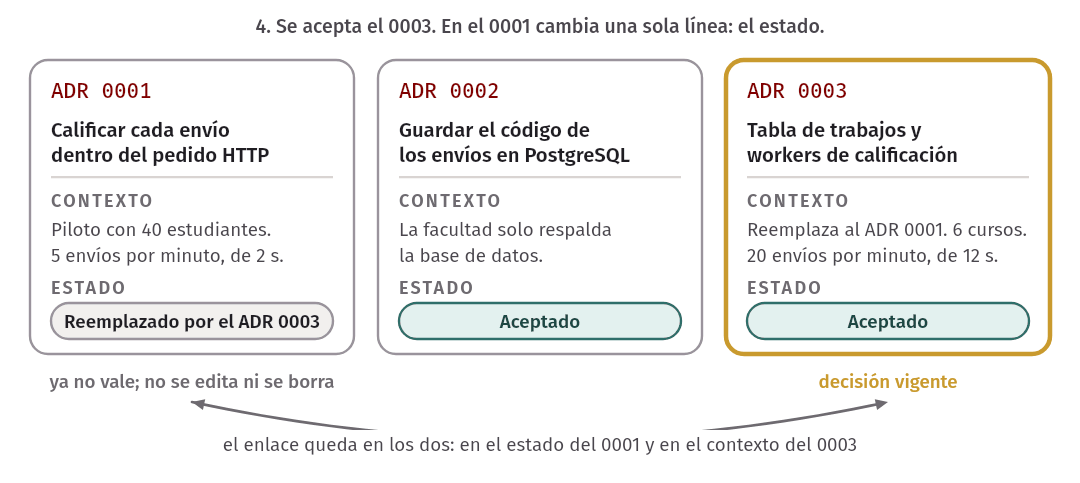
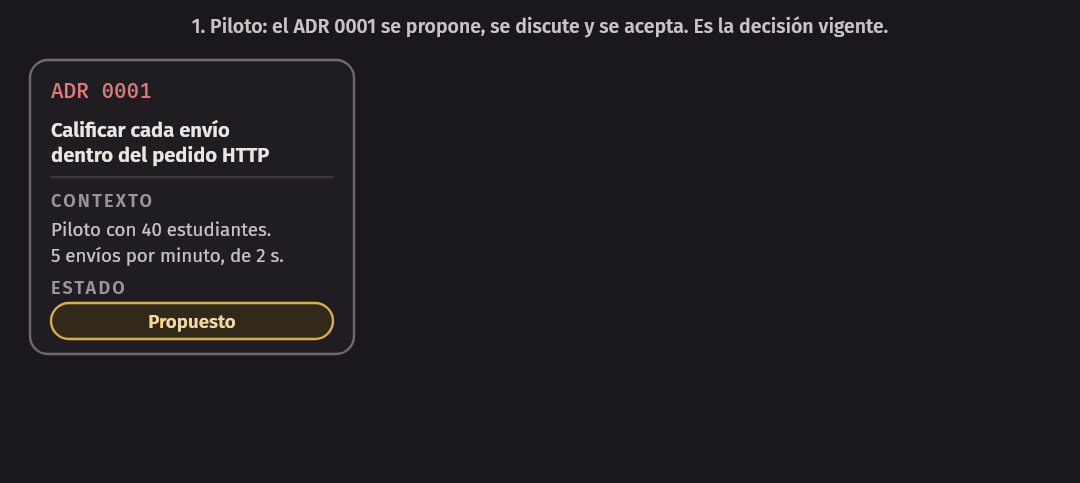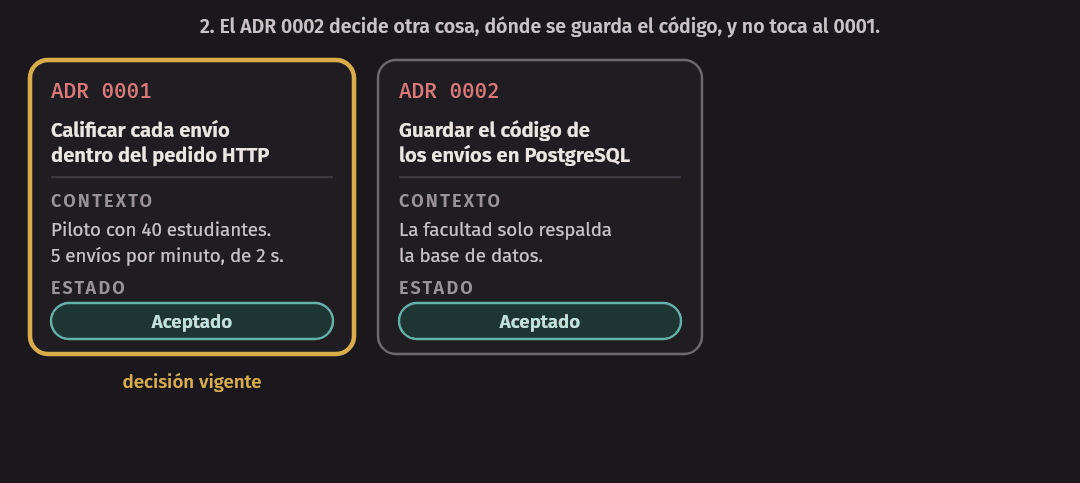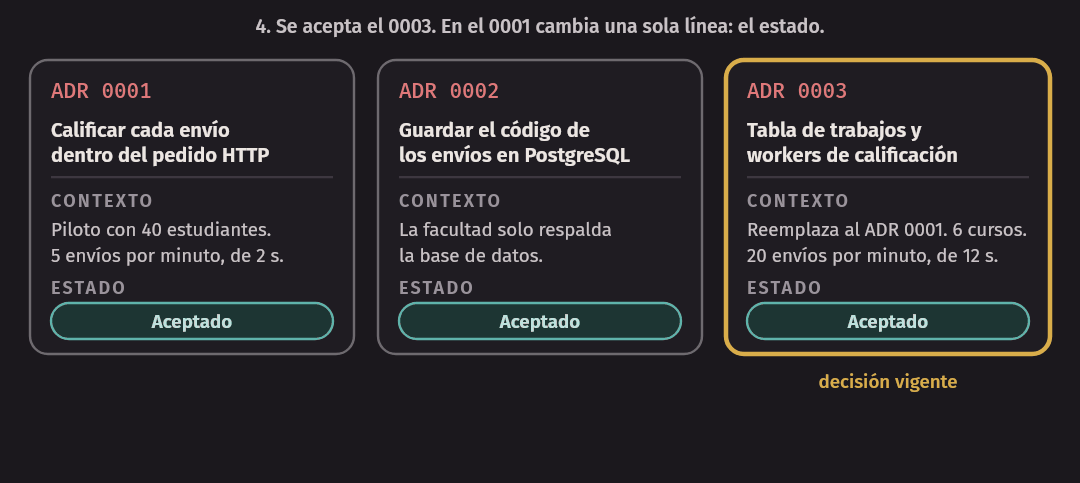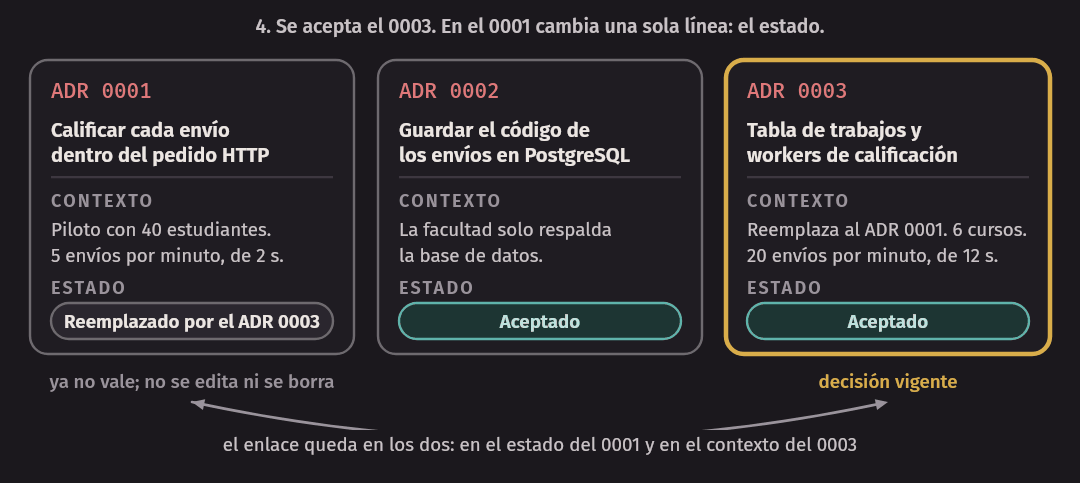
Así quedó el 0001. Su contexto sigue hablando de un piloto con 40 estudiantes; su decisión sigue diciendo “vamos a compilar y ejecutar cada envío dentro del pedido HTTP”; y su estado dice:
## Estado

Reemplazado por el ADR 0003
Vale la pena leer el 0001 completo, porque muestra por qué se conserva. Su escenario era otro (5 envíos por minuto, de 2 s cada uno), y con ese escenario la decisión era correcta: el servidor pasaba calificando 10 s de cada 60. Descartó la tabla de trabajos, la misma alternativa que después se eligió, con esta razón:
- **Por qué no:** con 5 envíos por minuto de 2 s resuelve un problema que el
  piloto no tiene, y cada pieza adicional la operan dos personas a tiempo
  parcial.
Y dejó escrito cuándo revisarla: si Yupana pasaba de una sección, o si aparecían tareas de más de 5 s. Pasaron las dos cosas.
Leídos juntos, el 0001 y el 0003 cuentan algo que ningún otro documento cuenta: que la primera decisión no fue un error, que el contexto cambió, y qué cambió exactamente. Si alguien hubiera reescrito el 0001, esa historia no existiría, y la tabla de trabajos parecería una decisión tomada desde el principio sin razón aparente.
Idea clave. Un ADR no se reescribe porque su valor está en poder reconstruir qué se sabía cuando se decidió. Una decisión se juzga contra su contexto, no contra el de hoy. Lo único que cambia en un ADR aceptado es su estado.
El revisor comprueba el enlace en los dos sentidos. Si se le pasa solo el 0001, no puede seguirlo:
$ node check-adr.ts example/yupana/docs/adr/0001-calificar-dentro-del-pedido-http.md
example/yupana/docs/adr/0001-calificar-dentro-del-pedido-http.md: ADR 0001, Reemplazado por el ADR 0003, 3 alternativas (elegida: A): sin errores
example/yupana/docs/adr/0001-calificar-dentro-del-pedido-http.md: [reemplazo] dice que lo reemplaza el ADR 0003, que no está entre los archivos revisados
Hay un caso que se presta a confusión: el ADR nuevo está escrito, pero
todavía propuesto. Mientras no se acepte, la decisión vigente es la
anterior, y su estado no cambia. La carpeta errors/ tiene ese caso: un ADR
0005 que ya se declaró reemplazado por un 0006 que nadie aceptó todavía.
errors/adr/0005-preguntar-por-el-veredicto-cada-tres-segundos.md: [reemplazo] el ADR 0006 todavía no fue aceptado: mientras tanto, este sigue vigente y su estado no cambia
errors/adr/0006-avisar-el-veredicto-con-server-sent-events.md: [reemplazo] el ADR 0005 dice que este lo reemplaza, y aquí el contexto no lo dice ("Reemplaza al ADR 0005")
¿Y si un ADR aceptado tiene una falta de ortografía, o un enlace roto? Eso se corrige. La regla protege el contenido de la decisión, no la tipografía. La prueba es simple: si después del cambio el ADR dice algo distinto sobre qué se decidió o por qué, no era una corrección.
Qué merece un ADR
No toda decisión merece un documento. Si todo tiene un ADR, nadie los lee. Tres preguntas sirven de filtro:
- ¿Cuesta cambiarla? Es la definición de decisión de arquitectura de la semana 1. Dónde se guardan los envíos cuesta cambiarlo; el nombre de una columna, no.
- ¿Alguien va a preguntar “por qué está así”? Si la respuesta es que sí, conviene que la respuesta esté escrita una vez.
- ¿Parece rara sin su contexto? Una decisión que parece un error a quien no conoce la restricción que la causó es la primera que alguien va a “arreglar”. En Yupana, que los workers consulten la base de datos cada 2 s en vez de recibir un aviso parece un descuido. Con el ADR 0003 se ve que fue una elección.
Si las tres respuestas son no, no hace falta un ADR. El nombre de una variable, la librería para formatear fechas o el orden de los campos de un JSON interno se deciden y se cambian sin ceremonia.
| Merece un ADR | No lo merece |
|---|---|
| Dónde vive cada dato y quién puede escribirlo | Cómo se llama una tabla |
| Si una operación es síncrona o asíncrona | Cómo se llama la función que la hace |
| Qué estilo tiene el sistema y dónde van sus límites | En qué carpeta va un archivo de utilidades |
| Una táctica que cuesta otro atributo: una cache, un retry, un timeout | El valor exacto de un parámetro que se ajusta con una medición |
| Una regla que se decide no cumplir, y por qué | Una convención de formato que el linter ya impone |
En Tinkuy. El Tinkuy inicial no tiene ningún ADR. Sus decisiones existen, pero solo en el código: en la semana 2 leímos tres de ellas como trade-offs que alguien tomó sin dejar registro. Desde esta semana, cada entrega del proyecto lleva sus decisiones en
docs/adr/, con este template, y las de entregas anteriores no se reescriben: si P3 cambia una decisión de P2, P3 trae el ADR que la reemplaza.
Dos errores al escribir un ADR
Error común. El ADR sin alternativas: “decidimos usar un broker”. Sin lo que se descartó, nadie puede saber si la decisión sigue vigente cuando cambie el contexto, porque no se sabe contra qué se comparó ni qué habría inclinado la balanza hacia otro lado.
La carpeta errors/ tiene uno así, el ADR 0004, “Usar un broker”. Su
contexto completo es “La calificación es lenta y los estudiantes se quejan”.
Considera una alternativa, NATS, de la que dice que “es rápido y moderno”.
Su decisión es “Decidimos usar NATS”, su estado es “Decidido” y su única
consecuencia, que la calificación va a ser más rápida.
Tiene las cinco secciones y no dice nada. El revisor lo explica mejor:
$ make errors
errors/adr/0004-usar-un-broker.md:3: [escenario] el contexto no nombra el escenario de calidad que empuja la decisión: falta el párrafo "**Escenario:** ..."
errors/adr/0004-usar-un-broker.md:7: [alternativas] hay 1 alternativa: hacen falta la elegida y al menos dos que se descartaron
errors/adr/0004-usar-un-broker.md:9: [alternativas] la alternativa A no dice qué cuesta ("- **Cuesta:** ..."): toda alternativa cuesta algo, también la elegida
errors/adr/0004-usar-un-broker.md:13: [decision] la decisión no dice cuál alternativa se eligió: falta el ítem "- **Alternativa elegida:** <letra>"
errors/adr/0004-usar-un-broker.md:19: [estado] el estado "Decidido" no existe: es Propuesto, Aceptado, Rechazado, Obsoleto, Reemplazado por el ADR NNNN
errors/adr/0004-usar-un-broker.md:21: [consecuencias] no hay ninguna consecuencia mala ("- **Mala:** ..."): toda decisión de arquitectura cuesta algo, y el ADR lo dice
errors/adr/0004-usar-un-broker.md: ADR 0004, estado desconocido, 1 alternativa (sin elegida): 6 errores
…
Compárenlo con el 0003, que decide sobre el mismo problema. “La calificación es lenta” contra “600 envíos en 30 minutos, de 12 s cada uno, con veredicto en 2 minutos”. “Es rápido y moderno” contra “entrega cada trabajo sin consultas periódicas, y cuesta un servicio más y una escritura en dos lugares”. Con el primero no se puede discutir. Con el segundo sí, y esa es la diferencia.
Error común. Documentar al final, para justificar lo que ya se hizo. Un ADR escrito después de construir nombra una sola alternativa de verdad, la que ganó, y dos de relleno que nadie evaluó. Se nota: las descartadas no tienen nada bueno. El ADR sirve cuando se escribe mientras se decide, porque obliga a buscar la segunda y la tercera alternativa antes de encariñarse con la primera, y a decir qué medida haría cambiar de opinión.
Una manera práctica de evitar el segundo error es usar el estado
Propuesto. Se escribe el ADR con el contexto y las alternativas antes de
tocar el código, se discute con el equipo, se hace el prototipo o la
medición que haga falta, y recién entonces se completa la decisión y pasa a
Aceptado. Si la medición contradice lo que esperaban, el ADR lo dice: es
información, y casi siempre la más valiosa del documento.
Diseñar con un método: ADD
Los siete pasos de una iteración
Hasta aquí documentamos decisiones ya tomadas. La segunda sesión empieza un paso antes: cómo se llega a ellas.
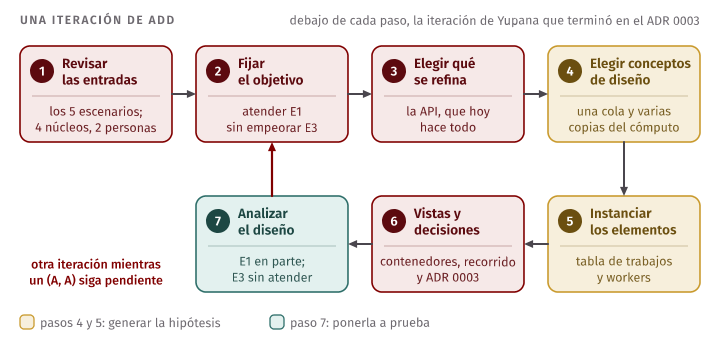
La forma más común de diseñar es empezar por la tecnología. Alguien propone “pongamos un broker” o “partamos esto en microservicios”, y el resto del diseño se acomoda alrededor. El diseño guiado por atributos, o ADD (attribute-driven design), invierte el orden: se empieza por los escenarios de calidad más importantes y se elige lo que los atiende. Es un método por iteraciones. Cada iteración toma una parte del sistema y unos pocos escenarios. El método tiene siete pasos: el primero se hace al empezar y las iteraciones repiten del segundo al séptimo:
- Revisar las entradas. El propósito del diseño (¿un sistema nuevo?, ¿un cambio a uno que existe?), los requisitos funcionales principales, los escenarios de calidad priorizados y las restricciones. Si falta alguna, se consigue antes de seguir.
- Fijar el objetivo de la iteración. Qué escenarios se van a atender en esta vuelta. Pocos: uno o dos.
- Elegir qué elemento del sistema se refina. En la primera iteración de un sistema nuevo es el sistema entero; después, el contenedor o el módulo donde vive el problema.
- Elegir conceptos de diseño que atiendan los escenarios elegidos: estilos, tácticas, patrones, tecnologías. Aquí se generan alternativas y se elige una.
- Instanciar los elementos: decidir qué piezas concretas aparecen, y asignarles responsabilidades e interfaces.
- Dibujar las vistas y registrar las decisiones. Los diagramas se actualizan y la decisión se escribe.
- Analizar el diseño contra el objetivo de la iteración y decidir si hace falta otra.
Los pasos 4 a 6 son los de las semanas anteriores con otro nombre. Los conceptos de diseño del paso 4 son los estilos de las semanas 4 y 5 y las tácticas de la semana 6. El paso 6 es la primera mitad de este capítulo: C4 para las vistas y un ADR para la decisión.
Una iteración sobre Yupana
Así se ve la iteración que terminó en el ADR 0003.
Paso 1, las entradas. El propósito es cambiar un sistema que existe: el piloto creció. La funcionalidad principal no cambia: enviar una solución, calificarla, ver el veredicto. Los escenarios son los cinco del utility tree. Las restricciones: una máquina virtual de cuatro núcleos, dos personas a tiempo parcial, Node.js y PostgreSQL, y que la facultad solo respalda la base de datos.
Paso 2, el objetivo. Atender E1, el cierre de una tarea. Es (A, A) y es el que hoy no se cumple. Queda como condición no empeorar E3: ningún envío confirmado se pierde.
Paso 3, qué se refina. La API. En el diseño del ADR 0001 hace todo: recibe el envío, lo califica y responde.
Paso 4, los conceptos de diseño. E1 tiene dos medidas distintas, y conviene separarlas. La confirmación en 1 s es un problema de tiempo bloqueado: el pedido espera a una calificación de 12 s. El veredicto en 2 minutos es un problema de capacidad: llega más trabajo del que una máquina hace a la vez. De las tácticas de rendimiento de la semana pasada, las candidatas son tres:
| Táctica | Qué haría aquí | Atiende la confirmación | Atiende el veredicto |
|---|---|---|---|
| Más recursos | Una máquina más grande | No: el pedido sigue esperando a la calificación | En parte, y hay que pedirla a la facultad |
| Limitar la respuesta a los eventos, con una cola | Recibir ahora y calificar después, a un ritmo controlado | Sí: confirmar ya no espera | No por sí sola: ordena la espera, no la reduce |
| Mantener varias copias del cómputo | Varios procesos que califican a la vez | No por sí sola | Sí, hasta donde alcancen los núcleos |
Ninguna alcanza sola. La combinación de la segunda y la tercera sí, y esa combinación tiene nombre desde la semana 5: sacar el trabajo del camino de la respuesta. Falta elegir con qué tecnología se implementa la cola, y ahí están las alternativas B y C del ADR: una tabla en PostgreSQL o un broker.
Paso 5, instanciar. Aparecen dos elementos nuevos y cambia uno:
| Elemento | Responsabilidad | Interfaz |
|---|---|---|
| API (cambia) | Recibir, validar, guardar el envío y dejar un trabajo pendiente | Responde 202 con el identificador del envío |
| Tabla de trabajos (nueva) | Decir qué envíos faltan calificar y cuál tomó cada worker | Filas con estado: pendiente, en calificación, terminado |
| Worker de calificación (nuevo) | Tomar un trabajo, calificarlo en un sandbox y anotar el veredicto | No ofrece ninguna: nadie lo llama. Consulta la tabla |
Paso 6, vistas y decisiones. Se actualizan el diagrama de contenedores y el recorrido de un envío, y se escribe el ADR 0003.
Paso 7, analizar. ¿Se cumplió el objetivo?
| Escenario | Antes de la iteración | Después |
|---|---|---|
| E1, confirmación en 1 s | No atendido | Atendido: confirmar es una transacción corta |
| E1, veredicto en 2 min | No atendido | En parte: depende de cuántos workers corran, y eso no se decidió |
| E3, un worker muere | No existía el problema | No atendido: no hay regla para un trabajo abandonado |
| E2, programa hostil | En parte | En parte: mejor que antes, porque el código ya no corre en la API |
Hace falta otra iteración. Su objetivo sale de esta tabla: terminar E1 y atender E3, refinando la tabla de trabajos y los workers.
Lo que ADD ordena
El método no inventa las soluciones: los conceptos de diseño los trae quien diseña. Lo que hace es ordenar el trabajo, de tres maneras.
- Se empieza por los escenarios, no por la tecnología. En la iteración de Yupana, la palabra “PostgreSQL” aparece recién al final del paso 4, después de saber qué había que resolver. Si se hubiera empezado por “pongamos NATS”, la pregunta de si un broker hacía falta nunca se habría hecho.
- Cada decisión queda atada a un escenario. La tabla del paso 4 tiene una columna por medida. Una táctica que no atiende ninguna no entra.
- Se sabe cuándo parar. El diseño termina cuando los escenarios prioritarios tienen respuesta, no cuando se acaban las ideas. La tabla del paso 7 es el tablero: mientras haya un (A, A) “no atendido” o “en parte”, falta una iteración.
Generar y probar
Hay una idea debajo del paso 7 que conviene decir en voz alta: una decisión de diseño es una hipótesis. “Con una tabla de trabajos, la confirmación tarda menos de 1 s en un cierre” es una afirmación sobre el mundo, y puede ser falsa.
Diseñar es, entonces, un ciclo de generar y probar: se genera una hipótesis (los pasos 4 y 5) y se la pone a prueba (el paso 7). Hay tres maneras de probar, de la más barata a la más cara:
| Prueba | Qué es | Cuánto cuesta | Qué tan segura deja |
|---|---|---|---|
| Análisis | Una cuenta o un recorrido sobre el diseño | Minutos | Detecta lo que no puede funcionar; no confirma lo que sí |
| Prototipo | Lo mínimo que permite ver el comportamiento | Horas o días | Confirma que el mecanismo funciona |
| Medición | El diseño implementado, con carga | Días | Es la única que confirma una medida |
Se usan en ese orden. Si una cuenta de dos líneas ya dice que el diseño no alcanza, no hace falta construirlo para saberlo. Si la cuenta dice que alcanza, falta medir.
Evaluar antes de construir
El paso 7 lo hace quien diseñó, y quien diseñó tiene un problema: ya está convencido. Conoce los supuestos del diseño tan bien que no los ve. Una evaluación es el mismo análisis hecho con otras personas en la sala.
La razón para evaluar temprano es económica. Un riesgo encontrado en una reunión cuesta una conversación y, a lo más, rehacer un diagrama. El mismo riesgo encontrado en producción cuesta una caída, los datos que haya dañado y un rediseño con el sistema en uso. Y la arquitectura es, por la definición de la semana 1, lo que más cuesta cambiar después.
Hay formas de evaluar con distinto grado de formalidad:
| Forma | Quiénes | Cuánto dura | Qué produce | Cuándo alcanza |
|---|---|---|---|---|
| Revisión entre pares | Quien diseñó y uno o dos colegas | Una hora | Comentarios | Decisiones de alcance limitado: un ADR, un cambio en un módulo |
| Recorrido de escenarios | El equipo | Una a dos horas | Una lista de problemas por escenario | Un rediseño dentro de un equipo |
| ATAM | Un equipo evaluador, quienes diseñaron y los stakeholders | Días | Riesgos, puntos de sensibilidad y de trade-off, priorizados contra el negocio | Sistemas grandes, caros o con muchos interesados |
Las tres hacen lo mismo en el fondo: recorrer escenarios sobre el diseño y preguntar qué decisión hace que cada uno se cumpla. Lo que cambia es cuánta gente participa y cuánto se registra.
Error común. Evaluar la arquitectura contra requisitos que nadie escribió. Alguien dice “esto no escala”; otro responde “sí escala”. Sin un escenario que diga cuánta carga, de qué tipo y con qué medida, los dos pueden tener razón, y la reunión la gana quien habla más fuerte. Sin escenarios, una evaluación es una discusión de gustos. Por eso el primer trabajo de cualquier evaluación, si los escenarios no existen, es escribirlos.
ATAM
Quiénes participan y qué hace falta
ATAM (Architecture Tradeoff Analysis Method) es un método del Software Engineering Institute para evaluar una arquitectura frente a sus requisitos de calidad. El reporte que lo describe dice para qué sirve en una frase: para entender las consecuencias de las decisiones de arquitectura a la luz de los requisitos de atributos de calidad. Y aclara qué tipo de método es: uno de identificación de riesgos. El nombre viene de que, además de decir qué tan bien se atiende cada atributo, muestra cómo los atributos interactúan: dónde mejorar uno empeora otro.
Reúne a tres grupos:
- El equipo evaluador, que conduce el método y no diseñó el sistema.
- Quienes deciden sobre el proyecto: quien lo dirige, quien representa al cliente y quien diseñó la arquitectura.
- Los stakeholders: quienes van a usar, operar, mantener y probar el sistema.
El reporte dice que una evaluación puede hacerse con tres a cinco stakeholders, o con cuarenta o cincuenta. Y describe dos fases. En la primera, un grupo pequeño (parte del equipo evaluador, el arquitecto y uno o dos stakeholders clave) recorre los seis primeros pasos y descubre qué documentación falta. Después de una pausa, que puede durar semanas, la segunda fase reúne a todos los stakeholders, repasa lo anterior y completa los pasos que faltan.
Lo que hace falta para empezar ya lo conocen: los objetivos del negocio, la arquitectura descrita (los diagramas) y, si existen, los escenarios. Si los escenarios no existen, el método los produce.
Los nueve pasos
El método tiene nueve pasos, en cuatro grupos.
Presentación
- Presentar el método. Quien conduce explica a todos qué se va a hacer, qué se va a registrar y qué va a salir de ahí.
- Presentar los objetivos del negocio. Quien dirige el proyecto dice para qué existe el sistema, sus funciones más importantes, sus restricciones y qué atributos de calidad le importan más al negocio.
- Presentar la arquitectura. Quien la diseñó la describe, mostrando cómo responde a esos objetivos.
Investigación y análisis
- Identificar los enfoques de arquitectura. Se listan los estilos, las tácticas y las decisiones principales. En este paso se identifican; no se analizan todavía.
- Generar el utility tree. Los atributos de calidad se refinan hasta llegar a escenarios, y cada escenario se prioriza con dos notas. Es el árbol de la semana 2: de este método viene.
- Analizar los enfoques de arquitectura. Para cada escenario prioritario, se identifica qué enfoques lo atienden y se los analiza. De aquí salen los primeros riesgos, puntos de sensibilidad y puntos de trade-off.
Prueba
- Lluvia de ideas y priorización de escenarios. Todos los stakeholders proponen escenarios, sin filtro, y después votan.
- Analizar los enfoques de arquitectura, otra vez, ahora con los escenarios más votados del paso 7. Estos escenarios funcionan como casos de prueba del análisis anterior.
Reporte
- Presentar los resultados. Lo que se encontró, a todos los que participaron.
Los pasos 6 y 8 se llaman igual a propósito: son la misma actividad con escenarios de distinto origen. Vale la pena detenerse en por qué el método la hace dos veces.
El utility tree del paso 5 lo construyen, sobre todo, quienes diseñaron. Es natural que contenga los escenarios en los que ya pensaron, y que el diseño los atienda. Los escenarios del paso 7 vienen de gente que no diseñó: quien opera, quien da soporte, quien usa el sistema. El reporte distingue tres clases de escenario que conviene pedir: de uso (lo que alguien hace con el sistema), de crecimiento (un cambio previsible: más carga, una función nueva) y exploratorios (un cambio extremo, para encontrar dónde se rompe el diseño).
Después se compara la lista votada con el utility tree. Si coinciden, el paso 8 es una confirmación: se espera encontrar poco. Si no coinciden, esa es la noticia: los stakeholders creen importante algo que quienes diseñaron no tenían en la lista, y eso ya es un riesgo, antes de analizar nada.
Para votar, el reporte describe un procedimiento simple: cada persona recibe un número de votos igual al 30 % de la cantidad de escenarios, redondeado hacia arriba, y los reparte como quiera, incluso todos al mismo. Se analizan los más votados.
En la industria. El reporte del SEI incluye una agenda típica: tres días de trabajo, con la presentación del método, los objetivos del negocio y la arquitectura en la mañana del primero, y los pasos 7 a 9 en el último, separados por una pausa de varias semanas. Fuente: Kazman, Klein y Clements, ATAM: Method for Architecture Evaluation (2000), sección 9. Tres días con decenas de personas es mucho dinero, y por eso el método completo se usa en sistemas donde un error de arquitectura cuesta mucho más.
Lo que produce
Una evaluación no termina con un veredicto. Termina con listas. Las cuatro más importantes clasifican decisiones, y hay que saber distinguirlas.
Un riesgo es una decisión de arquitectura que puede ser un problema: una decisión que puede impedir que se cumpla un escenario. También es un riesgo una decisión importante que todavía no se tomó. Según el reporte, un riesgo bien escrito tiene tres partes:
- la decisión (o la que falta tomar);
- la respuesta del atributo de calidad que esa decisión afecta, con sus consecuencias;
- el razonamiento que une las dos.
Un no riesgo es una decisión que se analizó y está bien. Se anota igual que un riesgo, con las mismas tres partes, por una razón que se suele pasar por alto: un no riesgo descansa sobre supuestos, y deja de serlo si cambian. Anotar “confirmar un envío cuesta dos escrituras pequeñas; no es un riesgo mientras la base de datos no esté saturada” deja dicho qué hay que volver a mirar el día que la base de datos se sature.
Un punto de sensibilidad es una propiedad de uno o más componentes, o de sus relaciones, de la que depende mucho la respuesta de un atributo de calidad. Es un lugar donde un cambio pequeño en el diseño produce un cambio grande en una medida. No es bueno ni malo: es una advertencia. El reporte lo compara con una señal amarilla: cuidado al cambiar esto.
Un punto de trade-off es una propiedad que afecta a más de un atributo y es punto de sensibilidad para más de uno. El ejemplo del reporte es el nivel de cifrado de un canal: subirlo mejora la seguridad y cuesta tiempo de procesamiento, así que si hay un requisito estricto de latencia, el nivel de cifrado es un punto de trade-off entre seguridad y rendimiento. El reporte dice que son las decisiones más críticas de una arquitectura, porque no se pueden mejorar sin pagar.
Las cuatro categorías se relacionan así:
| Hallazgo | Qué es | Pregunta que lo detecta |
|---|---|---|
| Riesgo | Una decisión (o una que falta) que puede impedir un escenario | ¿Qué decisión hace que este escenario no se cumpla, o no se sepa si se cumple? |
| No riesgo | Una decisión que se analizó y está bien, bajo un supuesto | ¿Qué decisión hace que se cumpla, y qué tendría que cambiar para que deje de hacerlo? |
| Punto de sensibilidad | Una propiedad de la que depende mucho la respuesta de un atributo | ¿Qué parámetro, si lo muevo un poco, mueve mucho la medida? |
| Punto de trade-off | Un punto de sensibilidad para dos atributos o más, casi siempre en sentidos opuestos | ¿A qué otro atributo afecta ese mismo parámetro? |
No son excluyentes. Un punto de sensibilidad dice dónde mirar; el valor que tiene hoy puede ser un riesgo. El número de bits de una clave es un punto de sensibilidad para la confidencialidad; una clave demasiado corta es un riesgo. Y una misma decisión puede ser punto de sensibilidad para un atributo y riesgo para otro.
En Tinkuy. Dos ejemplos, para fijar las categorías. “La pasarela se llama dentro de la transacción” es un punto de sensibilidad para la latencia de la compra, porque el tiempo de la pasarela entra completo en el tiempo de la respuesta, y es un riesgo para la disponibilidad, porque la compra necesita que la pasarela responda. Y si en el laboratorio de la semana 6 pusieron una cache del catálogo con un TTL de cinco segundos, ese TTL es un punto de trade-off entre rendimiento y actualidad de los datos: subirlo quita carga de la base de datos y alarga el tiempo en que un comprador ve asientos que ya no están. Los demás hallazgos de Tinkuy son el trabajo del laboratorio.
Error común. Anotar síntomas en vez de decisiones. “El sistema podría ser lento en los cierres” no es un riesgo: no dice qué decisión lo causa, así que nadie sabe qué cambiar. “Corren 2 workers, y con 12 s por envío califican 10 por minuto cuando llegan 20” sí lo es. Si un hallazgo no nombra una decisión que alguien tomó o dejó de tomar, todavía no está terminado.
Temas de riesgo
Una evaluación puede terminar con veinte riesgos. Una lista de veinte no le dice a nadie por dónde empezar, y el último paso del método no es leerla en voz alta.
En las descripciones posteriores del método, entre ellas la del libro del curso, el reporte final agrupa los riesgos en temas de riesgo: lo que varios riesgos tienen en común. Un tema suele ser una causa. Varios riesgos de disponibilidad pueden compartir que nadie pensó qué pasa cuando un proceso muere; varios de modificabilidad, que no hay reglas sobre quién puede leer qué tabla.
Cada tema se compara con los objetivos del negocio del paso 2: ¿qué objetivo amenaza? Esa comparación es lo que convierte una lista técnica en algo que quien dirige el proyecto puede priorizar. “Tenemos cinco riesgos de rendimiento” no significa nada para el negocio. “La noche de un cierre, los estudiantes van a esperar media hora por un veredicto” sí.
El recorrido de un escenario
El análisis de los pasos 6 y 8 tiene una mecánica concreta. Quien diseñó recorre el escenario sobre los diagramas: dice qué elementos intervienen, en qué orden y por qué relaciones pasa. Quienes evalúan hacen preguntas propias del atributo del escenario. De las respuestas salen los hallazgos.
Las preguntas dependen del atributo. Para empezar sirven estas:
| Atributo | Preguntas para el recorrido |
|---|---|
| Rendimiento | ¿A qué ritmo llega el estímulo? ¿Cuánto tarda cada paso? ¿Cuántos se atienden a la vez? ¿Dónde espera lo que no se atiende? ¿Qué recurso comparten los pasos? |
| Disponibilidad | ¿Qué pasa si este elemento se cae en este paso? ¿Quién se entera, y cómo? ¿Qué queda a medias? ¿Quién lo termina? |
| Seguridad | ¿Dónde está el límite de confianza? ¿Qué puede hacer quien lo cruza? ¿Con qué permisos corre cada elemento? |
| Modificabilidad | ¿Qué elementos toca el cambio? ¿Quién depende de ellos? ¿Hay que desplegar todo? |
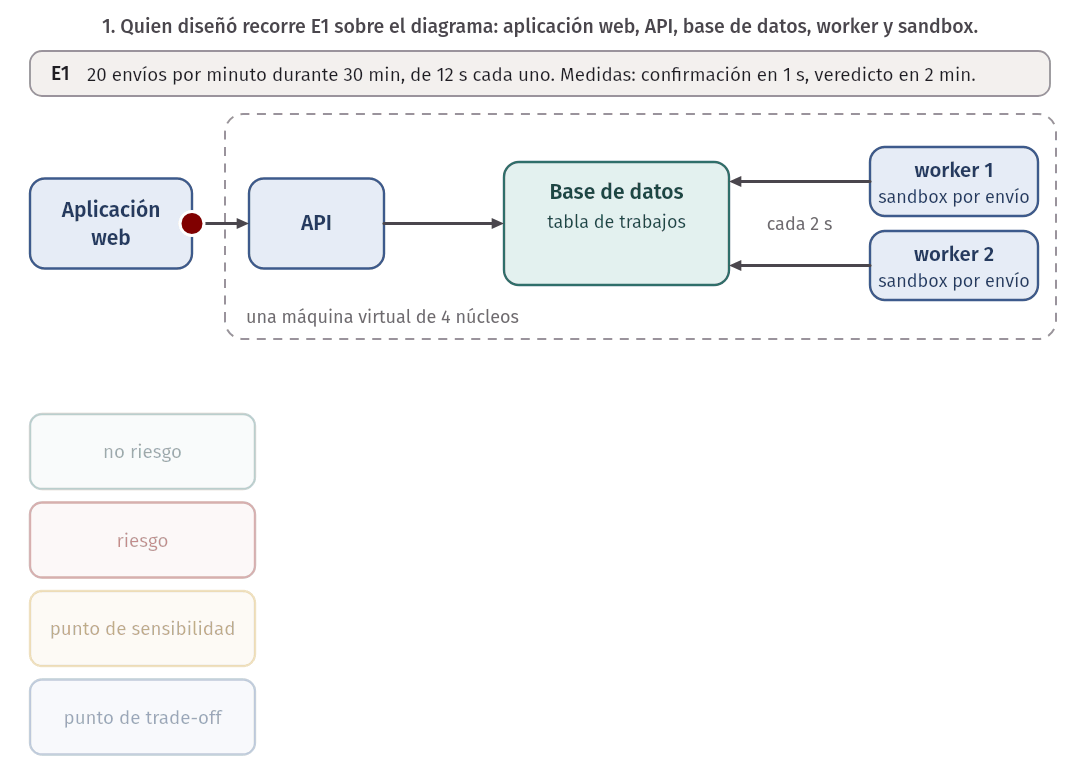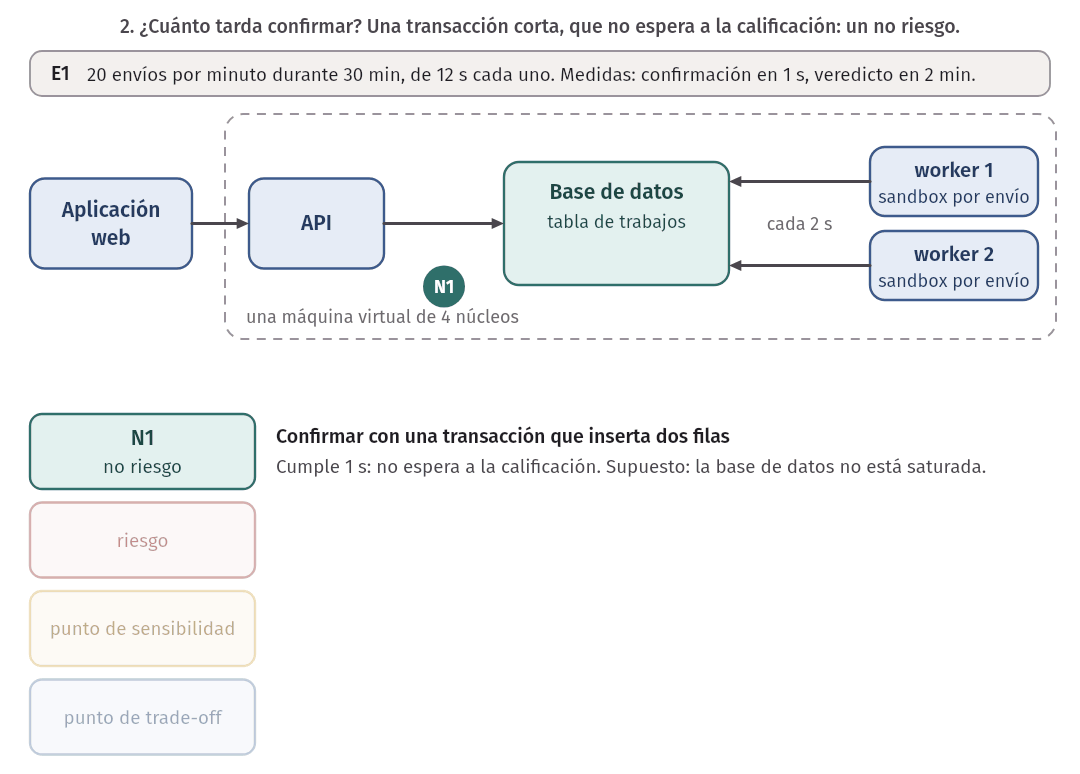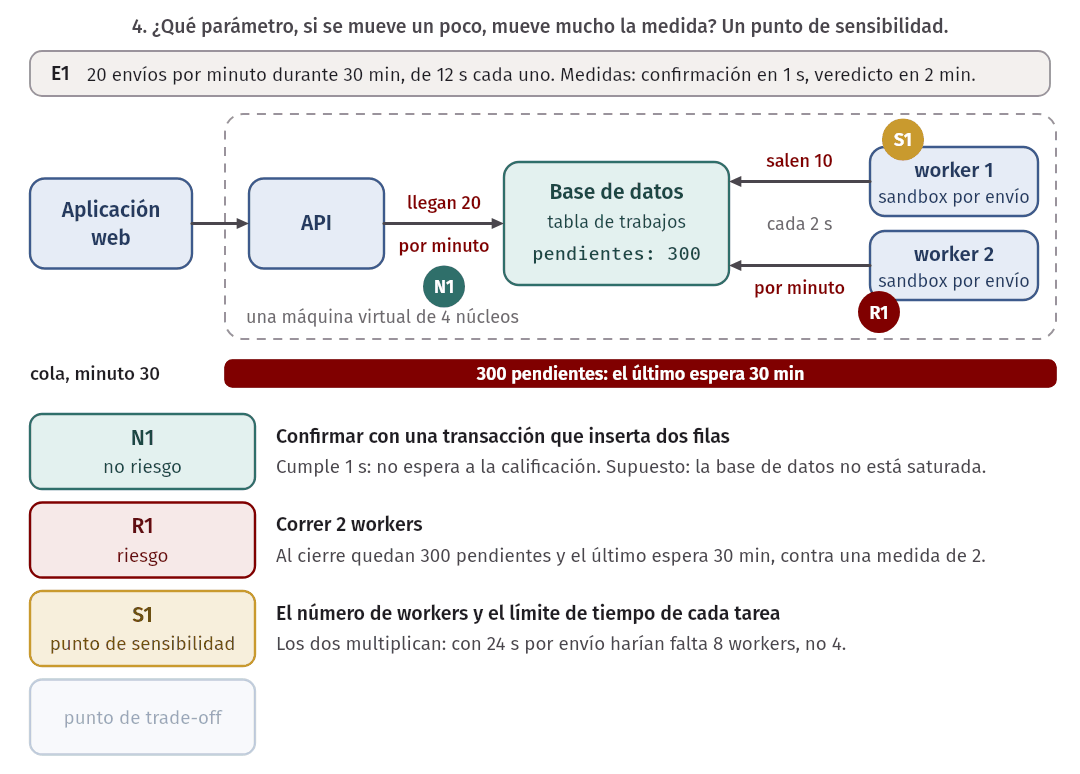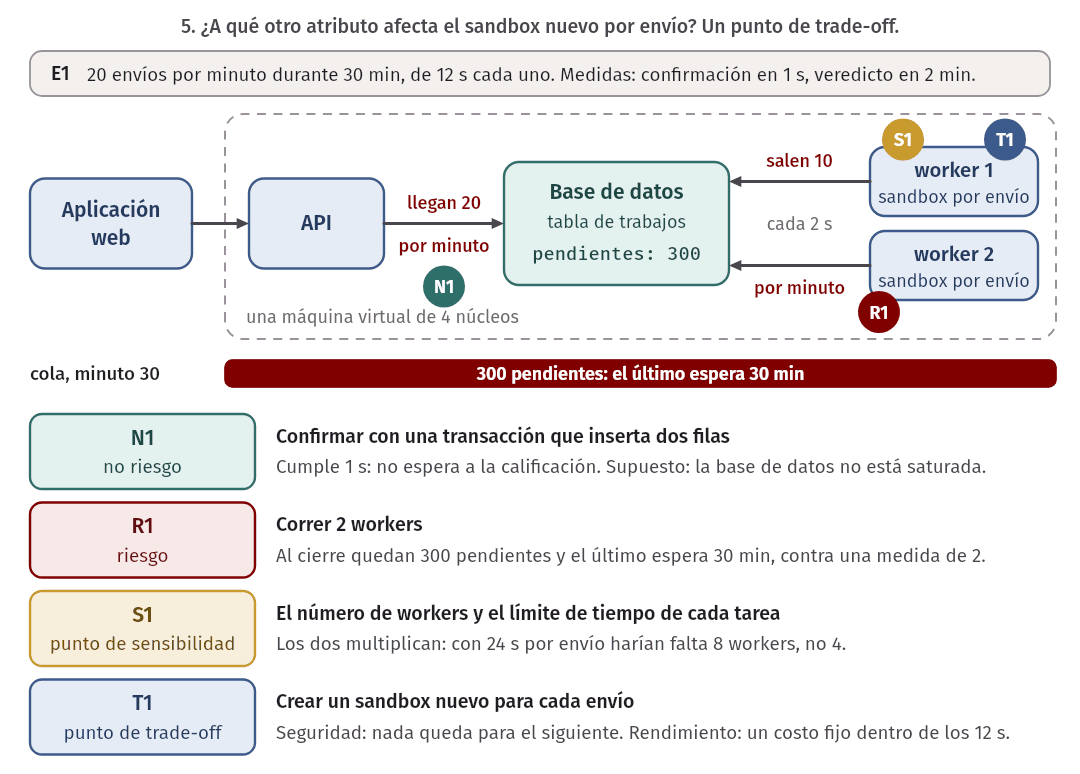
Recorramos E1 sobre Yupana. Los elementos que intervienen, en orden, son los del recorrido de un envío: aplicación web, API (HTTP, Sesiones, Envíos), base de datos, worker, sandbox, base de datos otra vez, API (Veredictos) y aplicación web. Las preguntas de rendimiento y sus respuestas:
- ¿A qué ritmo llega el estímulo? 20 envíos por minuto, durante 30 minutos. Lo dice el escenario.
- ¿Cuánto tarda cada paso? Confirmar es una transacción corta. Calificar tarda 12 s en promedio. Lo dice el escenario.
- ¿Cuántos se califican a la vez? Uno por worker. ¿Y cuántos workers hay? El ADR 0003 dice que eso es configuración del despliegue. La vista de despliegue dice que son 2.
- ¿Dónde espera lo que no se atiende? En la tabla de trabajos, en orden de llegada.
Con esas cuatro respuestas ya se puede hacer una cuenta. Si llegan envíos por minuto y hay workers que tardan segundos por envío, los workers califican entre todos
envíos por minuto. Mientras , la cola no crece. Si , crece a razón de envíos por minuto durante todo el pico. Después de minutos quedan envíos pendientes, y el último en llegar tiene que esperar a que salgan todos:
El menor número de workers con el que la cola no crece es
Con los números de E1 y los 2 workers del despliegue, envíos por minuto. La cuenta está en
queue-estimate.ts:
$ make queue ARRIVALS=20 MINUTES=30 WORKERS=2 SECONDS=12
llegan 20 por minuto durante 30 min; 2 workers, 12 s por trabajo
capacidad:            10 por minuto
utilización:          2
pendientes al final:  300
espera del último:    30 min
workers para no acumular: 4
El escenario pide el veredicto en 2 minutos, y quien envía a la hora del cierre lo recibe media hora después. No hizo falta construir nada ni medir nada para saberlo.
Ahora se clasifica lo que apareció:
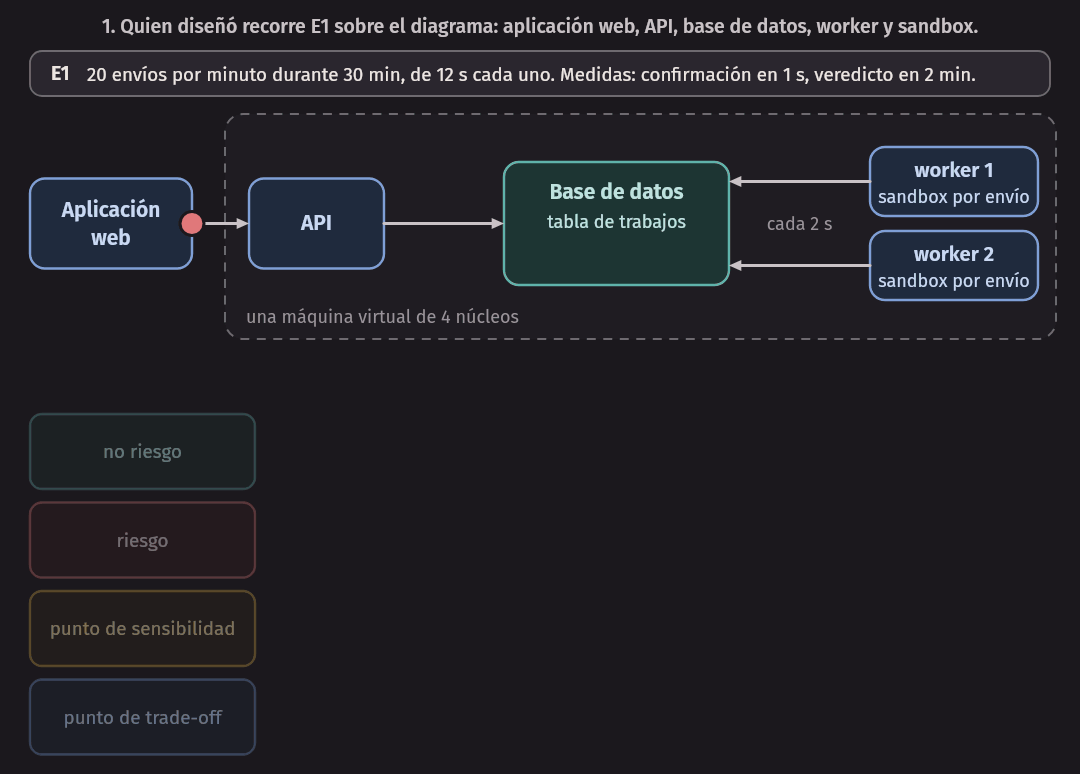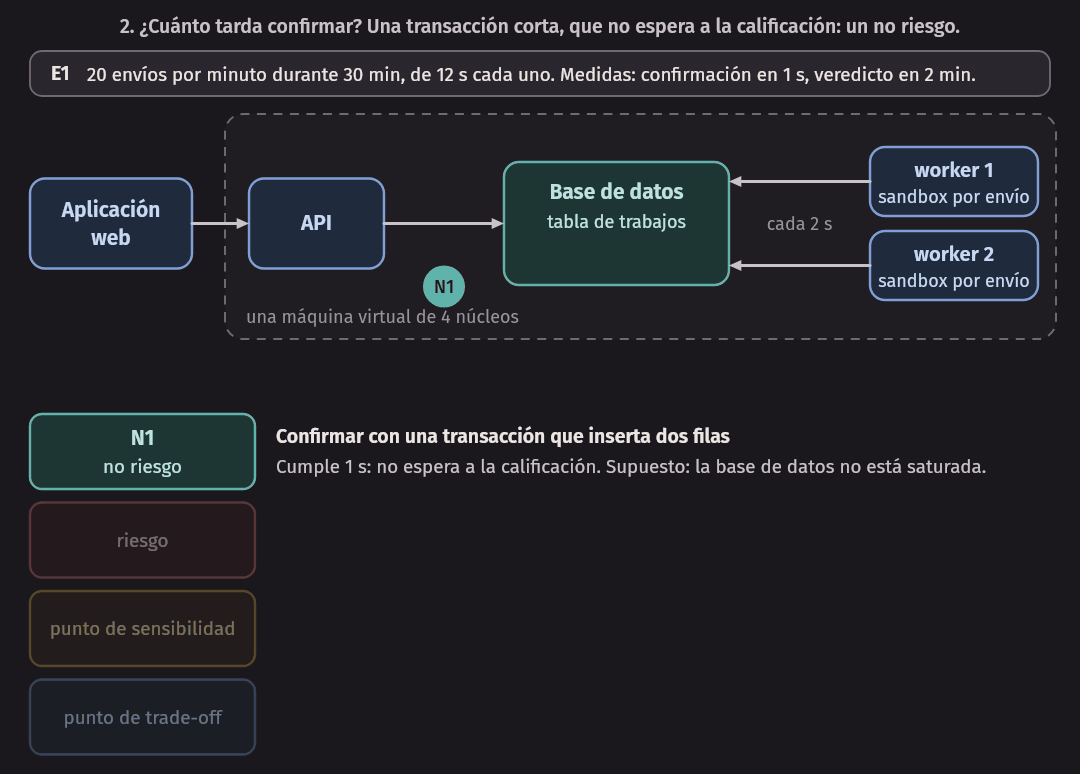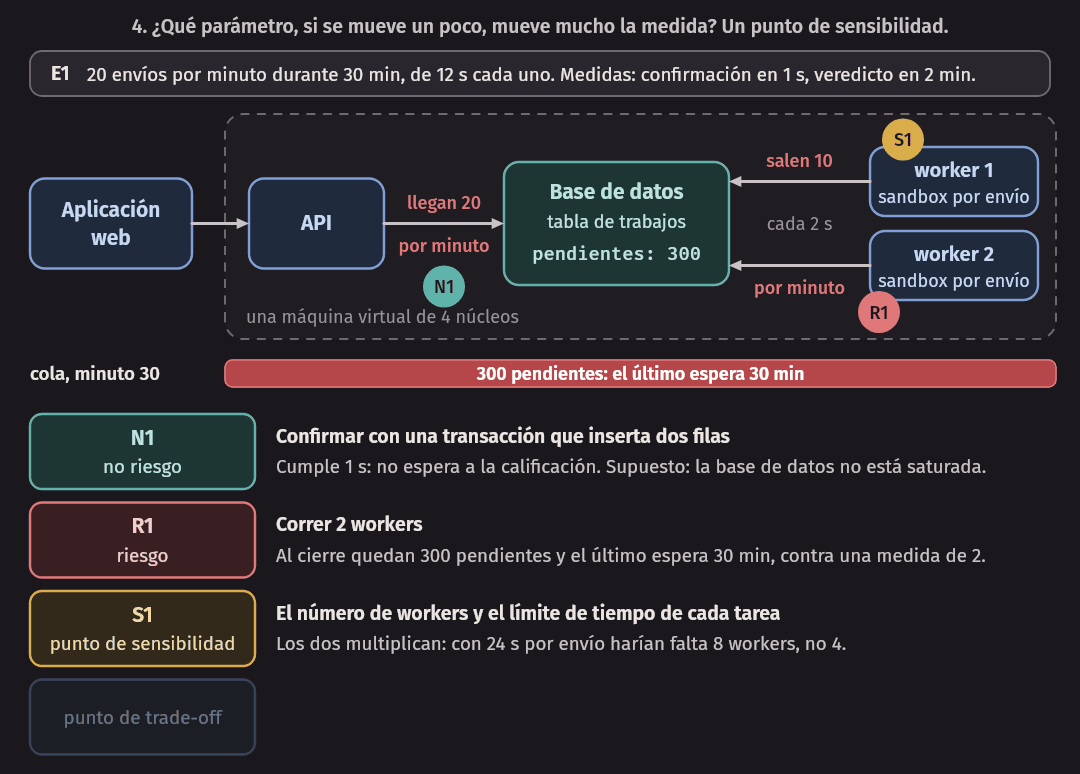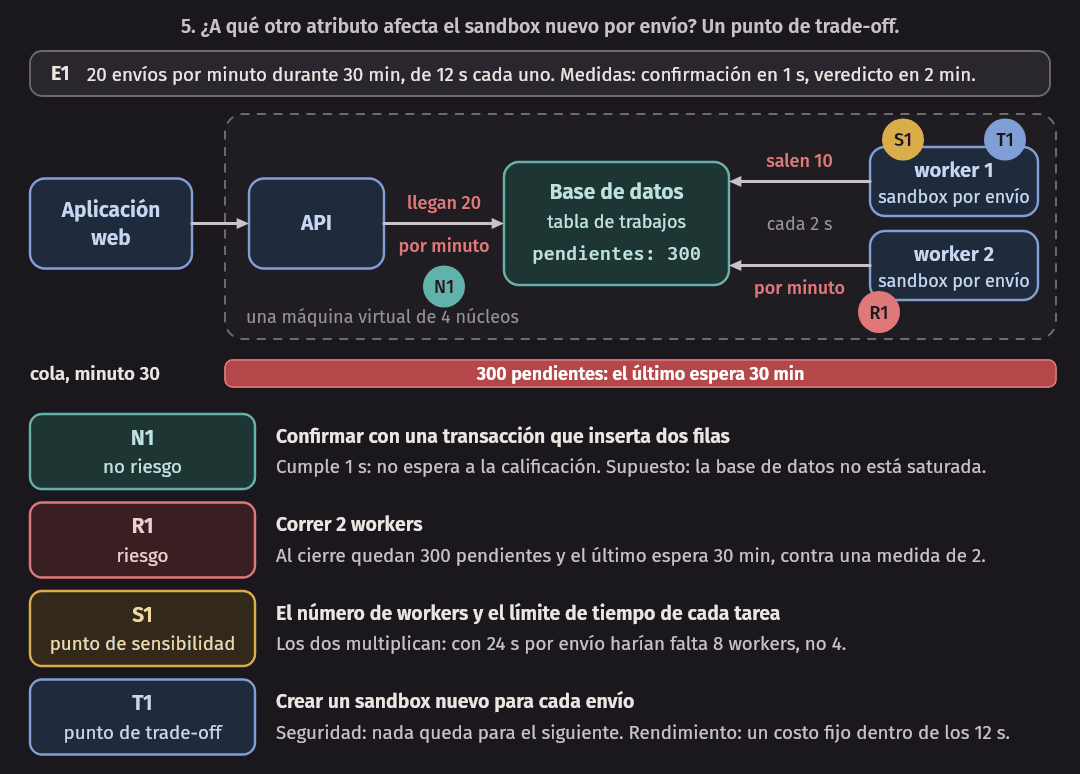
- Un riesgo (R1). La decisión: correr 2 workers. La respuesta afectada: el veredicto tarda hasta 30 minutos, contra una medida de 2. El razonamiento: la cuenta de arriba. Y trae una mala noticia adicional: hacen falta 4 workers, y la máquina tiene 4 núcleos que también usan la API y PostgreSQL.
- Un punto de sensibilidad (S1). El número de workers y el límite de
tiempo de cada tarea. En la fórmula de , los dos multiplican: si
un docente publica una tarea con el doble de tiempo por envío, hacen
falta el doble de workers (
make queue SECONDS=24responde 8). Nadie en el equipo decide ese límite: lo pone cada docente al crear su tarea. Es justo el tipo de cosa que un punto de sensibilidad debe dejar escrito. - Un no riesgo (N1). Confirmar el envío con una transacción que inserta dos filas. La medida de 1 s se cumple, porque confirmar ya no espera a la calificación. El supuesto: que la base de datos responda como siempre, lo cual deja de ser cierto si la máquina está saturada. Es decir, N1 depende de que R1 se resuelva.
- Un punto de trade-off (T1). Crear un sandbox nuevo para cada envío. Para la seguridad es lo que hace falta: nada de un envío queda para el siguiente. Para el rendimiento es un costo fijo en cada uno de los 600 envíos, que entra en los 12 s de . Reutilizar el sandbox bajaría y debilitaría E2.
Tres cosas de este recorrido valen para cualquier otro.
La primera: el hallazgo salió de cruzar dos documentos. El ADR decía “cuántos workers es configuración”; la vista de despliegue decía “2”; el escenario decía “20 por minuto”. Ninguno de los tres, solo, mostraba el problema.
La segunda: el análisis fue rudimentario, y eso es lo que el método pide. La cuenta supone llegadas a ritmo constante y envíos que tardan todos lo mismo. Con llegadas en ráfaga y tiempos variables, la espera real es mayor, sobre todo cuando la utilización se acerca a 1: con 4 workers la cuenta da una utilización de exactamente 1 y dice que la cola no crece; en la práctica crecería.
Una cuenta así sirve para descartar: si dice que no alcanza, no alcanza. Si dice que alcanza justo, hay que medir.
La tercera: nadie propuso una solución. El recorrido termina cuando el hallazgo está escrito. Qué hacer con R1 (más núcleos, otra máquina para los workers, límites de tiempo más bajos, aceptar una medida de 30 minutos) es una decisión de diseño, con sus alternativas y su ADR, y no es parte de la evaluación.
La tabla de Yupana
La evaluación completa está en
atam.md, con el formato de
atam-template.md: los objetivos del
negocio, los enfoques de arquitectura, los escenarios, los hallazgos y los
temas de riesgo.
Los enfoques identificados en el paso 4 fueron seis. Fíjense en que cada uno dice dónde se ve:
| Id | Enfoque | Dónde se ve |
|---|---|---|
| A1 | Calificación asíncrona: una tabla de trabajos en PostgreSQL que los workers consultan cada 2 s (ADR 0003) | Contenedores: API → Base de datos ← Worker de calificación |
| A2 | Un sandbox nuevo por envío, sin red, con el sistema de archivos de solo lectura y límites de CPU, memoria y número de procesos | Contenedores: Worker de calificación |
| A3 | El envío, su código y su trabajo pendiente se guardan en una sola transacción (ADR 0002) | Componentes: Envíos → Base de datos |
| A4 | Todo en una máquina virtual de 4 núcleos: la API, 2 workers y PostgreSQL | arc42, sección 7 |
| A5 | Un solo usuario de PostgreSQL para la API, los workers y la sincronización | Contenedores: las tres flechas hacia Base de datos |
| A6 | Los casos de prueba en una carpeta del servidor que el worker monta dentro del sandbox | Contenedores: Worker de calificación → Carpeta de casos de prueba |
A4, A5 y A6 no tienen ADR. Nadie los decidió en una reunión: quedaron así. Es frecuente, y es una de las utilidades del paso 4: hacer visibles las decisiones que se tomaron sin decidir.
El recorrido de E2 (un programa hostil) y de E3 (un worker que muere) encontró esto:
| Id | Tipo | Decisión | Razonamiento |
|---|---|---|---|
| N2 | no riesgo | Ejecutar cada programa sin red y con límites de CPU, memoria y número de procesos | El programa no puede abrir conexiones ni agotar la máquina. Supuesto: el aislamiento del kernel no tiene una falla conocida, lo que obliga a mantener el sistema operativo actualizado |
| R2 | riesgo | Los workers se conectan a la base de datos con el mismo usuario que la API | Si un programa escapa del sandbox, encuentra credenciales que leen el código de todos los envíos y cambian cualquier veredicto: el daño de una falla del sandbox no está acotado |
| R3 | riesgo | Montar en el sandbox la carpeta completa del caso de prueba, con la entrada y la salida esperada | El programa puede leer la salida esperada e imprimirla: obtiene “aceptado” sin resolver la tarea |
| R4 | riesgo | Falta decidir qué pasa con un trabajo que un worker tomó y no terminó | Si el worker muere, nadie devuelve el trabajo a “pendiente”: el envío queda sin veredicto para siempre, y el escenario pide 5 min |
| N3 | no riesgo | Guardar el código del envío en la misma transacción que su registro | Un envío confirmado está completo en la base de datos aunque el worker muera. Supuesto: el respaldo nocturno sigue funcionando |
| T2 | punto de trade-off | Cuántas veces se vuelve a intentar un trabajo abandonado (todavía sin decidir) | Más intentos recuperan más caídas pasajeras (E3). Pero un envío que mata al worker a propósito (E2) se ejecuta otra vez en cada intento y tumba un worker cada vez |
R2 es la aplicación de un principio de la semana pasada, el de mínimo privilegio, y muestra cómo se relacionan un no riesgo y un riesgo: N2 dice que el sandbox está bien bajo un supuesto, y R2 dice que, si el supuesto falla, no hay una segunda barrera. R4 es un riesgo del tipo “decisión sin tomar”. Y T2 es un punto de trade-off sobre una decisión que todavía no existe: cuando el equipo resuelva R4, va a tener que elegir un número de intentos, y la evaluación ya le avisó que ese número enfrenta a E3 con E2.
En el paso 7, las cuatro personas de la sala propusieron un escenario cada una. Con 4 escenarios, cada persona tuvo 2 votos (el 30 % de 4 es 1,2, que se redondea hacia arriba):
| Escenario propuesto | Clase | Votos |
|---|---|---|
| Un docente corrige un caso de prueba cuando ya hay 250 envíos: todos se recalifican en 60 min o menos y los envíos nuevos mantienen su veredicto en 2 min o menos | de uso | 4 |
| Dos tareas cierran a la misma hora: 40 envíos por minuto durante 30 min | de crecimiento | 2 |
| El disco del servidor se llena durante un cierre | exploratorio | 1 |
| Se agrega la detección de copias entre envíos, que compara cada envío con todos los de la tarea | de crecimiento | 1 |
Los dos más votados entraron a la tabla como E6 y E7. El primero lo propuso el docente, y a quienes diseñaron no se les había ocurrido: para ellos, los envíos llegaban de los estudiantes, de a uno. Su recorrido encontró un riesgo nuevo:
| Id | Tipo | Decisión | Razonamiento |
|---|---|---|---|
| R5 | riesgo | Atender los trabajos en orden de llegada, sin prioridades | Una recalificación mete 250 trabajos de golpe: a 10 por minuto son 25 min en los que todo envío nuevo espera detrás de ellos, contra una medida de 2 min |
E7 no encontró nada nuevo: duplica las llegadas, que es otra manera de mover el punto de sensibilidad S1. Es lo que el paso 8 espera en el mejor caso: un escenario nuevo que el análisis anterior ya cubría.
Por último, los temas. Los cinco riesgos se agrupan en dos:
| Tema | Riesgos | Objetivo del negocio que amenaza |
|---|---|---|
| La tabla de trabajos se adoptó como almacenamiento y nadie decidió sus reglas de cola: capacidad, trabajos abandonados y prioridades | R1, R4, R5 | El estudiante recibe el veredicto mientras todavía está trabajando en la tarea |
| El límite de confianza rodea al worker, y debería rodear al programa del estudiante | R2, R3 | Un veredicto dice la verdad, y nadie ve el código de otra persona |
El primer tema ya estaba escrito. Es, casi palabra por palabra, la cuarta consecuencia del ADR 0003: “la tabla de trabajos trae decisiones que antes no existían y que este ADR no toma: cuántos workers, qué se hace con un trabajo que un worker tomó y no terminó, y si todos los trabajos valen lo mismo”. Las consecuencias malas de un ADR son la lista de cosas que la siguiente evaluación debería mirar primero.
El revisor de la tabla comprueba su forma:
$ node check-atam.ts example/yupana/docs/atam.md
example/yupana/docs/atam.md: ATAM de Yupana, 6 enfoques, 5 escenarios, 5 riesgos, 3 no riesgos, 1 punto de sensibilidad, 2 puntos de trade-off, 2 temas de riesgo: sin errores
Sus reglas son las definiciones de esta sección, convertidas en
comprobaciones: un hallazgo sale de un escenario y de un enfoque que están
en la tabla; nombra una decisión y trae un razonamiento; un punto de
trade-off nombra al menos dos atributos; un tema agrupa al menos dos
riesgos y dice qué objetivo amenaza; y todo escenario recorrido deja al
menos un hallazgo. make errors muestra una tabla que las incumple casi
todas:
errors/atam.md:33: [decision] R1 no nombra una decisión de arquitectura: qué se decidió (o qué falta decidir), no qué podría salir mal
errors/atam.md:33: [razonamiento] R1 no explica por qué: el razonamiento une la decisión con la respuesta del escenario
…
errors/atam.md:35: [atributos] T1 es un punto de trade-off y nombra un solo atributo: un trade-off afecta por lo menos a dos; con uno es un punto de sensibilidad
…
Lo que ATAM no hace
Tan importante como saber qué produce el método es saber qué no produce.
- No dice si la arquitectura es buena. No hay nota ni aprobado. Yupana salió con cinco riesgos, y eso no la hace una mala arquitectura: la hace una arquitectura con cinco cosas que mirar. Una evaluación con cero riesgos es más sospechosa que una con cinco.
- No da números. El reporte es explícito: el método no necesita producir análisis detallados de ninguna medida, y su éxito está en identificar tendencias. La cuenta de la cola dice “no alcanza”; no dice cuál será el p95 del veredicto.
- No reemplaza a medir. Un no riesgo es una hipótesis que pasó un análisis, no una medición. N1 dice que confirmar va a tardar menos de 1 s; solo una prueba de carga lo confirma.
- No arregla nada. El reporte lo dice así: proponer mitigaciones no es parte integral del método. Localiza riesgos; qué hacer con ellos se decide después.
Idea clave. Una evaluación dice dónde mirar. Convierte “¿esta arquitectura está bien?”, que no tiene respuesta, en una lista corta de decisiones concretas, cada una atada a un escenario, que alguien tiene que revisar, medir o volver a tomar.
Trade-off. Evaluar con un método formal cuesta el tiempo de mucha gente y da un resultado que se puede repetir y defender. La alternativa, que una persona con experiencia revise el diseño, es mucho más barata y encuentra buena parte de lo mismo, pero el resultado depende de lo que esa persona haya visto antes, y no trae a la sala a quien opera ni a quien usa. La decisión depende de cuánto cuesta equivocarse: para un sistema como Yupana, un ATAM de tres días sería absurdo; una hora con el docente y la administradora de servidores encontró R5 y R2.
Una versión liviana para un equipo pequeño
Un equipo de cuatro personas no tiene equipo evaluador, ni cincuenta stakeholders, ni tres días. Puede quedarse con lo esencial del método: escenarios priorizados, un recorrido, y la misma clasificación.
La versión liviana dura una hora y necesita tres cosas que el equipo ya tiene: los diagramas, el utility tree y a alguien que no haya diseñado la parte que se evalúa. Si no hay nadie así, una persona del equipo hace ese papel: su trabajo es preguntar, no defender.
| Minutos | Qué se hace | Paso del método |
|---|---|---|
| 5 | Quien dirige recuerda para qué existe el sistema: sus dos o tres objetivos | 2 |
| 10 | Quien diseñó presenta la arquitectura, usando solo los diagramas | 3 |
| 5 | Entre todos listan los enfoques: estilo, datos, llamadas externas, tácticas | 4 |
| 30 | Para cada uno de los tres escenarios (A, A) del utility tree, un recorrido de 10 minutos | 5 y 6 |
| 10 | Agrupar los riesgos en temas y elegir cuál se atiende primero | 9 |
Para cada escenario, la pregunta es una sola, en dos mitades:
¿Qué decisión de nuestro diseño hace posible este escenario, y cuál lo pone en peligro?
La primera mitad produce los no riesgos y los puntos de sensibilidad. La segunda produce los riesgos. Cuando la misma decisión aparece en las dos mitades de dos escenarios distintos, es un punto de trade-off.
Lo que se pierde frente al método completo es, sobre todo, el paso 7: los escenarios que solo se le ocurren a quien no diseñó. Si hay diez minutos más, valen para eso: cada persona propone un escenario que no esté en el árbol, se vota, y se recorre el más votado. En Yupana, ese paso encontró el único riesgo que quienes diseñaron no habrían encontrado solos.
El laboratorio de esta semana es esta versión, con una hora y media y con otra pareja en el papel de quien evalúa.
Risk storming
Esta sección es opcional.
ATAM y su versión liviana empiezan por los escenarios. Risk storming, una técnica de Simon Brown, empieza por los diagramas, y aprovecha algo que los recorridos no usan: que cada persona ve riesgos distintos según lo que le haya pasado antes. Tiene cuatro pasos:
- Dibujar los diagramas de lo que se va a construir o cambiar, en varios niveles. Los de C4 sirven tal como están.
- Identificar los riesgos, cada persona por separado. En silencio y con tiempo limitado, unos diez minutos. Cada quien escribe un riesgo por nota adhesiva, con su prioridad.
- Juntar las notas sobre los diagramas, pegando cada una cerca del elemento donde está el riesgo.
- Revisar y resumir, mirando sobre todo dos cosas: los riesgos que marcó una sola persona, y los riesgos en los que varias personas no coinciden en la prioridad.
La prioridad sale de dos estimaciones, cada una de 1 a 3: qué tan probable es que ocurra y qué tanto impacto tendría. Se multiplican, y el sitio de la técnica propone tres franjas: un producto de 6 o 9 es prioridad alta; de 3 o 4, media; de 1 o 2, baja.
El paso 2 es el que le da valor. Si el grupo conversa primero, la primera persona que habla fija el tema y los demás la siguen. Al escribir por separado, cada quien deja lo que de verdad ve. Y por eso el paso 4 mira las discrepancias: una nota de prioridad alta que puso una sola persona es alguien que sabe algo que el resto no, o alguien que no sabe algo que el resto sí. En los dos casos hay una conversación que vale la pena.
Trade-off. Risk storming es más rápido que un recorrido de escenarios y no necesita que los escenarios existan, lo que lo hace útil al comienzo de un diseño. A cambio, los riesgos no quedan atados a una medida: una nota que dice “los workers no escalan” no dice cuánta carga ni con qué consecuencia, y ahí vuelve el problema de evaluar sin escenarios. Se complementan: risk storming para decidir dónde mirar, y un recorrido para decir qué tan grave es lo que se encontró.
El código de la semana
Todo está en code/week-07/ y se usa dentro del contenedor del curso. Esta semana no usa la base de datos ni la red.
| Carpeta o archivo | Qué contiene |
|---|---|
adr-template.md |
El template de ADR del curso |
adr.ts, check-adr.ts |
El revisor de ADR: las reglas de El template del curso y su revisor |
atam-template.md |
La tabla del ATAM reducido, para el laboratorio |
atam.ts, check-atam.ts |
El revisor de esa tabla |
arc42-template.md, arc42.ts |
El esqueleto de las doce secciones y su revisor |
queue-estimate.ts |
La cuenta de la cola de El recorrido de un escenario |
markdown.ts |
Lo que comparten los revisores: secciones, tablas e ítems |
example/yupana/docs/ |
El ejemplo completo: c4/ (tres diagramas), adr/ (tres ADR), scenarios.md, utility-tree.md, arc42.md y atam.md |
errors/ |
Tres ADR y una tabla de ATAM con los errores de este capítulo |
lab/components.md |
El archivo de partida para el diagrama de componentes de Tinkuy |
*.test.ts |
Las pruebas, que comprueban lo que afirma este capítulo |
El formato de los diagramas y su revisor siguen en code/week-01/
(c4-format.md), y el de los escenarios en
code/week-02/. El Makefile de esta semana los llama; no hay copias.
| Comando | Qué hace |
|---|---|
make o make example |
Revisa el ejemplo completo con los cinco revisores |
make errors |
Revisa los documentos de errors/: falla a propósito |
make check-c4 DOCS=<carpeta docs> |
Revisa c4/context.md, c4/containers.md y c4/components.md de esa carpeta |
make check-adr DOCS=<carpeta docs> |
Revisa todos los ADR de adr/ |
make check-atam DOCS=<carpeta docs> |
Revisa atam.md |
make queue ARRIVALS=20 MINUTES=30 WORKERS=2 SECONDS=12 |
La cuenta de una cola |
make test |
Revisa los tipos y corre las pruebas |
Las pruebas llevan en el nombre la afirmación del capítulo que comprueban:
$ make test
tsc -p .
node --test "*.test.ts"
▶ las partes de un ADR
  ✔ las secciones son las de Nygard más las alternativas consideradas, en este orden (2.21125ms)
  ✔ un ADR completo no tiene errores (4.186416ms)
  ✔ sin una de las cinco secciones, no pasa (1.775708ms)
…
✔ E1 con 2 workers: llegan 20 por minuto, salen 10, quedan 300 y el último espera 30 min (0.951167ms)
✔ con 4 workers la cola no crece, pero no sobra nada: utilización 1 (0.136208ms)
✔ E7, dos tareas cierran a la vez: el doble de llegadas pide el doble de workers (0.246917ms)
✔ punto de sensibilidad: duplicar los segundos por envío duplica los workers necesarios (0.108333ms)
…
ℹ tests 69
ℹ suites 16
ℹ pass 69
ℹ fail 0
…
Vale la pena leer
example.test.ts: comprueba que los
documentos de Yupana no se contradigan entre sí: por ejemplo, que la sección
9 del documento arc42 liste cada ADR con el estado que el ADR dice. Donde
hubo que copiar un dato, una prueba vigila que las dos copias coincidan.
Laboratorio: un ATAM reducido sobre Tinkuy
El laboratorio se hace en grupos de dos parejas. Una pareja presenta su Tinkuy, con los cambios de las semanas 3 a 6, y la otra lo evalúa; después cambian. El material está en code/week-07/. Lo que se evalúa es el diseño de cada pareja, así que no hay un resultado esperado: dos Tinkuy distintos dan dos tablas distintas, y la misma decisión puede ser un riesgo en uno y un no riesgo en otro.
Quien evalúa no busca defectos para ganar una discusión. Hace preguntas y anota. Y quien presenta no defiende: responde con lo que su diseño hace hoy, y “eso no lo decidimos” es una respuesta válida y valiosa.
Paso 1, antes de la sesión: los diagramas. Cada pareja actualiza sus
diagramas de contexto y de contenedores, que vienen de la semana 1, para
que describan su Tinkuy de hoy, y agrega el de componentes del proceso
principal. El archivo de partida es
lab/components.md; se copia a
docs/c4/components.md en su repositorio. Se revisan los tres juntos:
cd /work/code/week-07
make check-c4 DOCS=/work/tinkuy-suusuario/docs
El revisor comprueba que toda caja tenga descripción y tecnología, y toda
flecha un verbo y un protocolo. Lo que no comprueba, y es lo que la otra
pareja va a necesitar, es que los diagramas sean ciertos: si en la semana 6
agregaron Redis y no está en containers.md, la evaluación va a recorrer
un sistema que no existe. Tengan también a mano su utility tree de la
semana 2, con las dos notas de cada escenario. Si cambió, actualícenlo.
Paso 2: la presentación (10 minutos). La pareja que presenta dice los
objetivos del negocio de Tinkuy, los tres escenarios (A, A) de su utility
tree y la arquitectura, usando solo los diagramas. La restricción es el
ejercicio: si para explicar algo tienen que abrir el código, a los
diagramas les falta eso. La pareja que evalúa copia
atam-template.md y llena los
objetivos y los escenarios mientras escucha. Si un escenario no tiene
medida, se detiene la presentación y se la ponen: sin medida no se puede
recorrer.
Paso 3: los enfoques de arquitectura. La pareja que evalúa lista lo que entendió: qué estilo tiene el sistema, cómo está dividido en módulos, dónde están los datos y quién puede leerlos, cómo se llama a la pasarela y qué tácticas hay. Para cada enfoque, dice en qué diagrama y en qué elemento se ve. Quien presenta solo corrige. Este paso muestra qué tanto de la arquitectura llegó a los diagramas: un enfoque que quien presenta tiene que agregar de memoria es uno que no estaba documentado. Todavía no se analiza nada.
Paso 4: los recorridos. Para cada escenario (A, A), quien presenta lo recorre sobre los diagramas: qué elementos intervienen, en qué orden, por qué relaciones. Quien evalúa hace las preguntas del atributo (la tabla de El recorrido de un escenario) y registra cada hallazgo en la tabla, con su tipo, la decisión y el razonamiento. Dos reglas ayudan. Toda fila nombra una decisión, no un síntoma. Y si el recorrido no encuentra problemas, se anota el no riesgo con su supuesto: es un resultado, no una fila vacía. Donde se pueda, hagan una cuenta, como la de la cola. No propongan soluciones todavía.
Paso 5: escenarios nuevos. Cada una de las cuatro personas propone un escenario que nadie había considerado: un cambio, una falla, un pico. Ayuda pedir uno de cada clase: de uso, de crecimiento y exploratorio. Con cuatro escenarios, cada persona tiene dos votos. Los dos más votados entran a la tabla con origen “lluvia de ideas” y se recorren igual. Miren qué pasa: si el recorrido no encuentra nada nuevo, el análisis anterior era sólido; si encuentra un riesgo, miren quién propuso el escenario y por qué a quienes diseñaron no se les había ocurrido.
Paso 6: los temas. Con todos los riesgos a la vista, busquen qué tienen en común. ¿Hay una causa detrás de varios? Cada tema se compara con los objetivos del negocio del paso 2. Si los riesgos no comparten causa, la tabla de temas queda vacía, y eso también es un resultado. Al terminar, revisen la tabla:
make check-atam DOCS=/work/tinkuy-suusuario/docsPaso 7: cambiar de papeles y repetir los pasos 2 a 6. La segunda vuelta suele salir más rápida y con mejores preguntas: quien acaba de ser evaluado ya sabe qué preguntas duelen.
Paso 8: un ADR. Cada pareja escribe un ADR para el riesgo más grave que
le encontraron, con adr-template.md: el
contexto con el escenario, al menos tres alternativas con lo que cada una
gana y cuesta, la decisión y las consecuencias. Puede quedar en estado
Propuesto: el objetivo es escribirlo mientras se decide, no después. Lo
revisan con make check-adr y se lo pasan a la otra pareja, que lo lee con
una sola pregunta: ¿alguien que no estuvo hoy entendería por qué se
decidió así? Si la respuesta es no, falta contexto, o falta la
alternativa que esa persona habría propuesto.
Lo que cada pareja se lleva: tres diagramas al día, una tabla con lo que otra pareja vio en su diseño, y un ADR. P2 se entrega la próxima semana, y sus ADR siguen este template.
Resumen
- La documentación de una arquitectura responde preguntas de lectores distintos: quien construye, quien llega después, quien evalúa y quien opera. Un diagrama que intenta responderlas todas no responde ninguna.
- Una vista es la representación de una estructura para un lector. Lleva el diagrama, el catálogo de elementos, la leyenda y la justificación. Un diagrama sin leyenda son cajas y flechas con significado privado.
- C4 mira el sistema con cuatro niveles de zoom: contexto (el sistema y sus vecinos), contenedores (lo que corre o guarda datos por separado), componentes (las partes de un contenedor) y código (casi nunca se dibuja). Los complementan el diagrama dinámico y el de despliegue. Toda caja dice qué es, qué hace y con qué tecnología; toda flecha tiene dirección, verbo y protocolo.
- arc42 es un índice de doce secciones para el documento completo. Se llena lo que alguien va a leer, y se enlaza en vez de copiar.
- Un ADR es un documento corto por decisión: título, contexto, decisión, estado y consecuencias, según Nygard; el curso agrega las alternativas consideradas, y pide que el contexto nombre el escenario.
- Un ADR no se reescribe. Si la decisión cambia, otro ADR la reemplaza y en el anterior solo cambia el estado. Su valor es poder reconstruir qué se sabía cuando se decidió.
- Merece un ADR lo que cuesta cambiar, lo que alguien va a preguntar y lo que parece raro sin su contexto.
- ADD ordena el diseño en iteraciones de siete pasos. Se empieza por los escenarios y no por la tecnología; cada decisión queda atada a un escenario; se para cuando los escenarios prioritarios tienen respuesta.
- Una decisión de diseño es una hipótesis. Se prueba con un análisis, un prototipo o una medición, en ese orden de costo.
- ATAM evalúa una arquitectura recorriendo escenarios sobre sus enfoques, en nueve pasos: presentar el método, los objetivos del negocio y la arquitectura; identificar los enfoques, generar el utility tree y analizar; lluvia de ideas con todos los stakeholders y analizar de nuevo; presentar los resultados.
- Produce riesgos (decisiones que pueden impedir un escenario), no riesgos (decisiones que están bien bajo un supuesto), puntos de sensibilidad (propiedades de las que depende mucho un atributo) y puntos de trade-off (puntos de sensibilidad para más de un atributo). Los temas de riesgo agrupan los riesgos por lo que tienen en común y los comparan con los objetivos del negocio.
- ATAM no dice si la arquitectura es buena, no da números, no reemplaza a medir y no arregla nada. Dice dónde mirar.
- La versión liviana cabe en una hora: el utility tree, los tres escenarios (A, A) y, para cada uno, qué decisión lo hace posible y cuál lo pone en peligro.
Ejercicios
-
Para cada pregunta, digan qué diagrama de Yupana la responde (contexto, contenedores, componentes de la API, dinámico o de despliegue) y qué lector la haría. (a) Si se cae el sistema de matrícula a las 3 de la tarde, ¿algún estudiante deja de poder enviar? (b) ¿Qué módulos hay que revisar si cambia la forma de saber quién es docente de una sección? (c) ¿Los workers y PostgreSQL compiten por la misma CPU? (d) ¿En qué momento exacto un envío pasa a estar “confirmado”? (e) ¿Yupana guarda contraseñas? Para una de las cinco, muestren que otro diagrama parecería responderla y daría una respuesta incompleta.
-
Ordenen estos hechos y digan qué archivos existen al final en
docs/adr/, con el estado de cada uno. Luego comprueben su respuesta escribiendo los archivos mínimos y corriendocheck-adr.tssobre la carpeta. (a) El equipo propone el ADR 0007. (b) Se acepta. (c) Alguien propone el 0008, que reemplazaría al 0007. (d) El equipo rechaza el 0008. (e) Alguien propone el 0009, que también reemplazaría al 0007. (f) Se acepta el 0009. (g) El módulo sobre el que decidía el 0009 se elimina del sistema. ¿En qué momento, exactamente, cambió el estado del 0007? -
La facultad contrata un servicio de almacenamiento de objetos con respaldo, y los cursos avanzados piden aceptar proyectos de varios archivos, de hasta 20 MB. Escriban el ADR que revisa la decisión del ADR 0002 de Yupana. Tiene que pasar el revisor. Digan qué cambia en el archivo del 0002 y qué no. Atención: que el contexto haya cambiado no obliga a cambiar la decisión; si deciden mantenerla, ¿hace falta un ADR nuevo?
-
Hagan la segunda iteración de ADD sobre Yupana, con el objetivo de atender E3 (un worker muere a mitad de una calificación). Escriban los siete pasos. En el paso 4, propongan al menos tres conceptos de diseño de las tácticas de disponibilidad de la semana 6 y digan, para cada uno, si atiende “0 envíos perdidos”, “veredicto en 5 min” y “0 envíos con dos veredictos”. En el paso 7, digan qué escenario quedó peor que antes.
-
Clasifiquen cada frase como riesgo, no riesgo, punto de sensibilidad, punto de trade-off o “todavía no es un hallazgo”, y justifiquen. Las que no sean un hallazgo, reescríbanlas para que lo sean. (a) “La aplicación web pregunta por el veredicto cada 3 s.” (b) “Yupana podría caerse la noche de un cierre.” (c) “La sesión propia de Yupana dura 8 horas.” (d) “Los casos de prueba no están en el respaldo nocturno.” (e) “El cierre de una tarea se compara con el reloj de la base de datos y no con el del navegador.” (f) “PostgreSQL es un punto único de falla.” Para (c) van a necesitar E5 y un escenario de seguridad que no está en el utility tree: escríbanlo.
-
Con
make queue, respondan para Yupana: (a) ¿cuántos workers hacen falta para que, con las llegadas de E1, la utilización no pase de 0,8? (b) Si todos los docentes bajan el límite de tiempo de modo que el promedio sea 6 s por envío, ¿alcanzan los 2 workers? (c) La cuenta supone llegadas a ritmo constante. En un cierre real, la mitad de los envíos llega en los últimos 5 minutos. Rehagan la cuenta a mano para ese caso, con 4 workers, y digan cuánto espera el último. (d) ¿Qué conclusión de la cuenta original sigue en pie y cuál no? -
Recorran E5 (el proveedor de identidad no responde durante 15 minutos) sobre los diagramas de Yupana. Listen los elementos que intervienen, y registren al menos un no riesgo con su supuesto y un punto de trade-off, en el formato de la tabla. Agreguen sus filas a una copia de
atam.mdy pásenla por el revisor. -
Después de una evaluación, alguien escribe en el acta: “Se aplicó ATAM. No se encontraron riesgos. La arquitectura es adecuada y cumple los requisitos de rendimiento.” Encuentren los tres errores de esa frase, y reescriban el acta con lo que una evaluación sin riesgos sí permite afirmar.
-
En su Tinkuy, elijan una decisión que merezca un ADR y una que no, y justifiquen cada una con las tres preguntas de Qué merece un ADR. Luego busquen una decisión que se tomó sin decidir, como A4, A5 y A6 en Yupana: algo que quedó así y que nadie eligió contra una alternativa. ¿Qué alternativas tenía?