Apuntes · Capítulo 8Estilos, tácticas y decisiones
Repaso: de los requisitos a una arquitectura decidida, documentada y evaluada
Repaso: de los requisitos a una arquitectura decidida, documentada y evaluada
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): Cómo usar este capítulo, El hilo de las siete semanas y Un caso nuevo: Apachi. De las siete secciones de repaso, lean primero la de la semana que menos recuerden.
- En clase: Sesión A: un repaso rápido de las siete secciones (Semana 1: qué es la arquitectura y qué la determina, Semana 2: atributos de calidad, escenarios y medidas, Semana 3: módulos, acoplamiento y dependencias, Semana 4: estilos monolíticos, Semana 5: estilos distribuidos, Semana 6: tácticas y Semana 7: decidir, documentar y evaluar) y, sobre todo, los Ejercicios resueltos, que se hacen en la pizarra antes de mirar la solución. Sesión B: el examen parcial. Esta semana no hay laboratorio: ese tiempo es para cerrar P2, con la lista de Revisar su P2 con estos criterios.
- Después de clase: los Ejercicios del final, en papel. Opcionales: El código de la semana y
make testy, de los resueltos, 6. Un fragmento con acoplamiento.
En siete semanas recorrieron un camino completo. Empezamos por qué es una arquitectura y qué la determina; seguimos con la forma de escribir lo que se le pide (escenarios con una medida) y de priorizarlo; después vinieron los módulos y sus dependencias, los estilos monolíticos y los distribuidos, las tácticas, y la semana pasada, cómo se decide, se documenta y se evalúa. Cada tema tuvo su semana, pero en un sistema real son un solo hilo: de un requisito sale un escenario, del escenario una decisión, y la decisión queda en un módulo, en un diagrama y en un ADR.
Esta semana no hay temas nuevos. El capítulo tiene un solo propósito: que puedan aplicar esas ideas a un sistema que no han visto. La primera mitad repasa cada semana: lo que hay que tener preciso y cómo se conecta con las demás. La segunda resuelve diez ejercicios sobre un caso nuevo, Apachi, el sistema de encomiendas de una empresa de transporte. Las cuentas de esos ejercicios (percentiles, disponibilidad, ciclos) las hace un programa de la carpeta de la semana, y lo que se muestra aquí es su salida.
Lectura. Las Preguntas de repaso de las guías de las semanas 1, 2, 3, 4, 5, 6 y 7, y
exams/README.md, que describe el formato del examen y cómo estudiar, además del parcial de práctica. Complementarias: las lecturas principales que no hayan alcanzado a leer. Pesan más Software Architecture in Practice, cap. 1, 3, 8, 9 y 4; el artículo de Parnas, y el artículo de Nygard sobre los ADR. El código de los ejercicios resueltos está en code/week-08/ y se prueba conmake testdentro del contenedor del curso.
Cómo usar este capítulo
Las secciones de repaso no reemplazan a los capítulos: los resumen, con los mismos nombres y la misma notación. Si una viñeta no les dice nada, vuelvan al capítulo de esa semana, que tiene el ejemplo completo.
Los ejercicios resueltos sirven solo si los intentan antes de leer la solución: lean el enunciado, respondan en papel y después comparen. Lo que hay que comparar no es si llegaron a la misma respuesta, sino si la suya tiene las mismas partes: el escenario que la motiva, al menos una alternativa y lo que se sacrifica.
Error común. Estudiar memorizando listas de tácticas o de estilos. Una pregunta de arquitectura da un caso que no han visto y pide decidir y justificar. Una respuesta que nombra la solución sin decir qué se sacrifica está incompleta, por correcta que sea la solución.
Semana 1: qué es la arquitectura y qué la determina
Lo que hay que tener preciso:
- Dos definiciones que se complementan. La arquitectura de un sistema es el conjunto de estructuras necesarias para razonar sobre él; cada estructura tiene elementos, relaciones y propiedades. Y, de todas las decisiones de un sistema, son de arquitectura las que cuesta cambiar. La prueba práctica de la segunda: ¿cuántos archivos, cuántos equipos y cuántos despliegues toca deshacerla?
- Tres tipos de estructuras, cada uno con su pregunta. Las de módulos (el código y sus dependencias; existen con el sistema apagado) responden qué toca un cambio. Las de componentes y conectores (lo que existe mientras el sistema corre) responden qué pasa con la latencia y con las fallas. Las de asignación (máquinas, repositorios, equipos) responden quién lo construye y dónde corre.
- ASR: un requisito que, si cambiara, cambiaría la arquitectura. Casi nunca dice qué hace el sistema: dice cuánto, qué tan rápido, con qué frecuencia cambia algo o qué pasa si falla. Si no se puede decir cuándo se incumple, todavía no es un requisito.
- Restricción: una decisión que ya viene tomada. Un requisito se negocia; una restricción, no. Detrás de una restricción auténtica hay un contrato, una ley, un presupuesto o algo que la organización ya opera.
- C4, niveles de contexto y de contenedores. El de contexto muestra el sistema como una caja, con sus personas y sus sistemas externos. El de contenedores la abre: lo que tiene que estar corriendo o existir para que funcione (un contenedor de C4 no es un contenedor de Docker). En el curso son dos tablas: elementos (nombre, tipo, descripción, tecnología) y relaciones (de, hacia, qué viaja, protocolo), y la flecha va en la dirección de quien inicia.
Cómo se conecta: la semana 1 deja dos listas, los candidatos a ASR y las decisiones que cuesta cambiar. La semana 2 convierte la primera en escenarios; las semanas 3 a 6 dan las herramientas para decidir, y la 7, cómo se escribe lo decidido.
Error común. Clasificar por el tema y no por la prueba. “Los avisos salen por SMS” suena técnico y es un requisito funcional; “las tarifas cambian seis veces al año” suena a negocio y es un ASR. La prueba es siempre la misma: cámbienlo y miren si el diseño tendría que ser otro.
Semana 2: atributos de calidad, escenarios y medidas
Lo que hay que tener preciso:
- El escenario de seis partes: fuente del estímulo, estímulo, artefacto, entorno, respuesta y medida de la respuesta. Sin medida no es un escenario, y sin entorno la medida no dice nada. El escenario general de un atributo es el menú de valores posibles; el concreto es el de un sistema, con números.
- Percentiles por rango más cercano. Se ordenan las mediciones de menor a mayor; el percentil es la que ocupa la posición , contando desde 1. El resultado siempre es una de las mediciones; el p100 es el máximo, y con pocas mediciones los percentiles altos coinciden con él. k6 interpola, así que con muestras pequeñas da otro número: hay que decir con qué método se calculó.
- Por qué no el promedio: unos pocos valores extremos lo arrastran y mezcla poblaciones, así que puede no describir a ningún pedido. Sirve para capacidad y costo, no para la experiencia de quien espera.
- Los percentiles no se promedian, ni entre máquinas ni entre intervalos. Se juntan las mediciones (o los histogramas) y se calcula sobre el total.
- Disponibilidad: la fracción del tiempo (o de los pedidos) en que el sistema responde bien. Tres nueves son 8,76 horas al año. Si una operación necesita a todas sus partes, están en serie y se multiplican: . Si basta una de varias copias, están en paralelo: . Las dos cuentas suponen fallas independientes. También : se mejora fallando menos o recuperándose más rápido.
- Utility tree: atributos, refinamientos y escenarios en las hojas, cada una con dos notas (valor para el negocio, dificultad técnica). Los (A, A) definen la arquitectura. Si todo sale (A, A), el árbol no priorizó nada.
- Trade-off: una decisión que mejora un atributo y cuesta otro. Se escribe con el escenario, la decisión, la alternativa y el costo.
Cómo se conecta: el escenario es la unidad de todo lo que sigue. Un estilo se elige contra los escenarios (A, A) (semana 5), una táctica responde al estímulo de un escenario (semana 6), el contexto de un ADR nombra su escenario y un ATAM recorre escenarios sobre el diseño (semana 7).
Idea clave. De la serie salen dos consecuencias que valen más que la fórmula: el conjunto siempre es peor que su peor parte, y cada dependencia que se agrega al camino de una operación le resta disponibilidad.
Semana 3: módulos, acoplamiento y dependencias
Lo que hay que tener preciso:
- El criterio de Parnas: dividir por lo que puede cambiar, no por el orden en que se ejecuta. En el índice KWIC, la división por pasos y la división por decisiones funcionan las dos; cuando cambia la forma de guardar las líneas, la primera se reescribe casi entera y la segunda en un módulo.
- Ocultamiento de información y cohesión: la interfaz de un módulo es todo lo que los demás pueden suponer de él, y un módulo cohesivo cambia entero y por una razón. La medida que sirve para diseñar: cuántos módulos toca un cambio probable.
- Acoplamiento y connascence: dos elementos tienen connascence cuando un cambio en uno exige un cambio en el otro. Estáticas, de la más débil a la más fuerte: de nombre, de tipo, de significado, de posición, de algoritmo. Dinámicas: de ejecución, de tiempo, de valor, de identidad. Se mira en tres ejes (fuerza, localidad, grado), y la regla es que cuanto más lejos están dos elementos, más débil debe ser lo que los ata.
- El grafo de dependencias se calcula a partir de los imports: una flecha
de A a B si A importa algo de B. Un ciclo convierte a sus módulos en
uno solo con varios nombres: no se entienden, prueban, reutilizan ni
separan por separado. Un ciclo de
import typetambién es un ciclo. - Estabilidad: lo que cambia mucho debe depender de lo que cambia poco. La inestabilidad de un módulo es , con los que dependen de él y aquellos de los que depende. La métrica no dice qué está mal: dice dónde mirar.
- Cuatro maneras de romper un ciclo: fusionar los módulos, subir la
función que cruza, mover lo compartido a un módulo
shared(casi siempre una falsa solución) e invertir una dependencia. En la inversión, el módulo que necesita algo declara la interfaz, el otro la implementa y un tercero los conecta: elimportcambia de dirección; la llamada, no. Es la base de ports y adapters, donde el núcleo declara ports y no importa nada de afuera. - Reglas que se comprueban: un
index.tspor módulo y reglas de dependency-cruiser confromyto(sin ciclos, una capa no importa lo que no le corresponde, a un módulo se entra por su índice). Una regla nueva se ve fallar antes de confiar en ella. La herramienta ve imports: no ve el acoplamiento por la base de datos.
Cómo se conecta: la semana 3 es la semana 1 con herramientas. La estructura de módulos responde qué toca un cambio, y el escenario de modificabilidad de la semana 2 le pone número. Las reglas de dependencia son lo que hace que un estilo de la semana 4 exista de verdad.
Semana 4: estilos monolíticos
Lo que hay que tener preciso:
- Un estilo es un vocabulario de elementos y conectores más un conjunto de restricciones. Sus propiedades salen de las restricciones: un estilo que no se hace cumplir no da nada. Un patrón resuelve un problema local dentro de esa forma.
- Monolítico o distribuido es una pregunta sobre el despliegue: una unidad o varias. Un monolito da llamadas locales, transacciones simples y un solo despliegue; cobra despliegue acoplado, recursos compartidos y escalado en bloque. Monolito no es sinónimo de big ball of mud: son ejes distintos.
- Capas: se divide por rol técnico y cada capa usa solo la de abajo. Aísla tecnologías; un cambio de negocio atraviesa todas las capas, y las capas cerradas producen sumideros.
- Por rol técnico o por dominio: decide qué tipo de cambio llega más seguido. En Qhatu, el mismo cambio de negocio tocó cuatro carpetas en una versión y una en la otra; el cambio técnico cae al revés. No hay división que abarate todos los cambios.
- Modular monolith: un solo despliegue, con módulos por dominio que cumplen tres condiciones que se comprueban en cada build: interfaz pública, datos propios y dependencias sin ciclos. Da buena parte de la modificabilidad de los microservicios sin pagar la red; no da lo que depende del despliegue. Los datos son el límite más difícil.
- Monolith first: los límites de un dominio se descubren con el uso, y moverlos entre módulos cuesta mucho menos que entre servicios.
- Pipeline: filtros que solo conocen su entrada y su salida; el acoplamiento es el formato de los datos.
- Microkernel: un núcleo estable y plug-ins que implementan un contrato y se inscriben en un registro. Agregar una variante no toca el núcleo; cambiar el contrato toca todo. Un punto de extensión se compra para un cambio que un escenario anuncia.
- Los estilos se combinan: se eligen por parte del sistema y por atributo.
Cómo se conecta: cada estilo es una respuesta empaquetada a un tipo de escenario de la semana 2, casi siempre de modificabilidad, y sus restricciones se escriben como las reglas de la semana 3.
Error común. Llamar “modular” a un monolito porque tiene carpetas. Sin interfaz pública y sin regla que la proteja, una carpeta es solo un nombre.
Semana 5: estilos distribuidos
Lo que hay que tener preciso:
- Se distribuye para cumplir un escenario que el monolito no cumple: escalar o desplegar una parte sola, aislar una falla, que varios equipos no se pisen, repartir una carga que no cabe en una máquina. Sin escenario, no hay razón.
- Lo que cambia al cruzar la red: la llamada tarda órdenes de magnitud más, su tiempo se vuelve una distribución, y falla de maneras que quien llama no distingue (“no llegó” y “llegó y la respuesta se perdió” se ven igual). Un timeout no cancela nada. Las ocho falacias son los supuestos que en un monolito son verdad y en un sistema distribuido hay que pagar.
- Service-based: pocos servicios grandes, por dominio, normalmente sobre una base de datos compartida. Despliegue y escalado por partes sin renunciar a las transacciones.
- Microservicios: servicios pequeños, cada uno owner de sus datos, con
un bounded context como límite. Dan independencia entre equipos; cuestan
los
JOIN, las transacciones, la operación y la facilidad de mover límites. - Una cadena síncrona es una serie: cuatro componentes de 99,9 % dan 99,6 %. Con tablas compartidas y despliegues atados, además, se tiene un monolito distribuido: los costos de los dos mundos.
- Comando y evento: un comando pide que algo pase y va dirigido a alguien; un evento dice que algo ya pasó y no va dirigido a nadie. Con un comando, quien envía conoce al que recibe; con un evento, la dependencia se invierte.
- Event-driven saca trabajo del camino de la respuesta. Cobra consistencia eventual, flujos que no están escritos en ningún lugar, un broker del que todo depende, y tres preguntas que el diseño tiene que responder: qué pasa si falla a la mitad, qué pasa con los duplicados y qué pasa con el orden. Topologías: broker (sin coordinador, nadie tiene el flujo) y mediator (un coordinador que envía comandos; más control, más acoplamiento).
- Cómo se elige un estilo: tomar los escenarios (A, A); para cada candidato, decir con una frase concreta cómo cumple cada escenario o por qué no; sumar el costo de operarlo; elegir y escribir qué se sacrifica. Siempre se compara contra no cambiar nada, y la pregunta que más descarta es si el equipo lo puede operar.
Cómo se conecta: distribuir cambia la estructura de componentes y conectores de la semana 1 y pone a prueba las cuentas de disponibilidad de la semana 2. Un evento es la inversión de dependencias de la semana 3 hecha con mensajes.
Error común. Elegir el estilo por la empresa que lo hizo famoso. La pregunta útil no es “¿qué usan ellos?”, sino “¿qué escenario tenían ellos, y lo tengo yo?”.
Semana 6: tácticas
Lo que hay que tener preciso:
- Táctica: una decisión de diseño que influye sobre la respuesta a un estímulo de un atributo. Es más pequeña que un patrón (un patrón empaqueta varias tácticas) y se define por su efecto sobre un atributo: lo que les hace a los demás es el trade-off, y hay que mirarlo aparte.
- Modificabilidad: aumentar la cohesión, reducir el acoplamiento (encapsular, usar un intermediario, restringir dependencias) y diferir el enlace (configuración, registro de plug-ins). Son las semanas 3 y 4 con nombre. Cuanto más tarde se enlaza, más barato es el cambio y más cara la infraestructura que lo permite.
- Rendimiento: el tiempo de una petición se reparte en tiempo de procesamiento y tiempo bloqueado. Primero se mide dónde se va; después se elige. Dos grupos. Controlar la demanda: limitar la tasa de llegada (rate limiting), limitar la respuesta a eventos (colas con tamaño máximo), priorizar, reducir el costo de cada petición, acotar el tiempo de ejecución. Administrar los recursos: más recursos, concurrencia, varias copias del cómputo (réplicas detrás de un load balancer), varias copias de los datos (cache, réplicas de lectura), acotar el tamaño de las colas, planificar el uso de un recurso escaso.
- Tres casos que hay que saber explicar: el pool de conexiones (pone un tope a la concurrencia sobre la base de datos; más conexiones no es más rápido), el N+1 (una consulta para la lista y una más por cada elemento) y la cache (se gana latencia; se abren los datos viejos y la invalidación).
- Disponibilidad: una falta es la causa; una falla es lo que ve quien usa el sistema cuando deja de cumplir su especificación. Tres grupos. Detectar: monitor, ping y eco, heartbeat, timeout, votación, detección de excepciones. Recuperarse: redundancia, rollback, retry, degradación, reconfiguración, y la reintroducción del componente (modo sombra, resincronización del estado). Prevenir: sacar un componente de servicio, transacciones, prevención de excepciones. Sin detección no hay recuperación, y un retry puede duplicar una operación o cargar más a un servicio que ya está saturado.
- Seguridad: confidencialidad, integridad y disponibilidad. Cuatro grupos. Detectar (intrusos, denegación de servicio, integridad de los mensajes), resistir (identificar, autenticar y autorizar; limitar el acceso y la exposición; cifrar; separar entidades; validar la entrada), reaccionar (revocar el acceso, informar) y recuperarse (auditoría, y las tácticas de disponibilidad). De Saltzer y Schroeder: mínimo privilegio, valores por defecto seguros, mediación completa. Los límites de confianza son estructura.
Cómo se conecta: una táctica es la respuesta más pequeña a un escenario de la semana 2, y su costo es un trade-off. Se puede aplicar sin cambiar de estilo, y por eso se prueba primero.
Error común. Optimizar sin medir. La táctica correcta para un cuello de botella que no es el que limita no cambia nada.
Semana 7: decidir, documentar y evaluar
Lo que hay que tener preciso:
- Una vista es la representación de una estructura, y se elige por lo que su lector necesita saber: quien construye, quien llega dentro de un año, quien evalúa, quien opera.
- C4: cuatro niveles de zoom. Contexto (el sistema, las personas y los sistemas externos), contenedores (lo que corre por separado), componentes (las partes de un contenedor) y código (casi nunca se dibuja). Para el documento completo, arc42 da un template de doce secciones; se llena lo que alguien va a leer.
- ADR: un documento corto por decisión, numerado y guardado en el repositorio. El formato de Nygard tiene título, contexto, decisión, estado y consecuencias (las buenas y las malas); el curso agrega las alternativas consideradas, cada una con lo que gana, lo que cuesta y por qué se descartó. El contexto nombra el escenario que empuja la decisión.
- Un ADR no se reescribe. Si la decisión cambia, se escribe otro que lo reemplaza, y en el anterior solo cambia el estado. Merece un ADR lo que cuesta cambiar y lo que parece raro sin su contexto.
- ADD, diseño guiado por atributos, por iteraciones: fijar el objetivo, elegir qué elemento se refina, elegir conceptos de diseño (estilos, tácticas, tecnologías) para los escenarios elegidos, asignar responsabilidades, registrar las decisiones y analizar si hace falta otra iteración. Se empieza por los escenarios, no por la tecnología.
- ATAM: quienes diseñaron y los stakeholders recorren los escenarios del utility tree sobre los enfoques de arquitectura. Produce cuatro tipos de hallazgo. Un riesgo es una decisión (o una que falta tomar) que puede impedir un escenario. Un no riesgo es una decisión que se analizó y está bien, bajo un supuesto que se escribe. Un punto de sensibilidad es una propiedad de la que depende mucho la respuesta de un atributo. Un punto de trade-off es una propiedad que afecta a dos atributos o más en sentidos opuestos. Y los temas de riesgo: lo que varios riesgos tienen en común.
- Lo que ATAM no hace: no dice si la arquitectura es buena, no da números y no reemplaza a medir. Dice dónde mirar.
Cómo se conecta: el ADR es la frase de trade-off de la semana 2 con formato; los diagramas son las estructuras de la semana 1, y el ATAM usa el utility tree para encontrar dónde los estilos y las tácticas elegidos no alcanzan.
En la industria. El artículo de Michael Nygard que dio forma a los ADR pide documentos de una o dos páginas, en frases completas, con todas las consecuencias, también las negativas y las neutras. Cuando una decisión se revierte, el documento anterior se conserva y se marca como reemplazado. Y observa que las consecuencias de un ADR suelen volverse el contexto de los siguientes. Fuente: Documenting Architecture Decisions (2011).
El hilo de las siete semanas
Puestas en fila, las siete semanas son un procedimiento. Cada paso recibe lo que produjo el anterior:
| Paso | Qué se hace | Qué produce | Semana |
|---|---|---|---|
| 1 | Separar lo que piden en requisitos funcionales, candidatos a ASR y restricciones | Una lista corta de lo que puede cambiar el diseño | 1 |
| 2 | Escribir cada candidato como escenario y priorizarlos | Un utility tree con sus (A, A) | 2 |
| 3 | Mirar lo que hay: módulos, dependencias, procesos | El grafo, los diagramas de contexto y de contenedores | 1 y 3 |
| 4 | Para cada (A, A), proponer candidatos: un estilo, una táctica, no cambiar nada | Una tabla de candidatos contra escenarios, con su costo | 4, 5 y 6 |
| 5 | Elegir, y decir qué se sacrifica | Un ADR con sus alternativas | 7 |
| 6 | Recorrer los escenarios sobre el diseño elegido | Riesgos, no riesgos, puntos de sensibilidad y de trade-off | 7 |
| 7 | Comprobar: medir, o hacer que el build lo revise | Una medición antes y después; una regla de dependencia | 2, 3 y 6 |
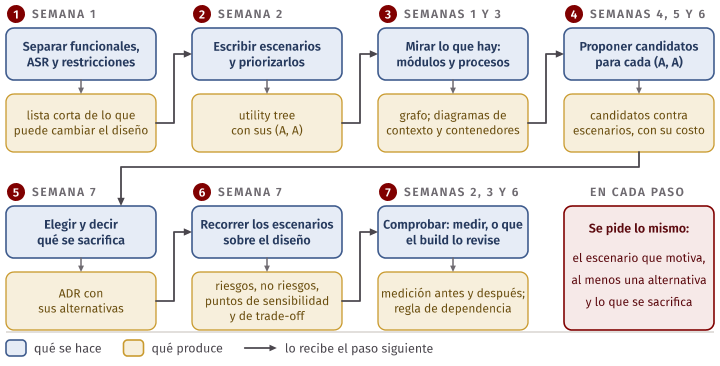
Los ejercicios resueltos siguen ese orden sobre un mismo sistema. Frente a una pregunta suelta conviene saber en qué paso están y qué recibió ese paso del anterior.
Idea clave. En todos los pasos se pide lo mismo: el escenario que motiva la decisión, al menos una alternativa y lo que se sacrifica. Es la regla de trabajo de la semana 1, y sirve para revisar cualquier respuesta antes de entregarla.
Un caso nuevo: Apachi
Apachi (del quechua apachiy, enviar) es el sistema de encomiendas de una empresa de transporte interprovincial con 38 agencias. No existe: sirve para practicar con un sistema que no es Tinkuy. Hoy es un monolito en la nube, con PostgreSQL, y las agencias entran con el navegador. De las reuniones con la empresa salió esta lista, tal como la dijeron (está en case/requirements.md):
- El encargado de la agencia registra una encomienda (remitente, destinatario, peso, valor declarado, destino); el sistema calcula el precio y entrega una guía con un código de seguimiento.
- El destinatario consulta el estado de su encomienda con el código, desde su celular, sin crear una cuenta.
- El destinatario recibe un SMS con el código cuando la encomienda se registra, y otro cuando llega a la agencia de destino.
- Para recoger, el destinatario muestra su DNI; el sistema guarda quién entregó y a quién.
- El sistema tiene que ser robusto y fácil de usar.
- En la campaña de diciembre se registran unas 9 000 encomiendas al día (un día normal son 1 500), y por las tardes llegan unas 40 consultas de seguimiento por segundo.
- Doce agencias de la sierra y de la selva pierden la conexión a internet varias veces al mes, a veces por horas. El mostrador no puede dejar de recibir encomiendas.
- Las tarifas cambian por ruta y por temporada. Gerencia comercial las cambia unas seis veces al año, y hoy cada cambio demora dos semanas.
- Cada encomienda lleva un comprobante electrónico. Lo emite un proveedor de facturación con el que la empresa ya tiene contrato.
- El sistema corre en la nube de un proveedor que la empresa ya contrató. El equipo son cinco personas, que conocen TypeScript y PostgreSQL.
- Una encomienda registrada no se puede perder, ni entregarse a quien no es su destinatario.
Ejercicios resueltos
1. De la lista de requisitos a los ASR
Enunciado. Clasifiquen cada punto de la lista como requisito funcional, ASR o restricción. Digan qué preguntas le harían a la empresa.
Solución. La prueba para cada uno: si cambiara, ¿cambiaría la arquitectura?
| # | Clasificación | Por qué |
|---|---|---|
| 1 | Funcional | Un formulario y una función. Pedir además el DNI del remitente no cambia la forma del sistema. |
| 2 | Funcional | Una consulta por código. “Sin crear una cuenta” importa para la seguridad (véase el 11). |
| 3 | Funcional, y esconde un ASR | Crea una dependencia de un proveedor de SMS. Falta preguntar: si no responde, ¿el mostrador deja de registrar? |
| 4 | Funcional | Un dato más en la entrega. |
| 5 | Todavía no es un requisito | No se puede decir cuándo se incumple. |
| 6 | ASR | Dice cuánto: seis veces la carga normal, y 40 consultas por segundo. |
| 7 | ASR | Dice qué pasa si algo falla. Si el enlace no se cayera, cualquier diseño central serviría. |
| 8 | ASR | Dice con qué frecuencia cambia algo, y cuánto cuesta hoy cambiarlo. |
| 9 | Restricción, y esconde un ASR | El proveedor ya está contratado: no se elige. La misma pregunta que en el 3. |
| 10 | Restricciones | La nube, el tamaño del equipo y lo que el equipo conoce ya vienen dados. |
| 11 | Dos ASR sin medida | “No se puede perder” y “no se entrega a otro” dicen qué pasa si algo falla; falta el número. |
Dos cosas que una buena respuesta dice además de la tabla. Primero, los requisitos 3 y 9 parecían inocentes hasta preguntar “¿y si falla?”. La empresa respondió que el mostrador sigue recibiendo y que el SMS y el comprobante pueden llegar después. (Es un supuesto del caso: en un sistema real, cuándo puede emitirse un comprobante lo dice la norma tributaria.) Segundo, el requisito 7 choca con el diseño actual: un mostrador que es una página servida desde la nube no puede registrar sin enlace. Ese conflicto es la decisión de arquitectura del caso.
2. Tres escenarios y un utility tree
Enunciado. Escriban como escenarios de seis partes los requisitos 7, 6 (solo el seguimiento) y 8. Corrijan después este intento de un compañero: “Fuente: los usuarios. Estímulo: consultan sus encomiendas. Artefacto: el sistema. Respuesta: el sistema responde. Medida: siempre en un tiempo razonable”.
Solución. Los tres, tal como quedaron en case/scenarios.md:
| Parte | E1, disponibilidad | E2, rendimiento | E3, modificabilidad |
|---|---|---|---|
| Fuente del estímulo | El enlace a internet de una agencia de la sierra | Destinatarios, desde su celular | Gerencia comercial |
| Estímulo | Deja de funcionar durante 2 horas | 40 consultas de seguimiento por segundo durante 2 horas | Pide una tarifa nueva para una ruta y una temporada |
| Artefacto | El registro de encomiendas en el mostrador de esa agencia | El endpoint de seguimiento (GET /tracking/:code) |
El módulo de tarifas |
| Entorno | Campaña de diciembre, con unas 40 encomiendas por hora en esa agencia | Una tarde de la campaña, con 90 000 encomiendas en tránsito | El sistema en operación, fuera de campaña |
| Respuesta | El mostrador sigue registrando y entrega la guía con su código; al volver el enlace, lo registrado aparece en el seguimiento | Devuelve el estado de la encomienda y su recorrido | Una persona hace el cambio, lo prueba y lo despliega sin detener el registro |
| Medida de la respuesta | 0 encomiendas perdidas, y el 100 % se puede consultar en 10 minutos o menos desde que el enlace vuelve | p95 menor que 500 ms y menos de 0,5 % de errores, medidos desde fuera del centro de datos | 1 día-persona o menos, 1 módulo modificado y 0 minutos de interrupción |
El intento del compañero pasó por el revisor de la semana 2 (make errors):
errors/vague-scenarios.md
  ✖ El seguimiento debe ser rápido (línea 7)
      Entorno: falta
      Medida de la respuesta: no tiene ningún número: ¿cómo se comprueba?
      Medida de la respuesta: "siempre" no se puede comprobar: escriban el número
El revisor ve la forma: falta el entorno y la medida no tiene número. Lo demás lo ve una persona: “los usuarios” no dice cuántos, “consultan” no dice con qué frecuencia, “el sistema” no dice qué parte. La versión corregida es E2.
El utility tree, con un cuarto escenario de seguridad (E4, alguien que prueba 10 000 códigos parecidos al suyo):
| Atributo | Refinamiento | Escenario (resumen) | Negocio | Técnica |
|---|---|---|---|---|
| Disponibilidad | Falla del enlace de una agencia | E1. Sin enlace 2 h: el mostrador sigue registrando, 0 perdidas, todo consultable en 10 min o menos al volver | A | A |
| Rendimiento | Latencia del seguimiento | E2. 40 consultas por segundo durante 2 h: p95 < 500 ms, errores < 0,5 % | A | M |
| Modificabilidad | Cambios de tarifa | E3. Tarifa nueva: 1 día-persona o menos, 1 módulo, 0 min de interrupción | M | B |
| Seguridad | Confidencialidad | E4. 10 000 códigos probados en 1 h: 0 datos personales devueltos, alerta en 5 min o menos | A | M |
E1 es el único (A, A): vale mucho, porque una agencia sin registrar pierde la venta, y con el diseño actual es difícil, porque el mostrador no existe sin la nube. La dificultad depende del diseño que se tiene.
3. Una tabla de latencias
Enunciado. Una prueba de carga con el tráfico de la campaña hizo 2 000 consultas de seguimiento: 1 700 tardaron 60 ms, 180 tardaron 250 ms, 90 tardaron 900 ms y 30 tardaron 6 s. Calculen el promedio, el p50, el p90, el p95 y el p99. ¿Se cumple E2? ¿Qué número le mostrarían a quien decide?
Solución. El promedio:
Para los percentiles, con una tabla de frecuencias no hace falta escribir las
2 000 mediciones: basta saber qué posiciones ocupa cada fila en la lista
ordenada, y en qué fila cae la posición . Para
el p95, . La tabla de posiciones y los
resultados, con make percentiles:
n = 2000
posiciones     valor
1 a 1700       60 ms
1701 a 1880    250 ms
1881 a 1970    900 ms
1971 a 2000    6000 ms
promedio = 204.0 ms
p50  posición 1000  60 ms
p90  posición 1800  250 ms
p95  posición 1900  900 ms
p99  posición 1980  6000 ms
p100 posición 2000  6000 ms
Lo que dicen los números:
- E2 no se cumple: pide un p95 menor que 500 ms y el p95 es 900 ms. Más de uno de cada veinte pedidos (120 de 2 000) tarda 900 ms o más.
- El promedio lo esconde. 204 ms está por debajo de 500 y no describe a ningún pedido: el 85 % tardó 60 ms, menos de un tercio del promedio, y nadie tardó 204. El p90 (250 ms) también queda por debajo: quien mire solo el promedio o el p90 dirá que el seguimiento está bien.
- Hay más de una población. Cuatro valores tan separados no son una distribución con cola: son grupos de pedidos que hacen trabajos distintos. Antes de elegir una táctica hay que saber qué tienen en común los 90 pedidos de 900 ms y los 30 de 6 s (el ejercicio 8 lo retoma).
- El número para quien decide es el de la medida del escenario, con su comparación: “p95 de 900 ms contra un objetivo de 500 ms; además, el 1,5 % de las consultas tarda 6 s”. El promedio no va.
Una variante. La prueba se repite con dos instancias de la API. api-1
atendió 1 900 pedidos, todos de 60 ms; api-2 atendió 100, todos de 900 ms.
¿Cuál es el p95 del sistema? El p95 de api-1 es 60 ms y el de api-2 es
900 ms. Su promedio, 480 ms, no es el p95 de nada. Con los 2 000 pedidos
juntos (make instances), las posiciones 1 a 1 900 son de 60 ms: el p95,
que cae en la posición 1 900, es 60 ms. En el ejemplo de la semana 2 el
promedio de los percentiles quedaba por debajo del valor real; aquí queda
muy por encima. Y ese p95 de 60 ms tampoco tranquiliza: el p96 ya es 900 ms.
4. La disponibilidad de registrar una encomienda
Enunciado. Con el diseño actual, registrar una encomienda necesita que respondan el enlace de la agencia, la API, PostgreSQL, el proveedor de facturación y el de SMS. En una agencia de la sierra sus disponibilidades son 99,2 %, 99,95 %, 99,95 %, 99,5 % y 99,9 %. ¿Cuál es la disponibilidad de registrar? Calculen también dos alternativas: (a) el comprobante y el SMS salen después del registro; (b) lo mismo, más un segundo enlace 4G de 97 %.
Solución. Las cinco piezas están en serie, porque la operación las necesita a todas:
En tiempo:
al año en que esa agencia no puede registrar. Con make availability, que lee cada
cadena de un archivo de data/:
== data/register-central.txt
enlace de la agencia      99.2000 %
API central               99.9500 %
PostgreSQL                99.9500 %
proveedor de facturación  99.5000 %
proveedor de SMS          99.9000 %
En serie                  98.5067 %
  no disponible al año: 130.8 h
  no disponible al mes: 645 min
== data/register-deferred-effects.txt
…
En serie              99.1008 %
  no disponible al año: 78.8 h
…
== data/register-backup-link.txt
enlace de la agencia  99.9760 %  (2 copias en paralelo)
…
En serie              99.8760 %
  no disponible al año: 10.9 h
…
La alternativa (a) quita dos piezas del producto y sube de 98,5 % a 99,1 %. No puede pasar de 99,2 %: el conjunto siempre es peor que su peor parte, y la peor parte es el enlace. La alternativa (b) ataca esa parte con redundancia. Los dos enlaces están en paralelo:
y la cadena completa da 99,88 %: de 131 horas al año a unas 11.
Dos advertencias que la respuesta tiene que traer. La primera es el supuesto de independencia, que en paralelo es todo el argumento: si el enlace principal y el 4G dependen de la misma energía o de la misma torre, se caen juntos, y la segunda copia aporta mucho menos que lo que dice la cuenta. La segunda: el número no responde el escenario. E1 describe dos horas concretas en las que no hay enlace, y un 99,88 % anual es compatible con no cumplirlo ni una sola vez.
Trade-off. Sacar el comprobante y el SMS del camino mejora la disponibilidad de registrar y cuesta consistencia: durante un rato existe una encomienda sin comprobante, y hace falta una pieza que envíe lo pendiente. Dejarlos en el camino es más simple de razonar y ata el mostrador a dos proveedores ajenos.
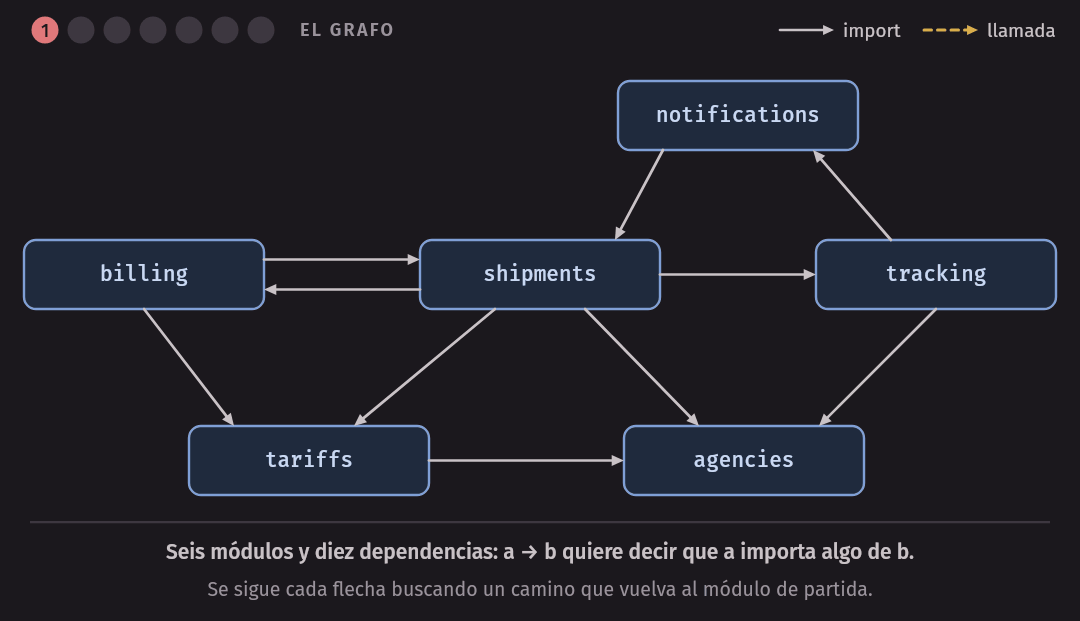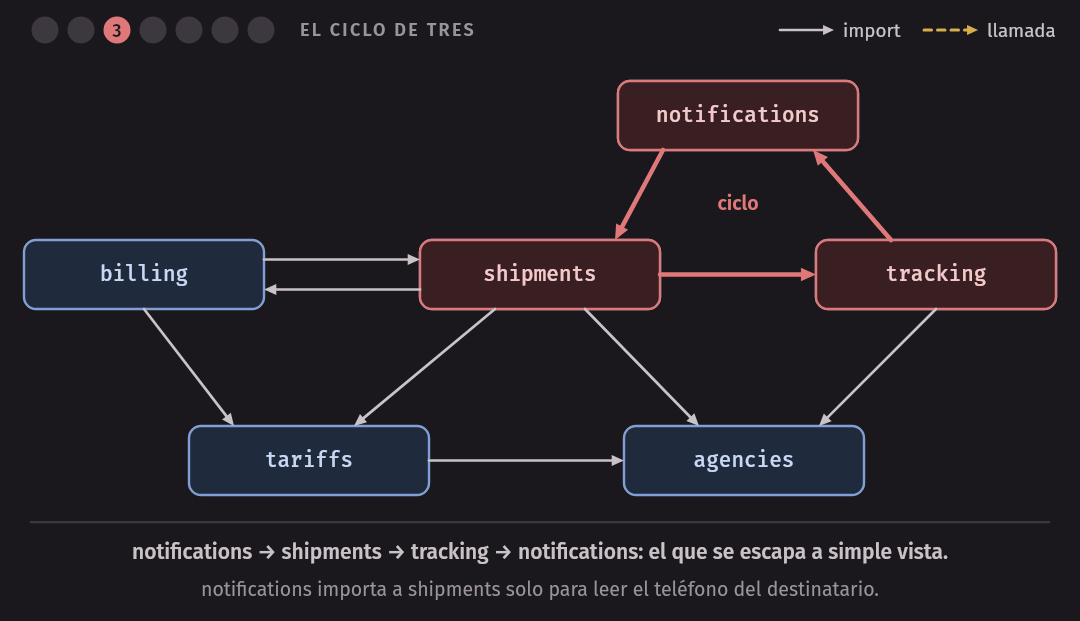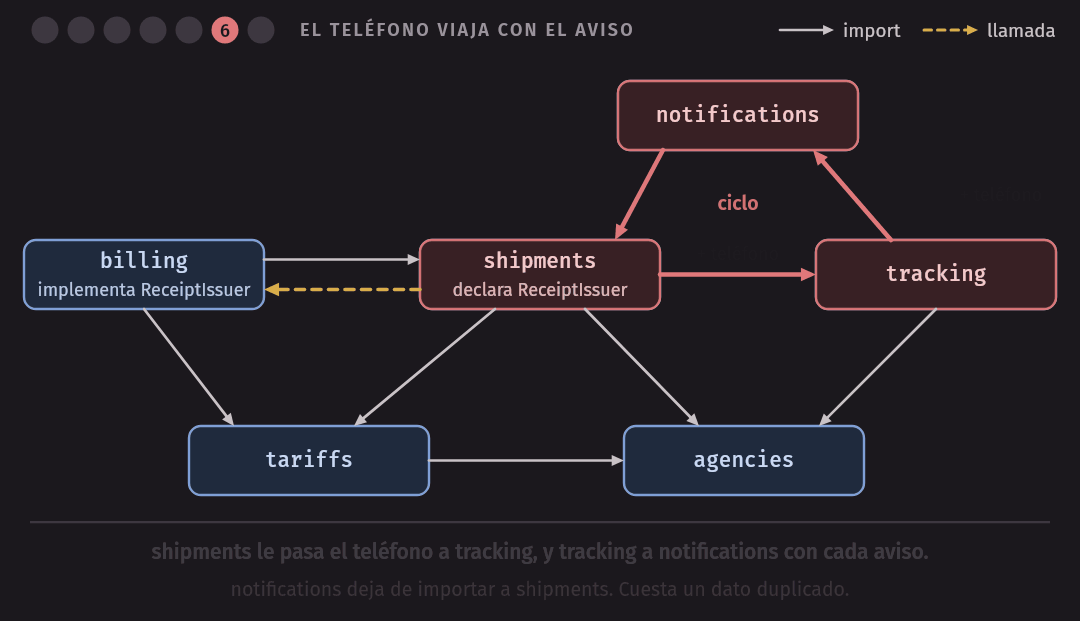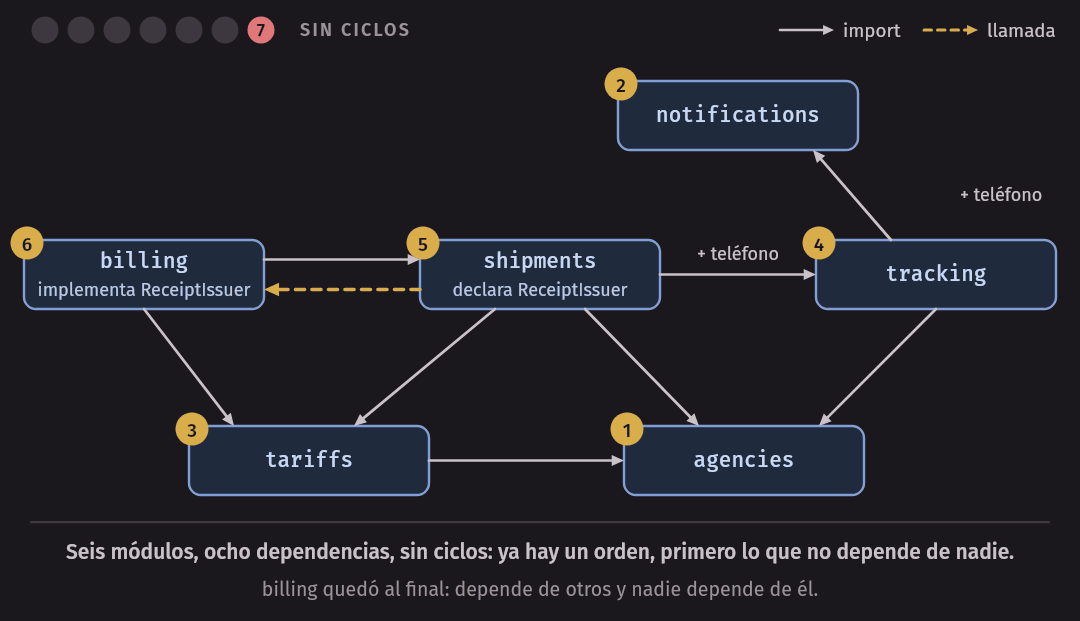
5. Un grafo de dependencias con dos ciclos
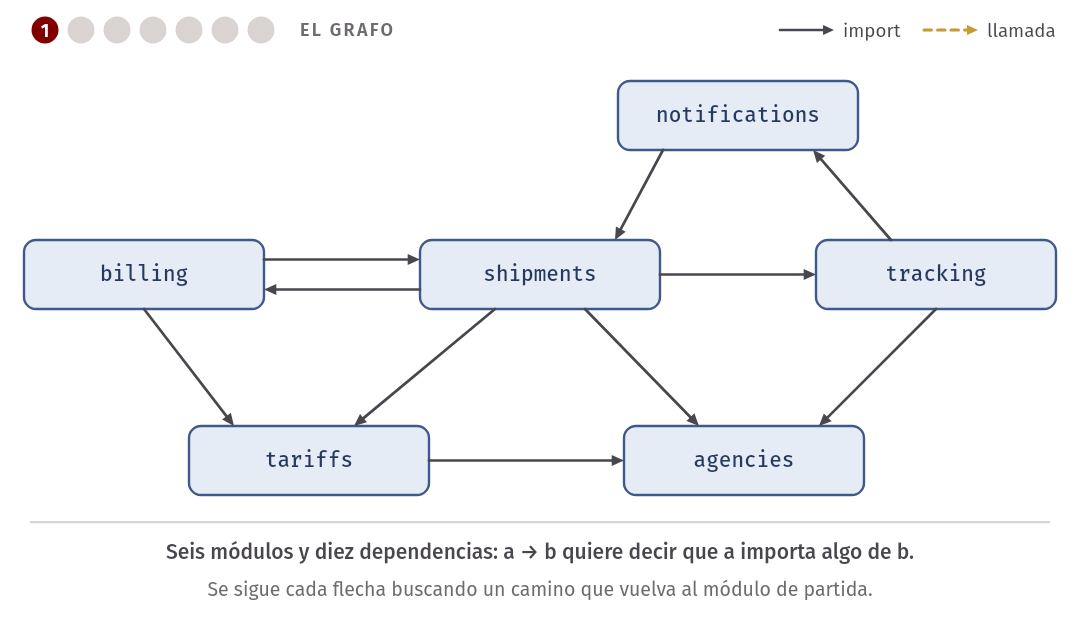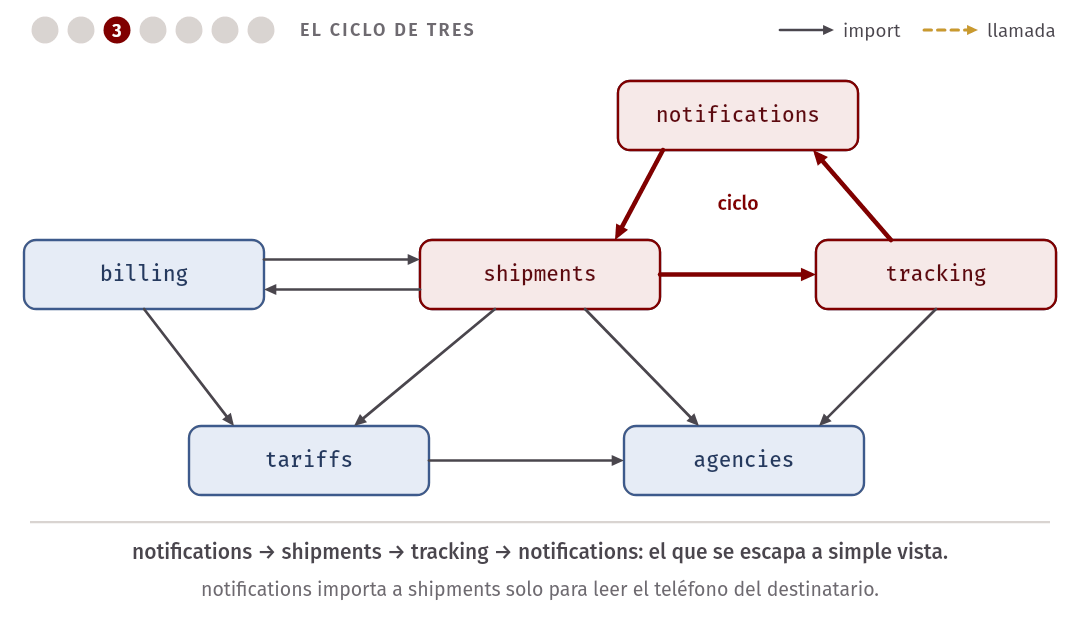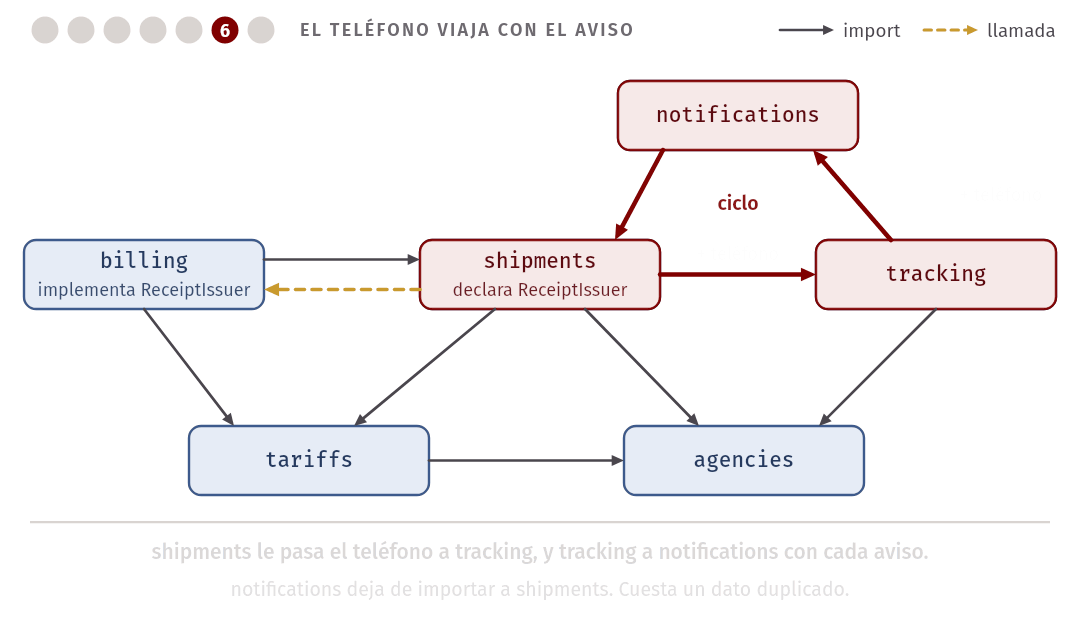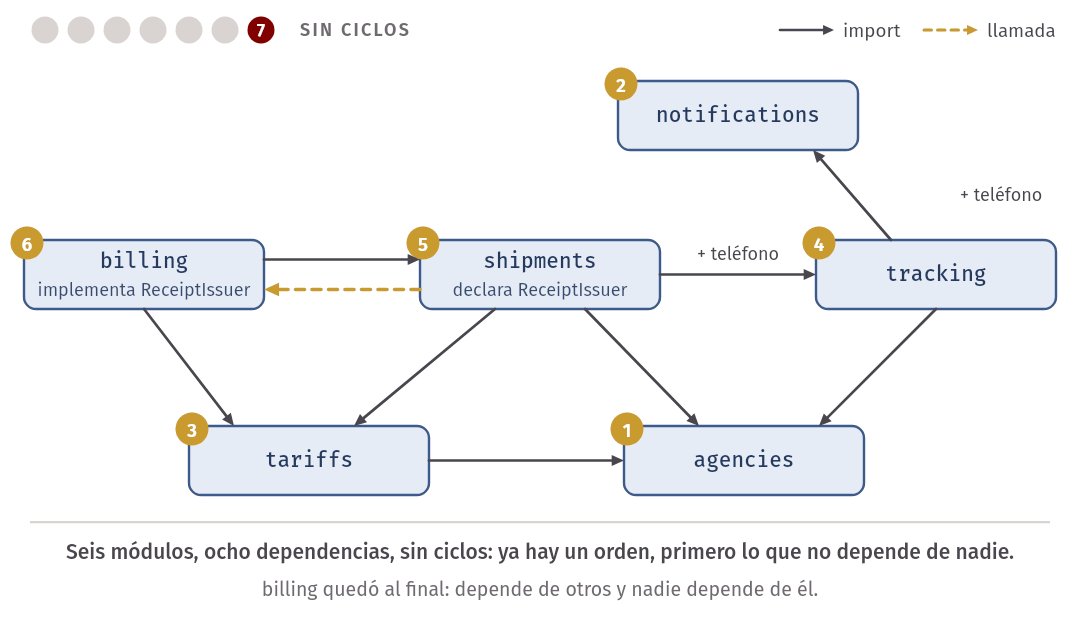
Enunciado. El monolito de Apachi tiene seis módulos. Sus dependencias («a -> b» quiere decir que a importa algo de b) son:
shipments -> agencies        billing -> shipments
shipments -> tariffs         billing -> tariffs
shipments -> billing         tariffs -> agencies
shipments -> tracking        tracking -> agencies
tracking -> notifications    notifications -> shipments
Encuentren los ciclos. ¿Alcanza con quitar una flecha? Rompan uno con una inversión de dependencias y escriban la regla que impide que vuelva.
Solución. Se sigue cada flecha buscando un camino que vuelva al módulo de
partida. Hay dos ciclos, y los dos pasan por shipments. make cycles:
6 módulos, 10 dependencias
Ciclos: 2
  billing -> shipments -> billing
  notifications -> shipments -> tracking -> notifications
Módulos enredados (de cada uno se llega a todos los demás del grupo):
  billing, notifications, shipments, tracking
Hay que quitar al menos 2 flechas; formas de hacerlo: 6
  billing -> shipments  y  notifications -> shipments
  …
El ciclo de tres es el que se escapa a simple vista. Como los dos ciclos
comparten un módulo, cuatro de los seis módulos son, en la práctica, uno
solo: no se puede probar ni separar billing sin tracking ni
notifications. Y como no comparten ninguna flecha, quitar una sola no
alcanza: hay que quitar una de cada ciclo, y hay seis combinaciones.
El programa dice cuántas flechas sobran, no cuáles. Eso lo decide la regla de estabilidad: lo que cambia mucho debe depender de lo que cambia poco.
El ciclo de dos. shipments importa a billing para emitir el
comprobante al registrar, y billing importa a shipments para saber qué es
una encomienda. La facturación cambia con cada norma y con cada proveedor; el
registro de encomiendas es lo más básico del sistema. La flecha que sobra es
shipments -> billing. Las alternativas, como en la semana 3: fusionar los
dos módulos (no cambian por las mismas razones, así que no); subir la
operación a un módulo que esté encima de los dos (sirve, y no necesita
interfaz, pero “registrar” deja de estar en shipments), o invertir.
Invertimos. shipments declara lo que necesita en una interfaz propia,
deps/src/shipments/ports.ts:
export interface ReceiptIssuer {
  issue(shipment: Shipment): Promise<string>;
}
billing la implementa, y para eso importa a shipments; main.ts los
conecta. La llamada no cambió de dirección; el import, sí.
El ciclo de tres. notifications importa a shipments solo para leer el
teléfono del destinatario. Aquí la salida más barata no es una inversión:
shipments le pasa el teléfono a tracking cuando abre el seguimiento, y
tracking se lo pasa a notifications con cada aviso. notifications deja
de necesitar a shipments. Cuesta un dato duplicado: si se corrige el
teléfono, hay que corregirlo en dos módulos. La alternativa, que
notifications declare un port y shipments lo implemente, no duplica nada
y agrega una interfaz y una flecha de shipments a notifications.
Sin esas dos flechas:
Sin shipments -> billing ni notifications -> shipments:
6 módulos, 8 dependencias
Sin ciclos.
Orden posible (primero lo que no depende de nadie): agencies, notifications, tariffs, tracking, shipments, billing
…
billing quedó al final: depende de otros y nadie depende de él. Es donde
conviene que esté lo que más cambia.
La regla. Una decisión que no se comprueba dura hasta el próximo plazo
apretado. En
deps/.dependency-cruiser.cjs,
además de no-circular:
      name: 'shipments-does-not-import-billing',
      from: { path: '^src/shipments/' },
      to: { path: '^src/billing/' },
Y se la ve fallar. La versión con el ciclo está en
errors/cycle/; con
make errors:
  error shipments-does-not-import-billing: src/shipments/counter.ts → src/billing/index.ts
  error no-circular: src/billing/index.ts →
      src/billing/receipts.ts →
      src/shipments/index.ts →
      src/shipments/counter.ts →
      src/billing/index.ts

x 2 dependency violations (2 errors, 0 warnings). 7 modules, 12 dependencies cruised.
no-circular dice que hay un ciclo y no dice cuál de sus flechas está mal.
La regla de dirección guarda la decisión del equipo.
Error común. Romper el ciclo moviendo
Shipmenty la emisión del comprobante a un móduloshared. La herramienta deja de quejarse y el acoplamiento es el mismo, ahora escondido en un módulo del que todos dependen y que cambia cada vez que cambia la facturación.
6. Un fragmento con acoplamiento
Enunciado. ¿Qué tiene que saber quien llama a esta función para no equivocarse, y que el tipo no dice? Nombren cada forma de connascence y propongan una firma mejor.
export function quoteByPosition(weightKg: number, declaredValue: number, service: number): numberSolución. Tres cosas. El orden de los dos primeros argumentos, que tienen
el mismo tipo: connascence de posición. Que el valor declarado va en
soles y no en céntimos, y que 1 es el servicio normal y 2 el express:
connascence de significado, dos veces. Las pruebas de
coupling/quote.test.ts muestran lo
que pasa cuando el acuerdo se rompe: con el peso y el valor al revés, compila
igual y cobra otra cosa.
La firma que baja las tres a connascence de nombre, la más débil:
export type Service = 'standard' | 'express';
export type Parcel = { weightKg: number; declaredValueCents: number; service: Service };
export function quoteCents(parcel: Parcel): number
No se eliminó el acoplamiento: se cambió por una forma más barata, en la que
un error se lee en el código o no compila. Importa más cuanto más lejos esté
quien llama: dentro de tariffs la primera firma es una molestia; como
interfaz pública del módulo, es un error que alguien va a cometer.
7. Dos estilos candidatos
Enunciado. Para Apachi, con sus escenarios E1, E2 y E3 y su equipo de cinco personas, comparen estos candidatos y elijan: (A) un modular monolith en la nube; (B) microservicios en la nube, uno por módulo; (C) el modular monolith más un nodo en cada agencia, que registra en un almacén local y le envía a la central lo registrado cuando hay enlace.
Solución. El procedimiento de la semana 5: cómo cumple cada candidato cada escenario, con una frase concreta; después el costo.
| A. Modular monolith | B. Microservicios | C. Monolith y nodos de agencia | |
|---|---|---|---|
| E1, sin enlace 2 h | No: el mostrador es una página servida desde la nube; sin enlace no hay mostrador | No: los servicios están igual de lejos que el monolito | Sí: registrar necesita solo la computadora de la agencia; lo registrado viaja después |
| E2, seguimiento en campaña | Depende de la consulta y de las tácticas, no del estilo | Podría escalar solo el seguimiento; el p95 medido no lo causa la falta de instancias | Igual que A: el seguimiento se sirve desde la central |
| E3, tarifa nueva | Sí, si tariffs tiene interfaz pública y reglas: un módulo, un despliegue |
Sí: un servicio, un despliegue | Sí en la central; pero la tarifa nueva tiene que llegar a 38 nodos |
| Costo | El más bajo: un despliegue, una base de datos | Seis servicios para cinco personas; los JOIN y las transacciones entre módulos se pierden |
38 instalaciones fuera del centro de datos; consistencia eventual; envíos repetidos y versiones que conviven |
La tabla descarta primero a B, y no por caro: no responde el escenario. El problema de E1 no es cuántas piezas hay en la nube, sino que el mostrador depende del enlace para llegar a cualquiera de ellas. Partir el monolito en seis servicios deja esa dependencia intacta y agrega cinco despliegues.
Entre A y C decide E1, que es el (A, A). Elegimos C, y lo que se sacrifica va escrito: el seguimiento deja de ser inmediato (una encomienda registrada sin enlace no existe para el destinatario hasta que el nodo la envía); el equipo pasa a operar 38 instalaciones en computadoras que no controla; y aparecen las tres preguntas de todo diseño con mensajes: qué pasa si el envío falla a la mitad, qué pasa con los duplicados y qué pasa con el orden. El nodo le cuenta a la central un hecho que ya ocurrió (“se registró esta encomienda”): es un evento, y la central no puede rechazarlo. Esa es la diferencia de fondo con A, donde el mostrador le pide a la central que registre y espera su respuesta.
Dos precisiones. C no reemplaza al modular monolith: lo combina con otro estilo en la parte del sistema donde un escenario lo pide. Y la comparación incluye no cambiar nada: seguir con A y llenar la guía en papel cuando no hay enlace cuesta cero, y es lo correcto si E1 deja de ser (A, A).
8. Un escenario y tres tácticas
Enunciado. Para E2 (p95 menor que 500 ms con 40 consultas por segundo), propongan tres tácticas y digan qué otro atributo afecta cada una. Datos de una medición por partes: el endpoint hace una consulta para la encomienda y una más por cada punto de su recorrido; abre una conexión nueva a PostgreSQL por pedido; los pedidos de 6 s son los que esperaron una conexión cuando PostgreSQL llegó a su límite.
Solución. Primero, dónde se va el tiempo: una parte en procesamiento (las consultas de más) y otra bloqueado (esperando una conexión). Son dos causas, y a cada una le corresponde una táctica distinta.
| Táctica | Grupo | Qué ataca | Qué cuesta |
|---|---|---|---|
| Una sola consulta que trae la encomienda con su recorrido | Controlar la demanda: reducir el costo de cada petición | El N+1: los pedidos de encomiendas con recorrido largo | Casi nada: una consulta algo más difícil de leer. Por eso va primero |
| Un pool de conexiones, con tamaño fijo | Administrar los recursos | La conexión nueva por pedido y el límite de PostgreSQL | Con el pool lleno, los pedidos esperan en una cola dentro de la API: hay que elegir el tamaño (más no es más rápido) y decidir qué pasa con la cola en una sobrecarga |
| Guardar la respuesta en una cache con un TTL de 30 s | Administrar los recursos: varias copias de los datos | La carga repetida: el mismo destinatario consulta muchas veces | Actualidad: una encomienda que ya llegó se ve “en camino” hasta 30 s. Y disponibilidad: una pieza más, que al caerse tiene que degradar a consultar la base de datos |
El orden importa. Se aplica la primera, se mide de nuevo con la misma carga, y solo si E2 sigue sin cumplirse se pasa a la siguiente. Si después de las dos primeras el p95 ya está por debajo de 500 ms, la cache no se pone: su costo no compra nada.
Una cuarta candidata sirve a dos escenarios: limitar la tasa de pedidos por origen (controlar la demanda) quita carga y es también una táctica de seguridad para E4, porque frena a quien prueba códigos. Cuesta usabilidad: varias personas detrás de una misma dirección, como los clientes de una agencia que usan su red, pueden quedar limitadas juntas.
Error común. Empezar por la cache. Esconde la consulta mal escrita, que sigue ahí y aparece con cada fallo de cache: justo en los pedidos que ya eran los lentos.
9. La decisión, como ADR
Enunciado. Escriban el ADR de la decisión del ejercicio 7.
Solución. Está completo en case/adr/0001-registro-local-en-la-agencia.md, con el template de la semana 7. Abreviado:
# ADR 0001: Las agencias registran encomiendas en un nodo local

## Contexto

Doce de las 38 agencias pierden el enlace a internet varias veces al mes […]

**Escenario:** E1, el único (A, A) del utility tree: con el enlace de una agencia caído 2 horas en plena campaña, el mostrador sigue registrando, se pierden 0 encomiendas y el 100 % se puede consultar en 10 minutos o menos desde que el enlace vuelve.

## Alternativas consideradas

### A. No cambiar el diseño

- **Gana:** no hay nada que construir ni que operar; […]
- **Cuesta:** sin enlace, la encomienda no tiene código de seguimiento hasta que alguien la digita […]
- **Por qué no:** no cumple E1: durante las 2 horas no se registra nada en el sistema.

### B. Efectos diferidos y un segundo enlace

- **Gana:** […] registrar sube a 99,88 % si las caídas de los dos enlaces son independientes. […]
- **Por qué no:** en esas agencias los dos enlaces dependen de la misma energía y, a veces, de la misma torre […]

### C. Un nodo local en cada agencia
[…]

## Decisión

- **Alternativa elegida:** C

Vamos a instalar en cada agencia un nodo […]

## Estado

Aceptado

## Consecuencias

- **Buena:** con el enlace caído, el mostrador sigue registrando y entrega la guía con su código. E1 se puede cumplir.
- **Mala:** el seguimiento es eventualmente consistente […]
- **Mala:** el nodo puede enviar la misma encomienda dos veces (envía, no recibe respuesta, reintenta). […]
- **Mala:** hasta que se envía, una encomienda existe en un solo disco. […]
Lo que hace que este ADR sirva dentro de un año:
- El contexto trae el escenario y las cuentas, no opiniones. Las dos cifras (98,5 % y 99,88 %) son las del ejercicio 4, y una prueba comprueba que el documento y el programa digan lo mismo.
- Hay tres alternativas, y una es no hacer nada. La B no se descarta por mala: se descarta porque su número depende de un supuesto que aquí no se cumple. Si un día las agencias tienen dos enlaces realmente independientes, quien lea el ADR sabrá que la decisión merece revisarse.
- Las consecuencias malas son más que las buenas. Es lo que la decisión cuesta, y varias son el trabajo que viene. El envío repetido pide que la central reconozca una encomienda que ya recibió: es la idempotencia, que veremos en la semana 12.
Error común. El ADR de una línea: “Contexto: las agencias pierden el enlace. Decisión: usamos un nodo local. Consecuencias: funciona sin enlace”. Sin las alternativas, nadie puede saber si la decisión sigue vigente cuando cambie el contexto; sin las consecuencias malas, nadie sabe qué quedó pendiente.
10. Recorrer un escenario sobre el diseño
Enunciado. Con el diagrama de contenedores del diseño elegido, recorran E1 paso a paso y clasifiquen lo que encuentren: riesgo, no riesgo, punto de sensibilidad o punto de trade-off.
Solución. El diagrama, en el formato del curso, está en case/containers.md (y el de contexto en case/context.md). En cada agencia hay una aplicación de mostrador, un nodo de agencia y su almacén en disco; en la nube, la API central, un trabajador de efectos y la base de datos central. Los dos proveedores externos solo hablan con el trabajador de efectos.
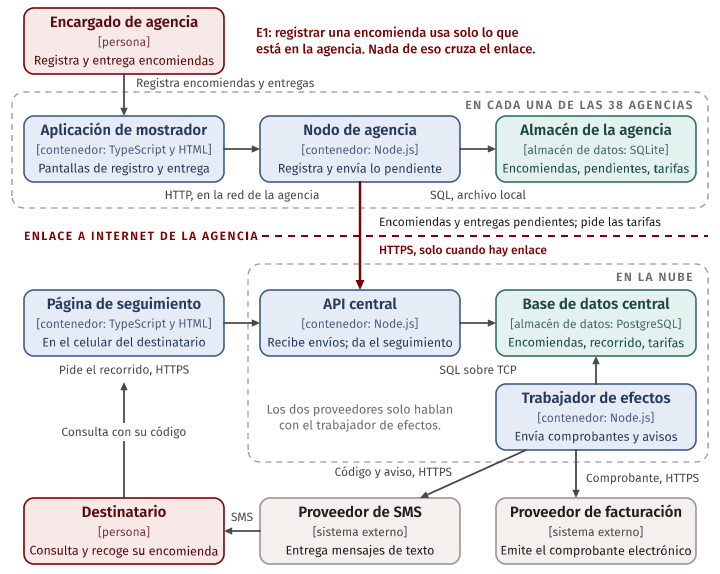
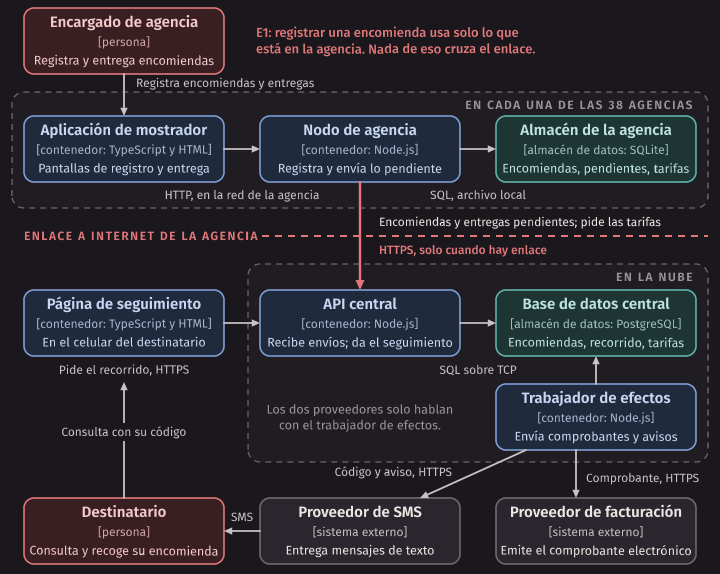
El recorrido de E1. Se cae el enlace. El encargado registra una encomienda en la aplicación de mostrador, que le habla al nodo por la red de la agencia. El nodo calcula el precio con su copia de las tarifas, genera el código, guarda la encomienda en su almacén y responde. Nada de eso cruza el enlace. Dos horas y unas 80 encomiendas después (40 por hora), el enlace vuelve; el nodo envía lo pendiente a la API central, que lo guarda y deja anotados el comprobante y el SMS para el trabajador de efectos. Los hallazgos, con las columnas de la tabla de la semana 7 (completa en case/atam.md):
| Id | Tipo | Decisión | Razonamiento |
|---|---|---|---|
| N1 | no riesgo | El nodo guarda la encomienda en su almacén antes de responder al mostrador | Registrar no usa el enlace, la API central ni a los proveedores. Vale mientras la computadora de la agencia funcione |
| R1 | riesgo | Hasta que se envía, la encomienda existe en un solo disco de la agencia | Si el disco se daña durante las 2 h, se pierden unas 80 encomiendas, y la medida pide 0 |
| S1 | punto de sensibilidad | Cada cuánto intenta el nodo enviar lo pendiente | Hay 10 min para que todo se pueda consultar: con un reintento cada 15 min, la medida no se cumple aunque todo lo demás funcione |
| R2 | riesgo | El nodo reenvía lo que no recibió respuesta, y nadie decidió cómo reconoce la central un envío repetido | Un envío que llegó y cuya respuesta se perdió se repite: la misma encomienda, dos veces, con dos comprobantes |
| T1 | punto de trade-off | Qué datos se guardan en la agencia y por cuánto tiempo | Cuanto más guarda el nodo, más puede hacer sin enlace (disponibilidad) y más datos personales quedan en 38 computadoras de mostrador (seguridad) |
Cómo distinguirlos. N1 y R1 son decisiones: una sostiene el escenario y la otra lo pone en peligro. S1 no es buena ni mala: es un parámetro del que depende la medida, y alguien tiene que fijarlo mirando el escenario. T1 mueve dos atributos en sentidos opuestos. R2 muestra algo frecuente: el riesgo es una decisión que falta.
El recorrido no dice que el diseño sea bueno. Dice dónde mirar: dos de los tres riesgos del análisis completo están en el contrato entre el nodo y la central, y ese es el tema de riesgo que hay que resolver antes de instalar el primer nodo.
Revisar su P2 con estos criterios
P2 se entrega esta semana. Antes de entregarlo, pásenle a su propio trabajo las mismas preguntas que le hicimos a Apachi:
- Cada decisión nombra su escenario. Si un ADR no dice qué escenario lo empuja, o el escenario no tiene medida, todavía es una preferencia.
- Cada decisión tiene al menos una alternativa, y una de ellas es no cambiar nada. Para cada descartada: ¿bajo qué supuesto habría ganado?
- Cada decisión dice qué cuesta. Busquen en sus ADR la sección de consecuencias: si todas son buenas, falta analizar.
- Cada número dice cómo se obtuvo: qué carga, cuántas corridas, en qué máquina, con qué método se calculó el percentil. La comparación entre antes y después se hizo con la misma carga.
- Cada táctica fue a la causa que midieron, no a la que suponían.
- Los diagramas coinciden con el sistema: lo que dicen las tablas es lo que corre.
- Pueden defenderlo sin leer. Para cada decisión, digan en voz alta el escenario, la alternativa y el costo. Si no sale en tres frases, el ADR tampoco lo dice.
El código de la semana y make test
La carpeta code/week-08/ no tiene laboratorio: tiene los revisores de las cuentas de este capítulo y los documentos del caso.
latency.ts, availability.ts y cycles.ts hacen las cuentas, y check.ts
es el programa que los usa. En data/ están las tablas, las cadenas y el
grafo de los ejercicios 3, 4 y 5; en case/, los documentos de Apachi; en
deps/ y errors/, los módulos del ejercicio 5 sin el ciclo y con él, y en
coupling/, la función del ejercicio 6.
Sirven para practicar: cambien una tabla de data/, hagan la cuenta en papel
y comparen con node check.ts percentiles data/tracking-latencies.txt (o
availability, o cycles). make test revisa los tipos y corre las
pruebas, que fijan cada número de este capítulo:
ℹ tests 48
ℹ suites 0
ℹ pass 48
ℹ fail 0
Una de ellas, errors/cycle compila y funciona, y rompe no-circular y la regla de dirección, deja constancia de algo que conviene recordar: un ciclo
no es un error de tipos ni de ejecución, y por eso no se anuncia solo.
Las pruebas comparan además los resultados con las funciones de la semana 2
(stats.ts): mismos percentiles, misma serie,
mismo paralelo. make case pasa los documentos del caso por los revisores de
las semanas 1, 2 y 7.
Un detalle de implementación: en JavaScript, 7 / 100 * 100 da
7.000000000000001, y su techo es 8. latency.ts redondea el producto antes
de aplicar el techo, y una prueba fija ese caso.
Resumen
- Las siete semanas son un procedimiento: de los requisitos a los ASR, de los ASR a escenarios priorizados, de los escenarios (A, A) a candidatos (estilos, tácticas, no cambiar nada), de los candidatos a una decisión escrita con sus alternativas, y de la decisión a una evaluación y a una comprobación.
- Un requisito es un ASR si al cambiarlo cambia el diseño; una restricción no se negocia. Preguntar “¿y si falla?” a un requisito funcional suele destapar un ASR.
- Un escenario sin medida no es un escenario. El número que se le muestra a quien decide es el de la medida, con un percentil; el promedio puede quedar por debajo del objetivo mientras el p95 no lo cumple.
- El percentil por rango más cercano es la medición en la posición . Con una tabla de frecuencias basta saber qué posiciones ocupa cada fila. Los percentiles no se promedian.
- La disponibilidad en serie se multiplica, y el conjunto no pasa de su peor parte; en paralelo depende por completo de que las fallas sean independientes. Un porcentaje anual no responde un escenario que describe una falla concreta.
- En un grafo de dependencias, los ciclos que comparten un módulo enredan a todos sus módulos. La herramienta dice cuántas flechas sobran; cuáles, lo dice la regla de estabilidad. Una decisión sobre dependencias se guarda como una regla que el build comprueba, y se la ve fallar.
- Un estilo se descarta primero por no responder el escenario, y después por su costo. Una táctica va a la causa que se midió, y se nombra con el atributo que mejora y con el que paga.
- Un ADR lleva el escenario en el contexto, tres alternativas (una es no hacer nada), la decisión, el estado y las consecuencias, también las malas. No se reescribe.
- Recorrer un escenario sobre el diseño produce riesgos, no riesgos, puntos de sensibilidad y puntos de trade-off: dice dónde mirar.
Ejercicios
Háganlos en papel. Para los que tienen cuentas, comprueben después con
check.ts, cambiando los archivos de data/.
- De estas tres decisiones de Apachi, ¿cuáles son de arquitectura? Apliquen la prueba de archivos, equipos y despliegues: (a) el formato del código de seguimiento; (b) que el precio se redondee a diez céntimos; (c) que el comprobante se emita después del registro.
- El requisito 11 dice que una encomienda “no se puede entregar a quien no es su destinatario”. Escríbanlo como escenario de seis partes. ¿Qué parte les costó más y qué le preguntarían a la empresa para llenarla?
- En una agencia se midieron 400 registros: 300 tardaron 200 ms, 60 tardaron 400 ms, 36 tardaron 1,5 s y 4 tardaron 12 s. Calculen el promedio, el p50, el p90, el p95 y el p99. ¿En cuál de esos percentiles un solo registro más de 12 s cambiaría el resultado?
- Con el diseño del ADR 0001, una encomienda registrada se puede consultar cuando han respondido el nodo de la agencia (99,8 %), el enlace (99,2 %), la API central (99,95 %) y PostgreSQL (99,95 %). Calculen la disponibilidad de “registrar” y la de “que lo registrado se pueda consultar”. ¿Por qué la segunda cuenta no contradice la decisión?
- Al grafo del ejercicio resuelto 5, ya sin ciclos, alguien le agrega
agencies -> tariffspara mostrar la tarifa más barata de cada agencia. ¿Aparece un ciclo? ¿Cuántos módulos quedan enredados? Propongan dos formas de evitarlo y digan cuál elegirían según la inestabilidad de cada módulo. - Escriban la regla de dependency-cruiser que guarda esta decisión: “solo
billingpuede importar el cliente del proveedor de facturación, que está ensrc/adapters/invoicing/”. Digan cómo comprobarían que la regla comprueba algo. - Para E1, propongan una táctica de detección, una de recuperación y una de prevención que ataquen el riesgo R1 (la encomienda en un solo disco). Para cada una, digan qué otro atributo paga.
- El equipo decide que la central reconozca un envío repetido por el código de seguimiento. Escriban ese ADR, con tres alternativas. Una pista para las alternativas: ¿qué pasa si dos agencias generan el mismo código?
- Recorran E4 (alguien prueba 10 000 códigos) sobre el diagrama de
contenedores. Encuentren un no riesgo, un riesgo y un punto de trade-off
que no estén en la tabla del ejercicio resuelto 10, y comparen después
con
case/atam.md.