Apuntes · Capítulo 9Datos y sistemas distribuidos
Los datos como decisión de arquitectura
Los datos como decisión de arquitectura
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Por qué los datos son lo que más cuesta cambiar, todo; de Transaccional y analítico, Dos formas de usar los mismos datos y El reporte compite con la venta; de Por qué la evolución es un problema de arquitectura, Versiones que conviven y Hacia atrás y hacia adelante; y de Expandir, migrar y contraer, El ejemplo: cambiar el nombre de una columna.
- En clase: Sesión A: Por qué los datos son lo que más cuesta cambiar, Transaccional y analítico, Sistema de registro y datos derivados, Un nodo o muchos, Servicio administrado o propio y La escalabilidad es una pregunta. Sesión B: El modelo de datos decide qué preguntas son fáciles, Por qué la evolución es un problema de arquitectura, Formatos, Evolucionar una API y Expandir, migrar y contraer. Laboratorio: Laboratorio: cambiar un contrato sin romper a quien lo usa.
- Después de clase: el Resumen y los Ejercicios. Antes de avanzar con P3 vale la pena releer Las tres fases y sus condiciones, Migrar los datos sin detener a nadie y Cuándo contraer. Opcionales: Grafos y clave-valor, Binarios con esquema: etiquetas en vez de nombres, La cola de locks y El código de la semana.
La primera mitad del curso trató sobre código: cómo se parte en módulos, qué puede depender de qué, en cuántas unidades se despliega y cómo se decide todo eso con escenarios de calidad en la mano. En casi todos los ejemplos había una base de datos, y casi siempre la tratamos como una caja al final del diagrama: el lugar donde las cosas se guardan.
La segunda mitad abre esa caja. La razón es práctica. Los problemas que Tinkuy mostró en la primera mitad (el catálogo que se vuelve lento durante una venta, el asiento que se vende cincuenta veces, la compra que queda cobrada y sin entrada) no se arreglan moviendo código de un módulo a otro. Se arreglan decidiendo dónde viven los datos, cuántas copias hay, quién puede escribirlos y qué se promete sobre ellos. Esas son las decisiones de las semanas 9 a 13.
Este capítulo pone el vocabulario y las preguntas. En la primera sesión vemos por qué los datos son la parte de una arquitectura que más cuesta cambiar, y los trade-offs que aparecen en todo sistema que guarda algo: transaccional o analítico, sistema de registro o dato derivado, un nodo o muchos, servicio administrado o propio. En la segunda vemos cómo se elige un modelo de datos, y después el problema que ocupa el laboratorio y una parte de P3: cómo se cambia un esquema o un contrato que otros ya usan, sin detener nada y sin romper a nadie. La respuesta tiene nombre, expandir, migrar y contraer, y la vamos a recorrer con un ejemplo completo.
Una advertencia sobre las palabras, la misma de la semana 5. En Tinkuy un evento es un concierto o un partido. En este capítulo casi no hablamos de mensajes, así que cuando aparece la palabra es en ese sentido: un evento de Tinkuy.
Lectura. Sesión A: Kleppmann y Riccomini, Designing Data-Intensive Applications (2.ª ed.), cap. 1 Trade-Offs in Data Systems Architecture y cap. 2 Defining Nonfunctional Requirements (el caso de las líneas de tiempo de una red social y la sección Scalability); Martin Kleppmann, apuntes del curso Concurrent and Distributed Systems de Cambridge, sección 1, Introduction. Complementarias: Martin Fowler, PolyglotPersistence; Software Architecture in Practice, cap. 17 The Cloud and Distributed Computing.
Sesión B: Designing Data-Intensive Applications (2.ª ed.), cap. 3 Data Models and Query Languages (las secciones sobre el modelo relacional y el de documentos) y cap. 5 Encoding and Evolution; Danilo Sato, ParallelChange (expandir y contraer), y Martin Fowler, TolerantReader. Complementarias: Designing Data-Intensive Applications (2.ª ed.), cap. 4 Storage and Retrieval; Hyrum’s Law; Protocol Buffers, Language Guide, la sección sobre cómo actualizar un tipo de mensaje.
El código de este capítulo está en code/week-09/. Todas las salidas que se muestran son de ejecuciones reales en el contenedor del curso, en una laptop con Apple Silicon, dentro de Docker. Los números cambian de una máquina a otra y de una corrida a otra; lo que se traslada es la comparación entre dos diseños medidos en la misma.
Por qué los datos son lo que más cuesta cambiar
El código se reemplaza; los datos se quedan
Piensen en lo que hace falta para poner en producción una versión nueva del servidor de Tinkuy. Se levanta un proceso con el código nuevo, se le empieza a enviar tráfico y se apaga el proceso anterior. Si la versión nueva tiene un error, se hace lo contrario. El proceso no recuerda nada entre una petición y la siguiente, así que cualquier copia suya vale lo mismo que otra: se puede reemplazar, se puede duplicar para atender más carga y se puede matar sin perder nada. A eso se le llama un servicio sin estado, y la semana 11 le dedica una sesión.
Con los datos, ninguna de esas tres cosas es cierta:
- No se reemplazan. La base de datos de la versión nueva tiene que ser la misma que la de la versión anterior, con todo lo que se vendió hasta ayer. Un cambio en el código se revierte volviendo al código anterior; un cambio que ya transformó las filas de una tabla no se revierte desplegando nada.
- No se copian gratis. Una segunda copia del proceso es idéntica a la primera desde que arranca. Una segunda copia de los datos empieza a diferenciarse de la primera con la siguiente escritura, y mantenerlas de acuerdo es un problema con nombre propio: replicación, la semana que viene.
- No se pierden sin consecuencias. Si un proceso muere a mitad de una petición, alguien recibe un error y reintenta. Si se pierde la tabla de órdenes, se perdió el negocio.
Hay una cuarta diferencia, que es la que más pesa en la segunda sesión: los datos viven más que el código que los escribió. Una orden guardada en 2024 la escribió una versión del servidor que ya nadie recuerda, y el servidor de hoy tiene que poder leerla. El código de hace dos años se puede borrar; sus datos no.
Idea clave. Las decisiones sobre dónde viven los datos, cuántas copias hay y quién puede escribirlos son las que más cuesta deshacer. Por eso se toman con más cuidado, y más tarde, que las decisiones sobre el código: una frontera entre módulos mal puesta se corrige con un refactoring; una frontera entre bases de datos mal puesta se corrige con una migración.
Esto ya apareció una vez en el curso, sin este nombre. En la semana 5, lo que
hacía caro pasar de un monolito a microservicios no era partir el código, sino
partir la base de datos: cada servicio es owner de sus datos, y lo que antes
era un JOIN y una transacción pasa a ser una llamada por la red y un
protocolo.
Sistemas intensivos en datos
Un sistema es intensivo en datos cuando su dificultad está en los datos: en cuántos son, en lo complejos que son o en lo rápido que cambian. Lo contrario es un sistema intensivo en cómputo, cuya dificultad está en el procesador: simular el clima o entrenar un modelo. Casi todos los sistemas que van a construir en su vida profesional son del primer tipo. Tinkuy lo es: no calcula nada difícil. Su problema es que muchas personas quieren leer y cambiar los mismos datos a la vez.
Un sistema así casi nunca se escribe desde cero. Se arma con piezas estándar, cada una buena para una cosa:
| Pieza | Para qué sirve | En el contenedor del curso |
|---|---|---|
| Base de datos | Guardar los datos y volver a encontrarlos | PostgreSQL |
| Cache | Recordar el resultado de algo caro | Redis |
| Índice de búsqueda | Encontrar por palabras o por filtros | (no se usa) |
| Cola o log de mensajes | Pasar trabajo a otro proceso, para después | NATS JetStream |
| Proceso por lotes | Recorrer muchos datos cada cierto tiempo | un script con node |
Ninguna de las piezas es el problema de arquitectura. El problema es lo que pasa entre ellas. PostgreSQL promete que una transacción ocurre completa o no ocurre. Redis promete responder rápido. En cuanto un dato está en los dos, la pregunta es qué se le promete a quien lo lee: ¿el valor de PostgreSQL, el de Redis, cualquiera de los dos? La arquitectura de un sistema de datos es cómo se combinan las piezas y qué garantías sobreviven a la combinación. Las semanas que siguen son, cada una, una combinación con su garantía: varias copias de una base de datos (semana 10), una base de datos y una cache (semana 11), una base de datos y un servicio externo (semana 12), una base de datos y un log de mensajes (semana 13).
Transaccional y analítico
Dos formas de usar los mismos datos
A una tabla de órdenes se le hacen dos clases de preguntas, tan distintas que tienen nombres propios.
La primera clase: ¿existe la orden 150 000?, ¿de quién es?, registra esta orden nueva. Son operaciones pequeñas, que encuentran unas pocas filas por su clave, y las hace una persona que está esperando la respuesta frente a una pantalla. A esta forma de uso se le llama transaccional, u OLTP (online transaction processing). Lo que importa es que cada operación sea rápida y exacta: la latencia de cada una, y que nadie vea una orden a medio escribir.
La segunda clase: ¿cuánto se vendió en marzo?, ¿quiénes son los cinco compradores que más gastaron? Son pocas consultas, cada una recorre una parte grande de la tabla, y quien las hace es un analista o un proceso que corre de madrugada. A esta forma de uso se le llama analítica, u OLAP (online analytical processing). Lo que importa es cuántos datos se procesan por segundo, el throughput, y no si una consulta tarda 300 ms o 3 s.
| Transaccional (OLTP) | Analítico (OLAP) | |
|---|---|---|
| Quién pregunta | Un usuario, a través de la aplicación | Un analista o un proceso por lotes |
| Qué lee | Unas pocas filas, por clave | Millones de filas, casi todas |
| Qué escribe | Filas sueltas, todo el tiempo | Cargas grandes, cada cierto tiempo |
| Cuántas consultas | Muchas por segundo | Pocas por hora |
| Qué se mide | Latencia de cada operación (p95, p99) | Throughput; duración del reporte |
| Qué datos | El estado de ahora | La historia |
La diferencia se ve en el plan de ejecución. La base de datos de la semana,
arq_w09, tiene una tabla orders con 300 000 filas. Esta es una lectura
transaccional, una orden por su id:
arq_w09=# EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF)
          SELECT id, buyer_email, total_cents, status FROM orders WHERE id = 150000;
 Index Scan using orders_pkey on orders (actual rows=1.00 loops=1)
   Index Cond: (id = 150000)
   Index Searches: 1
   Buffers: shared hit=4
 …
 Execution Time: 0.147 ms
Cuatro páginas de 8 kB: las del índice, de la raíz a la hoja, y la página donde está la fila. Y esta es una lectura analítica, los cinco compradores que más gastaron:
arq_w09=# EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF)
          SELECT buyer_email, count(*) AS orders, sum(total_cents) AS total_cents
            FROM orders WHERE status = 'paid'
           GROUP BY buyer_email ORDER BY sum(total_cents) DESC LIMIT 5;
 Limit (actual rows=5.00 loops=1)
   Buffers: shared hit=3478
         …
               ->  Gather (actual rows=15000.00 loops=1)
                     Workers Launched: 2
                     …
                           ->  Parallel Seq Scan on orders (actual rows=95652.33 loops=3)
                                 Filter: (status = 'paid'::text)
 …
 Execution Time: 79.445 ms
3 478 páginas en vez de 4: la tabla entera (pg_table_size dice que ocupa
27 MB), leída por tres procesos a la vez, el que atiende la consulta y dos
ayudantes (Workers Launched: 2). No hay índice que evite ese recorrido,
porque la pregunta es sobre todas las filas. Una sola de estas consultas ocupa
tres núcleos durante todo el tiempo que dura.
El reporte compite con la venta
Si las dos clases de consulta corren en la misma base de datos, comparten
todo lo que la base de datos tiene: procesador, memoria, disco y conexiones.
tools/oltp-vs-olap.ts lo mide. Ocho
sesiones hacen lecturas por id, una detrás de otra, durante cinco segundos.
Después hacen lo mismo mientras otras cuarenta sesiones repiten el reporte de
arriba. Y al final otra vez solas, para comprobar que el efecto se va cuando
se van los reportes:
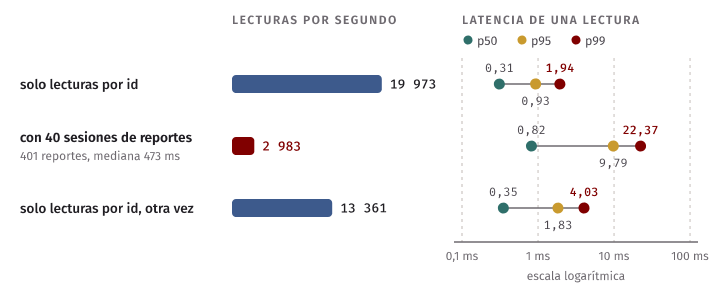
$ make oltp-olap
arq_w09: 300000 órdenes; 8 sesiones leen una orden por id durante 5 s.

solo lecturas por id                 19973 lecturas/s   p50    0.31 ms   p95    0.93 ms   p99    1.94 ms
con 40 sesiones de reportes           2983 lecturas/s   p50    0.82 ms   p95    9.79 ms   p99   22.37 ms   (401 reportes, mediana 473 ms)
solo lecturas por id, otra vez       13361 lecturas/s   p50    0.35 ms   p95    1.83 ms   p99    4.03 ms
Las mismas lecturas, sobre los mismos datos, con el mismo índice. Lo único que cambió es quién más estaba usando la base de datos. El throughput de las lecturas cayó a menos de la sexta parte, y el p99 se multiplicó por más de diez. Repetimos la medición tres veces: en las tres el throughput con reportes quedó entre 1 500 y 3 000 lecturas por segundo, contra 12 000 a 20 000 sin ellos, y el p99 entre 22 y 56 ms, contra 2 a 5 ms. La máquina donde se midió estaba ocupada con otras cosas, y por eso los valores absolutos se mueven tanto; la caída no desapareció en ninguna corrida.
Miren también lo que casi no cambió: el p50 pasó de 0,31 ms a 0,82 ms. La mitad de las lecturas apenas se enteró. Es el mismo fenómeno de la semana 2: cuando un recurso se satura, la mediana lo disimula y la cola de la distribución lo muestra. Quien mire solo el promedio de este servicio va a decir que el reporte no molesta.
Hay que decir bajo qué condición aparece el efecto. Cuarenta sesiones de
reportes, cada una con hasta tres procesos, son más procesos que los 14
núcleos del contenedor: el procesador está saturado. Con una sola sesión de
reportes (ANALYTIC=1 make oltp-olap), la diferencia queda dentro de lo que
la medición varía sola de una corrida a otra. La conclusión no es “un
reporte arruina la base de datos”, sino esta: las dos cargas compiten por el
mismo recurso, y la analítica no tiene un tamaño fijo. El día en que el
reporte del mes coincide con la apertura de una venta, quien espera es el
comprador.
En Tinkuy.
GET /reports/salesrecorre las órdenes, las entradas y los asientos de un evento con variosJOIN, en la misma base de datos que atiendePOST /orders. Y el organizador de un concierto abre su reporte justamente cuando la venta está en su pico, porque es cuando le interesa.
Separarlos: de menos a más costo
Hay tres respuestas habituales. Van en orden de costo, y la regla es no pasar a la siguiente mientras la anterior alcance.
No separar, y acotar. Si los reportes son pocos y se pueden programar,
corren de madrugada, con un tope de tiempo (statement_timeout) y sin
procesos ayudantes. No cuesta nada y funciona mientras el negocio acepte que
el reporte no es en vivo. Deja de funcionar cuando alguien necesita el reporte
durante la venta.
Una réplica para las lecturas pesadas. Una segunda copia de la base de datos, que recibe los cambios de la principal y solo atiende lecturas. Los reportes van a la réplica y dejan de competir con las ventas. Se paga una máquina más, y se acepta algo nuevo: la réplica va un poco atrasada, así que el reporte puede no incluir la venta de hace un segundo. Es el tema de la semana 10, y la primera mitad de P3.
Un data warehouse. Una base de datos distinta, pensada para consultas analíticas, a la que los datos llegan copiados: por lotes (cada noche) o por streams (a medida que ocurren). Aquí la separación es completa: otro motor, otro esquema (organizado para preguntar, no para vender), y la historia de varios sistemas en un solo lugar. Los motores analíticos guardan los datos de otra manera, por columnas en vez de por filas, porque un reporte lee tres columnas de millones de filas y no las veinte columnas de una. Se paga un sistema más que operar, un proceso de carga que puede fallar, y un retraso que ya no es de un segundo sino del tiempo entre cargas.
Trade-off. Cada paso compra aislamiento entre las dos cargas y lo paga con frescura de los datos y con operación. Una réplica atrasa el reporte segundos y agrega una máquina. Un data warehouse lo atrasa minutos u horas y agrega un sistema entero con su proceso de carga. La pregunta que decide no es técnica: ¿qué tan viejo puede ser el dato que ve quien lee el reporte?
Sistema de registro y datos derivados
En cuanto un sistema tiene más de un lugar donde guardar datos, el mismo dato empieza a estar en varios. La orden está en PostgreSQL, su resumen en una cache, su total en el reporte del mes. Para no perderse, cada dato se clasifica en uno de dos grupos.
El sistema de registro (system of record) de un dato es el lugar donde ese dato se escribe primero y donde está su versión oficial. Si dos lugares no coinciden, el sistema de registro tiene la razón por definición. Para cada dato hay uno solo.
Un dato derivado es el resultado de tomar datos de otro lugar y transformarlos: una cache, un índice de búsqueda, una vista materializada, un reporte, una tabla de totales. Su propiedad esencial es que se puede reconstruir: si se pierde, se vuelve a calcular a partir del sistema de registro. Lo que se pierde es tiempo, no información.
| Dato | Clase | Si se pierde |
|---|---|---|
| La tabla de órdenes | Sistema de registro | No hay de dónde recuperarla, salvo un respaldo. Se pierden ventas |
| La cache del catálogo | Derivado | Las lecturas se vuelven lentas hasta que se llena otra vez |
| El índice de búsqueda | Derivado | No se puede buscar mientras se reconstruye; puede tardar horas |
| El reporte de ventas del mes | Derivado | Se vuelve a correr |
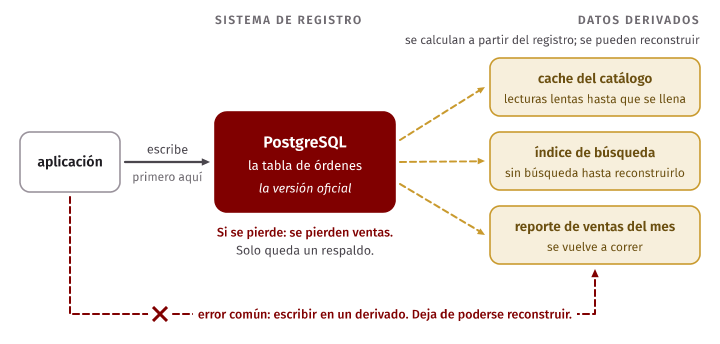
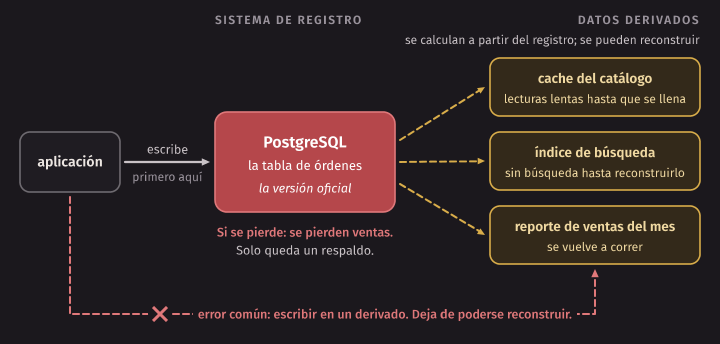
Saber cuál es cuál decide varias cosas a la vez: qué se respalda y con qué cuidado, qué se puede guardar en un sistema que pierde datos al reiniciarse (el Redis del contenedor arranca sin persistencia: sirve para una cache, no para las órdenes), y a quién se le cree cuando dos copias no coinciden.
Error común. Tratar un dato derivado como si fuera el oficial. Pasa sin que nadie lo decida: alguien corrige un total directamente en la tabla del reporte, o un servicio empieza a leer el saldo de la cache porque es más rápido, y un día escribe ahí. Desde ese momento el dato “derivado” ya no se puede reconstruir, porque contiene información que no está en ningún otro lugar, y nadie lo respalda porque todos creen que es una cache.
Que un dato sea derivado no quiere decir que sea barato perderlo. “Se puede reconstruir” tiene un tiempo, y ese tiempo es parte del diseño. Si reconstruir el índice de búsqueda tarda seis horas y el sitio no sirve sin búsqueda, ese índice necesita casi el mismo cuidado que el sistema de registro, aunque por otra razón: disponibilidad, no durabilidad.
Un nodo o muchos
Tres razones para distribuir los datos
Hasta aquí todo cabe en una máquina. Un nodo es una máquina que participa en un sistema de datos, y la pregunta de esta sección es cuándo conviene que los datos estén en más de uno. En la semana 5 vimos las razones para distribuir el código; para los datos son tres, y cada una es un escenario.
- Tolerar la falla de una máquina. Si los datos están en un solo nodo y ese nodo se cae, el sistema se detiene; si su disco se daña, además se pierden datos. Con una copia en otro nodo, el sistema puede seguir. Es un escenario de disponibilidad.
- Escalar más allá de una máquina. Si la carga o el volumen no caben en el nodo más grande que se puede pagar, hay que repartir: las lecturas entre varias copias (replicación, semana 10) o los datos mismos entre varios nodos (sharding, semana 11). Es un escenario de rendimiento.
- Acercar los datos a los usuarios. Una petición de Lima a un centro de datos en Virginia paga decenas de milisegundos de ida y vuelta antes de que la base de datos haga nada. Una copia cerca del usuario elimina ese tiempo para las lecturas. Es un escenario de latencia.
Lo que cuesta
Las falacias de la semana 5 valen aquí sin cambios, y con los datos duelen más, porque un dato mal escrito se queda mal escrito. Cuatro costos que no existen en un solo nodo:
- Fallas parciales. En un nodo, la base de datos funciona o no funciona. Con varios, una parte funciona y otra no, y la parte que funciona muchas veces no puede saber qué le pasó a la otra: si un nodo no responde, puede estar caído, puede estar lento, o puede haber respondido y que la respuesta se haya perdido. Los apuntes de Kleppmann para Cambridge empiezan el curso por aquí: distintas computadoras solo se comunican enviándose mensajes por una red, y eso lo cambia todo.
- Retraso de replicación. Una copia no recibe los cambios en el mismo instante en que ocurren. Quien lee de la copia puede ver el pasado: compra una entrada, recarga la página, y la compra no aparece.
- Relojes que no coinciden. Cada máquina tiene su reloj, y dos relojes nunca marcan exactamente lo mismo. “La escritura más reciente” deja de tener una respuesta evidente cuando las dos escrituras ocurrieron en nodos distintos.
- Lo que era una transacción pasa a ser un protocolo. En un nodo,
BEGINyCOMMITgarantizan que dos escrituras ocurren juntas. Entre dos nodos no hay unCOMMITque cubra a ambos: hay mensajes, y un procedimiento para decidir qué hacer cuando uno de los mensajes no llega. La semana 12 es sobre eso.
Cuánto aguanta una sola máquina
Contra esos costos hay que poner un dato que se suele subestimar: una sola
máquina aguanta mucho. En la medición de la sección anterior, un PostgreSQL
sin ajustar, dentro de un contenedor en una laptop que además estaba ocupada,
respondió entre 12 000 y 20 000 lecturas por clave por segundo con ocho
sesiones (y más de 50 000 en un momento en que la laptop estaba más libre). No
es una medición de capacidad (para eso habría que variar la concurrencia y
medir escrituras), pero da el orden de magnitud. La prueba de carga de la
venta en Tinkuy, make load-sale, usa 200 compradores a la vez: está muy por
debajo.
Y una sola máquina es más simple de razonar: tiene un reloj, las transacciones funcionan, no hay retraso de replicación porque no hay réplica, y cuando falla, falla entera.
Trade-off. Un solo nodo da transacciones, un solo reloj y un modelo de fallas simple, y cobra un techo de capacidad y un punto único de falla. Varios nodos quitan ese techo y ese punto único, y cobran fallas parciales, datos atrasados y protocolos en lugar de transacciones. El primer nodo extra casi siempre se justifica por disponibilidad (una copia para no perder los datos), no por carga.
Servicio administrado o propio
La base de datos se puede operar o se puede alquilar. Propio quiere decir que el equipo instala PostgreSQL en sus máquinas, lo configura, lo actualiza, lo respalda, prueba que los respaldos sirven y se levanta de madrugada cuando se llena el disco. Administrado quiere decir que un proveedor hace todo eso y entrega una dirección a la cual conectarse.
Parece una decisión de compras, y es de arquitectura por dos razones.
La primera: fija qué garantías se pueden pedir. Un servicio administrado ofrece un menú. Si el menú dice que el failover tarda hasta dos minutos, ese es el piso del escenario de disponibilidad, y ningún diseño del equipo lo va a mejorar. Si no permite cierta extensión, cierta versión o cierto parámetro, el diseño tiene que funcionar sin eso. A cambio, el menú trae cosas que al equipo le costaría meses hacer bien: réplicas, respaldos continuos, recuperación a un instante dado.
La segunda: fija cuánto cuesta salir. Cuanto más propio del proveedor es lo que se usa, más cara es la mudanza. Un PostgreSQL administrado se puede llevar a otro proveedor o a máquinas propias con un dump y una ventana de mantenimiento, porque del otro lado hay otro PostgreSQL. Una base de datos que solo existe en un proveedor no tiene otro lado: salir es reescribir el acceso a datos.
| Administrado | Propio | |
|---|---|---|
| Quién opera (respaldos, parches, failover) | El proveedor | El equipo |
| Qué se paga | Dinero, cada mes, creciente con el uso | Tiempo de personas que sepan hacerlo |
| Control (versión, parámetros, extensiones) | El que el menú permita | Todo |
| Garantías | Las del contrato del proveedor | Las que el equipo logre construir |
| Salir | Fácil si es un motor estándar; muy caro si no | No hay de dónde salir |
Trade-off. Con un servicio administrado se paga para no operar, y se entrega control y portabilidad. Conviene cuando el equipo es pequeño y operar una base de datos no es lo que lo distingue, que es casi siempre. Deja de convenir cuando la cuenta crece más rápido que el negocio, cuando se necesita algo que el menú no trae, o cuando una regulación exige que los datos estén en un lugar que el proveedor no ofrece.
La pregunta de la semana 5 vuelve con otra forma. Allí era ¿el equipo puede operar esto? Aquí es ¿el equipo quiere que operar esto sea su trabajo?
La escalabilidad es una pregunta
Describir la carga
“El sistema es escalable” no dice nada, igual que “el sistema es rápido” no decía nada en la semana 2. La escalabilidad no es una propiedad que un sistema tiene o no tiene. Es la respuesta a una pregunta con esta forma: si la carga crece de esta manera, ¿qué opciones hay para seguir cumpliendo, y cuánto cuesta cada una?
Para hacer la pregunta, primero hay que describir la carga, con números. Los parámetros de carga dependen del sistema, pero casi siempre incluyen:
- lecturas por segundo y escrituras por segundo;
- la proporción entre unas y otras;
- el tamaño de los datos, y cuánto crece;
- la forma en que llega: pareja, o en picos;
- el caso extremo: el usuario, el producto o la clave que concentra la carga.
Para Tinkuy, con lo que sabemos desde la semana 2:
| Parámetro | Valor | De dónde sale |
|---|---|---|
| Lecturas por cada escritura | Miles de visitas al catálogo por cada compra | Mirar es gratis; comprar no |
| Forma de las escrituras | Casi nada, y un pico el minuto en que abre una venta | Todos quieren el mismo asiento a la misma hora |
| Tamaño | Unos 13 000 asientos y 1 300 órdenes | La semilla de make db |
| Caso extremo | Un solo evento concentra casi todas las escrituras del pico | El evento 1 |
Dos sistemas con el mismo total de peticiones por segundo pueden necesitar arquitecturas opuestas. Uno con mil lecturas por cada escritura se resuelve con copias para leer (réplicas, cache). Uno con mil escrituras por cada lectura no gana nada con eso, porque todas las copias tienen que recibir todas las escrituras. Y un sistema cuya carga se concentra en una clave no se arregla repartiendo las claves entre máquinas, porque esa clave sigue cayendo entera en una sola. Por eso el caso extremo va en la lista.
Calcular al leer o al escribir: las líneas de tiempo
El capítulo 2 del libro desarrolla un caso que se volvió clásico: la línea de tiempo de una red social. Lo vamos a reconstruir en pequeño, con nuestros propios datos y nuestras propias mediciones, porque es la forma más clara de ver una decisión que aparece en todos los sistemas de datos.
El problema: cada usuario sigue a otros, y al abrir la aplicación quiere ver las veinte publicaciones más recientes de las cuentas que sigue. Hay dos operaciones, publicar y leer la línea de tiempo, y dos maneras de repartir el trabajo entre ellas.
Calcular al leer. Publicar guarda una fila. Leer busca a quiénes sigue el
usuario, trae las publicaciones de todos ellos, las ordena y se queda con
veinte. Las dos versiones están en
timeline/timeline.ts; esta es la
consulta de la primera:
SELECT p.id AS post_id, p.created_at
  FROM tl_follows f JOIN tl_posts p ON p.author_id = f.followee_id
 WHERE f.follower_id = $1
 ORDER BY p.created_at DESC, p.id DESC
 LIMIT 20
Calcular al escribir. Cada usuario tiene su línea de tiempo ya armada, en
la tabla tl_home. Publicar guarda la publicación y, además, agrega una fila
a la línea de tiempo de cada seguidor. Leer es recorrer veinte entradas de un
índice. A repartir una escritura entre muchos destinatarios se le dice
fan-out:
-- En la misma transacción que guarda la publicación $3 del autor $1:
INSERT INTO tl_home (user_id, created_at, post_id)
SELECT follower_id, $2, $3 FROM tl_follows WHERE followee_id = $1
El costo de cada diseño se puede escribir antes de medir nada. Si un usuario sigue a cuentas y cada una tiene publicaciones recientes, calcular al leer examina del orden de publicaciones en cada lectura, y publicar escribe una fila. Si el autor tiene seguidores, calcular al escribir escribe filas en cada publicación, y leer examina veinte entradas. El trabajo no desaparece: se mueve de una operación a la otra.
make timeline crea una red de 10 000 usuarios. Cada uno sigue a unas treinta
cuentas y además a la cuenta 1, la famosa, a la que siguen todos:
$ make timeline
10000 usuarios, 50000 publicaciones, 1549845 filas en las líneas de tiempo ya calculadas.
La cuenta 4242 tiene 30 seguidores; la cuenta 1, 9999.

Leer una línea de tiempo (mediana de 500 lectores):
  calculada al leer       0.58 ms
  calculada al escribir   0.32 ms

Publicar (mediana de 20 publicaciones):
  calculada al leer,     cuenta común    0.96 ms   (1 fila)
  calculada al leer,     cuenta famosa   0.93 ms   (1 fila)
  calculada al escribir, cuenta común    1.54 ms   (31 filas)
  calculada al escribir, cuenta famosa   96.33 ms   (10000 filas)
Lo que se ve, de arriba hacia abajo:
- La primera línea ya es un costo: 50 000 publicaciones se convirtieron en más de un millón y medio de filas derivadas. Calcular al escribir se paga también en espacio.
- Leer es más rápido con la línea de tiempo ya calculada, pero a esta escala la diferencia es chica: con 31 cuentas seguidas y cinco publicaciones cada una, calcular al leer examina unas 155 filas, y eso es poco trabajo. La ventaja crece con , es decir, con una red más activa que la del ejemplo. Los tiempos de lectura son además los que más se movieron entre corridas, por la carga de la máquina; lo estable es el orden.
- Publicar desde una cuenta común cuesta casi lo mismo en los dos diseños: 31 filas en vez de una.
- Publicar desde la cuenta famosa cuesta 10 000 filas. En las tres corridas que hicimos tardó entre 87 y 101 ms, contra 1 a 4 ms desde la misma cuenta sin fan-out. El conteo de filas no depende de la máquina: es .
Ese último renglón es el punto del caso. Calcular al escribir es una buena decisión para casi todos los usuarios, porque se lee mucho más de lo que se publica y cada publicación se reparte entre pocos. Y la misma decisión es mala para un puñado de cuentas: con diez mil seguidores son 10 000 filas por publicación; con diez millones, una sola publicación es una carga que no cabe en una transacción. El usuario extremo rompe la opción que servía para los demás.
La salida habitual es no elegir una de las dos para todos: las publicaciones de las cuentas comunes se reparten al escribir, y las de las pocas cuentas enormes se buscan al leer y se mezclan con la línea de tiempo ya calculada. Se paga con un sistema que tiene dos caminos, y con una regla más que decidir y mantener: desde cuántos seguidores una cuenta cambia de camino.
Dos cosas más que el ejemplo deja a la vista. La tabla tl_home es un dato
derivado, en el sentido de la sección anterior: test/timeline.test.ts la
borra entera y la reconstruye a partir de las otras dos. Y por ser derivada
puede quedar atrasada: si algo publica sin repartir, las líneas de tiempo ya
calculadas no se enteran. La misma prueba lo comprueba.
Idea clave. Casi toda decisión de rendimiento sobre datos es una variante de esta: hacer el trabajo cuando se escribe, para que leer sea barato, o cuando se lee, para que escribir lo sea. Un índice, una cache, una vista materializada y una tabla de totales son todos “calcular al escribir”. La elección depende de la proporción entre lecturas y escrituras, y del caso extremo.
La misma decisión en Tinkuy
Tinkuy toma esta decisión, en pequeño, cada vez que alguien abre el catálogo.
GET /events muestra cuántos asientos le quedan a cada evento. Hoy lo calcula
al leer. En src/catalog/seats.ts:
export async function countAvailableSeats(eventId: number): Promise<number> {
  const rows = await query<{ available: number }>(
    `SELECT count(*)::int AS available FROM seats WHERE event_id = $1 AND status = 'available'`,
    [eventId],
  );
  return rows[0]?.available ?? 0;
}
y listEvents llama a esa función una vez por cada evento de la lista. Es el
N+1 de la semana 6, y es la razón por la que GET /events es la lectura más
lenta del sistema. La alternativa es calcular al escribir: guardar en cada
evento un número, los asientos que le quedan, y cambiarlo en cada venta.
| Contar en cada lectura (hoy) | Mantener el número al vender | |
|---|---|---|
| Leer el catálogo | Un COUNT por evento, sobre todos sus asientos |
Un número ya calculado |
| Vender | Nada extra | Una escritura más, en la misma transacción |
| Puede estar desactualizado | No: siempre se cuenta lo que hay | Sí, si alguna escritura olvida actualizarlo |
| Caso extremo | Un catálogo con muchos eventos grandes | Todas las ventas del pico cambian la misma fila |
La última fila es la cuenta famosa de Tinkuy. Con la carga del sistema (miles de lecturas por cada compra), mantener el número parece la opción evidente. Pero el minuto en que abre una venta, todas las compras son del mismo evento, y todas tendrían que modificar la misma fila: la que guarda el contador. La decisión que conviene para la carga normal concentra el pico en un solo punto. No es una razón para descartarla; es lo que hay que medir antes de tomarla, y lo que un ADR sobre esta decisión tendría que decir en sus consecuencias.
Diseñar para una escala que no existe
Error común. Diseñar para una escala que no existe. “Pongamos sharding desde el inicio, por si crece.” “Usemos una base de datos distribuida, que escala sola.” Cada componente distribuido que se agrega “por si crece” es operación y modos de falla desde hoy: hay que desplegarlo, monitorearlo, actualizarlo y entender qué pasa cuando una parte se cae. El crecimiento es una hipótesis; el costo es un hecho, y empieza el primer día.
Lo contrario tampoco es una virtud. No pensar en la carga hasta que el sistema se cae también es un error, y es el que la semana 2 enseñó a evitar con escenarios. El punto medio tiene tres partes, y ninguna necesita construir nada por adelantado:
- Describir la carga de hoy y la que se espera, con sus parámetros. Si nadie puede decir cuánto va a crecer ni por qué, no hay base para diseñar para ese crecimiento.
- Saber dónde está el límite del diseño actual. Se mide: ¿con cuántas compras por segundo deja de cumplirse el escenario? Si el límite está a diez veces de la carga actual, hay tiempo.
- No cerrarse la puerta. Las decisiones baratas de hoy que hacen posible el cambio de mañana: que el acceso a los datos pase por un módulo y no esté regado por todo el código, que cada módulo sea owner de sus tablas, que las claves no dependan de estar todas en una máquina. Son las reglas de la primera mitad del curso, y esta es una de las razones por las que existen.
El modelo de datos decide qué preguntas son fáciles
Relacional y de documentos, con el mismo pedido
Un modelo de datos es la forma en que un sistema de almacenamiento deja representar la información: tablas con filas, documentos con campos anidados, nodos unidos por aristas, o claves con un valor opaco. No hay un modelo mejor. Cada uno hace baratas unas preguntas y caras otras, y se elige mirando qué preguntas hace el sistema: sus patrones de acceso.
Los dos más usados son el relacional y el de documentos, y se entienden mejor
con el mismo dato guardado de las dos maneras.
models/models.sql guarda mil pedidos de
una librería en tres tablas (m_orders, m_items, m_books) y, además, como
un documento JSON por pedido. PostgreSQL permite las dos cosas, así que se
pueden comparar sin cambiar de base de datos. make models hace cuatro
preguntas a cada uno.
Leer un pedido entero. El documento es una fila:
$ make models
== 1. Leer un pedido entero
Documento: una fila, sin JOIN.
                    pedido_4
------------------------------------------------
 {                                             +
     "buyer": "comprador 4",                   +
     "items": [                                +
         {                                     +
             "title": "La ciudad y los perros",+
             "quantity": 1,                    +
             "priceCents": 5200                +
         },                                    +
 …

Relacional: tres tablas.
    buyer    |         title          | price_cents | quantity
-------------+------------------------+-------------+----------
 comprador 4 | La ciudad y los perros |        5200 |        1
 comprador 4 | Trilce                 |        3000 |        1
Para esta pregunta el documento gana: lo que la aplicación usa junto está
guardado junto. A la unidad que se lee y se escribe entera se le llama un
agregado, y el modelo de documentos está hecho para eso. El modelo
relacional lo parte en tres tablas y lo vuelve a armar con dos JOIN cada vez.
Una pregunta que cruza pedidos. ¿Cuántos ejemplares se vendieron de cada libro?
== 2. Una pregunta que cruza pedidos: cuántos ejemplares se vendieron de cada libro
Relacional:
         title          | ejemplares
------------------------+------------
 La ciudad y los perros |        584
 Los ríos profundos     |        583
 Trilce                 |        583

Documento: hay que abrir todos los documentos y desarmar sus listas.
         title          | ejemplares
------------------------+------------
 La ciudad y los perros |        584
 Los ríos profundos     |        583
 Trilce                 |        583
Las dos responden lo mismo, pero no de la misma forma. La relacional recorre
una tabla angosta, m_items, que existe precisamente porque la relación entre
pedidos y libros es de muchos a muchos. La de documentos abre cada pedido y
desarma su lista:
SELECT item->>'title' AS title, sum((item->>'quantity')::int) AS ejemplares
FROM m_order_docs, jsonb_array_elements(doc->'items') AS item GROUP BY 1 ORDER BY 1;
Corregir un dato compartido. El título de un libro tenía un error:
== 3. Corregir el título de un libro
Relacional:
UPDATE 1
Documento: el título está copiado en cada pedido que lo incluye.
UPDATE 416
Una fila contra 416 documentos. En el modelo relacional cada dato está en un solo lugar (eso es lo que la normalización consigue) y los demás lo referencian. En el documento, el título viaja copiado dentro de cada pedido. No toda copia es un defecto: el precio debe estar copiado en el pedido, porque es el precio al que se vendió, un hecho que no cambia aunque el libro suba mañana. El título, en cambio, es una referencia a algo que vive en otro lado, y copiarlo obliga a corregirlo en todas partes.
Un dato mal formado.
== 4. Un dato mal formado
Relacional (esquema al escribir): la base de datos lo rechaza.
psql:models/models.sql:61: ERROR:  new row for relation "m_items" violates check constraint "m_items_quantity_check"
DETAIL:  Failing row contains (1, 3, 0).
Documento (esquema al leer): entra, y falla después, en quien lo lea.
psql:models/models.sql:64: ERROR:  invalid input syntax for type integer: "dos"
El segundo error no ocurrió al insertar el documento con "quantity": "dos":
ocurrió en la consulta siguiente, la que suma cantidades. Volvemos a esto en
Esquema al escribir y esquema al leer.
| Relacional | De documentos | |
|---|---|---|
| Unidad | La fila; un objeto se reparte entre tablas | El documento; un objeto completo |
| Fácil | Relaciones de muchos a muchos, JOIN, restricciones, transacciones entre varias tablas |
Leer y escribir un agregado entero; campos que varían de un documento a otro |
| Difícil | Armar un objeto con muchas partes; cambiar el esquema de una tabla enorme | Relaciones entre documentos; preguntas que cruzan agregados; datos compartidos |
| Esquema | Lo hace cumplir la base de datos | Está en el código que lee |
Trade-off. El modelo de documentos gana cuando los datos forman agregados independientes que se leen enteros (un pedido, un perfil, un carrito). El relacional gana cuando lo que importa son las relaciones entre las cosas y las preguntas que nadie previó. La mayoría de los sistemas tienen de las dos clases de datos, y por eso las bases de datos relacionales aceptan JSON y las de documentos fueron agregando formas de
JOIN. La frontera es menos nítida de lo que sugieren los nombres.
Grafos y clave-valor
Otros dos modelos ocupan los extremos.
De grafos. Cuando las relaciones no son un detalle de los datos sino los
datos mismos: quién sigue a quién, qué cuenta le transfirió a cuál, qué pieza
depende de qué otra. Las preguntas típicas recorren un número de pasos que no
se conoce de antemano (¿hay un camino entre estas dos cuentas?, amigos de
amigos de amigos). En SQL se pueden escribir, con consultas recursivas, pero
cada paso es un JOIN más. Un modelo de grafos guarda nodos y aristas y tiene
un lenguaje de consulta donde recorrer es la operación básica. Se paga con un
motor menos común, que menos gente sabe operar.
Clave-valor. El modelo más simple posible: se guarda un valor bajo una
clave y se recupera por esa clave. Nada más: ni consultas por otro campo, ni
JOIN, ni restricciones entre valores. Esa pobreza es lo que se compra:
como cada operación toca una sola clave, repartir las claves entre muchas
máquinas es directo (semana 11), y cada operación es tan rápida como puede
ser. Redis, en su uso como cache, es esto. Sirve cuando el patrón de acceso es
de verdad “dame lo que hay bajo esta clave”, y se vuelve una trampa el día en
que alguien necesita “dame todos los que cumplen tal condición”.
Error común. Elegir el modelo por moda o por lo que el equipo usó en el proyecto anterior. El procedimiento es el mismo que para elegir un estilo de arquitectura: se escriben las cinco o seis consultas que el sistema hace todo el tiempo y las dos o tres que no puede dejar de responder, y se mira con qué modelo cada una es una operación natural. Si casi todas lo son con el modelo relacional, la pregunta está resuelta, y es el caso más frecuente.
Esquema al escribir y esquema al leer
Las bases de datos de documentos se describen a veces como “sin esquema”. No
es exacto, y el cuarto resultado de make models muestra por qué. El código
que suma cantidades supone que quantity es un número. Esa suposición es
un esquema. Lo que cambia es dónde vive y quién lo hace cumplir:
- Esquema al escribir (schema-on-write): la estructura está declarada
en la base de datos, y un dato que no la cumple no entra. Es lo que hizo la
restricción
CHECK (quantity > 0). El error le llega a quien escribe, en el momento en que escribe. - Esquema al leer (schema-on-read): la base de datos acepta cualquier cosa, y la estructura está implícita en el código que lee. El error le llega a quien lee, cuando lee, que puede ser meses después y en otro programa.
Idea clave. “Sin esquema” quiere decir que el esquema está en el código que lee, sin nadie que lo haga cumplir. Sigue habiendo un esquema; lo que no hay es un lugar donde esté escrito ni un guardián.
El esquema al leer tiene usos legítimos. Cuando los datos vienen de fuera y no se controla su forma, o cuando cada documento tiene de verdad campos distintos, obligar una estructura única estorba. Y un cambio de estructura no necesita migrar nada: el código nuevo empieza a escribir el campo nuevo, y al leer maneja los documentos que no lo tienen. Lo que se paga es que todo lector tiene que manejar todas las formas que el dato tuvo alguna vez, y nada le avisa cuáles son.
Persistencia políglota
Si cada modelo es bueno para algo, la conclusión tentadora es usar varios: una base de datos por necesidad. A eso se le llama persistencia políglota. Para un sistema como Tinkuy podría ser PostgreSQL para las órdenes, Redis para la cache del catálogo y un índice de búsqueda para encontrar eventos por nombre.
Lo que se gana es ajuste: cada dato está donde sus preguntas son fáciles. Lo que se paga tiene dos partes.
La primera es operación. Tres sistemas son tres cosas que instalar, actualizar, monitorear y respaldar, y tres conjuntos de modos de falla que alguien del equipo tiene que entender.
La segunda es más profunda, y es el tema de las próximas semanas: ya no hay una transacción que cubra todo. Cuando un evento cambia de nombre, hay que cambiarlo en PostgreSQL, invalidarlo en Redis y actualizarlo en el índice de búsqueda. Son tres escrituras en tres sistemas, y ninguno de ellos puede garantizar que ocurran las tres o ninguna. Si la segunda falla, el catálogo muestra el nombre anterior hasta que alguien lo note. Mantener las copias de acuerdo pasa a ser trabajo del equipo.
Aquí es donde la distinción entre sistema de registro y dato derivado deja de ser vocabulario. Una persistencia políglota que se sostiene tiene un sistema de registro por dato, y los demás almacenes son derivados que se alimentan de él y se pueden reconstruir. Una que no se sostiene tiene tres almacenes que la aplicación escribe por separado, cada uno un poco distinto de los otros, y nadie sabe cuál tiene la razón.
Trade-off. Cada almacén que se agrega mejora el ajuste para una clase de consultas y cobra operación y consistencia. Antes de agregar el segundo, vale la pena preguntar si el primero no alcanza: PostgreSQL guarda documentos (
jsonb), busca texto y hace consultas recursivas. No lo hace tan bien como un sistema dedicado, y para muchos sistemas “no tan bien” es suficiente y cuesta un sistema menos.
El modelo de datos como interfaz
Queda un punto que conecta esta sesión con la primera mitad del curso. En la semana 3 una interfaz era lo que un módulo promete a los demás, y todo lo que no está en la interfaz se puede cambiar sin avisar. ¿Dónde queda el esquema de la base de datos?
Depende de quién lo lea. Si las tablas de órdenes solo las toca el módulo de órdenes, el esquema es un detalle de implementación: se puede cambiar el nombre de una columna y nadie más se entera. Pero si el módulo de reportes hace sus propias consultas sobre esas tablas, el esquema se volvió un contrato público. Cada columna que el reporte lee es una promesa que el módulo de órdenes hizo sin saberlo.
De ahí viene la regla que ya vieron dos veces, en el modular monolith (semana 4) y en los microservicios (semana 5): cada módulo o servicio es owner de sus datos, y los demás los piden por su interfaz. No es una regla de orden. Es lo que hace posible cambiar el esquema.
En Tinkuy. En el Tinkuy inicial, el módulo
reportsconsulta directamente las tablasorders,order_itemsyseats, que son de otros módulos.make depsno lo ve: la dependencia está escrita en SQL, no en unimport. Mientras alguien lea esas tablas por su cuenta, ninguna de sus columnas se puede cambiar sin coordinar con él.
El caso del laboratorio tiene exactamente esa forma: un servicio de órdenes, y un proceso de reportes de otro equipo que se conecta a su base de datos y lee la tabla. El resto del capítulo es sobre qué hacer cuando ya es tarde para evitarlo.
Por qué la evolución es un problema de arquitectura
Versiones que conviven
Cambiar un programa que corre en una sola computadora es simple: se detiene, se reemplaza, se inicia. Todo el código que existe es de la misma versión.
En un sistema que no se detiene, eso no pasa nunca. Hay al menos cuatro situaciones en las que código de dos versiones funciona al mismo tiempo sobre los mismos datos:
- Un despliegue gradual. Para no detener el servicio, las instancias se reemplazan de a pocas. Durante unos minutos, unas atienden con la versión anterior y otras con la nueva, y un load balancer reparte las peticiones entre todas. Las dos versiones leen y escriben la misma base de datos.
- Un cliente que no se actualiza. Una aplicación móvil instalada hace dos años sigue llamando a la API como se llamaba hace dos años. El equipo no puede obligar a nadie a actualizarla.
- Un mensaje que quedó en una cola. Lo escribió la versión anterior y lo va a leer la nueva. O al revés: la nueva ya publica, y un consumidor que todavía no se actualizó lo recibe.
- Los datos guardados. Toda fila de la base de datos la escribió alguna versión del código, casi siempre una anterior a la que hoy la lee.
Idea clave. En un sistema que no se detiene, la versión vieja y la nueva del código conviven siempre, aunque sea por unos minutos. Un cambio de formato o de contrato no se diseña para “antes” y “después”: se diseña para “durante”.
Es un problema de arquitectura, y no de programación, porque atraviesa fronteras. El formato de una fila, de un mensaje o de una respuesta HTTP es lo que conecta partes del sistema que se despliegan por separado y que a veces pertenecen a equipos distintos.
Hacia atrás y hacia adelante
La compatibilidad tiene dos direcciones, y casi todas las confusiones vienen de no decir cuál.
Compatibilidad hacia atrás (backward compatibility): el código nuevo puede leer datos escritos por el código viejo. Es la que todos tienen presente, y la fácil: quien escribe el código nuevo conoce el formato viejo y puede manejarlo explícitamente.
Compatibilidad hacia adelante (forward compatibility): el código viejo puede leer datos escritos por el código nuevo. Es la difícil, porque el código viejo ya está escrito y desplegado. No se le puede enseñar el formato nuevo: tiene que haber sido escrito, desde el principio, de modo que tolere lo que todavía no existía.
| Quién escribe | Quién lee | Cuándo importa | |
|---|---|---|---|
| Hacia atrás | La versión vieja | La versión nueva | Siempre: los datos guardados son viejos |
| Hacia adelante | La versión nueva | La versión vieja | Despliegue gradual, rollback, clientes que no se actualizan |
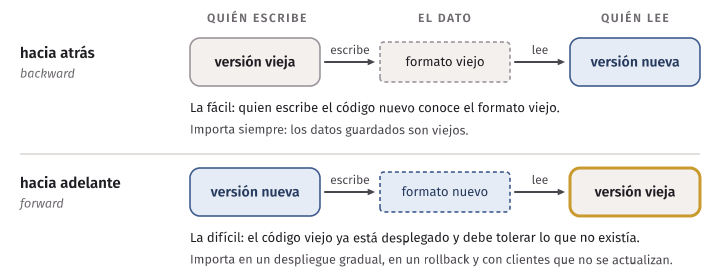
La compatibilidad hacia adelante importa incluso cuando todos los clientes son del mismo equipo y se actualizan juntos. Durante un despliegue gradual, una instancia nueva escribe una fila, y la petición siguiente sobre esa misma fila le toca a una instancia vieja. Y si el despliegue sale mal y se hace rollback, toda la base de datos queda con filas escritas por la versión nueva y leídas por la vieja. Un sistema sin compatibilidad hacia adelante es un sistema donde el rollback no funciona.
El campo que se pierde
“Tolerar lo que no se conoce” tiene dos niveles. El primero es no fallar: el código viejo ve un campo que no conoce y lo ignora. El segundo es más exigente y es el que se olvida: no destruirlo.
El caso es este. El código nuevo guarda una orden con un campo currency. El
código viejo la lee para anularla, cambia el estado y la vuelve a guardar.
formats/document-roundtrip.ts
tiene las dos maneras de escribir ese código viejo:
/** Como se escribe sin pensarlo: se copia el documento a un objeto con los campos conocidos. */
export function cancelDroppingUnknown(document: string): string {
  const raw = JSON.parse(document) as OrderV1;
  const order: OrderV1 = { id: raw.id, buyerName: raw.buyerName, totalCents: raw.totalCents, status: 'cancelled' };
  return JSON.stringify(order);
}

/** Lo mismo, llevando consigo todo lo que llegó: solo se toca el campo que cambia. */
export function cancelKeepingUnknown(document: string): string {
  const raw = JSON.parse(document) as Record<string, unknown>;
  return JSON.stringify({ ...raw, status: 'cancelled' });
}
$ node formats/document-roundtrip.ts
escrito por el código nuevo: {"id":7,"buyerName":"Ana Ccori","givenName":"Ana","familyName":"Ccori","totalCents":10000,"currency":"USD","status":"paid"}
anulado por el código viejo: {"id":7,"buyerName":"Ana Ccori","totalCents":10000,"status":"cancelled"}
anulado conservando el resto: {"id":7,"buyerName":"Ana Ccori","givenName":"Ana","familyName":"Ccori","totalCents":10000,"currency":"USD","status":"cancelled"}La primera función no falló. Leyó el documento, hizo su trabajo y guardó un documento válido. Y una orden de 100 dólares quedó convertida en una orden de 100 de una moneda que ya nadie sabe cuál es. No hubo error, no hubo log, y el código que lo causó es el viejo, el que nadie tocó.
Dos observaciones. La primera función es la que sale naturalmente cuando el
código convierte lo que lee en un objeto con tipo: los campos que el tipo no
declara no tienen dónde quedarse. Y el problema depende del modelo de datos.
En una tabla relacional, anular una orden es UPDATE orders SET status = 'cancelled' WHERE id = $1, que no toca las demás columnas, conozca o no el
código su existencia. En el modelo de documentos, donde se lee y se escribe el
agregado entero, quien reescribe es responsable de todo lo que había.
make forward lo muestra con el servicio de la semana, y es el último paso
del laboratorio.
Formatos
Para que un dato salga de la memoria de un proceso (hacia un archivo, una fila, un mensaje o una respuesta HTTP) hay que convertirlo en una secuencia de bytes, y del otro lado hay que hacer lo contrario. Al primer paso se le dice codificar o serializar. El formato que se elige determina qué cambios se pueden hacer después sin romper a nadie.
JSON
JSON es el formato de casi todas las API web, incluidas la de Tinkuy y la del servicio de la semana. Sus ventajas son reales: es texto, se lee a simple vista, todos los lenguajes lo entienden, y cada mensaje lleva los nombres de sus campos, así que se puede interpretar sin tener nada más.
Tiene tres debilidades que conviene conocer.
No trae esquema. Nada en un mensaje JSON dice qué campos son obligatorios ni de qué tipo. Es esquema al leer, con las consecuencias de la sección anterior. Se le puede agregar un esquema por fuera (JSON Schema, OpenAPI), pero es opcional y nada obliga a que el código y el esquema coincidan.
Es ambiguo con los números. JSON tiene “número” y nada más: no distingue enteros de decimales ni dice cuánta precisión tienen. Cada lenguaje decide. JavaScript los lee todos como punto flotante de 64 bits, que representa enteros exactos solo hasta :
$ node formats/json-numbers.ts
texto recibido:   {"orderId": 9007199254740993, "totalCents": 1999, "price": 0.1}
orderId leído:    9007199254740992
vuelto a escribir: {"orderId":9007199254740992,"totalCents":1999,"price":0.1}
Number.MAX_SAFE_INTEGER = 9007199254740991
0.1 + 0.2 = 0.30000000000000004   (por eso los montos van en céntimos, como enteros)
como texto:       9007199254740993
El identificador cambió al pasar por JSON.parse, sin ningún error. Un
servicio en otro lenguaje, con enteros de 64 bits, lo habría leído bien, y por
eso el problema aparece solo entre ciertas parejas de sistemas. Las API que
usan identificadores grandes los envían como texto.
Es grande. Los nombres de los campos viajan en cada mensaje. En una respuesta HTTP no importa. En mil millones de filas o de mensajes, sí.
Binarios con esquema: etiquetas en vez de nombres
Los formatos binarios con esquema, como Protocol Buffers y Avro, parten de otra idea: el esquema se escribe aparte, una vez, y los mensajes llevan solo los valores. Lo interesante para este capítulo no es que ocupen menos, sino que sus reglas de evolución son explícitas.
En Protocol Buffers, cada campo del esquema tiene un número, su etiqueta,
y en los bytes viaja la etiqueta, no el nombre. Para ver qué consecuencias
tiene, formats/tagged.ts implementa un
formato mínimo con esa misma idea: unas cien líneas, con enteros y textos. El
esquema de la orden tiene dos versiones; esta es la segunda:
export const orderV2: Schema = {
  1: { name: 'id', type: 'int' },
  2: { name: 'buyerName', type: 'string' },
  3: { name: 'totalCents', type: 'int' },
  4: { name: 'givenName', type: 'string' },   // las etiquetas 4, 5 y 6 no existen en orderV1
  5: { name: 'familyName', type: 'string' },
  6: { name: 'currency', type: 'string' },
};
$ node formats/tagged.ts
JSON (109 bytes): {"id":150,"buyerName":"Ana Ccori","totalCents":32000,"givenName":"Ana","familyName":"Ccori","currency":"USD"}
binario (35 bytes): 08 96 01 12 09 41 6e 61 20 43 63 6f 72 69 18 80 fa 01 22 03 41 6e 61 2a 05 43 63 6f 72 69 32 03 55 53 44
Un lector con el esquema v1 lee el mensaje escrito con el v2:
conoce: {"id":150,"buyerName":"Ana Ccori","totalCents":32000}
no conoce: etiquetas 4, 5, 6
El lector v1 cambia totalCents y vuelve a escribir, conservando lo que no conoce:
un lector v2 lee: {"id":150,"buyerName":"Ana Ccori","totalCents":30000,"givenName":"Ana","familyName":"Ccori","currency":"USD"}
Si no lo conserva:
un lector v2 lee: {"id":150,"buyerName":"Ana Ccori","totalCents":30000}Los tres primeros bytes, 08 96 01, son el campo 1 con el valor 150: 08 es
la etiqueta 1 con el tipo “entero”, y 96 01 es 150 en una codificación de
largo variable. La palabra id no aparece en ningún lado. De ahí salen las
propiedades del formato:
- Agregar un campo es compatible en las dos direcciones. El lector nuevo que recibe un mensaje viejo simplemente no encuentra las etiquetas 4, 5 y 6, y las trata como ausentes. El lector viejo que recibe un mensaje nuevo encuentra etiquetas que no conoce; como cada campo dice de qué tipo es, sabe cuántos bytes saltar.
- El lector viejo puede conservar lo que no conoce. Guarda los bytes de los campos desconocidos y los vuelve a escribir tal cual. Es la solución al problema de El campo que se pierde, resuelta por el formato y no por la disciplina de cada programador.
- Cambiar el nombre de un campo es gratis. El nombre solo existe en el esquema; los bytes no cambian.
- La etiqueta es para siempre. Si se reutiliza el número 2 para otra cosa,
los mensajes viejos se van a leer con el significado nuevo.
test/formats.test.tscomprueba las dos últimas afirmaciones.
En la industria. La guía de Protocol Buffers lo dice sin matices: los números de campo no se deben reutilizar nunca, y un campo que se elimina debe dejar su número en una lista
reservedpara que el compilador rechace a quien intente usarlo de nuevo. Entre las consecuencias de reutilizarlo, la guía lista corrupción de datos y fuga de datos personales. También dice que los campos desconocidos se conservan al leer y se incluyen al volver a escribir, y que se pierden si el mensaje se convierte a JSON o se copia campo por campo a un mensaje nuevo. Fuente: Language Guide (proto 3), secciones Assigning Field Numbers, Deleting Fields y Unknown Fields.
Avro resuelve lo mismo de otra manera. Sus mensajes no llevan ni nombres ni etiquetas, solo los valores en el orden del esquema, así que para leer uno hace falta el esquema exacto con que se escribió. Quien lee tiene entonces dos esquemas, el de quien escribió y el suyo, y la biblioteca los empareja campo por campo, por nombre: a eso se le llama resolución de esquemas. Un campo que está en el esquema de quien lee y no en el de quien escribió toma su valor por omisión; uno que está solo en el de quien escribió se descarta. La consecuencia es la regla inversa a la de Protocol Buffers: en Avro el nombre es lo que identifica al campo, y por eso cambiar un nombre exige declarar un alias.
Las reglas de evolución
Con cualquiera de los dos, las reglas se pueden escribir en una tabla, y esa es la ventaja sobre JSON: con JSON las mismas reglas valen, pero nadie las comprueba.
| Cambio | ¿Compatible? | Por qué |
|---|---|---|
| Agregar un campo opcional, o con valor por omisión | Sí, en las dos direcciones | El lector viejo lo ignora; el nuevo usa el valor por omisión cuando falta |
| Agregar un campo obligatorio | No hacia atrás | Los datos viejos no lo tienen, y el lector nuevo los rechaza |
| Quitar un campo opcional | Sí, si su etiqueta o su nombre no se reutilizan | El lector viejo lo ve ausente |
| Quitar un campo obligatorio | No hacia adelante | El lector viejo lo exige y ya no llega |
| Cambiar el nombre de un campo | Depende del formato | Gratis con etiquetas; incompatible en JSON; con alias en Avro |
| Cambiar el tipo de un campo | En general, no | Los bytes viejos se interpretan con el tipo nuevo, o al revés |
La fila del campo obligatorio explica una decisión de diseño de estos formatos: empujan a que todo campo nuevo sea opcional o tenga valor por omisión. Un campo obligatorio es una promesa que no se puede retirar.
Trade-off. JSON da legibilidad y cero herramientas, y cobra con un esquema que nadie hace cumplir. Un formato binario con esquema da mensajes compactos y compatibilidad que una herramienta puede comprobar, y cobra con un paso de generación de código, con mensajes que no se leen a simple vista y con la disciplina de administrar el esquema. Para una API pública que consumen navegadores, JSON es casi siempre la respuesta. Para mensajes entre servicios propios, o datos que se guardan por años, el esquema explícito empieza a pagar.
Evolucionar una API
Cambios compatibles e incompatibles
Una API HTTP con JSON es un contrato entre el servicio y sus clientes, y evoluciona con las mismas reglas, con un detalle: tiene dos sentidos. En la petición, el cliente escribe y el servicio lee. En la respuesta es al revés. El mismo cambio puede ser inocuo en un sentido y romper en el otro.
| Cambio | En la respuesta | En la petición |
|---|---|---|
| Agregar un campo opcional | Compatible, si los clientes ignoran lo que no conocen | Compatible: quien no lo envía sigue funcionando |
| Agregar un campo obligatorio | Compatible (el servicio siempre lo envía) | Incompatible: los clientes de hoy no lo envían |
| Quitar un campo | Incompatible para quien lo lee | Compatible, si el servicio ignora lo que ya no usa |
| Cambiar el nombre de un campo | Incompatible | Incompatible |
| Cambiar un tipo (número a texto) | Incompatible | Incompatible |
| Volver obligatorio un campo opcional | Compatible | Incompatible |
| Cambiar el significado de un campo | Incompatible, y sin ningún error | Incompatible, y sin ningún error |
| Agregar un endpoint | Compatible |
La regla que resume la tabla: es compatible exigir menos y prometer más. Un servicio puede aceptar peticiones que antes rechazaba y puede responder con más de lo que respondía. No puede exigir algo que antes no exigía, ni dejar de enviar algo que antes enviaba.
Lector tolerante
La primera fila de la tabla tiene una condición: si los clientes ignoran lo que no conocen. Esa condición no es automática. Depende de cómo se escribió cada cliente.
Un lector tolerante (tolerant reader) toma de una respuesta lo que necesita y no opina sobre el resto. Si necesita dos campos, busca esos dos; no comprueba que no haya otros, ni supone un orden, ni convierte la respuesta completa en un objeto rígido. La idea viene de la ley de Postel, que Fowler cita en su artículo: ser conservador en lo que se envía y liberal en lo que se acepta.
Lo contrario es un lector que valida la respuesta contra la lista exacta de
campos que conocía cuando se escribió.
errors/strict-reader.ts tiene uno
de cada clase. El estricto:
export function strictRead(order: Record<string, unknown>): string {
  const extra = Object.keys(order).filter((key) => !KNOWN_FIELDS.includes(key));
  if (extra.length > 0) throw new Error(`Respuesta inesperada: campos desconocidos ${extra.join(', ')}`);
  return `Orden #${String(order.id)} de ${String(order.buyerName)}`;
}
tolerantRead es la misma función sin las dos primeras líneas.
$ node errors/strict-reader.ts
lector tolerante, respuesta de antes:   Orden #7 de Ana Ccori
lector tolerante, respuesta con campos nuevos: Orden #7 de Ana Ccori
lector estricto, respuesta de antes:    Orden #7 de Ana Ccori
lector estricto, respuesta con campos nuevos:
…
Error: Respuesta inesperada: campos desconocidos givenName, familyName, currency
El lector estricto parece el más cuidadoso de los dos, y es el que convierte el cambio más inocente que existe, agregar un campo, en una caída. Además le quita al servicio la única forma de evolucionar sin coordinarse con nadie.
Tolerante no quiere decir que acepte cualquier cosa. El cliente móvil de la
semana (consumers/mobile-client.ts)
es tolerante con lo que no usa y exigente con lo que usa: si buyerName no
llega, o no es un texto, falla diciendo qué campo falta. Eso es lo correcto:
un cliente que mostrara “A nombre de: undefined” no sería tolerante, sería un
cliente con un error que nadie ve.
Ley de Hyrum
El lector tolerante es una recomendación para quien consume. Quien publica una API no puede contar con que todos la sigan, y hay una observación que dice hasta dónde llega el problema. La ley de Hyrum: con suficientes usuarios de una API, no importa lo que el contrato prometa; alguien dependerá de cada comportamiento observable del sistema.
“Comportamiento observable” incluye mucho más que los campos documentados. Algunos ejemplos de cosas de las que alguien termina dependiendo:
- El orden de los elementos de una lista. El contrato dice “devuelve las
órdenes del comprador”. La implementación, por cómo está escrita la
consulta, las devuelve por
id. Un cliente muestra “tu última compra” tomando el último elemento. El día en que alguien agrega un índice y PostgreSQL elige otro plan, el orden cambia y ese cliente muestra una compra de hace tres años. Nadie rompió el contrato. - El orden de las claves de un objeto JSON. Un cliente que busca el total con una expresión regular sobre el texto, en vez de interpretar el JSON.
- El texto de un mensaje de error. Un cliente que decide si reintentar buscando la palabra “ocupado” en el mensaje.
- La latencia. Un cliente con un timeout de 200 ms funciona mientras el servicio responda en 150 ms, aunque nadie lo haya prometido.
En la industria. Hyrum Wright, que fue ingeniero en Google, formuló la observación después de varios años de migraciones de infraestructura en un sistema muy grande: con suficientes consumidores, la interfaz implícita termina coincidiendo con la implementación, y cualquier cambio rompe la expectativa de alguien. El nombre “ley de Hyrum” se lo puso Titus Winters. Fuente: hyrumslaw.com.
La ley no dice que no se pueda cambiar nada. Dice que “no cambié el contrato” no es una prueba de que el cambio sea seguro. Las consecuencias prácticas son dos: lo que no se quiere prometer conviene que no sea observable (devolver la lista sin un orden estable, a propósito, es una defensa conocida), y antes de quitar algo hay que medir si alguien lo usa, que es el tema de Cuándo contraer.
Compatible en la forma, incompatible en el significado
La fila más peligrosa de la tabla es la penúltima. El servicio de la semana
guarda montos en céntimos de sol, y el cambio pedido en el laboratorio agrega
un campo currency. Mirado como estructura, es el cambio más seguro que hay:
un campo opcional más en la respuesta. El cliente móvil, que es un lector
tolerante, lo ignora y sigue funcionando.
Ese es justamente el problema.
errors/currency-meaning.ts le
da al código del cliente antiguo una orden en dólares:
$ node errors/currency-meaning.ts
El servicio responde: {"id":300010,"buyerEmail":"ana.ccori@correo.pe","buyerName":"Ana Ccori","givenName":"Ana","familyName":"Ccori","totalCents":10000,"currency":"USD","status":"paid","createdAt":"2026-11-16T15:00:00.000Z"}
El cliente móvil antiguo muestra:
  Orden #300010
  A nombre de: Ana Ccori
  Total: S/ 100.00
  Estado: pagada
Cien dólares mostrados como cien soles. El campo totalCents no cambió de
nombre ni de tipo. Cambió de significado: antes era “céntimos de sol” y ahora
es “céntimos de la moneda que diga currency”. Ninguna herramienta de
compatibilidad de esquemas detecta eso, porque el esquema viejo es un
subconjunto exacto del nuevo.
Error común. Creer que un cambio es compatible porque ningún cliente falla. Los cambios de significado no producen errores: producen datos equivocados que se ven correctos. Las preguntas que hay que hacerse ante un campo nuevo no son solo “¿quién falla si aparece?”, sino también “¿qué suponía quien lee los campos viejos, y sigue siendo cierto?”.
Mientras todas las órdenes sean en soles, el cliente antiguo acierta por
casualidad. Las salidas posibles cuestan todas algo: no crear órdenes en otra
moneda mientras ese cliente exista (se retrasa el negocio); dejar
totalCents siempre en soles y poner el monto en la otra moneda en campos
nuevos (el contrato queda con dos formas de decir lo mismo); o aceptar que el
cliente antiguo mostrará mal las órdenes en dólares, y decidir que es
tolerable porque ese cliente no puede crearlas. En el laboratorio tienen que
elegir una y defenderla.
Una versión nueva para cada cambio
La respuesta que muchos equipos dan a todo lo anterior es versionar la API: lo
nuevo va en /v2, y /v1 queda como estaba.
Error común. Versionar la API para cada cambio. Parece la opción segura porque nadie se rompe. Pero cada versión viva es código que hay que mantener, probar y operar: un error de seguridad se corrige en todas, y una regla de negocio nueva se implementa en todas. Y el problema original no se resolvió, solo se aplazó: los clientes de
/v1siguen ahí, y algún día alguien tiene que decidir cuándo se apaga.
La mayoría de los cambios se pueden hacer compatibles, y esa es la primera opción. De los cambios de las tablas anteriores, agregar campos y endpoints no necesita versión. Cambiar un nombre o partir un campo en dos tampoco: se agrega lo nuevo al lado de lo viejo, se espera, y se quita lo viejo cuando nadie lo usa. Eso es la sección siguiente.
Una versión nueva se justifica cuando el cambio no admite que las dos formas convivan en la misma respuesta: cambió el modelo entero, cambió el significado de casi todo, o cambió el mecanismo de autenticación.
En la industria. Stripe describe por qué evita las versiones grandes (
v1,v2): los cambios entre una y otra son tan grandes que actualizarse se parece a integrarse de nuevo, y siempre queda un grupo de usuarios atrapado en la versión vieja. Su API usa en cambio versiones con fecha, cada una con un conjunto pequeño de cambios incompatibles; cada cuenta queda fijada en la versión de su primera petición, y cada cambio incompatible vive en un módulo que transforma la respuesta actual a la forma que esperaba la versión anterior. Es versionar, y el costo de mantener lo viejo queda encerrado en esos módulos en vez de regado por el código. Fuente: Brandur Leach, APIs as infrastructure: future-proofing Stripe with versioning (2017).
Expandir, migrar y contraer
Renombrar en un solo paso
El caso más simple de cambio incompatible es cambiar un nombre. Una tabla de
cupones tiene una columna discount, un porcentaje, y el equipo quiere que se
llame percent_off. En SQL es una línea, y es atómica: ALTER TABLE coupons RENAME COLUMN discount TO percent_off. El código cambia en un commit.
El problema es que la línea de SQL y el despliegue del código no ocurren en el mismo instante, y no hay orden que funcione:
- Si primero se cambia la tabla, el código que está corriendo pregunta por una columna que ya no existe, hasta que termine el despliegue.
- Si primero se despliega el código, pregunta por una columna que todavía no existe, hasta que se cambie la tabla.
- Si el despliegue es gradual, durante varios minutos hay instancias de las dos versiones, y con cualquier esquema una de las dos falla.
Error común. Renombrar una columna o un campo en un solo despliegue. Durante los minutos que dura, la mitad del sistema lee un nombre que ya no existe. En el ambiente de desarrollo no se nota, porque ahí hay una sola instancia, se detiene y se inicia, y nadie más lee la tabla.
El ejemplo: cambiar el nombre de una columna
La salida es dejar de pensar en “el cambio” como un paso. Entre el código que
solo conoce discount y el que solo conoce percent_off hace falta una
tercera versión, que conozca las dos.
expand-contract/versions.ts
tiene las tres. La versión antigua es la que está en producción:
export const oldCode: CouponCode = {
  name: 'antigua',
  write: async (client, code, percent) =>
    void (await client.query('INSERT INTO coupons (code, discount) VALUES ($1, $2)', [code, percent])),
  read: (client, code) => one(client, 'SELECT discount AS percent FROM coupons WHERE code = $1', code),
};
La versión puente escribe en las dos columnas y lee la nueva, con la vieja de respaldo:
export const bridgeCode: CouponCode = {
  name: 'puente',
  write: async (client, code, percent) =>
    void (await client.query('INSERT INTO coupons (code, discount, percent_off) VALUES ($1, $2, $2)', [code, percent])),
  read: (client, code) =>
    one(client, 'SELECT coalesce(percent_off, discount) AS percent FROM coupons WHERE code = $1', code),
};
Y la nueva solo nombra percent_off. El esquema también pasa por estados
intermedios. Son tres archivos SQL, en
expand-contract/steps/:
-- 1-expand.sql
ALTER TABLE coupons
    ADD COLUMN percent_off integer CHECK (percent_off BETWEEN 1 AND 100);

-- 2-migrate.sql
UPDATE coupons SET percent_off = discount WHERE percent_off IS NULL;
ALTER TABLE coupons
    ALTER COLUMN percent_off SET NOT NULL,
    ALTER COLUMN discount DROP NOT NULL;

-- 3-contract.sql
ALTER TABLE coupons DROP COLUMN discount;
make expand-contract aplica los pasos uno por uno. Después de cada uno
prueba todas las parejas de versiones: una escribe un cupón y otra lo lee.
Dos versiones pueden correr a la vez sobre un esquema si todas las
combinaciones entre ellas dan bien:
$ make expand-contract

== 0-initial.sql
escribe \ lee antigua     puente      nueva
antigua       bien        no lee      no lee
puente        no escribe  no escribe  no escribe
nueva         no escribe  no escribe  no escribe
  puente: column "percent_off" of relation "coupons" does not exist
  nueva: column "percent_off" of relation "coupons" does not exist
  pueden convivir: antigua

== 1-expand.sql
escribe \ lee antigua     puente      nueva
antigua       bien        bien        lee NULL
puente        bien        bien        bien
nueva         no escribe  no escribe  no escribe
  nueva: null value in column "discount" of relation "coupons" violates not-null constraint
  pueden convivir: antigua y puente

== 2-migrate.sql
escribe \ lee antigua     puente      nueva
antigua       no escribe  no escribe  no escribe
puente        bien        bien        bien
nueva         lee NULL    bien        bien
  antigua: null value in column "percent_off" of relation "coupons" violates not-null constraint
  pueden convivir: puente y nueva

== 3-contract.sql
escribe \ lee antigua     puente      nueva
antigua       no escribe  no escribe  no escribe
puente        no escribe  no escribe  no escribe
nueva         no lee      no lee      bien
  antigua: column "discount" does not exist
  puente: column "discount" does not exist
  pueden convivir: nueva
La última línea de cada bloque cuenta toda la historia:
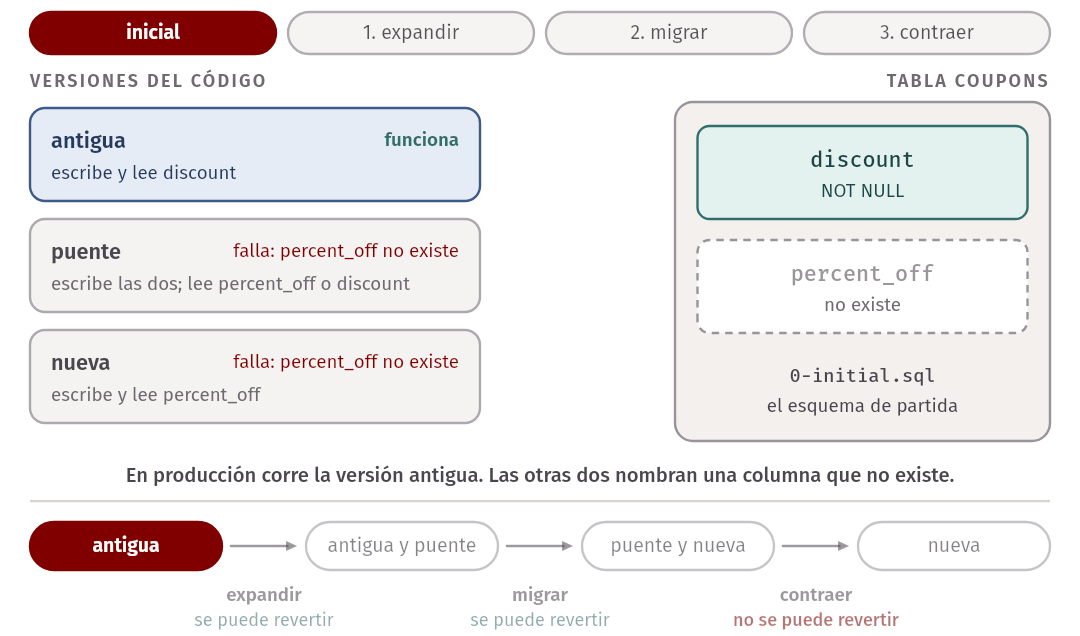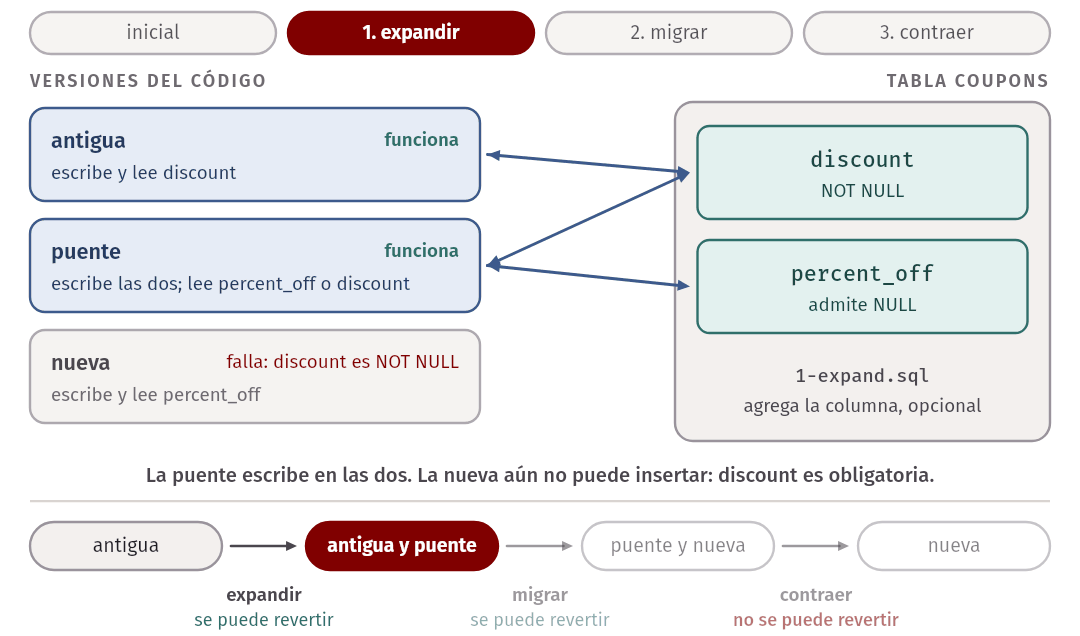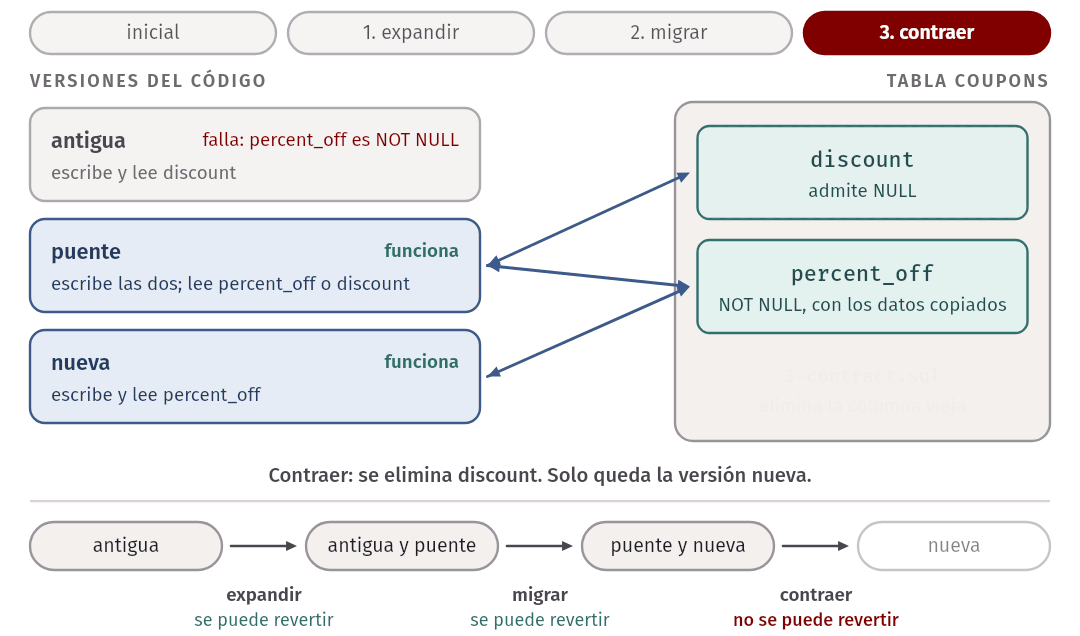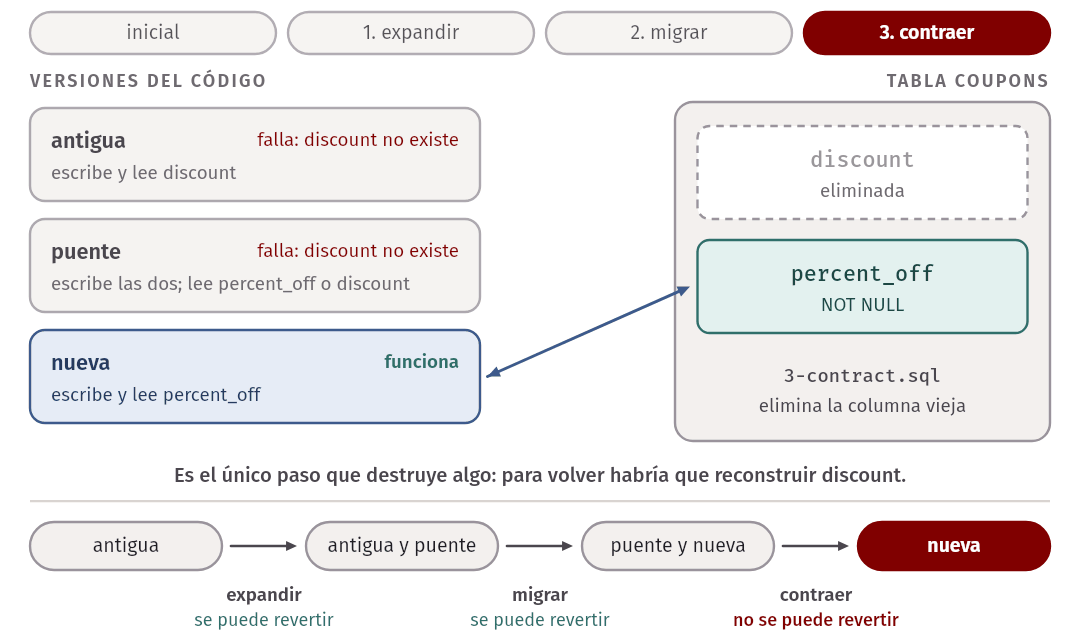
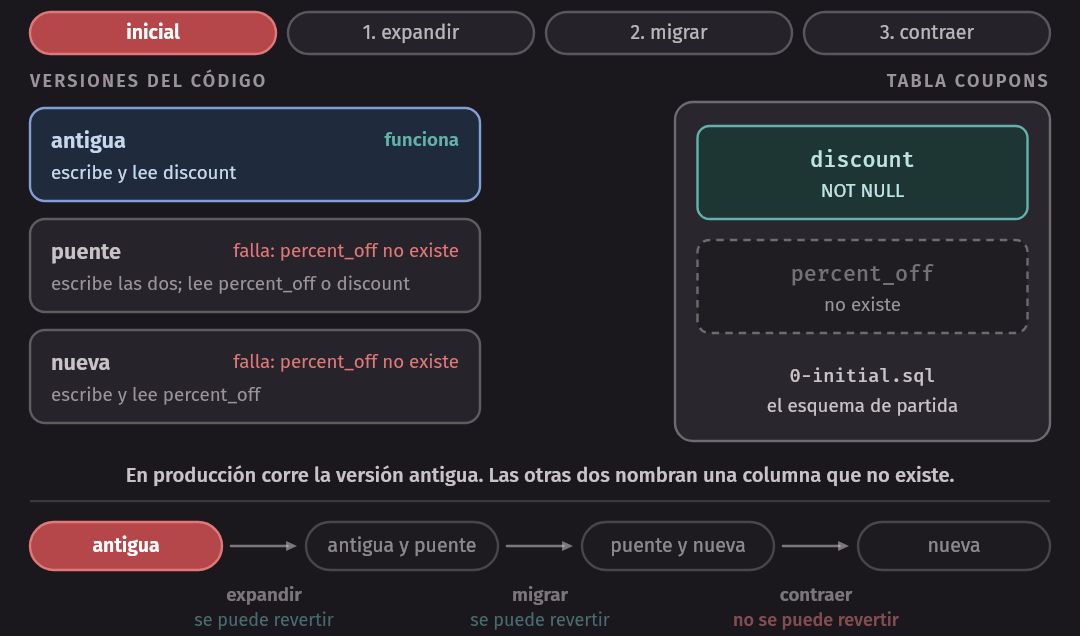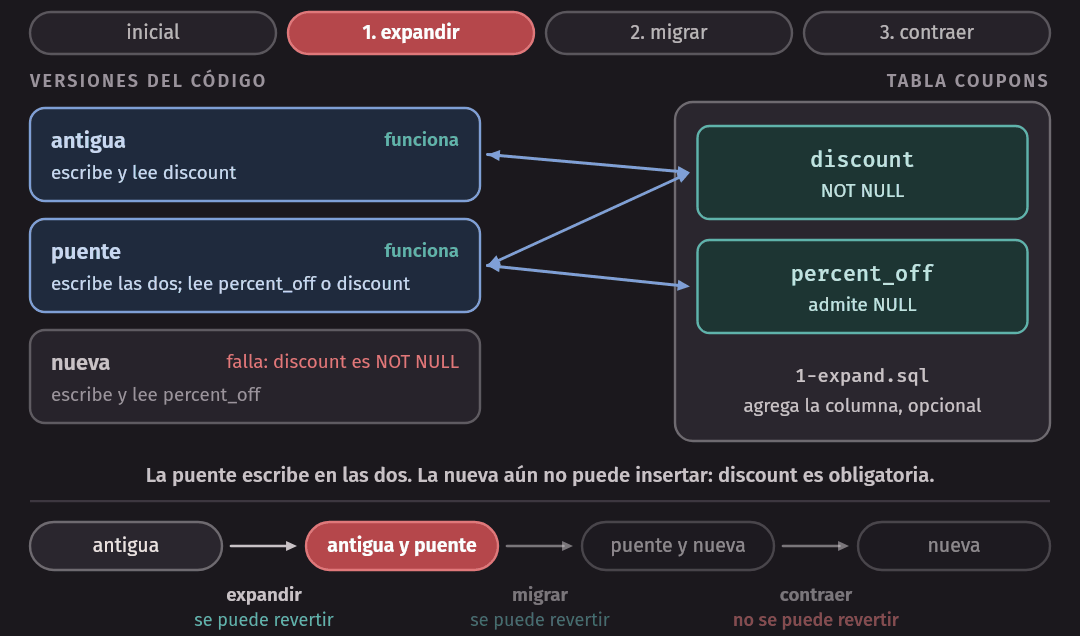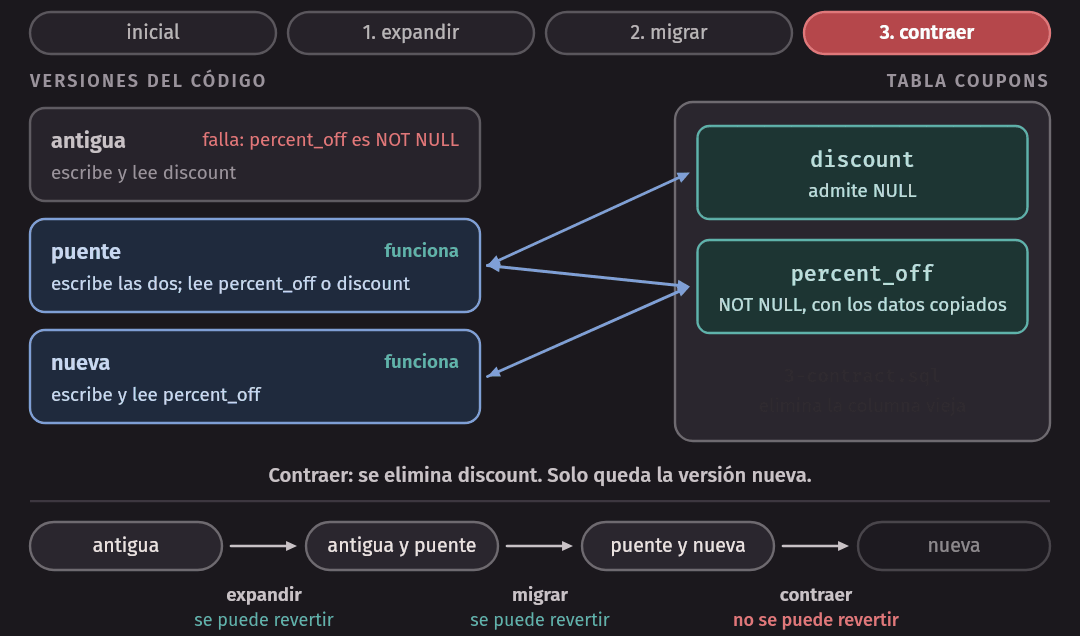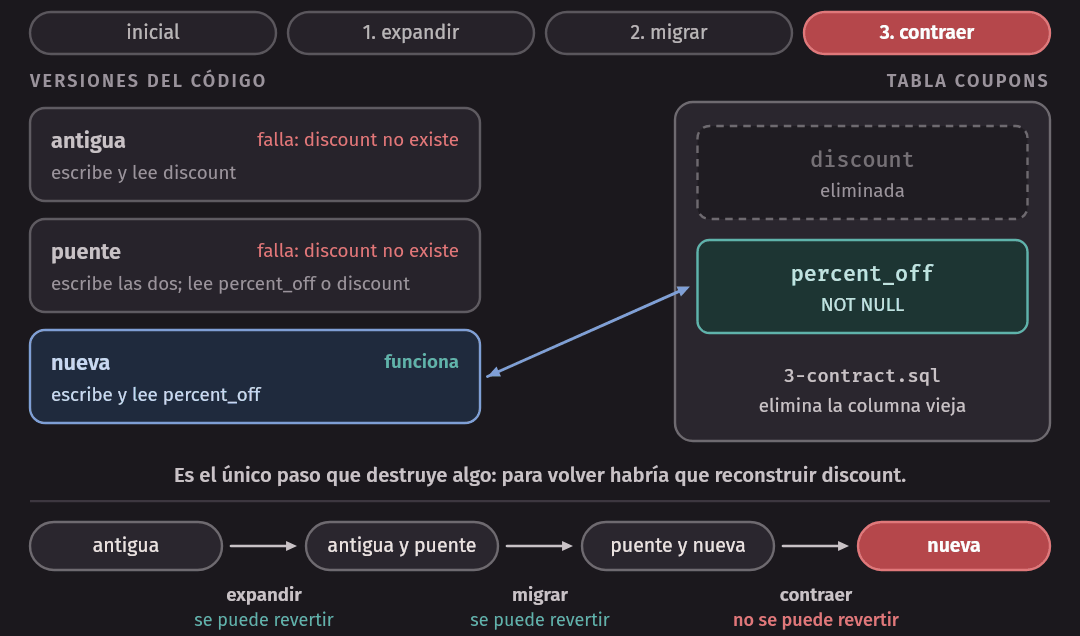
En ningún estado del esquema conviven la antigua y la nueva: por eso el cambio en un paso es imposible. Y en cada estado conviven dos versiones consecutivas: por eso cada paso se puede hacer con un despliegue gradual, y se puede deshacer volviendo a la versión anterior, que sigue funcionando sobre el mismo esquema.
Vale la pena mirar dos celdas. Con la tabla solo expandida, la antigua escribe
y la nueva lee NULL: lo que la versión antigua guarda no llega a la columna
nueva. Por eso la versión puente lee con coalesce, y por eso la copia de
datos de 2-migrate.sql se hace cuando ya no queda ninguna instancia antigua:
si quedara una, seguiría creando filas con percent_off vacío después de la
copia. Y en 2-migrate.sql se intercambian las obligaciones: percent_off
pasa a ser obligatoria y discount deja de serlo. Sin lo segundo, la versión
nueva no podría insertar mientras la columna vieja exista.
Las tres fases y sus condiciones
El patrón se llama cambio en paralelo (parallel change), o expandir y contraer. Sirve para una columna, para un campo de una API, para la firma de una función pública o para un mensaje.
Expandir. Se agrega lo nuevo junto a lo viejo, sin quitar ni cambiar
nada: la columna nueva, el campo nuevo en la respuesta, el campo nuevo
aceptado en la petición. Lo nuevo tiene que ser opcional (una columna que
admite NULL, o con un valor por omisión), porque quienes solo conocen lo
viejo siguen escribiendo. Después se despliega el código que escribe en ambos.
Condición para terminar: todo lo que escribe, escribe en los dos lugares.
Migrar. Se copian los datos antiguos a la forma nueva, y se mueve a quienes leen, uno por uno, de lo viejo a lo nuevo. Es la fase más larga, porque depende de otros: de otro equipo, o de usuarios que tienen que actualizar una aplicación. Condición para terminar: nadie lee ni escribe lo viejo. Saberlo es el problema de Cuándo contraer.
Contraer. Se quita lo viejo: primero del código, después del esquema. Condición para empezar: evidencia, no esperanza, de que nadie lo usa.
Idea clave. Un cambio incompatible se convierte en una secuencia de cambios compatibles. En cada momento, el esquema admite la versión del código que está corriendo y la siguiente; por eso cada paso es un despliegue normal, que se puede revertir.
“Se puede revertir” tiene una excepción, y hay que nombrarla. Expandir se revierte quitando lo que se agregó. Migrar se revierte moviendo a los lectores de regreso. Contraer destruye la columna vieja: se puede volver a crear, pero lo que tenía hay que reconstruirlo desde lo nuevo, si es que se puede. Por eso va al final, por eso exige evidencia, y por eso muchos equipos dejan pasar un tiempo entre que el código deja de usar una columna y que la borran.
En la industria. Stripe describe una migración de este tipo sobre sus suscripciones, que pasaron de vivir dentro de la tabla de clientes a una tabla propia. La presentan como un patrón de cuatro pasos: escribir en las dos tablas para mantenerlas de acuerdo; cambiar todas las lecturas para que usen la tabla nueva; cambiar todas las escrituras para que solo escriban en la nueva; y eliminar los datos que dependían del modelo anterior. Fuente: Jacqueline Xu, Online migrations at scale (2017).
Migrar los datos sin detener a nadie
En la tabla de cupones, copiar los datos fue una línea: UPDATE coupons SET percent_off = discount. Con dos filas no importa cómo se haga. Con una tabla
grande y en uso, importa mucho, por lo que el UPDATE hace mientras corre.
En PostgreSQL, una transacción que modifica una fila la deja bloqueada con un
lock hasta que termina: nadie más puede modificarla ni borrarla. Leerla sí se
puede, porque quien lee ve la versión anterior de la fila. Un UPDATE de toda
la tabla es una transacción que modifica todas las filas, así que
durante todo el tiempo que tarda, cualquier otra escritura sobre una fila que
ya pasó tiene que esperar a que termine.
Un ALTER TABLE es peor. Toma un lock sobre la tabla entera que no deja ni
leer, y lo mantiene hasta el final de su transacción. Si la transacción
contiene solo el ALTER, y el ALTER solo cambia el catálogo, eso dura
milisegundos. Si en la misma transacción va la copia de los datos, dura lo que
dure la copia.
tools/lock-time.ts mide las tres
formas de hacer la migración del laboratorio sobre las 300 000 órdenes.
Mientras corre cada una, una sesión lee órdenes al azar y otra las modifica,
como haría el servicio, y se anota la espera más larga de cada una:
$ make lock-time
300000 órdenes. Durante cada migración, una sesión lee y otra modifica órdenes al azar.

migración                                                      duró   lectura más lenta   escritura más lenta
todo en una transacción (errors/rename-in-one-step.sql)     2311 ms             2311 ms               2309 ms
un UPDATE de toda la tabla                                  2554 ms               10 ms               2500 ms
lotes de 5000 filas (tools/backfill-batches.ts) 2584 ms 26 ms 58 ms- Todo en una transacción. La primera sentencia es un
ALTER TABLE, y su lock dura hasta elCOMMIT: lecturas y escrituras esperaron los 2,3 s completos. Para los usuarios, el servicio estuvo caído ese tiempo. - Un
UPDATEde toda la tabla. Las lecturas no se enteraron. Una escritura esperó 2,5 s, casi todo lo que duró elUPDATE. - Por lotes. La migración tardó lo mismo, y la espera más larga de una escritura fue de 58 ms.
Hicimos la medición cinco veces. Las dos primeras formas hicieron esperar a
alguien entre 2,3 y 6,8 s, según lo ocupada que estaba la máquina; con lotes,
la escritura más lenta estuvo entre 43 y 109 ms en cuatro corridas, y fue de
612 ms en la peor. Con 300 000 filas la diferencia es de segundos contra
decenas de milisegundos. Con 300 millones, el UPDATE único tardaría mil
veces más, y la espera con él; la de los lotes no depende del tamaño de la
tabla, sino del tamaño del lote.
test/locks.test.ts comprueba el mecanismo sin medir tiempos: con un UPDATE
sin confirmar, otra sesión puede leer la fila y no modificarla, y puede
modificar las filas que el UPDATE no tocó, que es la razón por la que los
lotes funcionan. Con un ALTER TABLE sin confirmar, no puede ni leer.
El script por lotes,
tools/backfill-batches.ts, es
corto. A esta copia de datos antiguos hacia la forma nueva se le dice
backfill:
for (let from = first; from <= last; from += options.batchSize) {
  const batchStart = performance.now();
  const updated = await conn.query(
    `UPDATE orders
        SET given_name = ${GIVEN_NAME_SQL}, family_name = ${FAMILY_NAME_SQL}
      WHERE id >= $1 AND id < $2 AND given_name IS NULL`,
    [from, from + options.batchSize],
  );
  …
  if (options.pauseMs > 0) await new Promise((resolve) => setTimeout(resolve, options.pauseMs));
}
Tres decisiones de diseño, todas con su razón:
- Cada lote es su propia transacción. Ningún lock dura más que un lote.
- Se avanza por rangos de la clave primaria, no con
OFFSET: cada lote encuentra sus filas por el índice, sin recorrer las anteriores. - Solo toca las filas que faltan (
given_name IS NULL). Por eso se puede interrumpir y volver a correr, y correr otra vez al final para recoger las filas que alguna instancia antigua escribió mientras tanto.test/backfill.test.tslo interrumpe a la mitad y lo retoma.
Trade-off. Migrar por lotes cambia una espera larga por muchas esperas cortas, y cobra dos cosas. La migración deja de ser atómica: durante minutos u horas la tabla tiene filas migradas y filas sin migrar, y todo el código que lee tiene que funcionar con ambas. Y la migración pasa a ser un programa con estado, que hay que poder detener, retomar y vigilar. La alternativa, una ventana de mantenimiento con el sistema detenido, es más simple y es legítima cuando el negocio la acepta: un sistema interno que nadie usa de madrugada no necesita nada de esto.
Hay un problema que los lotes no resuelven, porque no es de la mecánica sino
de los datos. Partir buyer_name en nombre y apellido es adivinar: el texto
no dice dónde termina uno y empieza el otro. El script usa una regla (la
primera palabra es el nombre) y avisa de cuántas filas son dudosas:
$ make backfill
arq_w09: 300000 filas en 60 lotes de hasta 5000, 1334 ms en total; el lote más largo tardó 28 ms
Nombres de tres o más palabras, donde la regla pudo partir mal: 51686
“Rosa Quispe Mamani” queda bien; “Luz Marina Flores” queda con el apellido “Marina Flores”. Una migración que agrega estructura a datos que no la tenían siempre tiene esta forma, y el plan tiene que decir qué se hace con los casos dudosos: aceptarlos, marcarlos, o pedirle el dato a su owner la próxima vez que entre.
La cola de locks
Expandir con un ALTER TABLE ... ADD COLUMN es rápido en PostgreSQL cuando la
columna admite NULL o tiene un valor por omisión constante: solo cambia el
catálogo, no reescribe la tabla. Otros cambios sí la reescriben entera, con
el lock fuerte tomado todo ese tiempo: cambiar el tipo de una columna de
integer a bigint es el ejemplo habitual. La documentación de ALTER TABLE dice
cuál es cuál.
Pero incluso el ALTER de un milisegundo puede detener un servicio, por cómo
se forman las colas. El ALTER necesita un lock que es incompatible con
todos los demás, incluido el de una simple lectura. Si en ese momento hay una
transacción larga que ya leyó la tabla (un reporte, por ejemplo), el ALTER
espera. Y mientras espera, todas las consultas que llegan después esperan
detrás de él, también las lecturas que con el reporte solo habrían pasado
sin problema. Un reporte de dos minutos más un ALTER de un milisegundo son
dos minutos de servicio detenido.
La tercera prueba de test/locks.test.ts arma esa cola paso por paso: un
reporte con una transacción abierta, un ALTER TABLE que espera, y una
lectura que antes pasaba y ahora no. La defensa es que la migración se rinda
en vez de hacer cola: SET lock_timeout = '2s' antes del ALTER, y si no
consigue el lock en ese tiempo, falla y se reintenta más tarde. Los niveles
de lock y sus conflictos están en la sección Explicit
Locking de la
documentación; las transacciones y sus locks son el tema de la semana 12.
Cuándo contraer
La fase de contraer empieza con una pregunta que parece fácil: ¿alguien usa todavía lo viejo?
Para el código propio se responde buscando. Para el código ajeno hay que medir, y lo primero es admitir un límite: un servicio no puede ver qué campos de una respuesta lee un cliente. Envía el JSON completo y no sabe qué pasa después. Lo que sí puede ver son aproximaciones:
| Qué se mide | Qué dice | Qué no ve |
|---|---|---|
Quién llama (user-agent, clave de API) |
Si siguen llegando peticiones de clientes que se sabe que usan lo viejo | Un cliente desconocido que también lo usa |
| Qué envía el cliente | Si alguien todavía escribe con la forma vieja | A quien solo lee |
| Quién pidió la forma nueva (una cabecera, un parámetro) | A quien la pidió se le deja de enviar lo viejo; todos los demás cuentan como uso | Cuenta de más: quien no pidió nada y tampoco lee el campo |
La tercera es la más segura, porque se equivoca hacia el lado conservador: no puede decir “nadie lo usa” cuando alguien sí. Cuesta que los clientes nuevos tengan que declarar algo.
Con cualquiera de las tres, el número solo vale junto con un plazo. “Cero peticiones” durante una hora no dice nada si hay un cliente que corre una vez al mes. La ventana tiene que cubrir el uso más espaciado que se conozca, y el contador tiene que sobrevivir a los reinicios del servicio.
Y hay consumidores que ningún contador del servicio ve: los que no pasan por el servicio. El proceso de reportes que lee la tabla directamente no aparece en ninguna métrica de la API. Es la consecuencia práctica de El modelo de datos como interfaz: a quien entra por la interfaz se le puede contar; a quien entra por la base de datos hay que ir a buscarlo.
Cuando lo viejo no llega a cero, porque hay una aplicación instalada en celulares que nadie va a actualizar, la decisión deja de ser técnica: mantener el campo viejo para siempre, que es barato si se puede calcular a partir de lo nuevo, o anunciar una fecha y dejar de atender a esa versión. Lo que la arquitectura aporta a esa conversación es el número: cuántos son y cuánto cuesta seguir atendiéndolos.
Lo que cuesta, y las alternativas
Trade-off. Expandir, migrar y contraer compra cero tiempo de inactividad y la posibilidad de revertir cada paso. Lo paga con tiempo (tres o más despliegues, y una espera en el medio que puede durar meses), con código que durante la transición maneja las dos formas, y con una deuda: si nadie hace la contracción, el sistema se queda para siempre con las dos, y con la duda de cuál es la buena.
Las alternativas, y cuándo son razonables:
- Una ventana de mantenimiento. Se detiene todo, se cambia y se inicia. Simple y sin estados intermedios. Exige que el negocio acepte la caída y que todos los consumidores se puedan cambiar a la vez; con un cliente móvil instalado en celulares ajenos, lo segundo es imposible.
- Una versión nueva de la API. Lo visto en Una versión nueva para cada cambio: se justifica cuando las dos formas no pueden convivir en un mismo contrato.
- Sincronizar en la base de datos. En vez de que el código escriba en las dos columnas, un trigger copia de una a la otra. Atrapa a todos los que escriben, incluidas las instancias antiguas y los que no pasan por el servicio. Se paga con lógica que vive fuera del código, donde es fácil olvidarla.
Una advertencia para las semanas que vienen. En el ejemplo, “escribir en
ambos” fue un INSERT con dos columnas: una sola sentencia, atómica. Cuando
lo viejo y lo nuevo están en dos sistemas distintos (dos bases de datos, o una
base de datos y un stream de mensajes), escribir en ambos ya no es atómico:
puede ocurrir una escritura y fallar la otra. Qué hacer entonces es el tema
de la semana 12.
En Tinkuy. La tabla
ordersguarda el nombre del comprador en una sola columna,buyer_name, y el monto entotal_cents, que se entiende en soles porque nada dice otra cosa. La API devuelve lo mismo comobuyer.nameytotalCents. Separar nombre y apellido, o agregar la moneda, son cambios de la misma clase que los de este capítulo, y con el reporte y un cliente antiguo leyendo, ninguno de los dos se puede hacer en un paso. P3 pide un cambio de contrato sobre Tinkuy; el laboratorio de esta semana es el lugar para practicar la secuencia sobre un servicio más pequeño antes de hacerla ahí.
El código de la semana
Todo está en code/week-09/ y se usa dentro del contenedor
del curso. make crea la base de datos arq_w09 con 300 000 órdenes.
| Carpeta | Qué tiene |
|---|---|
orders-v1/ |
El servicio de órdenes, versión 1. No se modifica |
consumers/ |
El cliente móvil antiguo y el proceso de reportes, con sus pruebas. No se modifican |
lab/ |
La copia de trabajo del laboratorio: el servicio, el reporte y las migraciones por escribir |
errors/ |
El cambio en un solo paso, un lector estricto y el cambio de significado de totalCents |
tools/ |
El backfill por lotes y las mediciones (lock-time, oltp-olap, forward) |
expand-contract/ |
El ejemplo resuelto: el cambio de nombre de una columna |
timeline/, models/, formats/ |
Los ejemplos de las líneas de tiempo, los modelos de datos y los formatos |
test/ |
Las pruebas que comprueban lo que afirma el capítulo |
Los comandos están al inicio del Makefile. make test revisa los tipos y
corre las pruebas sobre otra base de datos, arq_w09_test: no toca arq_w09.
$ make test
tsc -p .
…
✔ [orders-v1] el cliente móvil antiguo muestra una orden que ya existía (21.945417ms)
✔ [orders-v1] el cliente móvil antiguo compra y ve su compra (8.907917ms)
✔ [consumers/sales-report.ts] el reporte de marzo de 2026 dice lo mismo de siempre (27.510541ms)
✔ si se interrumpe a la mitad, lo hecho queda hecho (250.487792ms)
…
✔ en cada estado del esquema conviven dos versiones consecutivas del código, nunca la primera con la última (97.924542ms)
…
✔ un UPDATE sin confirmar deja leer la fila, pero no modificarla (339.424584ms)
✔ un ALTER TABLE sin confirmar no deja ni leer (308.119709ms)
…
ℹ tests 31
ℹ suites 0
ℹ pass 31
ℹ fail 0
Cada prueba lleva en el nombre la afirmación del capítulo que comprueba. Las
primeras dicen entre corchetes contra qué versión corrieron: en el laboratorio
van a correr las mismas contra su copia, con make consumers S=lab.
Laboratorio: cambiar un contrato sin romper a quien lo usa
El laboratorio se hace en parejas, con el material de
code/week-09/. El cambio pedido tiene dos partes: separar
buyer_name en given_name y family_name, y agregar currency a los
montos. Se trabaja sobre lab/; orders-v1/ y consumers/ no se tocan,
porque representan código que no controlan. Al terminar deben tener el cambio
hecho, las pruebas de los consumidores pasando en cada paso intermedio, y
escritas las decisiones que tomaron en el camino.
Paso 1: el caso. Corran make y make test. Lean
orders-v1/server.ts, consumers/mobile-client.ts y
consumers/sales-report.ts, y levanten el servicio con make start para
probarlo desde otra terminal (node consumers/mobile-client.ts show 1,
make report). Lo que deben poder responder: ¿por dónde entra cada
consumidor, y de qué nombres exactos depende cada uno?
Paso 2: clasificar. Antes de escribir nada, llenen
lab/compatibility-table.md:
para cada parte del cambio, en la API y en la tabla, si es compatible hacia
atrás, hacia adelante, ambas o ninguna. Este paso muestra que “el cambio” son
una decena de cambios, y que no todos son del mismo tipo.
Paso 3: hacerlo mal. Apliquen errors/rename-in-one-step.sql con psql
y corran make consumers. Anoten qué prueba falla, con qué mensaje, y cuál
de los dos consumidores da el mensaje más útil. Deshagan con
errors/undo-rename-in-one-step.sql o con make db. Este paso muestra cómo
se ve, desde cada consumidor, un cambio incompatible.
Paso 4: expandir. Primero la tabla: escriban
lab/migrations/01-expand.sql, aplíquenlo, y comprueben con make consumers
que orders-v1 y los dos consumidores no notaron nada. Después el servicio:
modifiquen lab/orders/ para que acepte y devuelva los campos nuevos sin
dejar los viejos, y escriba en ambos. make consumers S=lab debe pasar sin
haber tocado las pruebas. Piensen qué necesita cada columna nueva para que
orders-v1, que no la conoce, pueda seguir insertando.
Paso 5: migrar. Llenen las filas antiguas con make backfill, y corran
make lock-time para ver cuánto hace esperar cada forma de hacerlo. Muevan
lab/sales-report.ts a las columnas nuevas: su prueba no cambia, así que el
reporte tiene que seguir diciendo lo mismo. Decidan qué hace el reporte con
la moneda. Escriban lab/migrations/02-migrate.sql. Este paso muestra que
migrar tiene dos mitades, los datos y los lectores, y que la segunda no
depende de ustedes.
Paso 6: el cliente que no se actualiza. Decidan cuánto tiempo se mantiene el campo viejo y cómo sabrían que ya nadie lo usa, y agreguen al servicio un contador de las peticiones que todavía dependen de él. Escriban qué cuenta exactamente el contador y qué uso no vería.
Paso 7: contraer. Cuando el contador esté en cero (en el laboratorio,
dejando de correr el cliente antiguo), quiten lo viejo: del servicio y, con
lab/migrations/03-contract.sql, de la tabla. Corran todo. Algunas pruebas
de consumers/ van a fallar: digan cuáles, y por qué en este punto eso es lo
esperado y no un error.
Paso 8: hacia adelante. make forward le envía a orders-v1, sin
modificar, órdenes con la forma que escribe el servicio nuevo. Respondan con
la salida a la vista: ¿las acepta?, ¿conserva los campos que no conoce al
devolverlas?, ¿qué hizo con el currency de la primera orden, y avisó? Y expliquen
por qué importa durante un despliegue gradual, en el que orders-v1 y su
versión nueva atienden a la vez.
Resumen
- El código sin estado se reemplaza, se copia y se descarta; los datos no, y viven más que el código que los escribió. Por eso las decisiones sobre datos son las que más cuesta deshacer.
- Transaccional (muchas operaciones pequeñas, por clave; importa la latencia) y analítico (pocas consultas que recorren todo; importa el throughput) compiten por los mismos recursos cuando comparten base de datos. En la medición de la semana, con el procesador saturado por reportes, el throughput de las lecturas por clave cayó a menos de la sexta parte y el p99 se multiplicó por más de diez, mientras el p50 casi no se movió.
- Cada dato tiene un sistema de registro; lo demás son datos derivados, que se pueden reconstruir. Saber cuál es cuál decide qué se puede perder y a quién se le cree.
- Distribuir los datos se justifica por tolerancia a fallas, por escala o por cercanía, y cobra fallas parciales, datos atrasados y protocolos en lugar de transacciones. Un servicio administrado cobra control y portabilidad a cambio de no operar.
- La escalabilidad es una pregunta sobre una carga descrita con parámetros. Calcular al leer o al escribir mueve el trabajo de una operación a la otra; el caso extremo (la cuenta con diez mil seguidores, el evento que concentra todas las ventas) es el que rompe la opción que servía para los demás.
- El modelo de datos se elige por los patrones de acceso. “Sin esquema” quiere decir esquema al leer. Si otros leen las tablas, el esquema es un contrato público.
- Hacia atrás: lo nuevo lee lo que escribió lo viejo. Hacia adelante: lo viejo lee lo que escribió lo nuevo, sin fallar y sin destruir lo que no conoce. La segunda es la que hace posible un despliegue gradual y un rollback.
- En una API es compatible exigir menos y prometer más. Un cambio puede ser compatible en la forma e incompatible en el significado, y ese no produce ningún error.
- Expandir, migrar y contraer convierte un cambio incompatible en una secuencia de cambios compatibles: en cada estado conviven dos versiones consecutivas del código. Los datos se migran por lotes, y se contrae con evidencia de que nadie usa lo viejo.
Ejercicios
-
Clasifiquen como transaccional o analítica cada consulta de la API de Tinkuy (la tabla de rutas de su README). Para las que consideren analíticas, digan qué tan viejo podría ser el dato que devuelven sin que su usuario lo note, y qué opción de Separarlos: de menos a más costo permitiría eso.
-
Corran
make oltp-olapconANALYTIC=1,ANALYTIC=4,ANALYTIC=14yANALYTIC=40, dos veces cada uno. Hagan una tabla con el throughput y el p99 de las lecturas porid. ¿A partir de qué valor el efecto es mayor que la diferencia entre dos corridas iguales? ¿Qué relación tiene ese valor con el número de núcleos de su máquina (nproc)? -
Un sistema de préstamos de una biblioteca tiene: la tabla de préstamos en PostgreSQL, un contador de “libros prestados hoy” en Redis, un índice de búsqueda del catálogo, y una hoja de cálculo donde la bibliotecaria corrige a mano las multas. Clasifiquen cada uno como sistema de registro o dato derivado, digan qué pasa si se pierde, y encuentren el que está mal clasificado en la práctica aunque nadie lo haya decidido.
-
En
make timeline, cambien el número de usuarios (USERS=2000yUSERS=20000). ¿Cómo cambia el costo de publicar desde la cuenta 1 con fan-out? Escriban la relación con una fórmula. Después propongan un umbral de seguidores a partir del cual una cuenta debería dejar de repartir al escribir, y digan qué dato de carga necesitarían para defenderlo. -
Para la disponibilidad de un evento en Tinkuy, escriban el ADR de la decisión entre contar en cada lectura y mantener el número al vender: contexto (con los parámetros de carga), las dos opciones, y las consecuencias de cada una. No escriban código. ¿Qué medirían antes de decidir?
-
Un taller mecánico guarda fichas de vehículos. Cada ficha tiene los datos del vehículo, una lista de órdenes de trabajo, y cada orden una lista de repuestos usados. Las consultas frecuentes son “abre la ficha de este vehículo” y “¿en qué vehículos se instaló este repuesto en el último mes?”. Digan qué modelo hace fácil cada una, qué dato quedaría copiado en el modelo de documentos, y si esa copia es un defecto o un hecho histórico.
-
Para cada cambio, digan si es compatible hacia atrás, hacia adelante, ambas o ninguna, y quién lo notaría: (a) la respuesta de
GET /orders/:idagregapaidAt; (b)POST /ordersempieza a exigirphone; (c)totalCentspasa de número a texto; (d)statusempieza a devolver también'refunded'; (e) la lista de órdenes pasa a ordenarse por fecha en vez de porid. Para (d) y (e), relacionen su respuesta con el lector tolerante y con la ley de Hyrum. -
Modifiquen una copia de
formats/tagged.tspara que el esquema v2 quite el campobuyerName. Muestren con una prueba qué lee un lector v1 de un mensaje v2, y qué pasa si, un año después, alguien define un campo nuevo con la etiqueta 2 y tipo entero. ¿Qué mecanismo de Protocol Buffers existe para impedir lo segundo? -
Una tabla
paymentsrecibe escrituras todo el día y su columnaidesinteger; se va a quedar sin números. Escriban los pasos para pasarla abigintsin detener el servicio: qué se agrega, quién escribe en qué durante la transición, cómo se copian los datos, y cuál es el paso que no se puede deshacer. Indiquen en qué pasos usaríanlock_timeouty por qué. -
El backfill del laboratorio parte “Luz Marina Flores” en nombre “Luz” y apellido “Marina Flores”. Propongan dos maneras de tratar las 51 686 filas dudosas, una que no requiera a ninguna persona y otra que sí, con lo que cuesta cada una. ¿Cambia su respuesta si el nombre se usa solo para saludar en un correo, o si se imprime en un comprobante?
-
Un equipo dice: “mantenemos
/v1y/v2de la API, así nunca rompemos a nadie”. Tienen 40 endpoints, tres clientes propios y unos 200 clientes externos. Escriban qué les preguntarían para saber si esa decisión les conviene, y describan cómo se vería el mismo cambio que motivó/v2hecho con expandir, migrar y contraer. ¿Para qué clase de cambio le darían la razón al equipo?