Apuntes · Capítulo 10Datos y sistemas distribuidos
Replicación
Replicación
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): Para qué se replica completo; de Replicación con un líder, La forma y Una réplica en el contenedor; de Síncrona y asíncrona, Qué espera el líder antes de responder; de Las anomalías del retraso y sus garantías, No leer lo que uno escribió; y de Sin líder, Quórums y El argumento del solapamiento.
- En clase: Sesión A: Para qué se replica, Replicación con un líder, Síncrona y asíncrona, El retraso de replicación, Las anomalías del retraso y sus garantías, Una réplica no es un respaldo y Failover. Sesión B: Varios líderes, Sin líder, Dynamo: una arquitectura derivada de un escenario y Cómo se elige. Laboratorio: Laboratorio: una réplica de PostgreSQL.
- Después de clase: el Resumen y los Ejercicios. Antes de entregar P3, relean Read-your-writes, de tres maneras y Qué lectura va a dónde. Opcionales: Agregar un seguidor sin detener al líder, Síncrona no es read-your-writes, Versiones en vez de relojes y El código de la semana.
La semana pasada dijimos que los datos son la parte de una arquitectura que más cuesta cambiar, y dejamos planteada una decisión sin entrar en ella: un nodo o muchos. Tener los datos en una sola máquina es lo más simple de razonar, y tiene tres límites: si esa máquina falla, el sistema se detiene; todas las lecturas compiten por ella; y queda lejos de alguien. La respuesta a los tres es la misma, replicar: mantener los mismos datos en varias máquinas.
Dicho así parece un asunto de operación, algo que se le encarga a quien administra la base de datos. No lo es. Apenas hay dos copias, las copias pueden no estar de acuerdo, y cuánto desacuerdo se tolera, quién lo ve y qué se pierde cuando una máquina falla son decisiones que cambian lo que el sistema le promete a sus usuarios. Un comprador que paga una entrada y no la ve en “mis compras” no está frente a un problema de operación: está frente a una decisión de arquitectura que alguien tomó sin saberlo.
El capítulo sigue las dos sesiones. En la primera estudiamos la forma más común, la replicación con un líder: cómo viaja un cambio, qué diferencia hay entre esperar al seguidor (síncrona) y no esperarlo (asíncrona), qué anomalías produce el retraso de replicación y qué pasa cuando el líder falla y hay que hacer failover. Todo eso lo van a ver con dos servidores PostgreSQL dentro del contenedor del curso. En la segunda sesión vemos las otras dos formas, varios líderes y sin líder, con sus conflictos y sus quórums. PostgreSQL no trabaja así, de modo que para esa parte usamos un simulador pequeño, escrito para la clase, donde cada afirmación del capítulo es una prueba que pueden correr.
Las palabras de esta semana: usamos líder y seguidor para los roles en general. PostgreSQL llama primary al líder y standby al seguidor, y los comandos del curso dicen principal y réplica; cuando hablamos de los dos servidores del contenedor usamos esos nombres. Una réplica, a secas, es cualquiera de las copias.
Lectura. Sesión A: Kleppmann y Riccomini, Designing Data-Intensive Applications (2.ª ed.), cap. 6 Replication: la introducción, Single-Leader Replication y la sección sobre los problemas del retraso de replicación; Martin Kleppmann, apuntes de sistemas distribuidos de Cambridge, sección 5, Replication. Complementarias: documentación de PostgreSQL 18, High Availability, Load Balancing, and Replication y Log-Shipping Standby Servers; Unmesh Joshi, Leader and Followers; GitHub, October 21 post-incident analysis (2018). Sesión B: Designing Data-Intensive Applications (2.ª ed.), cap. 6: Multi-Leader Replication y Leaderless Replication; DeCandia y otros, Dynamo: Amazon’s Highly Available Key-value Store (2007), secciones 1, 2 y 4. Complementarias: Unmesh Joshi, Majority Quorum; apuntes de Cambridge, sección 5.2, sobre quórums. El código de la semana está en code/week-10/.
Para qué se replica
Tres razones, tres escenarios
Replicar es mantener una copia de los mismos datos en varias máquinas conectadas por una red. Hay tres razones para hacerlo, y conviene escribir cada una como lo que es, un escenario de calidad con su medida (semana 2):
| Razón | Atributo | Un escenario para un sistema de venta de entradas |
|---|---|---|
| Seguir funcionando si una máquina falla | Disponibilidad | El servidor de base de datos se apaga durante una venta; en menos de 60 segundos el sistema vuelve a aceptar compras y no se pierde ninguna compra confirmada |
| Atender más lecturas | Rendimiento, escalabilidad | Con 2 000 personas mirando el catálogo mientras se abre una venta, GET /events responde con p95 menor a 300 ms sin que las compras se vuelvan más lentas |
| Tener los datos cerca de quien los usa | Latencia | Un comprador en Arequipa y otro en Madrid ven el mapa de asientos en menos de 200 ms |
Las tres razones no piden lo mismo. La primera necesita que la copia esté al día en el momento de la falla: una copia atrasada es una copia a la que le faltan compras. La segunda necesita muchas copias que respondan rápido, y tolera que estén un poco atrasadas. La tercera necesita copias repartidas por el mundo, donde la red entre ellas es lenta y a veces se corta. Un diseño de replicación que sirve para una puede ser malo para otra, y por eso la primera pregunta ante “pongamos una réplica” es para cuál de las tres.
Replicar no es lo mismo que hacer sharding. Replicar copia los mismos datos en varias máquinas; hacer sharding reparte datos distintos entre máquinas, porque no caben en una. Se combinan (cada shard tiene sus réplicas), pero son decisiones separadas. El sharding es el tema de la próxima semana.
Por qué es difícil
Si los datos no cambiaran nunca, replicar sería trivial: se copian una vez y listo. Toda la dificultad está en propagar los cambios. Cada escritura tiene que llegar a todas las copias, por una red que demora los mensajes, los pierde y a veces se corta, y hacia máquinas que pueden estar caídas cuando el cambio sale. Mientras el cambio viaja, hay copias que lo tienen y copias que no, y alguien puede estar leyendo de cualquiera de ellas.
De ahí salen las tres preguntas que ordenan el capítulo: quién acepta escrituras (un líder, varios o cualquiera), cuándo se le responde “listo” a quien escribió (con el cambio en un nodo o en varios) y qué ve quien lee de una copia que todavía no recibió el cambio.
Idea clave. Replicar no agrega una garantía; cambia unas por otras. Con una sola copia, lo que se escribió es lo que se lee. Con varias, eso deja de ser gratis: se paga con latencia en las escrituras, con disponibilidad cuando un nodo falla o con lecturas que muestran el pasado. Cada forma de replicar es una elección de cuál de las tres cosas se paga.
Replicación con un líder
La forma
En la replicación con un líder (single-leader replication) uno de los nodos, el líder, es el único que acepta escrituras. Cada vez que cambia sus datos, le envía el cambio a los demás nodos, los seguidores, que lo aplican en el mismo orden en que el líder lo hizo. Las lecturas pueden ir al líder o a cualquier seguidor.
Las dos propiedades que importan salen de esa descripción:
- Hay un solo orden de las escrituras, el del líder. Dos compras del mismo asiento llegan al mismo nodo, una antes que la otra, y ese nodo decide. No existe el caso de dos escrituras aceptadas en lugares distintos que después haya que reconciliar. Es la razón principal por la que esta forma es la más usada: conserva las transacciones y las restricciones tal como se conocen en una sola máquina.
- Los seguidores van detrás. Aplican lo que el líder ya hizo, de modo que lo que tienen es el estado del líder en algún momento del pasado, cercano o no.
Es lo que hacen PostgreSQL, MySQL y la mayoría de las bases de datos relacionales, y también varios sistemas que no lo son: el mismo esquema sirve para cualquier almacén que pueda escribir sus cambios como una secuencia.
Lo que esta forma no da: capacidad de escritura. Todas las escrituras siguen pasando por una máquina. Agregar seguidores multiplica las lecturas que el sistema atiende, no las escrituras.
Cómo viaja el cambio: el WAL
¿Qué le envía exactamente el líder a sus seguidores? Podría enviar las
sentencias SQL para que cada seguidor las repita, pero una sentencia como
UPDATE ... SET created_at = now() no da el mismo resultado en dos máquinas.
PostgreSQL envía algo más bajo: su WAL (write-ahead log), el log de
escritura anticipada.
El WAL existe aunque no haya réplicas. Antes de modificar una página de datos, PostgreSQL escribe en el WAL un registro que describe el cambio, y solo cuando ese registro está en disco considera que la transacción quedó confirmada. Si el servidor se cae, al arrancar vuelve a aplicar el WAL y recupera todo lo confirmado. La replicación aprovecha que ese log ya existe: un seguidor es un servidor que está permanentemente recuperándose, aplicando el WAL de otro a medida que llega.
Cada posición del WAL tiene un número, el LSN (log sequence number), que
PostgreSQL muestra como dos números en hexadecimal separados por una barra,
por ejemplo 0/2E009C78. Los LSN solo crecen. Con ellos se puede decir con
precisión dónde va cada servidor: el líder escribió hasta tal LSN, el seguidor
recibió hasta tal otro y aplicó hasta un tercero.
En PostgreSQL esta forma de replicar se llama replicación por streaming: el seguidor mantiene una conexión abierta con el líder y recibe el WAL en continuo, registro por registro. Como lo que viaja son cambios a páginas de disco, el seguidor es una copia física: tiene exactamente las mismas bases de datos, tablas e índices, byte por byte, y solo acepta lecturas. No se puede crear en él una tabla ni un índice que el líder no tenga.
Una réplica en el contenedor
El contenedor del curso arranca con un servidor PostgreSQL en el puerto 5432.
El comando pg-replica create (lo describe labs/README.md)
levanta un segundo servidor en el puerto 5433 que sigue al primero. En la
carpeta de la semana, make crea la base de datos arq_w10 con el esquema del
capítulo y, después, la réplica:
$ make
Base de datos arq_w10 recién creada en el principal.
Réplica lista en el puerto 5433 (psql -p 5433).
El esquema es el más pequeño que alcanza para ver la replicación
(db/schema.sql): una tabla orders con las
órdenes de compra (id, buyer, seat, created_at) y dos tablas
auxiliares que usaremos en el failover.
Ahora hay dos servidores. ¿Quién es quién? La función pg_is_in_recovery()
responde si el servidor está aplicando el WAL de otro:
$ psql -c "SELECT pg_is_in_recovery()"
 pg_is_in_recovery
-------------------
 f
(1 row)

$ psql -p 5433 -c "SELECT pg_is_in_recovery()"
 pg_is_in_recovery
-------------------
 t
(1 row)
El del puerto 5432 no está en recuperación: es el principal. El del 5433 sí: es la réplica. Si intentan escribir en ella:
$ psql -p 5433 -d arq_w10 -c "INSERT INTO orders (buyer, seat) VALUES ('rosa.quispe@correo.pe', 'A-1')"
ERROR:  cannot execute INSERT in a read-only transaction
No es un permiso que falte. La réplica no puede aceptar esa fila porque no tendría cómo hacerla llegar al principal ni en qué posición del orden ponerla. En cambio, lo que se escribe en el principal aparece en la réplica sin que nadie haga nada:
$ psql -d arq_w10 -c "INSERT INTO orders (buyer, seat) VALUES ('rosa.quispe@correo.pe', 'A-1')"
INSERT 0 1
$ psql -p 5433 -d arq_w10 -c "SELECT id, buyer, seat FROM orders"
 id |         buyer         | seat
----+-----------------------+------
  1 | rosa.quispe@correo.pe | A-1
(1 row)
La base de datos y la tabla se crearon en el principal antes de que la réplica existiera, y están en ella. La siguiente sección explica por qué.
Agregar un seguidor sin detener al líder
Un seguidor nuevo empieza vacío, y el líder no puede detenerse a esperarlo. El procedimiento es siempre el mismo, en cualquier base de datos:
- Tomar una copia consistente de los datos del líder, un snapshot, sin bloquear las escrituras, y anotar a qué posición del log corresponde.
- Llevar esa copia al nodo nuevo.
- El nodo nuevo se conecta al líder y pide todo el log desde esa posición. Cuando termina de aplicarlo, se dice que alcanzó al líder, y a partir de ahí sigue recibiendo los cambios a medida que ocurren.
Es exactamente lo que hace pg-replica create. Esta es su línea central
(env/pg-replica):
gosu postgres pg_basebackup -D "$DIR" -R -X stream -C -S replica_1 -c fastpg_basebackup copia todos los archivos del principal mientras sigue
atendiendo escrituras (paso 1 y 2), y -X stream trae además el WAL que se
genera durante la copia, para que el resultado sea consistente. La opción -R
deja escrito en la copia cómo seguir al principal (paso 3), en el directorio
de la réplica (/var/lib/postgresql/replica).
Dos cosas convierten a ese directorio en una réplica. El archivo vacío
standby.signal le dice a PostgreSQL que, al arrancar, no termine la
recuperación: que se quede aplicando WAL. Y primary_conninfo le dice de
dónde pedirlo.
Queda un problema: el principal borra el WAL viejo que ya no necesita. Si la
réplica se desconecta un rato y al volver pide un tramo que el principal ya
borró, no puede continuar y hay que crearla de nuevo. Para eso sirven las
opciones -C -S replica_1, que crean en el principal un slot de
replicación: un registro de hasta dónde llegó este seguidor, que le impide
al principal borrar el WAL que todavía no le entregó.
Trade-off. Un slot garantiza que el seguidor siempre pueda ponerse al día, y lo paga el disco del líder: si el seguidor desaparece y nadie borra el slot, el líder guarda WAL indefinidamente hasta quedarse sin espacio, y ahí se detiene él también. La alternativa, sin slot, protege al líder y acepta que un seguidor que estuvo desconectado demasiado tiempo haya que reconstruirlo. Quien pone un slot tiene que vigilar el WAL retenido.
Mirar la replicación desde el principal
El principal sabe quién lo sigue y por dónde va. La vista
pg_stat_replication tiene una fila por seguidor conectado:
$ psql -x -c "SELECT application_name, state, sent_lsn, write_lsn, flush_lsn, replay_lsn,
                     write_lag, flush_lag, replay_lag, sync_state FROM pg_stat_replication"
-[ RECORD 1 ]----+----------------
application_name | walreceiver
state            | streaming
sent_lsn         | 0/2E009C78
write_lsn        | 0/2E009C78
flush_lsn        | 0/2E009C78
replay_lsn       | 0/2E009C78
write_lag        | 00:00:00.035769
flush_lag        | 00:00:00.036359
replay_lag       | 00:00:00.036509
sync_state       | async
Las cuatro posiciones cuentan el viaje de un cambio, en orden:
| Columna | Hasta dónde… | Qué significa si el principal muere ahora |
|---|---|---|
sent_lsn |
envió el principal | Nada todavía: puede no haber llegado |
write_lsn |
recibió la réplica y lo escribió | Lo tiene el sistema operativo de la réplica |
flush_lsn |
lo tiene la réplica en disco | Sobrevive aunque la réplica también se reinicie |
replay_lsn |
aplicó la réplica | Una lectura en la réplica ya lo ve |
Aquí las cuatro son iguales: la réplica está al día. Las columnas *_lag
dicen cuánto tiempo pasó entre que el principal confirmó la última escritura y
la réplica informó haberla escrito, guardado y aplicado. La última columna,
sync_state, dice que esta réplica es asíncrona; es el tema de la sección
siguiente.
El comando pg-replica lag (o make lag) resume lo mismo en una línea: los
bytes de WAL que a la réplica le falta aplicar (bytes_pendientes) y el
replay_lag. La réplica también puede decir por dónde va ella, con
pg_last_wal_receive_lsn() (lo último que recibió) y
pg_last_wal_replay_lsn() (lo último que aplicó).
Error común. Medir el retraso solo con
replay_lag. Esa columna mide cuánto tardó en aplicarse lo último que se aplicó; si no hay escrituras nuevas, se queda mostrando el valor anterior, y si la réplica dejó de recibir, no dice nada de lo que está pendiente. Para saber cuánto falta se miran los bytes (pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn)), y para saber si la réplica está viva, que la fila exista y esté enstreaming.
Síncrona y asíncrona
Qué espera el líder antes de responder
Un comprador paga una entrada. La aplicación le envía el INSERT al líder, el
líder lo escribe en su WAL y lo envía al seguidor. ¿En qué momento le responde
“confirmado” a la aplicación? Hay dos respuestas, y la diferencia entre ellas
es la decisión más importante de la replicación con un líder.
Asíncrona: el líder responde apenas el cambio está en su disco, sin esperar al seguidor. El envío al seguidor ocurre en paralelo.
Síncrona: el líder espera a que el seguidor confirme que recibió el cambio y lo guardó, y recién entonces responde.
Lo que cada una garantiza se ve mejor preguntando qué pasa si el líder muere un instante después de responder:
| Asíncrona | Síncrona | |
|---|---|---|
| El líder responde cuando… | el cambio está en su disco | además está en el disco del seguidor |
| Si el líder muere después de confirmar | el seguidor puede no tenerlo: una escritura confirmada se pierde | el seguidor lo tiene: nada confirmado se pierde |
| Latencia de cada escritura | la del líder | la del líder más la ida y vuelta al seguidor y su disco |
| Si el seguidor no responde | el líder sigue como si nada | las escrituras se detienen |
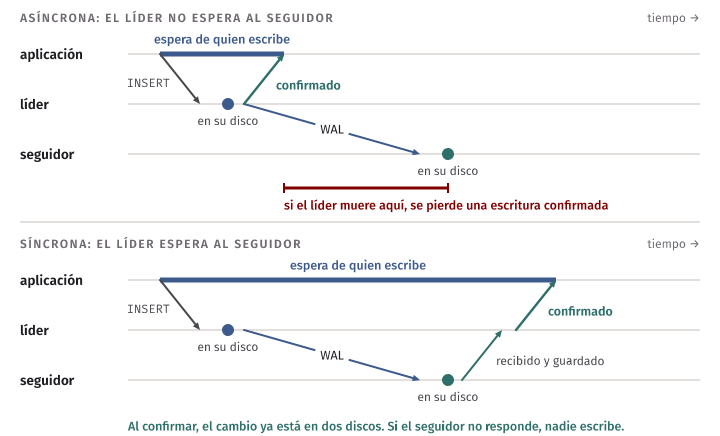
La síncrona le da a “confirmado” su significado completo, y a cambio ata la disponibilidad de las escrituras a la del seguidor: dos máquinas tienen que estar bien para escribir, en vez de una.
En PostgreSQL, una réplica es asíncrona salvo que el principal diga lo
contrario. Se le dice con el parámetro synchronous_standby_names, que lista
los nombres de las réplicas a las que hay que esperar. La réplica de
pg-replica se presenta con el nombre walreceiver (es la columna
application_name de pg_stat_replication), así que make sync-on ejecuta en
el principal ALTER SYSTEM SET synchronous_standby_names = 'walreceiver' y
recarga la configuración. Después, pg-replica lag muestra sync en la
columna sync_state, donde antes decía async. make sync-off lo deshace.
Lo que cuesta la síncrona, medido
El programa replication/burst.ts
(make burst) escribe una ráfaga de órdenes en el principal y mide, desde el
lado de quien escribe, cuánto tardó cada INSERT en confirmarse. Con una sola
conexión que escribe mil órdenes, una después de otra, primero asíncrona
(después de make sync-off):
$ CLIENTS=1 WRITES=1000 make burst
réplica: async
1000 escrituras con 1 conexión en 1730,27 ms
latencia de escritura: p50 1,16 ms, p95 5,00 ms, p99 8,94 ms
WAL pendiente de aplicar en la réplica, máximo visto: 624 bytes
la última orden apareció en la réplica 1,64 ms después de confirmada
Y lo mismo síncrona (después de make sync-on): 2 950,87 ms en total, con p50
de 2,30 ms. Repetimos el par tres veces, alternando:
| Corrida | Asíncrona, p50 | Síncrona, p50 | Asíncrona, total | Síncrona, total |
|---|---|---|---|---|
| 1 | 1,16 ms | 2,30 ms | 1 730 ms | 2 951 ms |
| 2 | 0,90 ms | 1,26 ms | 1 421 ms | 1 739 ms |
| 3 | 1,30 ms | 1,85 ms | 1 946 ms | 2 329 ms |
Las mediciones son de una laptop con Apple Silicon, dentro de Docker, con otras cargas corriendo a la vez, y por eso varían tanto de una corrida a otra. Lo que se sostiene en las tres es el sentido: la escritura síncrona tardó más que la asíncrona, entre 1,4 y 2 veces en la mediana (el cociente de las dos columnas de p50). La razón es que cada confirmación ahora incluye un viaje al seguidor y una escritura en su disco.
Esa diferencia es la mínima posible. Aquí el principal y la réplica están en la misma máquina y se hablan por un socket local, sin red de por medio. Con la réplica en otro centro de datos, cada escritura pagaría la ida y vuelta entre los dos, que son decenas de milisegundos entre ciudades. Por eso la replicación síncrona entre regiones lejanas es rara, y por eso la primera razón para replicar (no perder nada) y la tercera (estar cerca de todos) tiran en direcciones opuestas.
Cuando el seguidor síncrono no responde
El otro costo no es de latencia. Con la replicación síncrona activada, detengan la réplica y escriban:
$ pg-replica stop
Réplica detenida.
$ psql -d arq_w10 -c "INSERT INTO orders (buyer, seat) VALUES ('rosa.quispe@correo.pe', 'S-1')"
El INSERT no responde. No da error: espera. Cinco segundos después, desde
otra terminal, pg_stat_activity muestra esa conexión con wait_event = 'SyncRep': espera la confirmación de la réplica síncrona, que no va a llegar.
El principal está sano, tiene disco y CPU de sobra, y no puede confirmar una
sola escritura. Esperaría para siempre. Si alguien cancela la consulta desde
otra sesión (SELECT pg_cancel_backend(pid) FROM pg_stat_activity WHERE wait_event = 'SyncRep'), pasa algo que vale la pena leer con cuidado. En la
primera terminal, el INSERT por fin termina:
WARNING:  canceling wait for synchronous replication due to user request
DETAIL:  The transaction has already committed locally, but might not have been replicated to the standby.
INSERT 0 1
$ psql -d arq_w10 -c "SELECT id, seat FROM orders WHERE seat = 'S-1'"
  id   | seat
-------+------
 26757 | S-1
(1 row)
La fila está en el principal. La transacción ya se había confirmado en su disco; lo único que faltaba era la confirmación de la réplica. Cancelar la espera no deshace la escritura: deja una escritura que existe en el líder y no en el seguidor, que es justo la situación que la replicación síncrona debía impedir. El mensaje lo dice sin rodeos.
Error común. Activar la replicación síncrona con un solo seguidor y llamarlo “alta disponibilidad”. Lo que se obtuvo es durabilidad (nada confirmado se pierde) a cambio de menos disponibilidad de escritura: antes bastaba una máquina sana para escribir, y ahora hacen falta las dos. Si las dos tienen una disponibilidad de 99,9 % y fallan de forma independiente, la de escribir baja a : son componentes en serie, como en la semana 2.
Semisíncrona
Entre los dos extremos está lo que se hace en la práctica cuando perder una
escritura confirmada no es aceptable: varios seguidores, y el líder espera
a uno cualquiera de ellos. A eso se le suele llamar replicación
semisíncrona. Si un seguidor se cae, otro ocupa su lugar y las escrituras
continúan; lo confirmado está siempre en al menos dos máquinas. En PostgreSQL
se escribe en el mismo parámetro, por ejemplo
synchronous_standby_names = 'ANY 1 (replica_a, replica_b)'.
El costo es una máquina más, y que la latencia de cada escritura sea la del seguidor más rápido en confirmar, que sigue siendo mayor que cero.
Trade-off. Asíncrona: escrituras rápidas y un líder que no depende de nadie, al precio de que un failover pueda perder lo confirmado al final. Síncrona con un seguidor: nada confirmado se pierde, al precio de latencia y de que la caída del seguidor detenga las escrituras. Semisíncrona: las dos garantías, al precio de otra máquina. No hay una correcta: una red social puede perder un “me gusta”; un sistema que cobra no puede perder un pago.
El retraso de replicación
Leer de un seguidor es leer el pasado
El retraso de replicación (replication lag) es el tiempo que pasa entre que el líder confirma una escritura y un seguidor la aplica. Con replicación asíncrona nunca es cero. En condiciones normales es de milisegundos; cuando el seguidor tiene mucho que aplicar, cuando su disco es más lento que el del líder, cuando una consulta larga en el seguidor bloquea la aplicación del WAL o cuando la red entre ambos se degrada, puede ser de segundos o de minutos.
Mientras dura el retraso, leer de un seguidor es leer el pasado: la respuesta es correcta, pero para un momento que ya no es ahora.
¿Cuánto es “milisegundos” aquí? El programa de la ráfaga también mide cuánto
tardó la última orden en aparecer en la réplica después de que el principal la
confirmó (la última línea de su salida). Con cuatro conexiones escribiendo
2 000 órdenes, en tres corridas de make burst la última orden apareció entre
1,6 y 9,2 ms después de confirmada. Parece poco, y alcanza para que la mayoría
de las lecturas hechas justo después de una escritura no la encuentren.
Provocar el retraso
Con los dos servidores en la misma máquina, el retraso natural es pequeño y
cambia en cada corrida. Para estudiar sus efectos conviene uno grande y
estable. PostgreSQL tiene un parámetro para eso en el seguidor,
recovery_min_apply_delay: la réplica recibe el WAL de inmediato, pero
espera ese tiempo antes de aplicar cada transacción. make delay MS=2000 lo
pone en dos segundos:
$ make delay MS=2000
La réplica aplica cada transacción con una demora de: 2s
$ psql -d arq_w10 -c "INSERT INTO orders (buyer, seat) VALUES ('rosa.quispe@correo.pe', 'B-7')"
INSERT 0 1
$ psql -p 5433 -d arq_w10 -c "SELECT count(*) FROM orders WHERE seat = 'B-7'"
 count
-------
     0
(1 row)
La orden está confirmada y la réplica no la muestra; pg-replica lag dice en
ese momento que le faltan 216 bytes por aplicar. Dos segundos después, la
misma consulta en la réplica devuelve 1.
Y la ráfaga, con la demora puesta:
$ make burst
réplica: async
2000 escrituras con 4 conexiones en 811,66 ms
latencia de escritura: p50 1,25 ms, p95 3,66 ms, p99 5,15 ms
WAL pendiente de aplicar en la réplica, máximo visto: 426960 bytes
la última orden apareció en la réplica 2000,88 ms después de confirmada
Dos lecturas de esa salida. Primera: la latencia de escritura no cambió. Al principal no le importa cuánto tarde la réplica; eso es ser asíncrona. Segunda: durante la ráfaga la réplica llegó a tener 426 960 bytes de WAL recibidos y sin aplicar. Las 2 000 órdenes existían en el principal, estaban confirmadas, y ninguna lectura en la réplica las habría visto.
make delay MS=0 quita la demora.
Consistencia eventual
Si en este momento se dejara de escribir en el principal, la réplica terminaría de aplicar lo pendiente y los dos servidores quedarían iguales. A esa garantía se le llama consistencia eventual (eventual consistency): si no hay escrituras nuevas, todas las copias terminan por converger al mismo estado.
Es una garantía débil, y hay que leerla por lo que no dice:
- No dice cuándo. “Terminan por converger” puede ser un milisegundo o una hora.
- No dice qué se ve mientras tanto. Una lectura puede devolver cualquier estado pasado.
- Supone que se deja de escribir, y un sistema en uso no deja de escribir: siempre hay algo en camino.
Idea clave. “Consistencia eventual” describe el destino, no el viaje. A quien usa el sistema le importa el viaje: qué puede ver, en qué orden, justo después de hacer algo. Para decidir si un retraso es aceptable no sirve preguntar cuánto dura en promedio; hay que preguntar qué anomalía concreta vería un usuario mientras dura, y si esa anomalía importa en ese caso de uso.
Las anomalías del retraso y sus garantías
El retraso de replicación produce tres anomalías que tienen nombre. Cada una tiene también una garantía que la evita, más fuerte que la consistencia eventual y más barata que leer siempre del líder.
No leer lo que uno escribió
Una aplicación tiene un principal y una réplica, y alguien decide enviar todas
las lecturas a la réplica para descargar al principal. Un comprador paga su
entrada; la aplicación escribe la orden en el principal y lo lleva a la página
“tu compra”, que la lee de la réplica. El programa
read-your-writes.ts (make anomaly)
hace eso mismo cien veces, sin ninguna demora artificial:
$ make anomaly
100 órdenes creadas en el principal y leídas enseguida en la réplica
no encontradas en la primera lectura: 80 de 100
las que faltaban aparecieron después de: p50 2,52 ms, máximo 10,03 ms
Ochenta de cien compradores no encontraron la orden que acababan de pagar. En otras dos corridas fueron 80 y 75; en ninguna de las que hicimos bajó de 70. Y el retraso era de un par de milisegundos: la orden aparecía casi enseguida, pero la lectura llegaba antes.
Esta es la anomalía más visible de las tres, porque quien la sufre es justamente quien sabe que el dato debería estar ahí. Otro usuario que mirara la lista de órdenes no notaría nada: para él, que una orden ajena aparezca dos milisegundos más tarde no es un error. Para quien la creó, sí. El comprador no piensa “hay retraso de replicación”; piensa “me cobraron y no tengo entrada”, y vuelve a comprar o llama a reclamar.
La garantía que la evita se llama read-your-writes (también read-after-write): después de escribir, el mismo usuario ve su escritura, o algo posterior. No promete nada sobre lo que ven los demás.
Error común. Enviar todas las lecturas a la réplica “para descargar al principal” y descubrir en producción que el usuario no ve lo que acaba de hacer. En las pruebas no aparece porque las pruebas suelen correr contra un solo servidor, y en una demostración a mano tampoco, porque una persona tarda más en hacer clic que la réplica en ponerse al día. Aparece con usuarios reales, redirecciones automáticas y un día de carga. Las 80 de 100 de arriba son con una réplica sana, en la misma máquina, sin carga.
Read-your-writes, de tres maneras
Hay tres formas usuales de dar esa garantía. Las tres deciden de dónde leer según quién lee y qué hizo antes.
Por tipo de dato: leer del líder lo que el propio usuario pudo modificar. El perfil de un usuario lo edita solo él: su propio perfil se lee del líder, y los perfiles ajenos, de un seguidor. Es la más simple y no guarda ningún estado. Sirve cuando hay una frontera clara entre “lo mío” y “lo de otros”, y deja de servir cuando casi todo lo que el usuario ve lo pudo haber modificado él, porque entonces casi todo va al líder y la réplica no descarga nada.
(a) Por tiempo: leer del líder durante un rato después de escribir. La aplicación recuerda cuándo escribió cada usuario por última vez; si fue hace menos de, digamos, cinco segundos, sus lecturas van al líder, y después vuelven al seguidor.
(b) Por posición: esperar a que el seguidor alcance la escritura. Al escribir, la aplicación anota la posición del log en la que quedó la escritura. Antes de leer de un seguidor, comprueba que este ya aplicó hasta esa posición; si no, espera, o lee del líder.
Las dos últimas son las del laboratorio. Para (b) hacen falta dos funciones de
PostgreSQL que ya vieron: en el principal, después de confirmar la escritura,
pg_current_wal_lsn() dice hasta dónde llegó su WAL; en la réplica,
pg_last_wal_replay_lsn() dice hasta dónde aplicó. La comparación es una
consulta en la réplica:
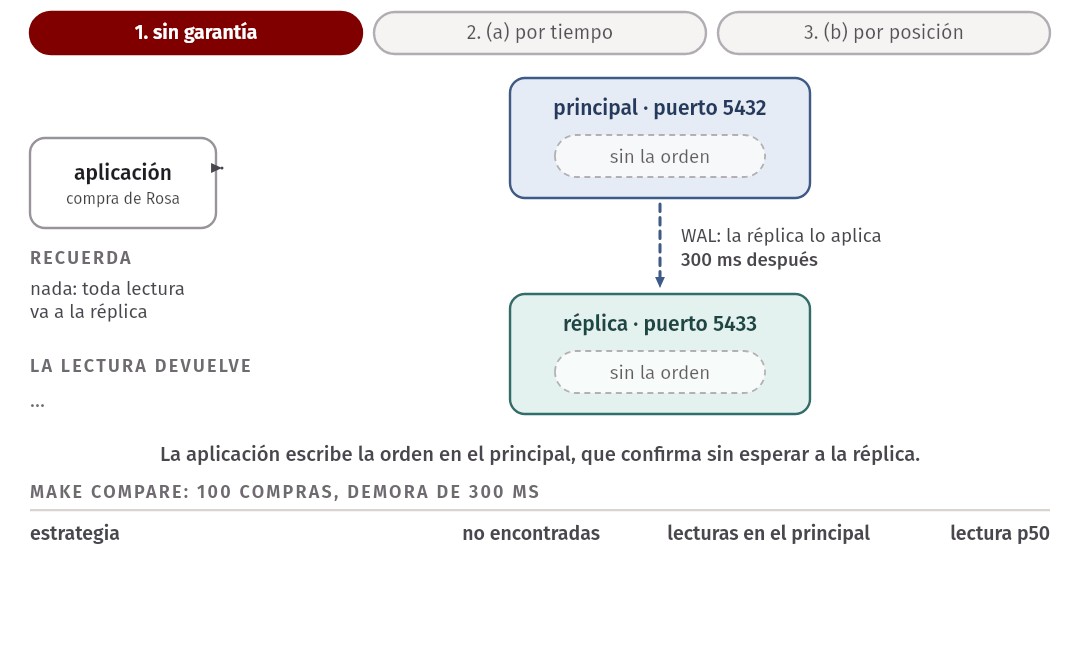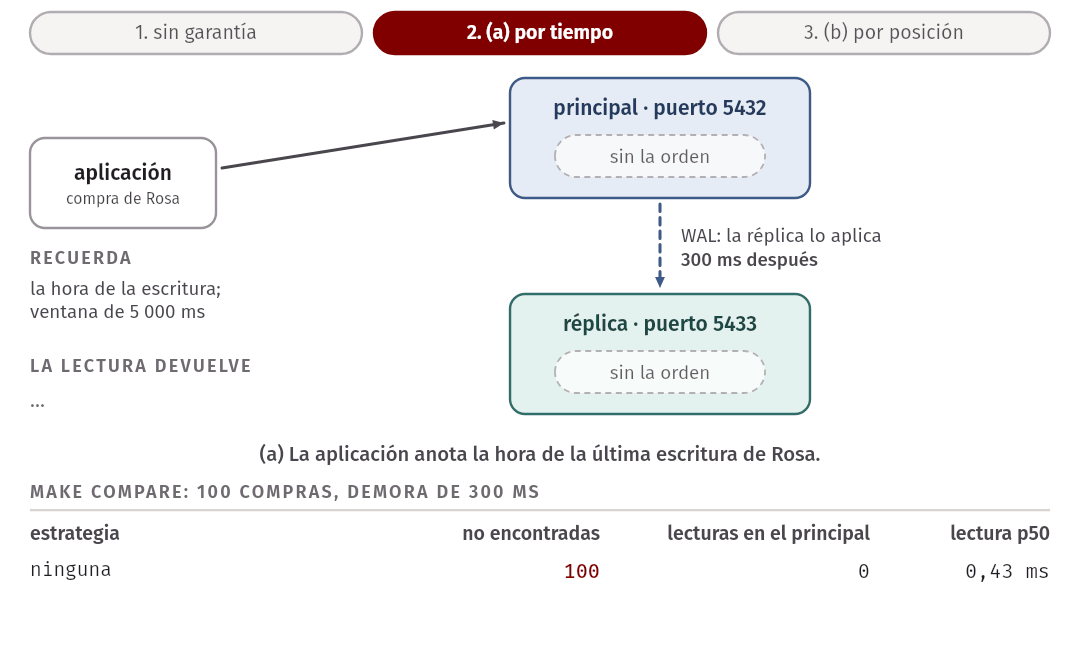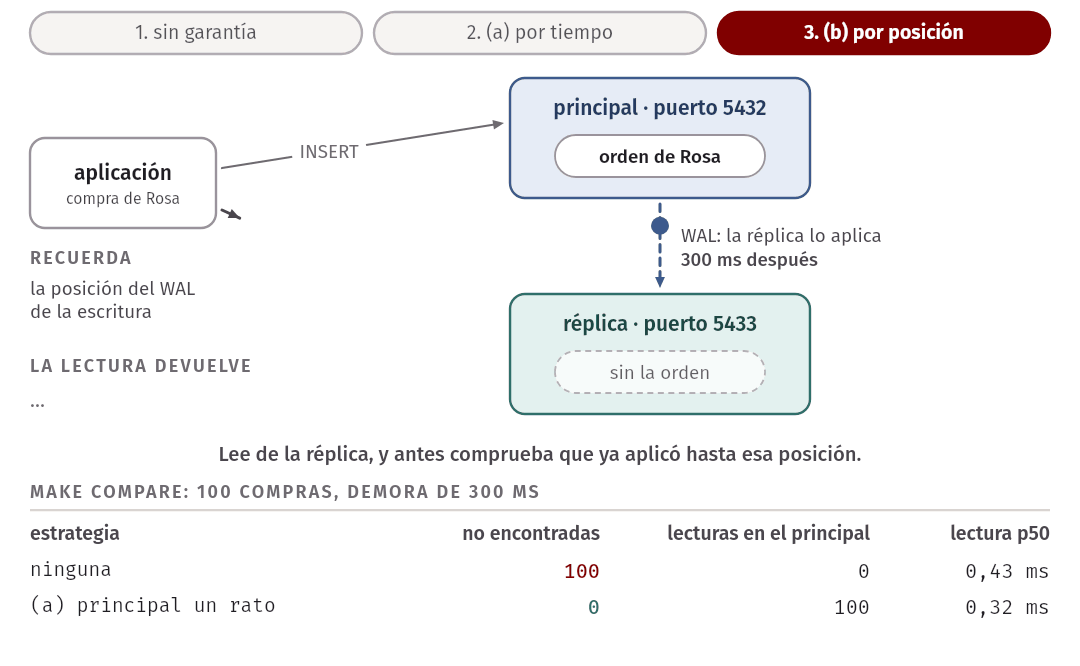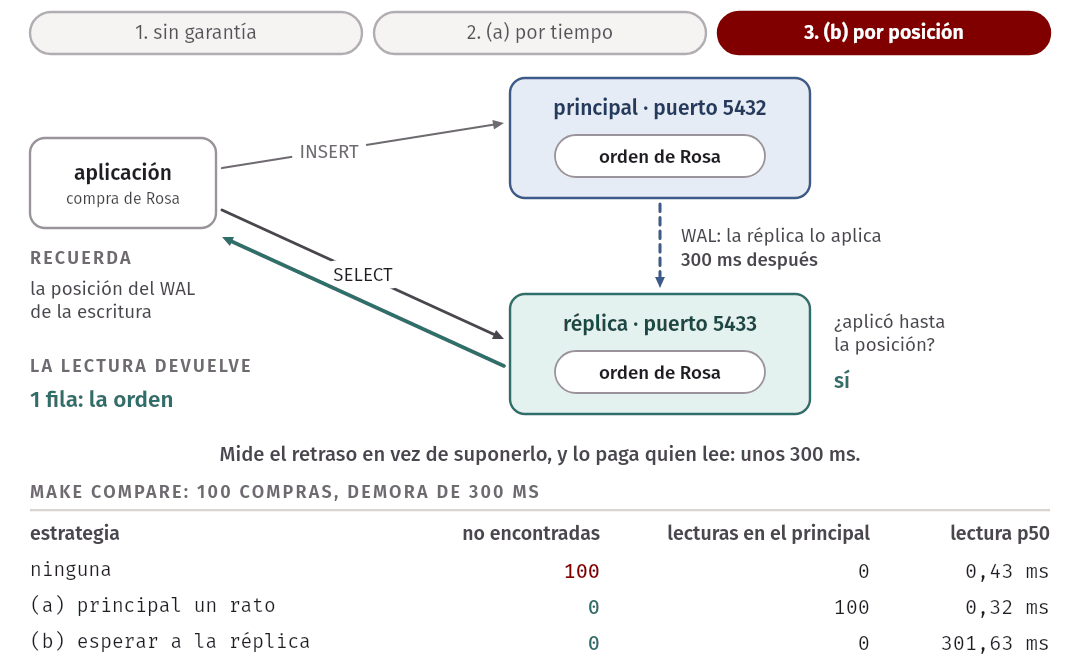
SELECT pg_last_wal_replay_lsn() >= $1::pg_lsn AS reached;El programa lab/compare.ts (make compare)
corre cien compras con cada estrategia y cuenta. Con una demora de 300 ms en
la réplica (make delay MS=300) y las dos estrategias ya implementadas:
$ make compare
100 compras por estrategia; ventana de (a): 5000 ms; pausa antes de leer: 0 ms
ninguna                   no encontradas: 100   lecturas en el principal:   0   lectura p50 0,43 ms, p95 1,51 ms
(a) principal un rato     no encontradas:   0   lecturas en el principal: 100   lectura p50 0,32 ms, p95 0,99 ms
(b) esperar a la réplica  no encontradas:   0   lecturas en el principal:   0   lectura p50 301,63 ms, p95 306,52 ms
Las dos corrigen la anomalía, y cada una cobra algo distinto.
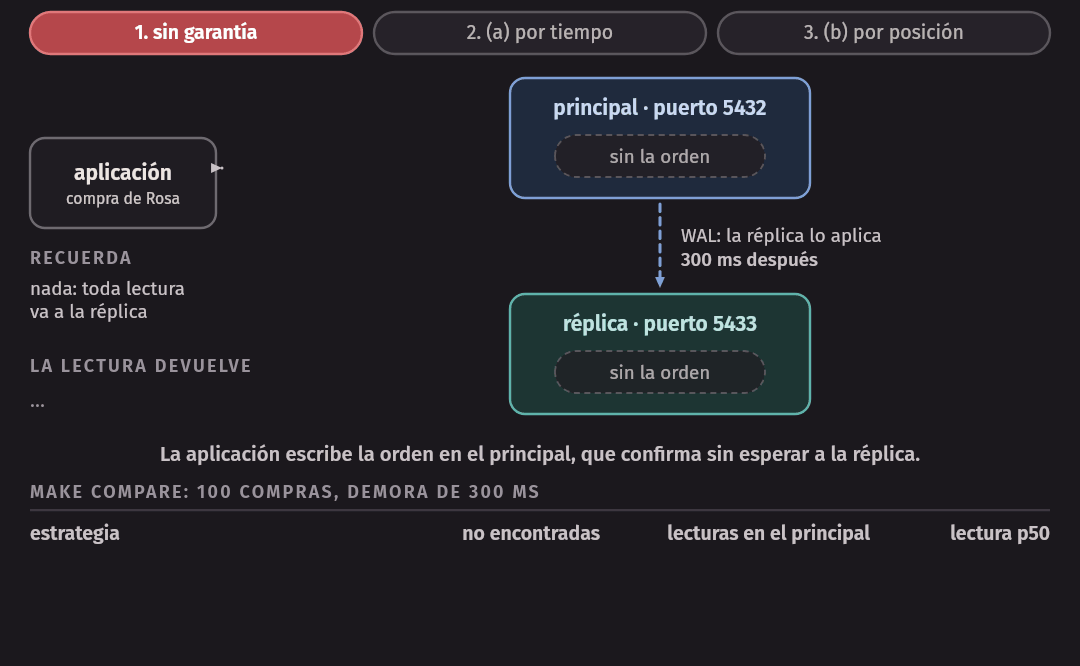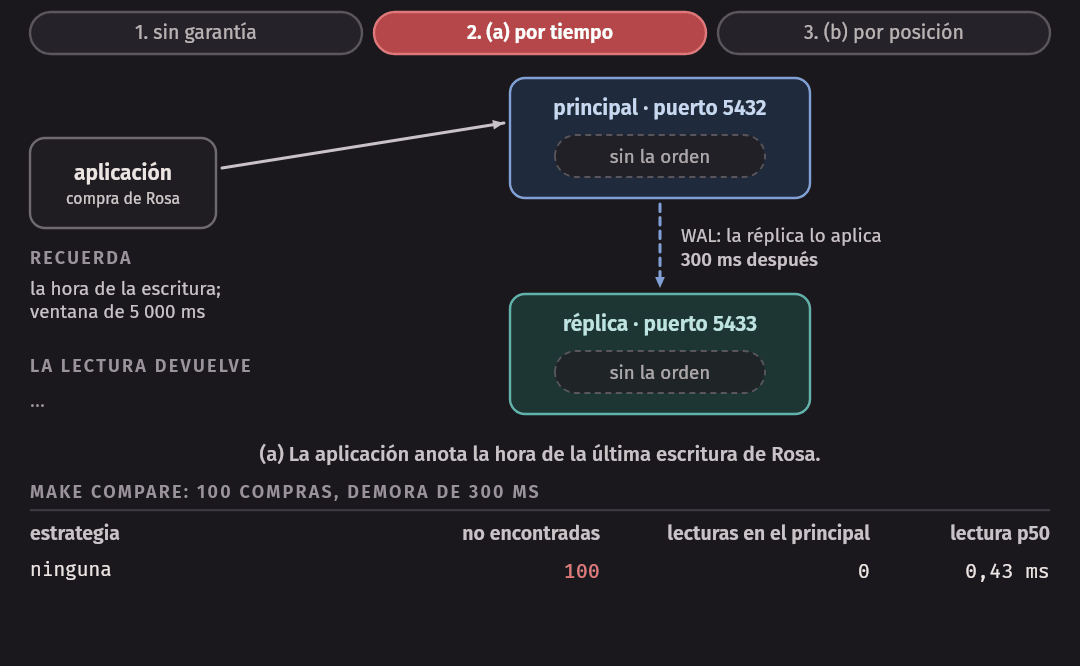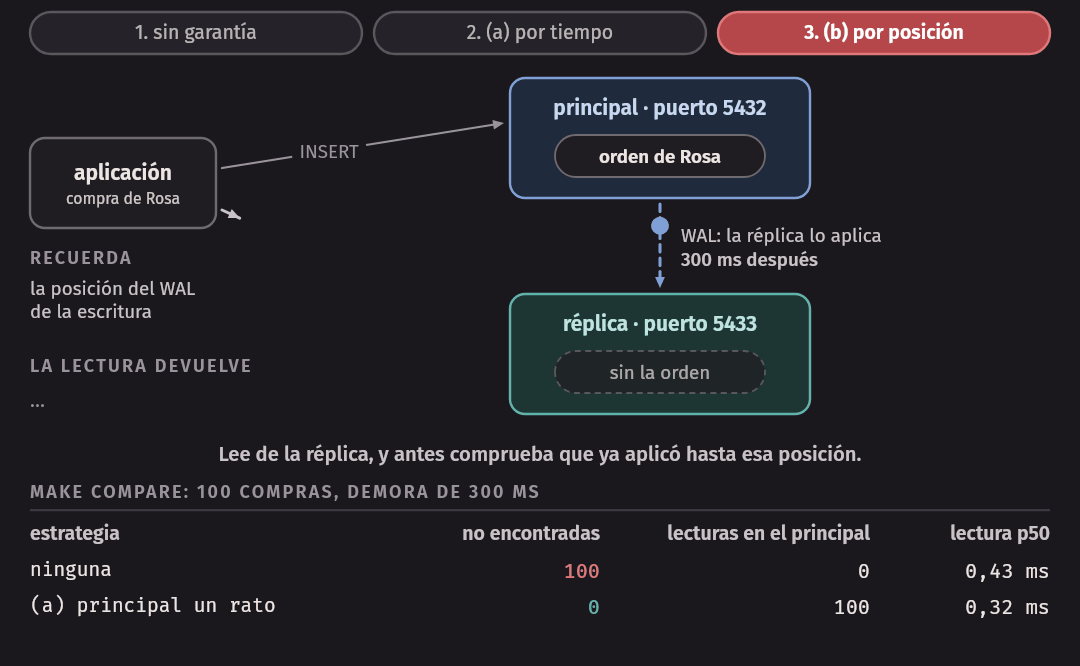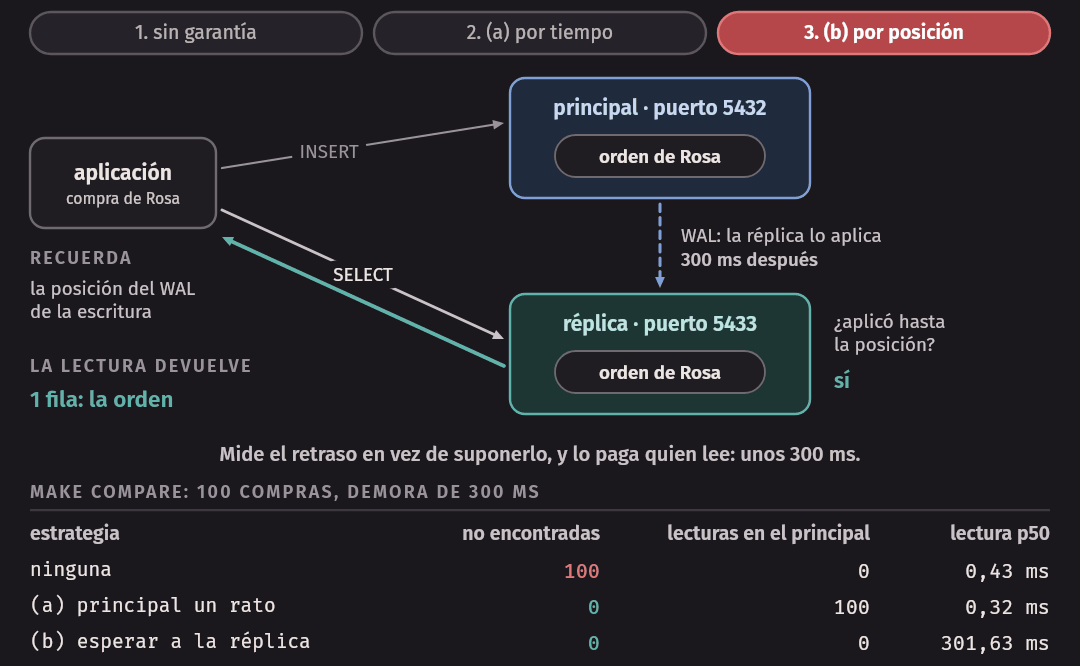
La estrategia (a) responde rápido, y lo logra enviando al principal las cien lecturas: durante la ventana, ese usuario no usa la réplica para nada. Además tiene que recordar la hora de la última escritura de cada usuario en un lugar que todas las instancias de la aplicación compartan, o que viaje con el usuario (una cookie, por ejemplo).
La estrategia (b) no le envió ni una lectura al principal, y lo pagó en latencia: cada lectura tardó lo que tardó la réplica en ponerse al día, unos 300 ms. Con la demora en cero, esa espera fue de 6,5 ms en la mediana, en tres corridas: unas quince veces lo que tarda la lectura sola, porque esperar aquí es preguntarle a la réplica cada 5 ms. Necesita que la posición viaje con el usuario, y necesita un timeout: si la réplica está muy atrasada o caída, hay que decidir qué pasa (leer del principal, o responder que todavía no).
La diferencia de fondo es otra. La estrategia (a) supone que el retraso es menor que la ventana; la (b) lo mide. Para verlo, hagan que el comprador tarde 150 ms en pedir la lectura (una redirección, por ejemplo), con una ventana de 100 ms y la misma demora de 300 ms:
$ THINK_MS=150 WINDOW_MS=100 RUNS=30 make compare
30 compras por estrategia; ventana de (a): 100 ms; pausa antes de leer: 150 ms
ninguna                   no encontradas:  30   lecturas en el principal:   0   lectura p50 0,97 ms, p95 3,36 ms
(a) principal un rato     no encontradas:  30   lecturas en el principal:   0   lectura p50 0,79 ms, p95 4,52 ms
(b) esperar a la réplica  no encontradas:   0   lecturas en el principal:   0   lectura p50 152,35 ms, p95 157,66 ms
La ventana ya había pasado, la réplica todavía no tenía la orden, y (a) falló las treinta veces sin que nada avisara. La estrategia (b) siguió sin fallar, y esperó solo lo que faltaba: 150 ms en vez de 300.
| Por tipo de dato | (a) Por tiempo | (b) Por posición | |
|---|---|---|---|
| Qué recuerda la aplicación | Nada | La hora de la última escritura de cada usuario | La posición del log de la última escritura de cada usuario |
| Qué le cuesta al líder | Todas las lecturas de “lo mío” | Las lecturas de quien escribió hace poco | Ninguna lectura (salvo timeout) |
| Qué le cuesta a quien lee | Nada | Nada | Esperar hasta el retraso actual |
| Cuándo falla | Si el dato lo modifican otros | Si el retraso supera la ventana | No falla; puede tardar o agotar el timeout |
Un detalle de (b) que cuesta caro si se pasa por alto: la posición hay que
pedirla después de que la escritura se confirmó, en una consulta aparte.
Es tentador pedirla en la misma sentencia, con
INSERT ... RETURNING pg_current_wal_insert_lsn(). En ese momento el registro
de COMMIT todavía no existe en el WAL, así que la posición que se obtiene
queda antes del commit. La réplica puede llegar a esa posición y aun así no
mostrar la fila, porque una fila se vuelve visible cuando se aplica el commit
de su transacción. El ejemplo
errors/lsn-before-commit.ts
(make wrong-lsn, con una demora de dos segundos) compara las dos formas:
$ make wrong-lsn
posición tomada dentro del INSERT (0/3009C48): la réplica llegó ahí;
  ¿ve la orden? no
posición tomada después del commit (0/3009D38): la réplica llegó ahí;
  ¿ve la orden? sí
Con una réplica al día, el error casi nunca se nota, porque el commit llega una fracción de milisegundo después. Es de los que pasan todas las pruebas.
Síncrona no es read-your-writes
Una confusión frecuente: “si la replicación es síncrona, la réplica siempre
está al día, así que no hay anomalía”. No es así. Lo que la replicación
síncrona de PostgreSQL espera, por omisión, es que la réplica haya guardado
el WAL en su disco (flush_lsn), no que lo haya aplicado
(replay_lsn). Es lo que hace falta para no perder la escritura, y no es lo
que hace falta para leerla.
Con la replicación síncrona activada (make sync-on) y sin demora, la
anomalía baja mucho y no desaparece:
$ make anomaly
100 órdenes creadas en el principal y leídas enseguida en la réplica
no encontradas en la primera lectura: 2 de 100
las que faltaban aparecieron después de: p50 2,92 ms, máximo 3,21 ms
Dos de cien (tres en otra corrida). Bajó porque esperar a que la réplica guarde el WAL le da casi siempre el tiempo que necesita para aplicarlo, no porque algo lo garantice: con una demora de aplicación en la réplica vuelven a ser todas, y una de las pruebas de la semana lo comprueba.
PostgreSQL permite pedir la garantía completa por conexión, con
synchronous_commit = remote_apply: la escritura no se confirma hasta que la
réplica la aplicó. Con esa opción
(PGOPTIONS="-c synchronous_commit=remote_apply" node read-your-writes.ts),
el programa de la anomalía reportó no encontradas en la primera lectura: 0 de 100 en las dos corridas que hicimos. Es una cuarta
manera de obtener read-your-writes, y mueve el costo de lugar: ya no espera
quien lee, sino toda escritura, lean después o no; y si la réplica se
atrasa, las escrituras se atrasan con ella.
Idea clave. “Síncrona” responde a la pregunta ¿se pierde lo confirmado si el líder muere?. Read-your-writes responde a otra: ¿ve su escritura quien acaba de escribir?. Son garantías distintas, sobre momentos distintos del viaje del cambio (guardado y aplicado), y una no trae a la otra.
Lecturas que retroceden
La segunda anomalía no necesita que el usuario escriba nada. Supongan dos seguidores con retrasos distintos y un load balancer que reparte las lecturas entre ellos. Un usuario recarga una página dos veces: la primera lectura cae en el seguidor adelantado y muestra un comentario nuevo; la segunda cae en el atrasado, y el comentario ya no está. Para ese usuario, el tiempo retrocedió.
En el contenedor hay una sola réplica, pero el efecto es el mismo si las
lecturas se reparten entre el principal y ella. El programa
replication/monotonic-reads.ts
(make monotonic) crea una orden y cuenta las órdenes de ese asiento tres
veces, alternando de servidor, con la demora de dos segundos puesta:
$ make monotonic
lectura 1 (principal): 1 orden(es) del asiento M-1794811781632
lectura 2 (réplica): 0 orden(es) del asiento M-1794811781632   <- retrocedió
lectura 3 (principal): 1 orden(es) del asiento M-1794811781632
Cada respuesta es correcta para el servidor que la dio. La secuencia, vista por una sola persona, no lo es: el asiento estaba vendido, luego libre, luego vendido.
La garantía se llama lecturas monótonas (monotonic reads): un mismo usuario nunca ve un estado anterior al que ya vio. Es más débil que read-your-writes en un sentido (no promete que vea lo último) y distinta en otro (vale aunque no haya escrito nada).
La forma usual de darla es fijar cada usuario a un seguidor: que todas sus lecturas vayan al mismo, por ejemplo eligiéndolo con un hash de su identificador. Un seguidor puede estar atrasado, pero no retrocede. Lo que cuesta: si ese seguidor se cae hay que mover a sus usuarios a otro, que puede estar más atrasado; y la carga ya no se reparte lectura por lectura, sino usuario por usuario. La alternativa es la idea de (b): que el usuario lleve la posición más alta que ya vio.
Efectos antes que sus causas
La tercera anomalía aparece cuando las escrituras relacionadas no viajan por el mismo camino. Alguien pregunta en un chat “¿a qué hora abre la venta?” y otra persona responde “a las diez”. Si las dos escrituras se replican por separado y la segunda llega antes a un seguidor, quien lea de él verá una respuesta a una pregunta que todavía no existe.
La garantía que lo evita son las lecturas con prefijo consistente (consistent prefix reads): quien lee ve las escrituras en un orden en el que de verdad ocurrieron, sin huecos en medio. Puede faltarle el final, pero no un pedazo del medio.
Con un líder y un solo log, esta garantía viene incluida: el seguidor aplica el WAL en el orden del líder, así que su estado siempre es un prefijo de la historia del líder. Por eso no pudimos mostrarla con PostgreSQL. Se rompe cuando hay varios logs independientes: datos repartidos en shards que se replican cada uno por su lado (semana 11), o varios líderes, que es el tema de la segunda sesión.
Qué lectura va a dónde
Las tres garantías se pueden dar siempre, leyendo todo del líder. Eso tira a la basura la razón por la que se puso la réplica. La decisión útil es por caso de uso: para cada lectura del sistema, quién la hace, qué tan viejo puede ser lo que ve y qué pasa si ve algo viejo. El resultado es una tabla, y se escribe, porque es una decisión de arquitectura como cualquier otra.
Para una tienda de entradas pequeña, por ejemplo:
| Lectura | Quién la hace | Si ve datos de hace unos segundos | Va a |
|---|---|---|---|
| Lista de conciertos | Cualquiera | No pasa nada | Réplica |
| Asientos libres de un concierto, para mostrar el mapa | Cualquiera | Puede ver libre un asiento recién vendido; la compra lo rechazará | Réplica |
| ¿Está libre este asiento?, al comprarlo | El proceso de compra | Vendería un asiento dos veces | Líder, dentro de la transacción de la compra |
| La orden que acabo de pagar | El comprador | Cree que no compró | Con read-your-writes |
| Reporte de ventas del mes | Administración | No pasa nada | Réplica |
La tercera fila merece una frase aparte. Una decisión que termina en una escritura no se toma con datos de una réplica. Comprobar en la réplica que el asiento está libre y después venderlo en el líder es vender con información vieja. Esa lectura va al líder y forma parte de la misma transacción que la escritura; cómo se hace bien es el tema de la semana 12.
En Tinkuy. El Tinkuy inicial tiene un solo servidor de base de datos, así que hoy no tiene ninguna de estas anomalías. En P3 le agregan una réplica de lectura, y con ella aparece esta decisión. El catálogo (
GET /events, que la semana 2 mostró como la lectura más lenta, yGET /events/:id) y el reporte (GET /reports/sales) son candidatos naturales a la réplica: los lee mucha gente y toleran segundos de retraso.GET /orders/:idjusto después de unPOST /ordersno lo es sin más: es el comprador mirando su compra. Qué lectura va a dónde, y con qué garantía, es una decisión de su equipo, y va en un ADR con la tabla.
Una réplica no es un respaldo
Una réplica tiene todos los datos del líder, al día. Es fácil concluir que ya no hace falta un respaldo. Miren qué hace la réplica con un error:
$ psql -d arq_w10 -c "DELETE FROM orders"
DELETE 1
$ psql -p 5433 -d arq_w10 -c "SELECT count(*) FROM orders"
 count
-------
     0
(1 row)
Un DELETE sin WHERE es una escritura como cualquier otra: va al WAL, viaja
a la réplica y se aplica, en milisegundos. La réplica hizo exactamente su
trabajo, que es parecerse al líder lo antes posible, errores incluidos.
Una réplica protege contra la falla de una máquina: un disco que muere, un servidor que se apaga. Un respaldo protege contra cambios que no debieron ocurrir: un borrado equivocado, una migración con un error, un ataque. Para eso hace falta volver a un momento anterior, y una réplica solo tiene el presente.
Una réplica con demora a propósito (recovery_min_apply_delay) queda en el
medio, y por eso se usa también en producción: durante la demora todavía
tiene lo borrado, si alguien llega a tiempo a detenerla. Ayuda, y no reemplaza
a un respaldo.
Error común. Creer que una réplica es un respaldo. Hacen falta las dos cosas, porque responden a fallas distintas; y un respaldo que nunca se probó restaurando tampoco es un respaldo.
Failover
Tres pasos, un riesgo en cada uno
Si un seguidor falla, casi no pasa nada: las lecturas se van a otro y, cuando vuelve, pide el log desde donde se quedó. Si falla el líder, el sistema no puede escribir hasta que otro nodo ocupe su lugar. Hacer failover es eso: promover a un seguidor a líder. Puede hacerlo una persona o un programa, y en los dos casos son tres pasos, cada uno con su riesgo.
1. Detectar la falla. Nadie puede saber que el líder murió. Lo único que se observa desde afuera es que dejó de responder, y eso mismo se observa si está sobrecargado, si la red hacia él se cortó o si hizo una pausa larga. Se decide con un timeout: si no responde en tantos segundos, se lo da por muerto. No hay un valor correcto:
- Un timeout corto reacciona rápido y se equivoca seguido: un líder lento bajo un pico de carga es declarado muerto, y el failover se dispara justo cuando el sistema está más cargado.
- Un timeout largo se equivoca poco y deja al sistema sin escribir durante todo ese tiempo cada vez que el líder muere de verdad.
Es la llamada remota sin respuesta de la semana 5, con una consecuencia más grave: aquí, equivocarse puede dejar dos líderes.
2. Elegir al nuevo líder. Con varios seguidores, conviene el más actualizado, el que aplicó más log, para perder lo menos posible. Pero todos los nodos tienen que quedar de acuerdo en cuál es, aunque algunos no se vean entre sí. Ponerse de acuerdo entre nodos que pueden fallar es el problema del consenso, que veremos en la semana 13; no se resuelve con que cada nodo decida por su cuenta.
3. Redirigir a los clientes. Las aplicaciones tienen que empezar a escribir en el líder nuevo: cambia una dirección en la configuración, un nombre de DNS o un proxy que está delante. Y el líder anterior, si vuelve, tiene que enterarse de que ya no lo es.
De esos pasos salen los dos riesgos mayores, que son el resto de la sección: con replicación asíncrona, el nuevo líder puede no tener escrituras que el anterior ya había confirmado; y si el anterior vuelve creyendo que sigue siendo líder, hay dos nodos aceptando escrituras.
Un failover a mano
En el contenedor hay un solo seguidor, así que el paso 2 no tiene misterio, y
los pasos 1 y 3 los hacen ustedes. El programa
failover/writer.ts (make writer)
hace de aplicación: escribe en el principal órdenes numeradas, 1, 2, 3…, una
después de otra, y cuenta una como confirmada solo cuando PostgreSQL le
respondió. Con el escritor corriendo en una terminal, en otra se mata al
principal con make kill-primary, que envía kill -9 al servidor del puerto
5432 y a sus procesos, sin darle tiempo de avisarle a nadie. El escritor lo
nota en la siguiente orden:
$ make writer
Escribiendo órdenes numeradas en el principal (puerto 5432)...
  confirmadas: 1000
  …
  confirmadas: 6000
El principal dejó de responder: read ECONNRESET
Última escritura confirmada al cliente: 6005
Escritura sin respuesta (no se sabe si llegó): 6006
Fíjense en la última línea. La orden 6006 se envió y no tuvo respuesta. El cliente no puede saber si el principal alcanzó a guardarla antes de morir: es la respuesta perdida de la semana 5. Lo único que sabe con certeza es que hasta la 6005 le dijeron “confirmado”.
En este momento el sistema no acepta escrituras (psql contra el puerto 5432
responde Connection refused). La réplica está viva y responde lecturas, pero
no es líder. Se la promueve:
$ pg-replica promote
La réplica ahora es un principal independiente en el puerto 5433.
$ psql -p 5433 -c "SELECT pg_is_in_recovery()"
 pg_is_in_recovery
-------------------
 f
(1 row)
El servidor del puerto 5433 dejó de estar en recuperación: ya acepta
escrituras. Su log (/var/log/course/replica.log) registra el momento con la
línea selected new timeline ID: 2. PostgreSQL numera las historias: todo lo
que escribió el principal original pertenece a la línea de tiempo 1, y lo
que escriba el promovido, a la 2. Es la forma en que el propio WAL anota que
aquí la historia se bifurcó.
Lo que este procedimiento a mano no hizo es el paso 3: ninguna aplicación sabe todavía que ahora debe escribir en el puerto 5433.
Escrituras confirmadas que se pierden
make compare-failover compara lo que el cliente recibió como confirmado con
lo que existe en el nuevo principal:
$ make compare-failover
confirmadas al cliente:        1..6005
existen en el nuevo principal: 1..6005 (6005 filas)
ninguna confirmada se perdió
Esta vez no se perdió nada. Con replicación asíncrona eso es suerte, no una garantía. Repetimos el mismo failover diez veces seguidas, cada una con una réplica recién creada: en ocho no se perdió ninguna confirmada, en una se perdió la última y en otra, las tres últimas. La salida de esta:
confirmadas al cliente:        1..1128
existen en el nuevo principal: 1..1125 (1125 filas)
confirmadas que se PERDIERON:  3 (de la 1126 a la 1128)
Tres compradores recibieron “confirmado”, y sus órdenes no existen en el sistema que quedó. No hubo ningún error en ningún log: el principal las confirmó correctamente y la réplica se promovió correctamente. Esas tres estaban en el principal y todavía no habían salido cuando murió.
Con los dos servidores en la misma máquina, la ventana en la que eso puede
pasar dura microsegundos, y aun así ocurrió en dos de diez corridas. Los
failovers reales, además, no suelen llegar con el enlace sano: llegan cuando
algo ya andaba mal. Para verlo, make link-cut detiene el proceso de la
réplica que recibe el WAL, que es lo que vería el principal si la red hacia
ella dejara de entregar paquetes. El principal sigue confirmando, porque es
asíncrono. Un segundo después del corte:
$ pg-replica lag
 application_name |   state   | sync_state | bytes_pendientes |   replay_lag
------------------+-----------+------------+------------------+-----------------
 walreceiver      | streaming | async      |           179160 | 00:00:00.005825
(1 row)
La réplica debe 179 160 bytes, y replay_lag sigue mostrando 5 ms: es el
error común de más arriba, en vivo. Ahora muere el principal
(make kill-primary), se repone el enlace (make link-restore; ya no hay
nadie del otro lado) y se promueve la réplica:
$ make compare-failover
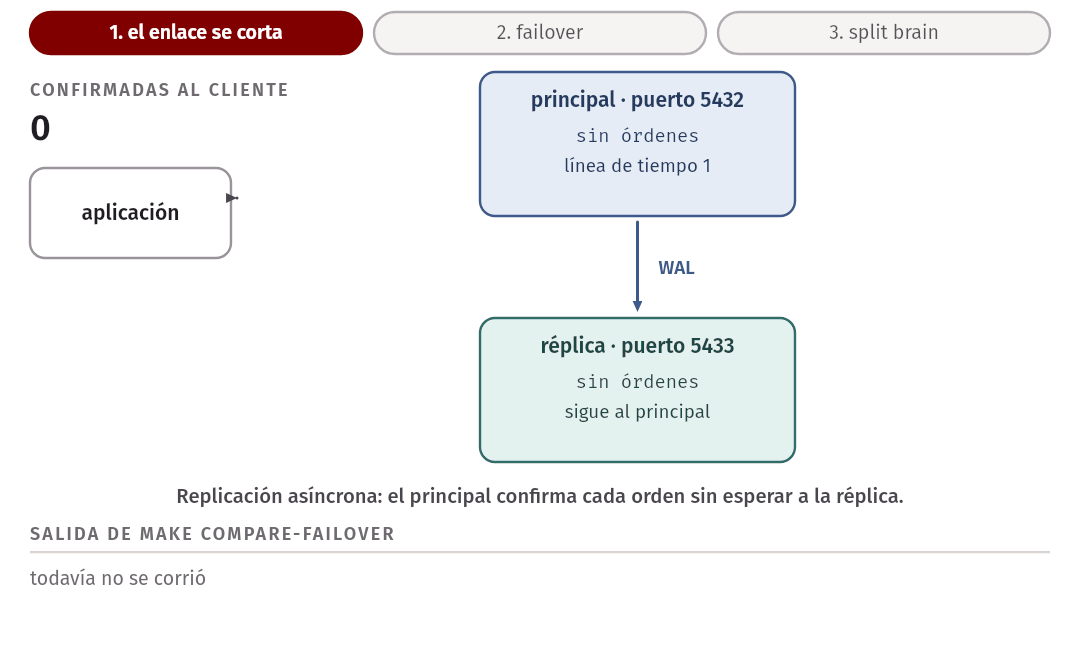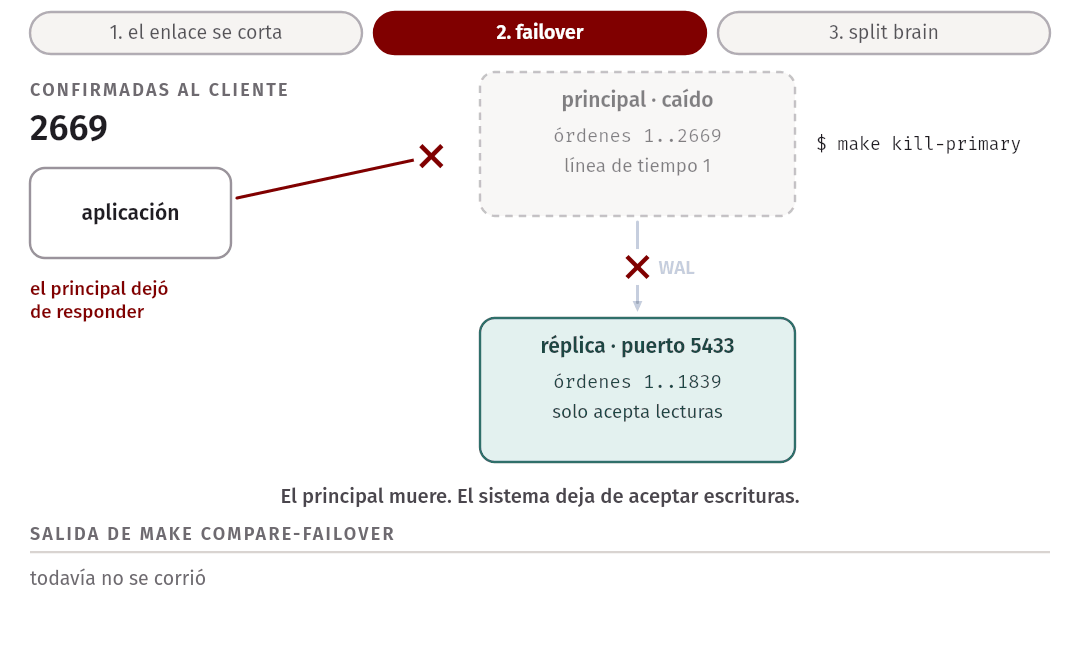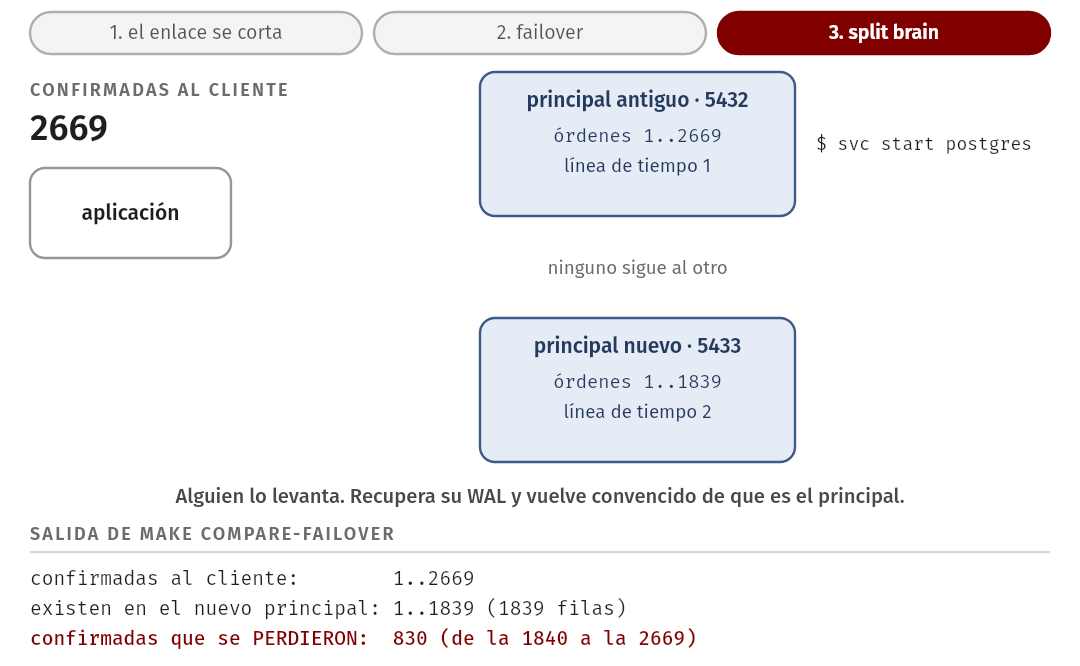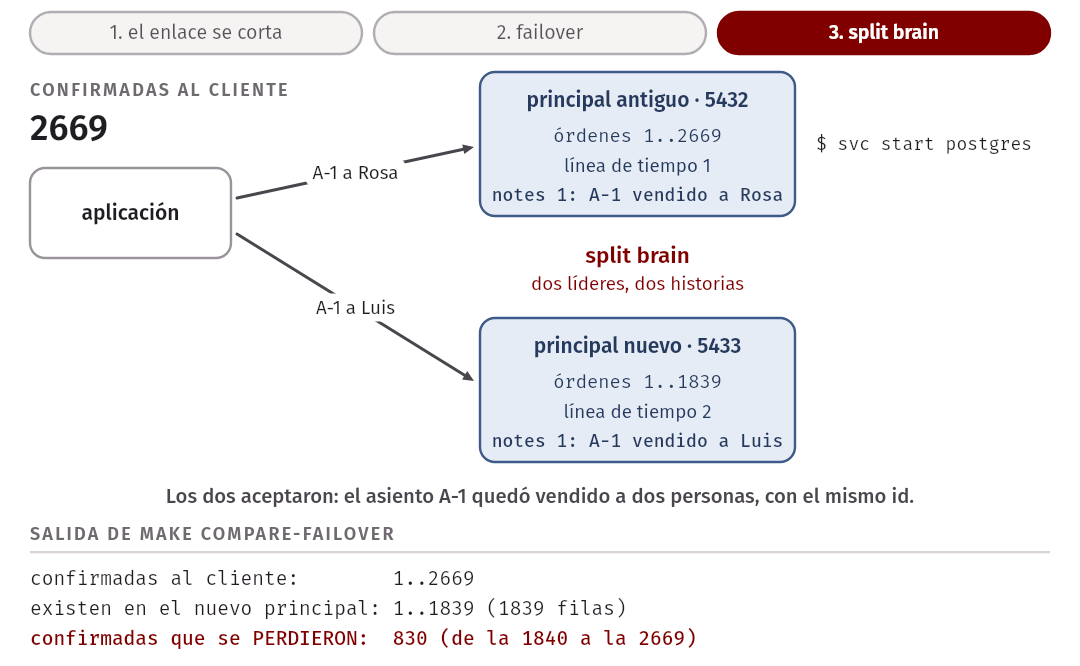
confirmadas al cliente:        1..2669
existen en el nuevo principal: 1..1839 (1839 filas)
confirmadas que se PERDIERON:  830 (de la 1840 a la 2669)
Ochocientas treinta órdenes confirmadas, perdidas en un segundo de enlace cortado. En otras dos corridas fueron 692 y 1 145; el número depende de cuántas escrituras entran en ese segundo.
¿Y con replicación síncrona? El mismo experimento, con make sync-on antes de
empezar. Al cortar el enlace, el escritor se detiene solo: su INSERT queda
esperando a la réplica (SyncRep), como en Cuando el seguidor síncrono no
responde. Se mata al principal, se promueve la réplica y se compara:
$ make writer
Escribiendo órdenes numeradas en el principal (puerto 5432)...
El principal dejó de responder: Connection terminated unexpectedly
Última escritura confirmada al cliente: 654
Escritura sin respuesta (no se sabe si llegó): 655
$ make compare-failover
confirmadas al cliente:        1..654
existen en el nuevo principal: 1..655 (655 filas)
ninguna confirmada se perdió; además llegó la 655, que el cliente nunca supo si se guardó
Ninguna confirmada se perdió, que es lo que la replicación síncrona promete. Y aparece el otro lado de la respuesta perdida: la orden 655 sí está en el nuevo principal. Había salido hacia la réplica antes del corte; lo que nunca llegó fue la confirmación de vuelta al cliente. La replicación síncrona garantiza que lo confirmado existe; no garantiza que lo no confirmado no exista. Un cliente que reintenta la 655 después del failover la escribiría dos veces, salvo que la escritura sea idempotente (semana 12).
| Asíncrona, enlace sano | Asíncrona, enlace cortado 1 s | Síncrona, enlace cortado 1 s | |
|---|---|---|---|
| Confirmadas que se perdieron | 0, 1 o 3 (en diez corridas) | 830, 692 y 1 145 (en tres) | 0 |
| ¿El sistema escribía durante el corte? | — | Sí | No |
Trade-off. La última fila es el precio de la penúltima. Durante el segundo de enlace cortado, el sistema asíncrono siguió vendiendo y perdió esas ventas; el síncrono no perdió ninguna porque no vendió ninguna. Qué es peor depende del dato. Para una orden pagada, perderla es peor que hacer esperar. Para un contador de visitas, detener el sitio para no perder una visita sería absurdo.
Split brain
Falta el último riesgo. El principal anterior no se destruyó: se cayó. En
algún momento alguien, o un supervisor automático, lo vuelve a levantar con
svc start postgres. Arranca, recupera su WAL y queda exactamente como estaba
antes de caer: convencido de que es el principal. Nadie le avisó del failover.
Ahora hay dos servidores, y ninguno está en recuperación:
$ psql -p 5432 -d arq_w10 -c "SELECT pg_is_in_recovery() AS es_replica, max(n) AS ultima_orden,
    substr(pg_walfile_name(pg_current_wal_lsn()), 1, 8) AS linea_de_tiempo FROM numbered_writes"
 es_replica | ultima_orden | linea_de_tiempo
------------+--------------+-----------------
 f          |         6005 | 00000001
(1 row)

$ psql -p 5433 -d arq_w10 -c "SELECT …"
 es_replica | ultima_orden | linea_de_tiempo
------------+--------------+-----------------
 f          |         6005 | 00000002
(1 row)
Los dos aceptan escrituras. Una parte de la aplicación sigue apuntando al 5432 y otra ya apunta al 5433:
$ psql -p 5432 -d arq_w10 -c "INSERT INTO notes (written_on, body) VALUES ('5432', 'asiento A-1 vendido a Rosa')"
INSERT 0 1
$ psql -p 5433 -d arq_w10 -c "INSERT INTO notes (written_on, body) VALUES ('5433', 'asiento A-1 vendido a Luis')"
INSERT 0 1
$ psql -p 5432 -d arq_w10 -c "SELECT id, written_on, body FROM notes"
 id | written_on |            body
----+------------+----------------------------
  1 | 5432       | asiento A-1 vendido a Rosa
(1 row)

$ psql -p 5433 -d arq_w10 -c "SELECT id, written_on, body FROM notes"
 id | written_on |            body
----+------------+----------------------------
  1 | 5433       | asiento A-1 vendido a Luis
(1 row)
Dos filas con la misma clave primaria y contenidos distintos, una en cada servidor. Cada servidor es consistente por dentro. El sistema, no: el asiento A-1 está vendido a dos personas, y ninguna restricción lo impidió porque cada restricción se comprobó en una base de datos distinta. A esta situación se le llama split brain: dos nodos que se creen líderes y aceptan escrituras a la vez.
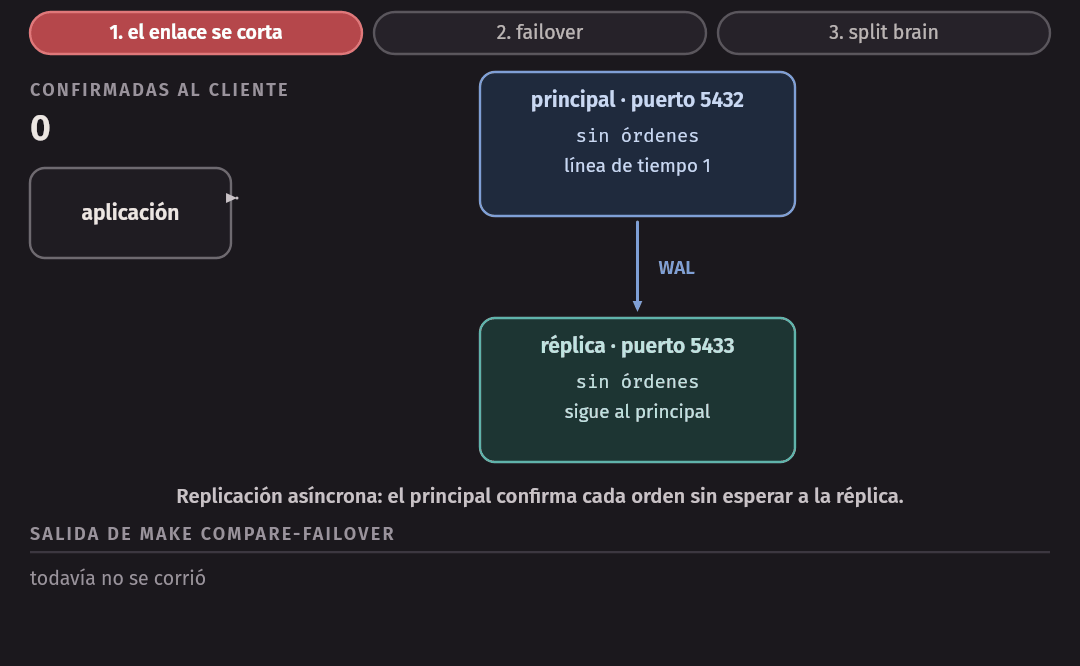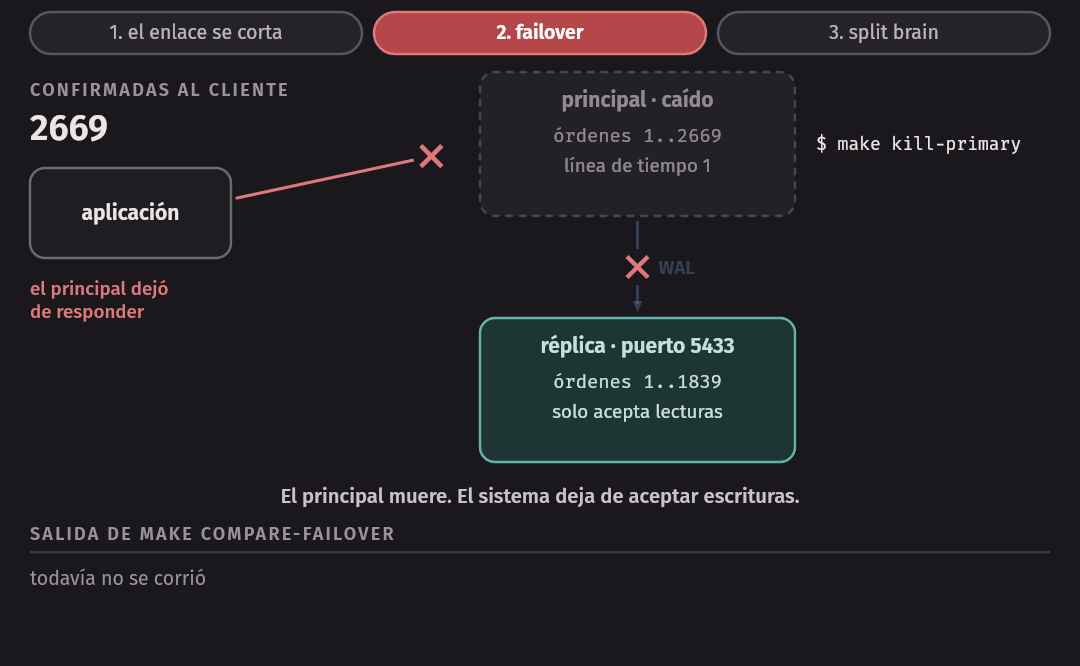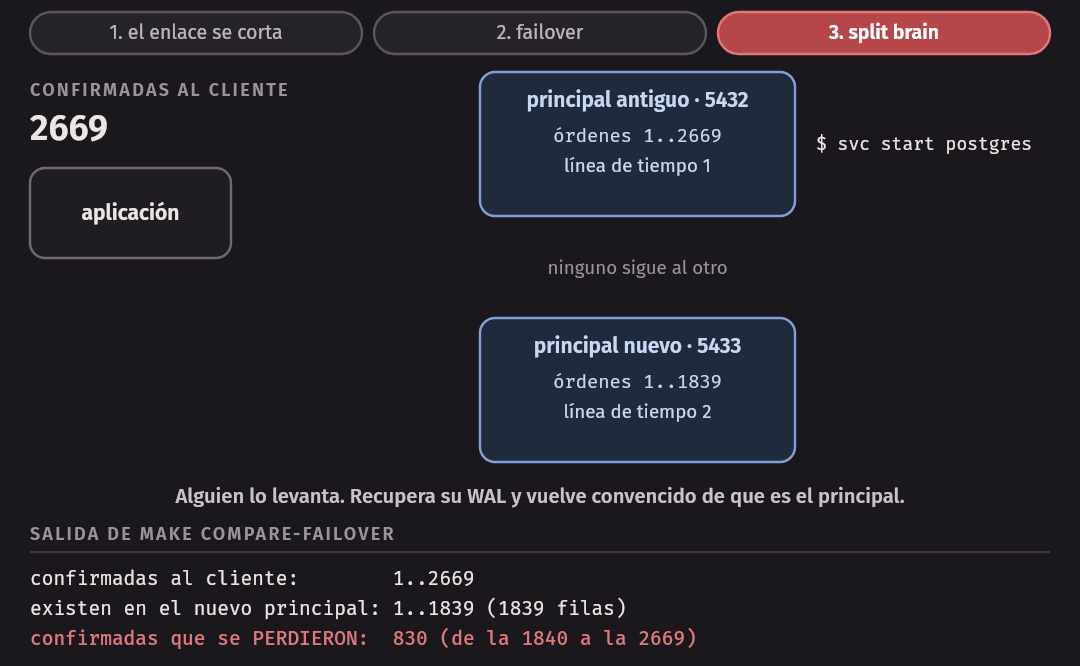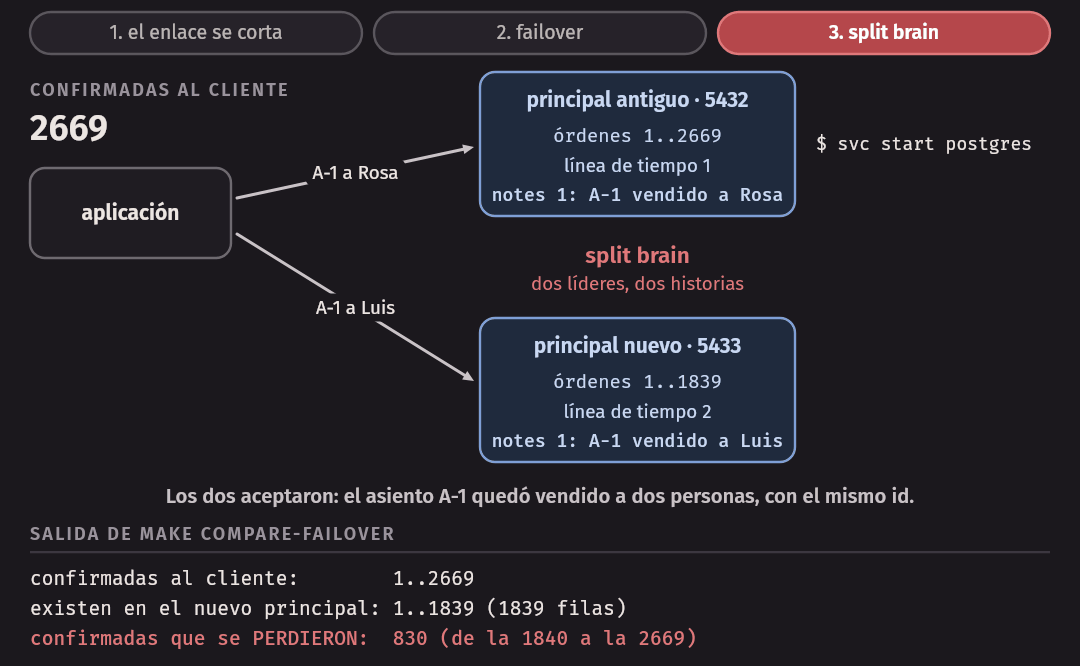
No hay forma automática de juntar las dos historias. La columna
linea_de_tiempo lo dice: son la 1 y la 2, se separaron en el failover, y un
servidor de PostgreSQL no puede seguir a otro cuya línea de tiempo diverge de
la suya (pg-replica lag ya no muestra ninguna fila). Alguien tiene que
elegir cuál historia sobrevive y recuperar a mano lo que valga la pena de la
otra. Después de un failover con el enlace cortado es peor: en una de nuestras
corridas, el principal antiguo volvió con órdenes hasta la 1 342 y el nuevo
solo tenía hasta la 1 331.
¿Qué tendría que haberlo impedido? Que el líder anterior no pueda aceptar escrituras una vez que fue reemplazado. A eso se le llama fencing (cercarlo), y se hace de varias maneras, de la más simple a la más segura:
- No volver a levantarlo como líder. El procedimiento de failover deja al anterior apagado, o lo arranca como seguidor del nuevo. Depende de que el procedimiento se siga, y un supervisor que reinicia servicios caídos no lo sabe.
- Quitarle a los clientes. Si todas las escrituras pasan por un proxy o una dirección que el failover mueve, el anterior puede creerse líder sin que nadie le escriba. Depende de que nadie conserve la dirección vieja.
- Un número de época. Cada líder nuevo recibe un número mayor que el anterior, y los seguidores y el almacenamiento rechazan lo que venga con un número viejo. Funciona aunque el líder anterior esté vivo y convencido, y necesita consenso para repartir los números.
Ninguna es gratis, y la más segura es la más difícil de construir. Por eso los equipos no escriben su propio failover automático: usan herramientas que ya lo resuelven, o un servicio administrado, y aun así leen con cuidado qué garantiza cada una.
En la industria. El 21 de octubre de 2018, un trabajo de mantenimiento en GitHub cortó durante 43 segundos la conexión entre su centro de datos principal de la costa este de Estados Unidos y el resto de su red. Su informe posterior cuenta que la herramienta que administraba sus clusters de MySQL hizo lo que estaba configurada para hacer: promovió réplicas de la costa oeste. Cuando la conexión volvió, los servidores del este tenían unos segundos de escrituras que no habían llegado al oeste, y el oeste ya había aceptado escrituras nuevas, de modo que no se podía volver atrás sin más. El servicio estuvo degradado 24 horas y 11 minutos. El informe dice que al final no se perdieron datos de usuarios, que quedó una reconciliación manual en curso, y que solo en uno de los clusters más activos hubo 954 escrituras en esa ventana. Es el laboratorio de esta semana a otra escala: replicación asíncrona, un corte de red corto, un failover automático y dos historias que alguien tuvo que juntar a mano. Fuente: GitHub, October 21 post-incident analysis.
Idea clave. Un failover no es “la réplica toma el lugar del principal”. Es una decisión tomada con información incompleta (¿murió o está lento?) que puede perder escrituras confirmadas y puede dejar dos líderes. Las tres preguntas que un diseño tiene que responder por escrito: cuánto se tarda en detectar, cuánto de lo confirmado se puede perder, y qué impide que el anterior siga escribiendo.
Varios líderes
Para qué
La replicación con un líder tiene un límite que ningún ajuste quita: toda escritura pasa por un nodo. Si ese nodo está lejos, la escritura es lenta; si no se llega a él, no se escribe. En la replicación con varios líderes (multi-leader replication), más de un nodo acepta escrituras, y cada uno replica las suyas a los demás, de forma asíncrona. Cada líder es, a la vez, seguidor de los otros.
Hay tres situaciones en las que eso vale lo que cuesta:
- Varios centros de datos. Un líder en cada región. Cada usuario escribe en el suyo, con latencia local, y si una región queda aislada, las demás siguen escribiendo.
- Aplicaciones que funcionan sin conexión. La aplicación de notas o de calendario del celular acepta cambios en un túnel. Cada dispositivo es un líder con su propia base de datos local, y la “red entre líderes” puede estar cortada durante horas o días.
- Edición colaborativa. Varias personas escriben en el mismo documento a la vez, y cada una ve sus propios cambios al instante, sin esperar al servidor.
En las tres, el requisito es el mismo: poder escribir aunque no se pueda hablar con los demás nodos.
El conflicto
El precio aparece con el primer par de escrituras concurrentes sobre el mismo dato. Rosa cambia su nombre a “Rosa Quispe Mamani” desde el celular, sin señal. En su laptop, que tampoco había sincronizado, lo había cambiado a “Rosa Quispe M.”. Las dos escrituras se aceptaron, cada una en su líder, y cada líder respondió “confirmado”. Cuando por fin se replican, cada nodo recibe una escritura que contradice la suya.
Con un líder, esto no puede pasar: la segunda escritura llega al mismo nodo que la primera, y ese nodo la ordena después, o la rechaza, o la hace esperar un lock. Con varios líderes, nadie detectó el conflicto al escribir, porque en ese momento ningún nodo conocía las dos escrituras. Se detecta después, cuando ya se le dijo “listo” a las dos personas, y ya no se puede rechazar a ninguna.
Es el split brain de la sección anterior, convertido de accidente en diseño. La diferencia es que un sistema con varios líderes sabe que va a pasar y tiene decidido qué hacer.
Qué hacer con un conflicto
Hay cuatro respuestas. Ninguna es la correcta en general.
Evitarlo. Si todas las escrituras de un mismo dato pasan siempre por el mismo líder, no hay conflictos: cada usuario tiene una región “de casa” y sus datos se escriben solo ahí. Es la más usada porque es la más simple. Falla en los bordes: cuando el usuario se muda, o cuando su región se cae y hay que enviarlo a otra, vuelve a haber dos líderes para el mismo dato.
Resolverlo con una regla fija. La más común es que la última escritura gana (last write wins, LWW): cada escritura lleva una marca de tiempo, y al encontrar dos, se conserva la de la marca más alta y se descarta la otra. Todos los nodos aplican la misma regla, así que todos terminan con el mismo valor. Es simple, converge, y pierde datos en silencio: una de las dos escrituras, a la que se le respondió “confirmado”, desaparece sin que nadie reciba un error.
Conservar las dos versiones. El sistema guarda ambas y se las entrega a quien lea. La aplicación las fusiona si sabe cómo (dos carritos de compras se unen), o se las muestra al usuario para que elija. No pierde nada, y a cambio toda lectura puede devolver más de un valor y todo el código que lee tiene que estar preparado para eso.
Usar tipos de datos diseñados para converger. Los CRDT (conflict-free replicated data types) son estructuras cuyas operaciones se pueden aplicar en cualquier orden y dan el mismo resultado: un contador que solo suma, un conjunto al que se agregan elementos, un texto compartido. El conflicto se resuelve por construcción. El límite es que no todo dato se deja modelar así.
Que no haya una resolución correcta se ve con dos datos de un mismo sistema. En un contador de visitas, dos incrementos concurrentes se suman y nadie pierde nada. Dos ventas concurrentes del mismo asiento no se pueden sumar, ni fusionar, ni decidir con una regla que deje contentas a las dos personas que pagaron. Qué significa “resolver” depende de qué significa el dato.
La última escritura gana, y los relojes
LWW necesita saber cuál escritura fue la última, y lo más a mano es el reloj de la máquina que la aceptó. Pero cada máquina tiene el suyo, y no marcan lo mismo: se sincronizan por la red, con un error que depende de la red, y se adelantan, se atrasan y a veces saltan. Una diferencia de decenas de milisegundos entre dos servidores no es una falla: es lo normal.
El archivo quorum/lww.ts lo modela con dos
nodos. Cada uno sella sus escrituras con la hora verdadera más lo que su reloj
esté adelantado y, al recibir una escritura del otro, se queda con la del
sello más alto. El reloj del nodo de Lima adelanta 500 ms. Rosa escribe su
nombre en Lima en el instante 1 000, y lo corrige en Cusco en el instante
1 200, doscientos milisegundos después (make quorum):
== La última escritura gana, con el reloj de Lima adelantado 500 ms
t = 1000 ms, en lima:  "Rosa Quispe" con sello 1500
t = 1200 ms, en cusco: "Rosa Quispe Mamani" con sello 1200
después de replicar: lima = "Rosa Quispe", cusco = "Rosa Quispe"
Los dos nodos convergieron, que es lo que LWW promete. Convergieron al valor anterior: la corrección, que ocurrió después, llevaba un sello más bajo y se descartó en los dos nodos. Nadie recibió un error.
Hay un caso todavía más incómodo, que es una de las pruebas de la semana. La segunda escritura puede perderse aunque quien la hizo ya había visto la primera:
const first = lima.write('2 entradas', 1000);
cusco.receive(first); // cusco ya tiene la primera: no hay concurrencia alguna
assert.equal(cusco.value, '2 entradas');
cusco.write('3 entradas', 1200); // sello 1200 < 1500: el propio nodo la descarta
assert.equal(cusco.value, '2 entradas');
Aquí no hay conflicto alguno: es una escritura, y después otra que la modifica. El nodo de Cusco descarta la que él mismo acaba de aceptar, porque su reloj dice que es más vieja que la que ya tenía.
Error común. “La última escritura gana” usando el reloj de cada máquina. Los relojes difieren, y la escritura que gana puede ser la que ocurrió antes. LWW con relojes de pared solo es aceptable cuando perder una escritura de vez en cuando no importa (una cache, el último “visto a las…”), y hay que decirlo en voz alta al elegirlo, porque el sistema nunca va a avisar.
Versiones en vez de relojes
Para decidir cuál de dos escrituras es más reciente sin mirar la hora, hay que registrar otra cosa: qué conocía cada una cuando se hizo. Si la escritura B se hizo habiendo visto A, B reemplaza a A, sin importar lo que digan los relojes. Si ninguna había visto a la otra, son concurrentes, y eso también es información: significa que hay un conflicto real, y no que una sea vieja.
Un vector de versiones (version vector) lleva esa cuenta: un contador por
nodo. Cada escritura lleva el vector de lo que su autor había visto, con el
contador del nodo que la aceptó aumentado en uno. Comparar dos vectores da
una de cuatro respuestas: iguales, anterior, posterior o concurrentes (la
función compare de
quorum/version-vector.ts).
Los dos casos de arriba, con vectores:
| Caso | Primera escritura | Segunda escritura | Comparación | Qué hace el sistema |
|---|---|---|---|---|
| Cusco había recibido la de Lima | { lima: 1 } |
{ lima: 1, cusco: 1 } |
la primera es anterior | Se queda con la segunda |
| Ninguno conocía al otro | { lima: 1 } |
{ cusco: 1 } |
concurrentes | Conserva las dos |
En el primer caso gana la escritura correcta sin consultar ningún reloj. En el segundo, el sistema sabe que no puede elegir, y conserva las dos versiones en vez de descartar una al azar. Lo que haga después con ellas es una de las cuatro respuestas de la sección anterior; lo que cambió es que ahora el conflicto se ve. El costo: cada valor guarda un vector que crece con el número de nodos que lo escribieron, y las lecturas pueden devolver varias versiones.
Sin líder
La forma
La tercera forma abandona la idea de líder. En la replicación sin líder (leaderless replication), cualquier réplica acepta escrituras y lecturas, y quien coordina cada operación es el cliente, o un nodo cualquiera que hace de coordinador para esa petición:
- Para escribir, se envía la escritura a todas las réplicas a la vez, y se la da por confirmada cuando respondieron algunas.
- Para leer, se pregunta a varias réplicas, y se toma la respuesta más nueva.
No hay failover, porque no hay a quién reemplazar. A cambio, las réplicas pueden tener valores distintos para la misma clave en cualquier momento, y cada lectura tiene que resolverlo.
Este diseño es anterior, pero se hizo conocido con Dynamo, el almacén que
Amazon describió en 2007, y por eso se habla de sistemas “al estilo Dynamo”.
PostgreSQL no trabaja así, de modo que para esta parte usamos un simulador:
quorum/cluster.ts. Es determinista: no
hay red ni azar; quien lo usa dice a qué réplicas llega cada petición, y por
eso las pruebas pueden recorrer todos los casos en vez de esperar a que
alguno ocurra. Cada réplica es un mapa de clave a valor con un número de
versión (quorum/replica.ts), y al
recibir un valor lo guarda solo si su versión es más alta que la que tiene.
Una simplificación a propósito: en el simulador, las versiones salen de un solo contador, como si un único cliente escribiera una cosa después de otra. Así se puede estudiar la pregunta de esta sección (¿la lectura ve la última escritura?) separada de la del orden entre escrituras concurrentes, que ya vimos que necesita vectores de versiones.
Quórums
Tres números describen un sistema sin líder:
- : cuántas réplicas guardan cada dato.
- : cuántas tienen que confirmar una escritura para darla por hecha.
- : cuántas se consultan en cada lectura.
Al grupo de réplicas que confirmó una escritura se le llama su quórum de escritura, y al grupo de que respondió una lectura, su quórum de lectura.
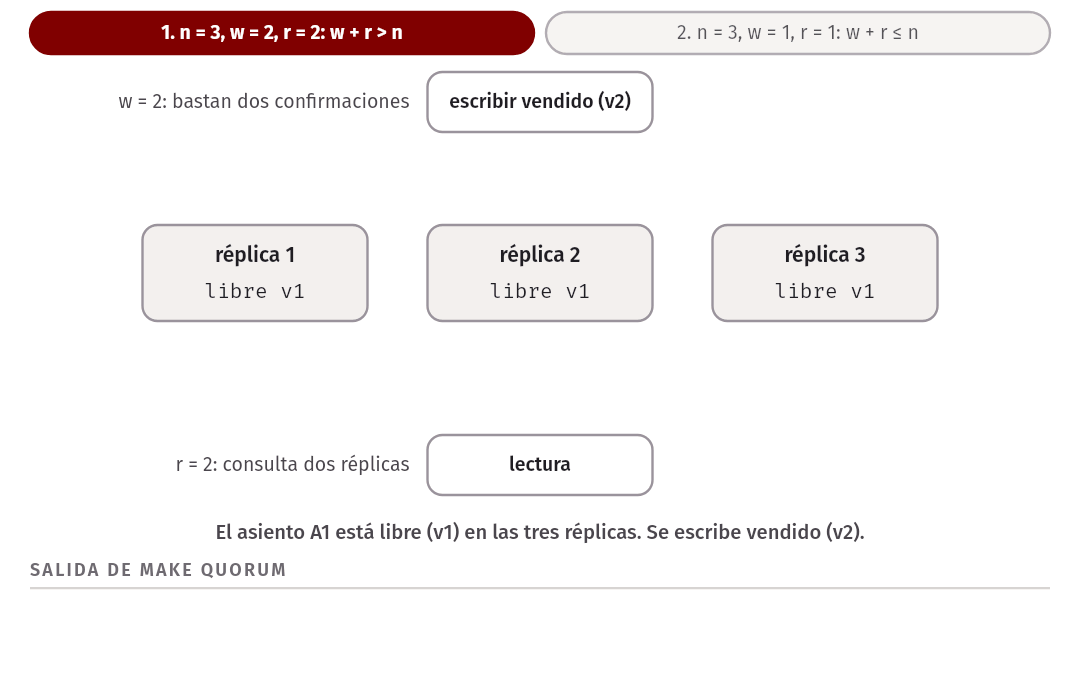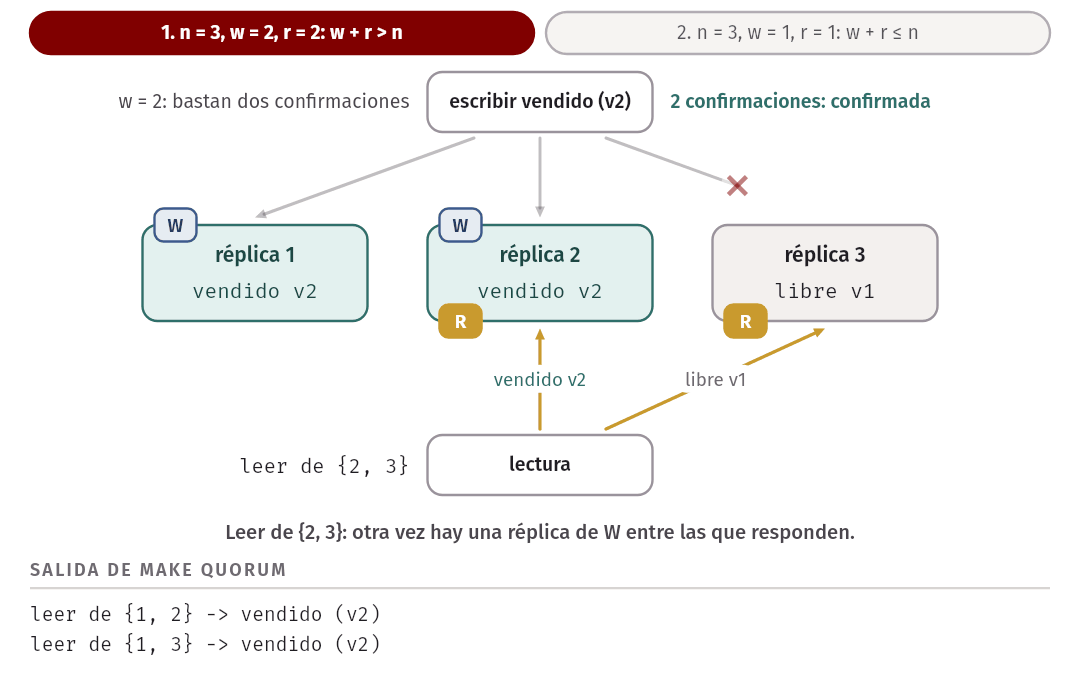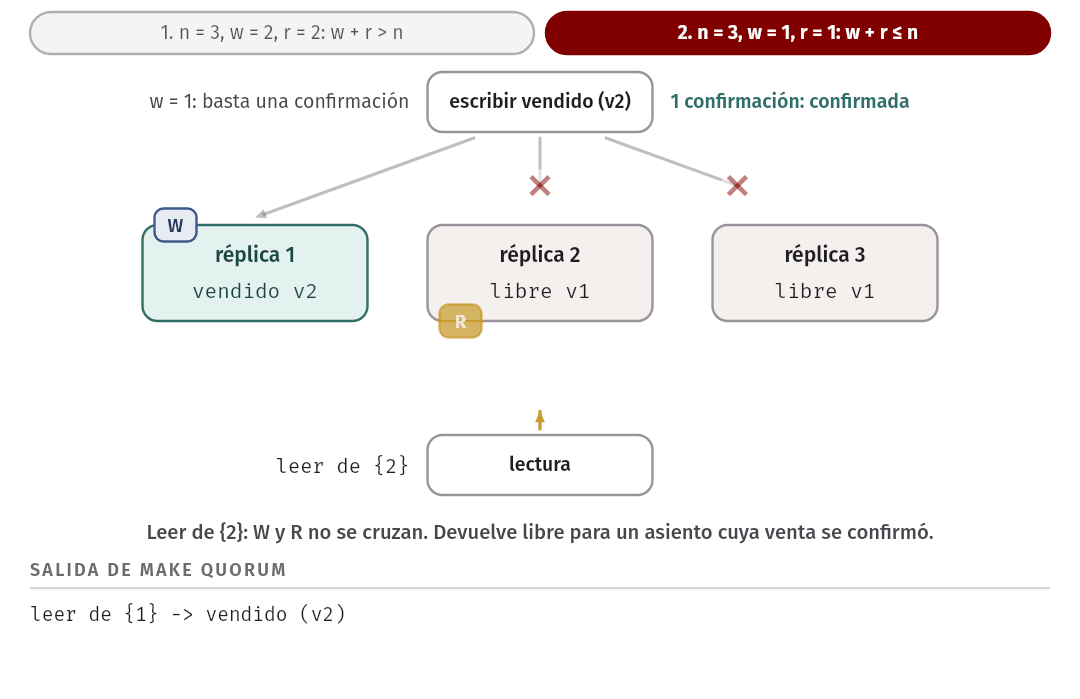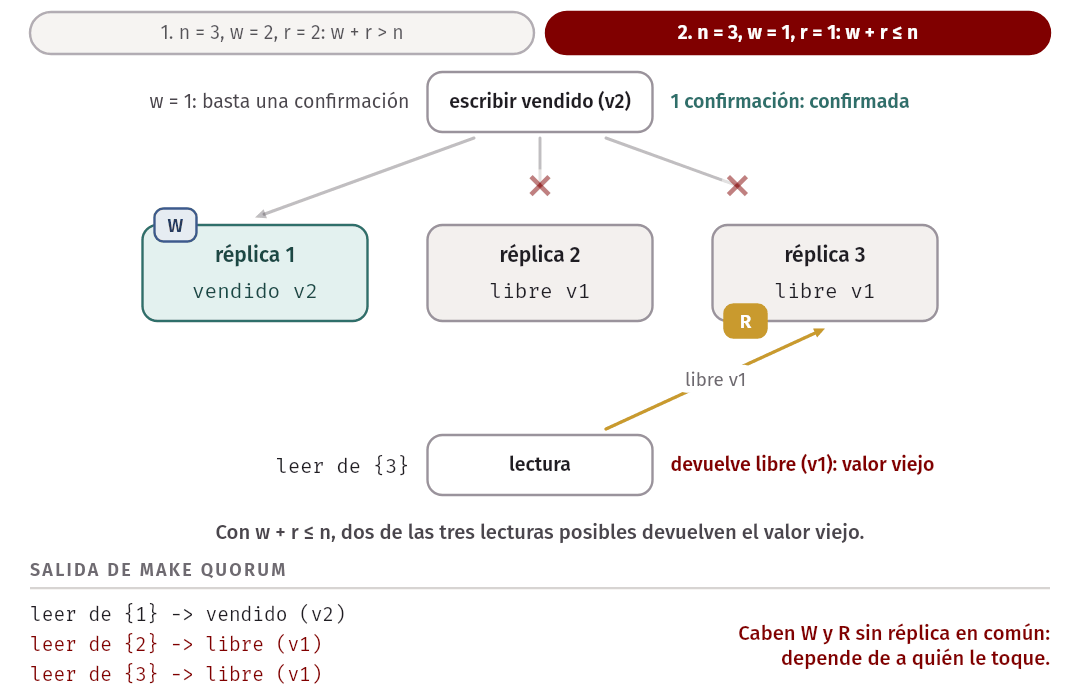
La escritura del simulador envía el valor a las réplicas que alcanza, cuenta
las que lo guardaron y se confirma si fueron al menos . Con ,
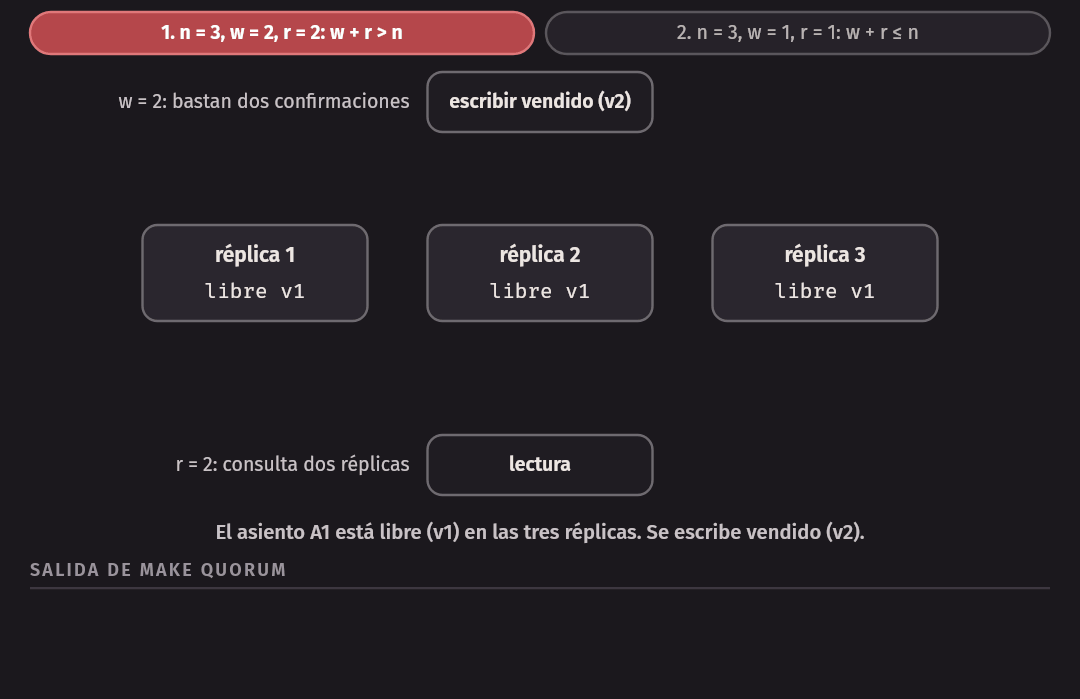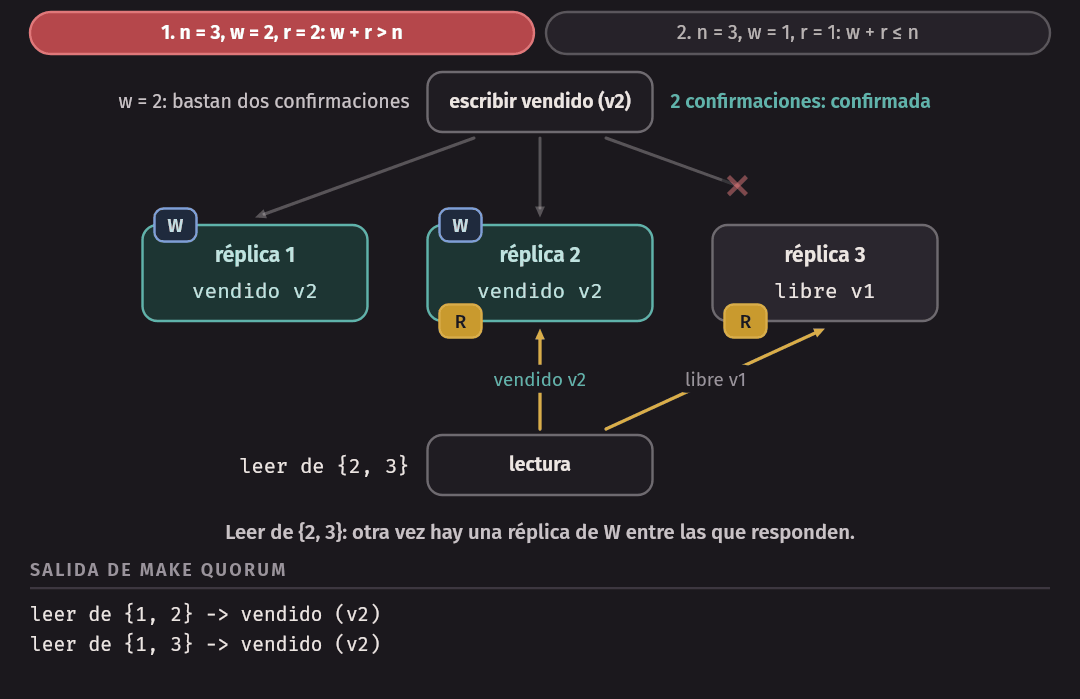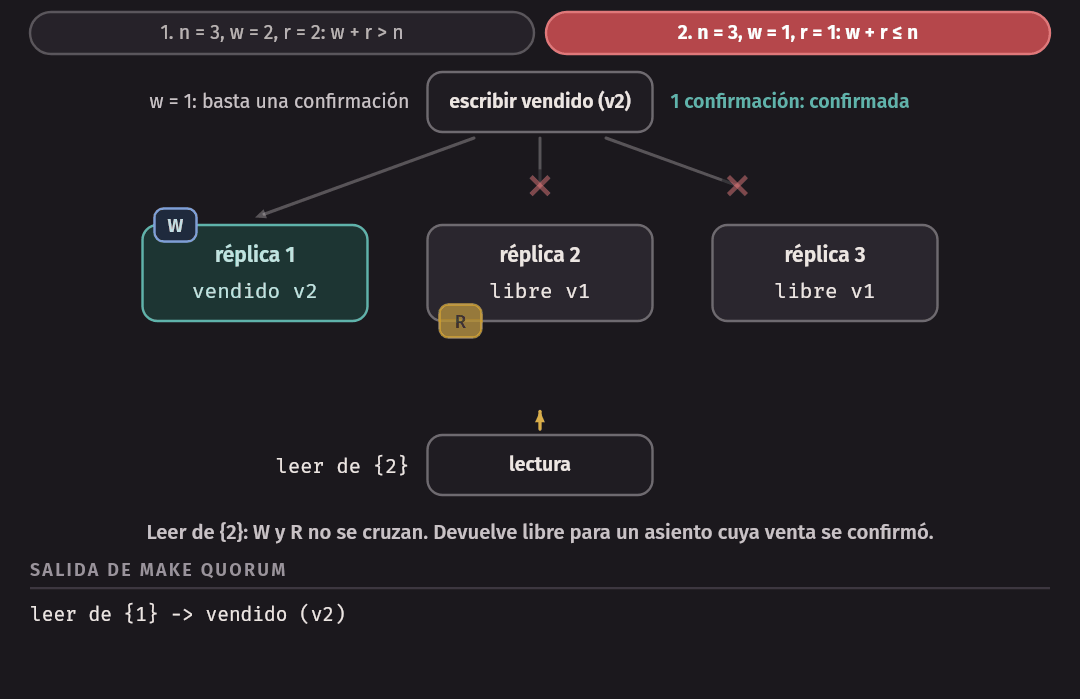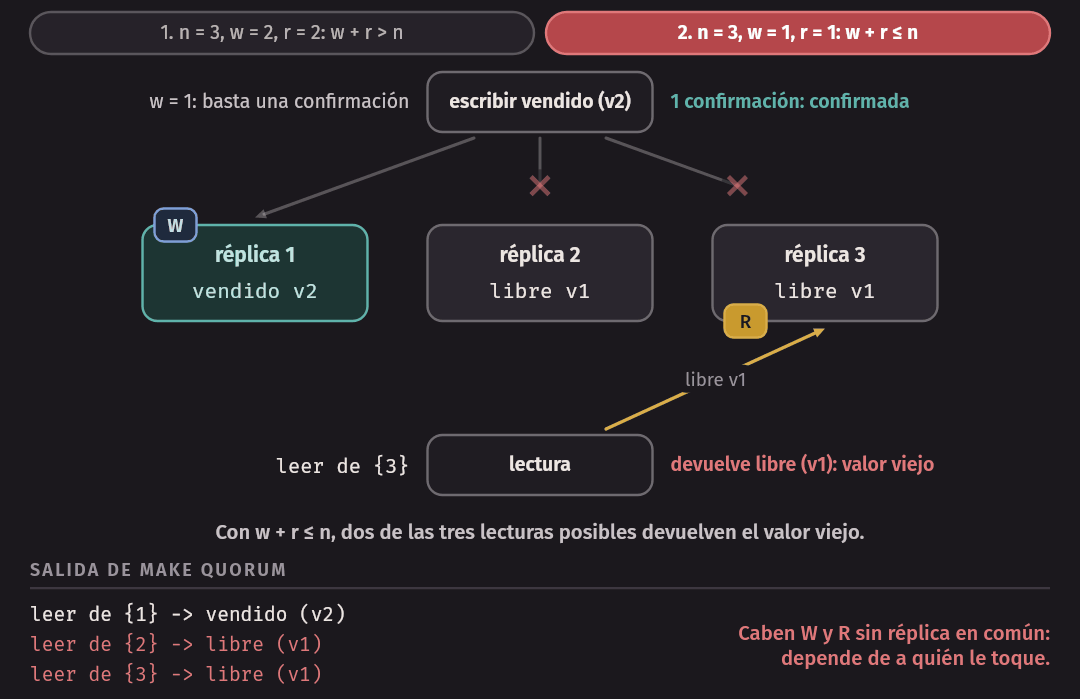
y : el asiento A1 está libre en las tres réplicas, y la
escritura vendido llega solo a la 1 y a la 2. Se confirma, porque dos
alcanzan. La réplica 3 se quedó con el valor viejo. Ahora se lee, de cada par
posible de réplicas (make quorum):
== n = 3, w = 2, r = 2: la escritura llega a dos réplicas y se lee de otras dos
r1: vendido v2 | r2: vendido v2 | r3: libre v1
  leer de {1, 2} -> vendido (v2)
  leer de {1, 3} -> vendido (v2)
  leer de {2, 3} -> vendido (v2)
Las tres lecturas devuelven vendido, incluidas las dos que consultaron a la
réplica atrasada. En cada una, al menos una de las dos respuestas traía la
versión 2, y la lectura se queda con la versión más alta.
Ahora con y : la escritura llega solo a la réplica 1 y se confirma igual.
== n = 3, w = 1, r = 1: w + r <= n, y la lectura depende de a quién le toque
escritura confirmada: sí (con 1 réplica)
r1: vendido v2 | r2: libre v1 | r3: libre v1
  leer de {1} -> vendido (v2)
  leer de {2} -> libre (v1)
  leer de {3} -> libre (v1)
Dos de las tres lecturas posibles devuelven libre para un asiento cuya venta
ya se confirmó.
El argumento del solapamiento
La diferencia entre los dos casos es una cuenta. Sea el conjunto de réplicas que confirmaron la última escritura y el conjunto que respondió la lectura. Los dos son subconjuntos de las mismas réplicas, así que su unión no puede tener más de elementos:
Si , entonces : al menos una réplica está en los dos conjuntos. Esa réplica confirmó la escritura y respondió la lectura, así que entre las respuestas de la lectura hay al menos una con el valor más reciente, y como la lectura se queda con la versión más alta, lo devuelve.
Si , la cuenta no obliga a nada: caben un quórum de escritura y uno de lectura sin ninguna réplica en común, y esa lectura devuelve un valor viejo. No pasa siempre. Pasa cuando los conjuntos no se cruzan, y por eso es de los errores que pasan las pruebas y aparecen en producción.
Las pruebas de test/quorum.test.ts
comprueban las dos direcciones sin confiar en el argumento. La primera recorre
todos los valores de hasta 7, todos los y , y todos los pares de
subconjuntos de esos tamaños, y verifica que todos los pares se cruzan
exactamente cuando :
test('w + r > n equivale a que todo quórum de lectura se cruce con todo quórum de escritura', () => {
  for (let n = 1; n <= 7; n++) {
    for (let w = 1; w <= n; w++) {
      for (let r = 1; r <= n; r++) {
        const alwaysIntersect = subsets(n, w).every((ws) => subsets(n, r).every((rs) => intersects(ws, rs)));
        assert.equal(alwaysIntersect, w + r > n, `n=${n} w=${w} r=${r}`);
      }
    }
  }
});
Otras dos hacen lo mismo con el simulador: con , la lectura devuelve la última escritura confirmada en todos los repartos posibles; con , devuelve el valor viejo exactamente en los repartos en que los conjuntos no se cruzan, y existe al menos uno.
Idea clave. no dice que todas las réplicas estén al día. Dice que toda lectura toca al menos una réplica que sí lo está. La consistencia no viene de que las copias sean iguales, sino de que los conjuntos se solapan y de que hay una forma de saber cuál respuesta es la más nueva.
Mover el punto
La misma cuenta dice cuántas réplicas pueden faltar. Una escritura necesita respuestas, así que tolera réplicas caídas. Una lectura tolera . Con :
== Cuántas réplicas caídas tolera cada configuración con n = 3
  w = 2, r = 2: escribe con 1 caída(s), lee con 1 caída(s), se solapan
  w = 3, r = 1: escribe con 0 caída(s), lee con 2 caída(s), se solapan
  w = 1, r = 3: escribe con 2 caída(s), lee con 0 caída(s), se solapan
  w = 1, r = 1: escribe con 2 caída(s), lee con 2 caída(s), NO se solapan
Las tres primeras cumplen y reparten el costo de forma distinta:
- , : el punto medio. Tolera una réplica caída para leer y para escribir. Con impar, , una mayoría, es la elección habitual.
- , : lecturas rápidas (basta una respuesta) que siguen funcionando con dos réplicas caídas. A cambio, una sola réplica caída detiene todas las escrituras. Es, en el fondo, replicación síncrona con todas.
- , : al revés. Las escrituras casi nunca fallan; cada lectura tiene que esperar a las tres, y una réplica caída las detiene.
La cuarta, y , es la más rápida y la más disponible, y no garantiza leer lo escrito. Tampoco es un error por sí misma: es elegir consistencia eventual a cambio de latencia, y para algunos datos es la elección correcta.
La latencia sigue a los mismos números: una operación tarda lo que tarde la más lenta de las (o ) respuestas que necesita.
Trade-off. Subir compra durabilidad y consistencia y cobra latencia y disponibilidad de escritura; subir hace lo mismo con las lecturas. Mientras , mover uno hacia arriba permite bajar el otro. No existe una terna que sea la mejor: depende de si el sistema lee mucho más de lo que escribe, y de cuál de las dos operaciones no puede fallar.
Read repair y anti-entropía
En el primer ejemplo, la réplica 3 se quedó con libre. ¿Cuándo se pone al
día? Sin líder no hay un log que alguien le reenvíe. Hay dos mecanismos.
Read repair. Una lectura ya tiene delante las respuestas de varias réplicas. Si no coinciden, sabe cuáles están atrasadas, y les escribe el valor más nuevo antes de terminar:
== Read repair: la réplica 3 estuvo caída durante una escritura
antes:   r1: vendido v2 | r2: vendido v2 | r3: libre v1
leer de {2, 3} -> vendido; reparadas: {3}
después: r1: vendido v2 | r2: vendido v2 | r3: vendido v2
Es barato, porque aprovecha un trabajo que ya se estaba haciendo, y solo repara lo que alguien lee. Una clave que nadie consulta puede quedarse desactualizada indefinidamente, y cada réplica que la tenga al día es una réplica menos de margen si las otras fallan.
Anti-entropía. Un proceso de fondo compara las réplicas entre sí y copia lo que falte, sin esperar lecturas. Repara todo, y gasta red y disco de forma continua; los sistemas reales comparan resúmenes de los datos (árboles de hashes) para no tener que enviar todo cada vez.
Se usan los dos: read repair para lo que se lee seguido, anti-entropía para lo demás.
Lo que los quórums no garantizan
es una garantía con letra pequeña. La cuenta supone que hubo una escritura que terminó, y después una lectura. Fuera de eso, un sistema con quórums bien configurados puede devolver un valor viejo. Cuatro casos; los tres primeros son pruebas de la semana.
Una escritura que falló a medias. La escritura llegó a una sola réplica, no alcanzó , y al cliente se le respondió que falló. Nadie la deshace: esa réplica la conserva.
const failed = cluster.write('k', 'b', [1]);
assert.equal(failed.ok, false);
assert.deepEqual(failed.acks, [1]);

// Según a quién se pregunte, el valor "fallido" aparece o no.
assert.equal(cluster.read('k', [2, 3]).value, 'a');
assert.equal(cluster.read('k', [1, 2]).value, 'b');
// Y read repair lo acaba de propagar: ahora lo ve cualquier quórum que incluya a la 2.
assert.equal(cluster.read('k', [2, 3]).value, 'b');
Una escritura que “falló” se vuelve visible, y después read repair la propaga al resto. Para quien escribe, un error en un sistema con quórums no significa “no se escribió”; significa “no sé si se escribió”, igual que la orden 655 del failover.
Una réplica restaurada con datos viejos. La escritura se confirmó con las réplicas 1 y 2. La 1 pierde su disco y se restaura de un respaldo anterior. Ahora el valor nuevo vive solo en la 2, y un quórum de lectura formado por la 1 y la 3 no lo ve. El número de réplicas que tienen el dato bajó de sin que ninguna escritura fallara.
Escrituras concurrentes. Si dos clientes escriben la misma clave a la vez y cada escritura llega a las réplicas en distinto orden, el sistema tiene que decidir cuál es “la más nueva”. Con marcas de tiempo vuelve a ser LWW con todos sus problemas. Por eso los sistemas de este tipo que no quieren perder escrituras usan vectores de versiones y conservan las versiones concurrentes.
Una lectura mientras la escritura está en curso. Si la escritura todavía no llegó a réplicas, una lectura puede ver el valor nuevo y la siguiente, con otro quórum, el viejo.
Error común. Leer "" como “consistencia fuerte”. Garantiza que una lectura posterior a una escritura completada con éxito la ve, si nada más pasó. No da transacciones, no ordena escrituras concurrentes y no impide que una lectura vea un valor que la siguiente no ve. Cuando hace falta un orden único, la herramienta es otra (un líder, o consenso).
Borrar: tombstones
Borrar parece el caso fácil y es el que más sorprende. El carrito de Rosa tiene una entrada VIP, guardada en las tres réplicas. Rosa la quita mientras la réplica 3 está caída. Las réplicas 1 y 2 borran la clave; con , el borrado se confirma. Después vuelve la réplica 3:
== Borrar con la réplica 3 caída, sin tombstones
borrado confirmado: sí
  r1: - | r2: - | r3 (caída): entrada VIP v1
vuelve la réplica 3; leer de {2, 3} -> entrada VIP; reparadas: {2}
  r1: - | r2: entrada VIP v1 | r3: entrada VIP v1
La entrada resucitó. La lectura consultó a la réplica 2, que no tiene nada, y a la 3, que tiene la entrada en su versión 1. Desde afuera, esa situación es indistinguible de “la réplica 2 estuvo caída cuando se escribió la entrada”: una réplica tiene el dato, la otra no. La lectura hace lo que haría en ese caso, devolver el dato, y read repair “arregla” a la réplica 2, que era la que estaba bien. La ausencia de un dato no lleva versión, así que no puede ganarle a nada.
La solución es que borrar sea una escritura: en vez de quitar la clave, se guarda una marca de borrado, un tombstone, con su propia versión, que se replica como cualquier otro valor.
delete(key: string, to: number[] = this.all()): WriteResult {
  if (this.config.tombstones) return this.store(key, null, to);
  …
}
== Borrar con la réplica 3 caída, con tombstones
borrado confirmado: sí
r1: tombstone v2 | r2: tombstone v2 | r3 (caída): entrada VIP v1
vuelve la réplica 3; leer de {2, 3} -> no existe; reparadas: {3}
r1: tombstone v2 | r2: tombstone v2 | r3: tombstone v2Ahora el borrado tiene la versión 2, le gana a la entrada en su versión 1, y read repair corrige a la réplica correcta.
Los tombstones ocupan espacio, y un sistema que borra mucho se llena de ellos.
Se pueden purgar, pero solo cuando todas las réplicas los tienen: si se
purga antes, la réplica que no vio el borrado vuelve a resucitar el dato. Las
dos últimas pruebas de test/tombstone.test.ts
muestran los dos casos. En los sistemas reales, ese plazo de espera es un
parámetro de operación, y una réplica que estuvo caída más tiempo que el plazo
no puede simplemente volver.
Dynamo: una arquitectura derivada de un escenario
En 2007, un grupo de ingenieros de Amazon publicó la descripción de Dynamo, el almacén clave-valor detrás de varios servicios de su tienda. Es una lectura recortada de esta semana (secciones 1, 2 y 4), y vale por algo más que por los quórums: es un ejemplo limpio de una arquitectura que se deriva de un escenario de disponibilidad, paso por paso, como el curso viene pidiendo desde la semana 2.
El escenario. El ejemplo que el artículo repite es el carrito de compras. El requisito, en sus palabras, es un almacén “always writeable”: un cliente tiene que poder agregar y quitar productos de su carrito aun en medio de fallas de servidores y de red, porque rechazar esa operación es una mala experiencia para el cliente (sección 2.3). La medida también está escrita: los acuerdos de nivel de servicio se expresan en el percentil 99,9 de la latencia, no en el promedio ni en la mediana, y el ejemplo que da es responder en 300 ms al 99,9 % de las peticiones (sección 2.2). A cambio, estos servicios solo necesitan leer y escribir por clave, y pueden operar con una consistencia más débil (sección 2.1).
Del escenario al diseño. Cada decisión de la sección 4 responde a ese requisito:
| Requisito | Decisión | Lo que cuesta |
|---|---|---|
| Aceptar escrituras aunque fallen nodos o la red | Sin líder: no hay un nodo cuya caída detenga las escrituras | Las réplicas pueden divergir |
| Que cada servicio elija su punto | , y configurables; con se obtiene un sistema de quórum (sección 4.5) | Elegirlos mal es fácil |
| No rechazar una escritura por un nodo caído | Si falta una de las réplicas, la escritura va a otro nodo, que la guarda con una nota para devolverla después (sección 4.6) | Los conjuntos ya no se solapan siempre |
| No perder un “agregar al carrito” | Versiones con relojes vectoriales; las versiones en conflicto se conservan y la aplicación las fusiona al leer (sección 4.4) | Toda lectura puede traer varias versiones |
| Réplicas que estuvieron caídas | Sincronización de fondo entre réplicas (sección 4.7) | Trabajo continuo de red y disco |
La tercera fila explica por qué Dynamo no es exactamente el simulador de esta semana. Con quórums estrictos, si faltan demasiadas réplicas de una clave, la escritura se rechaza; Dynamo prefiere aceptarla en otro nodo sano. Gana disponibilidad de escritura y pierde, mientras dura la falla, la garantía de solapamiento. El artículo dice que una aplicación que quiera la máxima disponibilidad puede usar , y que la mayoría de los servicios elige un valor más alto por durabilidad.
La cuarta fila es la decisión más característica, y el artículo es honesto sobre su costo. Al fusionar dos versiones del carrito, la aplicación une sus contenidos: así ningún “agregar” se pierde. Pero el propio texto advierte que, con esa fusión, los productos borrados pueden reaparecer (sección 4.4). Es la resurrección de la sección anterior, aceptada a sabiendas: para un carrito, que vuelva un producto que el cliente quitó es una molestia; que desaparezca uno que agregó es una venta perdida.
Lo que hay que llevarse. Dynamo es la respuesta a un escenario muy preciso: escrituras que no se pueden rechazar, sobre datos que se pueden fusionar. Cambien cualquiera de las dos cosas y el diseño deja de tener sentido: un asiento no se puede fusionar, y para venderlo hace falta justo lo que Dynamo sacrificó. El artículo es un buen modelo de cómo se justifica una arquitectura, y un mal catálogo del que copiar decisiones.
En la industria. El artículo cuenta que la configuración común de en las instancias de Dynamo era (lo dice en la sección 6, fuera de la lectura recortada): justo el punto medio de Mover el punto. Fuente: DeCandia y otros, Dynamo: Amazon’s Highly Available Key-value Store (2007).
Cómo se elige
Las tres formas responden distinto a las tres preguntas del comienzo:
| Un líder | Varios líderes | Sin líder | |
|---|---|---|---|
| Quién acepta escrituras | Un nodo | Varios, cada uno las suyas | Cualquier réplica |
| Orden de las escrituras | Uno solo, el del líder | Uno por líder; hay conflictos | Ninguno global; versiones |
| Si cae un nodo que escribe | Failover: segundos o minutos sin escribir, y sus riesgos | Los demás líderes siguen | Se sigue, si quedan |
| Escribir sin conexión con los demás | No | Sí | Sí, si quedan a la vista |
| Qué puede leerse | El pasado, en un seguidor | El pasado, y conflictos por resolver | El pasado si ; versiones en conflicto |
| Transacciones y restricciones | Las de siempre | Solo dentro de un líder | Por clave, y limitadas |
| Lo más difícil de operar | El failover | La resolución de conflictos | Elegir , , y vivir con las versiones |
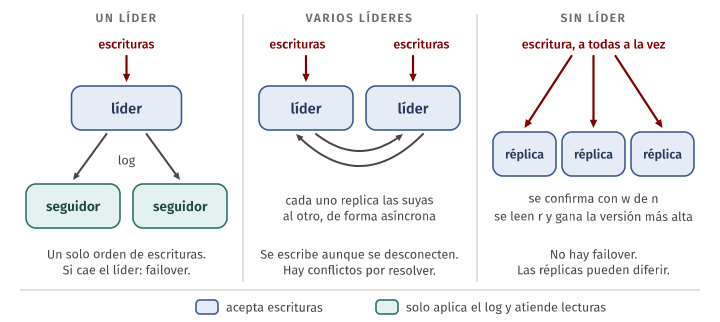
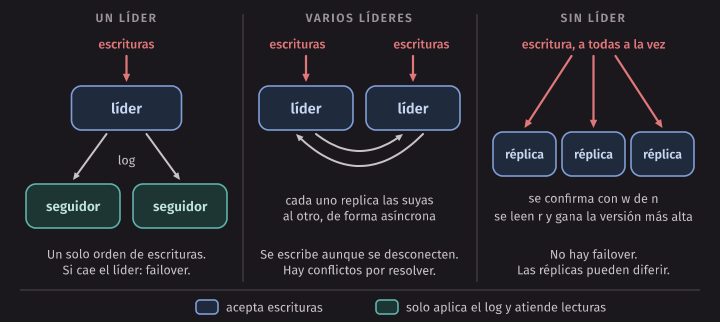
El criterio, en una frase por forma:
- Un líder cuando hace falta un orden único de las escrituras (transacciones, restricciones de unicidad, “no vender dos veces”) y se tolera un failover de vez en cuando. Es el punto de partida razonable para casi cualquier sistema, y muchos nunca necesitan otra cosa.
- Varios líderes cuando hay que escribir en varios lugares aunque se desconecten (regiones, dispositivos sin conexión), y los conflictos son raros o tienen una resolución natural para ese dato.
- Sin líder cuando la disponibilidad de escritura importa más que leer siempre lo último, y los datos son por clave y se pueden fusionar o reemplazar sin daño.
No es una elección por sistema. Es una elección por dato, y un sistema puede usar más de una: las órdenes en una base de datos con un líder y los contadores en un almacén sin líder. Lo que se paga entonces es la persistencia políglota de la semana pasada: más piezas que operar y ninguna transacción que las cubra a todas.
En Tinkuy. Los asientos necesitan un orden único. Dos compras del mismo asiento no se pueden fusionar ni resolver con “la última gana”: una tiene que perder, y tiene que enterarse antes de que le cobren. Eso es un líder, con la comprobación y la venta en la misma transacción. Un contador de visitas de un evento, en cambio, toleraría cualquiera de las otras dos formas: dos incrementos concurrentes se suman, y si se pierde una visita no pasa nada. Que los dos datos vivan en el mismo sistema no obliga a tratarlos igual; obliga a decidir, para cada uno, qué significa un conflicto.
El código de la semana
Todo está en code/week-10/ y se usa dentro del contenedor del curso.
| Carpeta o archivo | Qué es |
|---|---|
db/schema.sql |
Las tres tablas de la semana |
read-your-writes.ts |
La anomalía: escribir en el principal y leer enseguida en la réplica |
replication/burst.ts |
La ráfaga de escrituras: latencia y retraso |
replication/monotonic-reads.ts |
Una lectura que retrocede |
errors/lsn-before-commit.ts |
La posición del WAL tomada antes del commit |
lab/routing.ts, lab/compare.ts |
El punto de partida del paso 5 del laboratorio y su comparación |
failover/ |
El escritor de órdenes numeradas, la comparación, y los scripts que matan al principal y cortan el enlace |
quorum/ |
El simulador: réplicas, quórums, LWW y vectores de versiones |
test/ |
Las pruebas de las afirmaciones del capítulo |
make test revisa los tipos y corre las pruebas. Las del simulador no
necesitan nada; las de PostgreSQL crean la réplica si no existe, usan su
propia base de datos (arq_w10_test) y dejan la réplica como la encontraron,
asíncrona y sin demora. Para que las anomalías no dependan de la suerte, esas
pruebas ponen una demora de aplicación de 1,5 s en la réplica: durante ese
tiempo, lo confirmado en el principal no está en ella, siempre.
$ make test
tsc -p .
W10_DB=arq_w10_test node --test --test-concurrency=1 "test/*.test.ts"
✔ con relojes iguales, LWW se queda con la escritura posterior (0.830875ms)
…
✔ w + r > n equivale a que todo quórum de lectura se cruce con todo quórum de escritura (9.248208ms)
✔ con w + r > n, la lectura devuelve la última escritura confirmada, sea cual sea el reparto (2.575709ms)
✔ con w + r <= n hay repartos en los que la lectura devuelve un valor viejo (1.871209ms)
…
✔ un DELETE también se replica: la réplica no es un respaldo (15.506708ms)
✔ con retraso, quien escribe en el principal no encuentra su orden en la réplica (36.423625ms)
…
ℹ tests 32
ℹ suites 0
ℹ pass 32
ℹ fail 0
…
Cada prueba lleva en el nombre la afirmación que comprueba. Vale la pena leer
test/quorum.test.ts junto con Lo que
los quórums no garantizan, y test/replica.test.ts
junto con Síncrona no es read-your-writes.
Las pruebas no hacen failover: dejarían el contenedor en un estado del que el
siguiente make test no podría partir. Se hace a mano, en el laboratorio.
Laboratorio: una réplica de PostgreSQL
El laboratorio se hace en parejas, con code/week-10/ y dos terminales en el mismo contenedor. Van a matar un servidor de base de datos, y no pasa nada fuera de él. Anoten las salidas a medida que avanzan.
Dos avisos sobre el entorno, antes de empezar:
- Para matar al principal sirven
make kill-primaryysvc kill postgres: los dos matan solo al servidor del puerto 5432, sin aviso, y dejan viva a la réplica.svc start postgreslo devuelve. - Si
pg-replica createfalla conreplication slot "replica_1" already exists, la réplica anterior se borró con el principal caído y su slot quedó en él:psql -c "SELECT pg_drop_replication_slot('replica_1')". Para evitarlo, después de un failover levanten primero el principal (svc start postgres) y borren la réplica después (pg-replica destroy).
Paso 1: quién es quién. Corran make: crea la base de datos y la réplica.
Conéctense a cada servidor (psql -d arq_w10 y psql -p 5433 -d arq_w10) y
comprueben cuál está en recuperación con SELECT pg_is_in_recovery().
Intenten un INSERT en la réplica y lean el error completo. Busquen en
/var/lib/postgresql/replica los dos archivos que la hacen una réplica.
Paso 2: el viaje de un cambio. Escriban una orden en el principal y léanla
en la réplica. Corran make lag y la consulta completa a
pg_stat_replication de Mirar la replicación desde el principal. Para cada
una de las cuatro posiciones, digan con sus palabras qué garantiza. ¿Cuál de
ellas tiene que haber pasado una escritura para que una lectura en la réplica
la vea?
Paso 3: provocar retraso. Corran make burst tres veces y anoten las
cuatro líneas de cada corrida. Pongan una demora con make delay MS=2000 y
repitan. ¿Qué número cambió y cuál no, y por qué? Mientras la ráfaga corre,
miren make lag desde la otra terminal. Al terminar, make delay MS=0.
Paso 4: la anomalía. Lean read-your-writes.ts y, antes de correrlo,
escriban cuántas de cien órdenes creen que no va a encontrar, sin demora
alguna. Corran make anomaly tres veces y comparen con su predicción y con
el retraso que midieron en el paso 3.
Paso 5: corregirla de dos maneras. lab/routing.ts tiene dos funciones
sin terminar: chooseServer, para la estrategia (a), y waitForReplay, para
la (b). Tal como están, make compare muestra que ninguna corrige nada.
Complétenlas hasta que make test-lab pase, con una demora de 300 ms puesta
(make delay MS=300). Después corran make compare y llenen una tabla con
las tres estrategias: órdenes no encontradas, lecturas que fueron al
principal, y p50 y p95 de la lectura. Repitan con
THINK_MS=150 WINDOW_MS=100 make compare. ¿Qué cuesta cada una? ¿Qué supone
cada una? ¿Qué hace su waitForReplay si la réplica está detenida?
Paso 6: síncrona. Midan la latencia de escritura con
CLIENTS=1 WRITES=1000 make burst, tres veces. Activen la replicación
síncrona con make sync-on y repitan. Reporten las medianas y el cociente, y
digan cuánto varió cada una entre corridas. Luego, con la síncrona activada,
detengan la réplica (pg-replica stop) y escriban una orden con psql. Desde
la otra terminal, averigüen qué está esperando esa conexión
(pg_stat_activity) y cancélenla con pg_cancel_backend. Lean la advertencia
completa: ¿la orden quedó escrita o no? Vuelvan a iniciar la réplica
(pg-replica start) y a asíncrona (make sync-off).
Paso 7: failover. En una terminal, make writer. En la otra, después de
unos segundos: make kill-primary, pg-replica promote y
make compare-failover. ¿Cuál fue la última orden confirmada al cliente y
cuál es la última que existe en el nuevo principal? ¿Qué pasó con la orden que
quedó sin respuesta? Para repetir: svc start postgres, pg-replica destroy,
make. Háganlo al menos tres veces y junten los resultados con los de otras
parejas. Después repítanlo cortando el enlace un segundo antes de matar al
principal (make link-cut; tras matarlo, make link-restore). Por último,
una vez más con make sync-on antes de empezar. Con los tres resultados,
respondan: ¿con replicación síncrona habría pasado lo del segundo caso? ¿Qué
dejó de hacer el sistema a cambio?
Paso 8: split brain. Después de un failover, sin borrar nada, levanten el
principal antiguo: svc start postgres. Comprueben que los dos servidores
aceptan escrituras. Inserten en la tabla notes una fila distinta en cada
uno, y consulten la tabla en los dos. ¿Cómo se llama esta situación? ¿Qué
tendría que haberla impedido, y en cuál de los tres pasos del failover?
Propongan cómo decidirían cuál de las dos historias conservar, y qué harían
con las filas de la otra. Al terminar, pg-replica destroy.
Resumen
- Se replica por tres razones que son tres escenarios: seguir funcionando si una máquina falla, atender más lecturas y tener los datos cerca. La dificultad está en propagar los cambios.
- Con un líder, un nodo acepta las escrituras y los seguidores las aplican en su mismo orden. En PostgreSQL viaja el WAL, y el seguidor es una copia física de solo lectura, que se crea con un snapshot más el log desde ahí.
- Asíncrona: el líder no espera; es rápida, y un failover puede perder lo confirmado al final. Síncrona: el líder espera al seguidor; nada confirmado se pierde, cada escritura paga la espera (aquí, entre 1,4 y 2 veces la mediana), y un seguidor caído detiene las escrituras. Semisíncrona: esperar a uno de varios.
- El retraso de replicación hace que leer de un seguidor sea leer el pasado. Consistencia eventual dice que las copias convergen si se deja de escribir; no dice cuándo ni qué se ve mientras tanto.
- Tres anomalías y sus garantías: no leer lo que uno escribió (read-your-writes), lecturas que retroceden (lecturas monótonas) y efectos antes que sus causas (prefijo consistente). Sin demora alguna, entre 70 y 90 de cada 100 lecturas hechas tras escribir, según la corrida, no vieron la orden.
- Read-your-writes se da leyendo del líder lo propio, leyendo del líder un rato después de escribir (supone que el retraso es menor que la ventana), o esperando a que el seguidor alcance la posición de la escritura (lo mide, y hace esperar a la lectura). Replicación síncrona no es read-your-writes.
- Qué lectura va a dónde se decide por caso de uso y se escribe. Una lectura
que termina en una escritura va al líder. Y una réplica no es un respaldo:
replica un
DELETEequivocado en milisegundos. - Failover: detectar (con un timeout que siempre se equivoca hacia algún lado), elegir al nuevo líder y redirigir a los clientes. Con asíncrona se pueden perder escrituras confirmadas: 0, 1 o 3 con el enlace sano, cientos con el enlace cortado un segundo. Si el líder anterior vuelve sin fencing, hay split brain.
- Varios líderes permiten escribir en varios lugares aunque se desconecten, y producen conflictos que nadie detecta al escribir. Se evitan, se resuelven con una regla (LWW pierde datos en silencio, y con relojes de pared puede perder la escritura posterior), se conservan o se usan CRDT.
- Sin líder: se escribe en de réplicas y se leen . Si , los quórums se solapan en al menos una réplica y la lectura ve la última escritura completada. Se toleran caídas al escribir y al leer. No cubre escrituras fallidas a medias, réplicas restauradas ni escrituras concurrentes. Borrar necesita tombstones.
- Dynamo deriva su diseño de un escenario: escrituras que no se pueden rechazar sobre datos que se pueden fusionar. La forma se elige por dato: un líder para lo que necesita un orden único.
Ejercicios
-
Corran
make anomalycinco veces sin demora, y otras cinco después demake sync-on. ¿Por qué baja el número con la replicación síncrona, si esta no espera a que la réplica aplique el cambio? ¿Por qué no llega a cero? Digan qué prueba detest/replica.test.tsmuestra que no está garantizado y qué hace para que su resultado no dependa de la suerte. -
Para cada lectura de este sistema de reservas de un cine, decidan si puede ir a un seguidor, y con qué garantía: la cartelera; los asientos libres de una función, al mostrar la sala; el asiento que el usuario eligió, al pagar; “mis reservas”, justo después de pagar; el total vendido ayer, para administración. Justifiquen cada una con lo que pasaría si la lectura viera datos de hace cinco segundos.
-
En
lab/compare.ts, la estrategia (a) guarda la hora de la última escritura en un objeto en memoria. La aplicación real corre en cuatro instancias detrás de un load balancer. Expliquen qué falla, den dos lugares donde podría guardarse ese dato (o la posición del WAL de la estrategia (b)) y comparen lo que cuesta cada uno. -
Un equipo configura replicación síncrona con un solo seguidor “para tener alta disponibilidad”. Cada servidor tiene una disponibilidad de 99,9 % y fallan de forma independiente. Calculen la disponibilidad de las escrituras antes y después del cambio. ¿Qué ganaron en realidad? Propongan una configuración con tres servidores que conserve lo ganado sin perder disponibilidad de escritura, y calculen con cuántos servidores caídos sigue escribiendo.
-
Un supervisor declara muerto al líder si no responde a un health check en 2 segundos, y promueve a un seguidor. Durante una apertura de ventas, el líder tarda 3 segundos en responder a ese health check porque está atendiendo el pico. Describan paso a paso lo que ocurre, incluyendo qué pasa con las compras confirmadas durante esos segundos y con el líder original. ¿Qué cambiaría con un timeout de 30 segundos, y qué se pagaría por él?
-
Con : (a) listen todas las parejas que cumplen y, para cada una, cuántas réplicas caídas tolera al escribir y al leer; (b) ¿cuáles toleran dos réplicas caídas en las dos operaciones?; (c) un sistema hace cien lecturas por cada escritura y no puede tolerar lecturas lentas: ¿qué pareja elegirían y qué sacrifican? Comprueben (b) contra la prueba correspondiente de
test/quorum.test.ts. -
En el simulador, con , , , escriban una secuencia de operaciones (escrituras con
to, réplicas que se caen y vuelven, lecturas confrom) en la que una lectura devuelve un valor, y una lectura posterior, sin ninguna escritura en medio, devuelve uno más viejo. Desactiven read repair si hace falta (readRepair: false). Expliquen por qué no contradice el argumento de , y agréguenla como prueba. -
Modifiquen
quorum/lww.tspara que, en vez del reloj de pared, cada nodo use un contador que aumenta con cada escritura que acepta y que, al recibir una escritura de otro nodo, salta al máximo de los dos (un reloj lógico). Repitan las tres pruebas de LWW detest/lww.test.ts. ¿Cuáles cambian de resultado? ¿Qué caso sigue sin poder distinguir este reloj, y qué tendrían que usar para distinguirlo? -
En el failover con replicación síncrona, la orden 655 quedó en el nuevo principal aunque el cliente nunca recibió su confirmación. El cliente, que no sabe eso, reintenta. Describan qué pasa con el esquema de
numbered_writestal como está, y qué pasaría si la tabla no tuviera ancomo clave primaria. ¿Qué propiedad de la escritura hace que el reintento sea seguro? -
Un equipo quiere que su tienda “nunca rechace una compra” y propone guardar los asientos en un almacén sin líder con , , , citando el artículo de Dynamo. Escriban la respuesta que les darían: qué escenario tenía Dynamo, en qué se diferencia el de ellos, qué le pasaría concretamente a dos compradores del mismo asiento, y qué parte de la tienda sí podría usar ese almacén.