Apuntes · Capítulo 11Datos y sistemas distribuidos
Sharding, cache y escalabilidad
Sharding, cache y escalabilidad
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Replicar y hacer sharding, todo; de La clave de sharding, Qué decide la clave y Tinkuy con
event_id; de Qué es una cache y qué abre, Un dato derivado y Qué conviene guardar; y de Cache-aside, El patrón.- En clase: Sesión A: Replicar y hacer sharding, La clave de sharding, Por rango y por hash, Hot spots, Rebalanceo, Enrutar la petición, Lo que se pierde y Hacer sharding por adelantado. Sesión B: Qué es una cache y qué abre, Cache-aside, Invalidación, Estampida, Depender de la cache, Memoria finita y Escalar hacia los lados. Laboratorio: Laboratorio: cache-aside con Redis en Tinkuy y una estampida.
- Después de clase: el Resumen y los Ejercicios. Vale la pena releer La carrera que queda y Cache de latencia y cache de capacidad antes de defender P3. Opcionales: Consistent hashing, Recalcular antes de que venza y El código de la semana.
La semana pasada copiamos los datos: una réplica de PostgreSQL tiene lo mismo que el principal, con algún retraso. Eso resolvió dos escenarios (seguir funcionando si una máquina falla y atender más lecturas) y dejó dos sin tocar. Una réplica no ayuda cuando lo que no cabe en una máquina son las escrituras o el volumen de datos, porque cada réplica recibe todas las escrituras y guarda todo. Y una réplica tampoco hace que una lectura cara deje de ser cara: solo la manda a otra máquina.
Esta semana vemos las dos tácticas que faltaban. Hacer sharding es repartir los datos: cada máquina guarda una parte distinta, y entre todas tienen el total. Es la única de las tácticas del curso que hace crecer la capacidad de escritura, y también la más cara. Una cache guarda el resultado de algo caro para no repetirlo. Es la más barata de poner y la que más problemas sutiles trae: un dato que ya no es cierto, cientos de peticiones que recalculan lo mismo a la vez, y un sistema que dejó de funcionar sin ella y nadie lo sabía.
Las dos sesiones tienen formas distintas. El sharding no se puede correr en una laptop como un clúster de verdad, así que la primera sesión trabaja con los datos de ejemplo de Tinkuy y con programas que calculan a qué shard iría cada fila y cuánto se movería al agregar un nodo. La segunda sí se corre completa: un servicio pequeño con Redis delante de PostgreSQL, medido sin cache y con cache, con Redis vivo y con Redis muerto.
Lectura. Sesión A: Kleppmann y Riccomini, Designing Data-Intensive Applications (2.ª ed.), cap. 7 Sharding; Azure Architecture Center, Sharding pattern. Complementarias: Garrett Fidalgo, Herding elephants: lessons learned from sharding Postgres at Notion (2021); Sammy Steele, How Figma’s databases team lived to tell the scale (2024). Sesión B: Azure Architecture Center, Cache-Aside pattern; Site Reliability Engineering, cap. 22, Addressing Cascading Failures, la parte sobre arranque lento y caches frías; Software Architecture in Practice, cap. 9 Performance, las tácticas de mantener varias copias de los datos y del cómputo. Complementarias: Nishtala y otros, Scaling Memcache at Facebook (NSDI 2013), secciones 1 a 3; documentación de Redis, Key eviction; The Twelve-Factor App: Processes. El código de la semana está en code/week-11/.
Replicar y hacer sharding
Dos respuestas a dos problemas
Replicar es mantener los mismos datos en varias máquinas. Hacer sharding es repartir datos distintos entre varias máquinas: cada fila vive en una sola de ellas, y a cada parte se le llama shard. La diferencia decide para qué sirve cada una:
| Replicación | Sharding | |
|---|---|---|
| Qué tiene cada máquina | Todo | Una parte |
| Si una máquina se pierde | Otra tiene lo mismo | Esa parte de los datos no está |
| Más lecturas | Sí: se reparten entre las copias | Sí: cada shard atiende las suyas |
| Más escrituras | No: cada copia recibe todas | Sí: cada shard recibe solo las suyas |
| Más datos de los que caben en un disco | No: cada copia guarda todo | Sí |
Por eso no compiten, se combinan: en un sistema con sharding, cada shard tiene sus propias réplicas. El sharding reparte la carga y el volumen; la replicación hace que perder una máquina no sea perder un shard.
Sobre el nombre: van a encontrar partitioning para lo mismo (en Kafka y en la primera edición del libro de Kleppmann). La segunda edición usa sharding, y es la palabra del curso. Una tabla particionada de PostgreSQL es otra cosa: una tabla partida en varias dentro del mismo servidor, sin agregar máquinas.
Cuándo hace falta
Hace falta cuando los datos o las escrituras ya no caben en una máquina, y no antes. La página del patrón en el Azure Architecture Center lo dice desde el otro lado, en su lista de cuándo no usarlo: si el cuello de botella son las lecturas, las réplicas y una cache las descargan sin la complejidad de las consultas entre shards; y si el volumen y el throughput caben en una instancia, escalar hacia arriba conserva la simplicidad de las consultas y la integridad de las transacciones.
Antes del sharding hay una lista, y se recorre en orden porque cada paso es más barato que el siguiente:
- Mejores consultas e índices (semana 6): un recorrido completo de una tabla no se arregla con más máquinas.
- Una máquina más grande. No cambia una línea de código; tiene un tope.
- Archivar lo viejo: las órdenes de hace tres años no tienen por qué vivir con las de esta semana.
- Réplicas de lectura y cache, para las lecturas.
- Separar por dominio: grupos de tablas que no se consultan juntas, a bases de datos distintas (un servicio owner de sus datos, semana 5).
- Sharding.
¿Por qué es la más cara? Porque es la única de la lista que cambia lo que la
base de datos le garantiza a la aplicación. Con sharding ya no hay un JOIN
entre dos filas cualesquiera, ni una transacción que cubra dos filas
cualesquiera, ni una restricción UNIQUE sobre toda la tabla. La sección Lo
que se pierde recorre la lista. Y casi no tiene vuelta atrás: cambiar la clave
con la que se repartieron los datos es volver a repartirlos todos.
En la industria. Figma contó en 2024 cómo recorrió esa lista. Según el artículo de Sammy Steele, en 2020 corría una sola base de datos PostgreSQL en la instancia más grande de AWS; a fines de 2022 ya tenía cache, réplicas de lectura y una docena de bases de datos separadas por grupos de tablas. Recién entonces empezó el sharding horizontal, porque algunas tablas, con varios terabytes y miles de millones de filas, ya eran demasiado grandes para una sola base de datos. Hacer sharding de la primera tabla les tomó unos nueve meses. Fuente: How Figma’s databases team lived to tell the scale.
Trade-off. El sharding compra capacidad de escritura y de almacenamiento que crece agregando máquinas. Se paga con consultas y transacciones que dejan de existir o se vuelven caras, con una operación que se multiplica por el número de shards y con una clave que casi no se puede cambiar. La alternativa, una sola base de datos más grande con réplicas y cache, conserva todas las garantías y tiene un tope.
La clave de sharding
Qué decide la clave
Para repartir las filas hace falta una regla que diga, para cada fila, a qué shard va. La regla mira un atributo de la fila, la clave de sharding, y nada más. Todo lo que viene después sale de esa elección:
- Las filas con la misma clave viven juntas, en el mismo shard. Entre ellas
sigue habiendo
JOIN, transacciones y restricciones, como siempre. - Una consulta que trae la clave va a un solo shard. Una consulta que no la trae no sabe a dónde ir: tiene que preguntarles a todos.
- La carga de cada shard es la suma de la carga de sus claves. Si una clave concentra el tráfico, su shard también.
La clave se elige, entonces, por el patrón de acceso dominante: qué preguntas se hacen más, y qué filas se escriben juntas en una misma transacción. La página de Azure da los criterios en una frase: una buena clave no cambia, tiene muchos valores distintos, reparte parejo los datos y la carga, y coincide con las consultas dominantes, de modo que la mayoría de los pedidos se resuelva en un solo shard.
Dos ejemplos. En un sistema que atiende a muchas organizaciones (un sistema
multitenant: cada organización cliente es un tenant), casi toda consulta
es “los datos de esta organización”, y la clave natural es el id del tenant.
En Tinkuy, casi todo ocurre dentro de un evento (se mira, se miran sus
asientos, se compran, se pide su reporte): la clave natural es event_id.
En la industria. Notion partió su tabla de bloques (cada párrafo es un bloque) por el id del workspace. La razón que da Garrett Fidalgo es la del patrón de acceso: como los usuarios normalmente consultan datos de un solo workspace a la vez, se evita la mayoría de los
JOINentre shards. Y llevaron a los shards todas las tablas alcanzables desde un bloque por alguna clave foránea, para que un bloque y sus comentarios no quedaran en bases de datos distintas. Fuente: Herding elephants (2021).
Tinkuy con event_id
Tinkuy no necesita sharding: sus 13 080 asientos caben en la memoria de un teléfono. Lo usamos porque sus datos son conocidos y porque tiene, a escala, el problema que hace interesante el tema: un evento mucho más grande y mucho más pedido que los demás.
La pregunta es qué pasaría con cada consulta de Tinkuy si la tabla seats, y
las que cuelgan de ella, se repartieran en ocho shards con event_id como
clave. El programa shards/scatter.ts lo simula: reparte en memoria las filas
de los datos de ejemplo, ejecuta las lecturas de la API contra esos ocho
shards y cuenta a cuántos tuvo que preguntarles.
$ make scatter
Clave de sharding: event_id, 8 shards.

endpoint                     la consulta filtra por                             shards
GET /events/:id              WHERE event_id = $1                                1
GET /events/:id/seats        WHERE event_id = $1                                1
POST /orders                 WHERE t.id = ANY($1), con el eventId del pedido    1
GET /reports/sales?eventId=  WHERE o.event_id = $1                              1
GET /events                  sin filtro: todos los eventos                      8 (scatter-gather)
GET /orders/:id              WHERE o.id = $1                                    8 (scatter-gather)
Cuatro de las seis operaciones van a un solo shard, y entre ellas están las que
importan en una apertura de ventas: ver el evento, ver sus asientos y comprar.
Una compra toca un solo shard, así que sigue siendo una transacción de
PostgreSQL común. Las otras dos muestran lo que la clave no cubre.
GET /events es, por definición, una pregunta sobre todos los eventos: va a
los ocho shards. GET /orders/:id busca una orden que vive en el shard de su
evento, pero el pedido solo trae el id de la orden, y con eso no se sabe cuál
es: hay que preguntarles a los ocho para encontrar una fila.
La tercera fila tiene una lección aparte. La consulta que hoy hace Tinkuy para
leer los asientos de una compra filtra solo por el id de los asientos. El
shard se puede elegir porque el pedido POST /orders trae además el
eventId. Con sharding, la clave tiene que viajar con cada pedido, y eso
llega hasta el diseño de la API.
En Tinkuy. La tabla
venues(seis locales) no tieneevent_idy se usa en unJOINdesdeevents. Las tablas así, pequeñas y que casi no cambian, se suelen copiar completas en cada shard. La página de Azure lo recomienda, con su costo: cuando el dato cambia hay que cambiarlo en todos.
Otra clave, otro sistema
La clave no es evidente hasta que se prueba otra. Supongamos que alguien propone usar el id del asiento, con el argumento de que hay muchos más asientos que eventos y se van a repartir mejor. Tiene razón en lo segundo:
$ make shards
…
Otra clave: shard = hash(seat_id) mod 8
Asientos por shard: 1599, 1621, 1624, 1622, 1617, 1668, 1705, 1624
Los asientos del evento 1 quedan repartidos en 8 shards: pedir su mapa de asientos es preguntarles a todos.
De las 1303 órdenes de ejemplo, 971 llevan más de un asiento, y en 912 de ellas los asientos caen en shards distintos: serían transacciones entre shards.
El reparto es casi perfecto, y el sistema quedó peor. La consulta más frecuente de una apertura de ventas, el mapa de asientos de un evento, ahora va a los ocho shards. Y de las 971 órdenes de ejemplo con más de un asiento, 912 (el 94 %, que sale de dividir 912 entre 971) tendrían que escribir en más de un shard dentro de la misma compra: una transacción que PostgreSQL ya no puede garantizar sola.
Idea clave. Una clave de sharding no se juzga por lo parejo que reparte las filas, sino por cuántas operaciones deja dentro de un solo shard. Repartir parejo es necesario; no es el objetivo.
Por rango y por hash
Elegida la clave, falta la regla que convierte un valor de la clave en un número de shard. Hay dos familias.
Por rango de clave
Cada shard recibe un tramo continuo de claves, como los tomos de una
enciclopedia: de la A a la C, de la D a la F. Para saber a qué shard va una
clave se mira en qué tramo cae (shardByRange, en shards/hash.ts).
Lo que da: las claves vecinas quedan juntas y en orden, así que una consulta por rango (“las órdenes de marzo”, “los eventos del 10 al 15”) lee uno o pocos shards, de corrido.
Lo que cuesta: los tramos no reciben la misma carga, y hay un caso en que la reciben de la peor manera. Si la clave crece con el tiempo (una fecha, un id secuencial, un timestamp), todas las filas nuevas caen en el último tramo. El último shard recibe todas las escrituras y los demás, ninguna: se pagó por ocho máquinas y se escribe en una. La página de Azure pide evitar justamente esas claves, los enteros autoincrementales y los timestamps secuenciales.
Por hash de la clave
Se le aplica a la clave una función de hash, que la convierte en un número que parece al azar pero es siempre el mismo para la misma clave, y el shard sale de ese número.
export function hash32(key: string | number): number {
  return createHash('md5').update(String(key)).digest().readUInt32BE(0);
}

export function shardByHash(key: string | number, shards: number): number {
  return hash32(key) % shards;
}
Dos condiciones sobre la función. Tiene que repartir parejo: claves parecidas (1, 2, 3) deben terminar en lugares que no se parecen. Y tiene que ser estable: dar lo mismo en todas las máquinas, en todas las versiones del programa y para siempre, porque todos los que enrutan tienen que estar de acuerdo. No hace falta que sea criptográfica; aquí se usa MD5 porque viene con Node.js y cumple las dos. No sirve el hash interno que un lenguaje usa para sus tablas, que puede cambiar de una versión a otra.
Lo que da: claves consecutivas van a shards distintos, así que una clave que crece con el tiempo ya no manda todo al último.
Lo que cuesta: se pierde el orden. Las claves del 10 al 15 quedaron desparramadas, y una consulta por rango sobre la clave tiene que preguntarles a todos los shards.
En la industria. Figma se encontró con el caso exacto: muchas de sus claves eran ids autoincrementales o con un prefijo de tiempo, lo que habría dejado, dice el artículo, un solo shard con la mayoría de los datos. Decidieron enrutar por el hash de la clave, y escribieron el costo: los recorridos por rango sobre la clave son menos eficientes, y ese patrón de consulta no era común en su código.
La variante que casi todos usan en la práctica no asigna el hash directamente a una máquina, sino a un número fijo de shards lógicos, muchos más que máquinas, que luego se asignan a máquinas. La razón aparece en Rebalanceo.
Los datos de Tinkuy en ocho shards
Con make se carga en la base de datos de la semana una copia de los datos de
ejemplo de Tinkuy, y make shards calcula a qué shard iría cada evento con
cada regla:
$ make shards
24 eventos y 13080 asientos en 8 shards. Clave de sharding: event_id.

Por hash: shard = hash(event_id) mod 8
shard  eventos                 asientos  % de los asientos
    0  1 10 13 16 20               4280    32,7 %
    1  4 14                        1120     8,6 %
    2  22                           600     4,6 %
    3  11                           340     2,6 %
    4  6 18 21 23                  1460    11,2 %
    5  2 8 19                      1320    10,1 %
    6  3 9 17                      1120     8,6 %
    7  5 7 12 15 24                2840    21,7 %
El shard más cargado tiene 4280 asientos y el menos cargado 340. El evento 1 está en el shard 0.

Por rango: tres eventos seguidos por shard (límites 3, 6, 9, 12, 15, 18, 21, 24)
shard  eventos                 asientos  % de los asientos
    0  1 2 3                       2720    20,8 %
    1  4 5 6                       1600    12,2 %
…
    7  22 23 24                    1600    12,2 %
El shard más cargado tiene 2720 asientos y el menos cargado 1260. El evento 1 está en el shard 0.
…
Tres cosas para mirar.
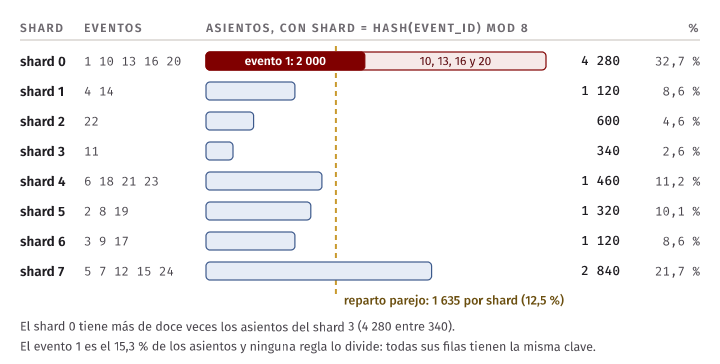
El hash no repartió parejo. Un shard quedó con cinco eventos y dos con uno; el más cargado tiene más de doce veces los asientos del menos cargado (4 280 entre 340). No es un defecto de la función: es que hay 24 claves. Un hash reparte parejo en promedio y con muchas claves, como una moneda sale mitad cara con muchos lanzamientos y no con cuatro. Con el id del asiento, que tiene 13 080 valores, el mismo hash dejó entre 1 599 y 1 705 por shard.
El rango, aquí, repartió mejor, porque se le dieron tres eventos a cada shard a mano. Es su ventaja (se controla dónde cae cada cosa) y su trampa: los eventos se crean con ids crecientes, así que los eventos nuevos, que son los que tienen la venta abierta, caerían siempre en el último shard.
El evento 1 está entero en un shard, con las dos reglas. Tiene 2 000 de los 13 080 asientos, el 15,3 % (2 000 entre 13 080), y ninguna regla lo puede dividir, porque todas sus filas tienen la misma clave. Ese es el tema de la sección siguiente.
Hot spots
Un hot spot es un shard que recibe una parte desproporcionada de la carga. Hay dos causas, y solo una se arregla eligiendo otra regla.
La primera es una regla que junta mucha carga en un tramo: el sharding por rango con una clave que crece con el tiempo. Se arregla con hash.
La segunda es una sola clave que concentra la carga. Esa no se arregla con ninguna función de hash, porque todas las filas de una clave van al mismo shard por definición: es lo que se le pidió a la clave. En el reparto de arriba, el evento 1 pesa lo mismo esté donde esté.
Y el tamaño es la parte menor del problema. La prueba de carga de la apertura
de ventas de Tinkuy (make load-sale) manda sus 200 compradores a un solo
evento, el 1: con ocho shards, uno recibiría toda la carga de la venta y los
otros siete mirarían. En una plataforma de entradas eso no es un caso raro:
el concierto que se agota en un minuto es el negocio, y es un hot spot por
definición.
Las opciones, con lo que cuesta cada una:
- Aislar la clave caliente en su propio shard, en la máquina más grande disponible. No divide la carga, pero evita que el evento grande degrade a los otros veintitrés. Necesita una regla de enrutamiento con excepciones (“el evento 1 va aquí; los demás, por hash”), o sea, una tabla de asignación en vez de una fórmula. Azure lo menciona para sistemas multitenant: darles su propio shard a los tenants más activos.
- Partir la clave con un sufijo: la clave pasa a ser
(event_id, sección)y las filas del evento se reparten entre varios shards. Ahora las escrituras sí se dividen. Se paga al leer: el mapa de asientos y el reporte pasan a preguntarles a varios shards, y una compra con asientos de dos secciones es una transacción entre shards. Solo vale la pena para las pocas claves que lo necesitan. - No resolverlo en la base de datos. Una fila virtual delante de la venta admite a los compradores al ritmo que un shard aguanta: el hot spot se trata en la puerta, con load shedding y backpressure (semana 14).
Error común. “Usamos hash, así que no vamos a tener hot spots.” El hash reparte claves. Si la carga no está repartida entre las claves, repartir las claves no reparte la carga.
Rebalanceo
Con el tiempo los shards dejan de estar parejos, o simplemente no alcanzan, y hay que agregar máquinas. Rebalancear es mover datos para que las máquinas nuevas reciban su parte. Mover datos cuesta: mientras se copian hay más carga sobre máquinas que ya estaban exigidas, y durante el cambio hay que seguir atendiendo lecturas y escrituras sin perder ninguna. El objetivo, entonces, es mover lo menos posible.
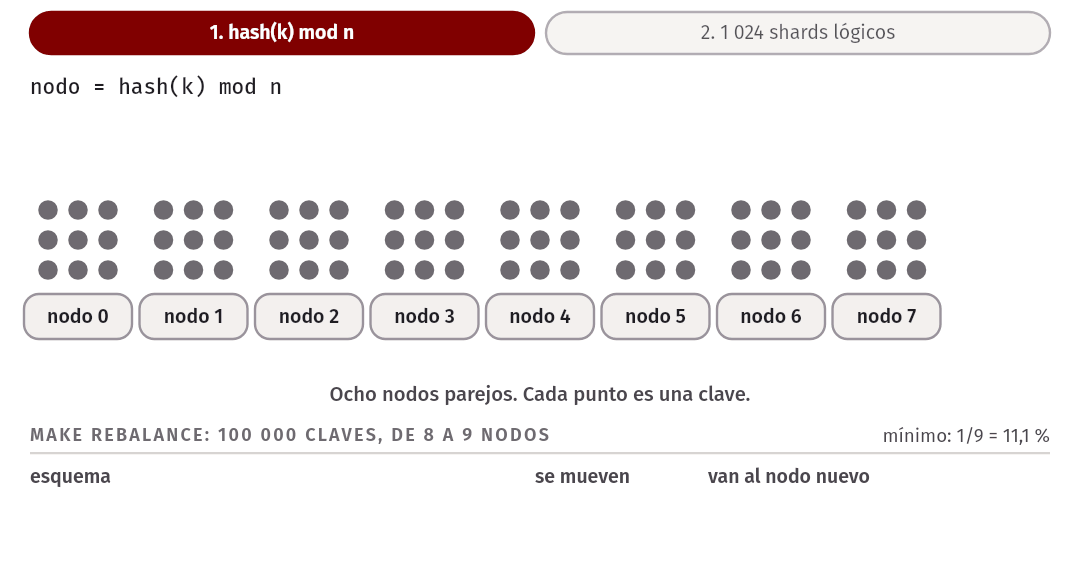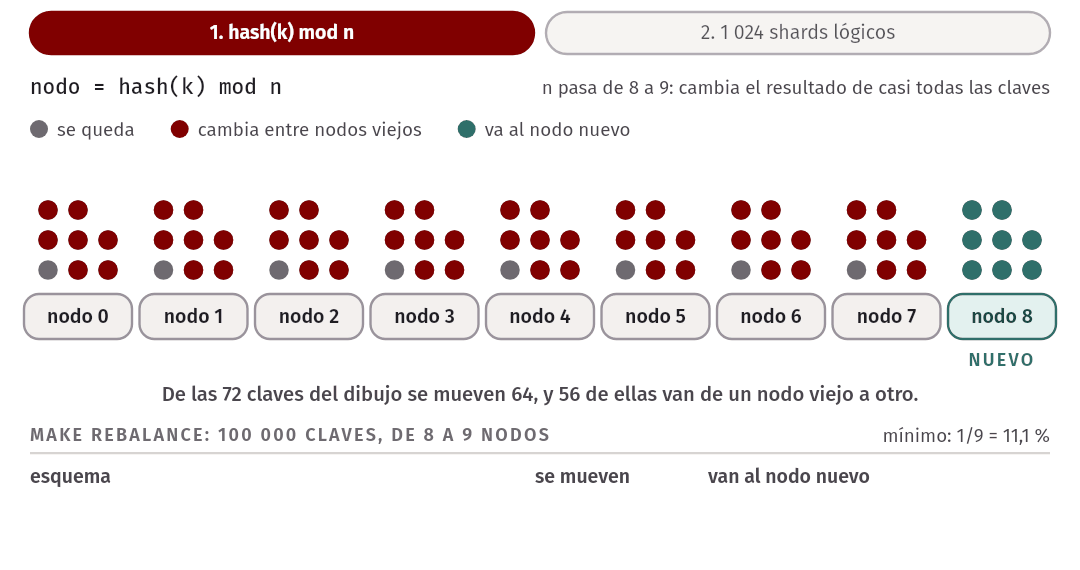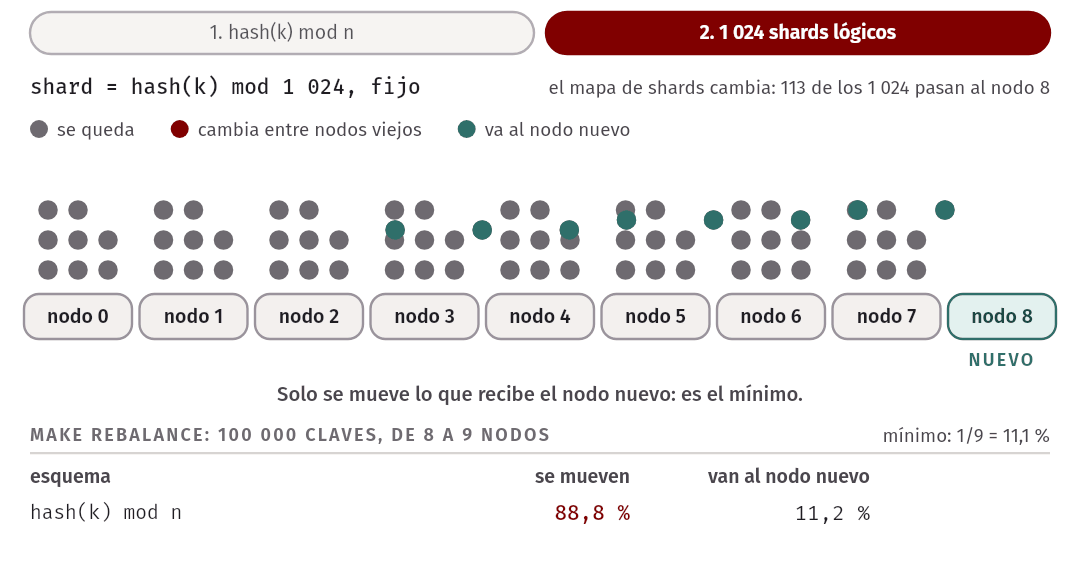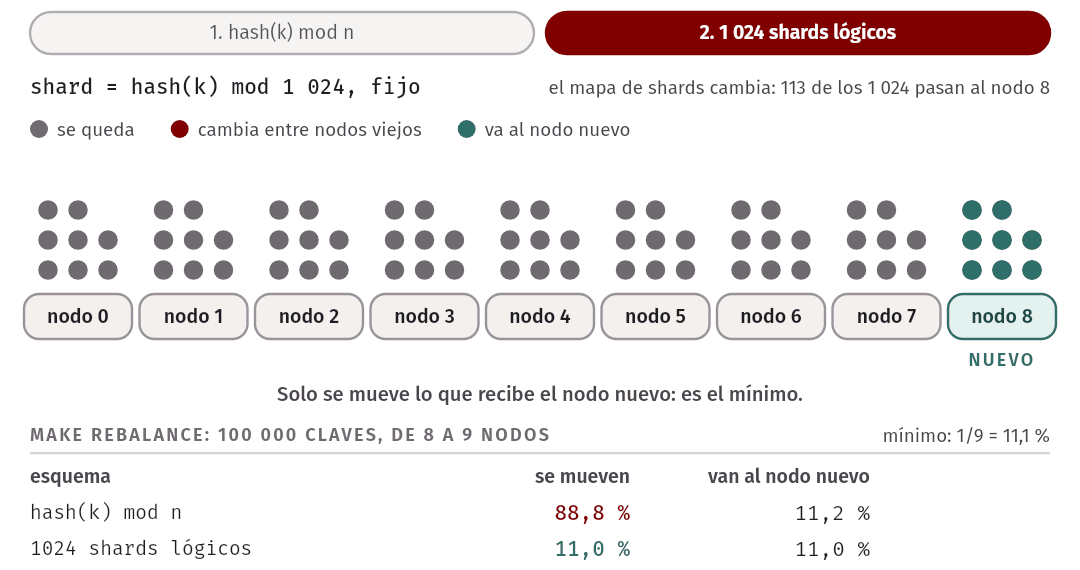
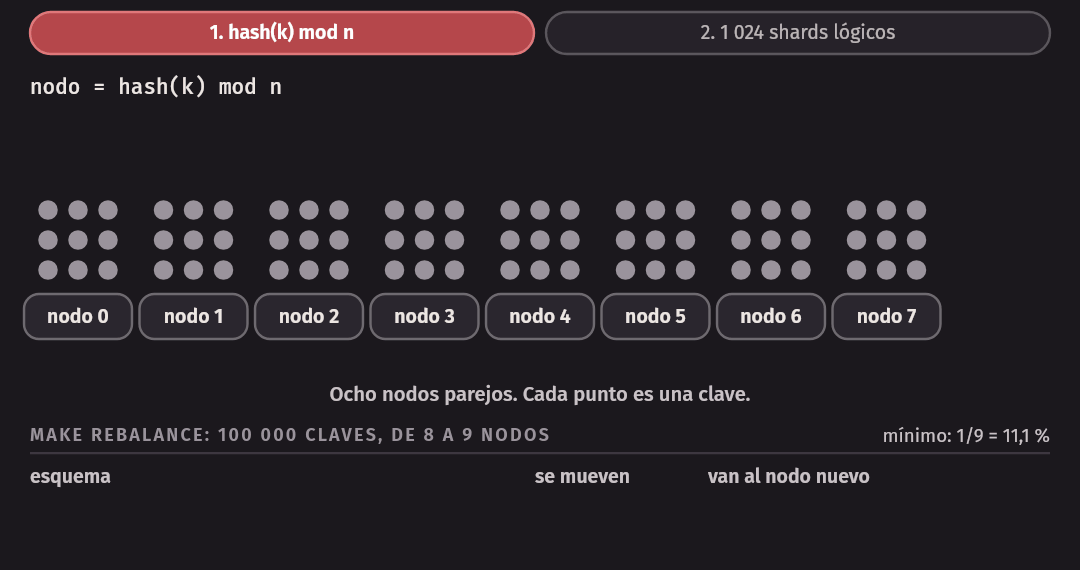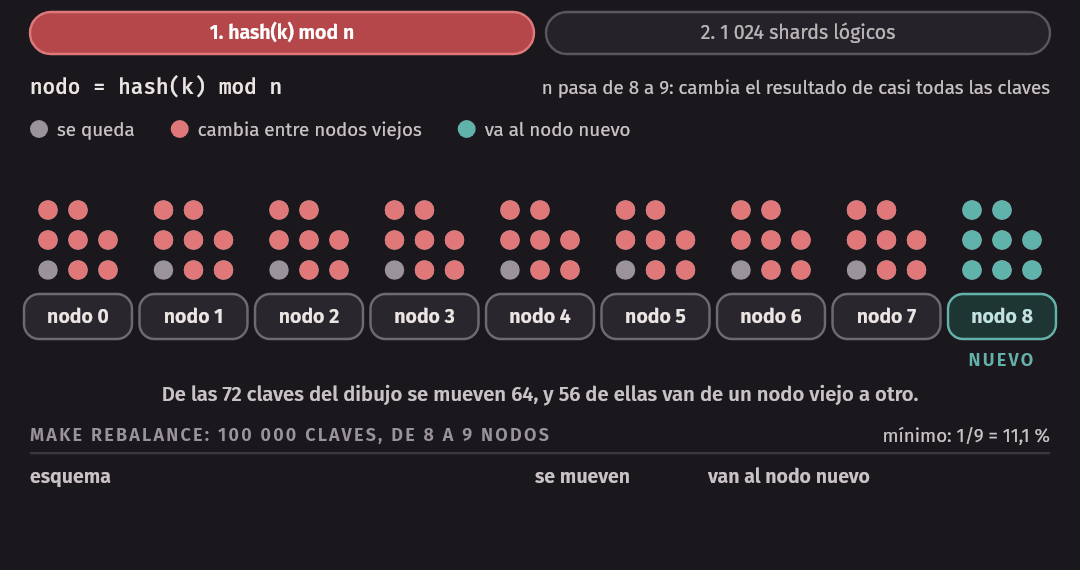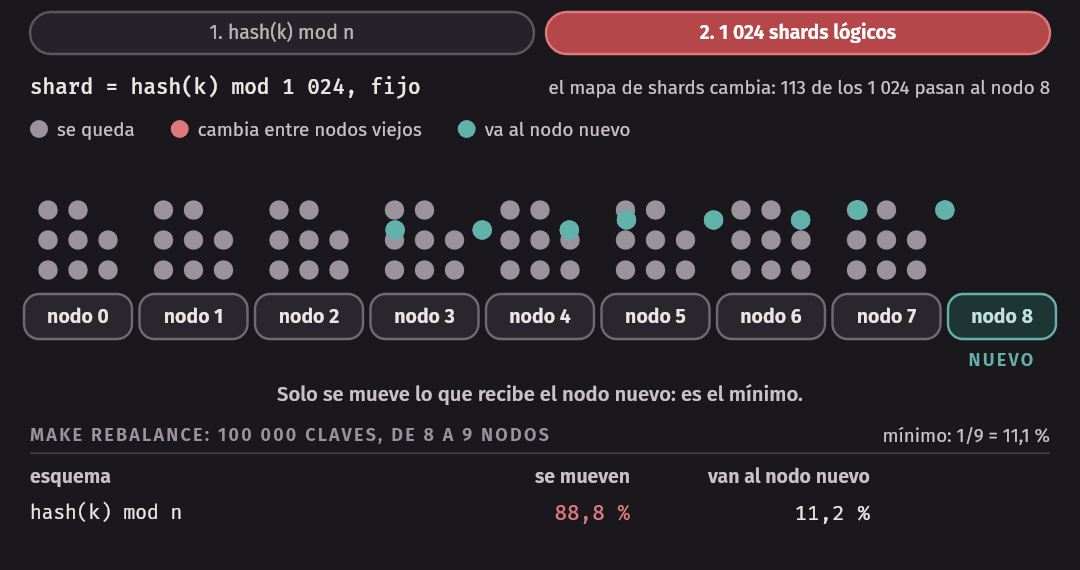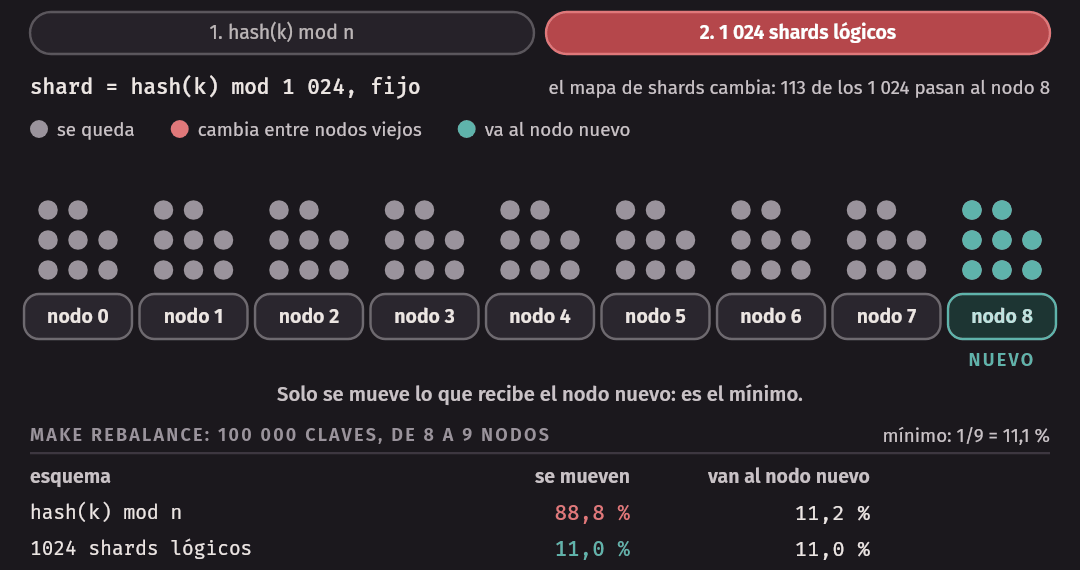
¿Cuánto es lo menos posible? Si hay nodos parejos y se agrega uno, el nuevo tiene que quedar con de las claves. Menos que eso no se puede mover. De 8 a 9 nodos, el mínimo es , el 11,1 %.
Por qué no hash(k) mod n
La forma más simple de asignar claves a nodos es la que usamos arriba con los shards: el resto de dividir el hash entre el número de nodos. Funciona mientras no cambie. Cuando cambia, pasa esto. Sea . La clave se queda donde estaba solo si
Para ver cuántas claves lo cumplen, basta mirar , que para un buen hash toma todos sus valores, de a , con la misma frecuencia. Si , los dos restos valen y la clave se queda. Para cualquier otro los dos restos difieren. Entonces:
Agregar un nodo a ocho mueve ocho de cada nueve claves, cuando bastaba mover
una. Y la mayoría de esos movimientos son inútiles: van de un nodo viejo a
otro nodo viejo. El programa shards/rebalance.ts lo mide con 100 000 claves:
$ make rebalance
100000 claves, de 8 nodos a 9. Lo mínimo que hay que mover para que el nodo nuevo tenga su parte es 1/9 = 11,1 %.

esquema                se mueven   van al nodo nuevo   claves por nodo después (mín. – máx.)
hash(k) mod n           88,8 %    11,2 %             10897 – 11228
1024 shards lógicos     11,0 %    11,0 %             10964 – 11319
consistent hashing      12,3 %    12,3 %             9710 – 12472

Y con hash(k) mod n, duplicar de 8 a 16 nodos mueve 50,2 % de las claves.
La primera fila coincide con la cuenta: se mueve el 88,8 %, y solo el 11,2 % va al nodo nuevo. El resto cambió de un nodo viejo a otro sin necesidad.
La última línea muestra la única salida que tiene este esquema: duplicar. De 8 a 16, una clave se queda si , que pasa la mitad de las veces, y las que se mueven van todas a un nodo nuevo. Se mueve el mínimo, a cambio de que la única forma de crecer sea comprar el doble de máquinas cada vez.
Shards lógicos
La solución habitual separa dos cosas que la fórmula anterior mezclaba: a qué shard pertenece una clave y en qué nodo vive ese shard.
- La clave se asigna a un shard lógico con , donde es un número fijo, decidido el primer día y mucho mayor que el número de nodos: 1 024 en el ejemplo. Como nunca cambia, una clave nunca cambia de shard.
- Una tabla, el mapa de shards, dice en qué nodo vive cada shard lógico. Al principio, con 8 nodos, cada uno tiene 128.
- Para agregar un nodo se le pasan shards enteros hasta que tenga su parte: 113 de los 1 024 (la parte entera de 1 024 entre 9). Los demás no se tocan.
En la tabla de arriba es la segunda fila: se movió el 11,0 % de las claves, y todo lo que se movió fue al nodo nuevo. Es el mínimo.
Lo que se paga es el mapa: un dato, pequeño y vital, que todos los que enrutan tienen que conocer y sobre el que tienen que estar de acuerdo. Y hay que elegirlo bien de entrada: es el máximo de nodos que el sistema podrá tener.
En la industria. Notion eligió 480 shards lógicos sobre 32 bases de datos físicas, 15 por base de datos. El artículo explica por qué 480 y no una potencia de 2: tiene muchos divisores, así que pueden pasar de 32 a 40 y a 48 máquinas manteniendo el reparto parejo; con 512 habrían tenido que saltar de 32 a 64. Azure llama a lo mismo virtual partitions y lo recomienda para rebalancear menos.
Consistent hashing
El consistent hashing consigue algo parecido sin un mapa de shards escrito. La idea: los nodos y las claves se colocan en un mismo anillo, que son los valores del hash con el final pegado al principio. La posición de un nodo es el hash de su nombre; la de una clave, su hash. Cada clave pertenece al primer nodo que se encuentra avanzando por el anillo desde su posición.
Cuando se agrega un nodo, aparece en un punto del anillo y se queda con las
claves del tramo que va desde el nodo anterior hasta él. Esas claves cambian
de nodo; las de todos los demás tramos no se enteran. Como un nodo con un solo
punto podría quedar con un tramo muy largo o muy corto, cada nodo se coloca en
muchos puntos (128 en shards/rebalance.ts), y así su parte es la suma de
muchos tramos pequeños.
En la tabla es la tercera fila: se movió el 12,3 %, todo hacia el nodo nuevo. Es cerca del mínimo, pero no exacto, y el reparto queda menos parejo (entre 9 710 y 12 472 claves por nodo, contra 10 964 y 11 319 con shards lógicos): los tramos salen del azar del hash, no de una cuenta.
Trade-off. Shards lógicos: reparto exacto y control total sobre qué se mueve y cuándo, a cambio de mantener un mapa en el que todos estén de acuerdo. Consistent hashing: no hay mapa que administrar más allá de la lista de nodos, a cambio de un reparto aproximado y de menos control. Los almacenes clave-valor distribuidos y las caches suelen usar lo segundo; el artículo de Facebook cuenta que reparten las claves entre sus servidores de memcached con consistent hashing. Las bases de datos relacionales con sharding, como las de Notion y Figma, usan lo primero.
Automático o manual
Falta decidir quién aprieta el botón. Un rebalanceo automático reacciona solo: detecta un nodo sobrecargado o caído y mueve shards. Es cómodo y es peligroso por la misma razón. Mover datos es carga adicional sobre el nodo que los entrega y sobre la red. Si el sistema decide rebalancear porque un nodo está lento, y el nodo está lento porque está sobrecargado, le agrega carga al nodo que menos la aguanta, y a los que reciben sus shards. Una sobrecarga se convierte en una falla en cascada (semana 14).
Un rebalanceo manual, o automático con una persona que aprueba el plan, es más lento y evita esa sorpresa.
Enrutar la petición
Con los datos repartidos, alguien tiene que saber, para cada pedido, a qué nodo ir. Hay tres lugares donde puede vivir ese conocimiento:
| Quién enruta | Cómo funciona | Qué cuesta |
|---|---|---|
| El cliente | La aplicación conoce el mapa y se conecta directo al nodo correcto | Cada aplicación (y cada versión desplegada) tiene que tener el mapa al día |
| Una capa de enrutamiento | Un proxy entre la aplicación y los nodos recibe todo y lo reenvía | Un salto más en cada consulta, y un componente más que operar y que puede fallar |
| Cualquier nodo | La aplicación le habla a cualquiera; si el dato no es suyo, ese nodo reenvía | Los nodos tienen que conocerse y mantenerse informados entre sí |
En los tres casos el problema de fondo es el mismo: tiene que existir un registro de la asignación (qué shard vive en qué nodo) y todos los que enrutan tienen que estar de acuerdo sobre lo que dice. Durante un rebalanceo, si la aplicación cree que el shard 300 está en el nodo 2 y ya se mudó al 9, lee datos que faltan o escribe donde nadie va a buscar. Poner de acuerdo a varias máquinas sobre un dato que cambia es el problema del consenso, que este curso no desarrolla; por eso el registro suele vivir en un servicio que ya lo resuelve (ZooKeeper y etcd son los nombres habituales), y no en un archivo de configuración copiado a mano.
En la industria. Los dos artículos de la semana eligieron distinto. Notion enruta desde la aplicación: querían, dice el artículo, una sola fuente de verdad para ir de un workspace a un shard lógico, y por eso armaron las tablas por separado y pusieron todo el enrutamiento en el código de la aplicación. Figma construyó una capa: un servicio en Go, DBProxy, que se pone entre la aplicación y las bases de datos, analiza cada consulta SQL, saca de ella la clave y la manda al shard que corresponde.
Lo que se pierde
Consultas entre shards: scatter-gather
Una consulta que no trae la clave se manda a todos los shards (scatter) y sus respuestas se juntan (gather). Ya vimos las dos de Tinkuy. Lo que cuesta no es solo la latencia:
- La latencia es la del shard más lento. La respuesta está lista cuando llega la última parte. Con ocho shards, la probabilidad de que alguno esté en un mal momento es bastante mayor que con uno; es el mismo efecto de las cadenas de llamadas de la semana 5.
- La disponibilidad es la de todos juntos. Si un shard no responde, la consulta no tiene respuesta completa. Hay que decidir si se responde con lo que hay o con un error.
- No escala. Esta es la que más importa. Una consulta de un solo shard usa la octava parte del sistema. Un scatter-gather usa las ocho. Agregar shards no le da más capacidad: le agrega trabajo.
En la industria. El artículo de Figma lo dice con claridad: como esas consultas tienen que tocar todas las bases de datos, cada scatter-gather aporta la misma carga que si la base de datos no tuviera sharding, y demasiados limitarían la escalabilidad del sharding horizontal. Por eso decidieron qué subconjunto de SQL soportar mirando el tráfico real: se permiten las consultas de una fila y los recorridos por rango, y los
JOINsolo entre tablas que comparten clave de sharding y sobre esa clave.
Y juntar no siempre es concatenar: un ORDER BY obliga a mezclar las
respuestas, un LIMIT 10 hay que pedírselo a cada shard y volver a cortar, y
un promedio no sale de promediar promedios. Cada operación de SQL que cruza
shards es algo que alguien tiene que programar.
Transacciones entre shards
Dentro de un shard, una transacción es una transacción. Entre dos shards hay dos bases de datos, y ninguna puede prometer nada sobre la otra: una escritura puede confirmarse en un shard y fallar en el otro. Lo que existe para coordinarlas (two-phase commit, sagas) es el tema de la semana 12, y todo cuesta latencia, disponibilidad o una consistencia más débil.
Por eso la clave se elige para que las filas que se escriben juntas vivan
juntas. En Tinkuy, una orden es de un solo evento (es una regla del
negocio), así que con event_id la compra entera vive en un shard. Una
función nueva como “comprar entradas de dos eventos en una sola orden”
rompería eso.
Unicidad e identificadores
Una restricción UNIQUE la comprueba una base de datos sobre sus propias
filas. Tinkuy tiene dos casos en db/schema.sql:
tickets.codeesUNIQUE. Con sharding, cada shard garantiza que el código no se repite en ese shard; nadie garantiza que no se repita entre dos. Las salidas: códigos que no puedan chocar (largos y al azar, o con el número de shard adentro), o un servicio aparte que los registre todos.- Los ids son
GENERATED BY DEFAULT AS IDENTITY: un contador por tabla. Ocho shards tienen ocho contadores que empiezan en 1, y la orden 1 304 existiría ocho veces. Hay que generar los ids de otro modo: un rango por shard, un id que incluya el shard, o un identificador aleatorio como un UUID.
Lo mismo pasa con las claves foráneas: REFERENCES events (id) solo se puede
comprobar si la fila referida está en el mismo shard.
Índices secundarios: locales y globales
Un índice secundario sirve para buscar por algo que no es la clave: las órdenes de un correo, los asientos de una sección. Con sharding hay dos formas de tenerlo, y cada una carga el costo en un lado distinto.
Un índice local es el de siempre: cada shard indexa sus propias filas.
Escribir es barato, porque la fila y su entrada en el índice están en el mismo
shard y se actualizan en la misma transacción. Leer por ese índice es caro: el
índice del shard 3 no sabe nada de las filas del shard 5, así que “las órdenes
de rosa.quispe@correo.pe” es un scatter-gather.
Un índice global cubre todos los shards: una estructura aparte que dice, para cada correo, dónde están sus órdenes. Leer es barato. Escribir es caro: cada escritura toca el shard de la fila y el lugar donde vive la entrada del índice, que normalmente es otro. Hacerlo de forma atómica sería una transacción entre shards, así que casi siempre el índice se actualiza después, de forma asíncrona: por un momento, una orden recién creada no aparece al buscarla por correo. Es un dato derivado con retraso, como la réplica.
Trade-off. Índice local: escrituras baratas y consistentes, lecturas por ese atributo que les preguntan a todos. Índice global: lecturas baratas, y escrituras que tocan dos lugares y un índice que puede estar atrasado. Se elige por la proporción entre lecturas por ese atributo y escrituras, y por si esa lectura tolera no ver lo último.
Hacer sharding por adelantado
Error común. Hacer sharding “para cuando crezcamos”. La clave se elige por el patrón de acceso dominante, y un sistema nuevo todavía no sabe cuál es el suyo. Una clave equivocada cuesta más que no tener sharding: se pagan todos los costos de la sección anterior y, además, las consultas que resultaron ser las frecuentes son scatter-gather.
El artículo de Notion tiene una nota al pie que lo explica mejor que cualquier regla: un peligro poco apreciado del sharding prematuro es que puede restringir el modelo del producto antes de que el negocio lo haya definido. Si un equipo hace sharding por usuario y después el producto gira hacia equipos de trabajo, la arquitectura queda en contra del producto.
El mismo artículo tiene entre sus lecciones una que dice lo contrario: shard
earlier. Esperaron hasta que la base de datos estaba tan exigida que la
migración misma se volvió difícil. Las dos cosas son ciertas, y juntas dicen
cuándo: no antes de conocer los patrones de acceso, y no después de quedarse
sin margen para migrar. Lo que sí se puede hacer temprano, y casi gratis, es
no cerrar la puerta: que cada tabla importante lleve la columna que
probablemente será la clave (en Tinkuy, orders ya lleva event_id) y medir
cuánto margen queda.
Qué es una cache y qué abre
Un dato derivado
Una cache guarda el resultado de algo caro para no repetirlo. “Caro” puede ser una consulta que suma miles de filas, una llamada a otro servicio o un cálculo largo. La segunda vez que alguien pide lo mismo, se le da el resultado guardado.
En los términos de la semana 9, una cache es un dato derivado: todo lo que contiene se puede volver a calcular a partir del sistema de registro, que aquí llamamos el origen. De esa definición salen las dos reglas que ordenan el resto del capítulo:
- La cache se puede perder. Si se pierde, el sistema tiene que seguir dando respuestas correctas, aunque más lentas. Un sistema que da respuestas incorrectas o deja de responder sin su cache la está usando como otra cosa.
- La cache puede estar equivocada. Es una segunda copia, y como toda segunda copia puede no coincidir con la primera. La pregunta no es si va a pasar, sino durante cuánto tiempo y quién lo va a notar.
Lo que una cache da son dos cosas distintas, y conviene no mezclarlas: menos latencia para quien pide (la respuesta guardada llega antes) y menos carga sobre el origen (las peticiones que la cache responde no llegan a la base de datos). Lo que abre también son dos: una copia que puede estar desactualizada y un componente más que puede fallar.
En la semana 6 la vimos como una táctica de rendimiento, de las que mantienen varias copias de los datos, como la réplica de la semana 10. La diferencia: una réplica copia los datos y contesta cualquier consulta con el costo de siempre; una cache copia las respuestas y contesta, casi gratis, solo las preguntas que ya se hicieron.
Dónde puede haber una cache
Entre quien pide y el origen hay varios lugares donde se puede guardar una respuesta. De más cerca del usuario a más cerca de los datos:
| Dónde | Quién la controla | Qué tiene de bueno | Qué tiene de malo |
|---|---|---|---|
| El navegador | Las cabeceras HTTP de la respuesta (Cache-Control) |
La petición ni siquiera sale de la máquina del usuario | Una vez entregada, no se puede invalidar: dura lo que dijo la cabecera |
| Una CDN | Las mismas cabeceras, y la configuración de la CDN | Sirve desde cerca del usuario y absorbe picos enormes | Sirve para respuestas iguales para todos; invalidar es una llamada a un tercero |
| La memoria del proceso | El código de la aplicación (un Map) |
La más rápida: no hay red | Una por instancia, y se pierde en cada reinicio |
| Un servicio compartido (Redis) | El código de la aplicación | Una sola para todas las instancias; sobrevive a los reinicios de la aplicación | Un salto de red, y un servicio más que operar |
Este capítulo trabaja con la última; la penúltima tiene su error común, al final.
Qué conviene guardar
No todo. Una respuesta es buena candidata cuando cumple tres condiciones a la vez:
- Se lee mucho más de lo que cambia. Si cambia tan seguido como se lee, cada lectura encuentra la entrada recién borrada y la cache solo agrega trabajo.
- Es cara de calcular. Guardar el resultado de una búsqueda por clave primaria que tarda un milisegundo ahorra poco y agrega todos los problemas.
- Tolera estar un poco vieja. Esta es una pregunta de negocio, no técnica: ¿qué pasa si alguien ve el valor de hace cinco segundos?
En Tinkuy. Tres respuestas, tres decisiones. La lista de eventos y sus precios: sí; todos la piden, cambia poco y es la lectura más lenta del sistema. Los asientos libres de un evento en plena venta: con mucho cuidado; cambia con cada compra, y un valor de hace dos segundos muestra como libre un asiento que ya no lo está. Se tolera solo porque la compra vuelve a comprobarlo contra el origen. El estado de un pago: no.
Para saber si una respuesta es cara hay que medirla. El Tinkuy inicial, con
make load-browse (hasta 50 usuarios mirando el catálogo durante 30
segundos), en una laptop con Apple Silicon y dentro de Docker:
$ make load-browse
…
    duration_event_detail..........: avg=44.37ms  min=12.22ms med=31.31ms p(90)=79.51ms  p(95)=124.86ms p(99)=227.07ms max=272.86ms
    duration_events_list...........: avg=384.38ms min=91.79ms med=310.5ms p(90)=780.7ms  p(95)=889.33ms p(99)=944.32ms max=969.19ms
    http_reqs......................: 1773   56.617729/s
La lista (GET /events) tiene una mediana diez veces mayor que la del
detalle. En otra corrida igual, en la misma máquina, el p95 de la lista fue
1,21 s y el del detalle 186 ms: los números cambian de una corrida a otra, y
la relación entre los dos endpoints se mantiene. La razón ya la conocen de la
semana 6: listEvents hace una consulta para la lista y una más por cada
evento, para contar sus asientos libres. Es un N+1.
Error común. Poner una cache para esconder una consulta mal escrita. La consulta sigue ahí, y aparece entera cada vez que la entrada vence o Redis se reinicia. Primero se arregla la consulta; después se decide si todavía hace falta la cache. En Estampida se ve por qué una lectura lenta detrás de una cache es peor que una lectura lenta sola.
Cache-aside
El patrón
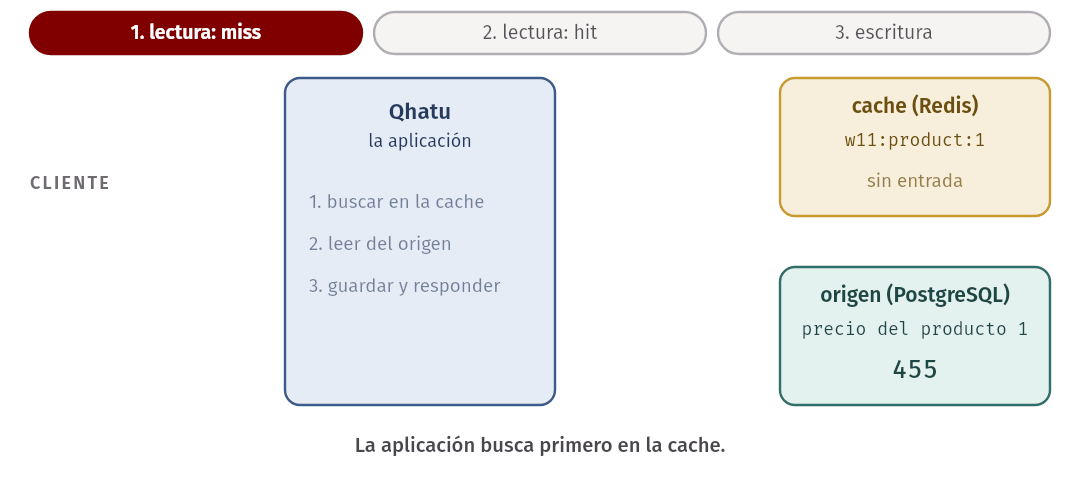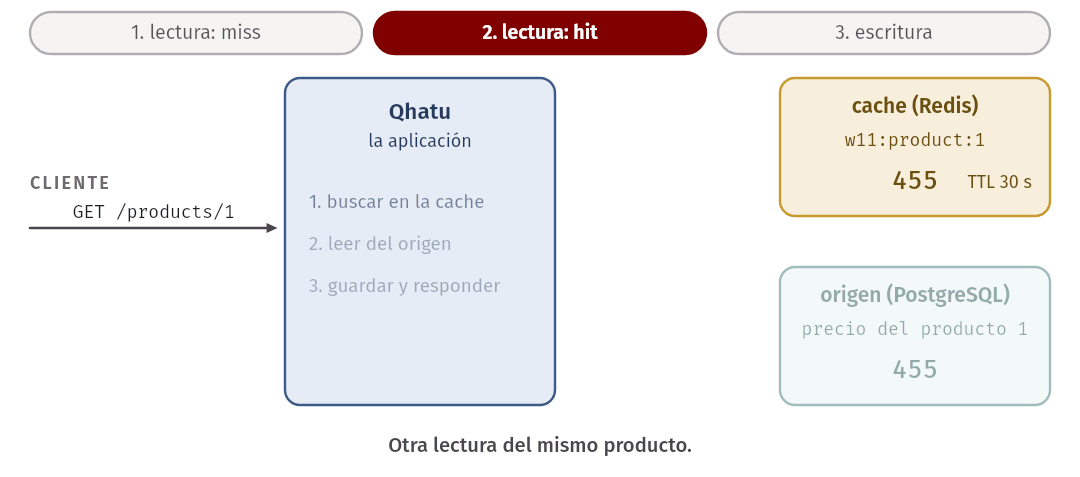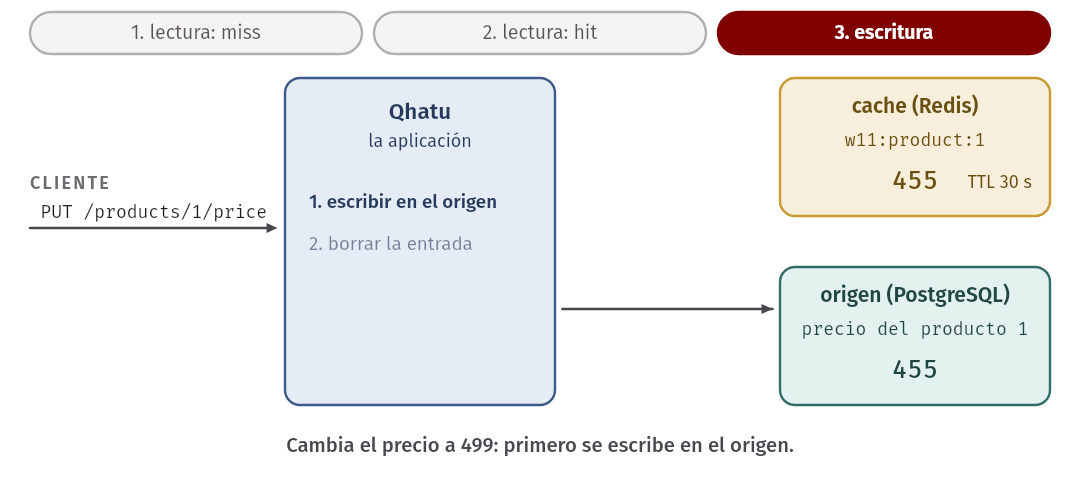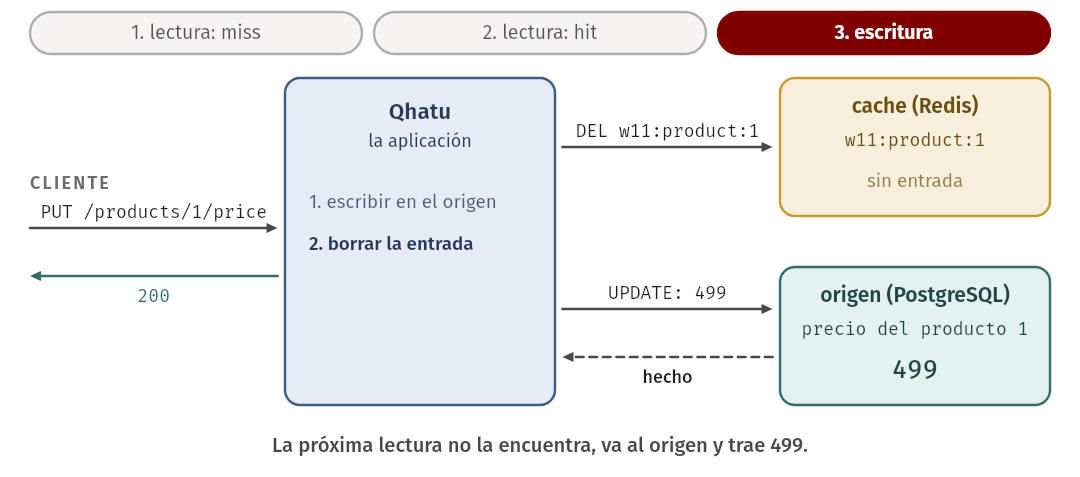
En cache-aside, la cache está al lado: la aplicación habla con la cache y con el origen, y es ella la que decide cuándo usar cada uno. La cache no sabe que el origen existe. Una lectura son tres pasos:
- La aplicación busca en la cache. Si la respuesta está, es un acierto (un hit) y termina ahí.
- Si no está, es un fallo (un miss): la aplicación lee del origen.
- Guarda lo que leyó en la cache, con un tiempo de vida, y responde.
Y una escritura son dos: la aplicación escribe en el origen y después borra la entrada de la cache. La próxima lectura no la encuentra, va al origen y trae el valor nuevo.
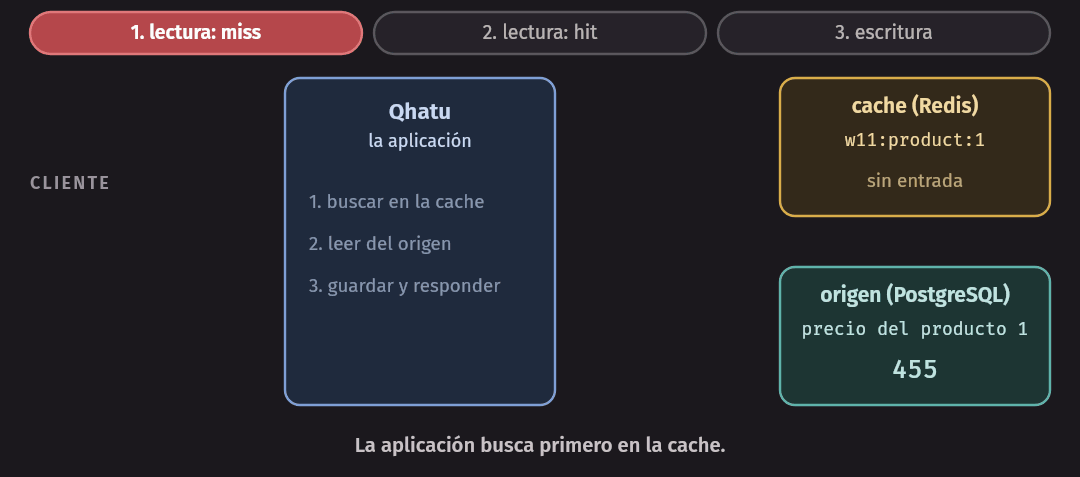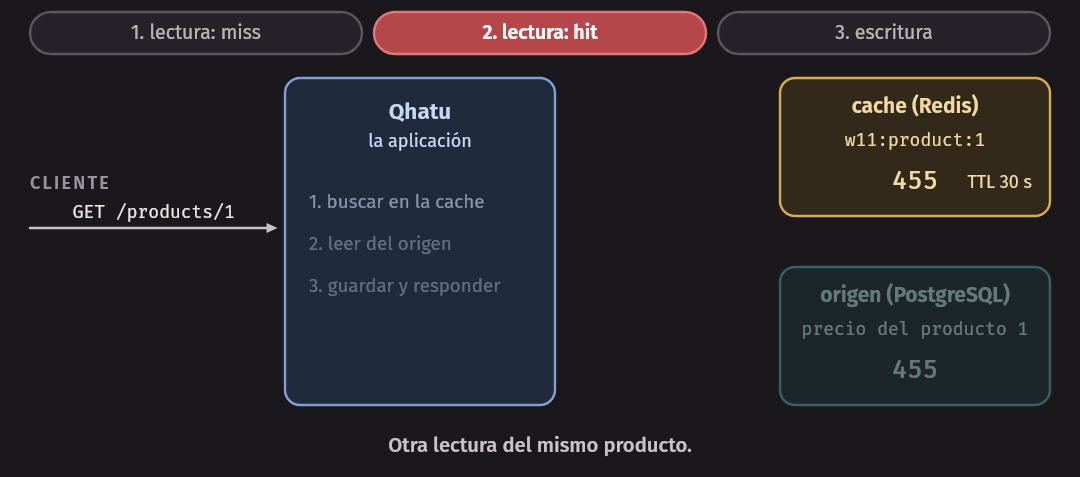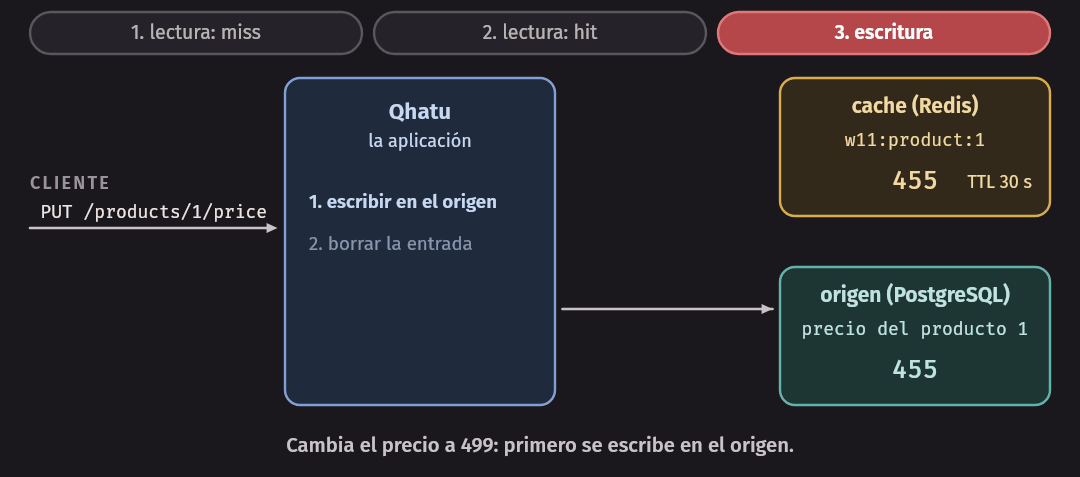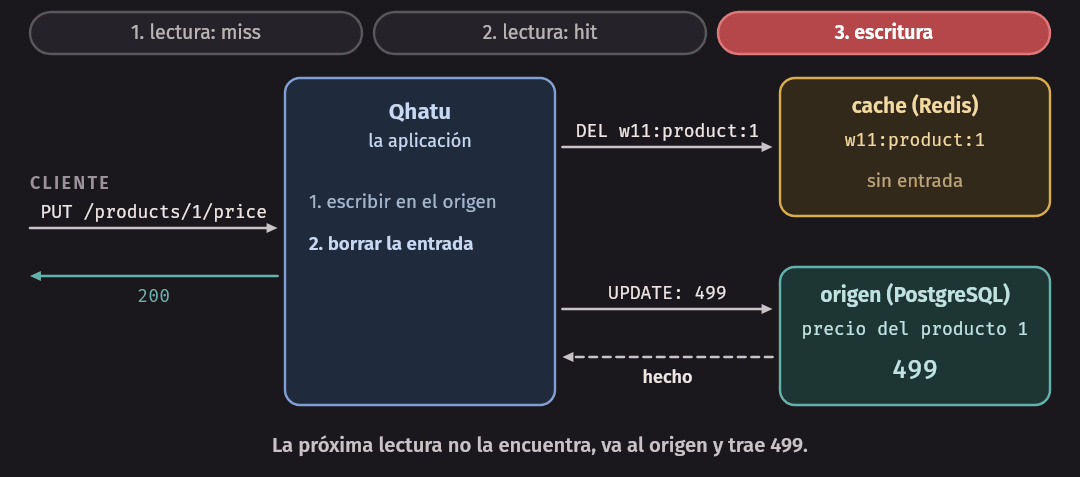
El módulo de la semana, src/cache.ts, es eso mismo, con Redis:
export async function cacheAside<T>(cache, key, ttlMs, load, options = {}) {
  const fullKey = cache.prefix + key;

  // 1. Buscar en la cache.
  const raw = await safely(cache, () => cache.redis.get(fullKey), null);
  if (raw !== null) {
    const entry = decode<T>(raw);
    if ('missing' in entry) {
      cache.stats.negativeHits++;
      return undefined;
    }
    cache.stats.hits++;
    return entry.v;
  }

  // 2. No está: leer del origen.
  cache.stats.misses++;
  const value = await load();

  // 3. Guardar y responder. Siempre con TTL: es lo que acota cuánto puede
  //    durar un valor viejo si alguna invalidación no llega.
  if (value !== undefined) {
    await safely(cache, () => cache.redis.set(fullKey, encode(value), { PX: ttlMs }), null);
  } // ... y si el origen dijo "no existe", ver Cache negativa
  return value;
}
Aquí está sin los tipos de sus parámetros y sin la rama de la cache negativa,
para que se vean los tres pasos. load es la función que lee del origen; quien llama decide cuál es. PX es
el tiempo de vida en milisegundos: pasado ese tiempo, Redis borra la entrada
solo. safely y la entrada missing tienen su sección más abajo.
Qhatu, el ejemplo de la semana
Poner una cache en el catálogo de Tinkuy es parte de P3, así que el capítulo lo hace sobre otro sistema. Qhatu (mercado, en quechua) es el catálogo de una bodega en línea: 200 productos y, por cada uno, sus movimientos de stock.
El stock no es una columna de products: es la suma de los movimientos del
producto en stock_movements (ingresos en positivo, ventas en negativo). Así
nunca se pierde por qué el stock es el que es, y a cambio cada lectura tiene
que sumar.
Tiene la forma que hace razonable una cache. Se lee mucho más de lo que se
escribe: mucha gente mira precios y pocos compran. Y las lecturas son caras
por una decisión de diseño defendible, no por un descuido: como el stock es
la suma de los movimientos, la lista de productos (GET /products) recorre
los 80 100 movimientos cada vez. El detalle de un producto
(GET /products/:id) suma solo los de ese producto, con un índice.
Las escrituras son dos: POST /products/:id/sales registra una venta (un
movimiento negativo, si hay stock) y PUT /products/:id/price cambia el
precio.
Las decisiones de cache están todas en un archivo, src/service.ts: qué se
guarda, con qué clave y cuánto dura.
// Las claves. Con el prefijo quedan como w11:products y w11:product:17.
export const LIST_KEY = 'products';
export const productKey = (id: number): string => `product:${id}`;

/** El detalle de un producto. Clave por id; se guarda también "no existe". */
export async function getProduct(service: Service, id: number): Promise<Product | undefined> {
  const { db, cache, settings } = service;
  if (settings.cacheMode === 'off') return readProduct(db, id);
  return cacheAside(cache, productKey(id), ttlWithJitter(settings.detailTtlMs, settings.jitter), () => readProduct(db, id), {
    negativeTtlMs: settings.negativeTtlMs,
  });
}
make crea los datos y make start levanta el servicio; aquí, con
INVALIDATE=off, que desactiva el borrado al escribir:
$ make
Qhatu: 200 productos, 80100 movimientos de stock. Tinkuy: 24 eventos, 13080 asientos.
$ INVALIDATE=off make start
Qhatu en http://localhost:3000  cache=aside  ttl lista=5000 ms  ttl detalle=30000 ms  invalidación=no  si Redis falla=open
Desde otra terminal, un detalle y tres veces la lista, midiendo cuánto tarda cada una:
$ curl -s localhost:3000/products/1
{"product":{"id":1,"name":"Arroz extra 250 g","category":"abarrotes","priceCents":455,"stock":1663}}
$ curl -s -o /dev/null -w '%{time_total}\n' localhost:3000/products
0.067759
$ curl -s -o /dev/null -w '%{time_total}\n' localhost:3000/products
0.004028
$ curl -s -o /dev/null -w '%{time_total}\n' localhost:3000/products
0.001773
El primer pedido de la lista fue un miss y tardó 68 ms; los dos siguientes fueron hits y tardaron 4 ms y 2 ms. Y en Redis quedó esto:
$ redis-cli --scan --pattern 'w11:*'
w11:products
w11:product:1
$ redis-cli get w11:product:1
{"v":{"id":1,"name":"Arroz extra 250 g","category":"abarrotes","priceCents":455,"stock":1663}}
$ redis-cli ttl w11:product:1
28
$ redis-cli info stats | grep keyspace
keyspace_hits:6
keyspace_misses:2
Dos entradas, cada una con su tiempo de vida contando hacia atrás (ttl
responde los segundos que le quedan). keyspace_hits y keyspace_misses son
los contadores del propio Redis. Cuentan todos los GET que recibió,
incluidos los de redis-cli, y por eso son más que los de la aplicación, que
lleva su propia cuenta:
$ curl -s localhost:3000/stats
{"cache":{"hits":2,"misses":2,"negativeHits":0,"staleServed":0,"errors":0},"originReads":2}
Cuatro lecturas, dos hits, dos misses y dos consultas a PostgreSQL. La tasa de aciertos es la fracción de las lecturas que la cache respondió, : aquí, 2 de 4. Dice si una cache está sirviendo para algo, y se mira junto con la carga sobre el origen, que es lo que de verdad se quiere bajar.
Medido: sin cache y con cache
make compare corre la misma carga (50 usuarios durante 15 segundos, que
piden la lista y el detalle de un producto, ocho de cada diez veces uno de los
diez más vistos) contra Qhatu sin cache, con cache-aside y con una variante
que vemos más adelante. Cada corrida empieza con Redis vacío. En una laptop
con Apple Silicon, dentro de Docker:
$ make compare
== CACHE_MODE=off
duration_detail: med=935.97µs p(95)=6.3ms    p(99)=20.54ms  max=53.03ms
duration_list: med=17.58ms  p(95)=39.99ms  p(99)=71.84ms  max=119.35ms
http_reqs: 6708   441.433343/s
lecturas que llegaron a PostgreSQL: 6708   hits: 0   misses: 0
== CACHE_MODE=aside
duration_detail: med=406.12µs p(95)=1.44ms   p(99)=3.49ms   max=50.69ms
duration_list: med=581.45µs p(95)=1.89ms   p(99)=85.82ms  max=207.03ms
http_reqs: 7390   486.044462/s
lecturas que llegaron a PostgreSQL: 275   hits: 7115   misses: 275
== CACHE_MODE=single-flight
duration_detail: med=419.35µs p(95)=1.67ms   p(99)=3.86ms   max=9.63ms
duration_list: med=910.12µs p(95)=3.22ms   p(99)=27.84ms  max=34.38ms
http_reqs: 7400   490.247369/s
lecturas que llegaron a PostgreSQL: 213   hits: 7154   misses: 213
Las dos primeras, que son las de esta sección:
- La carga sobre el origen bajó de 6 708 consultas a 275, atendiendo más pedidos: una tasa de aciertos de 7 115 entre 7 390, el 96 %. Es la diferencia grande y estable, que se repite en cada corrida.
- La mediana de la lista bajó de 17,6 ms a 0,6 ms. Las cifras absolutas varían bastante entre corridas; la diferencia de un orden de magnitud, no.
- El p99 de la lista subió, de 72 ms a 86 ms, y no es ruido. La mayoría de los pedidos es rapidísima y unos pocos son tan lentos como antes o más: los que llegan justo cuando la entrada venció. La sección Estampida explica por qué, y la tercera corrida es el remedio.
Idea clave. Una cache mejora la mediana mucho más que la cola. Los pedidos que no encuentran la entrada pagan el costo completo del origen, más los dos viajes a Redis. Si el escenario de calidad habla del p99, la cache sola puede no alcanzar.
Read-through, write-through y write-behind
Cache-aside no es la única forma de combinar una cache con un origen. Las otras tres se distinguen por quién habla con el origen:
| Patrón | Lectura | Escritura | Qué se gana | Qué se paga |
|---|---|---|---|---|
| Cache-aside | La aplicación lee de la cache y, si falta, del origen | La aplicación escribe en el origen y borra la entrada | Nada se guarda si nadie lo pide; si la cache se cae, la aplicación sigue | La lógica vive en la aplicación, y hay que acordarse de invalidar |
| Read-through | La aplicación solo le pide a la cache; la cache lee del origen si le falta | (se combina con una de las otras) | La aplicación no sabe que hay un origen | La cache tiene que saber leer del origen; es un componente con más lógica |
| Write-through | La aplicación le escribe a la cache, y la cache escribe en el origen antes de confirmar | La cache siempre tiene lo último que se escribió | Cada escritura paga dos; se guardan cosas que quizá nadie lea | |
| Write-behind | La aplicación le escribe a la cache, que confirma enseguida y escribe en el origen después | Escrituras muy rápidas; absorbe ráfagas | Si la cache se cae antes de escribir en el origen, esas escrituras se pierden |
Write-behind rompe la primera regla de este capítulo: por un rato, el único lugar donde existe el dato es la cache, así que dejó de ser un dato derivado. Sirve para lo que se puede perder (un contador de visitas) y no para lo que no (una orden).
La página de Azure señala el límite de cache-aside: no garantiza consistencia entre la cache y el origen, y si una lectura necesita ver siempre lo que se acaba de escribir, sugiere considerar write-through. En este curso usamos cache-aside porque deja a la vista todas las decisiones y se puede agregar a un sistema que ya existe sin cambiar quién escribe en la base de datos.
Invalidación
Guardar es la parte fácil. La parte difícil es que lo guardado deje de estar cuando ya no es cierto. Hay dos mecanismos, y se usan los dos.
Por tiempo: el TTL
Cada entrada se guarda con un TTL (time to live): pasado ese tiempo, se borra sola. Es simple, no depende de que nadie se acuerde de nada, y da una garantía que se puede escribir en una frase: ningún dato de esta cache tiene más de segundos de viejo, donde es el TTL.
El número sale del negocio, no de la costumbre. La pregunta es cuánto retraso tolera ese dato: el nombre de un producto puede estar una hora viejo sin que nadie lo note; el stock, unos segundos. Y tiene dos lados: un TTL largo da más aciertos y datos más viejos; uno corto, datos más frescos y más carga sobre el origen. En el límite, un TTL más corto que el tiempo entre dos lecturas no sirve de nada: cada lectura encuentra la entrada vencida.
Error común. Guardar en la cache sin decidir cómo se invalida. El resultado es un TTL elegido al azar (“pongámosle cinco minutos”) y un usuario que ve datos viejos sin que nadie del equipo sepa decir por cuánto tiempo. Si no pueden completar la frase “este dato puede estar hasta … de viejo, y eso está bien porque …”, todavía no decidieron.
Por evento: borrar al escribir
El otro mecanismo es exacto: cuando el dato cambia, se borra su entrada. Para
ver por qué hace falta, sigamos con el Qhatu que arrancó con INVALIDATE=off.
Se venden cinco unidades del producto 1 y se vuelve a pedir:
$ curl -s -X POST localhost:3000/products/1/sales -d '{"quantity": 5}'
{"sold":5}
$ curl -s localhost:3000/products/1
{"product":{"id":1,"name":"Arroz extra 250 g","category":"abarrotes","priceCents":455,"stock":1663}}
$ psql -d arq_w11 -c 'SELECT sum(quantity) AS stock FROM stock_movements WHERE product_id = 1'
 stock
-------
  1658
(1 row)
PostgreSQL dice 1 658 y la API dice 1 663. Nada falló: la cache hizo lo que se le pidió, y va a seguir diciendo 1 663 hasta que venza el TTL de 30 segundos.
Ahora se detiene el servicio y se levanta con make start, que trae la
invalidación activada. El primer pedido del producto 1 sigue respondiendo
1 663: el proceso se reinició, pero la entrada vieja estaba en Redis, y Redis
no. Una cache compartida sobrevive a los despliegues de la aplicación, con lo
bueno y con lo malo que tenga adentro. Otra venta, ahora con invalidación:
$ curl -s -X POST localhost:3000/products/1/sales -d '{"quantity": 5}'
{"sold":5}
$ redis-cli exists w11:product:1 w11:products
0
$ curl -s localhost:3000/products/1
{"product":{"id":1,"name":"Arroz extra 250 g","category":"abarrotes","priceCents":455,"stock":1653}}
La venta borró las dos entradas que dejó viejas (exists responde cuántas de
las claves existen: ninguna), y la lectura siguiente trajo 1 653. El código:
/** Una venta cambia el stock: deja viejos el detalle del producto y la lista. */
export async function sell(service: Service, id: number, quantity: number): Promise<SaleResult> {
  const result = await recordSale(service.db, id, quantity);
  // Primero el origen, después la cache, y solo si el origen cambió.
  if (result === 'sold' && service.settings.invalidateOnWrite) {
    await invalidate(service.cache, productKey(id), LIST_KEY);
  }
  return result;
}
Tres detalles que no son obvios:
- Una escritura puede dejar viejas varias entradas: la venta cambia el detalle del producto y también la lista. Saber qué depende de qué es la parte difícil, y crece con cada respuesta nueva que se guarda.
- Hay que acordarse en cada lugar donde se escribe. Si mañana alguien
agrega otra forma de cambiar un producto y se olvida, no falla ninguna
prueba. Y si alguien cambia un precio con
psql, la aplicación no se entera. - El orden es origen primero, cache después. Si se borrara primero, una lectura que llegue entre el borrado y la escritura volvería a guardar el valor viejo, y esta vez por el TTL completo.
Por eso lo habitual es usar los dos mecanismos: borrar al escribir, para
que el caso normal sea exacto, y un TTL como red de seguridad, para que
cualquier invalidación que se pierda (un olvido, un psql, un Redis que no
respondió justo en ese momento) tenga fecha de vencimiento.
Trade-off. Solo TTL: simple y sin acoplar las escrituras a la cache; a cambio, todo dato puede estar viejo hasta , siempre. Solo invalidación por evento: exacta mientras nadie se olvide de nada, y sin límite cuando alguien se olvida. Las dos: el caso normal es exacto y el peor caso está acotado; se paga con el código de invalidación en cada escritura.
Por qué borrar y no actualizar
Si la escritura ya tiene el valor nuevo en la mano, ¿por qué no lo guarda en la cache, en vez de borrar la entrada y obligar a la siguiente lectura a ir al origen? Porque dos escrituras concurrentes pueden dejar la cache con el valor que perdió.
El programa race.ts ejecuta pasos en el orden que se le diga, uno por uno,
sin esperas ni azar. Con --writers hay dos escritores sobre el precio del
producto 1: A lo pone en 470 y B en 499. Cada uno hace dos cosas: cambia
PostgreSQL (paso 1) y después la cache (paso 2). Con --update, el paso 2
guarda el valor nuevo en vez de borrar:
$ node race.ts --writers --update A1 B1 B2 A2
A1  UPDATE en PostgreSQL: el precio ahora es 470
B1  UPDATE en PostgreSQL: el precio ahora es 499
B2  SET en la cache: 499
A2  SET en la cache: 470

PostgreSQL: 499
Cache:      470
VIEJO: la cache va a responder 470 durante 29994 ms más, hasta que venza el TTL.
En PostgreSQL ganó B, que escribió último. En la cache ganó A, que escribió
último ahí. No hay nada que obligue a que los dos órdenes coincidan: entre
el paso 1 y el paso 2 de A pasa tiempo, y B puede completar los suyos en el
medio. Con el mismo orden y borrando (node race.ts --writers A1 B1 B2 A2),
los dos pasos finales son dos DEL, y la cache queda sin entrada: la próxima
lectura va a PostgreSQL y trae 499.
Borrar dos veces da lo mismo que borrar una, en cualquier orden. Las pruebas de la semana recorren los seis órdenes posibles de esos cuatro pasos: actualizando, dos dejan la cache con el valor perdedor; borrando, ninguno.
En la industria. Facebook describe su uso de memcache como cache-aside (ellos dicen look-aside): para leer, el servidor web pide el valor a memcache y, si no está, lo trae de la base de datos y lo guarda; para escribir, ejecuta el SQL y después manda un borrado a memcache. Y dan su razón en una línea: eligen borrar en vez de actualizar porque los borrados son idempotentes. Fuente: Nishtala y otros, Scaling Memcache at Facebook (2013), sección 2.
Borrar tiene su costo: la lectura siguiente es un miss seguro, y si la entrada es muy pedida, muchas lo son a la vez. Es una puerta de entrada a la estampida.
La carrera que queda
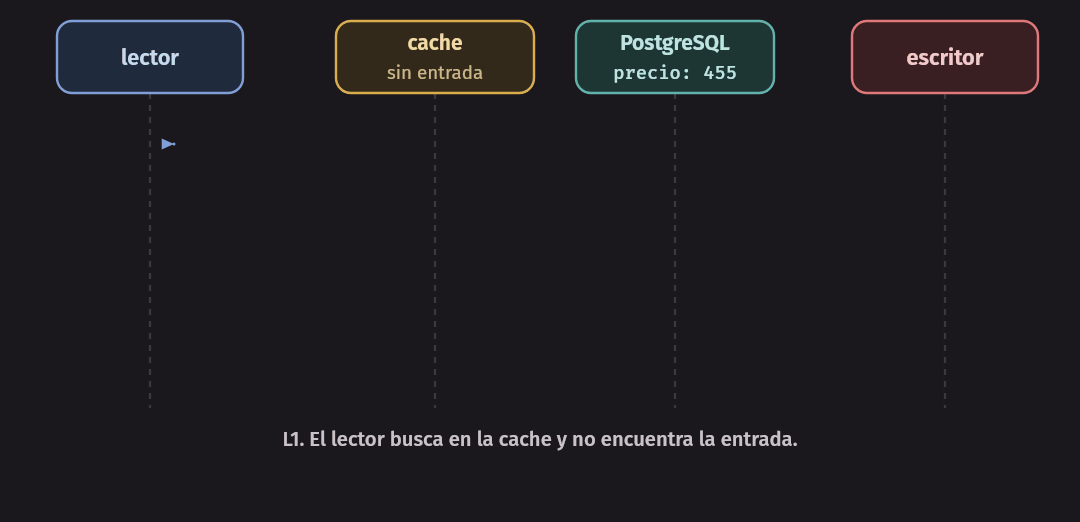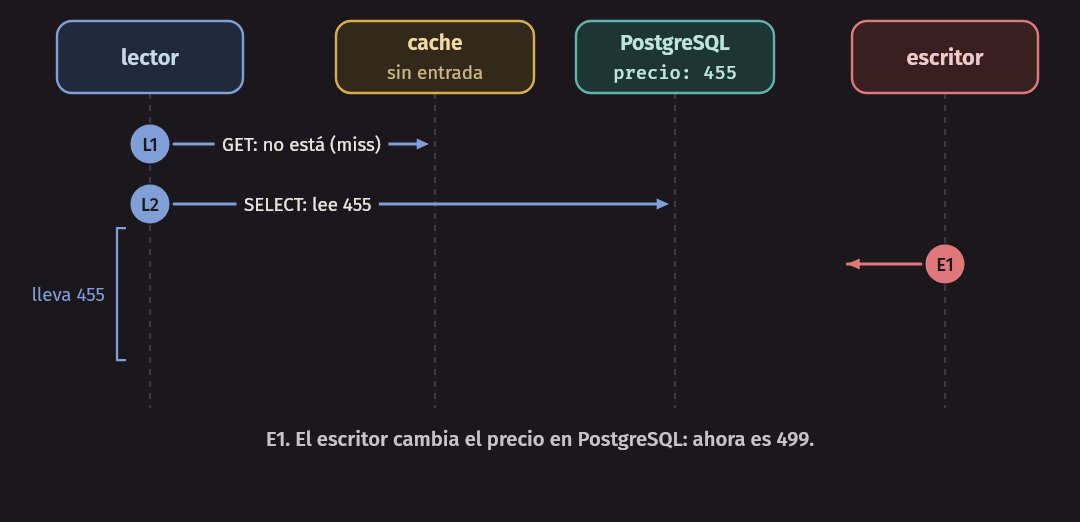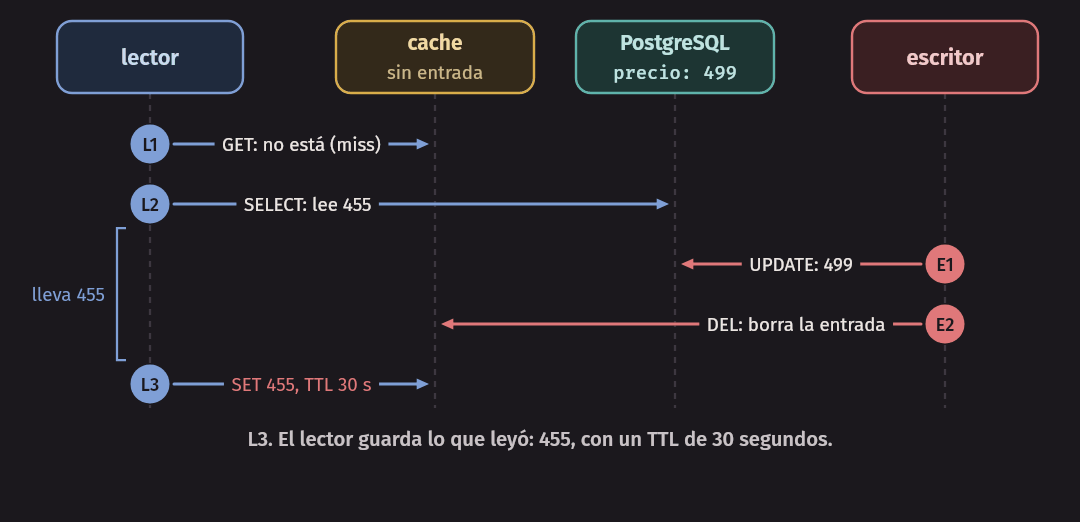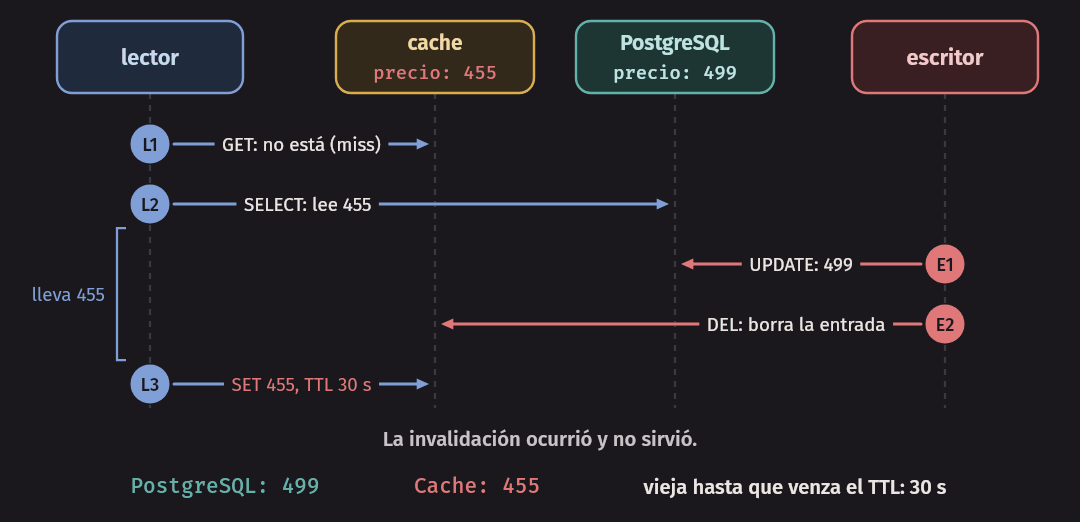
Borrar al escribir no cierra todas las carreras. Queda una, entre una lectura y una escritura. El lector hace su cache-aside en tres pasos y el escritor cambia el precio en dos:
| Lector | Escritor |
|---|---|
L1 busca en la cache |
E1 cambia el precio en PostgreSQL |
L2 lee el precio de PostgreSQL |
E2 borra la entrada de la cache |
L3 guarda en la cache lo que leyó |
Si el lector termina antes de que el escritor empiece (L1 L2 L3 E1 E2), no
pasa nada: el lector guarda 455, el escritor cambia el precio y borra la
entrada. Pero si el escritor completa sus dos pasos entre L2 y L3:
$ node race.ts L1 L2 E1 E2 L3
L1  GET en la cache: no está (miss)
L2  SELECT en PostgreSQL: lee 455
E1  UPDATE en PostgreSQL: el precio ahora es 499
E2  DEL en la cache
L3  SET en la cache: 455, con TTL de 30000 ms

PostgreSQL: 499
Cache:      455
VIEJO: la cache va a responder 455 durante 29998 ms más, hasta que venza el TTL.
El lector leyó 455 cuando era cierto. El escritor cambió el precio y borró una entrada que todavía no existía. Y el lector guardó, con toda la autoridad de un valor recién traído, un precio que ya no es. La invalidación ocurrió y no sirvió.
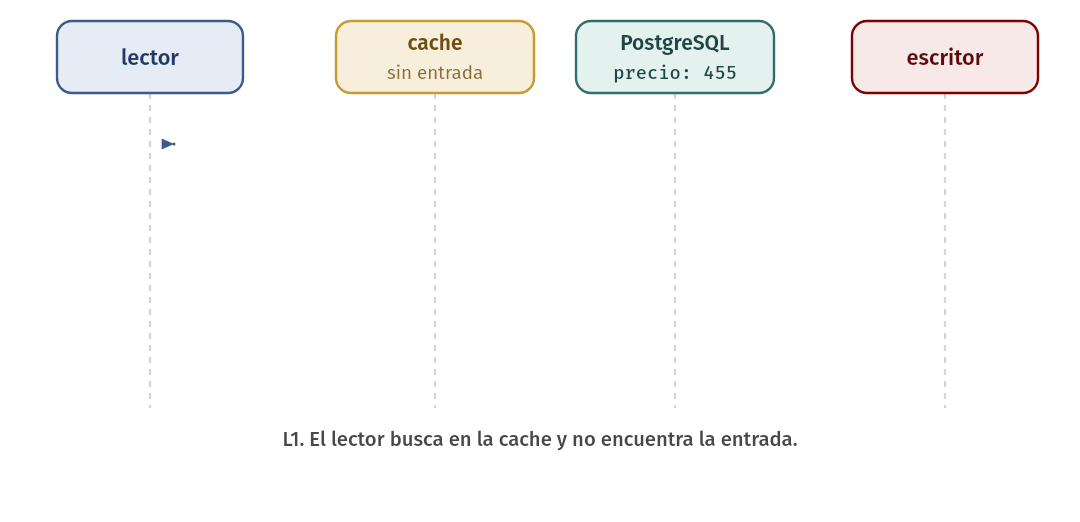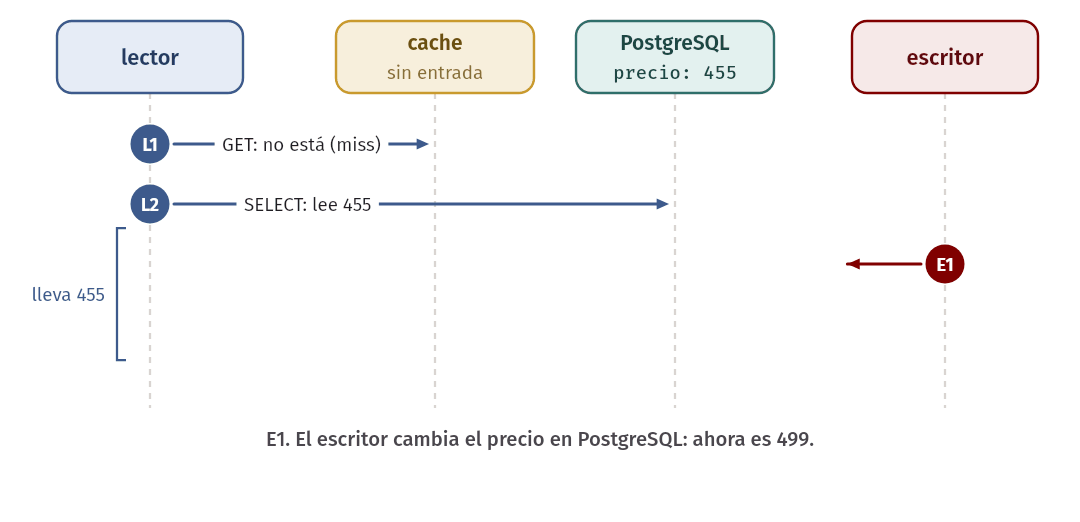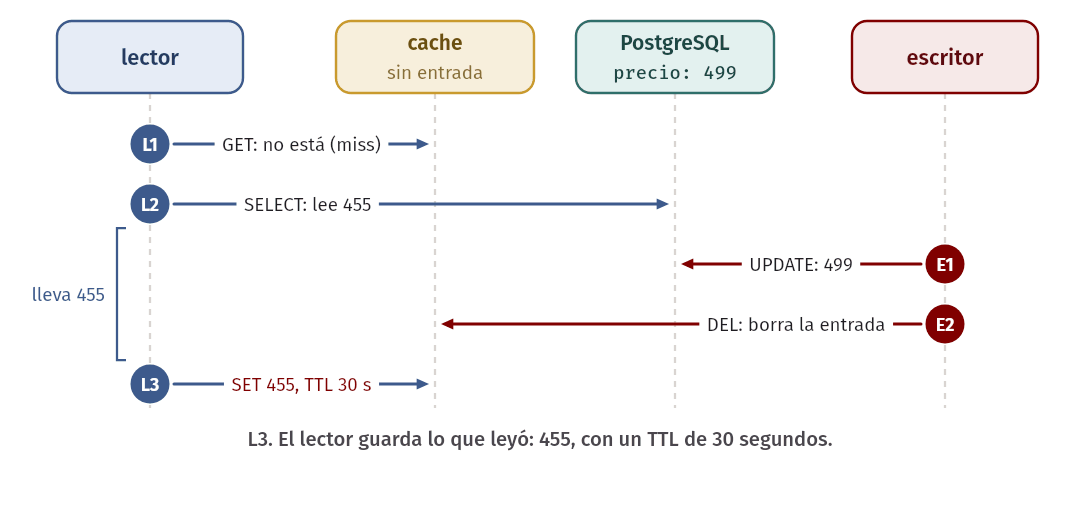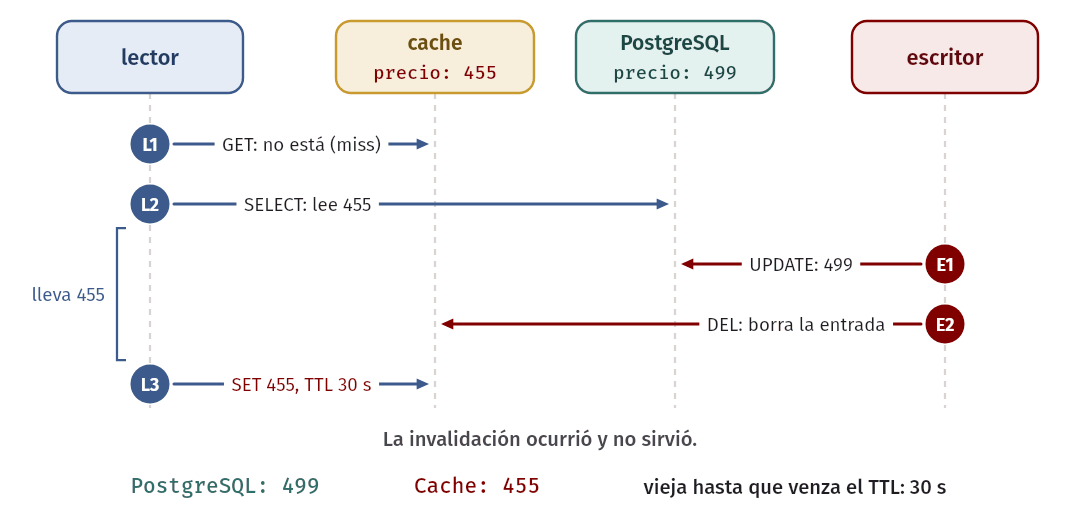
Hay diez formas de intercalar esos cinco pasos respetando el orden de cada
actor. Las pruebas las corren todas, y solo esa deja la cache vieja: hace
falta que el lector lea antes del cambio (L2 antes que E1) y guarde
después del borrado (E2 antes que L3). Es raro. Se vuelve menos raro
cuando la lectura del origen es lenta, y sobre todo cuando hay miles de
lecturas y escrituras por segundo sobre la misma clave: lo raro, multiplicado
por mucho, pasa todos los días.
Qué la acota: el TTL. La entrada vieja se guardó con tiempo de vida. En
el peor caso dura lo que dure el TTL, y después se va sola. Es la razón por la
que cacheAside no tiene una opción para guardar sin TTL, y es lo que
convierte “la cache puede quedar mal para siempre” en “la cache puede quedar
mal hasta treinta segundos”. Con jitter de fracción , la cota es
: con de 30 s y de 0,1, 33 segundos.
Idea clave. Con cache-aside, la consistencia entre la cache y el origen no se garantiza: se acota. La invalidación al escribir hace que el caso normal sea exacto; el TTL pone el techo del caso anormal. Elegir el TTL es elegir ese techo.
Qué la elimina: un lease. El TTL acota la carrera; no la elimina. Para
eliminarla, la cache tiene que poder responder si la entrada fue invalidada
después de que este lector la buscó. El artículo de Facebook llama lease
al mecanismo: cuando un lector tiene un miss, la cache le da un token asociado
a esa clave, y para guardar hay que presentarlo. Si entre tanto llegó un
borrado, la cache invalidó el token y rechaza el guardado.
node race.ts --lease L1 L2 E1 E2 L3 lo imita con una segunda clave de Redis,
y su último paso dice la cache rechaza el SET de 455: el lease ya no existe.
Con el lease, ninguno de los diez órdenes deja la cache vieja. Cuesta una
clave más por cada miss y más código que entender y probar; para la mayoría de
los sistemas el TTL alcanza, y el lease es para cuando el volumen hace que lo
raro sea frecuente.
La tabla de decisiones
Todo lo anterior son decisiones, y se escriben antes de programar. El archivo
cache-decisions-template.md de la carpeta de la semana es la tabla, con una
fila por cada respuesta del sistema:
| Columna | La pregunta que responde |
|---|---|
| Respuesta | ¿Qué endpoint o consulta, con qué parámetros? |
| ¿Va a la cache? ¿Por qué? | ¿Cuánto se lee por cada vez que cambia, cuánto cuesta y cuánto retraso tolera? |
| Clave | ¿Qué hace que dos respuestas sean distintas? |
| TTL | ¿Cuánto retraso tolera el negocio para este dato? |
| Qué la invalida | ¿Qué escrituras la dejan vieja, y en qué lugar del código ocurren? |
| Cuán vieja puede llegar a estar y quién lo nota | Si falla una invalidación, ¿qué ve el usuario y por cuánto tiempo? |
| Con la cache vacía o caída | ¿El origen aguanta? |
“No va a la cache” es una respuesta válida y también se escribe, con su razón. El archivo trae la tabla llena para Qhatu como ejemplo.
La columna de la clave merece un aviso. La clave tiene que incluir todo lo
que hace distinta a la respuesta. Si GET /events?city=Cusco y
GET /events?city=Lima se guardaran con la misma clave, quien pregunta por
Lima recibiría los eventos del Cusco. Y si la respuesta depende de quién
pregunta, el usuario va en la clave, o esa respuesta no va a una cache
compartida.
Estampida
Qué es
Una entrada muy pedida vence. En el instante siguiente llegan cincuenta peticiones. Las cincuenta hacen el paso 1 del cache-aside y las cincuenta tienen un miss, porque ninguna ha tenido tiempo de guardar nada. Las cincuenta van al origen a calcular exactamente lo mismo, a la vez. Eso es una estampida (en inglés, cache stampede o thundering herd).
Lo que la hace peligrosa es que se alimenta sola. Cincuenta consultas iguales y simultáneas compiten por la base de datos, así que cada una tarda más que sola; mientras tardan, siguen llegando peticiones, que también tienen un miss. El número de consultas por estampida es, aproximadamente, las peticiones que llegan mientras dura el primer recálculo:
donde es la tasa de llegada de peticiones para esa clave y lo que tarda el origen bajo esa carga. Cuanto más lento el origen, más grande la estampida, y al revés.
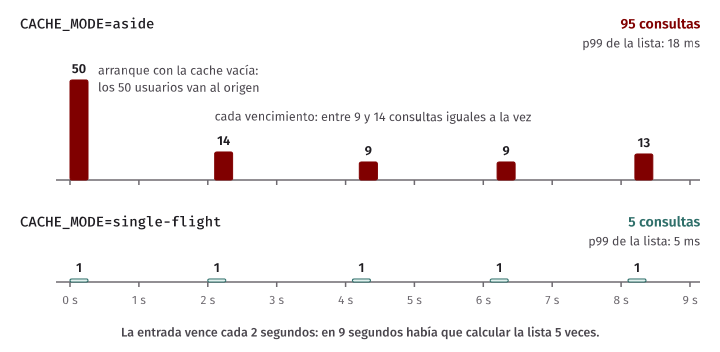
make stampede la mide. Qhatu arranca con un TTL de 2 segundos para la lista
y 50 usuarios la piden sin parar durante 9 segundos. Las consultas no se
cuentan en la aplicación sino en PostgreSQL: tools/pg-queries.ts le pide que
registre cada sentencia en su log, y después cuenta las que corresponden a la
lista y las agrupa en ráfagas. Con cache-aside:
$ make stampede
== CACHE_MODE=aside, la lista vence cada 2 segundos
duration_list: med=851.02µs p(95)=3.17ms  p(99)=18.14ms max=120.34ms
http_req_failed: 0.00%  0 out of 8582
http_reqs: 8582   948.28793/s
Consultas a arq_w11 que contienen "LEFT JOIN stock_movements": 95, en 5 ráfagas
ráfaga  empieza en  consultas  dura
     1       0,0 s         50    96 ms
     2       2,1 s         14    25 ms
     3       4,2 s          9    16 ms
     4       6,2 s          9     8 ms
     5       8,2 s         13    17 ms
La ráfaga más grande: 50 consultas
La lista se necesitaba calcular cinco veces en nueve segundos, una por cada vencimiento. Se calculó 95. La primera ráfaga es el arranque con la cache vacía: los 50 usuarios llegan a la vez y los 50 van a PostgreSQL. Las siguientes son los vencimientos, y coinciden con la fórmula: a unos 950 pedidos por segundo, y con ráfagas que duraron entre 8 y 25 ms, salen entre 8 y 24 pedidos por ráfaga; se contaron entre 9 y 14.
En otra corrida, con la máquina más ocupada y el origen más lento, las mismas ráfagas duraron entre 164 y 293 ms y sumaron 140 consultas en vez de 95: no es una constante.
En Tinkuy.
GET /eventsdel Tinkuy inicial hace 25 consultas por pedido (una para la lista y una por cada evento). Con una cache-aside simple delante, cada vencimiento bajo carga sería una estampida de pedidos de 25 consultas cada uno: la lectura lenta no deja de ser un problema; se convierte en uno que aparece de golpe cada pocos segundos.
Que solo uno recalcule
El remedio más directo: cuando la entrada vence, una sola petición recalcula. Las demás no van al origen. ¿Qué reciben? Hay dos respuestas posibles: esperan a que la primera termine, o reciben el valor anterior, el que acaba de vencer. Lo segundo es casi siempre mejor: un valor de hace dos segundos y un instante, entregado ya, en vez de un valor nuevo después de esperar.
src/single-flight.ts lo hace con tres claves de Redis por entrada:
w11:productstiene el valor, y vive mucho más que el TTL: con un TTL de 5 segundos, 55.w11:products:freshes una marca vacía que vive exactamente el TTL. Mientras la marca existe, el valor está vigente. Cuando la marca vence, el valor sigue ahí: es el valor anterior.w11:products:lockaparece solo mientras alguien recalcula.
Que la vigencia sea una clave con su propio TTL, y no una fecha guardada dentro del valor, es a propósito: así quien decide si algo venció es el reloj de Redis, uno solo, y no el reloj de cada instancia de la aplicación, que pueden diferir (semana 10).
Quién recalcula lo decide un comando:
const locked = await safely(cache, () => cache.redis.set(lockKey, token, { NX: true, PX: options.lockMs }), null);SET clave valor NX PX 5000 quiere decir: guarda esta clave solo si no
existe (NX), y bórrala sola a los 5 000 ms (PX). Redis ejecuta los
comandos de uno en uno, así que de cincuenta peticiones que lo manden a la
vez, exactamente una recibe OK. Esa va al origen, guarda el valor y la
marca, y suelta el lock. Las demás responden con el valor anterior.
Las dos opciones hacen falta. Sin NX no hay exclusión. Sin PX, si el
proceso que obtuvo el lock se cae antes de soltarlo, nadie vuelve a recalcular
esa entrada; con PX, el lock de un proceso muerto vence solo. Al soltar, se
borra el lock solo si todavía es de uno (por eso lleva un token al azar):
si el recálculo tardó más que el lock, otro ya lo tomó. Y si no hay valor
anterior (la cache recién arrancó, o una escritura borró la entrada), los que
no obtuvieron el lock esperan un poco, vuelven a mirar y, pasado un plazo, van
al origen.
La misma medición, con este módulo:
== CACHE_MODE=single-flight, la lista vence cada 2 segundos
duration_list: med=805.2µs p(95)=2.78ms p(99)=5.34ms  max=54.76ms
http_req_failed: 0.00%  0 out of 8678
http_reqs: 8678   959.092931/s
Consultas a arq_w11 que contienen "LEFT JOIN stock_movements": 5, en 5 ráfagas
ráfaga  empieza en  consultas  dura
     1       0,0 s          1     0 ms
     2       2,0 s          1     0 ms
     3       4,1 s          1     0 ms
     4       6,1 s          1     0 ms
     5       8,1 s          1     0 ms
La ráfaga más grande: 1 consulta
Cinco consultas, una por vencimiento: de 95 a 5. Y el p99 de la lista bajó de
18 ms a 5 ms, porque ya nadie espera a un origen congestionado. Es también la
explicación de la tercera corrida de make compare: el p99 de la lista, que
con cache-aside era 86 ms, con single-flight fue 28 ms.
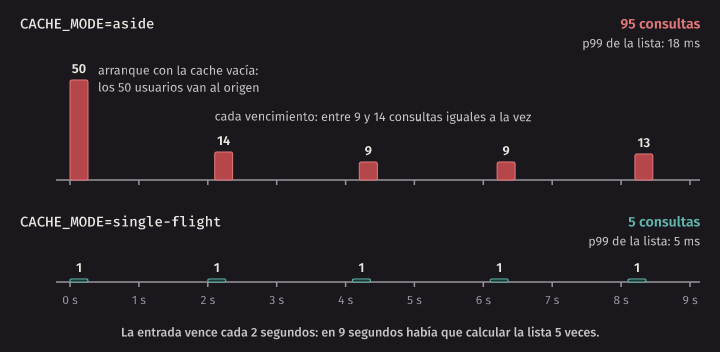
Trade-off. Single-flight con valor anterior cambia carga sobre el origen por frescura: mientras uno recalcula, los demás reciben un dato que ya venció. El TTL deja de ser “nadie ve algo más viejo que ” y pasa a ser “nadie ve algo más viejo que más lo que tarde el recálculo”. Si eso no es aceptable para un dato, la alternativa es que los demás esperen: nadie ve un dato vencido, y la latencia de todos es la del recálculo. Además hay más piezas: tres claves por entrada y un lock con sus casos borde.
Una advertencia sobre la palabra lock. Este lock es una optimización: si
falla y dos procesos recalculan a la vez, el resultado es trabajo de más, no
un dato incorrecto. Eso es lo que permite hacerlo con un SET NX PX y un
tiempo de vencimiento. Un lock del que dependa la corrección (que dos procesos
no vendan el mismo asiento) es otro problema, y no se resuelve así: un proceso
que se detiene más de lo que dura su lock sigue creyendo que lo tiene. Para
eso están las transacciones de la base de datos (semana 12).
En la industria. Los leases de Facebook resuelven también esto. El servidor de memcache entrega, por omisión, un token cada 10 segundos por clave; a quien pide la misma clave en ese intervalo le responde que espere un momento y reintente. El artículo reporta una semana de mediciones sobre un conjunto de claves propensas a estampidas: sin leases, los misses producían un pico de 17 000 consultas por segundo a la base de datos; con leases, de 1 300. Y las aplicaciones que pueden avanzar con un dato algo viejo reciben el valor recién borrado, marcado como tal. Fuente: Nishtala y otros (2013), sección 3.2.
Jitter
Single-flight resuelve la estampida sobre una clave. Hay otra, sobre muchas: mil entradas que se guardaron en el mismo instante (después de un deploy, de un reinicio de Redis, de un proceso que llenó la cache de golpe) con el mismo TTL vencen en el mismo instante, y mil recálculos distintos caen juntos sobre el origen.
El remedio es no darles a todas el mismo TTL: sumarle o restarle a cada una una fracción al azar, jitter.
export function ttlWithJitter(baseMs: number, spread: number, random: () => number = Math.random): number {
  const factor = 1 - spread + 2 * spread * random();
  return Math.max(1, Math.round(baseMs * factor));
}
make jitter guarda 1 000 entradas a la vez con TTL de 60 segundos, sin
jitter y con ±10 %, y le pregunta a Redis cuándo vence cada una:
$ make jitter
TTL de 60 s exactos: vencen entre el segundo 60 y el 60; en el peor segundo vencen 1000 de 1000
TTL de 60 s ± 10 %  : vencen entre el segundo 54 y el 66; en el peor segundo vencen 98 de 1000
De mil recálculos en un segundo a menos de cien en el peor. Cuesta una línea de código y que el TTL deje de ser un número exacto: con ±10 %, un dato puede vivir un 10 % más de lo que dice la tabla de decisiones. El jitter va a volver en la semana 14, con el mismo propósito: que mil clientes que reintentan no reintenten todos a la vez.
Recalcular antes de que venza
El tercer remedio es que la entrada nunca llegue a vencer delante de un usuario: un proceso de fondo recalcula las entradas importantes cada cierto tiempo, antes de su TTL. Sirve para un conjunto pequeño y conocido de claves (la lista de eventos, la portada). Se paga recalculando cosas que quizá nadie pidió, y con un proceso más que puede detenerse sin que nadie lo note: si se detiene, las entradas vencen y vuelve la estampida que se quería evitar. Single-flight con valor anterior es la misma idea disparada por una lectura.
Depender de la cache
Cache de latencia y cache de capacidad
Una cache se agrega para que el sistema responda más rápido. Funciona, el tráfico crece, y la base de datos sigue tranquila porque la cache absorbe el 96 % de las lecturas. Dos años después, la base de datos está dimensionada para el 4 % restante, y nadie lo decidió. La cache dejó de ser una optimización y pasó a ser parte de la capacidad del sistema.
El libro de SRE de Google les pone nombre a los dos casos. Una cache de latencia es aquella sin la cual el servicio aguanta la carga esperada, más lento. Una cache de capacidad es aquella sin la cual no la aguanta. Y advierte que las caches que se agregan para mejorar el rendimiento terminan a veces siendo dependencias duras. La diferencia no está en el código: está en cuánta carga soporta el origen solo, y cambia con el tiempo sin que nadie toque nada.
Hay dos situaciones en las que se descubre cuál de las dos se tiene, y conviene que no sea en producción: la cache caída y la cache vacía.
Redis caído, medido
make redis-down corre 50 usuarios durante 12 segundos; en el segundo 4 mata
Redis con svc kill redis, como en una caída real, y en el 8 lo vuelve a
levantar. Cada línea es un segundo, contado por el servidor. Primero con un
servicio que no previó la falla: un error de Redis se propaga a quien llama
(CACHE_FAILURE=closed).
$ make redis-down
== CACHE_FAILURE=closed
…
t= 4s  pedidos= 460  hits= 440  viejos=   0  origen=  20  errores_cache=   0  5xx=   0  p95=5,6 ms
   (segundo 4: svc kill redis)
t= 5s  pedidos= 500  hits=  49  viejos=   0  origen=   1  errores_cache= 450  5xx= 450  p95=1,0 ms
t= 6s  pedidos= 499  hits=   0  viejos=   0  origen=   0  errores_cache= 499  5xx= 499  p95=0,1 ms
t= 7s  pedidos= 486  hits=   0  viejos=   0  origen=   0  errores_cache= 486  5xx= 486  p95=0,1 ms
t= 8s  pedidos= 465  hits=   0  viejos=   0  origen=   0  errores_cache= 465  5xx= 465  p95=0,1 ms
   (segundo 8: svc start redis)
t= 9s  pedidos= 451  hits=  87  viejos=   0  origen=  64  errores_cache= 300  5xx= 300  p95=90,8 ms
t=10s  pedidos= 491  hits= 449  viejos=   0  origen=  42  errores_cache=   0  5xx=   0  p95=4,6 ms
…
http_req_failed: 37.95% 2200 out of 5796
Durante los cuatro segundos sin Redis, todos los pedidos fallaron, con
PostgreSQL sano y sin recibir una sola consulta (origen=0). Un componente
que era opcional tumbó al sistema entero. Es lo que pasa por omisión, cuando
el código de la cache deja que sus excepciones suban.
Ahora con el servicio como viene (CACHE_FAILURE=open): si Redis falla, la
lectura va al origen.
== CACHE_FAILURE=open
…
t= 4s  pedidos= 495  hits= 472  viejos=   0  origen=  23  errores_cache=   0  5xx=   0  p95=1,0 ms
   (segundo 4: svc kill redis)
t= 5s  pedidos= 439  hits=  11  viejos=   0  origen= 434  errores_cache= 860  5xx=   0  p95=24,8 ms
t= 6s  pedidos= 447  hits=   0  viejos=   0  origen= 443  errores_cache= 890  5xx=   0  p95=27,7 ms
t= 7s  pedidos= 449  hits=   0  viejos=   0  origen= 452  errores_cache= 901  5xx=   0  p95=23,3 ms
t= 8s  pedidos= 440  hits=   0  viejos=   0  origen= 447  errores_cache= 887  5xx=   0  p95=28,7 ms
   (segundo 8: svc start redis)
t= 9s  pedidos= 470  hits= 188  viejos=   0  origen= 270  errores_cache= 479  5xx=   0  p95=25,5 ms
t=10s  pedidos= 498  hits= 460  viejos=   0  origen=  38  errores_cache=   0  5xx=   0  p95=0,9 ms
…
http_req_failed: 0.00%  0 out of 5690
Ningún pedido falló. Lo que cambió es lo que tenía que cambiar: las consultas
a PostgreSQL pasaron de unas 25 por segundo a unas 445 (todas), y el p95 de
1 ms a unos 26 ms. El sistema degradó en vez de caerse (semana 6). El
código es safely, en src/cache.ts: una función de pocas líneas por la que
pasa toda operación de Redis, que atrapa el error, lo cuenta y devuelve un
valor de reemplazo. Un GET que falla devuelve null, que es lo mismo que un
miss; un SET que falla no hace nada. Para quien llama, una cache caída se ve
como una cache vacía. Hay un detalle más, en la conexión, que importa tanto como este: el
cliente de Redis está configurado para fallar al instante cuando no hay
conexión (disableOfflineQueue), en vez de encolar los comandos hasta que
Redis vuelva. Sin eso, cada pedido se quedaría esperando a un Redis que no
está, y degradar sería colgarse.
La pregunta que queda es la de la sección anterior: ¿PostgreSQL aguantó la
carga completa? Aquí sí: con 445 consultas por segundo respondió con un p95
de 26 ms y sin errores. A esta carga, la cache de Qhatu es de latencia. No es
una propiedad de Qhatu, sino de Qhatu con 50 usuarios: con una lectura como
el GET /events de Tinkuy la respuesta puede ser otra, y hay que medirla con
CACHE_MODE=off y la carga del pico esperado.
Error común. Un sistema que responde bien con la cache caliente y se cae cuando Redis se reinicia. El error de diseño no es usar una cache: es no saber que el origen ya no aguanta sin ella. Se detecta antes de producción con dos pruebas de carga que casi nadie corre: una con la cache apagada y otra reiniciando Redis en medio de la carga.
Dos cosas que degradar no resuelve. Mientras Redis no responde, las invalidaciones tampoco llegan: si Redis vuelve con sus datos (solo estuvo inalcanzable), tiene entradas que debieron borrarse, y lo único que las saca es el TTL. Y si el origen no aguanta la carga completa, mandarle todo el tráfico lo tumba también a él: entonces degradar es rechazar parte de los pedidos (load shedding, semana 14) para proteger lo que sí se puede atender.
En la industria. Facebook trata la caída de servidores de cache como un riesgo para la base de datos: no poder leer de memcache, dice el artículo, produce una carga excesiva sobre los servicios de backend que puede causar fallas en cascada. Su respuesta es un conjunto pequeño de máquinas de reserva, Gutter (alrededor del 1 % de los servidores de memcached de un clúster), que hace de cache temporal cuando un servidor no responde. Fuente: Nishtala y otros (2013), sección 3.3.
La cache vacía
La otra situación es más frecuente y más silenciosa: la cache está, pero no tiene nada. Pasa después de reiniciar Redis (en el contenedor del curso Redis no guarda nada en disco), al desplegar en una región nueva o al cambiar el formato de las claves. En la medición de arriba es el segundo 9. El origen recibe la carga completa, igual que con la cache caída, y además todas las estampidas a la vez. El libro de SRE recomienda, para una cache de la que depende la capacidad, subir la carga de a pocos, para que los primeros pedidos la llenen antes de que lleguen los demás. La otra opción es llenarla antes de abrir el tráfico, con un proceso que pida las claves más usadas.
Trade-off. Una cache de capacidad es más barata que una base de datos del tamaño del pico: es una decisión legítima. Cuesta que la cache pasa a ser un componente crítico, con réplica, con un plan para llenarla después de un reinicio y con una prueba de que el sistema sobrevive a perderla. Lo que no es legítimo es tenerla sin saberlo.
Memoria finita
Desalojo
Una cache vive en memoria, y la memoria se acaba. Cuando se llena, hay que decidir qué pasa con la siguiente escritura. A sacar una entrada para hacer lugar se le llama desalojo (eviction), y la regla que elige cuál sale es la política:
- LRU (least recently used): sale la que hace más tiempo que nadie usa. Supone que lo usado hace poco se va a volver a usar.
- LFU (least frequently used): sale la que menos veces se ha usado. Protege a las entradas populares de una ráfaga de entradas nuevas que nadie volverá a pedir.
En Redis se configura con maxmemory (el límite) y maxmemory-policy. Y el
valor por omisión de la política no es ninguna de las dos:
$ redis-cli config get maxmemory-policy
maxmemory-policy
noeviction
Con noeviction, Redis no desaloja nada: cuando se llena, rechaza las
escrituras. Tiene sentido si Redis se usa como base de datos; para una cache
es lo contrario de lo que se quiere. make eviction lo muestra: fija el
límite 2 MB por encima de lo que Redis usa en ese momento e intenta guardar
5 000 entradas de 1 KB, con cada política.
$ make eviction
Límite: lo que Redis usa ahora más 2 MB. Se escriben 5000 entradas de 1 KB.
maxmemory-policy = noeviction
  escrituras rechazadas: 3524  ("OOM command not allowed when used memory > 'maxmemory'.")
  entradas desalojadas:  0
  quedan 1476 de 5000; la primera que se escribió sigue, la última no entró
maxmemory-policy = allkeys-lru
  escrituras rechazadas: 0
  entradas desalojadas:  3525
  quedan 1475 de 5000; la primera que se escribió ya no está, la última está
Con noeviction la cache se quedó con las primeras 1 476 entradas y rechazó
todo lo demás. Con allkeys-lru aceptó todo y fue sacando lo menos usado; la
documentación de Redis la sugiere como una buena opción por omisión.
De aquí salen dos consecuencias. Una entrada puede desaparecer antes de su TTL: el TTL es un máximo, no una promesa, y con cache-aside eso no es un problema porque cada lectura está preparada para un miss. Y qué claves entran también es una decisión: una entrada por cada combinación de filtros que alguien probó una vez llena la memoria de cosas que nadie vuelve a pedir, y el desalojo empieza a sacar las que sí importan.
Cache negativa
Cache-aside, tal como se describió, guarda lo que el origen devuelve. ¿Y cuando el origen responde “eso no existe”? No hay nada que guardar, así que la siguiente pregunta por lo mismo es otro miss, y la siguiente. Las preguntas por algo inexistente llegan siempre al origen, sin importar cuántas veces se repitan. Basta un enlace roto en una página muy visitada, o alguien recorriendo ids a propósito, para que la cache no proteja nada.
La cache negativa guarda también la respuesta “no existe”. En Qhatu es
una entrada {"missing":true} con un TTL de 5 segundos. make negative cuenta
la diferencia con 200 pedidos seguidos del mismo producto inexistente:
$ make negative
200 pedidos de GET /products/999999, que no existe:
  sin cache negativa:               200 consultas a PostgreSQL
  con cache negativa (TTL de 5 s):  1 consulta a PostgreSQL
  en Redis quedó: {"missing":true}
Trade-off. La cache negativa protege al origen de las preguntas repetidas por lo que no existe. Se paga de dos maneras. Algo que no existía y se acaba de crear sigue “sin existir” hasta que venza la entrada, salvo que crear también invalide; por eso su TTL es corto, mucho más que el de una entrada normal. Y no protege de quien pregunta por un id distinto cada vez: ahí cada pregunta es una clave nueva, y lo que se consigue es llenar la memoria de entradas
missing. Para eso sirven otras cosas (validar el formato del id antes de buscar, rate limiting).
Escalar hacia los lados
Servicios sin estado
Hasta aquí, todo fue sobre los datos. Queda el cómputo: el proceso que atiende los pedidos. Cuando una instancia no alcanza, hay dos caminos. Escalar hacia arriba es darle una máquina más grande. Escalar hacia los lados es correr más copias del mismo servicio y repartir los pedidos entre ellas. Lo segundo no tiene el tope de la máquina más grande que existe, y además da disponibilidad: si una copia se cae, quedan las otras.
Tiene un requisito: que cualquier instancia pueda atender cualquier pedido. Eso se cumple si el servicio no guarda estado propio entre un pedido y el siguiente. Un servicio así se llama sin estado (stateless). No quiere decir que el sistema no tenga estado: quiere decir que el estado vive en otro lado, en un almacén que todas las instancias comparten.
Lo que rompe el requisito: las sesiones en memoria (si el carrito del comprador está en un objeto del proceso que lo atendió, su siguiente pedido tiene que caer en el mismo proceso; se puede forzar con sticky sessions, y entonces apagar esa instancia es perder los carritos), los archivos en el disco local y una cache local que tiene que ser exacta, que es la sección siguiente.
The Twelve-Factor App lo pone como regla: los procesos no guardan estado y no comparten nada; lo que deba persistir va a un servicio de respaldo, como una base de datos. La memoria del proceso se puede usar como cache breve, dentro de una operación, sin suponer nunca que lo que quedó ahí va a estar en el pedido siguiente. Y las sticky sessions son, dice, una violación de la regla: los datos de sesión van a un almacén con vencimiento, como Redis.
Qhatu cumple: src/server.ts no guarda nada entre pedidos, así que diez
copias del servicio ven los mismos datos y la misma cache, y cualquiera se
puede apagar.
Idea clave. Escalar hacia los lados no elimina el estado: lo mueve. El servicio se vuelve fácil de copiar porque el problema difícil (los datos, su consistencia, su capacidad) quedó en la base de datos y en la cache. Por eso las dos mitades de este capítulo van juntas, y por eso la primera mitad es la difícil.
El error de la cache en el proceso
La cache más rápida es un Map en la memoria del proceso: ni siquiera hay un
viaje de red. Con una sola instancia funciona. Con dos, cada una tiene su
copia, y la invalidación de una no le llega a la otra. El ejemplo está en
errors/local-cache.ts: dos instancias detrás de un load balancer que reparte
por turnos.
$ make local-cache
GET /products/2 → instancia A responde 490
GET /products/2 → instancia B responde 490
PUT /products/2/price 550 → lo atiende la instancia A
GET /products/2 → instancia B responde 490
GET /products/2 → instancia A responde 550
GET /products/2 → instancia B responde 490
GET /products/2 → instancia A responde 550
La instancia A atendió el cambio de precio y borró su entrada. La B no se enteró. Quien recarga la página ve 490, 550, 490, 550: el precio depende de a qué instancia le tocó.
Error común. Cache en el proceso con varias instancias. Es peor que un dato viejo: es un dato que cambia hacia atrás. Un usuario que vio 550 y después ve 490 no piensa que el sistema está atrasado, sino que está roto. Es la anomalía de las lecturas que retroceden de la semana 10, con caches en lugar de réplicas.
Una cache local no está prohibida. Sirve para lo que no cambia mientras el proceso vive (la configuración, una tabla de países) o para lo que tolera un TTL muy corto sin invalidación. La página de Azure dice lo mismo: una cache privada de cada instancia puede quedar inconsistente con las demás, y entonces conviene vencerla más seguido o usar una compartida.
Trade-off. Cache local: la más rápida y sin dependencias, a cambio de una copia por instancia, sin invalidación entre ellas. Cache compartida: una sola copia que todas invalidan, a cambio de un salto de red y un servicio que puede caerse.
Load balancer y health checks
El load balancer es lo que hace que varias copias parezcan un solo servicio: recibe los pedidos y los reparte. Dos formas comunes de repartir:
- Por turnos (round robin): uno a cada instancia, en orden. Simple, y supone que todos los pedidos cuestan parecido y todas las instancias rinden igual.
- A la menos ocupada (least connections): a la que tiene menos pedidos en curso. Se adapta sola cuando una instancia está lenta, porque los pedidos se le acumulan y deja de recibir.
Su segunda tarea es dejar de enviarle pedidos a una instancia que no puede atenderlos. Para saberlo, le pregunta cada pocos segundos: es el health check. Y aquí hay una decisión con más consecuencias de las que parece: qué responde esa pregunta.
- Que el proceso vive. Es el
GET /healthde Qhatu, que responde{"status":"ok"}sin consultar nada. Detecta un proceso colgado o caído. No detecta un proceso que vive y no puede trabajar. - Que además puede hacer su trabajo. Es el
GET /ready, que hace unSELECT 1en PostgreSQL. Detecta una instancia que perdió la conexión con la base de datos.
El segundo parece mejor siempre, y tiene una trampa. El /ready de Qhatu
informa el estado de Redis ("cache":"ok" o "down"), pero Redis no
decide la respuesta: solo PostgreSQL puede hacerla fallar.
Si el health check fallara cuando Redis no responde, una caída de Redis haría que todas las instancias se declararan enfermas al mismo tiempo, y el load balancer se quedaría sin a quién enviarle nada. Acabamos de medir que Qhatu atiende sin Redis; un health check demasiado exigente habría convertido esa degradación en una caída total. La regla: un health check comprueba lo que esa instancia necesita para trabajar y que otra instancia podría tener bien. Una dependencia compartida que está caída para todas no es motivo para sacar a ninguna. La semana 14 vuelve sobre esto.
El código de la semana
Todo está en code/week-11/ y se usa dentro del contenedor del curso.
| Carpeta o archivo | Qué contiene |
|---|---|
db/, src/catalog.ts |
El esquema, los datos de Qhatu y el origen: lecturas y escrituras contra PostgreSQL, sin cache |
src/cache.ts |
Cache-aside, invalidación, cache negativa, jitter y la política ante un Redis caído |
src/single-flight.ts |
Cache-aside en el que solo uno recalcula y los demás reciben el valor anterior |
src/service.ts |
Las decisiones: claves, TTL y qué invalida cada escritura |
src/server.ts, src/main.ts |
El servidor HTTP, con /health, /ready y /stats |
race.ts |
La carrera entre una lectura y una escritura, con los pasos en el orden que se le pida |
load/, tools/ |
La carga de k6, pg-queries.ts (cuenta consultas en PostgreSQL) y los programas de cada make |
shards/ |
hash.ts, assign.ts (Tinkuy en ocho shards), rebalance.ts y scatter.ts |
errors/local-cache.ts |
El error de la cache en el proceso con dos instancias |
lab/, cache-decisions-template.md |
El módulo del laboratorio, por completar, y la tabla de decisiones |
test/ |
Las pruebas, que comprueban lo que afirma este capítulo |
Los comandos están listados al principio del Makefile. make crea la base
de datos arq_w11, con Qhatu y una copia de los datos de ejemplo de Tinkuy, y
borra las claves w11:*; cada ejemplo del capítulo tiene su comando
(make compare, make race, make stampede, make jitter, make negative,
make eviction, make redis-down, make local-cache, make shards,
make rebalance, make scatter); make pg-on, make pg-report y
make pg-off son el contador de consultas, para usarlo con otra aplicación; y
make clean borra las bases de datos, las claves y build/.
make start acepta variables delante: CACHE_MODE (off, aside o
single-flight), LIST_TTL_MS, DETAIL_TTL_MS, NEGATIVE_TTL_MS, JITTER,
INVALIDATE=off, CACHE_FAILURE=closed y STATS_LOG=1. make compare,
make stampede y make redis-down levantan y detienen su propio Qhatu: no
hay que tener otro corriendo en el puerto 3000. make test no necesita nada
corriendo: crea su propia base de datos y usa su propio prefijo en Redis.
$ make test
tsc -p .
W11_DB=arq_w11_test W11_PREFIX=w11:test: node --test --test-concurrency=1 "test/*.test.ts"
…
✔ borrando al escribir, la cache queda vieja solo si el lector leyó antes del cambio y guardó después del borrado (33.816625ms)
…
✔ cache-aside: los 30 lectores que no encuentran la entrada van todos al origen (12.834709ms)
✔ single-flight con valor anterior: uno recalcula y 29 reciben el anterior sin esperar (13.460792ms)
✔ single-flight con la cache vacía: uno recalcula y los demás esperan su resultado (16.292667ms)
✔ si quien tenía el lock se cae, el lock vence y otro recalcula (206.117ms)
…
ℹ tests 45
ℹ suites 0
ℹ pass 45
ℹ fail 0
Las pruebas de la carrera y de la estampida no dependen del reloj. La carrera se arma ejecutando los pasos uno por uno. La estampida usa un origen que se queda detenido hasta que la prueba lo suelta: así se puede afirmar que los treinta lectores llegaron mientras el origen no había respondido. Las pruebas llamadas “paso 3”, “paso 7” y “paso 8” son las del módulo del laboratorio; se saltan cuando su versión completa no está en la carpeta.
Laboratorio: cache-aside con Redis en Tinkuy y una estampida
El laboratorio se hace en parejas, sobre su copia de Tinkuy, con el material
de code/week-11/. Necesitan tres terminales en el mismo
contenedor: una con Tinkuy (make start), otra para la carga y otra para
mirar Redis y PostgreSQL. make load-browse no vende nada, así que no hace
falta la pasarela de pagos hasta el paso 4. Antes de empezar, corran make en
code/week-11/.
Paso 1: la línea de base. En su Tinkuy, make db, make start y
make load-browse. Anoten la mediana y el p95 de duration_events_list y de
duration_event_detail, y el throughput. Repitan una vez sin cambiar nada,
para saber cuánto varía sola la medición: una mejora más chica que esa
variación no es una mejora.
Paso 2: decidir antes de programar. Copien
code/week-11/cache-decisions-template.md a los documentos de su proyecto y
llenen una fila por cada endpoint de lectura de Tinkuy: si va a la cache, con
qué clave (prefijo w11:), con qué TTL y qué la invalida. La fila de
GET /events/:id/seats es la que más discusión merece. Van a volver a la
tabla al final, para corregirla con lo que midieron.
Paso 3: cache-aside para el detalle de un evento. Copien
code/week-11/lab/cache-aside.ts a su Tinkuy y completen cacheAside
(make test-lab, en code/week-11/, prueba la versión que esté en lab/).
Úsenla para el detalle de un evento y midan de nuevo. Miren qué quedó en
Redis con redis-cli --scan --pattern 'w11:*', redis-cli ttl y
redis-cli info stats | grep keyspace, y calculen la tasa de aciertos. Este
paso muestra cuánto mejora la mediana y cuánto la cola, que no es lo mismo.
Paso 4: datos viejos. Con la pasarela corriendo, pidan el detalle del evento 1, compren una entrada y vuelvan a pedirlo. ¿Cuántos asientos disponibles muestra, y durante cuánto tiempo? Agreguen la invalidación y repitan. Lo que hay que poder responder: ¿en cuántos lugares del código de Tinkuy cambia la disponibilidad de un evento?
Paso 5: la carrera. Este paso se hace con Qhatu, donde los pasos se pueden
ordenar a mano; el cambio de precio hace el papel de la venta. Corran
node race.ts L1 L2 L3 E1 E2 en code/week-11/ y busquen un orden de los
cinco pasos que deje la cache con el precio viejo a pesar de la
invalidación. Expliquen por qué ese orden lo produce, y respondan para su
Tinkuy: ¿puede pasar lo mismo entre una lectura del detalle y una compra? ¿Qué
lo acota, y en cuánto?
Paso 6: la estampida. Guarden también la lista de eventos, con un TTL de
dos segundos. En code/week-11/, make pg-on; corran make load-browse en
su Tinkuy; y después make pg-report DB=tinkuy MATCH='ORDER BY e.starts_at',
que cuenta las veces que se ejecutó la consulta de la lista y las agrupa en
ráfagas. Terminen con make pg-off. ¿Cuántas veces había que calcular la
lista en 30 segundos, y cuántas se calculó?
Paso 7: el remedio. Completen cacheAsideSingleFlight: que una sola
petición recalcule, con un lock de SET NX PX, mientras las demás reciben el
valor anterior. Repitan la medición del paso 6 y comparen el número de
consultas y el p99 de la lista. Anoten en su tabla lo que este remedio le
cuesta a la frescura.
Paso 8: la cache caída. Con la carga corriendo, ejecuten svc kill redis.
¿Qué pasa con la latencia y con los errores? Si hay errores, corrijan el
módulo para que degrade y repitan. Comparen la latencia sin Redis con la línea
de base del paso 1: ¿PostgreSQL aguanta la carga completa? Escriban qué
significa eso para la capacidad de su sistema. Al terminar, svc start redis.
Paso 9: sharding en papel. Con make shards y make scatter: para la
tabla seats con event_id como clave sobre ocho shards, ¿cómo se reparten
los eventos por hash y por rango? ¿Qué pasa con el evento 1? ¿Qué consultas de
Tinkuy tocarían más de un shard? Elijan una y propongan cómo evitarlo, con lo
que cuesta.
Los pasos 3, 4, 7 y 8 son, sobre su propio Tinkuy, parte de lo que pide P3. Lo que el laboratorio no les da son las decisiones: qué respuestas van a la cache y cuáles no, con qué TTL, y la medición que lo justifica.
Resumen
- Replicar copia los mismos datos; hacer sharding reparte datos distintos, y es lo único que aumenta la capacidad de escritura y de almacenamiento. Es la táctica más cara y casi no tiene vuelta atrás: antes se agotan los índices, una máquina más grande, archivar, réplicas y cache.
- La clave de sharding decide qué consultas van a un shard y cuáles a
todos. Se elige por el patrón de acceso dominante y por qué filas se
escriben juntas. En Tinkuy,
event_id: una compra toca un solo shard. - Por rango se conserva el orden, y una clave que crece con el tiempo manda todo al último shard. Por hash se reparte parejo si hay muchas claves, y se pierde el orden.
- Un hot spot causado por una sola clave no se arregla con ninguna función de hash: el evento 1 queda entero en un shard con cualquier regla.
- mueve de las claves al agregar un nodo: el 88,8 % de 8 a 9. Con shards lógicos o consistent hashing se mueve cerca del mínimo, , y solo hacia el nodo nuevo.
- Con sharding se pierden los
JOINy las transacciones entre shards, la unicidad global y los contadores de ids. Un índice secundario es local (lecturas scatter-gather) o global (escrituras en dos lugares). - Una cache es un dato derivado: se puede perder y puede estar equivocada. Cache-aside: buscar; si no está, leer del origen y guardar con TTL; al escribir, primero el origen y después borrar la entrada. En Qhatu, las consultas a PostgreSQL bajaron de 6 708 a 275 con la misma carga.
- Se borra y no se actualiza porque dos escrituras concurrentes pueden actualizar la cache en el orden contrario al de la base de datos. Aun borrando queda una carrera, que el TTL acota y un lease elimina.
- Estampida: una entrada muy pedida vence y todos recalculan a la vez. Con
single-flight (un lock
SET NX PXy el valor anterior para los demás), 95 consultas se volvieron 5. El jitter evita que muchas venzan juntas. - Una cache es de latencia si el origen aguanta sin ella y de capacidad si no; se sabe midiendo con la cache apagada y con Redis caído. Una cache caída debe verse como una cache vacía, no como un error.
- Sin política de desalojo, Redis rechaza escrituras cuando se llena. La cache negativa guarda también “no existe”.
- Escalar hacia los lados exige servicios sin estado. Una cache en la memoria del proceso, con varias instancias, muestra valores distintos según a cuál se llegue. Un health check no debe fallar por una dependencia compartida sin la cual el servicio puede seguir.
Ejercicios
-
Clasifiquen cada problema según si lo resuelve la replicación, el sharding, los dos o ninguno, con una frase: (a) el disco se llena en tres meses; (b) el reporte de ventas vuelve lento el catálogo; (c) el servidor se quema y hay que seguir vendiendo; (d) hay más compras por segundo de las que un servidor puede confirmar; (e) alguien ejecutó un
DELETEsinWHERE. -
Una tabla de auditoría recibe una fila por cada acción de cada usuario y usa la fecha como clave de sharding por rango, con un shard por mes. ¿Dónde caen las escrituras de hoy? Propongan otra clave, digan qué consulta se vuelve cara con ella y para qué uso de la tabla su clave sería la equivocada.
-
Con la derivación de Por qué no hash(k) mod n, calculen qué fracción de las claves se mueve al pasar de 4 a 5 nodos y de 20 a 21. Comprueben los dos números cambiando los argumentos de
schemesenshards/rebalance.ts. ¿El esquema empeora o mejora cuando el clúster crece? Después calculen, para el paso de 20 a 21, cuánto se movería con shards lógicos. -
Tinkuy quiere agregar la búsqueda “todas las órdenes de un correo”, con
event_idcomo clave de sharding. Describan cómo se respondería con un índice local y con uno global. Para cada uno, digan qué operación se encarece y qué puede ver un comprador que busca sus órdenes un segundo después de comprar. -
Corran
make racey después los otros nueve órdenes posibles deL1 L2 L3 E1 E2(cada actor en su orden). Hagan una tabla con el orden, el valor final en la cache y si quedó vieja. Luego supongan que el escritor borrara la entrada antes de escribir en PostgreSQL. Sin correr nada, encuentren un orden que deje la cache vieja con ese diseño. ¿Necesita una coincidencia más o menos improbable que la demake race? ¿Qué dice eso sobre el orden “primero el origen, después la cache”? -
Corran
make stampedetres veces y anoten, para el modoaside, el total de consultas y la ráfaga más grande de cada corrida. ¿Qué número se repite y cuál varía? Usen la fórmula para explicar la variación. Después levanten Qhatu conCACHE_MODE=aside LIST_TTL_MS=2000 make start, y antes de correr la carga conVUS=200 ONLY_LIST=1 THINK=0.05 make loadpredigan cuántas consultas tendrá cada ráfaga. Cuéntenlas conmake pg-onymake pg-report MATCH='LEFT JOIN stock_movements'. -
cacheAsideSingleFlightsirve el valor anterior mientras otro recalcula. Den un dato de Tinkuy para el que eso sea aceptable y uno para el que no. Para el segundo, describan cómo cambiarían el módulo para que los demás esperen en vez de recibir el valor anterior, y qué le pasa a la latencia de esas peticiones si el origen tarda dos segundos. -
Un equipo reporta: “con Redis el p95 del catálogo es 20 ms; en la prueba en que reiniciamos Redis, el sistema dejó de responder durante cuatro minutos aunque Redis volvió en cinco segundos”. Expliquen con los conceptos del capítulo qué pasó en esos cuatro minutos, por qué el sistema no se recuperó cuando Redis volvió, y propongan dos cambios, uno en el código y uno en cómo se opera, con lo que cuesta cada uno.
-
Qhatu corre con tres instancias detrás de un load balancer, y su health check es
/ready. Para cada falla, digan qué responde el health check de cada instancia, qué hace el load balancer y qué ve el usuario: (a) una instancia pierde su conexión con PostgreSQL; (b) PostgreSQL se cae; (c) Redis se cae; (d) una instancia entra en un ciclo infinito dentro de un pedido. ¿En cuál de los cuatro casos el health check empeora las cosas o no ayuda, y qué cambiarían?