Apuntes · Capítulo 12Datos y sistemas distribuidos
Transacciones: dentro de una base de datos y entre servicios
Transacciones: dentro de una base de datos y entre servicios
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): Qué garantiza una transacción; de Cómo se vende dos veces un asiento, El problema en Tinkuy y La doble reserva, paso a paso; y de Cuando la transacción no alcanza, Dos sistemas, ninguna transacción y Un timeout no dice qué pasó.
- En clase: Sesión A: Qué garantiza una transacción, Cómo se vende dos veces un asiento, Niveles de aislamiento, Las anomalías que los niveles débiles permiten, Tres maneras de no reservar dos veces, Optimista y pesimista y La transacción como recurso. Sesión B: Cuando la transacción no alcanza, Two-phase commit, Sagas, Idempotencia y La escritura doble y la outbox. Laboratorio: Laboratorio: no vender el mismo asiento dos veces, de tres maneras.
- Después de clase: el Resumen y los Ejercicios. Antes de la semana 13 vale la pena releer La clave de idempotencia y La escritura doble y la outbox. Opcionales: Serializable aborta de más, Lo que hay que decidir al usar claves y El código de la semana.
Las tres semanas anteriores trataron de datos que viven en más de un lugar: réplicas, shards, una cache. En todas apareció la misma renuncia: al partir los datos se pierde la posibilidad de cambiarlos todos a la vez, y la semana pasada quedó anotado que el sharding se lleva las transacciones entre shards. Esta semana estudiamos qué es exactamente lo que se pierde. Primero, lo que una transacción da cuando todos los datos están en una sola base de datos, que es menos de lo que se suele creer. Después, qué se hace cuando la operación cruza a otro servicio y ya no hay transacción que la cubra.
El hilo de la primera sesión es un defecto que conocen desde la primera semana: Tinkuy vende el mismo asiento más de una vez. En P2 lo corrigieron con lo que daba el enunciado. Ahora vamos a entender por qué ocurre, por qué “usar transacciones” no lo evita, y a comparar tres maneras de impedirlo, con lo que cuesta cada una. El hilo de la segunda sesión es la compra completa: reservar el asiento y cobrarlo son dos cosas que hacen dos sistemas, y entre los dos solo hay una red que pierde mensajes. Ahí aparecen las sagas, la idempotencia y la outbox, que son las piezas de P4.
Una advertencia sobre el ejemplo. Para no resolver en los apuntes lo que ustedes resuelven en el proyecto, esta semana el código no es el de Tinkuy: es un hospedaje pequeño que reserva noches de habitación y vende cupos de un tour. El problema es el mismo (un recurso que solo se puede vender una vez), y todo lo que se muestra se traslada a los asientos sin cambiar de idea.
Lectura. Sesión A: Kleppmann y Riccomini, Designing Data-Intensive Applications (2.ª ed.), cap. 8 Transactions; documentación de PostgreSQL 18, Transaction Isolation y Explicit Locking. Complementarias: documentación de PostgreSQL 18, Concurrency Control, la introducción; Jepsen: Consistency Models, la guía de referencia de los modelos de consistencia, con su mapa.
Sesión B: Ford, Richards, Sadalage y Dehghani, Software Architecture: The Hard Parts, cap. 9 Data Ownership and Distributed Transactions y cap. 12 Transactional Sagas; Chris Richardson, Saga y Transactional outbox; Brandur Leach, Designing robust and predictable APIs with idempotency (Stripe, 2017). Complementarias: Designing Data-Intensive Applications (2.ª ed.), cap. 9 The Trouble with Distributed Systems; Hector Garcia-Molina y Kenneth Salem, Sagas (1987), secciones 1 y 2; Unmesh Joshi, Two-Phase Commit e Idempotent Receiver.
El código de este capítulo está en code/week-12/. Todas las salidas que se muestran son de ejecuciones reales en el contenedor del curso (PostgreSQL 18), en una laptop con Apple Silicon, dentro de Docker. Los tiempos cambian de una máquina a otra y de una corrida a otra; lo que se traslada es la comparación entre dos diseños medidos en la misma máquina.
Qué garantiza una transacción
Todo o nada
Reservar una noche en el hospedaje son dos escrituras: marcar la noche como reservada y registrar la reserva a nombre del huésped. Si el programa hace la primera y muere antes de la segunda, queda una noche que nadie puede reservar y que nadie reservó. Sin ayuda de la base de datos, el programa tendría que prever esa caída en cada par de escrituras, y también la caída del código que repara la caída.
Una transacción agrupa varias lecturas y escrituras en una unidad: o se
aplican todas (COMMIT) o no se aplica ninguna (ROLLBACK, o una falla en
cualquier punto). Lo que el programa gana es un manejo de errores muy simple:
ante cualquier problema, se aborta, y es como si nada hubiera pasado. Después
se puede reintentar desde el principio, sin averiguar hasta dónde se llegó.
Esa simplicidad es la razón de fondo para usar transacciones, y conviene recordarla en la segunda sesión: cuando la operación cruza a otro servicio, lo que se pierde es justamente poder decir “se aborta y no pasó nada”.
ACID, letra por letra
Las garantías de una transacción se resumen con la sigla ACID. Las cuatro letras no pesan lo mismo ni las cumple el mismo responsable.
| Letra | Garantía | Quién la da |
|---|---|---|
| A, atomicidad | Todo o nada: si la transacción no llega al COMMIT, por un error o por una caída, ninguna de sus escrituras queda |
La base de datos |
| C, consistencia | Los invariantes de la aplicación se cumplen antes y después (una noche tiene a lo más una reserva) | La aplicación, con ayuda de las restricciones que declare en la base de datos |
| I, aislamiento | Las transacciones que corren a la vez no se estorban: cada una puede razonar como si estuviera sola | La base de datos, en la medida del nivel de aislamiento que se elija |
| D, durabilidad | Lo confirmado no se pierde, aunque la máquina se apague un instante después del COMMIT |
La base de datos (el WAL de la semana 10) y, si hay réplicas, la forma en que se replica |
Dos precisiones. La atomicidad no habla de concurrencia: habla de fallas. Que dos transacciones no se mezclen es asunto del aislamiento. Y la consistencia no es una propiedad que la base de datos pueda garantizar sola: la base de datos no sabe que una noche con dos reservas está mal, salvo que alguien se lo diga con una restricción. Una transacción puede ser perfectamente atómica, aislada y durable, y dejar los datos mal porque el código escribió algo incorrecto.
De las cuatro, el aislamiento es la que tiene trade-offs que el arquitecto decide, y es donde está el resto de la sesión.
Idea clave. Una transacción convierte “varias escrituras que pueden quedar a medias” en “una operación que ocurre o no ocurre”. Lo que cuesta elegir no es si usarla, sino cuánto aislamiento pedirle.
Cómo se vende dos veces un asiento
El problema en Tinkuy
El Tinkuy inicial trae un programa que manda 50 órdenes a la vez para un
mismo asiento, de 50 compradores distintos. En el contenedor, sobre una copia
sin modificar (make tinkuy-oversell en la carpeta de la semana la prepara y
la corre):
$ make tinkuy-oversell
Semilla 7: 6 locales, 24 eventos, 75 secciones, 13080 asientos (3225 vendidos), 1303 órdenes, 1303 pagos, 3225 entradas, 1303 notificaciones
node tools/oversell.ts
Asiento 1 del evento 1 (fila A, número 1): 50 órdenes a la vez
  respuestas 201: 50
Órdenes aceptadas para el asiento 1: 50
Entradas emitidas para el asiento 1: 50
Cincuenta personas con una entrada para la fila A, número 1. Y la compra sí
usa una transacción. Esto es lo que hace createOrder, en
tinkuy/src/orders/create-order.ts, reducido a los pasos que importan:
await client.query('BEGIN');
try {
  const seats = await findSeatsForSale(client, input.seatIds);   // SELECT … FROM seats
  // …
  const taken = seats.filter((seat) => seat.status !== 'available');
  if (taken.length > 0) {
    throw conflict('SEAT_NOT_AVAILABLE', `Ya no está disponible: asiento ${ids}`);
  }
  // … inserta la orden …
  const result = await charge({ /* … */ });                      // llama a la pasarela
  // …
  await markSeatsSold(client, input.seatIds);                     // UPDATE seats SET status = 'sold'
  // … inserta una entrada por asiento …
  await client.query('COMMIT');
Hay un BEGIN y un COMMIT, y si algo falla hay un ROLLBACK. La atomicidad
está bien: ninguna orden queda a medias. Lo que falla es el aislamiento. Las
50 transacciones leyeron el asiento como disponible antes de que alguna lo
marcara vendido, y la pasarela, que tarda 80 ms, les dio tiempo de sobra.
El ejemplo de la semana: un hospedaje
Para estudiar el problema usamos un esquema más pequeño, el de
db/schema.sql. Un hospedaje con diez
habitaciones vende noches. Hay una fila por cada noche de cada habitación, y
reservar es pasar la fila de available a booked y anotar la reserva:
CREATE TABLE room_nights (
    id     integer PRIMARY KEY,
    room   integer NOT NULL,
    night  date    NOT NULL,
    status text    NOT NULL DEFAULT 'available' CHECK (status IN ('available', 'booked')),
    UNIQUE (room, night)
);

CREATE TABLE bookings (
    id            integer     PRIMARY KEY GENERATED ALWAYS AS IDENTITY,
    room_night_id integer     NOT NULL REFERENCES room_nights (id),
    guest         text        NOT NULL,
    created_at    timestamptz NOT NULL DEFAULT now()
);
El invariante: una noche de una habitación tiene a lo más una reserva. A
propósito, nada en este esquema lo respalda todavía. La versión con el
problema, booking/naive.ts, tiene la
misma forma que la compra de Tinkuy: dentro de una transacción, un SELECT
para ver que las noches están libres, el cobro, y después el UPDATE que las
marca y el INSERT de la reserva.
La doble reserva, paso a paso
Un defecto de concurrencia que aparece “a veces, con carga” no se puede
estudiar: hay que poder repetirlo a voluntad. Para eso sirven dos terminales.
Cada una abre una sesión de psql, y ustedes deciden en qué orden se ejecuta
cada sentencia. La carpeta guion/ tiene diez guiones escritos así; las
marcas -- [A] y -- [B] dicen en qué sesión va cada paso.
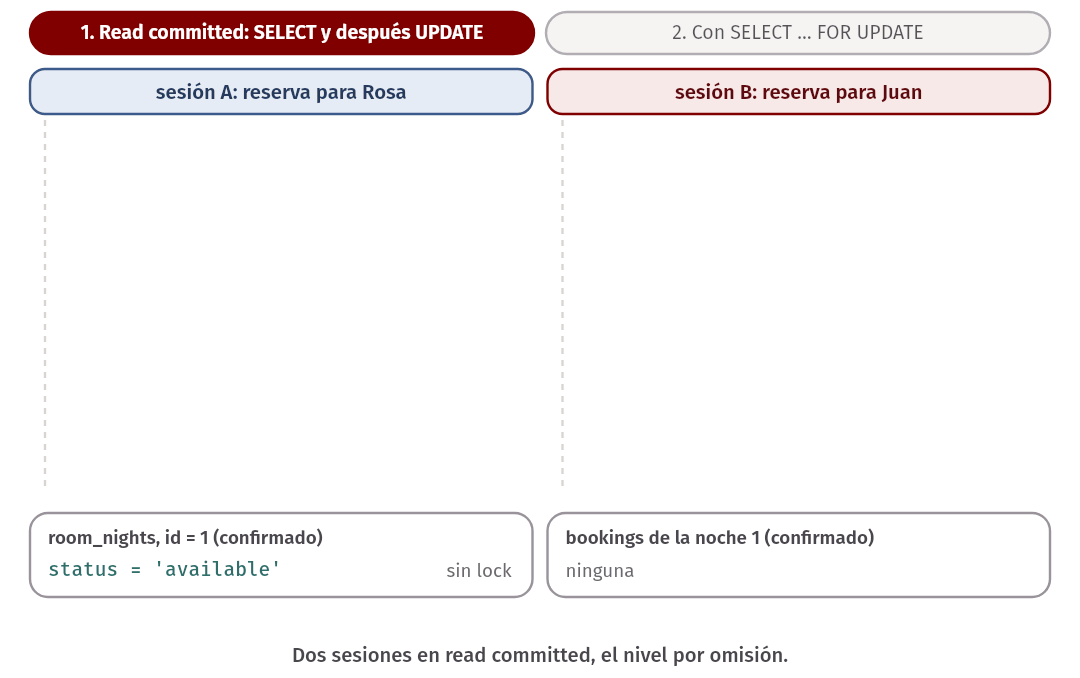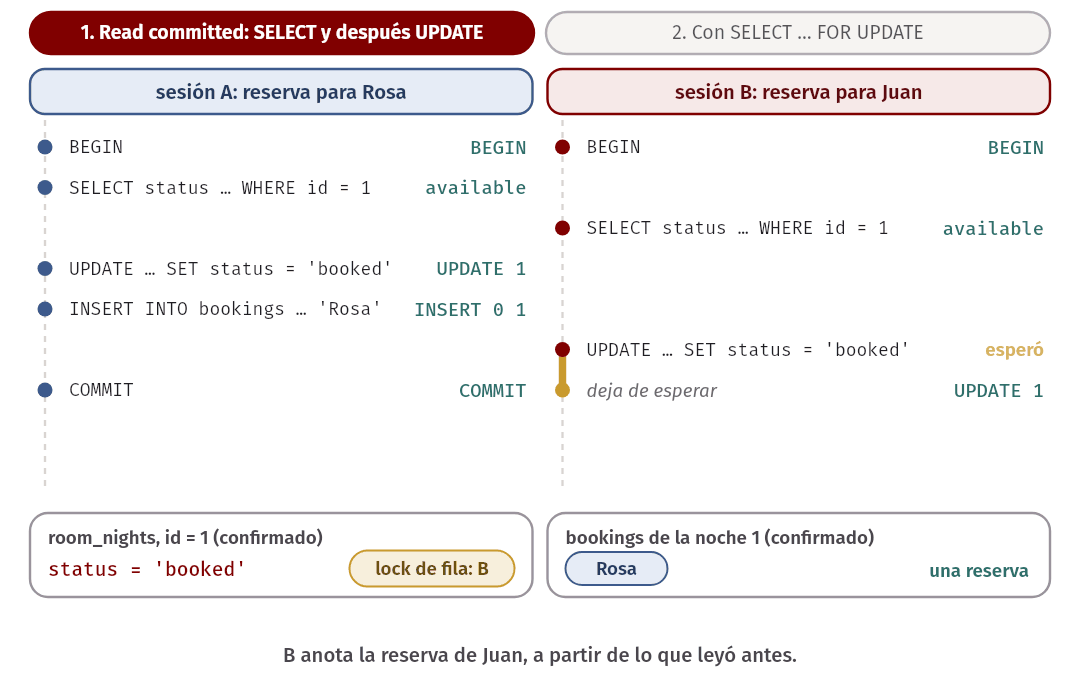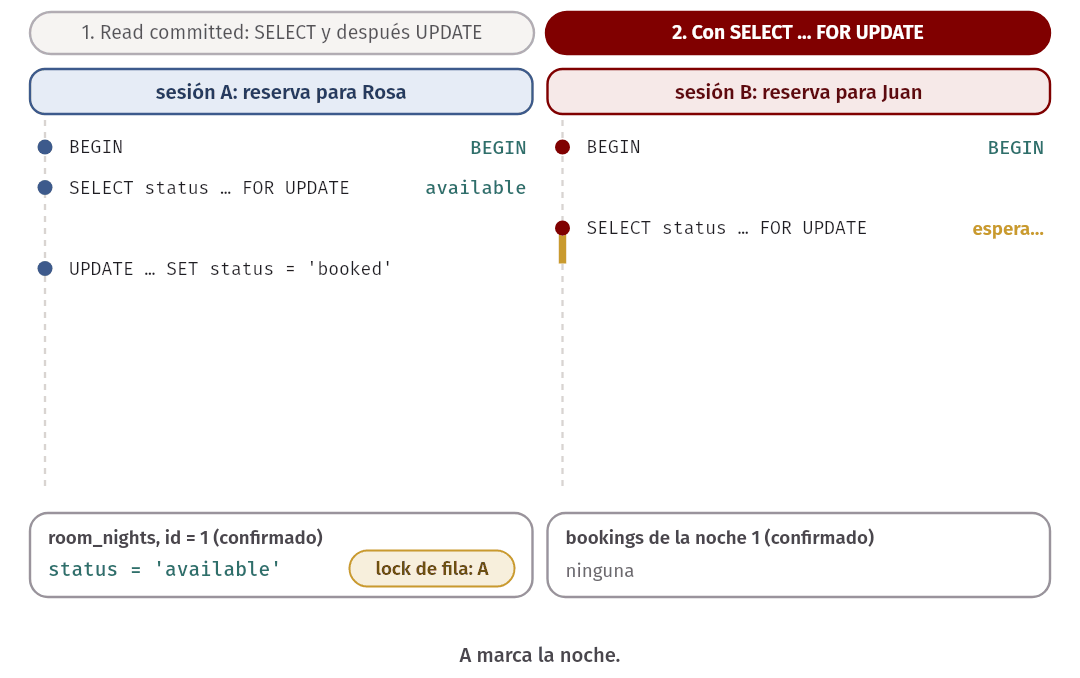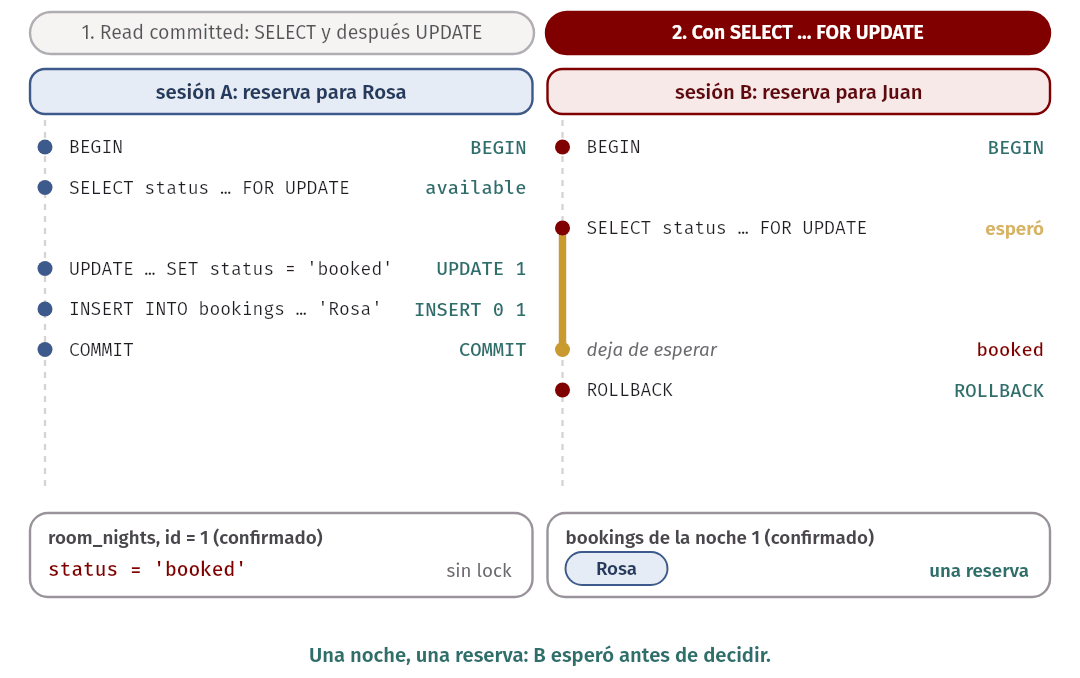
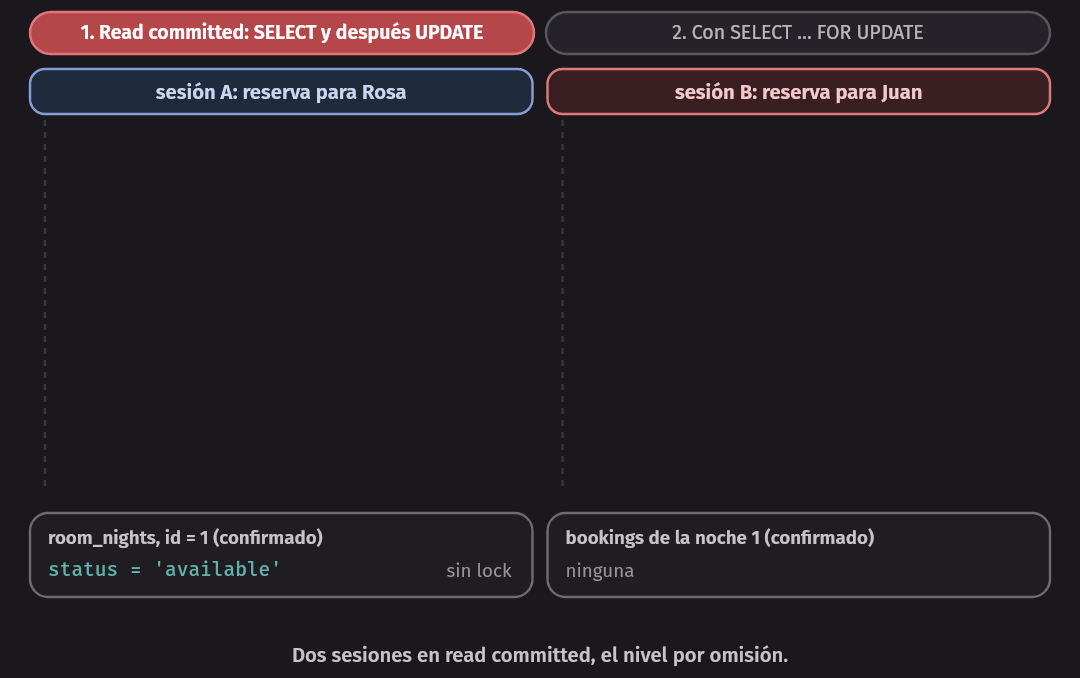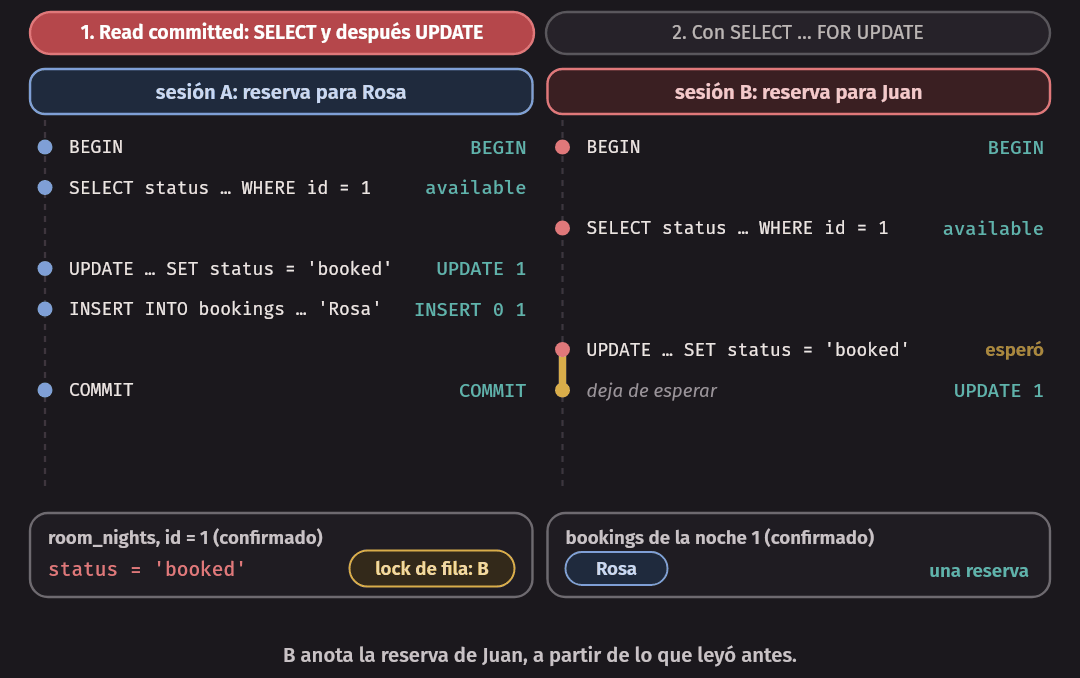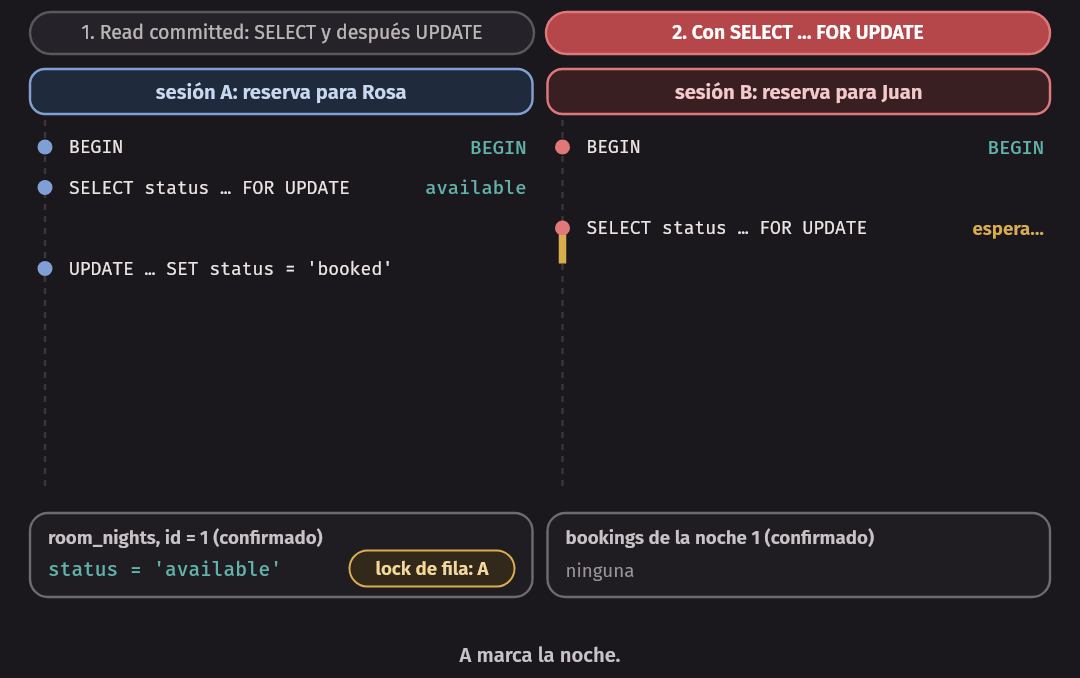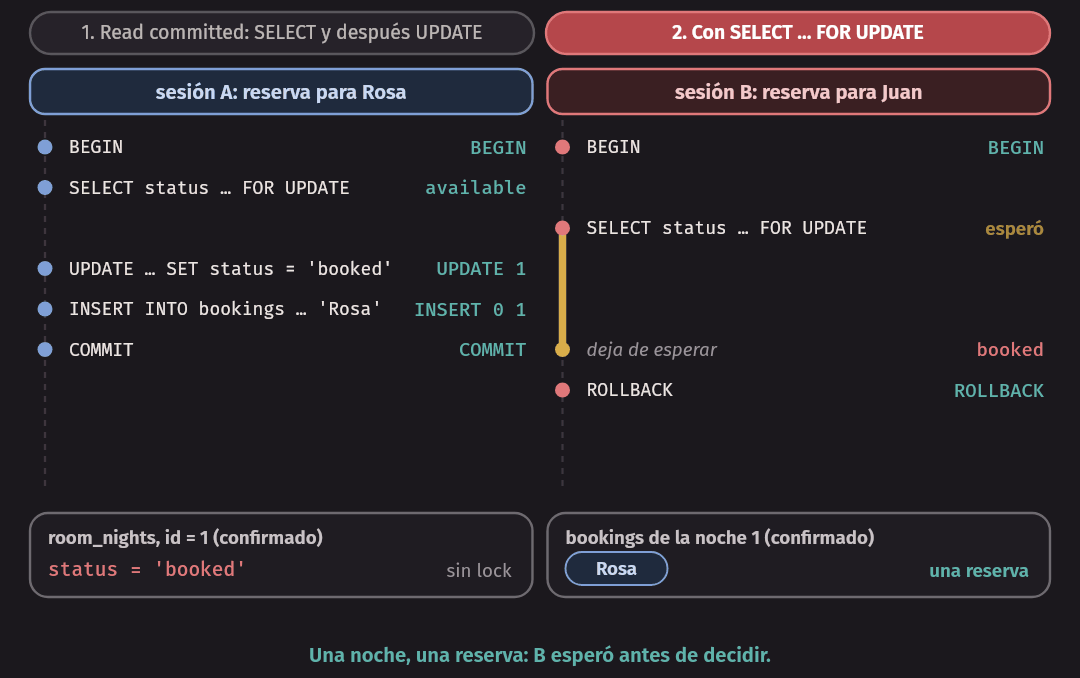
guion/01-double-booking.sql
es la doble reserva. make guion G=01 lo ejecuta con dos sesiones de psql
de verdad y muestra lo que respondería cada terminal:
$ make guion G=01
A=# BEGIN;
BEGIN
B=# BEGIN;
BEGIN
-- Las dos comprueban que la noche 1 (habitación 101, 1 de julio) está libre.
A=# SELECT id, room, night, status FROM room_nights WHERE id = 1;
 id | room |   night    |  status
----+------+------------+-----------
  1 |  101 | 2027-07-01 | available
(1 row)
B=# SELECT id, room, night, status FROM room_nights WHERE id = 1;
 id | room |   night    |  status
----+------+------------+-----------
  1 |  101 | 2027-07-01 | available
(1 row)
-- A la reserva y confirma.
A=# UPDATE room_nights SET status = 'booked' WHERE id = 1;
UPDATE 1
A=# INSERT INTO bookings (room_night_id, guest) VALUES (1, 'Rosa');
INSERT 0 1
-- B hace lo mismo, a partir de lo que leyó antes.
B=# UPDATE room_nights SET status = 'booked' WHERE id = 1;
    (la sesión B queda esperando: el lock lo tiene la sesión A)
A=# COMMIT;
COMMIT
    (la sesión B deja de esperar; su terminal muestra:)
UPDATE 1
B=# INSERT INTO bookings (room_night_id, guest) VALUES (1, 'Juan');
INSERT 0 1
B=# COMMIT;
COMMIT
-- El resultado: una noche, dos reservas.
A=# SELECT id, room_night_id, guest FROM bookings WHERE room_night_id = 1;
 id | room_night_id | guest
----+---------------+-------
  1 |             1 | Rosa
  2 |             1 | Juan
(2 rows)
Hay que leer esta salida con cuidado, porque tiene dos lecciones.
La primera: el orden que produce la doble reserva es que las dos lean antes
de que alguna escriba. Si A termina completa antes de que B empiece, B lee
booked y no sigue. El defecto necesita que las dos lecturas caigan dentro de
la ventana entre la lectura y la escritura de la otra. En Tinkuy esa ventana
dura lo que tarda la pasarela.
La segunda: la base de datos sí hizo algo. El UPDATE de B quedó
esperando hasta que A confirmó. PostgreSQL no deja que dos transacciones
modifiquen la misma fila a la vez: la segunda espera a que la primera
termine. Pero esa espera no salvó nada. Cuando A confirmó, el UPDATE de B
continuó: la fila con id = 1 seguía existiendo, la condición WHERE id = 1
seguía cumpliéndose, y B la marcó booked otra vez. Lo que B decidió con su
lectura (que la noche estaba libre) ya no era cierto, y nada se lo dijo.
Comprobar y después actuar
El patrón tiene nombre: comprobar y después actuar. El programa lee un dato, decide a partir de él, y actúa. Entre la lectura y la acción el dato puede cambiar, y la decisión queda apoyada en algo que ya no es verdad. Lo van a reconocer con muchas caras:
SELECTpara ver que el asiento está libre, y despuésUPDATE.SELECTpara ver que el correo no está registrado, y despuésINSERT.SELECT saldo, unif (saldo >= monto)en la aplicación, y despuésUPDATEcon el saldo nuevo.
En las tres hay un if en el código de la aplicación entre una lectura y una
escritura. Ese if es la señal.
Error común. Creer que “usar transacciones” basta. La compra de Tinkuy las usa, y vende 50 veces el mismo asiento. La pregunta útil tiene dos partes: en qué nivel de aislamiento corre la transacción, y qué anomalía de ese nivel le hace daño a este invariante.
Niveles de aislamiento
Serializable: el ideal y su precio
El aislamiento ideal se llama serializable: el resultado de ejecutar varias transacciones a la vez es el mismo que se habría obtenido ejecutándolas una tras otra, en algún orden. No dice en cuál orden; dice que existe uno. Con esa garantía, quien escribe una transacción puede razonar como si fuera la única en el sistema, y todo defecto de concurrencia desaparece por definición: si cada transacción es correcta sola, cualquier mezcla lo es.
La forma más simple de conseguirlo es ejecutar de verdad una transacción a la vez, y es justamente lo que no se quiere: mientras una transacción espera a la pasarela, todas las demás estarían detenidas. Las bases de datos lo consiguen con técnicas más finas, que siempre pagan algo: o hacen esperar a unas transacciones por otras, o abortan algunas y hay que repetirlas. Por eso ofrecen niveles de aislamiento más débiles, que permiten ciertas mezclas incorrectas a cambio de esperar y abortar menos. Y por eso el nivel por omisión casi nunca es serializable: en PostgreSQL es read committed.
Trade-off. Más aislamiento es menos anomalías que el código tiene que prever, y más esperas o más transacciones abortadas. Menos aislamiento es más rendimiento, y una lista de anomalías que cada transacción tiene que revisar contra sus invariantes. Ninguno de los dos extremos es “el correcto”: se elige por transacción, mirando qué invariante protege.
Read committed
Read committed es el nivel por omisión de PostgreSQL. Da dos garantías:
- No se leen datos sin confirmar. Una consulta ve solo lo que estaba
confirmado cuando empezó. Si otra transacción modificó una fila y todavía
no hizo
COMMIT, se ve el valor anterior, sin esperar. - No se sobrescriben datos sin confirmar. Si dos transacciones quieren modificar la misma fila, la segunda espera a que la primera termine. Es la espera que vimos en el guion.
Lo que no garantiza: que dos lecturas de la misma transacción vean lo mismo.
Cada sentencia ve lo confirmado hasta el momento en que ella empieza, así
que entre una sentencia y la siguiente el mundo puede haber cambiado. La
prueba, en test/isolation.test.ts:
await a.run('BEGIN'); // read committed es el nivel por omisión
assert.deepEqual(await a.run(placesLeft), [{ places_left: 10 }]);
await b.run('UPDATE tours SET places_left = 9 WHERE id = 1'); // B confirma sola (autocommit)
assert.deepEqual(await a.run(placesLeft), [{ places_left: 9 }]);
await a.run('COMMIT');
A leyó 10 y, sin haber hecho nada, después leyó 9. Para una transacción que lee una vez y escribe, puede no importar. Para un reporte que suma en una consulta y cuenta en otra, los dos números no cuadran.
Hay un detalle de read committed en PostgreSQL que va a ser la base de una de
las soluciones. Cuando un UPDATE tuvo que esperar a otra transacción y esta
confirma, PostgreSQL vuelve a evaluar el WHERE sobre la versión nueva de
la fila antes de modificarla. Si la fila ya no cumple la condición, el
UPDATE no la toca. En el guion 1 no sirvió de nada porque la condición era
solo id = 1. Lo usaremos más adelante.
Snapshot isolation: el repeatable read de PostgreSQL
El siguiente nivel resuelve las lecturas que no cuadran. Con snapshot
isolation, cada transacción ve una foto (un snapshot) de la base de datos:
todo lo que estaba confirmado en un instante, y nada de lo que se confirme
después. Lea lo que lea y cuantas veces lo lea, ve la misma foto. PostgreSQL
ofrece este nivel con el nombre REPEATABLE READ; su documentación dice
expresamente que lo implementa con la técnica que la literatura llama snapshot
isolation.
await a.run('BEGIN ISOLATION LEVEL REPEATABLE READ');
assert.deepEqual(await a.run(placesLeft), [{ places_left: 10 }]);
await b.run('UPDATE tours SET places_left = 9 WHERE id = 1');
await b.run(`INSERT INTO tours (id, name, places_left) VALUES (2, 'Maras y Moray', 8)`);
// Ni el cambio ni la fila nueva: en PostgreSQL este nivel tampoco muestra fantasmas.
assert.deepEqual(await a.run(placesLeft), [{ places_left: 10 }]);
assert.deepEqual(await a.run('SELECT count(*)::int AS tours FROM tours'), [{ tours: 1 }]);
await a.run('COMMIT');
assert.deepEqual(await a.run(placesLeft), [{ places_left: 9 }]);
Un detalle que sorprende: la foto no se toma en el BEGIN, sino en la primera
consulta de la transacción. Otra prueba del mismo archivo lo comprueba: B
confirma un cambio después del BEGIN de A y antes de su primera lectura, y
A lo ve.
Lo que hace posible la foto es el control de concurrencia multiversión
(MVCC). PostgreSQL no modifica una fila en su sitio: un UPDATE escribe una
versión nueva y deja la anterior, marcada con qué transacción la creó y cuál
la reemplazó. Cada transacción ve, de cada fila, la versión que corresponde a
su foto. La consecuencia práctica es la frase que la documentación usa para
resumir el modelo: leer nunca bloquea a quien escribe, y escribir nunca
bloquea a quien lee. Un reporte largo no detiene las ventas, y las ventas no
detienen el reporte. Por eso el SELECT del guion 1 nunca esperó, aunque la
otra sesión tuviera la fila modificada.
En read committed el mecanismo es el mismo; lo que cambia es que la foto se renueva en cada sentencia.
En la industria. La documentación de PostgreSQL 18 resume los niveles en una tabla (Transaction Isolation, tabla 13.1). El estándar SQL define cuatro niveles; PostgreSQL implementa tres, porque su read uncommitted se comporta como read committed. Y su repeatable read es más fuerte de lo que el estándar exige: no permite lecturas fantasma. La única fila de la tabla sin anomalías posibles es serializable. Otros motores usan los mismos nombres para garantías distintas, así que el nombre del nivel no alcanza: hay que leer la documentación del motor que se usa. La guía de Jepsen ordena todos estos modelos y dice cuál implica a cuál.
| Nivel en PostgreSQL 18 | Lectura sucia | Lectura no repetible | Lectura fantasma | Anomalía de serialización |
|---|---|---|---|---|
| Read committed (por omisión) | No | Posible | Posible | Posible |
| Repeatable read (snapshot isolation) | No | No | No en PostgreSQL | Posible |
| Serializable | No | No | No | No |
La última columna, “anomalía de serialización”, es el cajón donde cae todo lo demás: resultados que ninguna ejecución una tras otra habría producido. Las tres que siguen están ahí.
Las anomalías que los niveles débiles permiten
Actualización perdida
Dos transacciones leen un valor, calculan uno nuevo a partir de él y lo
escriben. La segunda escritura pisa a la primera, y una de las dos
modificaciones desaparece. El tour del hospedaje tiene 10 cupos, y dos
sesiones venden uno cada una
(guion/07-lost-update.sql):
A=# SELECT places_left FROM tours WHERE id = 1;
 places_left
-------------
          10
(1 row)
B=# SELECT places_left FROM tours WHERE id = 1;
…
A=# UPDATE tours SET places_left = 9 WHERE id = 1;
UPDATE 1
B=# UPDATE tours SET places_left = 9 WHERE id = 1;
    (la sesión B queda esperando: el lock lo tiene la sesión A)
A=# COMMIT;
COMMIT
    (la sesión B deja de esperar; su terminal muestra:)
UPDATE 1
B=# COMMIT;
COMMIT
-- Se vendieron dos cupos y el contador bajó uno.
A=# SELECT places_left FROM tours WHERE id = 1;
 places_left
-------------
           9
(1 row)
Cada sesión calculó en la aplicación y escribió 9. Read committed
lo permite. Hay cuatro maneras de evitarlo, y las cuatro están probadas en
test/isolation.test.ts:
| Manera | Cómo queda | Qué cuesta |
|---|---|---|
| Que el cálculo lo haga la base de datos | UPDATE tours SET places_left = places_left - 1 WHERE id = 1 AND places_left > 0 |
Nada, cuando el cálculo cabe en una expresión SQL. Es la primera opción |
| Lock explícito | SELECT … FOR UPDATE al leer: la segunda sesión espera en su lectura y lee 9 |
Una espera, y un lock tomado durante toda la transacción |
| Columna de versión | UPDATE … SET …, version = version + 1 WHERE id = 1 AND version = $2; si cambia 0 filas, leer de nuevo y repetir |
Una columna más, y el código del reintento |
| Subir a repeatable read | La segunda transacción aborta con el error 40001, y se repite |
Reintentar transacciones completas |
La primera funciona por lo que dijimos de read committed: el UPDATE de B
espera, y al continuar vuelve a leer la fila, que ya vale 9, y le resta 1. La
última merece verse. En repeatable read, PostgreSQL detecta la
actualización perdida:
const outcome = await pending.result;
assert.deepEqual(outcome, {
  ok: false,
  code: '40001',
  message: 'could not serialize access due to concurrent update',
});
La transacción de B quiso modificar una fila que otra transacción cambió
después de que B tomara su foto. En vez de pisar el cambio, PostgreSQL aborta
a B con el código 40001 (serialization failure). B queda abortada y solo
acepta ROLLBACK; la aplicación tiene que repetirla entera, y en el nuevo
intento leerá 9.
Write skew: los médicos de guardia
La actualización perdida tiene una forma reconocible: dos transacciones escriben la misma fila. La anomalía siguiente es más difícil de ver porque escriben filas distintas.
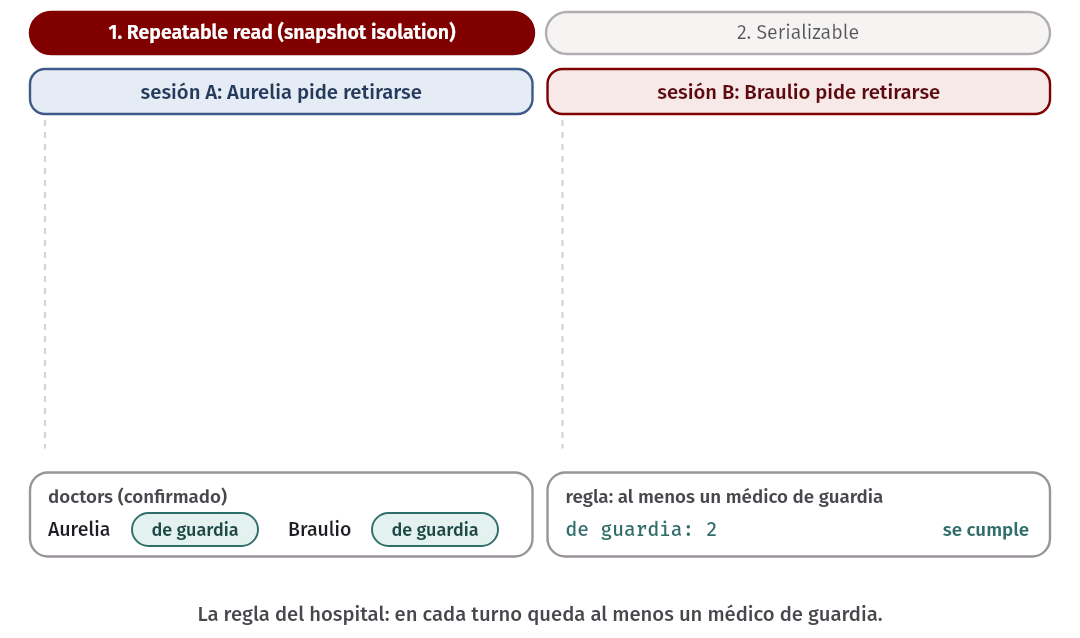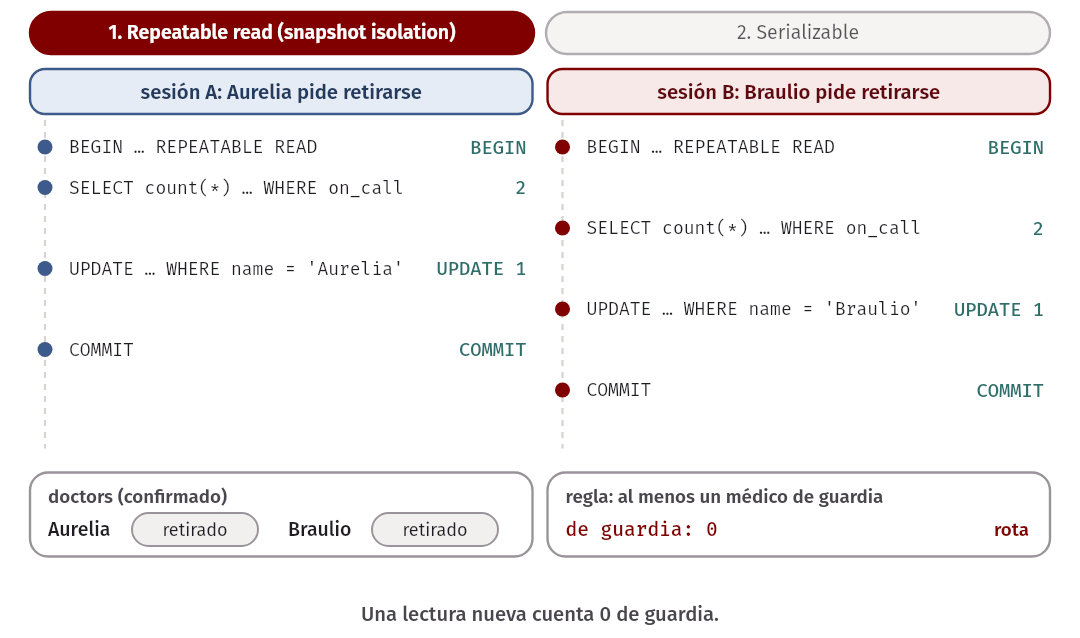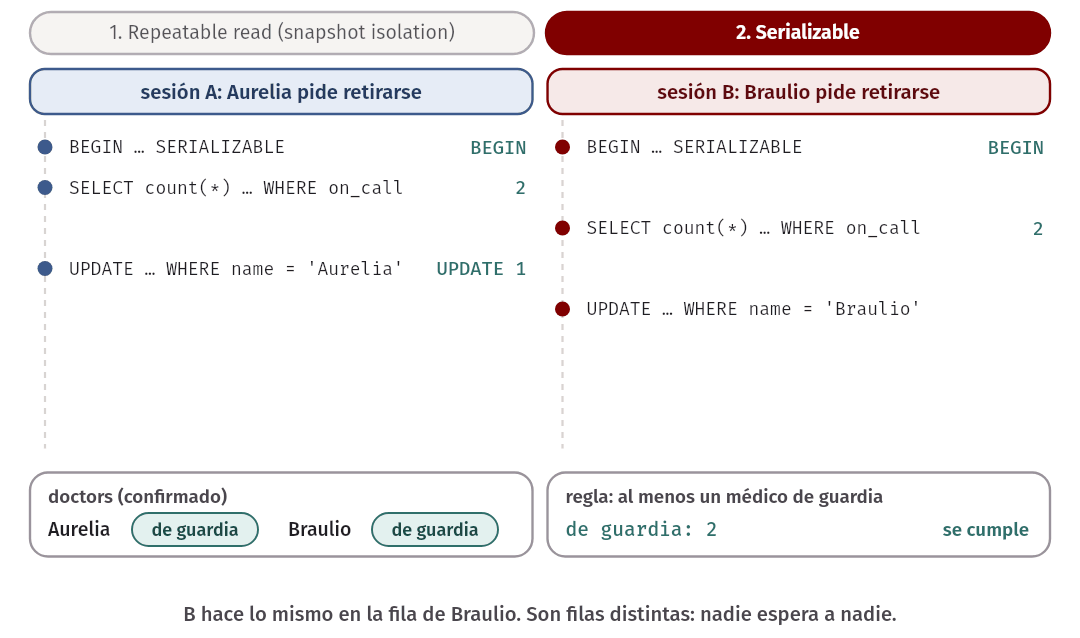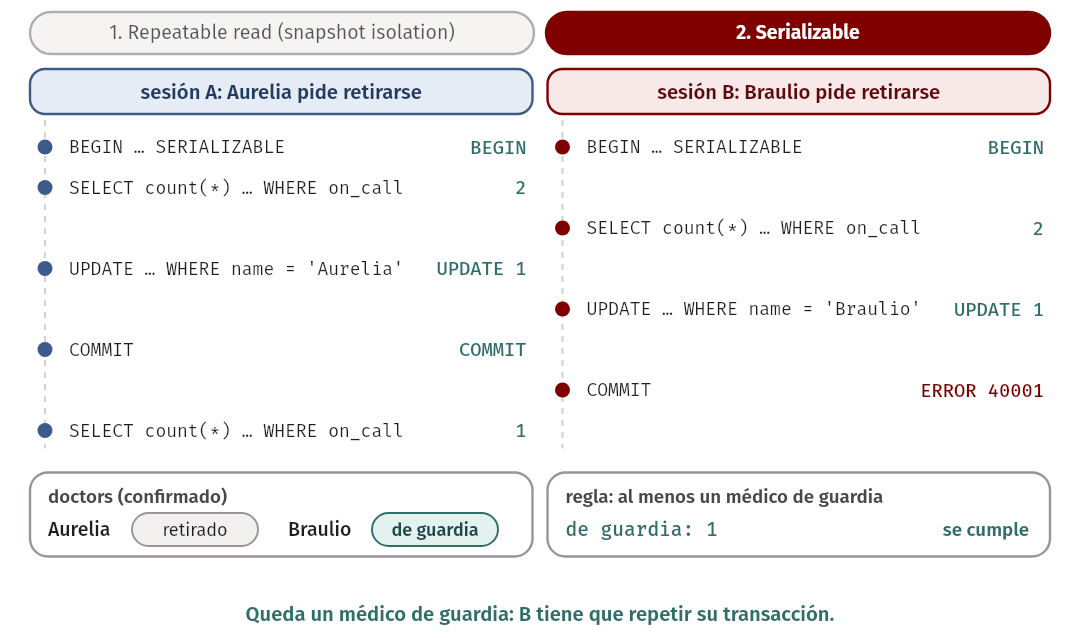
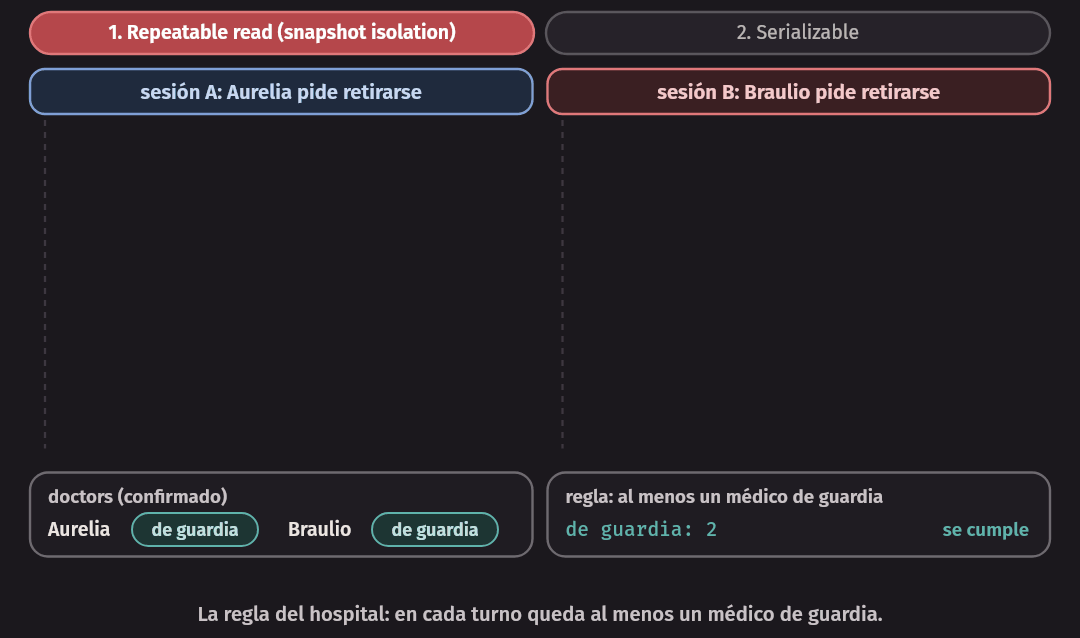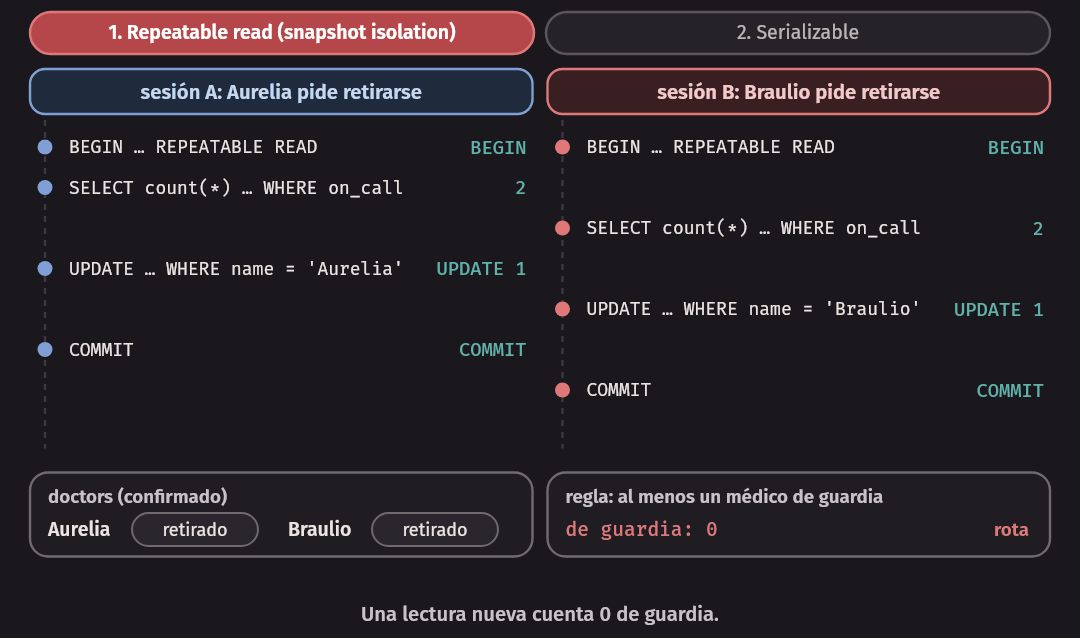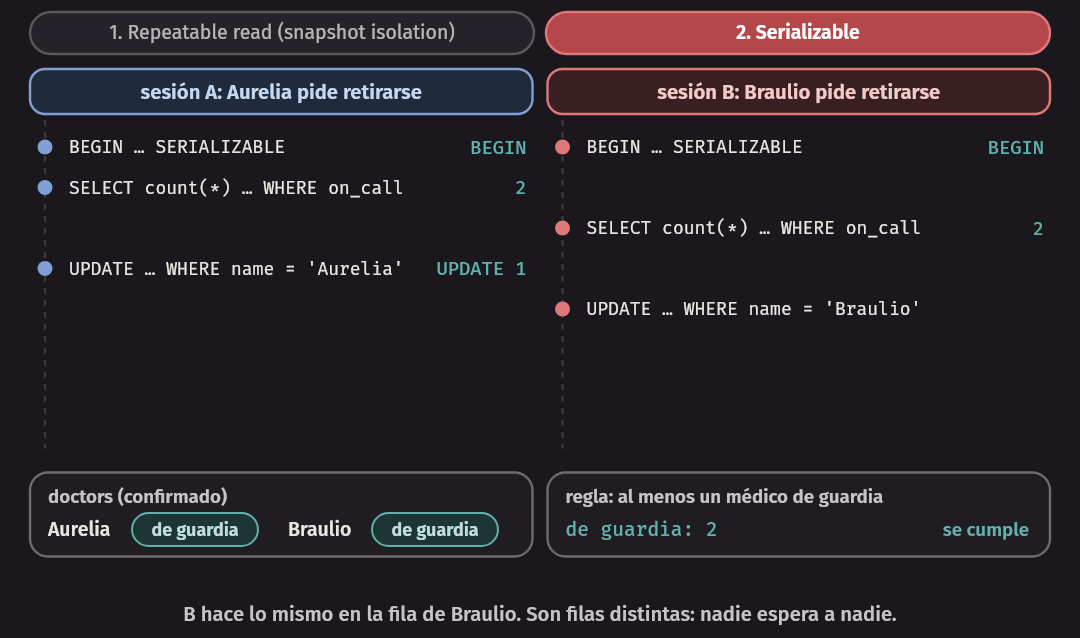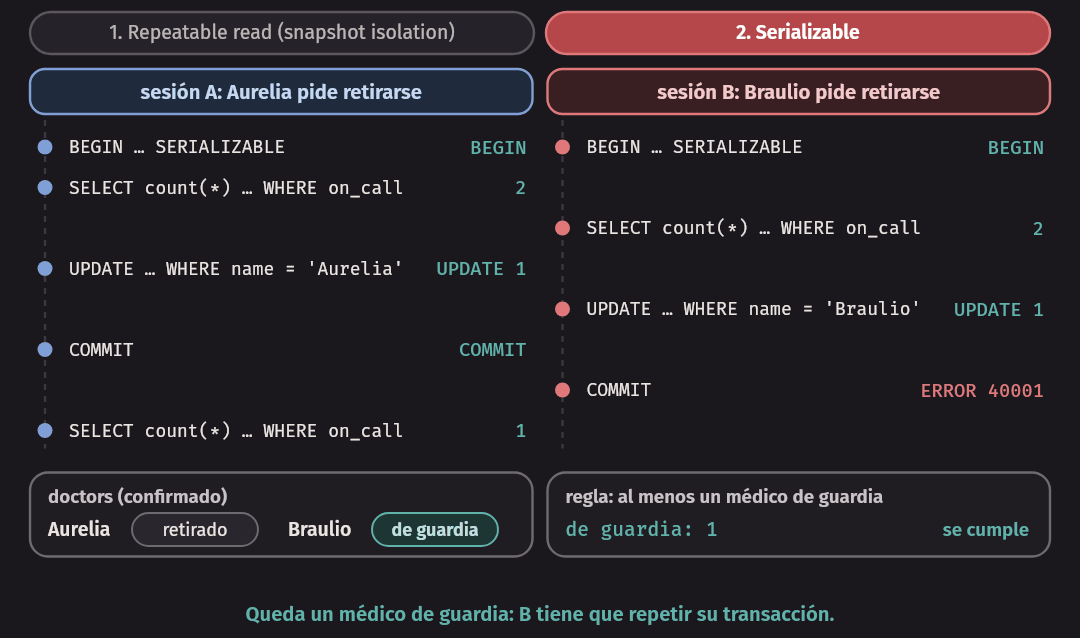
El ejemplo clásico es el de los médicos de guardia. Un hospital exige que en
cada turno quede al menos un médico de guardia. Un médico puede retirarse de
la guardia si hay otro que se queda. Aurelia y Braulio están de guardia, los
dos se sienten mal, y los dos piden retirarse casi al mismo tiempo. La
aplicación hace, para cada uno: contar cuántos médicos hay de guardia y, si
son dos o más, marcar a este como retirado. En repeatable read
(guion/08-write-skew.sql):
A=# BEGIN ISOLATION LEVEL REPEATABLE READ;
BEGIN
B=# BEGIN ISOLATION LEVEL REPEATABLE READ;
BEGIN
-- Cada médico comprueba que hay otro de guardia.
A=# SELECT count(*) AS de_guardia FROM doctors WHERE on_call;
 de_guardia
------------
          2
(1 row)
B=# SELECT count(*) AS de_guardia FROM doctors WHERE on_call;
 de_guardia
------------
          2
(1 row)
-- Y cada uno se retira. Escriben filas distintas: nadie espera a nadie.
A=# UPDATE doctors SET on_call = false WHERE name = 'Aurelia';
UPDATE 1
B=# UPDATE doctors SET on_call = false WHERE name = 'Braulio';
UPDATE 1
A=# COMMIT;
COMMIT
B=# COMMIT;
COMMIT
A=# SELECT count(*) AS de_guardia FROM doctors WHERE on_call;
 de_guardia
------------
          0
(1 row)
Nadie de guardia. Y ninguna de las defensas anteriores se activó: ninguna
sesión esperó, porque nadie tocó la fila de otro; no hubo error 40001,
porque nadie quiso modificar una fila que otro había cambiado. Cada
transacción, mirada sola, es correcta: vio dos médicos y retiró uno.
Esto es write skew: dos transacciones leen los mismos datos, deciden a partir de ellos, y escriben en filas distintas, de modo que cada una invalida la premisa de la otra. La premisa de Aurelia era “hay otro médico de guardia”, y la escritura de Braulio la volvió falsa, y al revés.
Snapshot isolation no lo impide por construcción. Cada transacción trabaja
sobre su foto, y en las dos fotos hay dos médicos. Lo que snapshot isolation
vigila son las escrituras sobre una misma fila; no vigila lo que se leyó
para decidir. Subir de read committed a repeatable read, entonces, no arregla
este defecto: el mismo guion en read committed da el mismo resultado, y una
prueba de test/anomalies.test.ts
lo comprueba en los dos niveles.
Serializable sí lo impide. El guion 9 son las mismas sentencias con otro
BEGIN:
A=# COMMIT;
COMMIT
B=# COMMIT;
ERROR:  could not serialize access due to read/write dependencies among transactions
DETAIL:  Reason code: Canceled on identification as a pivot, during commit attempt.
HINT:  The transaction might succeed if retried.
B=# \errverbose
ERROR:  40001: could not serialize access due to read/write dependencies among transactions
…
A=# SELECT count(*) AS de_guardia FROM doctors WHERE on_call;
 de_guardia
------------
          1
(1 row)
Tampoco aquí esperó nadie. PostgreSQL dejó avanzar a las dos, anotó qué leyó
cada una, y al llegar el segundo COMMIT reconoció que lo que B leyó fue
modificado por A y lo que A leyó fue modificado por B: no hay ningún orden,
una tras otra, que dé ese resultado. Abortó a B. Si la aplicación repite la
transacción de B, esta vez contará un solo médico y no dejará que Braulio se
retire.
Hay otra salida sin cambiar de nivel: SELECT … FOR UPDATE sobre las filas
que se leyeron para decidir. Con SELECT name FROM doctors WHERE on_call ORDER BY name FOR UPDATE, la segunda transacción espera en su lectura y,
cuando continúa, solo recibe a Braulio. Funciona porque aquí la decisión
dependía de filas que existen y se pueden bloquear. La anomalía siguiente es
el caso en que no existen.
Fantasmas
La sala de reuniones del hospedaje se reserva por día. A diferencia de las
noches, no hay una fila por cada día: una reserva es una fila nueva en
room_reservations. La aplicación comprueba que no haya ninguna reserva para
ese día y, si no la hay, inserta la suya. El equipo, que ya aprendió lo del
lock, lee con FOR UPDATE
(guion/10-phantom.sql):
A=# SELECT id FROM room_reservations WHERE room = 'sala' AND day = '2027-07-28' FOR UPDATE;
 id
----
(0 rows)
B=# SELECT id FROM room_reservations WHERE room = 'sala' AND day = '2027-07-28' FOR UPDATE;
 id
----
(0 rows)
A=# INSERT INTO room_reservations (room, day, guest) VALUES ('sala', '2027-07-28', 'Rosa');
INSERT 0 1
B=# INSERT INTO room_reservations (room, day, guest) VALUES ('sala', '2027-07-28', 'Juan');
INSERT 0 1
…
A=# SELECT id, room, day, guest FROM room_reservations;
 id | room |    day     | guest
----+------+------------+-------
  1 | sala | 2027-07-28 | Rosa
  2 | sala | 2027-07-28 | Juan
(2 rows)
FOR UPDATE bloquea las filas que la consulta devuelve, y la consulta no
devolvió ninguna. No hay nada que bloquear. Cuando la decisión de una
transacción depende de que una fila no exista, y otra transacción la
inserta, esa fila es un fantasma. Es un write skew donde lo leído es una
ausencia.
Tres salidas, de la más barata a la más cara:
- Una restricción de unicidad.
UNIQUE (room, day)hace que el segundoINSERTespere al primero y, si este confirma, falle con el error23505. Sirve cuando el conflicto se puede expresar como “dos filas con la misma clave”. - Crear las filas por adelantado. Si hubiera una fila por cada día de la
sala, la reserva sería un
UPDATEde una fila que existe, y los locks tendrían dónde agarrarse. Es exactamente lo que haceroom_nights, y lo que hace la tablaseatsde Tinkuy: los asientos existen antes de venderse. - Serializable. Con las dos transacciones en serializable, una aborta con
40001. PostgreSQL anota también lo que una consulta leyó “en vacío”.
Error común. Subir el nivel de una sola de las dos transacciones. Serializable protege a las transacciones serializables entre sí. Una prueba de
test/anomalies.test.tslo muestra: con A en serializable y B en read committed, las dos reservan la sala. Si se elige serializable para proteger un invariante, todas las transacciones que lo tocan tienen que usarlo.
Qué nivel evita qué
El resumen de lo que acabamos de ver, tal como lo comprueban las pruebas de
test/isolation.test.ts y test/anomalies.test.ts en PostgreSQL 18:
| Anomalía | Read committed | Repeatable read | Serializable |
|---|---|---|---|
| Dos lecturas de la transacción ven datos distintos | Ocurre | No ocurre | No ocurre |
| Actualización perdida (leer, calcular afuera, escribir) | Ocurre | Aborta una (40001) |
Aborta una (40001) |
Doble reserva con SELECT y después UPDATE de la misma fila |
Ocurre | Aborta una (40001) |
Aborta una (40001) |
| Write skew (los médicos) | Ocurre | Ocurre | Aborta una (40001) |
| Fantasma (la sala) | Ocurre | Ocurre | Aborta una (40001) |
Fíjense en la tercera fila. La doble reserva del hospedaje escribe la misma fila en las dos transacciones, así que repeatable read ya la detecta. Pero “aborta una” no es “funciona”: la aplicación recibe un error y alguien tiene que escribir el reintento. Y en la versión de la sala, donde reservar es insertar, repeatable read no detecta nada.
Tres maneras de no reservar dos veces
El defecto es un comprobar y después actuar en read committed. Hay tres
maneras de cerrarlo, y las tres están en booking/, con la misma firma, para
poder compararlas: reciben el pool, el pedido y una función charge que hace
de cobro. En las tres el cobro ocurre con la transacción abierta, como en el
Tinkuy inicial; lo que cambia es qué tiene tomado la transacción mientras
espera.
Solución 1: lock explícito
La idea: que la lectura ya reserve el derecho a escribir. SELECT … FOR UPDATE toma un lock sobre cada fila que devuelve y lo conserva hasta el
final de la transacción. El guion 2 es el guion 1 con esas dos palabras
agregadas:
A=# SELECT id, status FROM room_nights WHERE id = 1 FOR UPDATE;
 id |  status
----+-----------
  1 | available
(1 row)
-- B se detiene en su lectura: la fila tiene un lock de A.
B=# SELECT id, status FROM room_nights WHERE id = 1 FOR UPDATE;
    (la sesión B queda esperando: el lock lo tiene la sesión A)
A=# UPDATE room_nights SET status = 'booked' WHERE id = 1;
UPDATE 1
A=# INSERT INTO bookings (room_night_id, guest) VALUES (1, 'Rosa');
INSERT 0 1
A=# COMMIT;
COMMIT
    (la sesión B deja de esperar; su terminal muestra:)
 id | status
----+--------
  1 | booked
(1 row)
-- B ve la noche reservada: la aplicación responde "ya no está disponible".
B=# ROLLBACK;
ROLLBACK
La diferencia con el guion 1 es dónde espera B. Antes esperaba en el
UPDATE, cuando ya había decidido. Ahora espera en la lectura, y cuando
continúa lee el estado que dejó A. La comprobación y la acción de A quedaron
protegidas como una unidad: quienes compiten por la misma noche pasan de uno
en uno.
Qué detiene exactamente un FOR UPDATE, según las pruebas de
test/isolation.test.ts:
| Otra sesión intenta, sobre la misma fila | Resultado |
|---|---|
SELECT normal |
No espera. Lee la versión confirmada |
SELECT … FOR UPDATE o FOR SHARE |
Espera hasta el COMMIT o ROLLBACK de quien tiene el lock |
UPDATE o DELETE |
Espera igual |
SELECT … FOR UPDATE NOWAIT |
Falla enseguida con el error 55P03, sin esperar |
SELECT … FOR UPDATE SKIP LOCKED |
Se salta la fila bloqueada y devuelve las demás |
| Cualquier cosa sobre otra fila | No espera |
Tres cosas de esa tabla importan para el diseño. El lock es por fila, así que
solo se estorban quienes quieren la misma noche. Un SELECT normal no espera,
así que el catálogo sigue respondiendo mientras hay compras en curso (y por
eso mismo puede mostrar como libre una noche que alguien está pagando). Y el
lock no se suelta con la siguiente sentencia: dura hasta el final de la
transacción. La documentación de PostgreSQL lo dice así: los locks de fila no
afectan a las consultas; solo detienen a quienes escriben o bloquean la misma
fila.
La versión completa, en
booking/with-lock.ts:
await client.query('BEGIN');
// ORDER BY id: todas las transacciones toman los locks en el mismo
// orden, pidan las noches en el orden que las pidan. Sin eso, dos
// reservas con noches en común pueden esperarse una a la otra (deadlock).
const nights = await client.query<NightRow>(
  'SELECT id, status FROM room_nights WHERE id = ANY($1::int[]) ORDER BY id FOR UPDATE',
  [request.nightIds],
);
const problem = unavailable(nights.rows, request);
if (problem) {
  await client.query('ROLLBACK');
  return problem;
}
await charge(request); // con los locks tomados: nadie más avanza sobre estas noches
await client.query(`UPDATE room_nights SET status = 'booked' WHERE id = ANY($1::int[])`, [request.nightIds]);
const bookingIds = await insertBookings(client, request);
await client.query('COMMIT');
Trade-off. El lock explícito es fácil de razonar (es un “de uno en uno” por fila) y quien pierde no cobra ni escribe nada. A cambio, quien pierde espera lo que dure la transacción de quien ganó, con una conexión ocupada mientras tanto, y el equipo tiene que acordarse de pedir el lock en todos los caminos que leen para decidir. Un
SELECTsinFOR UPDATEen otro módulo vuelve a abrir el defecto, y nada avisa.
Deadlock y el orden de los locks
El comentario sobre ORDER BY id no es un adorno. Una reserva puede incluir
varias noches, y con varios locks aparece un problema nuevo. Rosa pide las
noches 1 y 2. Juan pide las mismas, pero su pedido llega como [2, 1]. Si
cada transacción bloquea las noches en el orden en que las recibió
(guion/03-deadlock.sql):
A=# SELECT id, status FROM room_nights WHERE id = 1 FOR UPDATE;
…
B=# SELECT id, status FROM room_nights WHERE id = 2 FOR UPDATE;
…
A=# SELECT id, status FROM room_nights WHERE id = 2 FOR UPDATE;
    (la sesión A queda esperando: el lock lo tiene la sesión B)
-- Con este paso se cierra el ciclo: A espera a B y B espera a A.
B=# SELECT id, status FROM room_nights WHERE id = 1 FOR UPDATE;
    (la sesión B queda esperando: el lock lo tiene la sesión A)
    (la sesión B deja de esperar; su terminal muestra:)
ERROR:  deadlock detected
DETAIL:  Process 4249 waits for ShareLock on transaction 41688; blocked by process 4247.
Process 4247 waits for ShareLock on transaction 41689; blocked by process 4249.
HINT:  See server log for query details.
CONTEXT:  while locking tuple (0,1) in relation "room_nights"
-- \errverbose repite el último error con su código SQLSTATE.
B=# \errverbose
ERROR:  40P01: deadlock detected
…
    (la sesión A deja de esperar; su terminal muestra:)
 id |  status
----+-----------
  2 | available
(1 row)
A tiene la noche 1 y espera la 2. B tiene la 2 y espera la 1. Ninguna puede avanzar, y ninguna va a soltar lo que tiene: eso es un deadlock. Solas no saldrían nunca.
PostgreSQL lo detecta. Una sesión que lleva esperando un lock más de
deadlock_timeout (1 segundo por omisión) revisa si hay un ciclo de esperas;
si lo hay, aborta su propia transacción con el error 40P01, y la otra
continúa. La documentación advierte que no se puede predecir cuál de las
transacciones será la abortada. (En el guion, la sesión A lleva un SET LOCAL deadlock_timeout = '60s' solo para que el resultado sea siempre el mismo.)
Que la base de datos lo resuelva no lo vuelve aceptable: el comprador que
recibió el 40P01 esperó un segundo para recibir un error, y la otra
transacción también estuvo detenida ese segundo. La solución es no formar el
ciclo: todas las transacciones toman los locks en el mismo orden. Con las
noches ordenadas por id, tanto [1, 2] como [2, 1] empiezan por la 1. La
segunda sesión espera ahí, sin tener nada tomado, y no hay ciclo posible
(guion/04-ordered-locks.sql):
A=# SELECT id, status FROM room_nights WHERE id IN (1, 2) ORDER BY id FOR UPDATE;
…
-- B pidió [2, 1], pero también empieza por la noche 1: espera sin tener nada.
B=# SELECT id, status FROM room_nights WHERE id IN (2, 1) ORDER BY id FOR UPDATE;
    (la sesión B queda esperando: el lock lo tiene la sesión A)
A=# UPDATE room_nights SET status = 'booked' WHERE id IN (1, 2);
UPDATE 2
A=# COMMIT;
COMMIT
    (la sesión B deja de esperar; su terminal muestra:)
 id | status
----+--------
  1 | booked
  2 | booked
(2 rows)
El error a propósito está en
errors/lock-unordered.ts, y su
prueba provoca el deadlock con dos llamadas a la función. Dos cosas más sobre
los deadlocks:
- No son exclusivos del
FOR UPDATE. UnUPDATEtambién toma un lock sobre cada fila que modifica, así que dos transacciones que modifican las mismas filas en orden distinto pueden caer en uno. El deadlock de las pruebas se reproduce igual en los tres niveles de aislamiento. - Como defensa de fondo, el código que usa locks debería estar preparado para
reintentar ante un
40P01. Ordenar evita los ciclos que uno conoce; el reintento cubre los que no.
Solución 2: UPDATE con condición y restricción UNIQUE
La segunda solución no agrega nada: quita. Si el problema es que hay un
tiempo entre comprobar y actuar, se puede hacer que comprobar y actuar sean
una sola sentencia. El UPDATE lleva la condición, y la base de datos
dice cuántas filas cambió:
UPDATE room_nights SET status = 'booked' WHERE id = $1 AND status = 'available';Si cambió una fila, la noche era nuestra. Si cambió cero, ya no estaba libre.
No hay lectura previa, y el if de la aplicación pasa a preguntar por el
resultado de la escritura. Funciona por el detalle de read committed que
dejamos pendiente: un UPDATE que tuvo que esperar vuelve a evaluar su
WHERE sobre la versión confirmada de la fila
(guion/05-conditional-update.sql):
A=# UPDATE room_nights SET status = 'booked' WHERE id = 1 AND status = 'available';
UPDATE 1
A=# INSERT INTO bookings (room_night_id, guest) VALUES (1, 'Rosa');
INSERT 0 1
-- El UPDATE de B espera a que A termine, y después vuelve a evaluar su WHERE.
B=# UPDATE room_nights SET status = 'booked' WHERE id = 1 AND status = 'available';
    (la sesión B queda esperando: el lock lo tiene la sesión A)
A=# COMMIT;
COMMIT
    (la sesión B deja de esperar; su terminal muestra:)
UPDATE 0
UPDATE 0. Y si A hubiera hecho ROLLBACK (un pago rechazado, por ejemplo),
el UPDATE de B habría cambiado una fila: la noche queda para quien sigue en
la cola. Las dos ramas están probadas.
El guion empieza con una sentencia más, que es la otra mitad de la solución:
ALTER TABLE bookings ADD CONSTRAINT bookings_one_per_night UNIQUE (room_night_id);Con esa restricción, el invariante deja de vivir solo en el código y pasa a
estar declarado en la base de datos. Si un programa descuidado inserta la
reserva sin haber hecho el UPDATE con condición, la base de datos la
rechaza:
B=# INSERT INTO bookings (room_night_id, guest) VALUES (1, 'Juan');
ERROR:  duplicate key value violates unique constraint "bookings_one_per_night"
DETAIL:  Key (room_night_id)=(1) already exists.
La restricción sola ya alcanza para proteger el invariante. Una prueba de
test/fixes.test.ts corre la versión
ingenua con la restricción puesta: de las dos transacciones que comprueban a
la vez, una termina con el error 23505 y queda una sola reserva. Pero la
misma prueba cuenta los cobros, y son dos: la restricción actuó al final,
cuando la segunda ya había cobrado. Por eso van juntas. El UPDATE con
condición rechaza pronto, antes de cobrar; la restricción garantiza que,
pase lo que pase en el código, el dato no queda mal.
La versión completa, en
booking/conditional.ts:
await client.query('BEGIN');
// Una noche por sentencia y en orden de id: el UPDATE también toma un
// lock sobre la fila que cambia, y el orden evita el deadlock.
for (const nightId of [...request.nightIds].sort((x, y) => x - y)) {
  const marked = await client.query(
    `UPDATE room_nights SET status = 'booked' WHERE id = $1 AND status = 'available'`,
    [nightId],
  );
  if (marked.rowCount !== 1) {
    // 0 filas: la noche no existe o ya no está libre. Se deshace lo marcado.
    await client.query('ROLLBACK');
    return { booked: false, reason: 'not_available' };
  }
}
const bookingIds = await insertBookings(client, request);
await charge(request);
await client.query('COMMIT');
Trade-off. Es la solución con menos piezas: una sentencia menos, sin lock explícito que alguien pueda olvidar, y con una restricción que protege el dato aunque el código falle. Lo que cuesta: solo sirve cuando la condición se puede escribir en el
WHEREde una escritura (los médicos de guardia no caben), elUPDATEsigue tomando un lock de fila, así que quien llega segundo también espera, y una restricciónUNIQUEtan simple supone que una reserva nunca se anula. Si las reservas se cancelan y la fila se conserva, hace falta un índice único parcial que solo cuente las vigentes.
Error común. Comprobar el invariante solo en la aplicación, con un
if, sin nada en la base de datos que lo respalde. Con una sola instancia del servicio ya falla, como vimos. Con dos instancias es peor de entender: elifde una no ve lo que hace la otra, y cualquier mecanismo en memoria (un mutex, un mapa de asientos ocupados) protege solo al proceso que lo tiene. El único lugar que ven todas las instancias es la base de datos.
Solución 3: serializable con reintento
La tercera solución no toca el código que comprueba y actúa. Cambia el nivel
de aislamiento de la transacción y deja que la base de datos detecte el
conflicto. El guion 6 es el guion 1 con otro BEGIN:
A=# BEGIN ISOLATION LEVEL SERIALIZABLE;
BEGIN
B=# BEGIN ISOLATION LEVEL SERIALIZABLE;
BEGIN
…
A=# UPDATE room_nights SET status = 'booked' WHERE id = 1;
UPDATE 1
A=# INSERT INTO bookings (room_night_id, guest) VALUES (1, 'Rosa');
INSERT 0 1
B=# UPDATE room_nights SET status = 'booked' WHERE id = 1;
    (la sesión B queda esperando: el lock lo tiene la sesión A)
A=# COMMIT;
COMMIT
    (la sesión B deja de esperar; su terminal muestra:)
ERROR:  could not serialize access due to concurrent update
B=# \errverbose
ERROR:  40001: could not serialize access due to concurrent update
LOCATION:  ExecUpdate, nodeModifyTable.c:2610
-- La transacción de B quedó abortada: lo único que acepta es ROLLBACK.
B=# INSERT INTO bookings (room_night_id, guest) VALUES (1, 'Juan');
ERROR:  current transaction is aborted, commands ignored until end of transaction block
B=# ROLLBACK;
ROLLBACK
Una reserva, y un error 40001 para B. El error no significa “la noche no
está”: significa “esta transacción no pudo completarse sin romper el
aislamiento; repítanla”. La documentación de PostgreSQL es explícita en que
las aplicaciones que usan este nivel deben estar preparadas para reintentar,
y en que el reintento es de la transacción completa, desde el BEGIN. Por eso
la solución tiene dos partes, y la segunda es código
(booking/retry.ts):
for (let attempt = 1; ; attempt += 1) {
  stats.attempts += 1;
  try {
    return await transaction();
  } catch (error) {
    const code = sqlState(error);
    if (code === SERIALIZATION_FAILURE) stats.serializationFailures += 1;
    else if (code === DEADLOCK_DETECTED) stats.deadlocks += 1;
    else throw error;
    if (attempt >= maxAttempts) throw new TooManyRetries(attempt);
    // Backoff exponencial con jitter: si todas reintentan a la vez, vuelven a chocar.
    const ceiling = Math.min(200, 5 * 2 ** attempt);
    await sleep(Math.random() * ceiling);
  }
}
En el nuevo intento, B empieza una transacción nueva, lee la noche como
booked y responde “ya no está disponible”. Solo se reintentan los códigos
40001 y 40P01: cualquier otro error daría lo mismo al repetirlo. La
espera antes del intento es un tiempo al azar entre 0 y milisegundos: el retry con backoff exponencial y jitter que
veremos con más detalle en la semana 14.
Lo atractivo de esta solución es que cubre también lo que las otras dos no: los médicos de guardia y la sala de reuniones se arreglan igual, sin pensar qué filas bloquear. Lo que cuesta tiene tres partes.
Hay que reintentar, y todos tienen que usar el nivel. Ya lo vimos: el
40001 es parte del funcionamiento normal, y una transacción en otro nivel
no queda protegida.
Un efecto fuera de la base de datos se repite con el reintento. El
ROLLBACK deshace las escrituras; no deshace una llamada a la pasarela.
errors/serializable-charge-first.ts
cobra antes de escribir, y su prueba termina con dos cobros para una reserva.
booking/serializable.ts cobra
después de escribir, para que el conflicto sobre la fila aparezca antes del
cobro. No alcanza: en serializable el error también puede llegar en el
COMMIT, como en el guion de los médicos, cuando el cobro ya se hizo. La
prueba de concurrencia lo deja a la vista (60 huéspedes, 4 noches):
✔ serializable con reintento: 60 huéspedes, 4 noches: exactamente 4 reservas, una por noche (39.83925ms)
ℹ cobros: 7 para 4 reservas; errores 40001: 13
Cuatro reservas, una por noche: el invariante se cumple. Y siete cobros. El número cambia de una corrida a otra (en otras salieron 5, 6, 9, 10 y 17), pero con las otras dos soluciones la misma prueba exige exactamente cuatro, y pasa. Una transacción que puede abortar y repetirse no debe tener efectos fuera de la base de datos, salvo que esos efectos sean idempotentes. Es el tema de la segunda sesión.
Serializable aborta de más
Y aborta transacciones que no competían por nada. Para saber si una
escritura invalida lo que otra transacción leyó, PostgreSQL anota lo que cada
transacción serializable lee (son locks de predicado, que no detienen a
nadie). No siempre los anota fila por fila. Si la consulta recorrió la tabla
entera, anota la tabla. Si entró por un índice, anota páginas del índice.
Cuanto más grueso es lo anotado, más transacciones parecen estar en conflicto
sin estarlo. Tres pruebas de test/anomalies.test.ts lo muestran con dos
reservas de noches distintas, que no tienen por qué estorbarse:
✔ serializable, dos reservas de noches distintas (300 noches, recorrido secuencial): una aborta igual (54.660084ms)
✔ serializable, dos reservas de noches distintas (300 noches, por el índice (todo el índice cabe en una página)): una aborta igual (56.746625ms)
✔ serializable, dos reservas de noches distintas (3000 noches, por el índice, noches lejanas): ninguna aborta (59.244ms)
Con 300 noches, la tabla es tan pequeña que cualquier par de reservas simultáneas parece un conflicto. La documentación lo anticipa: un recorrido secuencial necesita un lock de predicado sobre toda la tabla, y eso aumenta la tasa de errores de serialización. En la práctica quiere decir que el costo de serializable depende de los planes de las consultas, que cambian con los datos y con los índices: una consulta que pierde su índice no solo se vuelve lenta, también empieza a abortar a las demás.
Trade-off. Serializable ofrece lo más cercano a no pensar en concurrencia: el código se escribe como si corriera solo y la base de datos rechaza las mezclas incorrectas, incluidas las que nadie previó. Se paga con transacciones abortadas (algunas sin conflicto real), con el código de reintento, con la disciplina de que todas las transacciones usen el nivel, y con la obligación de que nada dentro de la transacción tenga efectos externos que no se puedan repetir.
Optimista y pesimista
Las tres soluciones son ejemplos de dos actitudes generales ante la concurrencia.
El control pesimista supone que habrá conflicto y se protege antes: toma un lock, y quien llega después espera. Es la solución 1. Nadie hace trabajo que después se descarta, pero todos pagan la espera, haya conflicto o no, y aparecen los deadlocks.
El control optimista supone que no habrá conflicto, deja avanzar a todos y
comprueba al final. Si hubo conflicto, alguien descarta su trabajo y lo
repite. Es la solución 3, y es también la columna de versión de la tabla de
la actualización perdida: se lee la fila con su número de versión, se trabaja
sin tener nada tomado, y la escritura lleva la condición AND version = $2.
Si cambió cero filas, alguien se adelantó. La columna de versión tiene una
ventaja que los locks no tienen: funciona aunque entre la lectura y la
escritura no haya una transacción abierta, por ejemplo cuando una persona
tiene un formulario abierto varios minutos.
La solución 2 está en medio: no hay lectura previa ni trabajo que descartar, y
la espera es la del lock que toma el propio UPDATE.
Cuál conviene depende de cuánta contención hay, es decir, de cuántas transacciones quieren lo mismo a la vez. Con poca contención, el optimista casi nunca repite nada y se ahorra las esperas. Con mucha, casi todo el trabajo se descarta y se repite, los reintentos se suman a la carga, y el sistema hace cada vez más trabajo para completar lo mismo.
Las tres, medidas
booking/server.ts expone las cuatro versiones por HTTP (STRATEGY=naive,
lock, conditional o serializable), con un pool de 20 conexiones y un
cobro simulado de 20 ms. Dos cargas distintas las comparan.
Mucha contención. make compare-burst lanza 200 pedidos simultáneos por
las mismas 10 noches, cinco rondas con cada estrategia. Una corrida (de cada
estrategia se muestran las rondas 1, 2 y 5):
$ make compare-burst
ronda  estrategia     201  409  5xx  reservas  dobles  cobros  transacciones  40001   p50 ms   p95 ms   max ms
    1  naive          22  178    0        22      10      22            200      0       80       82       93
    2  naive          26  174    0        26      10      26            200      0       46       55       64
…
    5  naive          22  178    0        22      10      22            200      0       34       39       50
ronda  estrategia     201  409  5xx  reservas  dobles  cobros  transacciones  40001   p50 ms   p95 ms   max ms
    1  lock           10  190    0        10       0      10            200      0       84       93       95
    2  lock           10  190    0        10       0      10            200      0       46       53       54
…
    5  lock           10  190    0        10       0      10            200      0       34       40       41
ronda  estrategia     201  409  5xx  reservas  dobles  cobros  transacciones  40001   p50 ms   p95 ms   max ms
    1  conditional    10  190    0        10       0      10            200      0       68       75       76
    2  conditional    10  190    0        10       0      10            200      0       39       40       41
…
    5  conditional    10  190    0        10       0      10            200      0       34       39       40
ronda  estrategia     201  409  5xx  reservas  dobles  cobros  transacciones  40001   p50 ms   p95 ms   max ms
    1  serializable   10  190    0        10       0      33            294     94      193      253      265
    2  serializable   10  190    0        10       0      55            313    113      201      258      270
…
    5  serializable   10  190    0        10       0      34            292     92      122      171      185
La columna “dobles” son las noches con más de una reserva. Repetimos la corrida completa tres veces, en una laptop con Apple Silicon dentro de Docker y con otros contenedores trabajando a la vez, así que los tiempos tienen ruido (la primera ronda de cada servidor siempre es más lenta). Lo que se mantuvo en las quince rondas de cada estrategia:
- La versión ingenua hizo entre 20 y 26 reservas de 10 noches, y casi siempre las 10 noches quedaron con reserva doble. Es la más “rápida” porque no espera a nadie, que es justamente su defecto.
- Lock y UPDATE con condición: 10 reservas, 10 cobros y 200 transacciones, siempre. Entre las dos no hay una diferencia de latencia que se distinga del ruido: las dos hacen esperar al segundo en un lock de fila.
- Serializable: 10 reservas, y para conseguirlas entre 266 y 316
transacciones (entre un tercio y algo más de la mitad de trabajo extra para
lo mismo), entre 66 y 116 errores
40001y entre 27 y 55 cobros. Su p95 fue, según la ronda, entre casi 2 y 6 veces el de las otras dos soluciones medidas en la misma corrida. Es el optimista bajo mucha contención: los reintentos se pagan en latencia, y los cobros repetidos son el defecto de la sección anterior.
Poca contención. make compare-load corre k6 durante 15 segundos con 200
huéspedes sobre 3 000 noches: cada uno pide una noche al azar (a veces dos) y
vuelve a intentar. Los choques son ocasionales. Una de las tres corridas (de
cada estrategia, el estado final, los pedidos aceptados y la latencia):
$ make compare-load
== naive: reservas=2977 noches_reservadas=2953 noches_con_reserva_doble=24 cobros=2522 transacciones=14553 errores_40001=0 errores_5xx=0
    bookings_ok....................: 2522   164.879215/s
    http_req_duration..............: med=755.45µs p(95)=23.87ms  p(99)=94.27ms  max=248.2ms
== lock: reservas=2944 noches_reservadas=2944 noches_con_reserva_doble=0 cobros=2501 transacciones=14543 errores_40001=0 errores_5xx=0
    bookings_ok....................: 2501   163.139471/s
    http_req_duration..............: med=420.83µs p(95)=22.33ms p(99)=88.6ms   max=245.7ms
== conditional: reservas=2954 noches_reservadas=2954 noches_con_reserva_doble=0 cobros=2519 transacciones=14642 errores_40001=0 errores_5xx=0
    bookings_ok....................: 2519   164.221087/s
    http_req_duration..............: med=545.83µs p(95)=21.74ms  p(99)=81.36ms  max=221.34ms
== serializable: reservas=2949 noches_reservadas=2949 noches_con_reserva_doble=0 cobros=2517 transacciones=14558 errores_40001=30 errores_5xx=0
    bookings_ok....................: 2508   163.610633/s
    http_req_duration..............: med=935.31µs p(95)=24.28ms  p(99)=107.06ms max=265.98ms
Con poca contención, las tres soluciones cuestan lo mismo: en las tres
corridas, el p95 de las cuatro versiones quedó entre 21 y 34 ms, sin un orden
estable entre ellas (es, sobre todo, el cobro de 20 ms). Lo que sí se repitió:
la versión ingenua dejó entre 15 y 24 noches con reserva doble, aun con
choques ocasionales; y serializable tuvo entre 27 y 38 errores 40001 y
cobró más veces de las que reservó (2 517 cobros para 2 508 pedidos
aceptados en esta corrida), mientras que en las otras dos soluciones los
cobros y los pedidos aceptados coinciden siempre.
Idea clave. La corrección no es un trade-off: las tres soluciones dan cero reservas dobles, y la versión ingenua no es una opción por rápida que sea. El trade-off está entre las tres, y solo aparece con contención. Para la apertura de una venta, que es contención pura sobre pocos recursos, conviene que quien pierde espere poco y no repita trabajo: un lock de fila, explícito o el del
UPDATEcon condición. Para operaciones con invariantes que cruzan varias filas y poca contención, serializable ahorra errores de razonamiento a un costo bajo.
La transacción como recurso
Las mediciones anteriores usaron un cobro de 20 ms. Hay que mirar qué pasa cuando el servicio externo se pone lento, porque muestra algo que no depende de la estrategia elegida: una transacción abierta ocupa cosas.
- Una conexión a la base de datos, que no puede atender a nadie más. Las conexiones son pocas: el pool de este servidor tiene 20, y PostgreSQL, en el contenedor, acepta 100 en total.
- Los locks que haya tomado, que detienen a quien quiera las mismas filas.
- En PostgreSQL, además, una transacción abierta mucho tiempo puede impedir que se limpien las versiones viejas de las filas.
Con el servidor en STRATEGY=lock y un cobro de 3 segundos
(CHARGE_MS=3000), lanzamos los 200 pedidos por 10 noches y, a mitad de
camino, le preguntamos a PostgreSQL qué hace cada conexión:
$ make activity
        state        | espera | conexiones
---------------------+--------+------------
 active              | Lock   |         10
 idle in transaction | Client |         10
(2 rows)
Diez conexiones están en idle in transaction: tienen una transacción
abierta, con su lock, y no ejecutan nada. Esperan a la aplicación, que a su
vez espera el cobro. Otras diez esperan un lock que tienen las primeras. Son
las 20 del pool. Los otros 180 pedidos ni siquiera tienen conexión: hacen cola
en la aplicación. El resultado de esa ronda:
ronda  estrategia     201  409  5xx  reservas  dobles  cobros  transacciones  40001   p50 ms   p95 ms   max ms
    1  lock           10  190    0        10       0      10            200      0     3079     3082     3084
Todo correcto, y todos tardaron 3 segundos, incluidos los 190 que solo recibieron un “ya no está disponible”. La lentitud de un sistema externo se contagió a toda la base de datos a través de las transacciones abiertas. Y si en ese momento alguien quiere listar las noches, tampoco encuentra una conexión libre.
En Tinkuy. El Tinkuy inicial llama a la pasarela dentro de la transacción (lo vieron en el fragmento de
createOrder), y además envía el correo antes delCOMMIT. Cada compra retiene una conexión durante todo el cobro y, en cuanto agreguen un lock para P2, también el asiento. Mientras la pasarela responde en 80 ms casi no se nota. La semana 14 empieza con la pasarela tardando cinco segundos.
La regla que sale de aquí: una transacción debe durar lo que duran sus
sentencias, y no esperar a nada que esté fuera de la base de datos. La
documentación de PostgreSQL lo recomienda al hablar de deadlocks (no mantener
transacciones abiertas mientras se espera, por ejemplo, la entrada de un
usuario) y al hablar de serializable (no dejar conexiones en idle in transaction más de lo necesario).
Pero sacar el cobro de la transacción tiene un precio, y es el tema de la
segunda sesión. Si se cobra antes de la transacción, se puede cobrar un
asiento que después resulta no estar. Si se cobra después, se puede confirmar
una reserva que nadie pagó. Dentro de la transacción, al menos, el ROLLBACK
deshacía la mitad del problema.
Trade-off. El cobro dentro de la transacción es simple y mantiene juntas la reserva y su pago, a costa de retener una conexión y unos locks durante una espera que no controlamos. Fuera de la transacción, la base de datos queda libre y aparecen estados intermedios que hay que modelar: una reserva pendiente de pago, un pago sin reserva. No hay una opción sin costo; hay que elegir cuál se paga.
Cuando la transacción no alcanza
Dos sistemas, ninguna transacción
Todo lo anterior supone que los datos están en una sola base de datos. La
compra completa no cabe en ese supuesto. Reservar la noche es una escritura
en la base de datos del hospedaje. Cobrar es una operación en la pasarela, que
es un sistema de otra empresa, con su propia base de datos, al otro lado de
una red. No existe un BEGIN que abarque a los dos. Y lo mismo pasa entre dos
servicios propios cuando cada uno es owner de sus datos, que era la regla de
los microservicios en la semana 5.
Sin una transacción común, los dos órdenes posibles tienen un hueco:
| Orden | Si el proceso falla entre los dos pasos | Resultado |
|---|---|---|
| Cobrar y después registrar la reserva | Se cobró y la reserva no existe | Un cobro sin reserva |
| Registrar la reserva y después cobrar | La reserva existe y nadie cobró | Una reserva sin pago |
Ningún orden elimina el hueco. Lo que se puede elegir es cuál de los dos estados incorrectos es menos grave y más fácil de reparar. Esa elección es el diseño de una saga.
Un timeout no dice qué pasó
Lo que vuelve difícil a un sistema distribuido, y no solo incómodo, son las
fallas parciales: una parte funciona y otra no, y quien llama no puede
distinguir cuál. Lo vieron en la semana 5 con make lost-reply: el pedido que
se pierde y la respuesta que se pierde se ven idénticos desde el cliente.
Brandur Leach, en la lectura de Stripe, lo ordena en tres casos para una llamada entre dos nodos: la conexión inicial puede fallar; la llamada puede fallar a la mitad, mientras el servidor hace la operación, y dejar el trabajo en el limbo; o la llamada puede completarse y la conexión cortarse antes de que el servidor se lo diga al cliente. En el primero no pasó nada; en el tercero pasó todo; en el segundo, quién sabe. Desde el cliente, los tres son un timeout o un error de red.
De ahí sale la regla de toda la sesión: no se puede saber; solo se puede diseñar para que repetir sea seguro. Un timeout no es un “no”. Si después de un timeout el cliente se rinde, puede dejar un cobro hecho y sin registrar. Si reintenta, puede cobrar dos veces. La única salida es que el reintento no tenga efecto cuando la primera vez sí lo tuvo.
Two-phase commit
Antes de las sagas hay que mirar el mecanismo que sí da atomicidad entre varios nodos, para entender por qué casi nunca se usa entre servicios.
En two-phase commit (2PC) hay un coordinador y varios participantes, y la confirmación se hace en dos fases:
- Preparar. El coordinador le pregunta a cada participante si puede confirmar. Cada uno hace todo el trabajo, lo deja escrito de forma durable y responde sí o no. Al responder sí, promete que podrá confirmar pase lo que pase, incluso si se cae y vuelve a arrancar.
- Confirmar. Si todos dijeron sí, el coordinador anota la decisión y les ordena confirmar. Si alguno dijo no, les ordena abortar.
Da lo que promete: o todos confirman o ninguno. El precio está en la promesa. Un participante que respondió sí ya no puede decidir solo: no puede abortar, porque prometió confirmar, ni confirmar, porque quizá otro dijo que no. Tiene que esperar la orden, y mientras espera conserva sus locks. Si el coordinador se cae justo en ese momento, el participante queda detenido, con sus filas bloqueadas, hasta que el coordinador vuelva. Una transacción local acota cuánto duran sus locks; con 2PC, la duración la decide la disponibilidad de otro nodo.
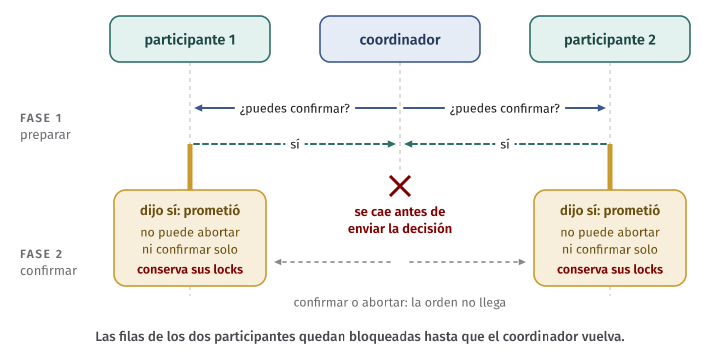
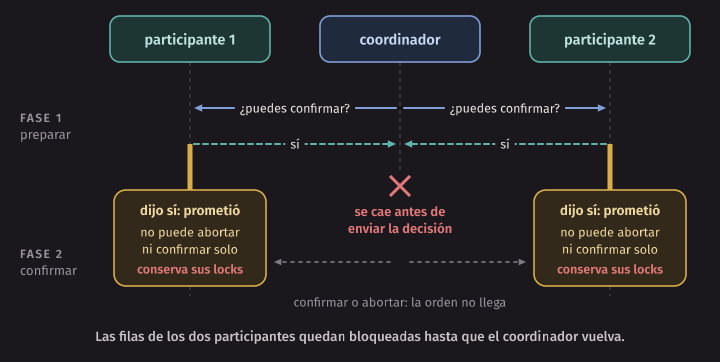
Tres razones por las que no sirve para coordinar una reserva con su cobro:
- Todos los participantes tienen que hablar el protocolo. Una pasarela de pagos externa ofrece una API HTTP para cobrar; no ofrece “preparar” y “confirmar” de una transacción ajena, ni va a dejar sus recursos bloqueados a la espera de nuestro coordinador.
- La disponibilidad se multiplica. La operación solo se completa si todos los participantes y el coordinador están arriba a la vez. Con las cuentas de la semana 5, , cada participante que se agrega baja la disponibilidad del conjunto.
- Los locks cruzan servicios. La latencia y las caídas de un servicio se convierten en filas bloqueadas en otro.
2PC se usa, y funciona, dentro de un mismo sistema: una base de datos distribuida lo emplea para confirmar una transacción que toca varios shards, con todos los nodos bajo el mismo equipo y el mismo protocolo. Entre servicios de equipos distintos, y más aún con sistemas de terceros, casi nunca.
Trade-off. Two-phase commit conserva la atomicidad y la paga con disponibilidad y con acoplamiento: todos esperan a todos. Una saga hace lo contrario: cada servicio confirma por su cuenta y nadie espera, y se renuncia a la atomicidad y al aislamiento.
Sagas
Transacciones locales y compensaciones
Una saga es una secuencia de transacciones locales, cada una en su
servicio. Cada paso se confirma de verdad al terminar: no queda nada
“preparado” ni bloqueado a la espera de los demás. Si un paso falla, no hay
ROLLBACK posible para los anteriores, porque ya confirmaron. En su lugar se
ejecutan transacciones de compensación, una por cada paso completado, en
orden inverso, que deshacen su efecto.
La idea es de 1987. Hector Garcia-Molina y Kenneth Salem la propusieron para las transacciones de larga duración, las que tardan horas o días y no pueden tener locks tomados todo ese tiempo; su ejemplo es una reserva de vuelos. La garantía que describen es que, de una saga con pasos , se ejecuta la secuencia completa o bien una parte seguida de sus compensaciones:
Dos advertencias que ya están en ese artículo siguen siendo las importantes. La compensación deshace el paso desde el punto de vista del negocio, no devuelve la base de datos al estado anterior: liberar una noche apartada no borra que estuvo apartada, y devolver un cobro son dos movimientos en el estado de cuenta, no ninguno. Y otras transacciones pueden ver los efectos de una saga que todavía no termina. Una saga tiene atomicidad “por partes” y no tiene aislamiento.
Como los estados intermedios se ven desde afuera, se modelan de forma
explícita. Una noche no pasa de libre a reservada: pasa por held (apartada).
Una orden no nace pagada: nace pending y termina paid o cancelled. Un
estado intermedio que no tiene nombre igual existe; solo que nadie decidió qué
se puede hacer con el recurso mientras dura.
El orden de los pasos y el punto de no retorno
No todos los pasos son iguales, y el diseño de una saga consiste en clasificarlos y ordenarlos.
| Tipo de paso | Qué es | Ejemplo | Dónde va |
|---|---|---|---|
| Compensable | Se puede deshacer con otra transacción | Apartar una noche (se libera) | Al principio |
| Punto de no retorno | Si se completa, la saga ya no vuelve atrás | El cobro aprobado | En medio, uno solo |
| Reintentable | No puede fallar por una regla del negocio, solo por una falla técnica, y se repite hasta que salga | Emitir el comprobante, enviar el correo | Al final |
El orden importa por una razón simple: antes del punto de no retorno, una falla se resuelve hacia atrás, compensando; después, solo hacia adelante, reintentando. Por eso los pasos que pueden fallar por una regla del negocio (no hay noche, el pago se rechaza) van antes o en el punto de no retorno, y después solo quedan pasos que tarde o temprano van a salir.
No todo se compensa. Un correo enviado no se retira: se envía otro que lo corrige. Un cobro se puede devolver, pero la devolución tarda, puede costar una comisión y el comprador la ve. Poner el cobro después de todo lo que puede fallar evita tener que devolverlo.
Error común. Diseñar una saga cuya compensación puede fallar por una regla del negocio. Si para deshacer la reserva hay que “devolver el cupo” y el cupo ya lo tomó otro, la saga no puede ni avanzar ni retroceder. Una compensación tiene que poder ejecutarse siempre: como mucho, se reintenta.
La saga del hospedaje
En saga/, reservar una noche tiene tres participantes: inventario (aparta
la noche), pagos (cobra) y comprobantes (emite el comprobante). Cada uno tiene
sus tablas y ninguno toca las de otro; en un sistema real serían tres
servicios, y las llamadas irían por la red. El orquestador
(saga/orchestrator.ts) guarda en su
propia tabla, sagas, en qué estado va cada una:
| Estado | Paso que sigue | Si sale bien | Si falla por una regla del negocio |
|---|---|---|---|
started |
hold: apartar la noche (compensable) |
reserved |
cancelled: no hay nada que compensar |
reserved |
charge: cobrar (punto de no retorno) |
charged |
compensating |
charged |
issue y confirm: emitir el comprobante y confirmar la noche (reintentables) |
completed |
No aplica: se reintenta |
compensating |
release: liberar la noche |
cancelled |
No aplica: se reintenta |
El núcleo del orquestador es un bucle que lee el estado y ejecuta el paso que toca:
case 'reserved': {
  const result = await this.#step('charge', () => this.#participants.charge(saga.id, saga.amountCents));
  // Aprobado: pasó el punto de no retorno. Rechazado: hay que deshacer lo anterior.
  await this.#set(saga.id, result === 'approved' ? 'charged' : 'compensating', result === 'approved' ? null : 'pago rechazado');
  break;
}
Entre “el participante hizo el paso” y “el orquestador lo anotó” hay dos
escrituras en dos lugares, y el orquestador puede morir en medio. Cuando
vuelve a arrancar, lee sagas, encuentra la saga en el estado anterior y
repite el paso. Por eso cada operación de los participantes
(saga/participants.ts) tiene que
poder repetirse sin daño:
async hold(nightId, sagaId) {
  // "O held_by = esta saga": repetir el paso después de una respuesta perdida da lo mismo.
  const result = await pool.query(
    `UPDATE inventory_nights SET status = 'held', held_by = $2
      WHERE id = $1 AND (status = 'available' OR (status = 'held' AND held_by = $2))`,
    [nightId, sagaId],
  );
  return result.rowCount === 1;
},
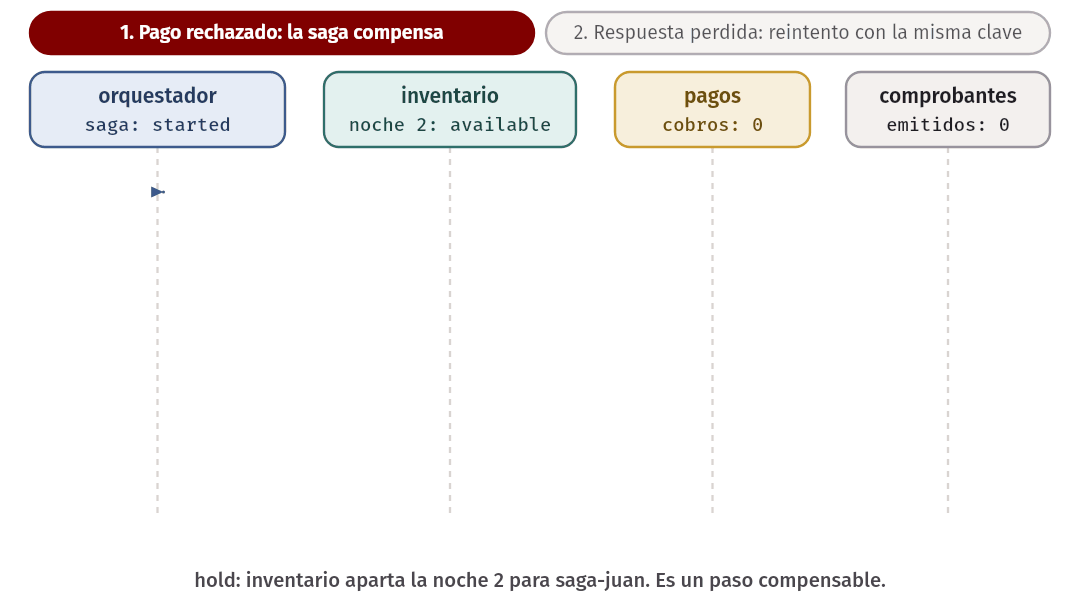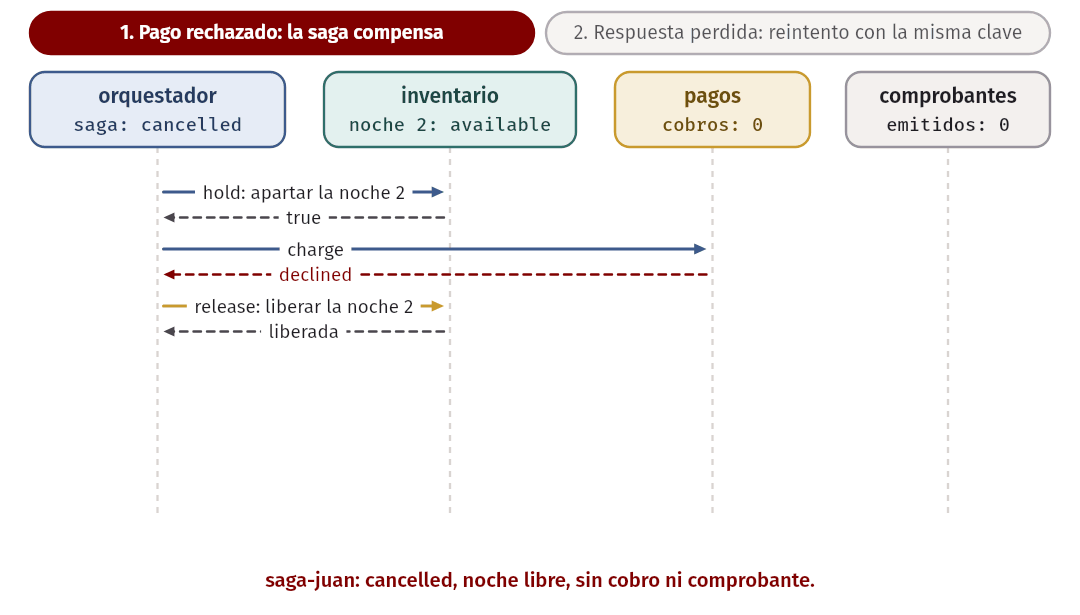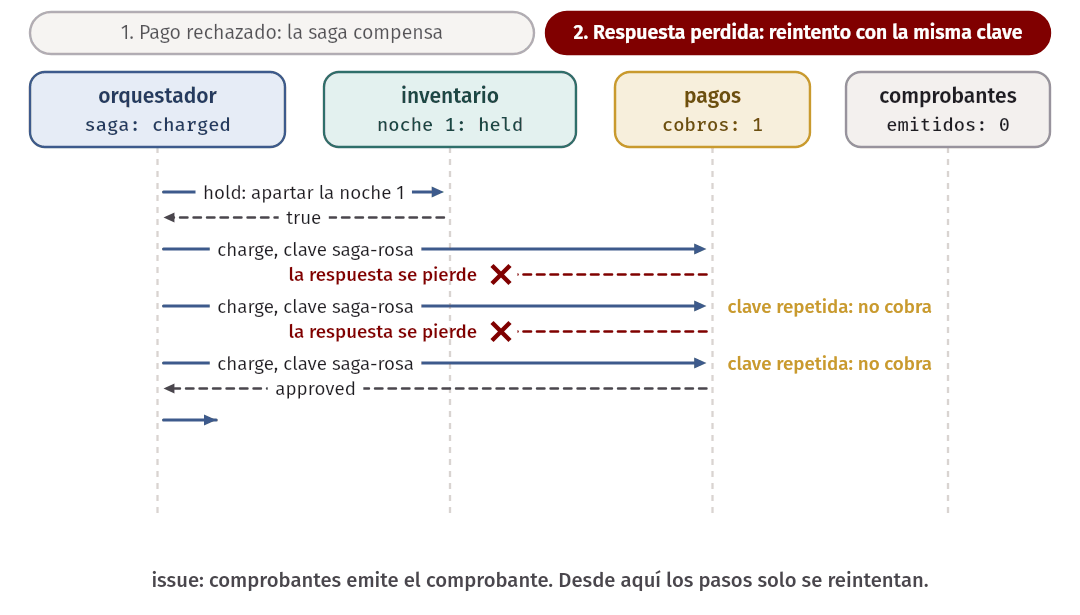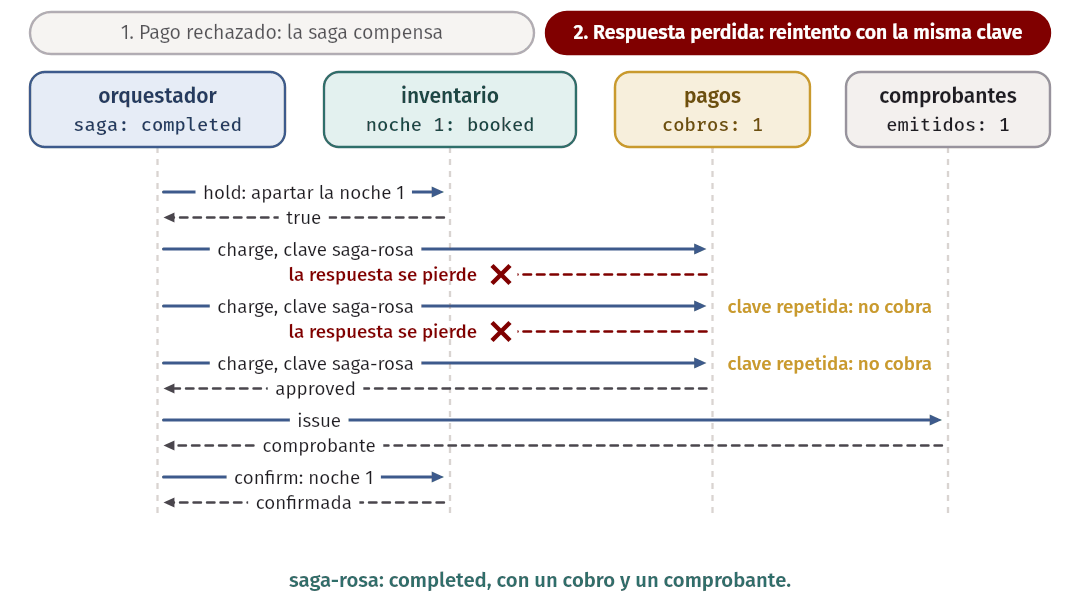
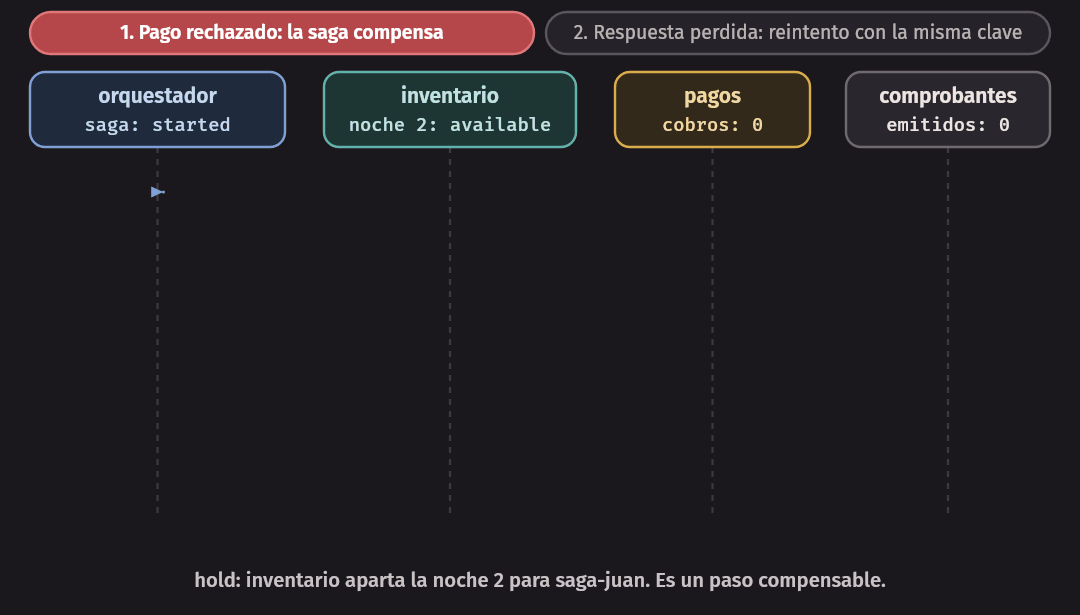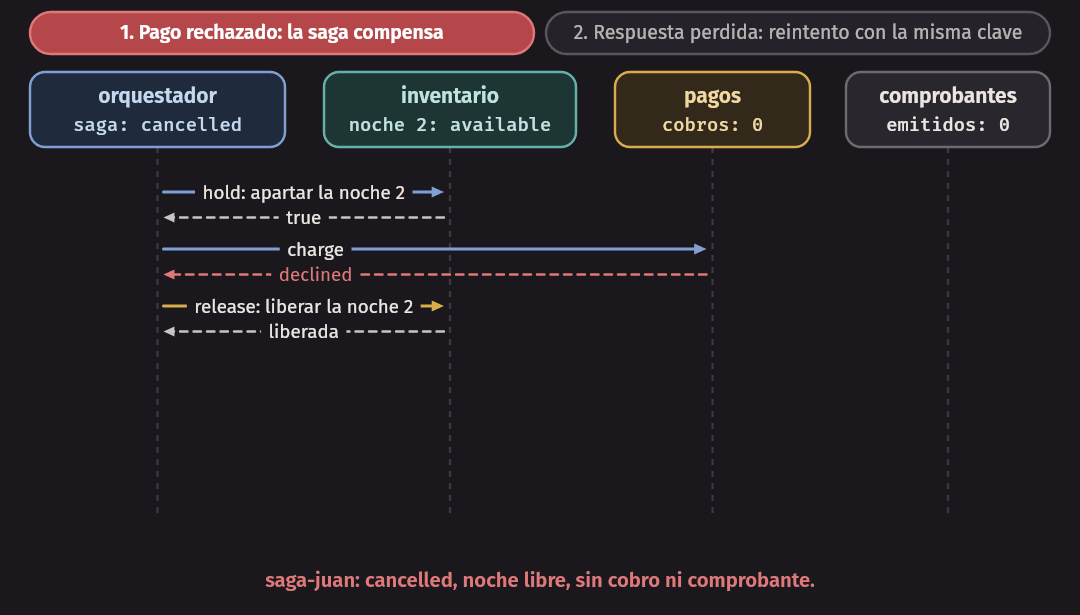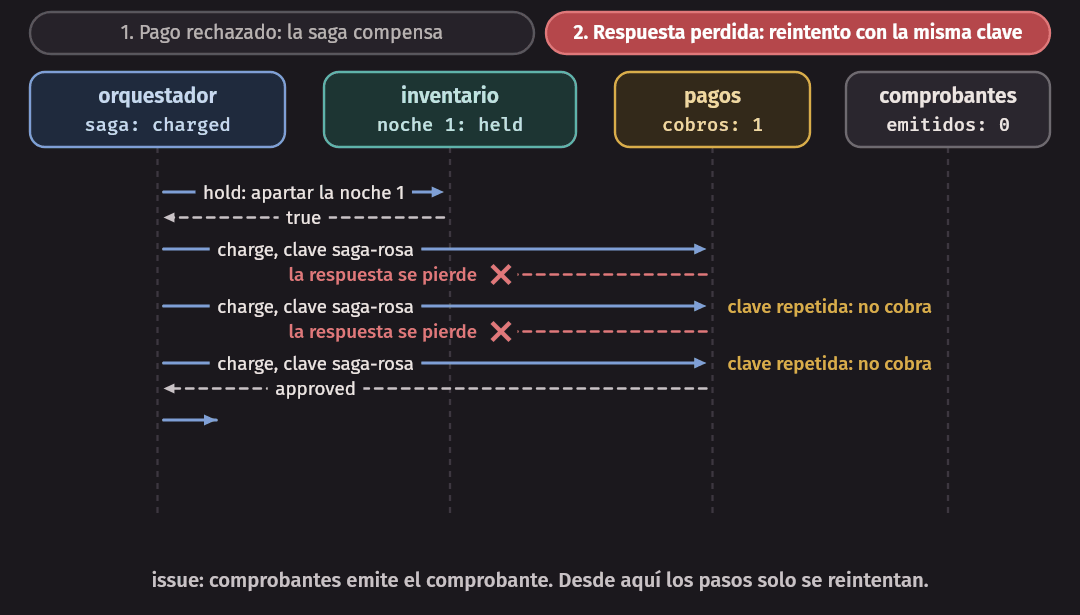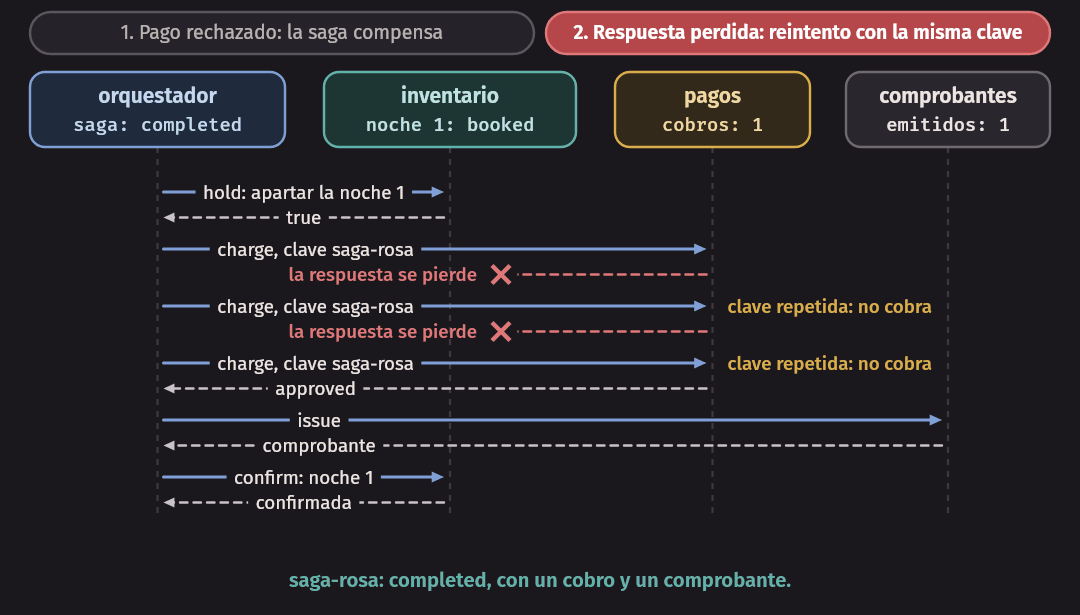
make saga corre tres: una que sale bien, una con el pago rechazado, y una
en la que el orquestador muere justo después de cobrar.
$ make saga
Después de la caída del orquestador:
  saga         estado      noche      apartada por  cobros  comprobantes
  saga-ines    reserved    held       saga-ines          1             0
  saga-juan    cancelled   available  -                  0             0
  saga-rosa    completed   booked     saga-rosa          1             1
Después de recover():
  saga         estado      noche      apartada por  cobros  comprobantes
  saga-ines    completed   booked     saga-ines          1             1
  saga-juan    cancelled   available  -                  0             0
  saga-rosa    completed   booked     saga-rosa          1             1
La primera tabla es lo que una transacción nunca dejaría ver: la saga de Inés
dice reserved, y en pagos ya hay un cobro. Al retomarla, el orquestador
repite charge. No se cobra de nuevo porque el cobro lleva una clave de
idempotencia, derivada del id de la saga, que es el tema de la sección siguiente.
Fallas en cada paso
test/saga.test.ts inyecta una falla en
cada paso y revisa el estado final de los tres participantes, no solo el
del orquestador (saga/check.ts compara lo que dice cada uno). Los casos:
| Falla inyectada | Qué hace la saga | Estado final |
|---|---|---|
| La noche no está libre | Termina; no hay nada que compensar | cancelled, sin cobro ni comprobante |
| El pago se rechaza | Ejecuta release |
cancelled, noche libre, sin cobro ni comprobante |
Se pierde el pedido o la respuesta de hold, charge, issue o confirm, dos veces |
Reintenta el paso | completed, un cobro, un comprobante |
Se pierde la respuesta de release |
Reintenta la compensación | cancelled, noche libre |
| El orquestador muere después de cualquier paso, antes de anotarlo | Al arrancar, recover() repite el paso |
completed (o cancelled, si estaba compensando) |
issue sigue fallando después del cobro |
No compensa: queda en charged |
Se completa cuando el servicio vuelve |
El último caso es el punto de no retorno en acción. La saga queda detenida con la noche apartada y el cobro hecho, y eso es lo correcto: el huésped ya pagó, y lo que falta es entregarle su comprobante, no quitarle la noche.
Sin aislamiento: lo que se ve desde afuera
La consistencia que consigue una saga es al final. Mientras tanto, el estado intermedio lo ve todo el mundo. Una prueba lo muestra con dos huéspedes y una noche:
✔ sin aislamiento: otra saga ve la noche apartada y se cancela, aunque la primera termine cancelándose también (28.361833ms)Rosa aparta la noche y empieza a pagar. Juan llega, encuentra la noche apartada y su saga se cancela. Después el pago de Rosa se rechaza, y la noche vuelve a quedar libre. Estado final consistente, y ninguno de los dos se quedó con la noche. Con una transacción y un lock, Juan habría esperado y la habría conseguido.
Es el costo de no tener aislamiento, y se administra con decisiones de negocio: cuánto tiempo puede estar apartado un recurso antes de liberarlo solo, qué se le dice a quien llega mientras tanto (“alguien está comprando este asiento”), si se permite una lista de espera.
Coreografía y orquestación
Queda decidir quién conoce el flujo. Es la pareja broker y mediator de la semana 5, con otros nombres.
En una saga con orquestación, como la del ejemplo, un coordinador guarda el estado y envía comandos a los participantes. El flujo completo y su manejo de errores están escritos en un solo lugar, se puede leer y se puede probar. A cambio, el orquestador conoce a todos, es un componente más que tiene que estar arriba, y si se le deja crecer termina teniendo la lógica de todos.
En una saga con coreografía no hay coordinador: cada servicio publica un evento al terminar su transacción local, y el siguiente reacciona a ese evento. Inventario publica “noche apartada”, pagos lo escucha y cobra, publica “pago aprobado”, y así. Los servicios quedan menos acoplados y no hay un punto central. A cambio, el flujo no está escrito en ningún lado: para saber qué pasa cuando un pago se rechaza hay que leer el código de todos los que escuchan, y saber en qué va una compra exige juntar los eventos de varios servicios.
Para una saga corta, de dos o tres pasos y con pocas ramas, la coreografía alcanza. Cuando hay compensaciones, reintentos y un punto de no retorno, el flujo es lo bastante delicado como para querer leerlo en un solo archivo.
En Tinkuy. En P4, la compra pasa a ser una saga orquestada: reservar los asientos (compensable), cobrar (el punto de no retorno), y emitir las entradas y notificar (se reintentan). El cobro lleva una clave de idempotencia. El hospedaje de esta semana tiene la misma forma con otros nombres; lo que no está aquí, y es parte del trabajo, es decidir qué estados intermedios necesita una orden, qué ve el catálogo mientras un asiento está reservado y sin pagar, y cuánto tiempo puede quedar así.
Idempotencia
Repetir sin daño
Una operación es idempotente si aplicarla dos veces deja lo mismo que
aplicarla una. UPDATE … SET status = 'booked' lo es: la segunda vez no
cambia nada. UPDATE … SET places_left = places_left - 1 no lo es, ni
tampoco un cobro, ni enviar un correo.
Hemos llegado tres veces a la misma necesidad por caminos distintos. Un timeout obliga a reintentar sin saber si la primera vez se hizo. Un orquestador que se cae repite el último paso. Una transacción serializable que aborta se repite completa. En los tres casos, lo que se repite tiene que ser idempotente. Y en la semana 13 se suma un cuarto: un broker con entrega at-least-once entrega el mismo mensaje más de una vez.
Algunas operaciones son idempotentes por cómo están escritas, como el hold
de la saga, que acepta que la noche ya esté apartada por la misma saga. Para
las que no lo son por naturaleza, hay una técnica general.
La clave de idempotencia
Quien llama genera un identificador único por operación (no por intento)
y lo envía en cada reintento. Quien recibe guarda la clave junto con el
resultado y, cuando la clave se repite, devuelve el resultado guardado sin
ejecutar nada. Es lo que describe la lectura de Stripe, cuya API recibe la
clave en la cabecera Idempotency-Key; Joshi cataloga el mismo patrón como
Idempotent Receiver.
El servicio de cobros de la semana
(idempotency/charges.ts) lo
implementa con una tabla, idempotency_keys, cuya clave primaria es la clave
de idempotencia y que guarda además un hash del pedido, el código de estado y
el cuerpo de la respuesta. Y con una transacción que hace tres cosas:
await client.query('BEGIN');
// 1. Reclamar la clave. La clave primaria hace el trabajo: si otra
//    transacción está insertando la misma clave y todavía no confirma,
//    este INSERT espera a ver cómo termina.
const claimed = await client.query(
  `INSERT INTO idempotency_keys (key, request_hash, status_code, response)
   VALUES ($1, $2, 0, '{}') ON CONFLICT (key) DO NOTHING`,
  [key, hash],
);
if (claimed.rowCount === 0) {
  // 2a. La clave ya existía: no se cobra. Se devuelve lo que se respondió la primera vez.
  // … lee la fila, hace ROLLBACK y devuelve status_code y response …
}
// 2b. La clave es nueva: el efecto, y su respuesta junto a la clave.
const reply = await insertCharge(client, input);
await client.query('UPDATE idempotency_keys SET status_code = $2, response = $3 WHERE key = $1', [
  key,
  reply.status,
  JSON.stringify(reply.body),
]);
await hooks.beforeCommit?.();
await client.query('COMMIT');
Lo que hace que funcione es que la clave, el efecto y la respuesta se escriben en la misma transacción. O quedan las tres cosas o ninguna. Si se guardara la clave en una transacción y el cobro en otra, una caída entre las dos dejaría una clave “ya procesada” sin cobro (el reintento no cobraría nunca) o un cobro sin clave (el reintento cobraría otra vez): la escritura doble, de nuevo. La atomicidad de la primera sesión es la que sostiene la idempotencia de la segunda.
make lost-response lo muestra desde el cliente. El servicio cobra, corta la
conexión sin responder, y el cliente
(idempotency/retry-client.ts)
reintenta:
$ make lost-response
Sin clave de idempotencia:
  intento 1: sin respuesta (TypeError, UND_ERR_SOCKET)
  intento 2: respuesta 201
  el cliente recibe: {"chargeId":2,"status":"approved","amountCents":18000}
  cobros registrados en el servicio: 2
Con clave, pero el servicio la ignora:
  intento 1: sin respuesta (TypeError, UND_ERR_SOCKET)
  intento 2: respuesta 201
  el cliente recibe: {"chargeId":2,"status":"approved","amountCents":18000}
  cobros registrados en el servicio: 2
Con clave de idempotencia:
  intento 1: sin respuesta (TypeError, UND_ERR_SOCKET)
  intento 2: respuesta 201 (guardada)
  el cliente recibe: {"chargeId":1,"status":"approved","amountCents":18000}
  cobros registrados en el servicio: 1
En el primer caso el cliente recibe el cobro 2 y ni se entera de que existe el 1. En el tercero recibe el cobro 1: la misma respuesta que se perdió. El caso de en medio está para recordar que la idempotencia es un acuerdo entre dos partes: no sirve que el cliente envíe la clave si el servidor no la usa, ni que el servidor la soporte si el cliente genera una clave nueva en cada intento (hay una prueba de eso último, y termina con dos cobros).
Duplicados concurrentes
El reintento no siempre llega después de que el primer pedido terminó. Un
cliente impaciente, o un timeout corto, puede enviar el duplicado mientras el
original todavía se procesa. Si la implementación fuera “SELECT para ver si
la clave existe y, si no, cobrar e insertarla”, los dos pedidos verían que la
clave no existe y los dos cobrarían: es un comprobar y después actuar, el
mismo defecto de la primera sesión, ahora dentro del mecanismo que debía
protegernos.
Por eso el primer paso es un INSERT sobre la clave primaria y no un
SELECT. La prueba fija el orden con dos pedidos de la misma clave:
✔ duplicados concurrentes: el segundo espera a que el primero confirme y recibe su misma respuesta (34.776042ms)
✔ 20 pedidos simultáneos con la misma clave: un cobro y 20 respuestas iguales (29.820083ms)
✔ si la transacción del cobro falla, no queda ni el cobro ni la clave: el reintento cobra (27.667084ms)
El segundo pedido queda detenido en su INSERT hasta que el primero
confirma; entonces su INSERT no inserta nada, lee la respuesta guardada y la
devuelve. Si el primero aborta, el segundo inserta la clave y cobra él. Es la
solución 2 de la primera sesión (una escritura con condición, respaldada por
una restricción de unicidad) aplicada a otra tabla.
Lo que hay que decidir al usar claves
La tabla de claves es fácil de escribir. Las decisiones que la rodean son las que distinguen una implementación que sirve de una que falla en producción.
- Quién genera la clave y con qué alcance. La genera quien inicia la operación, una vez, y la conserva hasta saber cómo terminó. En la saga, la clave del cobro se deriva del id de la saga: así el orquestador puede repetir el paso después de una caída sin haber guardado nada más.
- La misma clave con otro pedido. Es un error de quien llama, y conviene rechazarlo en vez de devolver en silencio la respuesta de otro pedido. Por eso la tabla guarda un hash del pedido; el servicio de la semana responde 422.
- Qué respuestas se guardan. Las definitivas. Si el cobro falla por un
error técnico, la transacción hace
ROLLBACK, la clave no queda y el reintento vuelve a intentar de verdad. - Cuánto se conservan. No para siempre: la tabla crece con cada operación. Se borran las claves más antiguas que el tiempo máximo en que un cliente todavía podría reintentar.
- El efecto que sale de la base de datos. Cuando la operación llama a
otro sistema, la clave tiene que viajar también hacia allá. Si el servicio
de reservas muere después de cobrar y antes de su
COMMIT, su reintento vuelve a pedir el cobro, y solo la pasarela puede reconocer que ya lo hizo.
Trade-off. La clave de idempotencia convierte cualquier operación en segura de repetir, y cuesta una escritura más por operación, una tabla que hay que limpiar y un contrato con quien llama. La alternativa, cuando existe, es más barata: diseñar la operación para que sea idempotente por sí misma (fijar un estado en vez de sumar, insertar con una clave natural). Cuando el efecto es un cobro, no hay alternativa.
La escritura doble y la outbox
Queda un caso de “dos sistemas, ninguna transacción” que vieron de pasada en
la semana 5: después de confirmar una reserva hay que avisarle a otros
servicios, publicando un mensaje en el broker. Guardar en la base de datos y
publicar en el broker son dos operaciones sobre dos sistemas, y el proceso
puede morir entre las dos. Es el problema de la escritura doble, y tiene
la misma tabla de dos filas que el cobro
(errors/dual-write.ts):
✔ escritura doble, publicar y después confirmar: si el proceso muere en medio, se anunció una reserva que no existe (32.4545ms)
✔ escritura doble, confirmar y después publicar: si el proceso muere en medio, la reserva existe y nadie se entera (26.775959ms)
Si publica primero, anuncia algo que no pasó. Si confirma primero, puede no anunciarlo nunca: el huésped tiene su reserva y nadie le envía el correo, ni se actualiza el reporte.
Si el problema es que son dos sistemas, la solución es escribir en uno solo. El patrón outbox inserta el mensaje en una tabla de la misma base de datos, en la misma transacción que el cambio de estado:
CREATE TABLE outbox (
    id           bigint      PRIMARY KEY GENERATED ALWAYS AS IDENTITY,
    topic        text        NOT NULL,
    payload      jsonb       NOT NULL,
    created_at   timestamptz NOT NULL DEFAULT now(),
    published_at timestamptz
);
En outbox/book-with-outbox.ts,
la reserva y su mensaje van entre el mismo BEGIN y el mismo COMMIT:
const booking = await client.query<{ id: number }>(
  'INSERT INTO bookings (room_night_id, guest) VALUES ($1, $2) RETURNING id',
  [nightId, request.guest],
);
// …
const message: BookingConfirmed = { type: 'BookingConfirmed', bookingId, roomNightId: nightId, guest: request.guest };
await client.query('INSERT INTO outbox (topic, payload) VALUES ($1, $2)', ['bookings.confirmed', JSON.stringify(message)]);
Ya no hay hueco: o existen la reserva y su mensaje, o no existe ninguno. Las
pruebas matan el proceso antes del COMMIT y no encuentran ni lo uno ni lo
otro.
Lo que falta es que el mensaje llegue al broker. De eso se encarga un proceso
aparte, que lee las filas con published_at vacío, las publica y las marca
como enviadas. Ese proceso también puede morir entre publicar y marcar, y
cuando vuelva publicará otra vez el mismo mensaje. Richardson lo dice en la
descripción del patrón: quien publica puede hacerlo más de una vez, y por eso
el consumidor tiene que ser idempotente. La entrega es at-least-once.
La outbox, entonces, no elimina el problema de la escritura doble: lo mueve a un lugar donde repetir es seguro. Cambia “puede perderse o inventarse un mensaje” por “puede repetirse un mensaje”, y lo segundo se resuelve con lo que ya vimos: una clave que identifica el mensaje y un consumidor que la recuerda. Ese proceso que publica, el broker y los consumidores son la semana 13; aquí llegamos hasta la tabla.
Trade-off. Una saga cambia aislamiento por disponibilidad y autonomía: cada servicio confirma solo y sigue funcionando aunque otro esté caído, y a cambio aparecen estados intermedios, compensaciones, claves de idempotencia y una outbox. Es mucho mecanismo. Si un invariante de verdad exige atomicidad, la primera opción no es una saga mejor diseñada: es mantener esos datos en un mismo servicio y una misma base de datos, donde un
BEGINy unCOMMITlo resuelven.
Error común. Partir en dos servicios datos que cambian en la misma transacción, y después intentar recuperar la transacción con una saga. Si los asientos y las entradas siempre se escriben juntos, separarlos no desacopla nada: agrega una red en medio de una operación que era atómica. Los límites de un servicio se trazan alrededor de lo que tiene que cambiar junto, que era el criterio de la semana 5.
El código de la semana
Todo está en code/week-12/ y se usa dentro del contenedor.
make crea la base de datos arq_w12; make test revisa los tipos y corre
las pruebas, que usan su propia base de datos.
| Carpeta | Qué tiene |
|---|---|
db/ |
El esquema, los datos iniciales y la restricción UNIQUE de la solución 2 |
guion/ |
Diez guiones para dos sesiones de psql; make guion G=03 ejecuta uno |
harness/ |
sessions.ts: dos sesiones manejadas paso a paso desde una prueba; guion.ts: el que ejecuta los guiones |
booking/ |
La versión ingenua, las tres soluciones, el reintento y el servidor HTTP que las expone |
errors/ |
Tres errores a propósito: locks sin orden, cobro antes de escribir en una transacción que se reintenta, y la escritura doble |
idempotency/ |
El servicio de cobros con clave de idempotencia y el cliente que reintenta |
saga/ |
Los participantes, el orquestador y el comprobador de consistencia |
outbox/ |
La reserva con su mensaje en la misma transacción |
load/, tools/ |
El script de k6, la ráfaga de 200 pedidos y los scripts que comparan las estrategias |
lab/ |
El punto de partida del paso 8 del laboratorio, con sus pruebas |
Lo que vale la pena mirar con calma es cómo las pruebas fijan el orden de los
pasos. Un defecto de concurrencia que depende del azar da pruebas que a veces
pasan; aquí ninguna espera “un ratito” a que la otra sesión avance.
harness/sessions.ts abre dos conexiones y deja ejecutar una sentencia sin
esperar su resultado; para saber que quedó detenida, le pregunta a PostgreSQL
con pg_blocking_pids:
const pending = b.start(mark);
await b.waitsFor(a, pending); // B espera el lock de la fila, nada más
await a.run('COMMIT');
assert.deepEqual(await pending.result, { ok: true, rows: [], rowCount: 1 });
Y en las pruebas de las funciones de booking/, el cobro que reciben es el
punto de control: un cobro que no termina hasta que las dos transacciones
llegaron a él garantiza que las dos ya comprobaron.
$ make test
…
ℹ tests 107
ℹ suites 0
ℹ pass 107
ℹ fail 0
…
Laboratorio: no vender el mismo asiento dos veces, de tres maneras
El laboratorio se hace en parejas. Los pasos 1 a 7 trabajan sobre su copia
de Tinkuy, y usan code/week-12/ como referencia: cada técnica está aquí
sobre el hospedaje, y ustedes la llevan a los asientos. El paso 8 se hace en
code/week-12/lab/. Lo que cada paso muestra:
-
Ver el problema.
make oversellen Tinkuy sin modificar (omake tinkuy-overselldesde la carpeta de la semana). Anoten cuántas órdenes se aceptaron y cuántas entradas existen para el asiento. Es su línea de base: toda solución se compara contra esos dos números. -
Reproducirlo a mano. Dos terminales con
psql tinkuy. Sigan el guion 1 de la semana, pero sobre la tablaseats. Lo que hay que anotar es el orden exacto de los pasos que produce la doble venta, y cuál orden no la produce. Si no pueden decir en qué paso espera la segunda sesión, repitan. -
Lock explícito. El guion 2, sobre
seats: ¿qué hace la segunda sesión mientras la primera no confirma, y qué ve cuando continúa? Después llévenlo al código y corranmake oversell. Antes de darlo por bueno, busquen todos los lugares que leen asientos para decidir algo. -
Deadlock. Dos órdenes que piden los asientos A y B en orden inverso. Provóquenlo con el guion 3, lean el error completo (
\errverboseles da el código) y corríjanlo ordenando los ids antes de bloquear. La pregunta que importa: ¿su código de órdenes puede recibir los asientos en cualquier orden? -
Sin locks explícitos.
UPDATE … WHERE status = 'available'revisando el número de filas, más una restricciónUNIQUEsobre el asiento entickets. Corranmake oversell. Prueben también la restricción sola, con el código original: ¿cuántas entradas se emiten y cuántos cobros hace la pasarela? -
SERIALIZABLE. Corranmake overselly cuenten cuántas respuestas terminan en error; busquen el código40001en la salida del servidor. Agreguen el reintento y repitan. Para la pregunta de la latencia con 200 compradores y 10 asientos, tienenmake compare-burstcomo referencia de qué mirar: cuántas transacciones hicieron falta y cuántos cobros hubo. -
Medir las tres.
make load-salecon cada variante, partiendo siempre demake db, y llenen la tabla: órdenes exitosas, ventas dobles (deben ser cero), p95 y errores. Repitan cada medición. Si las tres salen parecidas, no es un error de medición: revisen cuánta contención tiene esa carga, con 2 000 asientos, y compárenla con la del paso 6. Después decidan cuál elegirían para la apertura de una venta y escriban por qué. -
Idempotencia.
make lab-lost-response: el cliente compra un cupo del tour, la primera respuesta se pierde y reintenta con la misma clave. Conlab/purchase-service.tscomo viene:$ make lab-lost-response intento 1: sin respuesta (TypeError, UND_ERR_SOCKET) intento 2: respuesta 201 el cliente recibe: {"purchaseId":2,"chargeId":2,"placesLeft":8} compras registradas: 2 cupos que quedan (había 10): 8 cobros en el servicio de cobros: 2Completen el servicio (la cabecera
Idempotency-Key, la tablapurchase_keyscon la clave y la respuesta, en la misma transacción que la compra) hasta que pasen las seis pruebas demake lab-test. Las dos primeras ya pasan. La última es la que más enseña: el servicio muere después de cobrar y antes de suCOMMIT.
Sobre el paso 7: el make load-sale del Tinkuy inicial abre una conexión por
pedido, y con 200 compradores PostgreSQL responde too many clients already.
Si su P2 ya tiene un pool, no lo verán; si lo ven, esos errores no dicen nada
sobre la estrategia de concurrencia.
Resumen
- Una transacción agrupa lecturas y escrituras en una unidad que ocurre o no ocurre. De ACID, la atomicidad y la durabilidad las da la base de datos; la consistencia depende del código y de las restricciones; y el aislamiento tiene niveles, que es donde se decide.
- Serializable es el ideal: el resultado equivale a ejecutar las transacciones una tras otra. Los niveles más débiles permiten anomalías a cambio de rendimiento. PostgreSQL usa read committed por omisión.
- Read committed no lee ni sobrescribe datos sin confirmar, pero cada sentencia ve un mundo distinto. Repeatable read, en PostgreSQL, es snapshot isolation: una foto por transacción, gracias a MVCC, donde leer y escribir no se detienen entre sí.
- Tres anomalías: la actualización perdida (dos escriben la misma fila a partir de una lectura vieja), el write skew (leen lo mismo y escriben filas distintas) y los fantasmas (la decisión dependía de que una fila no existiera). Snapshot isolation detecta la primera y no las otras dos.
- Un asiento se vende dos veces por un comprobar y después actuar. Se impide
con un lock explícito (
SELECT … FOR UPDATE, con los locks siempre en el mismo orden), con una escritura condicional respaldada por una restricciónUNIQUE, o con serializable y reintento. Las tres son correctas; se distinguen bajo contención, donde el optimista repite trabajo. - PostgreSQL detecta los deadlocks y aborta una transacción con
40P01; los conflictos de serialización terminan en40001. Los dos se reintentan, y lo que se reintenta no puede tener efectos externos que no sean idempotentes. - Una transacción abierta ocupa una conexión y conserva sus locks. No debe esperar a un sistema externo.
- Entre dos servicios no hay transacción. Two-phase commit da atomicidad a cambio de bloquear a los participantes mientras esperan al coordinador, y exige que todos hablen el protocolo.
- Una saga es una secuencia de transacciones locales con compensaciones: primero los pasos compensables, después el punto de no retorno, al final los que solo se reintentan. No tiene aislamiento: los estados intermedios se ven y se modelan.
- Como un timeout no dice si la operación se hizo, todo lo que se repite debe ser idempotente. La clave de idempotencia se guarda con la respuesta en la misma transacción que el efecto.
- La outbox reemplaza la escritura doble por una sola transacción local; el mensaje se publica después, at-least-once.
Ejercicios
- Dos transacciones en read committed ejecutan
SELECT places_lefty despuésUPDATE tours SET places_left = <valor leído> - 1. Escriban el orden de pasos que pierde una actualización y el que no. Después corrijan el defecto sin cambiar el nivel de aislamiento, de dos maneras distintas, y digan cuál elegirían si entre la lectura y la escritura hay un formulario que una persona tarda minutos en llenar. - En el guion 1, el
UPDATEde la sesión B espera a la sesión A y aun así se hacen dos reservas. En el guion 5 también espera, y se hace una sola. Expliquen la diferencia con el mecanismo exacto de read committed que interviene. Compruébenlo cambiando una sola sentencia del guion 1. - Un sistema de reservas de canchas deportivas guarda cada reserva como una
fila con cancha, hora de inicio y hora de fin, y antes de insertar comprueba
que no haya otra reserva que se cruce. Digan qué anomalía permite, por qué
SELECT … FOR UPDATEno la impide y por qué una restricciónUNIQUEsimple tampoco alcanza. Propongan dos soluciones y lo que cuesta cada una. - Den un ejemplo de write skew en Tinkuy o en otro sistema de venta de
entradas que no sea el de los asientos (piensen en un límite de entradas
por comprador). Escriban las dos transacciones y el orden de pasos, y
comprueben en
psqlque repeatable read lo permite. - La prueba versión ingenua con la restricción UNIQUE termina con una
reserva y dos cobros. Expliquen por qué la restricción no evita el segundo
cobro. ¿Qué cambiarían para que quien pierde no llegue a cobrar, sin usar
FOR UPDATE? - Modifiquen
booking/with-lock.tspara que bloquee las noches con una sentencia por noche, en el orden del pedido, y corranmake test. ¿Qué prueba falla y con qué error? ¿Cuánto tarda en fallar y por qué ese tiempo? - En
make compare-burst, serializable hace cerca de 300 transacciones para 200 pedidos. Antes de probarlo, predigan si eso cambia con una tabla diez veces más grande. Después levanten el servidor conNIGHTS=3000 STRATEGY=serializable make serve, corranmake bursten otra terminal y comparen el número de errores40001. Expliquen el resultado con lo que vieron en Serializable aborta de más (fíjense en cuáles son las 10 noches por las que se compite) y digan qué tendría que cambiar en la carga para que el número bajara. - En P2 dejaron el cobro dentro de la transacción. Describan qué ocupa cada compra mientras la pasarela responde, y qué le pasaría al catálogo si la pasarela tardara cinco segundos. Después propongan dónde pondrían el cobro y digan qué estado incorrecto nuevo se vuelve posible y cómo lo repararían.
- Ordenen los pasos de una saga de compra (cobrar, reservar los asientos, enviar el correo, emitir las entradas). Digan cuál es el punto de no retorno, qué compensación tiene cada paso anterior y por qué los posteriores no la necesitan. Después respondan: ¿qué cambia si el negocio decide que una entrada emitida se puede anular y devolver el dinero?
- En
saga/orchestrator.ts, sichargefalla por razones técnicas más veces queattemptsPerStep, la saga queda enreservedcon la noche apartada. Propongan qué hacer con una saga que lleva diez minutos así. Tengan en cuenta que no saben si el cobro se hizo. ¿Qué operación necesitarían que ofrezca el servicio de pagos? - Un servicio guarda la orden y luego publica
OrderPaid. Describan la falla que deja a los demás servicios sin enterarse. Rediseñen la operación con una outbox y digan qué garantía de entrega da el conjunto y qué exige de cada consumidor. ¿Por qué no alcanza con publicar primero y guardar después? - Un cliente móvil envía
POST /orderscon una clave de idempotencia. El servidor valida, reserva, cobra y responde. Enumeren todos los puntos donde la operación puede cortarse y, para cada uno, digan qué encuentra el reintento y qué debe responder el servidor. ¿En cuál de ellos no basta con la tabla de claves del servidor?