Apuntes · Capítulo 13Datos y sistemas distribuidos
Mensajería, eventos y consistencia
Mensajería, eventos y consistencia
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Por qué poner un broker en medio, todo; de Cola y log, La cola: el broker reparte y borra y El log: los mensajes se quedan; de Garantías de entrega, At-most-once y at-least-once y Cuándo confirma el consumidor; y de De la base de datos al stream: la outbox, La escritura doble, medida.
- En clase: Sesión A: Por qué poner un broker en medio, Cola y log, Garantías de entrega, El orden de los mensajes, De la base de datos al stream: la outbox y Consumidores que soportan la entrega repetida. Sesión B: Event sourcing, CQRS, Consistencia, Consenso y Diseñar con consistencia eventual. Laboratorio: Laboratorio: outbox y consumidor idempotente con NATS JetStream.
- Después de clase: el Resumen y los Ejercicios. Antes de P4 vale la pena releer Lo que el relay garantiza: duplicados y El id del evento, en la misma transacción que el efecto. Opcionales: El orden dentro de la outbox, Lo que el teorema CAP no dice y El código de la semana.
La semana pasada terminó con dos ideas que quedaron enunciadas y sin correr. La primera: guardar un cambio en la base de datos y publicar un mensaje son dos operaciones, y el proceso puede morir entre las dos; el patrón outbox lo resuelve guardando el mensaje en la misma transacción que el cambio. La segunda: como un timeout no dice si la operación se hizo, todo se reintenta, y por eso todo lo que recibe mensajes tiene que ser idempotente. Antes, en la semana 5, habíamos dejado una cuenta pendiente con cuatro partidas: un evento que no sale, un mensaje que llega dos veces, mensajes que llegan en otro orden y nadie que sepa si los efectos ya ocurrieron.
Esta semana pagamos esa cuenta. En la primera sesión estudiamos el componente que quedó en medio, el broker: qué modelos de mensajería existen (cola y log), qué garantiza cada uno sobre la entrega y el orden, y cómo se construye, con una outbox y consumidores idempotentes, un efecto que ocurre una sola vez sobre un canal que entrega al menos una vez. Todo se corre: van a matar procesos a la mitad y a contar lo que quedó.
En la segunda sesión subimos un nivel. Si los eventos se guardan para siempre, se puede dejar de guardar el estado y derivarlo de ellos (event sourcing), y se puede tener un modelo para escribir y otro para leer (CQRS). Las dos ideas tienen el mismo precio: lo que se lee va atrasado respecto de lo que se escribió. Eso nos lleva a la pregunta que cierra la parte de datos del curso: qué quiere decir que un sistema con varias copias sea consistente, cuánto cuesta la versión más fuerte (linealizabilidad), qué dice de verdad el teorema CAP y qué es el consenso, que es la pieza que hay detrás de elegir un líder y que ustedes van a usar sin implementarla nunca.
La advertencia de la semana 5 sigue vigente. En Tinkuy, un evento es un concierto o un partido. En este capítulo, un evento es un mensaje que dice que algo ya pasó. El ejemplo de la semana vende entradas para conciertos, y la palabra evento queda para los mensajes.
Lectura. Sesión A: Kleppmann y Riccomini, Designing Data-Intensive Applications (2.ª ed.), cap. 12 Stream Processing, las secciones sobre sistemas de mensajería y sobre logs particionados; Kreps, Narkhede y Rao, Kafka: a Distributed Messaging System for Log Processing (2011), secciones 1 a 3. Complementarias: documentación de NATS, JetStream y Consumers; Azure Architecture Center, Competing Consumers pattern. Sesión B: Designing Data-Intensive Applications (2.ª ed.), cap. 3, la sección Event Sourcing and CQRS, y cap. 10 Consistency and Consensus: Linearizability y la introducción de Consensus; Martin Kleppmann, Please stop calling databases CP or AP (2015). Complementarias: Martin Fowler, Event Sourcing y CQRS; Azure Architecture Center, Event Sourcing pattern y CQRS pattern; apuntes de Cambridge, secciones 6 y 7; el sitio de Raft, con su visualización. Para el laboratorio: Chris Richardson, Transactional outbox. El código de la semana está en code/week-13/, y los términos, en el glosario.
Por qué poner un broker en medio
Lo que el broker da
En una llamada síncrona, quien llama necesita tres cosas del otro lado: que esté arriba, que responda rápido y que responda ahora. Un broker de mensajes es un servicio que recibe mensajes de los productores, los guarda y los entrega a los consumidores. Ponerlo en medio quita las tres exigencias:
- El consumidor no necesita estar arriba. El productor entrega el mensaje al broker y sigue. Si el consumidor está caído o en medio de un deploy, el mensaje espera. Lo vieron en la semana 5: la compra respondía 201 con el consumidor de correo detenido, y los correos salían al reiniciarlo.
- El consumidor no necesita ser rápido. Si llegan mil compras en un segundo y el servidor de correo acepta veinte por segundo, la diferencia se acumula en el broker y se va procesando. El broker absorbe los picos: la carga que ve el consumidor es su propio ritmo, no el de las llegadas.
- Puede haber varios consumidores, y el productor no los conoce. Agregar un cuarto efecto a la compra es agregar un consumidor; el código que publica no cambia.
A esto se le llama desacoplar en el tiempo: productor y consumidor no tienen que coincidir.
Lo que el broker cuesta
Nada de eso es gratis, y las tres partidas del costo son de arquitectura:
- Es un componente más que operar y del que depender. Hay que monitorearlo, darle disco, actualizarlo y decidir qué pasa cuando no está. En la semana 5, con NATS caído, la compra esperaba cinco segundos y respondía con un error: el broker se había vuelto una dependencia síncrona de la compra. Hoy veremos cómo quitar esa dependencia.
- Quien publica deja de saber cuándo se procesó su mensaje, y si se procesó. Publicar con éxito quiere decir “el broker lo tiene”, no “el correo salió”. Para saber lo segundo hay que construir algo más: un evento de vuelta, una tabla de estado, una consulta que compare.
- La falla cambia de forma. Una llamada que falla, falla delante de quien llama. Un mensaje que no se puede procesar falla más tarde, en otro proceso, sin nadie esperando la respuesta. Si el diseño no dice adónde va ese mensaje, se pierde o se reintenta para siempre.
Trade-off. Un broker cambia disponibilidad y elasticidad del productor (ya no depende de sus consumidores) por consistencia inmediata y por simplicidad de operación. La alternativa, la llamada síncrona, da una respuesta definitiva en el momento y un solo lugar donde mirar cuando algo falla, y ata la disponibilidad de quien llama a la de todos los que llama. Cuando el efecto tiene que haber ocurrido antes de responderle al comprador (cobrar), la llamada es la opción natural; cuando puede ocurrir después (avisar, sumar puntos, actualizar un reporte), el mensaje.
Dos preguntas para cualquier sistema de mensajería
Hay decenas de sistemas de mensajería, y los nombres de sus características no coinciden entre uno y otro. Dos preguntas los ordenan a todos.
¿Qué pasa si el productor es más rápido que el consumidor? Solo hay tres respuestas: descartar mensajes, encolar (guardarlos y que esperen) o frenar al productor hasta que haya lugar, que es lo que se llama backpressure. Encolar parece la respuesta sin costo, y no lo es: una cola tiene un tamaño, y cuando se llena hay que elegir una de las otras dos.
make demo-limits lo muestra con un stream de JetStream al que le caben cinco
mensajes y al que le llegan ocho, con las dos políticas que el servidor ofrece
para cuando se llena:
$ make demo-limits
== max_msgs = 5, discard = old
mensaje 1: guardado con la secuencia 1
…
mensaje 8: guardado con la secuencia 8
stream: 5 mensajes, de la secuencia 4 a la 8
== max_msgs = 5, discard = new
mensaje 1: guardado con la secuencia 1
…
mensaje 5: guardado con la secuencia 5
mensaje 6: RECHAZADO (maximum messages exceeded)
…
stream: 5 mensajes, de la secuencia 1 a la 5
Con discard = old, el productor nunca se entera: los ocho mensajes se
aceptan y los tres más antiguos desaparecen. Con discard = new, el productor
recibe un error y tiene que decidir qué hacer: esperar y reintentar, o
rechazar a su vez a quien lo llamó. Lo primero sirve para datos donde lo nuevo
reemplaza a lo viejo (la última posición de un repartidor); lo segundo, para
datos que no se pueden perder (una orden pagada).
Error común. Una cola sin límite. No elimina la sobrecarga: la esconde. Si el productor es más rápido que el consumidor de manera sostenida, la cola crece hasta que se acaba la memoria o el disco, y mientras tanto la latencia de cada mensaje (el tiempo entre que se publica y que se procesa) crece sin tope: un correo de confirmación que llega cuatro horas después. El stream que crea
nats stream add … --defaultsdiceMaximum Messages: unlimited: es un valor por omisión cómodo para un laboratorio, y en producción el límite lo eligen ustedes o lo elige el disco. Todo stream lleva un límite, una política para cuando se llena y una alerta sobre cuántos mensajes esperan.
¿Qué pasa si un nodo cae? Si el broker guarda los mensajes solo en memoria, una caída los pierde. Si los escribe en disco, sobreviven a un reinicio del proceso; si además los replica en varios nodos, sobreviven a la pérdida de una máquina. Cada nivel cuesta latencia al publicar. Lo mismo vale para el consumidor: si cae a la mitad de un mensaje, ¿ese mensaje se pierde o vuelve? De eso tratan las garantías de entrega, más abajo.
Cola y log
Los brokers responden esas preguntas con dos modelos distintos. Conviene entender los dos en abstracto antes de ver cómo los ofrece el broker del curso.
La cola: el broker reparte y borra
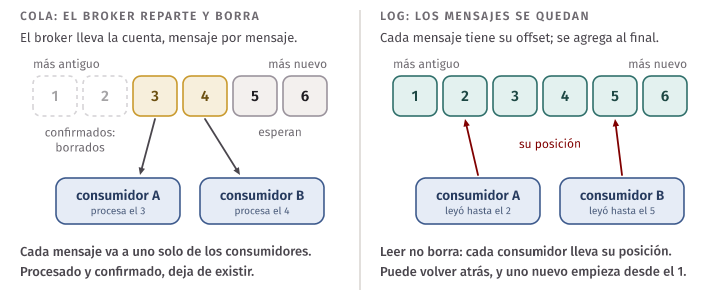
En el modelo de cola (el de AMQP y de los brokers tradicionales, como RabbitMQ), el broker lleva la cuenta de cada mensaje: lo asigna a un consumidor, espera su confirmación y, cuando la recibe, lo borra. Un mensaje procesado deja de existir.
Si varios consumidores leen de la misma cola, el broker reparte: cada mensaje va a uno solo. Es el patrón de consumidores que compiten (competing consumers), y es la manera de escalar un trabajo: si un consumidor genera 20 PDF por segundo y llegan 60, se ponen tres.
El precio está en el orden. Si un consumidor recibe un mensaje y no lo confirma (murió, o tardó demasiado), el broker lo entrega a otro. Para entonces, los mensajes que venían detrás ya se procesaron. Con varios consumidores ni siquiera hace falta una falla: el mensaje 1 va al consumidor A, el 2 al B, y B termina primero.
El log: los mensajes se quedan
En el modelo de log (el de Kafka), el broker hace mucho menos. Los mensajes se agregan al final de una secuencia que se conserva, cada uno con un número de posición, el offset. Leer no borra. Cada consumidor lleva su propia posición y avanza a su ritmo; el broker no sabe, ni le importa, quién leyó qué.
De esa decisión salen tres propiedades que una cola no tiene:
- Un consumidor nuevo puede empezar desde el principio y recibir todo lo que se publicó antes de que existiera.
- Un consumidor que falló, o que tenía un error, puede volver atrás y leer de nuevo.
- Varios sistemas distintos leen los mismos mensajes sin estorbarse, cada uno con su posición.
¿Y cómo se reparte el trabajo, si leer no borra? Partiendo el log. Un tema se divide en particiones; cada mensaje va a una partición según una clave (por ejemplo, el id de la orden), y dentro de una partición el orden está garantizado. Los consumidores se agrupan en un consumer group, y cada partición la lee un solo consumidor del grupo. Así, todos los mensajes de una misma orden van a la misma partición y los procesa, en orden, el mismo consumidor; el paralelismo está entre particiones.
En la industria. El artículo que presentó Kafka, escrito en LinkedIn en 2011, explica estas decisiones una por una. En Kafka, cuánto ha consumido cada consumidor no lo guarda el broker sino el consumidor; como el broker no sabe quién leyó qué, no puede borrar “lo ya leído”, y borra por antigüedad (el artículo habla de siete días como valor típico). Los autores señalan el beneficio lateral: un consumidor puede retroceder a propósito a un offset anterior y volver a consumir, algo que, dicen, viola el contrato habitual de una cola y resulta esencial para muchos consumidores. Sobre la entrega: Kafka garantiza at-least-once, y si a una aplicación le importan los duplicados debe agregar su propia lógica para descartarlos. Sobre el orden: se garantiza dentro de una partición, no entre particiones. Kreps, Narkhede y Rao, Kafka: a Distributed Messaging System for Log Processing, secciones 3.1 a 3.3.
Cuál se elige
| Cola | Log | |
|---|---|---|
| El mensaje, después de procesado | se borra | se conserva (por tiempo o por tamaño) |
| Quién lleva la cuenta de lo leído | el broker, mensaje por mensaje | cada consumidor, con una posición |
| Repartir trabajo entre procesos | natural: se agregan consumidores | por particiones: tantos procesos útiles como particiones |
| Orden | se pierde con varios consumidores o con reintentos | garantizado dentro de una partición |
| Un consumidor nuevo | solo ve lo que llegue desde ahora | puede leer desde el principio |
| Reprocesar | no se puede: el mensaje ya no está | se puede: se vuelve atrás |
La elección sale del caso, no del gusto:
- Cola para tareas independientes y caras, donde importa repartir y no el orden: enviar correos, generar el PDF de una entrada, redimensionar una imagen. Cada mensaje es un trabajo; una vez hecho, no interesa más.
- Log cuando importa el orden por clave (los eventos de una misma orden), cuando varios sistemas necesitan los mismos eventos (notificaciones, reportes, puntos), o cuando hay que poder reprocesar (un consumidor nuevo que debe ponerse al día, una vista que hay que recalcular).
Idea clave. En una cola, el mensaje es una tarea: se hace y desaparece. En un log, el mensaje es un hecho: queda registrado y cada quien lo lee cuando quiere. La pregunta que decide es qué pasa con el mensaje después de procesarlo: si no le sirve a nadie más, cola; si es parte de la historia, log.
NATS JetStream: un log que también sabe ser cola
El broker del curso es NATS, con su capa de persistencia, JetStream. Sus piezas ya aparecieron en la semana 5; aquí las miramos con más cuidado, porque según cómo se configuren dan uno u otro modelo.
- Un stream guarda los mensajes publicados en un conjunto de subjects, en orden, cada uno con un número de secuencia. Es el log.
- Un consumer es la posición de un lector sobre ese stream, guardada en el servidor: qué entregó y qué le confirmaron. En esto JetStream se aparta de Kafka, donde la posición la guarda quien lee.
Es el paso 1 del laboratorio. Se crea el stream W13_ORDERS para todo lo que
se publique en w13.orders.> (el > es un comodín: cualquier cosa que siga)
y se publican tres mensajes:
$ nats stream add W13_ORDERS --subjects 'w13.orders.>' --defaults
Stream W13_ORDERS was created
…
                    Retention: Limits
              Acknowledgments: true
               Discard Policy: Old
             Duplicate Window: 2m0s
…
             Maximum Messages: unlimited
…
$ nats pub w13.orders.paid '{"orderId": 1}'
06:47:29 Published 14 bytes to "w13.orders.paid"
$ nats pub w13.orders.paid '{"orderId": 2}'
$ nats pub w13.orders.paid '{"orderId": 3}'
…
$ nats stream info W13_ORDERS
…
                     Messages: 3
                        Bytes: 177 B
               First Sequence: 1 @ 2026-11-16 06:47:29
                Last Sequence: 3 @ 2026-11-16 06:47:29
             Active Consumers: 0
           Number of Subjects: 1
Tres mensajes guardados, con las secuencias 1 a 3, y ningún consumer: nadie
los ha leído y ahí siguen. Retention: Limits quiere decir que los mensajes
solo se borran al llegar a un límite (de cantidad, de tamaño o de antigüedad),
no al leerlos. Ahora un consumer, y dos lecturas: la primera confirma el
mensaje; la segunda, con --no-ack, lo recibe y no lo confirma.
$ nats consumer add W13_ORDERS first --pull --deliver all --ack explicit --defaults
…
$ nats consumer next W13_ORDERS first
[06:47:29] subj: w13.orders.paid / tries: 1 / cons seq: 1 / str seq: 1 / pending: 2

{"orderId": 1}

Acknowledged message

$ nats consumer next W13_ORDERS first --no-ack
[06:47:29] subj: w13.orders.paid / tries: 1 / cons seq: 2 / str seq: 2 / pending: 1

{"orderId": 2}
$ nats consumer info W13_ORDERS first
…
  Last Delivered Message: Consumer sequence: 2 Stream sequence: 2 Last delivery: 30ms ago
    Acknowledgment Floor: Consumer sequence: 1 Stream sequence: 1 Last Ack: 68ms ago
        Outstanding Acks: 1 out of maximum 1,000
    Redelivered Messages: 0
    Unprocessed Messages: 1
…
Esas cuatro líneas del estado son todo lo que hay que saber leer de un consumer:
| Línea | Qué dice | Aquí |
|---|---|---|
Last Delivered Message |
hasta qué secuencia del stream entregó | la 2 |
Acknowledgment Floor |
hasta qué secuencia está todo confirmado, sin huecos | la 1 |
Outstanding Acks |
mensajes entregados que nadie confirmó todavía | 1 (el mensaje 2) |
Unprocessed Messages |
mensajes del stream que todavía no entregó | 1 (el mensaje 3) |
El mensaje 2 está en el estado que importa esta semana: entregado y sin
confirmar. Si nadie lo confirma en 30 segundos (Ack Wait), el servidor lo
entrega otra vez.
Como log. Paso 2 del laboratorio. Con seis mensajes en el stream, dos
procesos leen, cada uno con su propio consumer (reader-a y reader-b). El
programa tools/worker.ts lee con el consumer que le indiquen y dice qué
recibió:
$ make worker C=reader-a
[proceso 1822, consumer reader-a] seq 1 (entrega 1): recibí la orden 1
…
[proceso 1822, consumer reader-a] seq 6 (entrega 1): recibí la orden 6
$ make worker C=reader-b
[proceso 1832, consumer reader-b] seq 1 (entrega 1): recibí la orden 1
…
[proceso 1832, consumer reader-b] seq 6 (entrega 1): recibí la orden 6(make worker se detiene con Ctrl+C; se muestran las líneas de recepción.)
reader-b empezó cuando reader-a ya había leído y confirmado
los seis, y los recibió todos igual: leer no borra, y cada consumer es una
posición independiente. Es el comportamiento de un log, y es lo que usó la
semana 5 para que correo, reporte y puntos recibieran cada uno todas las
órdenes.
Como cola. Ahora dos procesos que usan el mismo consumer, shared, en
dos terminales, cada uno con WORK_MS=200 make worker C=shared (las tres
primeras líneas son de una terminal y las otras tres de la otra):
[proceso 1847, consumer shared] seq 1 (entrega 1): recibí la orden 1
[proceso 1847, consumer shared] seq 3 (entrega 1): recibí la orden 3
[proceso 1847, consumer shared] seq 5 (entrega 1): recibí la orden 5
[proceso 1846, consumer shared] seq 2 (entrega 1): recibí la orden 2
[proceso 1846, consumer shared] seq 4 (entrega 1): recibí la orden 4
[proceso 1846, consumer shared] seq 6 (entrega 1): recibí la orden 6
Se los repartieron: cada mensaje fue a uno solo de los dos. Para el servidor
hay una sola posición, la de shared, y dos procesos que le piden mensajes;
le da el siguiente a quien pida. Son consumidores que compiten. Mientras trabajan,
nats consumer info W13_ORDERS shared muestra Outstanding Acks: 2: dos
mensajes entregados y sin confirmar, uno en manos de cada proceso.
Entonces, en JetStream, log o cola no lo decide el stream sino cómo se
lee: un consumer por cada sistema que necesita todos los mensajes, y varios
procesos sobre un mismo consumer cuando hay que repartir el trabajo de ese
sistema. Las dos cosas se combinan: el consumer points puede tener tres
procesos, y el consumer report, uno.
Si además se quiere el otro rasgo de la cola, que el mensaje procesado
desaparezca, el stream se crea con retención por trabajo
(--retention work). Entonces el mensaje confirmado se borra, y el servidor
no admite un segundo consumer sobre los mismos mensajes:
$ nats stream add W13_JOBS --subjects 'w13.jobs.>' --retention work --defaults
…
$ nats pub w13.jobs.pdf 'ticket {{Count}}' --count 3
…
$ nats consumer add W13_JOBS workers --pull --deliver all --ack explicit --defaults
…
$ nats consumer next W13_JOBS workers
[06:47:41] subj: w13.jobs.pdf / tries: 1 / cons seq: 1 / str seq: 1 / pending: 2
…
$ nats stream info W13_JOBS
…
                     Messages: 2
               First Sequence: 2 @ 2026-11-16 06:47:41
                Last Sequence: 3 @ 2026-11-16 06:47:41
$ nats consumer add W13_JOBS others --pull --deliver all --ack explicit --defaults
nats: error: Consumer creation failed: multiple non-filtered consumers not allowed on workqueue stream (10099)
Trade-off. Un stream con retención por límites y varios consumers conserva todo, permite reprocesar y sumar consumidores nuevos, y gasta disco en mensajes que quizá nadie vuelva a leer. Un stream de trabajo ocupa solo lo pendiente y hace imposible que dos sistemas procesen lo mismo por error, y renuncia a la historia: lo confirmado no se puede volver a leer. Para los eventos de órdenes de la semana usamos el primero, porque tres sistemas los necesitan y porque al final vamos a reconstruir una tabla con ellos. Las pruebas de
test/jetstream.test.tscomprueban cada afirmación de esta sección contra el servidor.
Garantías de entrega
At-most-once y at-least-once
Entre el productor, el broker y el consumidor hay red, y los procesos mueren. Un mensaje puede perderse en cualquier tramo, y lo mismo la confirmación que viaja de vuelta. Frente a eso hay dos políticas:
- At-most-once (a lo más una vez): se envía y no se reintenta. Cada mensaje llega una vez o ninguna. Es barato y no produce duplicados; sirve cuando perder uno no importa (una métrica que se vuelve a medir en diez segundos).
- At-least-once (al menos una vez): se reintenta hasta recibir la confirmación. Ningún mensaje se pierde, y algunos llegan más de una vez.
¿Por qué at-least-once produce duplicados aunque nada “falle”? Porque quien envía no distingue dos situaciones: el mensaje no llegó, o llegó y lo que se perdió fue la confirmación. En las dos ve lo mismo, silencio, y en las dos reintenta. En la segunda, el receptor recibe el mensaje otra vez. Es el mismo razonamiento del timeout de la semana 12: no se puede saber; solo se puede diseñar para que repetir sea seguro.
Cuándo confirma el consumidor
Del lado del consumidor, la política se elige con una sola decisión: en qué
momento confirma. make demo-ack lo muestra con cinco mensajes y un proceso
que muere (con SIGKILL, sin oportunidad de limpiar nada) mientras procesa el
tercero. Después arranca otro proceso con el mismo consumer. Primero,
confirmando antes de procesar:
$ make demo-ack

== Confirmar ANTES de procesar (ACK_FIRST=1)
-- primer proceso (muere mientras procesa la secuencia 3)
[proceso 678, consumer ack-first] seq 1 (entrega 1): recibí la orden 1
…
[proceso 678, consumer ack-first] seq 2: orden 2 procesada
[proceso 678, consumer ack-first] seq 3 (entrega 1): recibí la orden 3
-- segundo proceso, con el mismo consumer
[proceso 686, consumer ack-first] seq 4 (entrega 1): recibí la orden 4
[proceso 686, consumer ack-first] seq 4: orden 4 procesada
[proceso 686, consumer ack-first] seq 5 (entrega 1): recibí la orden 5
[proceso 686, consumer ack-first] seq 5: orden 5 procesada
-- procesados: 1 2 4 5; perdidos: 3
El mensaje 3 se confirmó, el proceso murió antes de terminar el trabajo, y para el servidor ese mensaje está cerrado. El segundo proceso sigue con el 4. La orden 3 se quedó sin su efecto y ningún componente lo sabe. Es at-most-once. Ahora confirmando después:
== Confirmar DESPUÉS de procesar
-- primer proceso (muere mientras procesa la secuencia 3)
…
[proceso 694, consumer ack-last] seq 3 (entrega 1): recibí la orden 3
-- segundo proceso, con el mismo consumer
[proceso 702, consumer ack-last] seq 4 (entrega 1): recibí la orden 4
…
[proceso 702, consumer ack-last] seq 5: orden 5 procesada
[proceso 702, consumer ack-last] seq 3 (entrega 2): recibí la orden 3
[proceso 702, consumer ack-last] seq 3: orden 3 procesada
-- procesados: 1 2 3 4 5; perdidos: ninguno
El mensaje 3 quedó entregado y sin confirmar. Cuando venció el plazo de
confirmación (ack_wait, un segundo en esta demostración), el servidor lo
entregó de nuevo: entrega 2. No se perdió nada. Fíjense en tres detalles
de esta salida, porque cada uno reaparece más abajo:
- El segundo proceso retomó donde el consumer se había quedado, no desde el principio: los mensajes 1 y 2, ya confirmados, no volvieron.
- El mensaje 3 llegó después del 4 y del 5. La reentrega rompió el orden.
- En este experimento el primer proceso murió antes de hacer el trabajo. Si hubiera muerto después de hacerlo y antes de confirmar, el segundo proceso lo habría hecho otra vez. El servidor no puede distinguir los dos casos: en ambos, lo único que ve es que la confirmación no llegó.
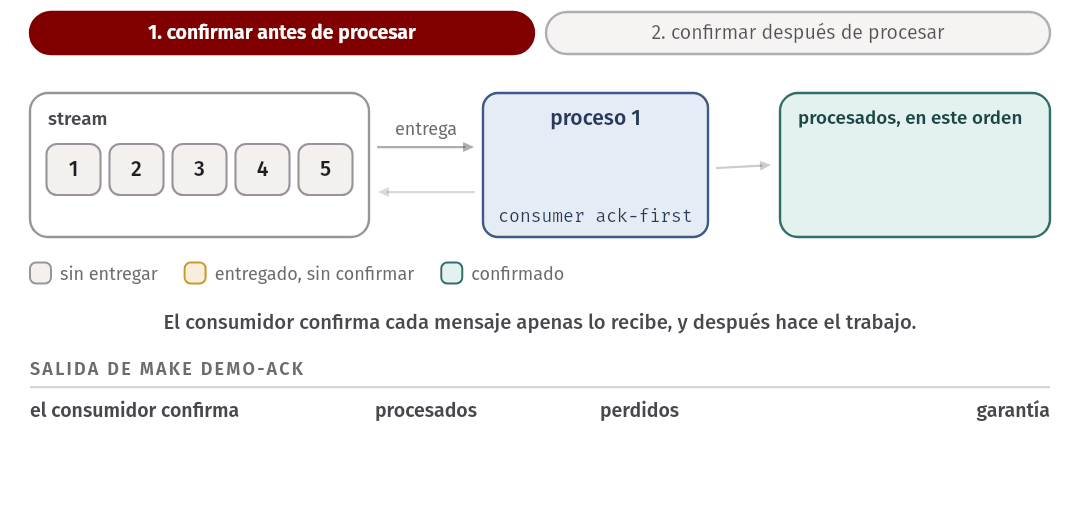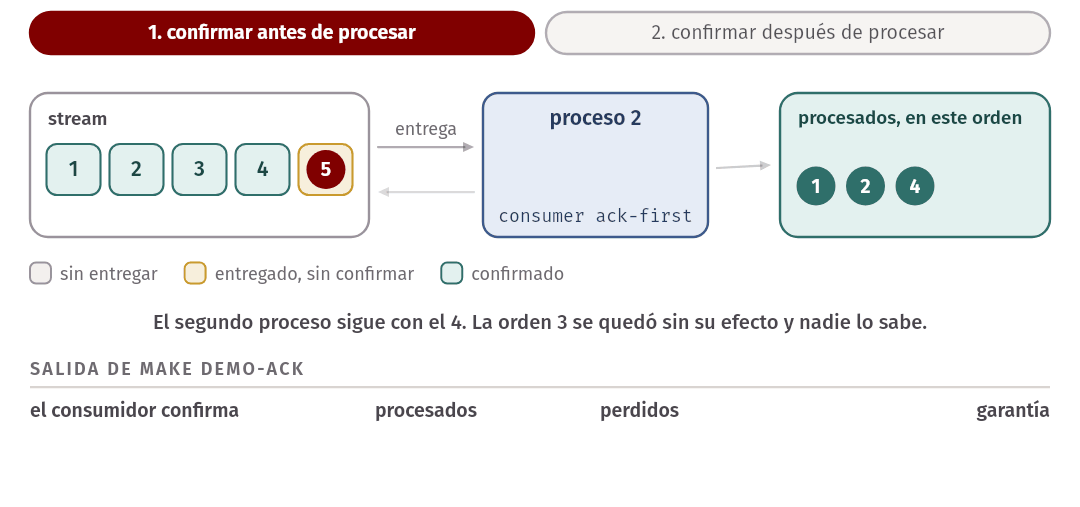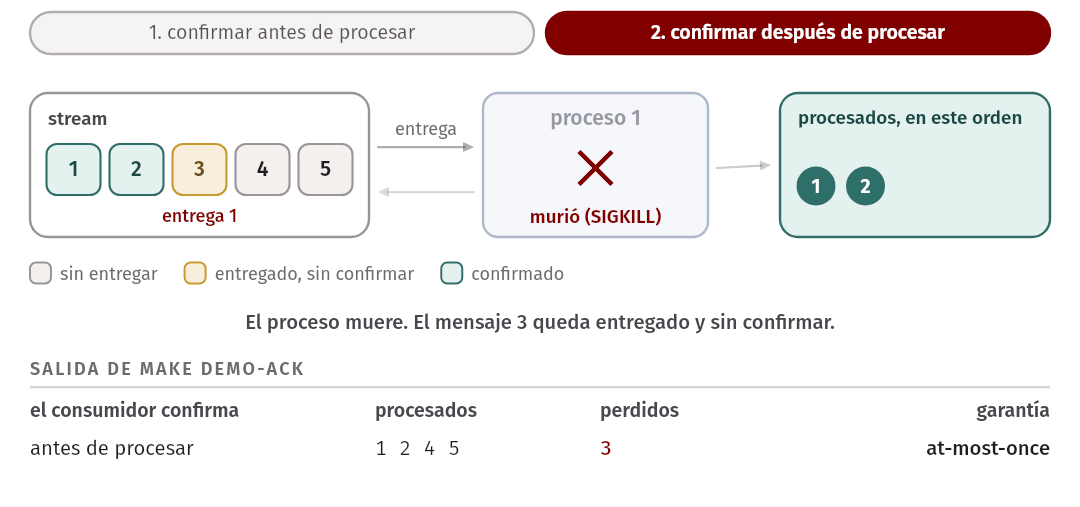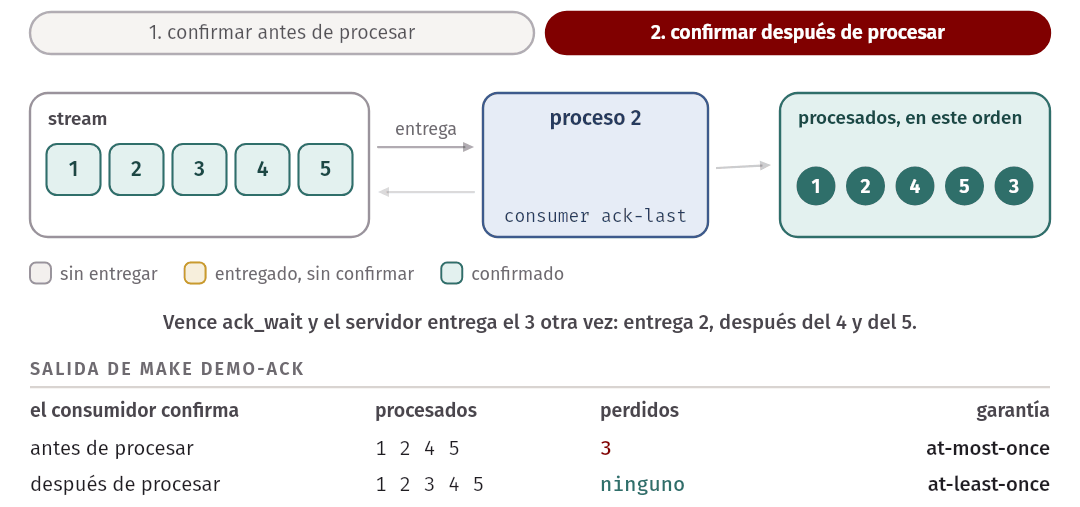
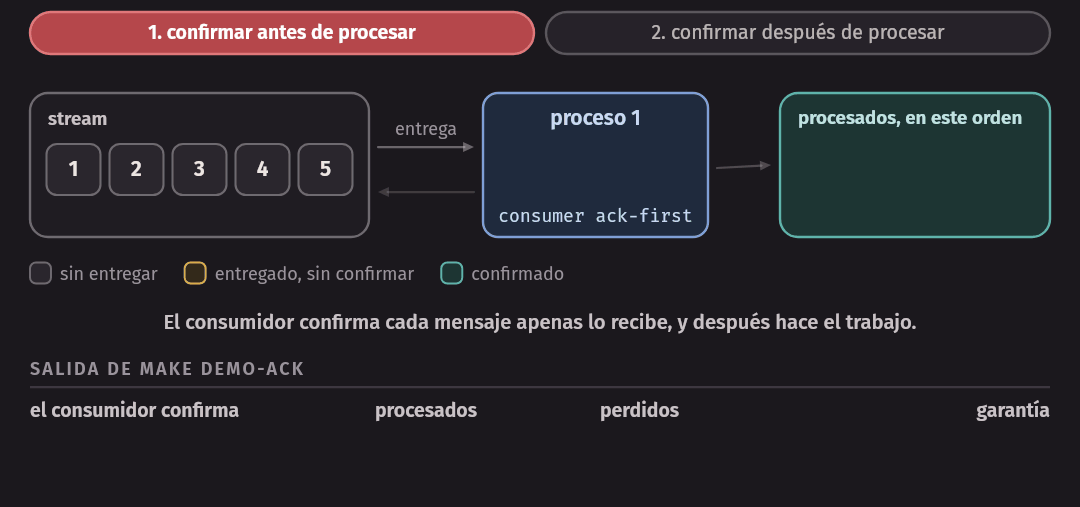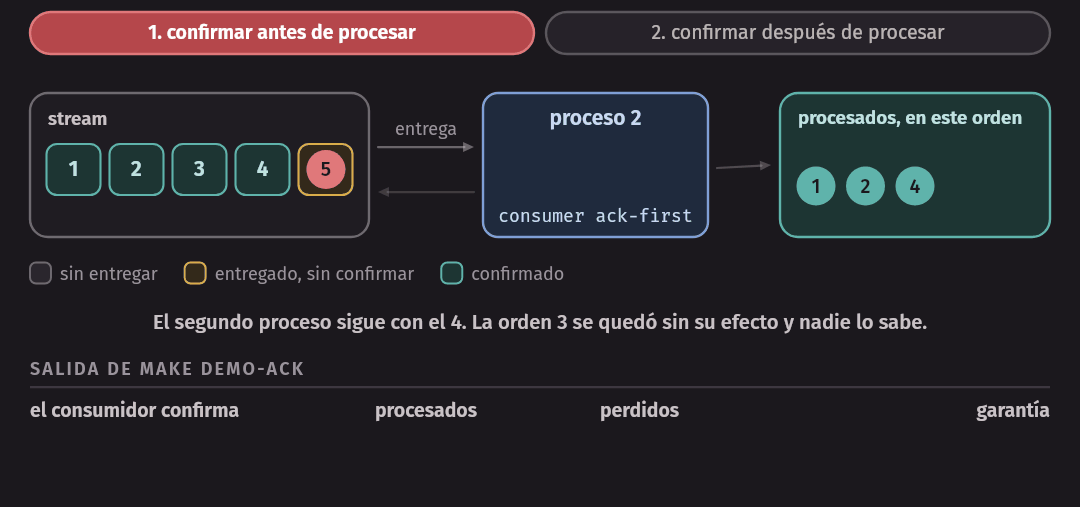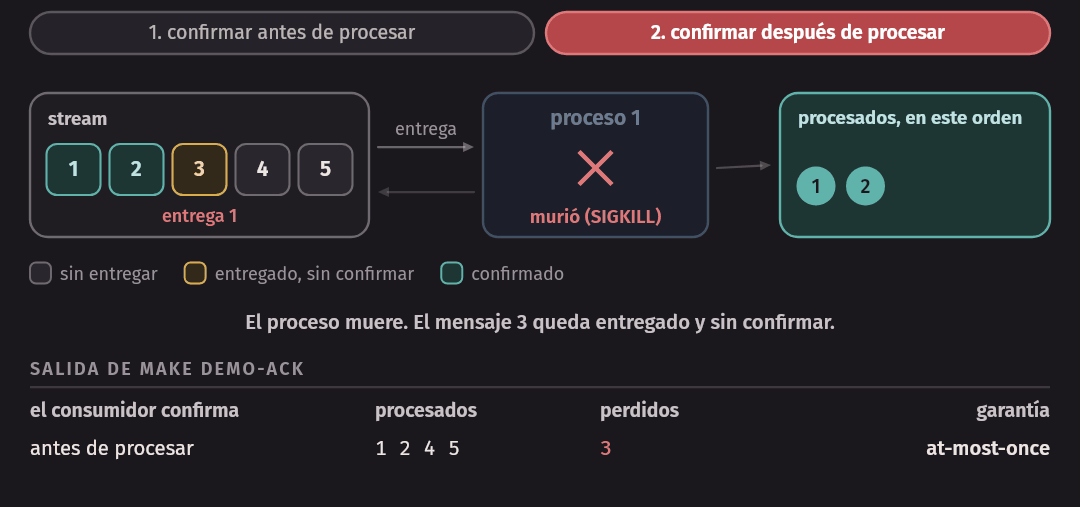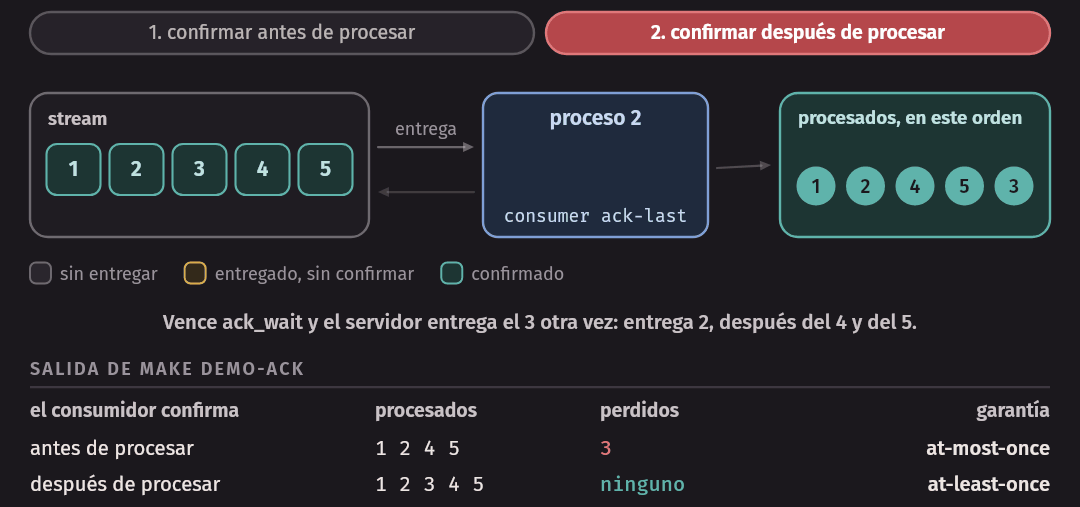
Idea clave. Confirmar antes de procesar es at-most-once: si el proceso muere, el trabajo se pierde. Confirmar después es at-least-once: si el proceso muere, el trabajo se repite. Para no perder trabajo se confirma después, y por eso el procesamiento tiene que soportar la repetición.
Exactly-once es un efecto, no una entrega
Lo que uno quisiera es exactly-once: que cada mensaje se procese exactamente una vez. Como garantía de entrega, entre dos procesos que pueden fallar, no existe: el párrafo anterior muestra por qué. Lo que sí se puede construir es que el efecto ocurra una sola vez:
La entrega at-least-once garantiza que el efecto ocurra por lo menos una vez; la idempotencia (semana 12) garantiza que aplicar el mismo mensaje dos veces deje lo mismo que aplicarlo una.
El broker no puede dar esto por sí solo, por una razón de fondo: no controla el efecto del consumidor. El efecto ocurre en otro sistema (una fila en PostgreSQL, un correo que sale, un cobro en la pasarela), y el broker solo se entera de él por la confirmación, que puede perderse. Para que el efecto y la confirmación fueran una sola operación atómica haría falta una transacción que cubriera al broker y al otro sistema: el two-phase commit de la semana pasada, con todos sus costos. La idempotencia consigue el mismo resultado sin esa transacción.
Cuando un broker anuncia “exactly-once”, hay que leer la letra pequeña: suele referirse a un tramo (por ejemplo, descartar publicaciones repetidas del productor, que veremos en JetStream) o a efectos que quedan dentro del propio broker. Para un efecto en un sistema externo, la responsabilidad es del consumidor.
Error común. Suponer que los mensajes llegan una vez y en orden porque en las pruebas siempre fue así. En las pruebas nada falla: ningún proceso muere entre el efecto y la confirmación, ninguna confirmación se pierde, ningún consumidor tarda más que
ack_wait. Un duplicado en producción no es un caso raro que se pueda ignorar: es el funcionamiento normal de la entrega at-least-once cuando algo se reinicia, y en producción siempre hay algo reiniciándose (cada deploy lo hace). Por eso las pruebas de esta semana matan procesos y publican duplicados a propósito.
El orden de los mensajes
Dónde hay orden y dónde se pierde
El stream guarda los mensajes en un orden total: las secuencias 1, 2, 3… Lo
que no está garantizado es que se procesen en ese orden. make demo-order
publica ocho mensajes y los lee de cuatro maneras. Los mensajes impares tardan
60 ms en procesarse y los pares 5 ms, porque en la realidad no todos los
trabajos duran lo mismo:
$ make demo-order
1. Un lector
    orden en que terminaron: 1 2 3 4 5 6 7 8
2. Tres lectores del mismo consumer
    orden en que terminaron: 2 4 1 6 3 8 5 7
3. Un lector; la secuencia 3 falla una vez y se reintenta a los 300 ms
    orden en que terminaron: 1 2 4 5 6 7 8 3(entrega 2)
4. Lo mismo, con max_ack_pending = 1 (el servidor no entrega el siguiente sin confirmar el anterior)
orden en que terminaron: 1 2 3(entrega 2) 4 5 6 7 8- Un lector, sin fallas (1): se procesa en el orden del stream.
- Tres lectores (2): cada uno recibe un mensaje distinto y termina cuando termina. El 2 acabó antes que el 1. Repartir el trabajo y conservar el orden son objetivos opuestos.
- Un lector y un reintento (3): el mensaje 3 falló, se devolvió y volvió 300 ms después, cuando los demás ya estaban procesados. Un mensaje antiguo llegó después de los nuevos, con un solo consumidor.
- Orden estricto (4): con
max_ack_pending = 1el servidor no entrega el mensaje siguiente mientras haya uno sin confirmar. El orden se conserva, y el precio se ve en la misma línea: los mensajes 4 a 8 esperaron al reintento del 3. Si el 3 no se pudiera procesar nunca, no pasaría ninguno.
Resumido: el orden está garantizado solo donde hay un único consumidor
activo y nada se adelanta a un reintento. En un log particionado, eso es una
partición; en JetStream, un consumer con un solo lector y
max_ack_pending = 1. Fuera de esas condiciones, los mensajes pueden
procesarse en otro orden.
Trade-off. Orden estricto contra throughput y contra disponibilidad. Con orden estricto, el ritmo es el de un solo consumidor y un mensaje que falla detiene a todos los que vienen detrás (se le llama bloqueo de cabeza de línea). Sin él, el trabajo se reparte y una falla no detiene a los demás, y el consumidor tiene que soportar el desorden. Los logs particionados buscan un punto medio: orden estricto dentro de cada clave, paralelismo entre claves.
Diseñar para el desorden
Como el orden global es caro, se diseña para necesitarlo lo menos posible. Hay tres técnicas, de la más barata a la más cara.
1. Efectos que dan lo mismo en cualquier orden. Sumar 10 puntos por cada orden es conmutativo: el saldo final no depende de qué orden se procesó primero. Un contador, un conjunto al que se agregan elementos, un máximo. Si el efecto se puede escribir así, el orden deja de importar. El reporte de ventas de la semana es de este tipo.
2. Números de versión. Cuando el efecto no es conmutativo, el evento lleva
un número que dice a qué versión de la entidad corresponde, y el consumidor
ignora lo que sea más antiguo que lo que ya tiene. El ejemplo de
ordering/order-status.ts es una
vista con el estado de cada orden. La orden 7 se pagó (versión 1) y después se
devolvió (versión 2). La manera ingenua, “el último que llega gana”, guarda
lo que trae cada evento a medida que llega. Si OrderRefunded llega primero
y OrderPaid después (porque OrderPaid falló una vez y se reintentó), la
vista dice que una orden devuelta está pagada. Con versión:
export function applyIfNewer(view: StatusView, event: StatusEvent): void {
  const current = view.get(event.orderId);
  if (current && current.version >= event.version) return;
  view.set(event.orderId, { status: statusOf(event), version: event.version });
}
La comparación con >= hace dos trabajos: descarta el evento antiguo que
llega tarde y descarta el repetido. Las pruebas de
ordering/order-status.test.ts
recorren varias llegadas (en orden, al revés, con el reintento de un mensaje
antiguo, con todo repetido) y el resultado es siempre refunded. La versión
la pone quien produce el evento, que es quien conoce el orden real: un
contador por entidad que se incrementa en la misma transacción que el cambio.
Una marca de tiempo no sirve igual de bien: dos relojes de dos máquinas no
están de acuerdo.
Esta técnica alcanza cuando cada evento trae el estado completo que importa. Si el consumidor necesita haber visto el evento 1 para entender el 2, ignorar no basta: hay que guardar el 2 y esperar al 1, y eso ya es reconstruir el orden a mano.
3. Clave de partición por entidad. Si de verdad hace falta el orden, se pide solo dentro de una entidad: todos los eventos de la orden 7 van a la misma partición (o al mismo consumer con un solo lector), y los de órdenes distintas se procesan en paralelo. Es lo más caro de las tres: limita el paralelismo, y un mensaje que no se puede procesar bloquea a todos los de su partición.
De la base de datos al stream: la outbox
Hasta aquí supusimos que el evento llega al stream. Ese es el primer eslabón de la cadena, y es el que la semana 5 dejó roto.
La escritura doble, medida
La aplicación de la semana es pequeña: un servicio de órdenes que vende
entradas para tres conciertos y que, por cada orden pagada, debe publicar un
evento OrderPaid. La versión directa está en
errors/dual-write.ts:
/** Primero COMMIT, después publicar. Si muere en medio: orden sin evento. */
async function commitThenPublish(input: OrderInput): Promise<PaidOrder> {
  const order = await inTransaction((client) => insertPaidOrder(client, input));
  crashPoint('CRASH_BETWEEN');
  await publish(settings.subjects.paid, newOrderPaid(order));
  return order;
}
Son dos escrituras en dos sistemas, PostgreSQL y NATS, y ninguna transacción
cubre a las dos: es el problema de la escritura doble (dual write).
crashPoint es el instrumento de la semana: si la variable de entorno está
definida, el proceso se mata a sí mismo con SIGKILL en ese punto. No corre
ningún finally ni se cierra ninguna conexión con cuidado: es lo más parecido
a que se vaya la luz.
Paso 3 del laboratorio: cien compras, cada una en su propio proceso, y todas mueren entre las dos operaciones.
$ CRASH_BETWEEN=1 make dual-write N=100
100 compras (dual-write): 0 procesos terminaron bien, 100 murieron a la mitad
$ make counts
órdenes guardadas                   100
filas en la outbox                    0
  pendientes de publicar              0
mensajes en el stream                 0
  eventos distintos                   0
órdenes sin evento                  100
eventos de órdenes que no existen     0
Cien órdenes pagadas, cero eventos. Cien compradores sin correo, sin puntos y
fuera del reporte, y nada en el sistema que lo sepa. Que el proceso muera
siempre es exagerado; lo realista es que muera a veces. Con CRASH_BETWEEN=0.5
muere, al azar, la mitad de las veces:
$ CRASH_BETWEEN=0.5 make dual-write N=100
100 compras (dual-write): 53 procesos terminaron bien, 47 murieron a la mitad
$ make counts
órdenes guardadas                   100
…
mensajes en el stream                53
  eventos distintos                  53
órdenes sin evento                   47
eventos de órdenes que no existen     0
Las dos cuentas no coinciden y la diferencia es exactamente el número de procesos que murieron. En producción la proporción es mucho menor, y eso lo hace peor, no mejor: una orden sin evento cada cien mil no se nota en ninguna prueba y aparece meses después como un reclamo.
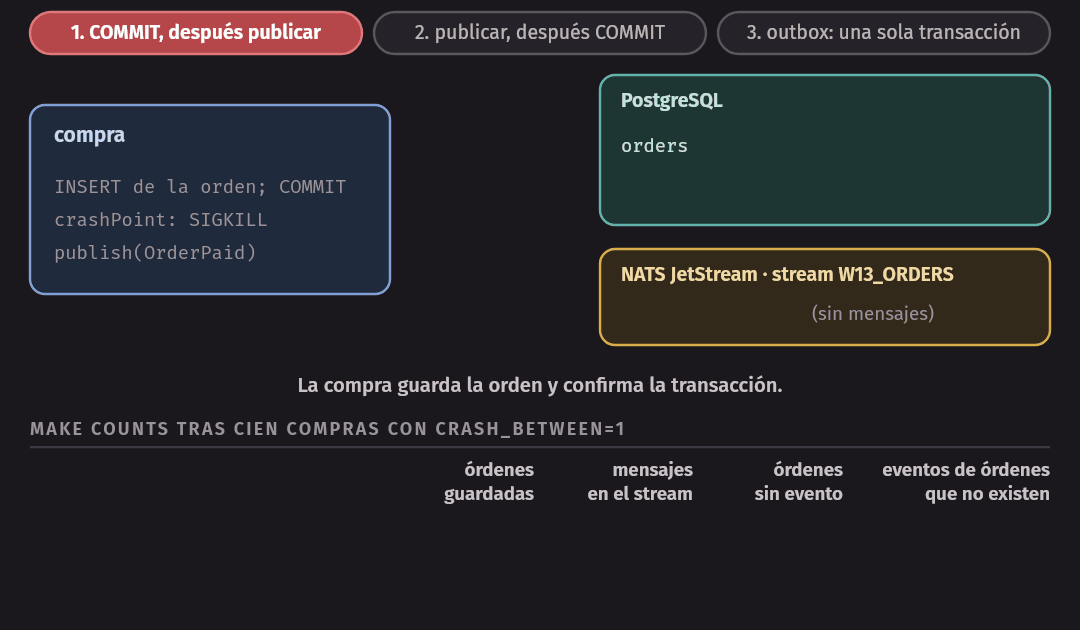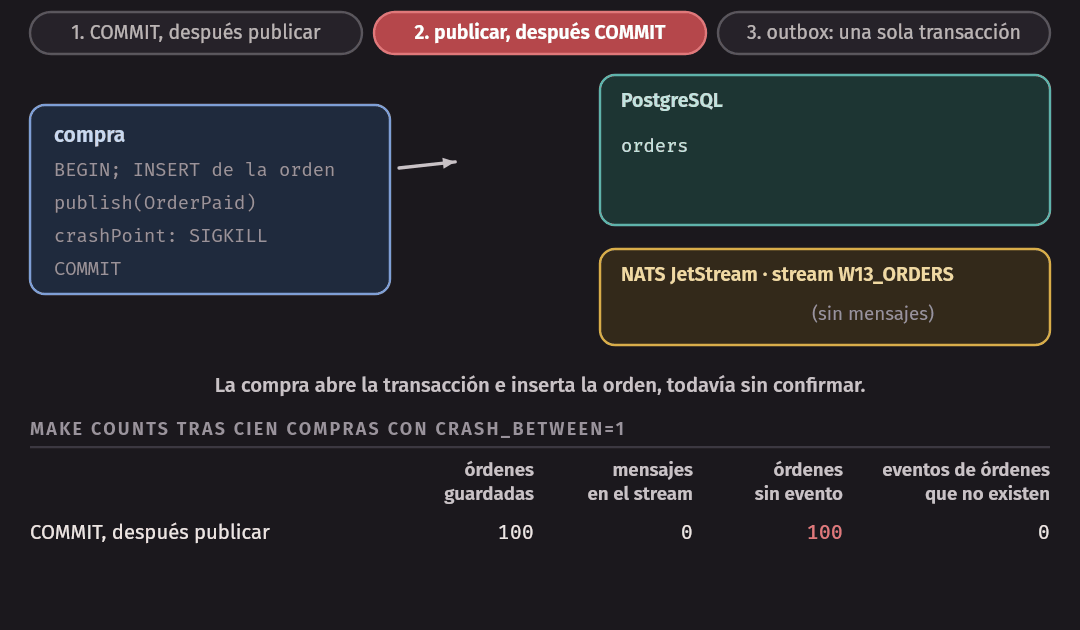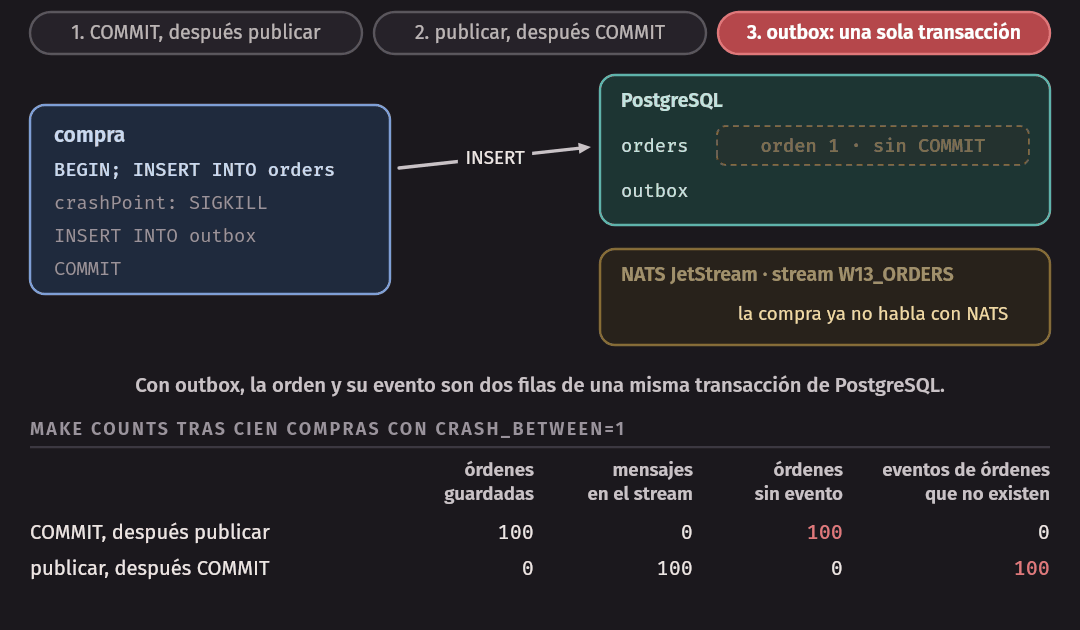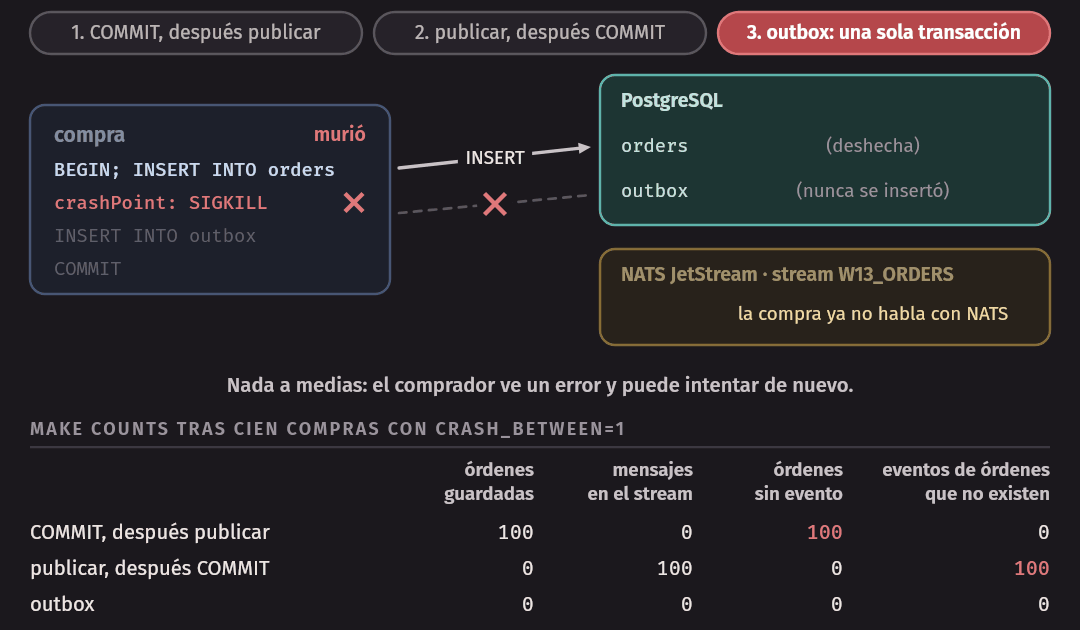
La reacción natural es invertir el orden: publicar primero y confirmar la
transacción después (PUBLISH_FIRST=1).
$ PUBLISH_FIRST=1 CRASH_BETWEEN=1 make dual-write N=100
100 compras (dual-write): 0 procesos terminaron bien, 100 murieron a la mitad
$ make counts
órdenes guardadas                     0
…
mensajes en el stream               100
  eventos distintos                 100
órdenes sin evento                    0
eventos de órdenes que no existen   100
Ahora hay cien eventos OrderPaid de órdenes que no existen: la transacción
nunca se confirmó. Es peor que antes. Se enviaron cien correos de
confirmación y se sumaron puntos por compras que no ocurrieron.
Idea clave. Con dos escrituras en dos sistemas, no hay un orden correcto: cualquiera de los dos deja, ante una caída, un estado que nunca debió existir. Con una primero, el sistema calla algo que pasó; con la otra primero, anuncia algo que no pasó. El problema no es el orden: es que son dos.
La outbox y el relay
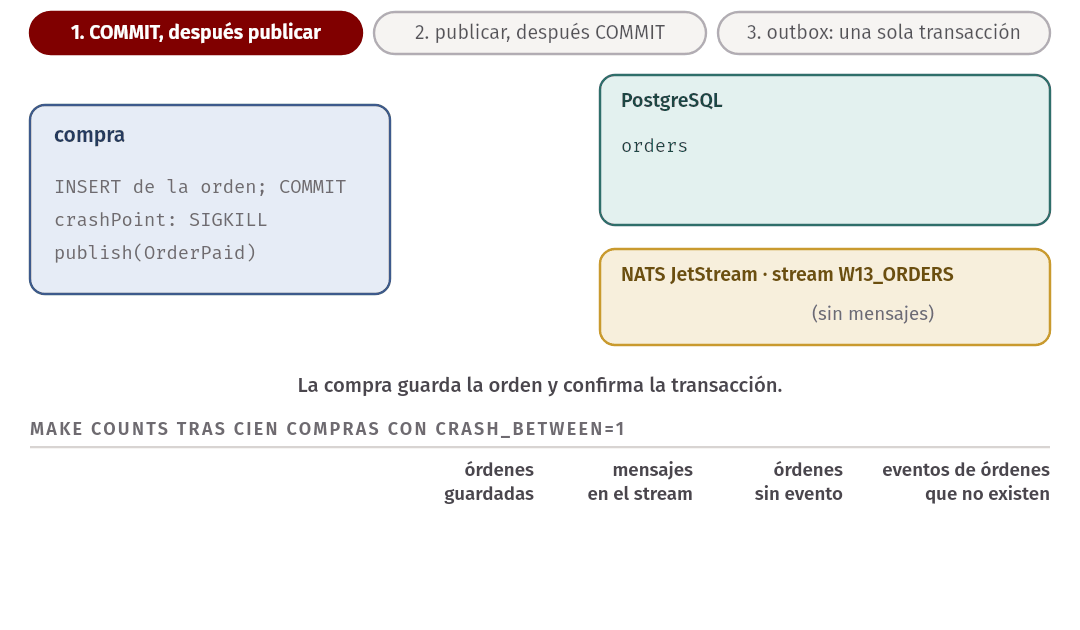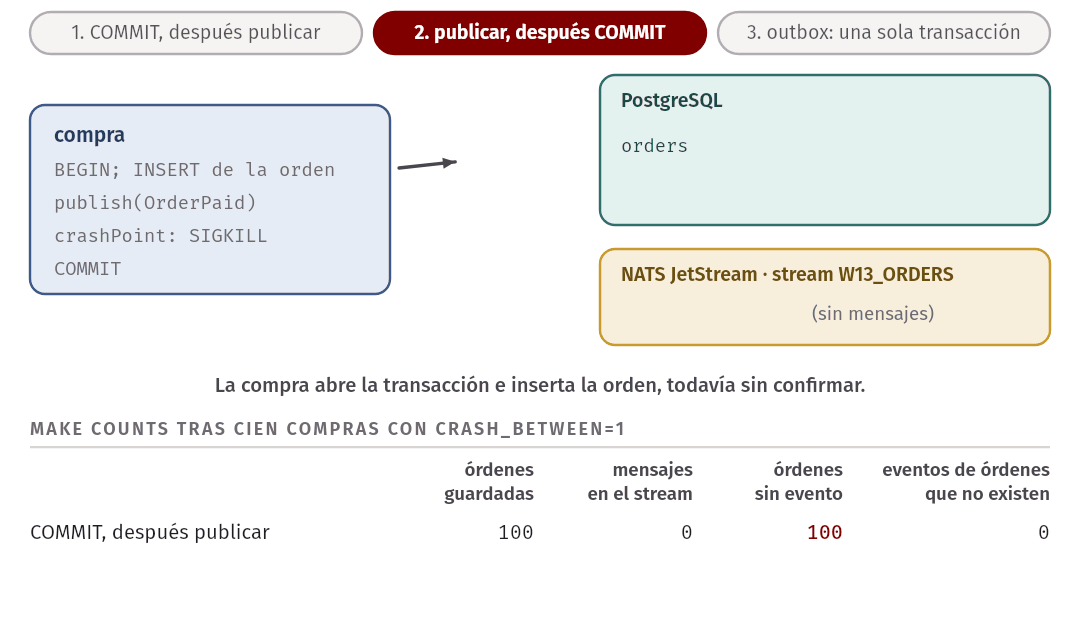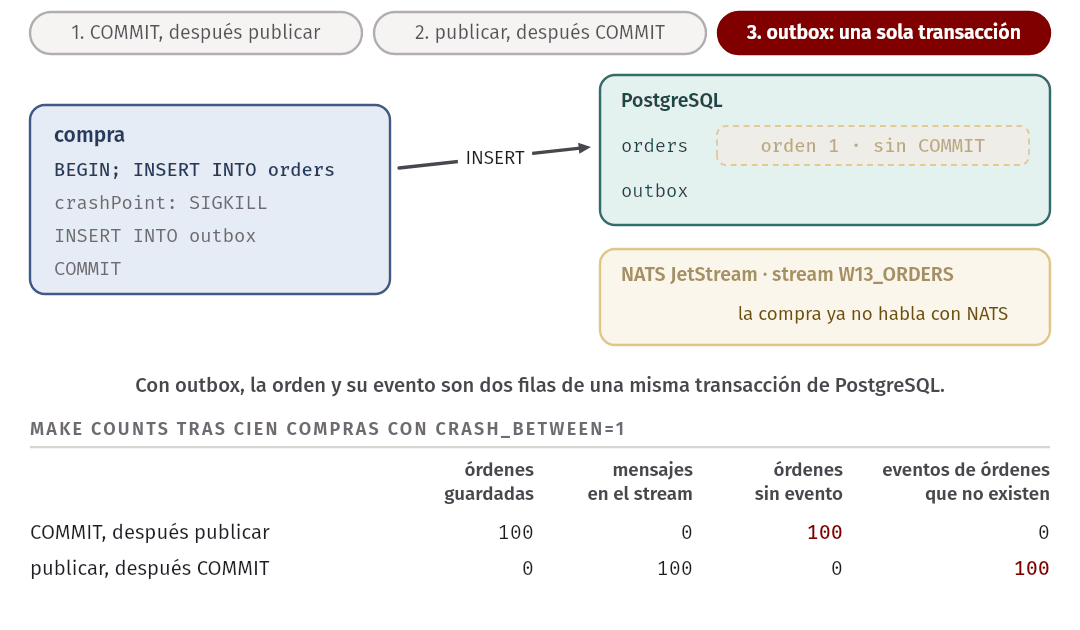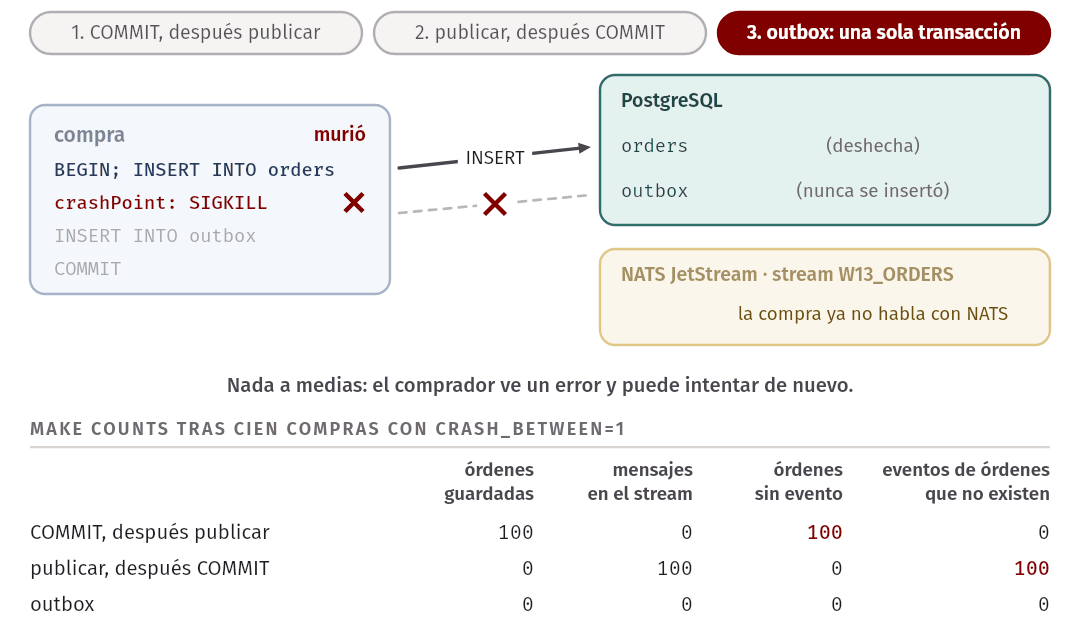
Si el problema es que son dos sistemas, la solución es escribir en uno solo. El patrón outbox convierte la publicación en una escritura más de la misma base de datos:
- En la misma transacción que guarda la orden, se inserta el evento en
una tabla,
outbox. PostgreSQL garantiza que o quedan las dos filas o ninguna: es la atomicidad de la semana 12, sin nada nuevo. - Un proceso aparte, el relay, lee de esa tabla lo que está pendiente, lo publica en el broker y lo marca como enviado.
La tabla, en db/schema.sql:
CREATE TABLE outbox (
    id           bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    event_id     uuid NOT NULL UNIQUE,
    subject      text NOT NULL,
    payload      jsonb NOT NULL,
    created_at   timestamptz NOT NULL DEFAULT now(),
    published_at timestamptz
);

CREATE INDEX outbox_pending ON outbox (id) WHERE published_at IS NULL;
published_at es NULL mientras el relay no publicó la fila. event_id es
el identificador del evento: lo genera quien crea el evento, una sola vez, y
viaja dentro del mensaje en cada publicación y en cada entrega. Será la clave
con que los consumidores reconozcan un duplicado.
Lo que hace la compra, visto como SQL, son dos INSERT entre un BEGIN y un
COMMIT:
BEGIN;
INSERT INTO orders (concert_id, buyer_email, quantity, total_cents, status) VALUES (…);
INSERT INTO outbox (event_id, subject, payload) VALUES (…);
COMMIT;
Completar eso en lab/outbox.ts, y el relay
en lab/relay.ts, es el paso 4 del
laboratorio. Las salidas que siguen son las del laboratorio completo. Primero
la misma prueba que rompió a la escritura doble, con el punto de caída entre
los dos INSERT:
$ CRASH_BETWEEN=1 make outbox N=100
100 compras (outbox): 0 procesos terminaron bien, 100 murieron a la mitad
$ make counts
órdenes guardadas                     0
filas en la outbox                    0
…
órdenes sin evento                    0
eventos de órdenes que no existen     0
Cero y cero. Cada proceso murió con la transacción abierta, PostgreSQL la deshizo, y no quedó ni la orden ni el evento. El comprador vio un error y puede intentar de nuevo: no hay nada a medias. Las cuentas coinciden, aunque de una manera poco vistosa. Con la mitad de las caídas:
$ CRASH_BETWEEN=0.5 make outbox N=100
100 compras (outbox): 50 procesos terminaron bien, 50 murieron a la mitad
$ make counts
órdenes guardadas                    50
filas en la outbox                   50
  pendientes de publicar             50
mensajes en el stream                 0
  eventos distintos                   0
órdenes sin evento                   50
eventos de órdenes que no existen     0
Cincuenta órdenes y cincuenta filas en la outbox, una por orden. En el stream todavía no hay nada, porque el relay no ha corrido: las órdenes “sin evento” son, esta vez, órdenes cuyo evento está guardado y esperando. Y aquí está la otra ganancia: la compra ya no habla con NATS. Si el broker está caído, la compra funciona igual, y los eventos esperan en la tabla. El relay:
$ make relay-once
[relay] 50 eventos publicados (solution/relay.ts)
$ make counts
órdenes guardadas                    50
…
mensajes en el stream                50
  eventos distintos                  50
órdenes sin evento                    0
eventos de órdenes que no existen     0
(La línea del relay nombra solution/relay.ts porque estas salidas se tomaron
con la versión completa; con la suya dirá lab/relay.ts.) Cincuenta órdenes,
cincuenta eventos, ninguna diferencia.
Trade-off. La outbox cambia un problema de corrección por latencia y por trabajo de operación. El evento ya no sale en el momento de la compra, sino cuando el relay pasa: aquí, cada 200 ms. Hay un proceso más que mantener vivo y que vigilar (¿cuántas filas pendientes hay?, ¿desde cuándo espera la más antigua?), y una tabla que crece y hay que limpiar. Hay dos alternativas. Una es leer los cambios directamente del log de la base de datos (el WAL), sin tabla ni consultas periódicas: menos latencia y menos carga, y más infraestructura que operar. La otra es two-phase commit entre la base de datos y el broker, que exige que los dos lo soporten y trae los bloqueos de la semana 12. Richardson describe las dos formas del relay, Polling publisher y Transaction log tailing, en Transactional outbox.
Lo que el relay garantiza: duplicados
El relay hace, por cada fila pendiente, dos cosas: publicar y marcar. Otra vez son dos escrituras en dos sistemas. ¿No volvió el problema? Volvió, pero ahora se puede elegir de qué lado cae el error. Hay dos órdenes posibles:
| El relay… | Si muere entre las dos operaciones | Resultado |
|---|---|---|
| marca y después publica | la fila está marcada y el evento no salió | el evento se pierde |
| publica y después marca | el evento salió y la fila sigue pendiente | el evento se publica otra vez |
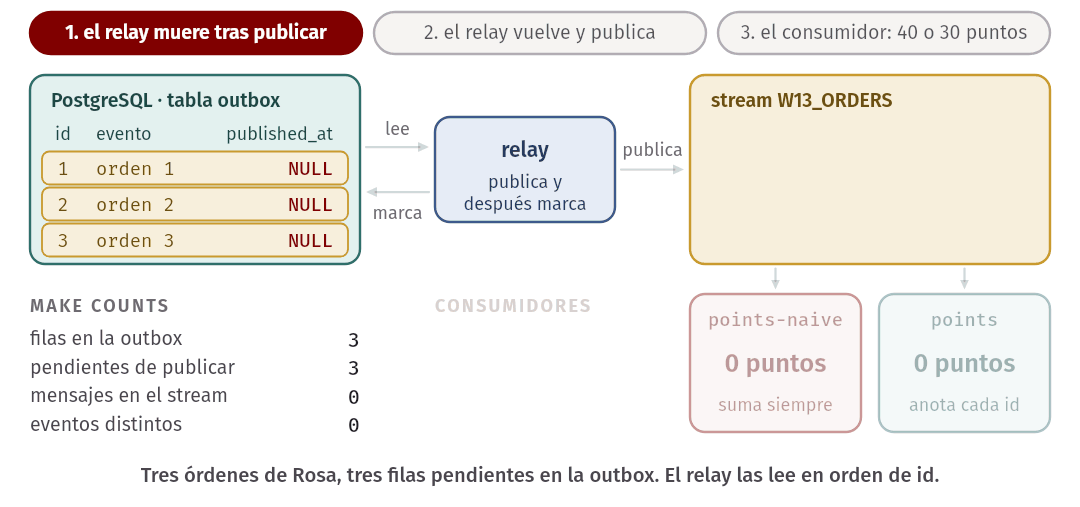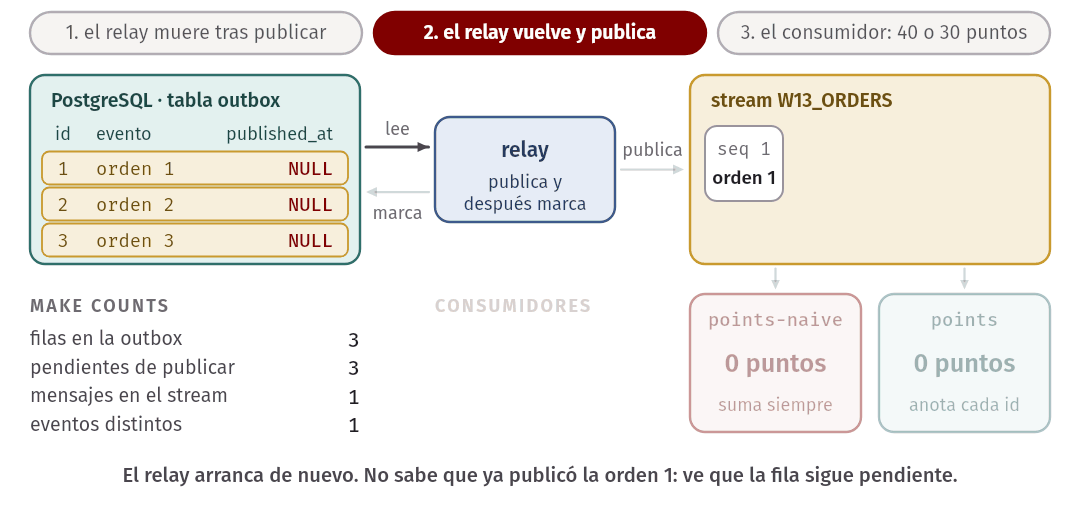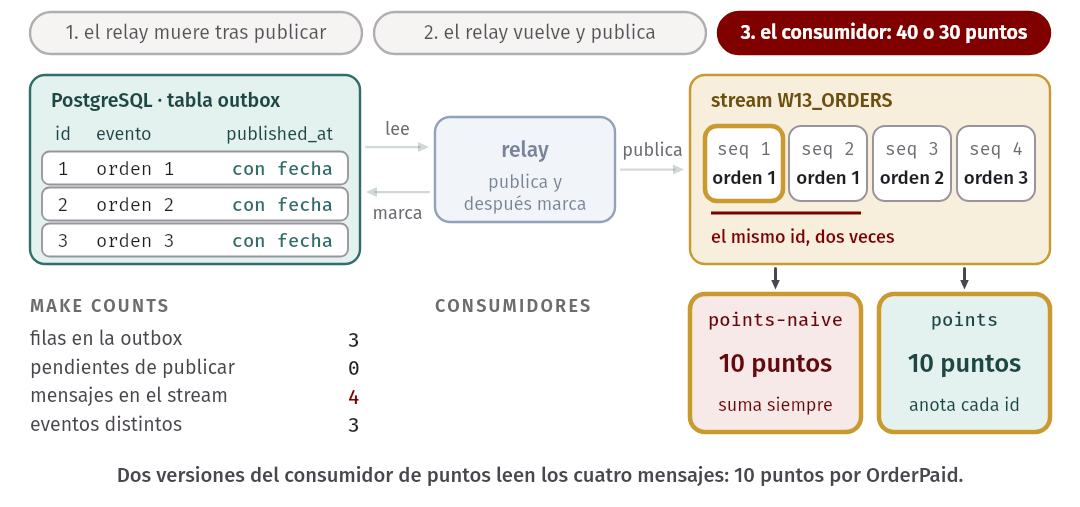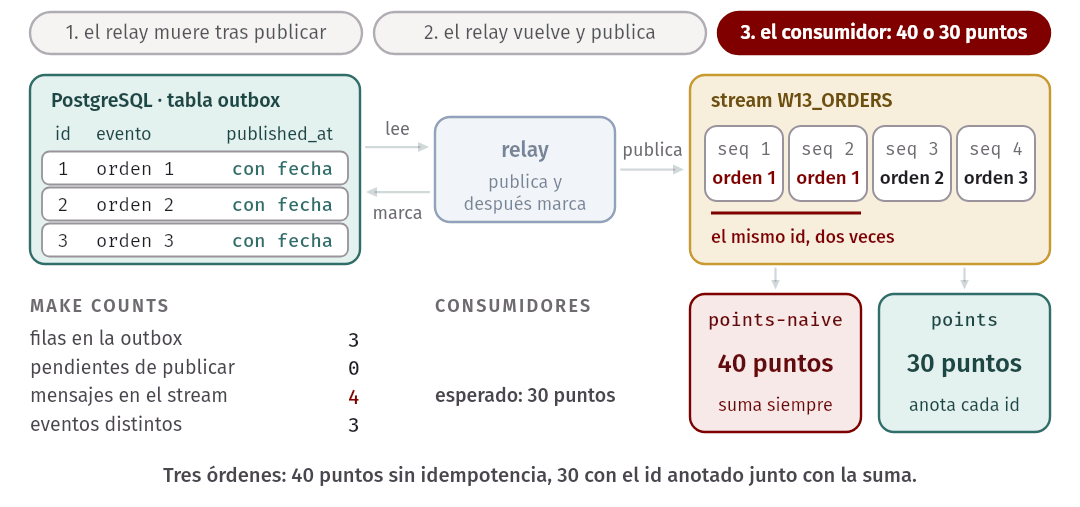
La segunda es la que se elige: un duplicado se puede descartar más adelante, y un evento perdido no se recupera. Paso 5 del laboratorio: tres órdenes de la misma compradora y un relay que muere justo después de publicar la primera.
$ BUYER=rosa.quispe@correo.pe make outbox N=3
3 compras (outbox): 3 procesos terminaron bien, 0 murieron a la mitad
$ CRASH_AFTER_PUBLISH=1 make relay-once
make: *** [Makefile:90: relay-once] Killed
$ make counts
órdenes guardadas                     3
filas en la outbox                    3
  pendientes de publicar              3
mensajes en el stream                 1
…
Un mensaje en el stream y tres filas pendientes: la primera se publicó, y el relay murió antes de marcarla. Al reiniciarlo, sin la caída:
$ make relay-once
[relay] 3 eventos publicados (solution/relay.ts)
$ make counts
…
  pendientes de publicar              0
mensajes en el stream                 4
  eventos distintos                   3
…
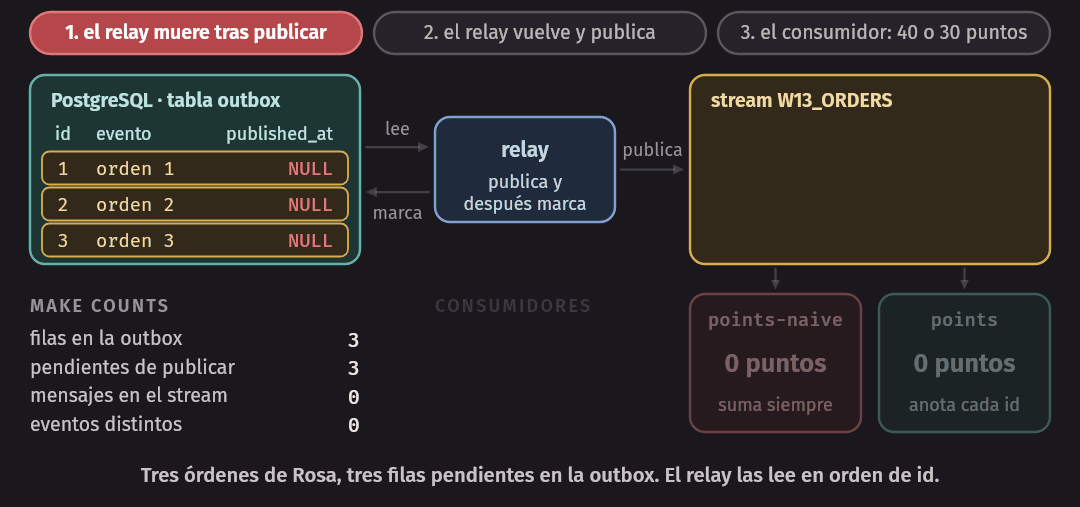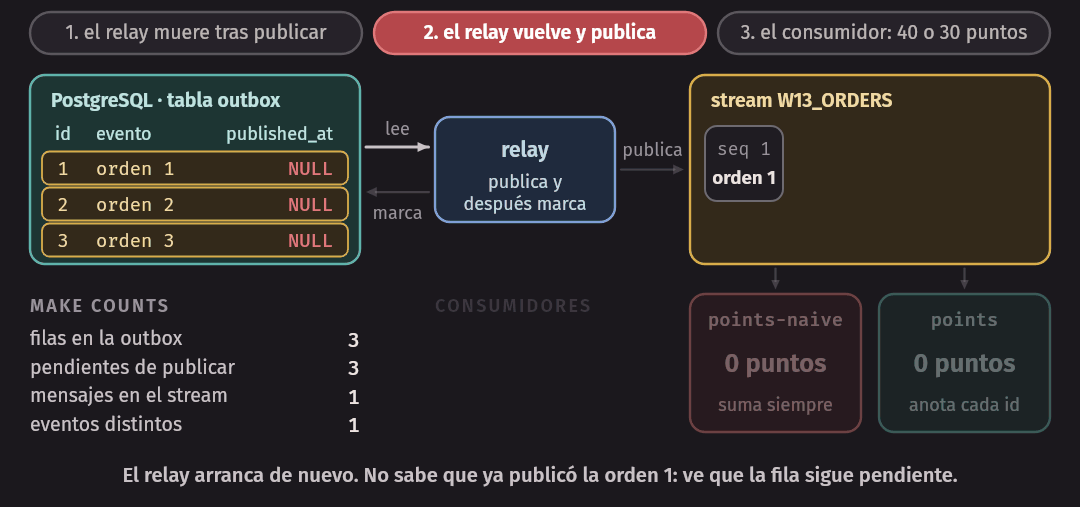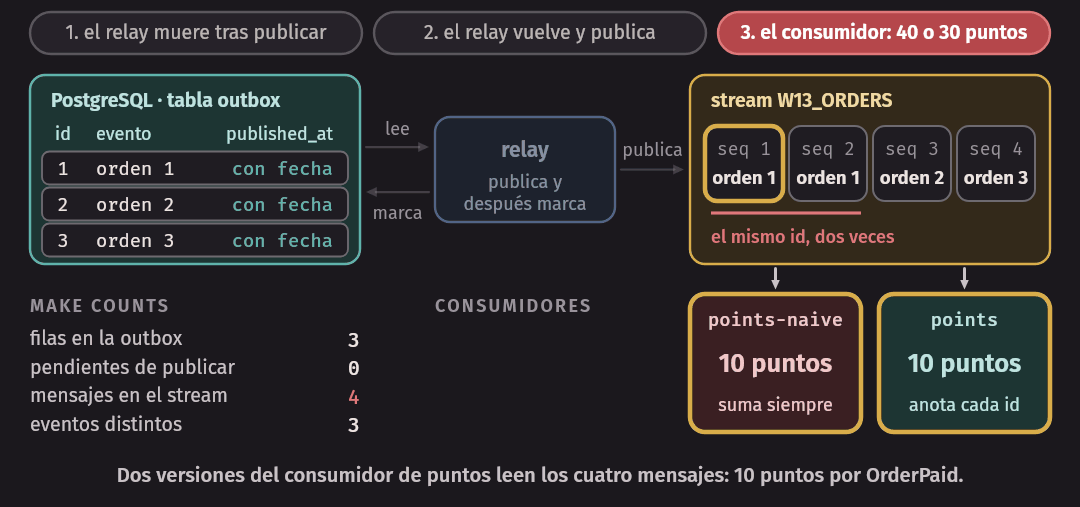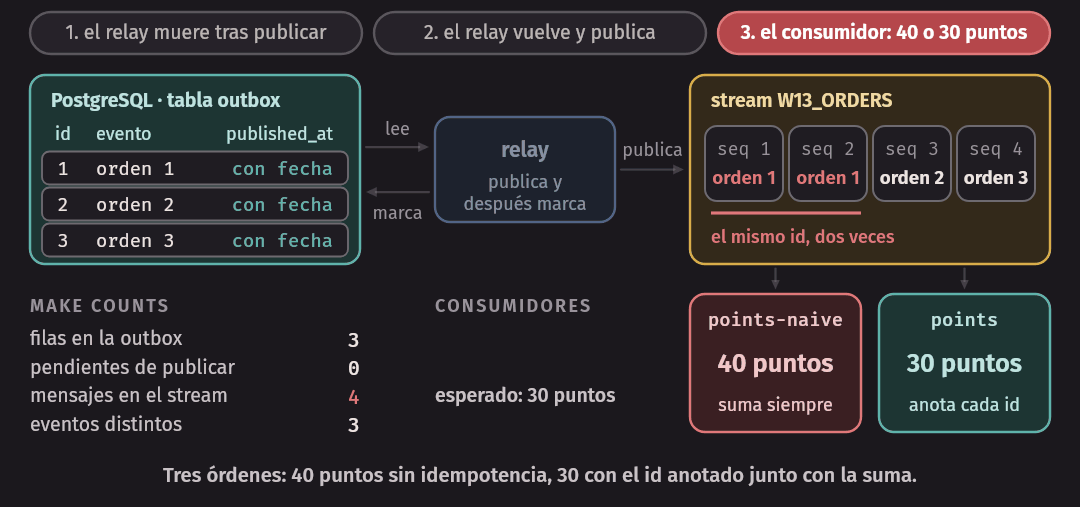
Tres órdenes, tres eventos distintos y cuatro mensajes: el evento de la
orden 1 está dos veces en el stream, con el mismo id. El relay no podía
saber que ya lo había publicado; lo único que sabía es que la fila seguía
pendiente. La outbox con relay da entrega at-least-once: ningún evento se
pierde, y algunos se repiten.
Idea clave. La outbox no elimina el duplicado: lo mueve a donde se puede manejar. Entre “puede perderse” y “puede repetirse”, se elige repetir, porque para la repetición hay remedio (un consumidor idempotente) y para la pérdida no.
JetStream puede descartar parte de esos duplicados. Si el mensaje se publica
con la cabecera Nats-Msg-Id, el stream recuerda los identificadores que
recibió durante su ventana de duplicados (el Duplicate Window: 2m0s de
más arriba) y no guarda dos veces el mismo. El relay completo lo hace con
RELAY_MSG_ID=1, usando el id del evento. Con la misma secuencia
de tres órdenes, caída (RELAY_MSG_ID=1 CRASH_AFTER_PUBLISH=1 make relay-once)
y reinicio (RELAY_MSG_ID=1 make relay-once), make counts termina en
mensajes en el stream 3 y eventos distintos 3.
Tres mensajes. Vale la pena activarlo, y no reemplaza al consumidor
idempotente, por dos razones. La ventana tiene un límite: si el relay estuvo
caído más de dos minutos, la repetición entra. Y solo cubre el tramo del
productor al stream: el tramo del stream al consumidor tiene sus propios
duplicados (la entrega 2 de make demo-ack), y esos no los ve el stream.
El orden dentro de la outbox
Un detalle para quien vaya a construir una outbox de verdad. El relay lee las
filas pendientes ordenadas por id, pero el id se asigna al insertar la
fila, no al confirmar: dos compras concurrentes pueden recibir los ids 1 y 2
y confirmarse en el orden 2, 1. Si el relay pasa en medio, publica la 2 antes
que la 1. La prueba de
test/outbox-order.test.ts
reproduce ese entrelazado y comprueba dos cosas: un relay que busca “lo
pendiente” (published_at IS NULL) publica la fila 1 tarde, pero la publica;
uno que recordara “ya publiqué hasta el id 2” y buscara id > 2 no la vería
nunca. Por eso la outbox usa una marca por fila y no un contador. Y si dos
eventos de la misma entidad pueden salir de transacciones concurrentes,
hace falta un número de versión en el evento, como en la sección anterior.
En Tinkuy. El Tinkuy inicial no publica nada: cobra y envía el correo dentro de la transacción de la compra, y si el correo falla, la orden se deshace después de haber cobrado. En P4 el pago sale a un servicio propio y los efectos pasan a ser mensajes:
OrderPaidsale de una outbox a un stream, y los consumidores de notificaciones y de reportes llevan cada uno su posición. Lo que construyen esta semana sobre la aplicación decode/week-13/es la misma técnica, en pequeño; decidir dónde va la outbox de Tinkuy, qué eventos lleva y quién los consume es parte de su entrega.
Consumidores que soportan la entrega repetida
El evento ya llega al stream, al menos una vez. Falta el último eslabón: que procesarlo dos veces no haga daño.
Un consumidor que no es idempotente
El programa de puntos da 10 puntos por cada OrderPaid. La versión de
errors/points-naive.ts hace lo que
dice el enunciado y nada más:
export async function addPointsNaive(event: OrderPaid): Promise<void> {
  await db().query(
    `INSERT INTO loyalty_points (buyer_email, points) VALUES ($1, $2)
     ON CONFLICT (buyer_email) DO UPDATE SET points = loyalty_points.points + EXCLUDED.points`,
    [event.buyerEmail, POINTS_PER_ORDER],
  );
}
Paso 6 del laboratorio. El stream quedó, tras el paso 5, con cuatro mensajes de tres órdenes de Rosa. El consumidor los procesa:
$ make consumer C=points-naive
[points-naive] esperando eventos con el consumer "points"
[points-naive] seq 1 (entrega 1): orden 1 procesada
[points-naive] seq 2 (entrega 1): orden 1 procesada
[points-naive] seq 3 (entrega 1): orden 2 procesada
[points-naive] seq 4 (entrega 1): orden 3 procesada
$ make status
== órdenes y puntos por comprador (10 puntos por orden)
┌─────────┬─────────────────────────┬────────┬─────────────────┬────────┐
│ (index) │ buyer_email             │ orders │ expected_points │ points │
├─────────┼─────────────────────────┼────────┼─────────────────┼────────┤
│ 0       │ 'rosa.quispe@correo.pe' │ 3      │ 30              │ 40     │
└─────────┴─────────────────────────┴────────┴─────────────────┴────────┘
…
Tres órdenes y 40 puntos: la orden 1 se contó dos veces (secuencias 1 y 2).
Fíjense en que las dos fueron entrega 1: para el servidor son dos mensajes
distintos, y no hay nada en la entrega que delate la repetición. Lo único que
las une es el id del evento, que viaja dentro del mensaje.
El id del evento, en la misma transacción que el efecto
Es la clave de idempotencia de la semana 12, aplicada a un consumidor: se guarda el identificador de cada evento procesado, y antes de aplicar un efecto se comprueba si ese identificador ya está. La tabla:
CREATE TABLE processed_events (
    consumer     text NOT NULL,
    event_id     uuid NOT NULL,
    processed_at timestamptz NOT NULL DEFAULT now(),
    PRIMARY KEY (consumer, event_id)
);
El consumidor del reporte de ventas,
consumers/report.ts, ya está hecho
así, y es el modelo para el de puntos:
export async function addToSalesReport(event: OrderPaid, target: ReportTarget = SALES_REPORT): Promise<void> {
  await inTransaction(async (client) => {
    const first = await client.query(
      'INSERT INTO processed_events (consumer, event_id) VALUES ($1, $2) ON CONFLICT DO NOTHING',
      [target.consumer, event.id],
    );
    if (first.rowCount === 0) return; // ya se procesó: no se suma de nuevo

    await client.query(
      `INSERT INTO ${target.table} (concert_id, orders, tickets, revenue_cents) VALUES ($1, 1, $2, $3)
       ON CONFLICT (concert_id) DO UPDATE SET …`,
      [event.concertId, event.quantity, event.totalCents],
    );
  });
}
Hay tres decisiones en esas líneas, y las tres importan.
El identificador y el efecto van en la misma transacción. Supongan que no: que primero se anota el id y, en otra transacción, se suma. Si el proceso muere entre las dos, el evento queda anotado como procesado y su efecto no ocurrió; cuando el mensaje vuelva, se descartará. Se perdió, con un consumidor que confirma después. Al revés (sumar, después anotar), una caída en medio repite el efecto. Es, por tercera vez en el capítulo, la escritura doble, y la solución es la misma: que las dos escrituras sean una transacción de la misma base de datos. La prueba el id procesado y el efecto van en la misma transacción provoca una falla en la suma y comprueba que el id tampoco quedó.
La comprobación es un INSERT, no un SELECT seguido de un INSERT.
Comprobar y después actuar es el patrón que vendía dos veces un asiento en la
semana 12. Dos procesos del mismo consumer pueden recibir el mismo evento casi
a la vez (uno por la entrega original, que tardó; otro por la reentrega). Con
INSERT … ON CONFLICT DO NOTHING sobre la clave primaria, la base de datos
decide: uno inserta la fila y el otro obtiene cero filas, después de esperar a
que el primero confirme o aborte.
Un evento repetido termina bien. La función no lanza un error ante un duplicado: retorna, y el consumidor confirma el mensaje. Un duplicado no es una falla; si se tratara como tal, se reintentaría para siempre.
Y una cuarta decisión, que está en la tabla: la clave incluye el nombre del
consumidor. Cada consumidor anota lo suyo; que report haya procesado un
evento no dice nada sobre points.
Hacer lo mismo en lab/points.ts es la
segunda mitad del paso 6. Con el consumidor de puntos ya idempotente, sobre el
mismo stream de cuatro mensajes:
$ make consumer C=points
[points] esperando eventos con el consumer "points"
[points] seq 1 (entrega 1): orden 1 procesada
[points] seq 2 (entrega 1): orden 1 procesada
…
$ make status
…
│ 0       │ 'rosa.quispe@correo.pe' │ 3      │ 30              │ 30     │
…
Los cuatro mensajes se recibieron y se confirmaron; el segundo no sumó.
Treinta puntos por tres órdenes, y en processed_events quedaron tres
identificadores, uno por evento distinto.
Trade-off. La tabla de eventos procesados es la técnica general: sirve para cualquier efecto que viva en la misma base de datos. Cuesta una escritura más por mensaje y una tabla que crece sin fin si nadie la limpia (se pueden borrar los identificadores más antiguos que el plazo máximo en que un duplicado puede llegar, y hay que saber cuál es ese plazo). La alternativa, cuando existe, es un efecto idempotente por naturaleza:
UPDATE orders SET status = 'paid'da lo mismo una vez que diez, y unINSERTcon la orden como clave primaria rechaza la repetición sin tabla aparte. Sumar no lo es, y enviar un correo tampoco. Y cuando el efecto ocurre fuera de la base de datos (el correo, un cobro), no hay transacción que una el id con el efecto: ahí la clave de idempotencia se le envía al otro sistema, como en el cobro de la semana 12, o se acepta que una caída en el peor momento repita el correo.
Mensajes que nunca se procesan: la dead letter
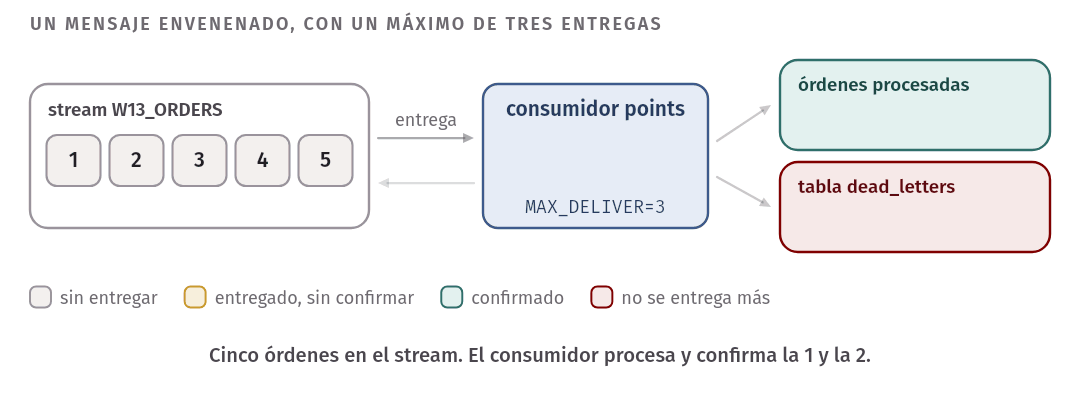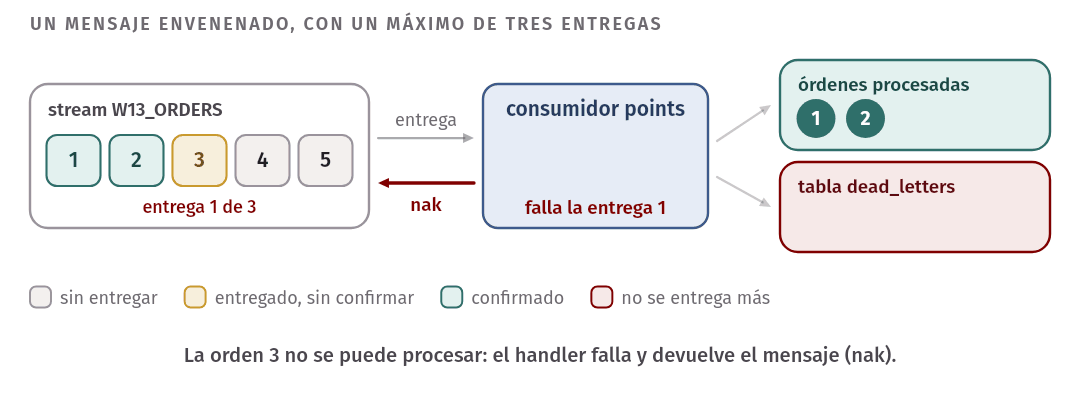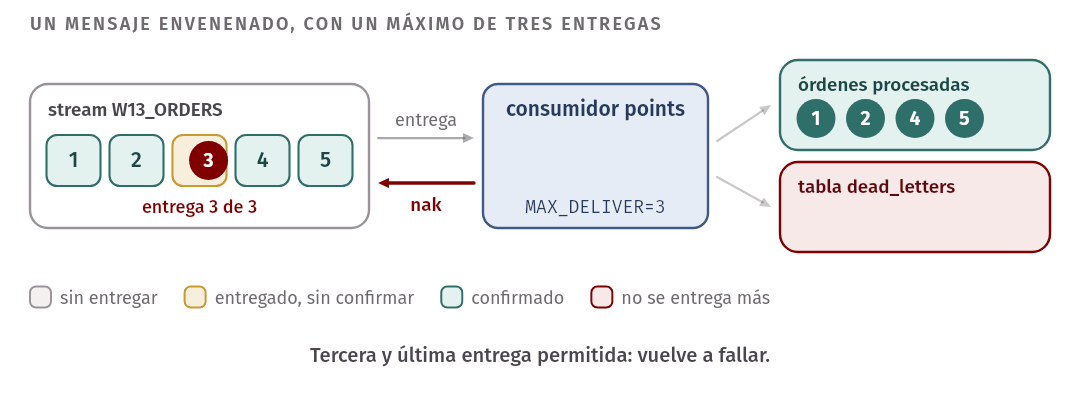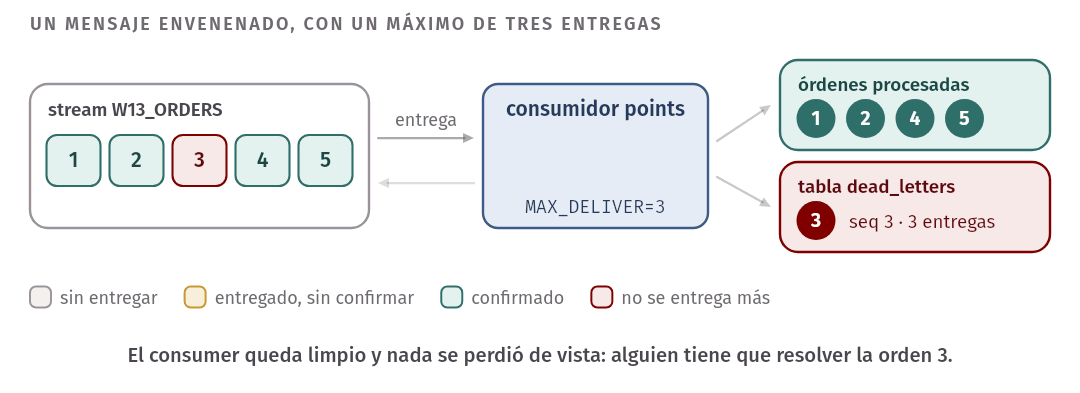
Hasta ahora, un mensaje que falla se reintenta y, tarde o temprano, pasa. Hay mensajes que no van a pasar nunca: un evento con un campo que el consumidor no entiende, una orden que referencia algo que no existe, un error de programación que salta con ese dato. Se les llama mensajes envenenados (poison messages). Paso 7 del laboratorio: cinco órdenes, y un consumidor que falla siempre con la orden 3.
$ POISON_ORDER=3 make consumer C=points
[points] esperando eventos con el consumer "points"
[points] seq 1 (entrega 1): orden 1 procesada
[points] seq 2 (entrega 1): orden 2 procesada
[points] seq 3: la entrega 1 falló (Error: no puedo procesar la orden 3)
[points] seq 4 (entrega 1): orden 4 procesada
[points] seq 5 (entrega 1): orden 5 procesada
[points] seq 3: la entrega 2 falló (Error: no puedo procesar la orden 3)
[points] seq 3: la entrega 3 falló (Error: no puedo procesar la orden 3)
…
Una entrega por segundo, sin fin, hasta que alguien detenga el proceso. Los
mensajes 4 y 5 pasaron, porque este consumidor no exige orden; con orden
estricto (max_ack_pending = 1), el mensaje 3 los habría detenido a todos
para siempre. En los dos casos hay un problema: o un mensaje que consume
recursos eternamente y llena los logs, o una cola entera detenida detrás de
él. El consumer lo muestra así:
$ nats consumer info W13_ORDERS points
…
    Acknowledgment Floor: Consumer sequence: 2 Stream sequence: 2 Last Ack: 4.70s ago
        Outstanding Acks: 1 out of maximum 1,000
…
Todo entregado, y el piso de confirmaciones detenido en la secuencia 2: hay un hueco en la 3. Un piso de confirmaciones que no avanza mientras las entregas siguen es la señal de un mensaje envenenado, y es una buena alerta.
La salida es poner un número máximo de entregas y un lugar adonde va lo
que lo agota: la dead letter queue. No es un mecanismo para arreglar el
mensaje; es para sacarlo del camino sin perderlo, de modo que una persona lo
vea. En la aplicación de la semana es una tabla, dead_letters, y la lógica
está en startConsumer
(shared/bus.ts):
} catch (error) {
  if (options.ackFirst) continue; // ya se confirmó: el mensaje se perdió
  const last = options.maxDeliver !== undefined && delivery.deliveryCount >= options.maxDeliver;
  log(name, `seq ${delivery.streamSeq}: la entrega ${delivery.deliveryCount} falló (${String(error)})`);
  if (last) {
    await options.onGiveUp?.(event, delivery, error);
    message.term('se agotaron las entregas');
  } else {
    message.nak(settings.redeliveryDelayMs);
  }
}
Cada entrega trae su número, deliveryCount. Cuando el handler falla en la
última permitida, el consumidor registra el mensaje (onGiveUp inserta en
dead_letters) y le dice al servidor que no lo entregue más (term). Con el
consumer recién creado y MAX_DELIVER=3:
$ nats consumer rm -f W13_ORDERS points
$ POISON_ORDER=3 MAX_DELIVER=3 make consumer C=points
[points] esperando eventos con el consumer "points"
…
[points] seq 3: la entrega 1 falló (Error: no puedo procesar la orden 3)
[points] seq 4 (entrega 1): orden 4 procesada
[points] seq 5 (entrega 1): orden 5 procesada
[points] seq 3: la entrega 2 falló (Error: no puedo procesar la orden 3)
[points] seq 3: la entrega 3 falló (Error: no puedo procesar la orden 3)
$ make status
┌─────────┬─────────────────────────┬────────┬─────────────────┬────────┐
│ (index) │ buyer_email             │ orders │ expected_points │ points │
├─────────┼─────────────────────────┼────────┼─────────────────┼────────┤
│ 0       │ 'rosa.quispe@correo.pe' │ 5      │ 50              │ 40     │
└─────────┴─────────────────────────┴────────┴─────────────────┴────────┘
…
== dead letters
┌─────────┬──────────┬────────────┬──────────┬────────────┬───────────────────────────────────────┐
│ (index) │ consumer │ stream_seq │ order_id │ deliveries │ reason                                │
├─────────┼──────────┼────────────┼──────────┼────────────┼───────────────────────────────────────┤
│ 0       │ 'points' │ 3          │ '3'      │ 3          │ 'Error: no puedo procesar la orden 3' │
└─────────┴──────────┴────────────┴──────────┴────────────┴───────────────────────────────────────┘
Tres intentos, y el mensaje queda registrado con su motivo. Después de eso el
consumer está limpio: Acknowledgment Floor en la secuencia 5 y
Outstanding Acks: 0. Dos cosas más que mirar en esta salida. Como el
consumer se borró y se creó de nuevo, empezó otra vez desde la secuencia 1, y
los puntos siguen en 40: el consumidor idempotente descartó las órdenes 1, 2,
4 y 5, que ya había procesado. Y faltan 10 puntos de la orden 3, que alguien
tiene que resolver: la dead letter no los suma, solo evita que se olviden.
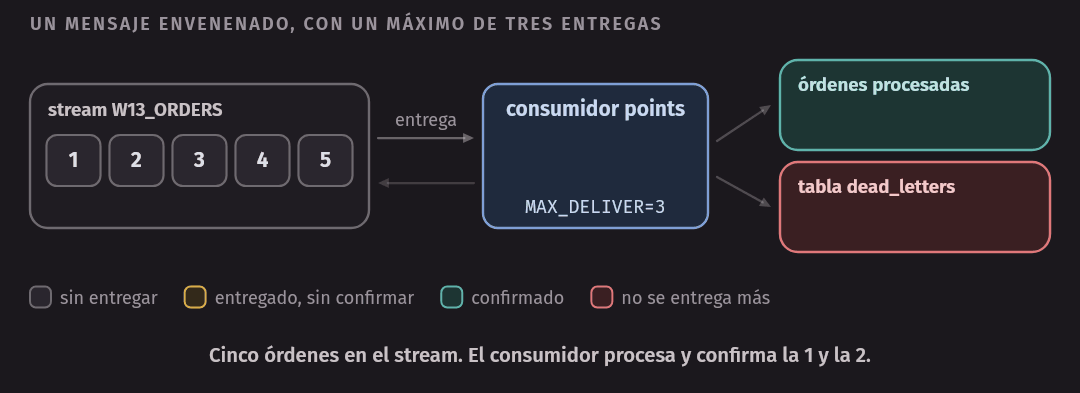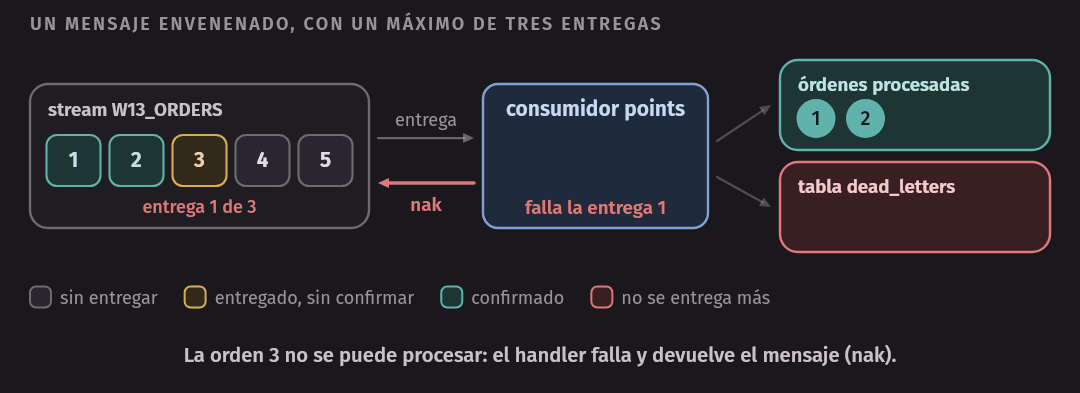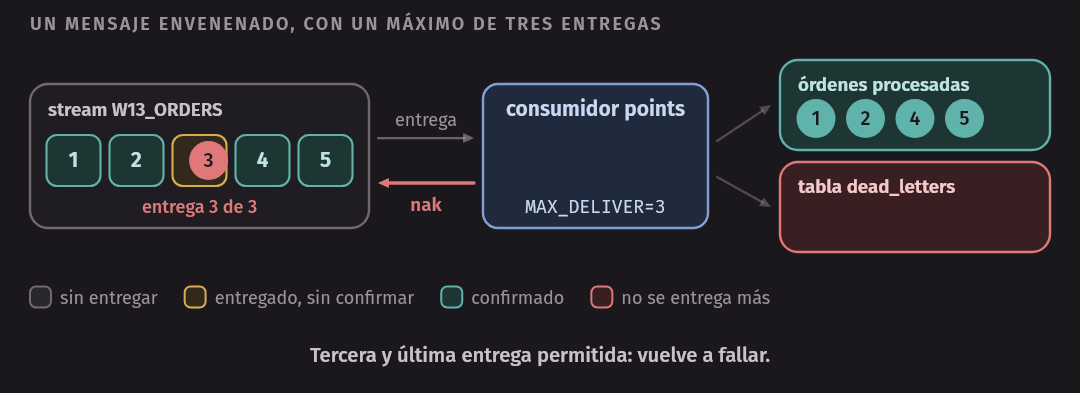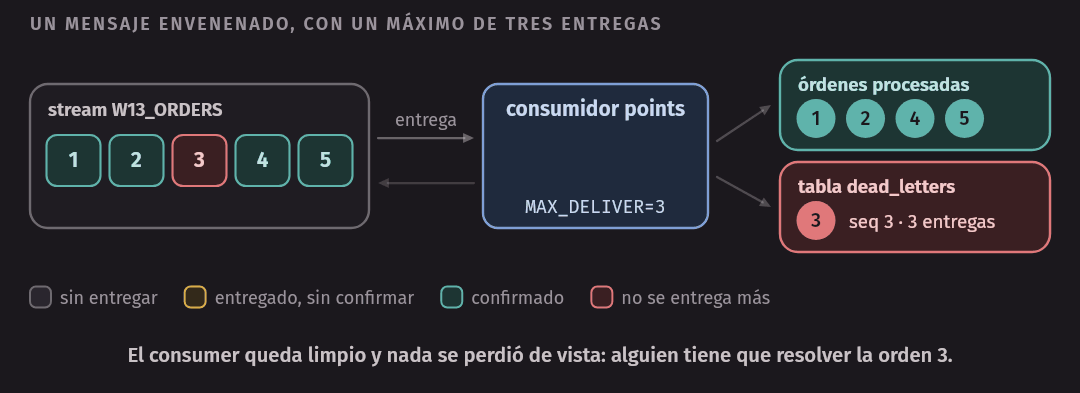
El registro depende de que el consumidor llegue vivo a ese catch. Hay
situaciones en que no llega: el proceso muere en cada entrega (se queda sin
memoria con ese mensaje, por ejemplo). Para eso el servidor tiene su propia
señal. make demo-max-deliveries usa un consumidor que solo confirma o
devuelve, sin saber nada de límites, sobre un consumer con max_deliver = 3:
$ make demo-max-deliveries
   5 ms  seq 1, deliveryCount 1: ack
   8 ms  seq 2, deliveryCount 1: falla, nak
   9 ms  seq 3, deliveryCount 1: ack
  10 ms  seq 4, deliveryCount 1: ack
 310 ms  seq 2, deliveryCount 2: falla, nak
 632 ms  seq 2, deliveryCount 3: falla, nak
aviso del servidor en $JS.EVENT.ADVISORY.CONSUMER.MAX_DELIVERIES.W13_DEMO.poisoned
    {"type":"io.nats.jetstream.advisory.v1.max_deliver","id":"ZFXd0WBpsmXLeyrvza2U9m","timestamp":"2026-11-16T06:43:39.820194341Z","stream":"W13_DEMO","consumer":"poisoned","stream_seq":2,"deliveries":3}
consumer: ack_floor.stream_seq 1, num_ack_pending 0, num_redelivered 1, num_pending 0
(Los tiempos son de una laptop con Apple Silicon, dentro de Docker; lo que importa es la secuencia, no los milisegundos.) Después de la tercera entrega, el servidor deja de entregar el mensaje 2 y publica un aviso (advisory) en un subject de sistema, con el stream, el consumer y la secuencia. El mensaje sigue en el stream; el consumer simplemente no lo entrega más, y su piso de confirmaciones se queda en 1.
Son dos señales complementarias, y con NATS 2.15 y el cliente nats 2.29
funcionan las dos:
| Señal | Quién la ve | Qué trae | Cuándo falla |
|---|---|---|---|
deliveryCount en la entrega |
el consumidor, al procesar | el mensaje completo y el error | si el proceso no llega vivo al catch de la última entrega |
Aviso MAX_DELIVERIES |
quien esté suscrito al subject | stream, consumer y secuencia (no el contenido ni el error) | si nadie está suscrito en ese momento: el aviso es un mensaje común, que no se guarda |
La aplicación de la semana usa la primera, porque quiere registrar el error. Un sistema en producción usa las dos: la primera para el caso normal, y un stream que capture los avisos para lo que se le escape a la primera.
Error común. Un límite de entregas sin dead letter. El mensaje deja de molestar y desaparece del radar, que es peor que un reintento infinito: al menos ese se nota. Lo vimos al preparar este capítulo: si a un consumer que ya entregó cinco veces un mensaje se le baja el límite a tres, el servidor deja de entregarlo en silencio y el consumidor nunca tiene la ocasión de registrarlo. La otra mitad del error es la dead letter que nadie mira: una tabla que crece sin alerta ni responsable es lo mismo que borrar los mensajes, con más disco.
Reprocesar: una tabla reconstruida desde el stream
Queda por cobrar la ventaja del log: como los mensajes siguen ahí, se pueden
leer de nuevo. Paso 8 del laboratorio. Doce órdenes, un relay que muere una
vez (trece mensajes, doce eventos distintos) y el consumidor del reporte, que
ya procesó todo. Ahora se crea un consumer nuevo, report-rebuild, que
lee desde la secuencia 1 y llena otra tabla, sales_report_rebuilt, con la
misma función:
$ make replay
Reconstruido con el consumer "report-rebuild": 13 mensajes leídos desde la secuencia 1.
== sales_report
┌─────────┬────────────┬────────┬─────────┬───────────────┐
│ (index) │ concert_id │ orders │ tickets │ revenue_cents │
├─────────┼────────────┼────────┼─────────┼───────────────┤
│ 0       │ 1          │ 4      │ 10      │ 160000        │
│ 1       │ 2          │ 4      │ 10      │ 90000         │
│ 2       │ 3          │ 4      │ 10      │ 45000         │
└─────────┴────────────┴────────┴─────────┴───────────────┘
== sales_report_rebuilt
…
│ 0       │ 1          │ 4      │ 10      │ 160000        │
│ 1       │ 2          │ 4      │ 10      │ 90000         │
│ 2       │ 3          │ 4      │ 10      │ 45000         │
…
Las dos tablas son iguales.
Trece mensajes leídos, doce órdenes en cada tabla. La tabla original se armó
evento a evento, a medida que llegaban; la reconstruida, de una sola pasada
sobre la historia. Son iguales, y el consumer report no se movió: la
reconstrucción es otro lector del mismo log.
Para qué sirve: para crear un consumidor nuevo que nace con toda la historia (un reporte que nadie pidió hasta hoy), para corregir un consumidor que tenía un error y recalcular su tabla, o para cambiar la forma de una vista. Y qué tiene que cumplir el consumidor para que sea seguro:
- Ser idempotente. El stream tiene duplicados, y la reconstrucción los lee igual que el consumidor original. Con el consumidor de puntos ingenuo, los trece mensajes darían 130 puntos por doce órdenes.
- Que su efecto dependa solo del contenido de los eventos. El reporte se
arma con lo que trae cada
OrderPaid. Un consumidor que consultara “el precio actual del concierto” al procesar daría otro resultado hoy que el día en que el evento ocurrió. - No tener efectos hacia afuera. Reprocesar el consumidor de correo envía de nuevo todos los correos de la historia. Lo que se reprocesa son vistas y datos derivados; un efecto externo se protege con su propio registro de lo enviado, o no se reprocesa.
- Que los eventos sigan en el stream. Con retención por límites, lo más antiguo se borra en algún momento; desde ahí hacia atrás no hay nada que leer.
Hay un caso instructivo en que las tablas no coinciden. Seis órdenes, y
el consumidor del reporte, con POISON_ORDER=3 MAX_DELIVER=2, manda la orden
3 a la dead letter. Después se reconstruye, con un consumidor que ya no tiene
ese problema:
$ make replay
Reconstruido con el consumer "report-rebuild": 6 mensajes leídos desde la secuencia 1.
…
Filas que están en una tabla y no en la otra:
┌─────────┬────────────┬────────────────────────┬────────┬─────────┬───────────────┐
│ (index) │ concert_id │ table                  │ orders │ tickets │ revenue_cents │
├─────────┼────────────┼────────────────────────┼────────┼─────────┼───────────────┤
│ 0       │ 1          │ 'sales_report'         │ 1      │ 3       │ 48000         │
│ 1       │ 1          │ 'sales_report_rebuilt' │ 2      │ 7       │ 112000        │
└─────────┴────────────┴────────────────────────┴────────┴─────────┴───────────────┘
make: *** [Makefile:102: replay] Error 1
La reconstruida tiene una orden más en el concierto 1: la que el consumidor original descartó. La diferencia no es un error de la reconstrucción; es la medida exacta de lo que el reporte original había perdido. Comparar una vista con su reconstrucción es una manera de auditar a un consumidor.
Idea clave. La cadena completa tiene tres eslabones, y cada uno responde a una de las preguntas de la semana 5. La outbox garantiza que el evento sale si y solo si la orden se guardó. El relay y el consumer con confirmación después del trabajo garantizan que llega al menos una vez. El consumidor idempotente garantiza que llegar más de una vez no cambia nada. Ninguno alcanza solo, y los tres juntos dan un efecto que ocurre exactamente una vez.
Event sourcing
En la primera sesión, el log de eventos era un canal: los eventos salían de
una tabla (orders) que seguía siendo la verdad. La segunda sesión empieza
dándole la vuelta: ¿y si la verdad fueran los eventos?
El estado como fold de los eventos
Una aplicación corriente guarda el estado actual y lo sobrescribe: la
orden 1 tiene status = 'refunded', y cómo llegó ahí no está en ninguna
parte. Con event sourcing se guarda la secuencia de eventos que
produjeron ese estado, y los eventos nunca se modifican ni se borran: solo se
agregan. El estado actual pasa a ser un dato derivado: se calcula aplicando
los eventos, en orden, desde un estado inicial.
Esa operación tiene nombre en programación funcional, fold, y es una línea. Si es el estado inicial y los eventos:
El ejemplo está en es/order.ts: una orden
con tres eventos posibles, SeatsReserved, OrderPaid y OrderRefunded.
/** Aplica un evento al estado. No valida nada: el evento ya ocurrió. */
export function apply(state: OrderState, event: OrderEvent): OrderState {
  switch (event.type) {
    case 'SeatsReserved':
      return { status: 'reserved', concertId: event.concertId, /* … */ totalCents: event.totalCents };
    case 'OrderPaid':
      return state.status === 'none' ? state : { ...state, status: 'paid' };
    case 'OrderRefunded':
      return state.status === 'none' ? state : { ...state, status: 'refunded' };
  }
}

export function fold(events: readonly OrderEvent[]): OrderState {
  return events.reduce(apply, INITIAL);
}
Los eventos se guardan en una sola tabla, es_events, con el agregado al que
pertenecen (la orden) y un número de versión dentro de él. make es registra
la vida de tres órdenes y muestra el log y la orden 1:
$ make es
== El log (es_events)
┌─────────┬──────────┬──────────────┬─────────┬─────────────────┐
│ (index) │ position │ aggregate_id │ version │ type            │
├─────────┼──────────┼──────────────┼─────────┼─────────────────┤
│ 0       │ 1        │ 'order-1'    │ 1       │ 'SeatsReserved' │
│ 1       │ 2        │ 'order-1'    │ 2       │ 'OrderPaid'     │
│ 2       │ 3        │ 'order-2'    │ 1       │ 'SeatsReserved' │
│ 3       │ 4        │ 'order-3'    │ 1       │ 'SeatsReserved' │
│ 4       │ 5        │ 'order-3'    │ 2       │ 'OrderPaid'     │
│ 5       │ 6        │ 'order-1'    │ 3       │ 'OrderRefunded' │
└─────────┴──────────┴──────────────┴─────────┴─────────────────┘
== La orden 1: su estado es el fold de su historia
…
  estado actual:     {"status":"refunded","concertId":1,"buyerEmail":"rosa.quispe@correo.pe","quantity":2,"totalCents":32000}
  estado en la v2:   {"status":"paid","concertId":1,"buyerEmail":"rosa.quispe@correo.pe","quantity":2,"totalCents":32000}
No existe una tabla de órdenes. El estado de la orden 1 se obtuvo leyendo sus tres eventos y aplicándolos. Y la última línea es lo que una tabla sobrescrita no puede dar: el estado en otro momento. Aplicar solo los dos primeros eventos dice cómo estaba la orden antes de la devolución.
Comandos y eventos
La distinción de la semana 5 se vuelve aquí estructura. Un comando es un
pedido (PayOrder) y se puede rechazar. Un evento es un hecho
(OrderPaid) y ya ocurrió: no se discute. El ciclo de una escritura es
siempre el mismo, y está en handle
(es/event-store.ts):
- Leer la historia del agregado y calcular su estado con
fold. - Decidir: dado ese estado, ¿el comando se puede cumplir? Aquí viven los invariantes (no se devuelve lo que no se pagó). Si no se puede, se rechaza y no se escribe nada.
- Si se puede, registrar los eventos que resultan.
== Un comando que se rechaza no deja evento
  rechazado: No se puede devolver una orden en estado reserved
  eventos de order-2: 1
¿Y si dos procesos deciden a la vez sobre la misma orden, los dos a partir de
la versión 1? Los dos intentarán escribir la versión 2, y la restricción
UNIQUE (aggregate_id, version) deja pasar a uno solo. Es el control de
concurrencia optimista de la semana 12, y la prueba dos decisiones tomadas
sobre la misma versión lo comprueba: el segundo OrderPaid choca, y la orden
no queda pagada dos veces.
Lo que da y lo que cuesta
Lo que da:
- Historia completa y auditable. No hay que agregar una tabla de auditoría que alguien puede olvidar actualizar: el registro es el sistema.
- El estado de cualquier momento, como en la salida de arriba.
- Vistas nuevas con eventos antiguos. Una pregunta que nadie previó (“¿cuánto tarda en promedio una orden en pasar de reservada a pagada?”) se responde recorriendo la historia que ya está guardada.
Lo que cuesta:
- Leer exige una vista. “¿Cuántas entradas pagadas tiene el concierto 1?”
no se responde con un
SELECTsobre el log sin recorrerlo entero. Hace falta una vista materializada, mantenida aparte: es la sección siguiente. - Los eventos son un contrato que vive para siempre. Un
SeatsReservedguardado hace tres años tiene que poder leerse con el código de hoy. Todo lo de la semana 9 sobre evolución de contratos se aplica, sin fecha de vencimiento. - Corregir es agregar. Un evento equivocado no se edita: se registra otro que lo compensa, como en contabilidad.
- Borrar datos personales es difícil. Si alguien pide que se eliminen sus datos, están repartidos en eventos que por diseño no se borran. Hay técnicas (guardar los datos personales aparte y referenciarlos), y todas complican el modelo.
- Es un modelo mental distinto para todo el equipo, y casi todas las herramientas (reportes, migraciones, soporte) suponen tablas con estado.
Trade-off. Event sourcing compra historia y capacidad de derivar datos a cambio de complejidad en las lecturas y de una obligación permanente con el formato de los eventos. Se justifica en dominios donde la historia es el negocio: contabilidad, pagos, inventario, todo lo que alguien va a auditar. La alternativa barata, cuando solo se quiere saber quién cambió qué, es una tabla de estado más una tabla de auditoría: da la historia para consultar, y no permite reconstruir el estado a partir de ella.
Error común. Aplicar event sourcing a todo el sistema. Se adopta por agregado, donde la historia importa: quizá los pagos de Tinkuy, no su catálogo de locales. Un sistema entero con event sourcing paga los costos de arriba en cada tabla para obtener el beneficio en dos.
CQRS
Dos modelos: escribir y leer
Escribir y leer piden cosas distintas del mismo dato. Para escribir conviene un modelo normalizado, que proteja los invariantes y no repita nada. Para leer conviene tener la respuesta casi hecha: la tabla del reporte con una fila por concierto, sin sumar nada en el momento.
CQRS (command query responsibility segregation) es separar los dos: las escrituras van a un modelo, y las lecturas a una o más vistas hechas para sus consultas, que se actualizan a partir de los cambios del primero. Sirve cuando leer y escribir tienen formas muy distintas (un reporte que cruza seis tablas) o cargas muy distintas (mil lecturas por cada escritura), y así cada lado se diseña y se escala por separado.
En el ejemplo, el modelo de escritura es el log es_events, y el de lectura
es la tabla es_concert_sales. Quien la mantiene es una proyección
(es/projection.ts): un proceso que lee
el log en orden y aplica cada evento a la vista. Guarda hasta dónde llegó en
una tabla de checkpoints, y actualiza la vista y el checkpoint en la misma
transacción: es, otra vez, el consumidor idempotente.
La vista va atrasada
El precio de CQRS se ve en la segunda mitad de make es. Las seis escrituras
ya están confirmadas, y la proyección todavía no corrió:
== La vista de lectura, antes de que corra la proyección
  eventos sin proyectar: 6
  (vacía)
== La proyección aplica cuatro eventos
  eventos sin proyectar: 2
┌─────────┬────────────┬──────────────────┬──────────────┬───────────────┐
│ (index) │ concert_id │ reserved_tickets │ paid_tickets │ revenue_cents │
├─────────┼────────────┼──────────────────┼──────────────┼───────────────┤
│ 0       │ 1          │ 3                │ 2            │ 32000         │
│ 1       │ 2          │ 1                │ 0            │ 0             │
└─────────┴────────────┴──────────────────┴──────────────┴───────────────┘
== La proyección se pone al día
  eventos sin proyectar: 0
┌─────────┬────────────┬──────────────────┬──────────────┬───────────────┐
│ (index) │ concert_id │ reserved_tickets │ paid_tickets │ revenue_cents │
├─────────┼────────────┼──────────────────┼──────────────┼───────────────┤
│ 0       │ 1          │ 3                │ 0            │ 0             │
│ 1       │ 2          │ 0                │ 1            │ 9000          │
└─────────┴────────────┴──────────────────┴──────────────┴───────────────┘
…
Tres momentos. Primero la vista está vacía, aunque las órdenes existen: quien lee no ve lo que se acaba de escribir. Después, a medio camino, la vista dice que el concierto 1 tiene 2 entradas pagadas y S/ 320 recaudados: era verdad hace dos eventos, y ya no (la orden 1 se devolvió). Al final, la vista está al día. Es consistencia eventual entre el lado que escribe y el lado que lee: si las escrituras se detienen, la vista termina coincidiendo, y mientras tanto va atrasada.
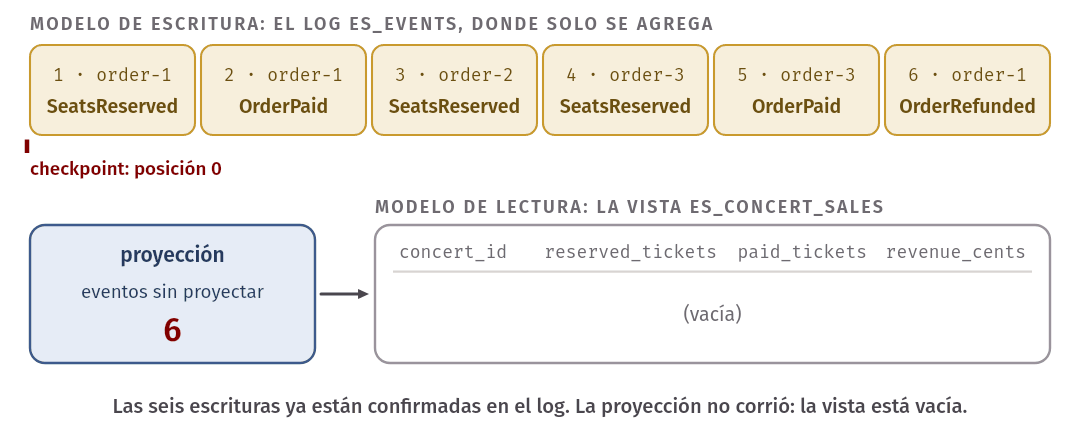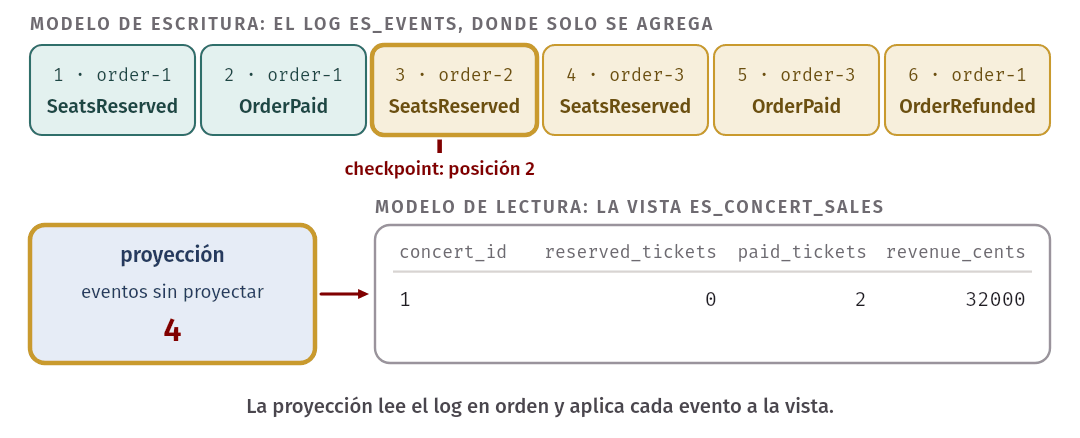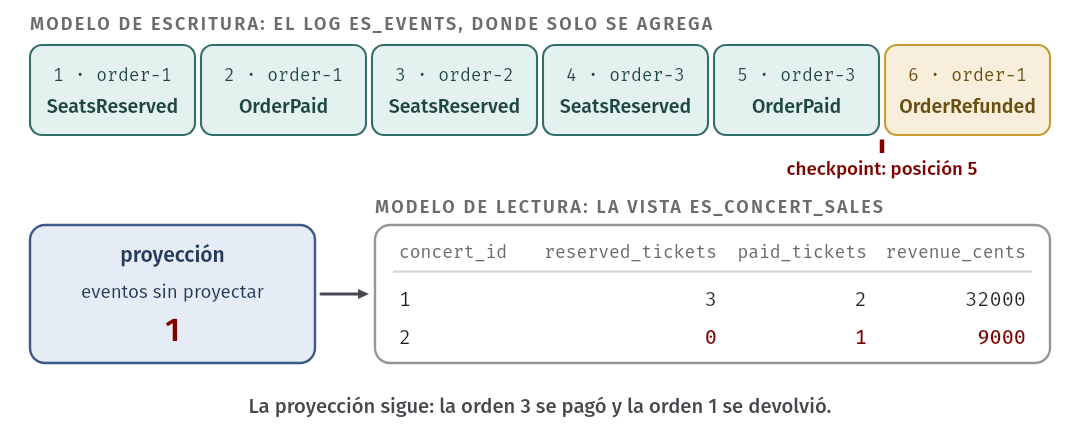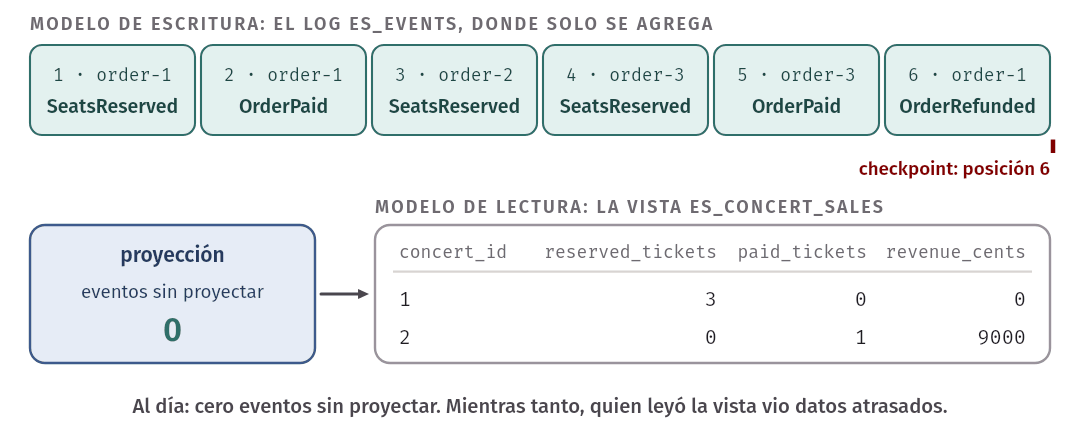
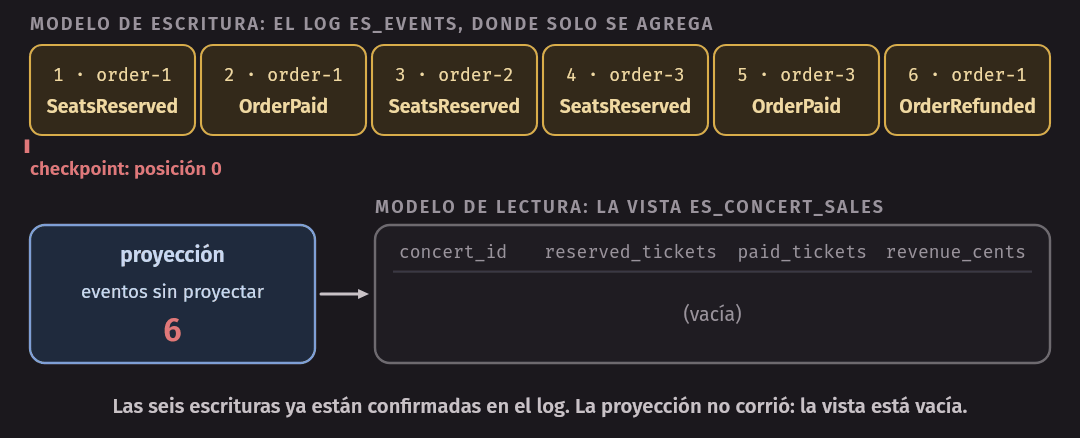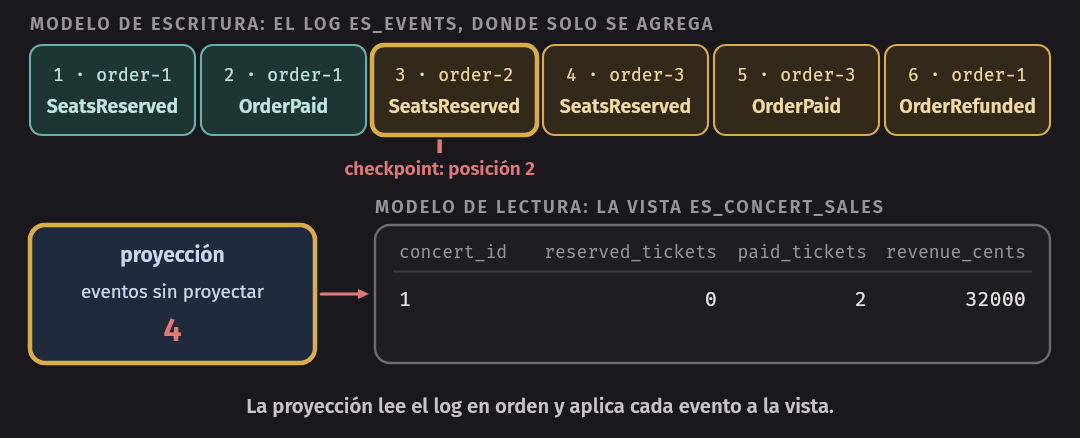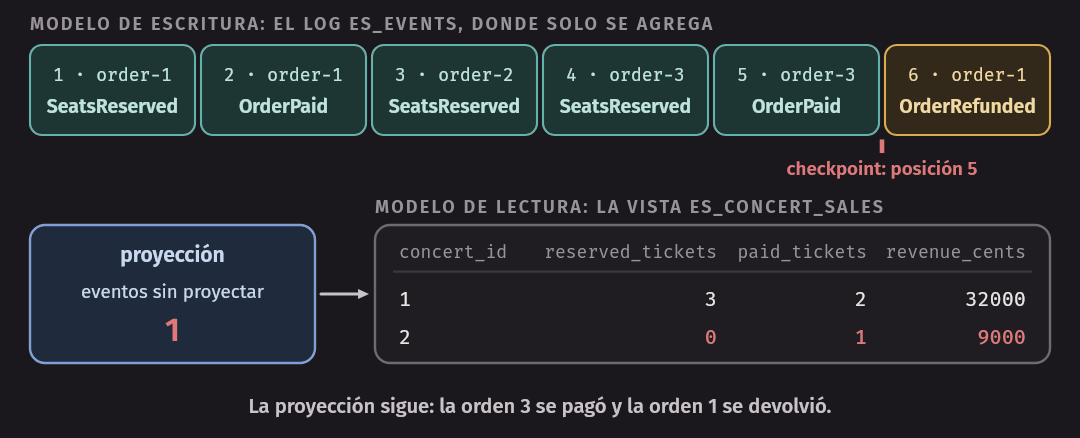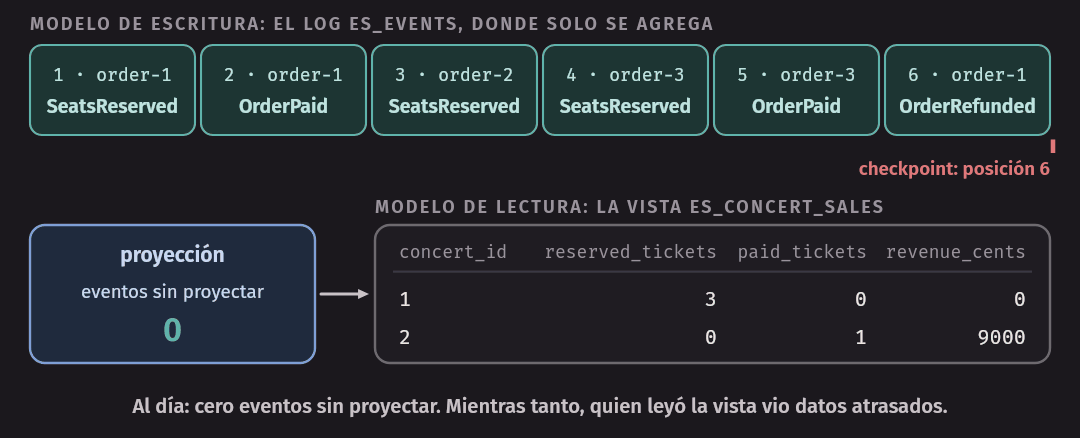
Es el mismo problema que el retraso de replicación de la semana 10, con otra causa. Allá, la réplica aplicaba el WAL del líder con retraso, y un comprador no encontraba la orden que acababa de crear. Aquí, la proyección aplica los eventos con retraso, y pasa lo mismo. Los remedios también son los de la semana 10: para lo que el propio usuario acaba de escribir, leer del lado de escritura (read-your-writes), o esperar a que la vista alcance la posición de esa escritura.
make es termina con la ganancia: borra la vista y la reconstruye desde
el primer evento, porque es un dato derivado. La prueba la vista reconstruida
desde el primer evento es igual a la que se mantuvo evento a evento lo
comprueba. Si mañana se necesita otra vista, se escribe otra proyección y se
la hace correr desde la posición 1.
Trade-off. CQRS da lecturas baratas, con la forma que cada consulta necesita y escalables por separado, a cambio de consistencia eventual entre escribir y leer, de código que mantiene cada vista y de un nuevo modo de falla: una proyección detenida deja una vista que responde, rápido y sin errores, con datos viejos. La alternativa, una sola tabla para las dos cosas, es consistente y simple, y alcanza mientras la consulta de lectura no sea el cuello de botella.
En la industria. Martin Fowler, que ayudó a difundir el patrón, lo presenta con una advertencia: para algunas situaciones la separación es valiosa, y para la mayoría de los sistemas CQRS agrega una complejidad riesgosa. Recomienda aplicarlo a partes concretas de un sistema y no al sistema entero. CQRS.
CQRS sin event sourcing
Las dos ideas se presentan juntas tan a menudo que parecen una. No lo son. Event sourcing obliga a tener vistas, así que casi siempre trae CQRS. Al revés no: se puede tener CQRS sin event sourcing, y es lo más frecuente. El modelo de escritura sigue siendo un conjunto de tablas corrientes con su estado, y una vista de lectura se alimenta con los eventos que salen de la outbox.
Ya lo construyeron en la primera sesión sin llamarlo así: orders es el
modelo de escritura, sales_report es una vista de lectura, y el consumidor
report es su proyección. La reconstrucción del paso 8 es la reconstrucción
de una vista.
En Tinkuy. El reporte de ventas del Tinkuy inicial es una consulta que agrupa órdenes, ítems, asientos y secciones cada vez que alguien lo pide, sobre las mismas tablas que usa la venta. La alternativa que esta semana pone sobre la mesa es una vista que se actualiza con cada
OrderPaid: leerla es unSELECTde pocas filas, no compite con la venta, y puede ir unos segundos atrasada. Si ese retraso es aceptable para quien organiza un concierto es una pregunta de requisitos, no de técnica.
Consistencia
La outbox, las proyecciones y las réplicas tienen algo en común: hay más de una copia de un dato, y las copias no coinciden en todo momento. Falta el vocabulario para decir cuánto pueden diferir.
Una palabra, varios significados
Consistencia es de las palabras más cargadas del área. En este curso ya apareció con dos sentidos distintos:
- La C de ACID (semana 12): que una transacción deje a la base de datos cumpliendo sus invariantes. Depende sobre todo de la aplicación.
- La consistencia entre réplicas (semana 10): que las copias de un dato coincidan.
El que nos interesa hoy es el segundo, visto desde quien lee: qué tan actual y coherente es lo que se lee de un sistema con varias copias. Hay una escala de garantías; estudiamos sus dos extremos.
Linealizabilidad
La garantía más fuerte es la linealizabilidad (linearizability). Un sistema es linealizable si se comporta como si hubiera una sola copia de los datos y cada operación ocurriera de golpe, en algún instante entre el momento en que se pidió y el momento en que se respondió.
La consecuencia práctica es una regla sobre el tiempo: una vez que alguien leyó un valor nuevo, nadie lee después uno viejo. Si la escritura que marca el asiento 14 como vendido ya terminó, toda lectura que empiece después ve el asiento vendido, la atienda la copia que la atienda.
Un sistema con un líder y una réplica asíncrona no lo cumple. Luis compra el asiento 14; el líder confirma. Ana consulta el líder y ve vendido. Un segundo después, Bruno consulta la réplica, que aún no aplicó el cambio, y ve disponible. Bruno leyó, después que Ana, un valor más viejo que el de Ana. Con una sola copia eso no podría pasar. Lo midieron en el laboratorio de la semana 10, con el programa que creaba una orden en el principal y la buscaba enseguida en la réplica.
Dos precisiones para no confundirla con sus vecinas:
- No es serializabilidad. Serializable (semana 12) habla de transacciones: el resultado equivale a ejecutarlas una tras otra, en algún orden. Linealizable habla de operaciones sobre un dato y del tiempo real: lo que terminó antes se ve antes. Un sistema puede ser lo uno sin lo otro.
- Consistencia eventual es el otro extremo: solo promete que, si dejan de llegar escrituras, las copias acabarán coincidiendo. No dice cuándo ni qué se ve mientras tanto.
Dónde hace falta de verdad. En los pocos lugares donde dos partes tienen que estar de acuerdo en un hecho único, ahora:
- Elegir un líder: dos nodos que creen ser líder a la vez es el split brain de la semana 10.
- Una restricción de unicidad: un asiento se vende una vez; un nombre de usuario lo tiene una persona. Si dos copias aceptan cada una “su” venta del asiento 14, no hay arreglo posterior que no perjudique a un comprador.
- Un lock distribuido: su única razón de existir es que lo tenga uno solo.
Dónde no: en casi todo lo demás. El catálogo de conciertos, el reporte de ventas, el saldo de puntos, el número de entradas que quedan como información (no como decisión de venta): un valor de hace dos segundos no rompe ningún invariante.
Lo que cuesta, y lo que dice el teorema CAP
La linealizabilidad se paga dos veces.
Latencia. Para que todas las copias se comporten como una, hay que coordinarlas en cada operación: la escritura no se confirma hasta que suficientes copias la tienen, y la lectura tiene que asegurarse de no estar viendo una copia atrasada. Eso son viajes de red en el camino de cada petición, todo el tiempo, haya fallas o no.
Disponibilidad. Supongan dos copias en dos centros de datos y que el enlace entre ellos se corta: una partición de red. Las dos copias siguen funcionando; solo no pueden hablarse. Llega una petición a la copia que quedó aislada. Tiene exactamente dos opciones:
- Responder con lo que tiene. Puede que la otra copia haya aceptado una escritura que esta no conoce: la respuesta puede ser vieja. Deja de ser linealizable.
- No responder (devolver un error, o esperar a que la red vuelva). Sigue siendo linealizable y deja de estar disponible.
No hay tercera opción: para dar la respuesta actual tendría que hablar con la otra copia, y no puede. Eso, y nada más, es lo que dice el teorema CAP: ante una partición de red, un sistema no puede ser a la vez linealizable (la C, consistency) y disponible (la A, availability, entendida como que todo nodo que no falló responde a toda petición que recibe).
Idea clave. El teorema CAP no es “elijan dos de tres”. Las particiones no se eligen: ocurren. Lo que se elige es qué hace cada parte del sistema mientras dura una partición: responder con riesgo de dar un valor viejo, o no responder.
Lo que el teorema CAP no dice
El teorema es correcto y estrecho, y casi todo lo que se le atribuye no está en él.
- No sirve para clasificar bases de datos en “CP” y “AP”. Sus definiciones son muy exigentes, y la mayoría de los sistemas reales no cumple ninguna de las dos. El caso más común: una base de datos con un líder y réplicas asíncronas. Un cliente que quedó separado del líder no puede escribir, así que no es disponible en el sentido del teorema; y si se permite leer de las réplicas, las lecturas no son linealizables. No es ni lo uno ni lo otro.
- No dice nada de la latencia, que es lo que casi siempre importa. Un sistema “disponible” en el sentido del teorema puede tardar lo que quiera en responder. Y en operación normal, sin partición, el trade-off que se paga a diario es otro: consistencia contra latencia. Se replica de forma asíncrona porque esperar a la otra copia es lento, no por miedo a una partición.
- Solo considera un tipo de falla, la partición de red, y un modelo mínimo: un solo dato que se lee y se escribe. No habla de transacciones, ni de nodos que se caen, ni de discos llenos.
- No obliga a una sola respuesta para todo el sistema. Distintas operaciones pueden elegir distinto: vender un asiento, no responder antes que arriesgar una doble venta; mostrar el catálogo, responder con lo que haya.
En la industria. Kleppmann recorre estos puntos uno por uno en la lectura de la semana, y los ilustra con ZooKeeper, un servicio de coordinación que usa consenso y que suele ponerse como ejemplo claro de “CP”. Por omisión, señala, sus lecturas no son linealizables (cada cliente lee del nodo al que está conectado, que puede ir atrasado), y los nodos del lado minoritario de una partición no pueden procesar escrituras: según las definiciones estrictas, no cumple ni una ni otra. Su conclusión es que esas dos etiquetas no describen sistemas y que conviene usar términos más precisos. Martin Kleppmann, Please stop calling databases CP or AP (2015).
Consenso
El problema
Varios de los problemas anteriores son el mismo. Elegir un líder: todos los nodos tienen que estar de acuerdo en quién es. Vender un asiento entre varias copias: todas tienen que estar de acuerdo en quién lo compró. Confirmar una transacción en varios nodos: todos confirman o ninguno. El problema común es el consenso: que varios nodos se pongan de acuerdo en un valor, de modo que la decisión sea una sola, no cambie después y se alcance aunque algunos nodos fallen.
En la práctica lo que se acuerda no es un valor suelto sino un orden de operaciones: un log replicado. Si todos los nodos aplican las mismas operaciones en el mismo orden, todos llegan al mismo estado. Es el mismo log de toda la semana, con una exigencia nueva: que varias máquinas estén de acuerdo en su contenido aunque alguna se caiga a la mitad.
Parece fácil y no lo es: los mensajes se pierden y se demoran, un nodo lento no se distingue de uno caído, y un nodo que se creía líder puede volver de una pausa sin saber que ya lo reemplazaron. Los algoritmos que lo resuelven, Paxos y Raft, llevan décadas de trabajo y son famosos por lo fácil que es implementarlos mal.
Mayorías
Lo que quien diseña necesita saber de esos algoritmos cabe en una idea: para avanzar necesitan una mayoría. Cada decisión (elegir un líder, aceptar una entrada en el log) requiere el voto de más de la mitad de los nodos. Con nodos, la mayoría es
y por tanto el grupo sigue funcionando mientras fallen, como máximo, nodos:
| Nodos | Mayoría | Fallas que tolera |
|---|---|---|
| 1 | 1 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
| 7 | 4 | 3 |
Con cinco nodos se toleran dos caídos. Un cuarto nodo no agrega tolerancia respecto de tres, y sí agrega una máquina que puede fallar: por eso los grupos de consenso tienen tamaño impar.
¿Por qué mayoría y no otra cosa? Porque dos mayorías del mismo grupo
siempre comparten al menos un nodo. Si una mayoría aceptó una decisión,
cualquier otra mayoría que se forme después incluye a alguien que la conoce,
y no puede decidir lo contrario. Es el mismo argumento de solapamiento de los
quórums de la semana 10. De ahí sale también lo que pasa en una partición:
si la red se parte en dos, a lo más un lado tiene mayoría. Ese lado sigue;
el otro, la parte minoritaria, se detiene. Por eso no hay split brain: no
pueden existir dos líderes elegidos por dos mayorías distintas del mismo
grupo. Las pruebas de
consensus/majority.test.ts
comprueban las dos afirmaciones por enumeración, para grupos de hasta siete y
nueve nodos.
Miren esto con el lente de la sección anterior: la parte minoritaria elige no responder. Un sistema basado en consenso paga la linealizabilidad con la disponibilidad de la minoría, exactamente como dice el teorema CAP.
El consenso se usa, no se implementa
Para quien diseña un sistema, la conclusión es práctica. El consenso no se
implementa: se usa, a través de un componente que ya lo resuelve y que
miles de equipos han probado antes: una base de datos que replica con
consenso, un servicio de coordinación como etcd o ZooKeeper, o el propio
broker. JetStream, en un cluster, replica cada stream con un grupo Raft: lo
que en el contenedor del curso es un solo proceso nats-server, en
producción son tres o cinco, y un mensaje publicado se confirma cuando una
mayoría lo tiene (documentación de NATS,
JetStream Clustering).
El sitio de Raft tiene una visualización donde se
pueden detener nodos y ver cómo se elige otro líder; diez minutos ahí valen
más que cualquier descripción.
La decisión de arquitectura no es cómo hacer consenso. Es qué datos lo necesitan, y mantenerlos pocos.
Error común. Pedir consistencia fuerte “por si acaso”. Cada dato que la exige ata la disponibilidad del sistema a la de un quórum: si la mayoría no está, ese dato no se puede leer ni escribir, y todo lo que dependa de él se detiene. Y lo paga en latencia en cada operación, también cuando nada falla. La pregunta correcta, dato por dato: ¿qué se rompe si alguien lee un valor de hace dos segundos? Si la respuesta es “nada”, no la necesita.
En Tinkuy. La disponibilidad de un asiento en el momento de venderlo necesita una sola verdad: es la restricción de unicidad de la semana 12, y la resuelve una sola base de datos con su líder. El listado de eventos, el mapa de asientos que se muestra antes de comprar y el reporte de ventas no la necesitan: pueden venir de una réplica, de una cache o de una vista atrasada. Si el mapa muestra libre un asiento que se acaba de vender, una venta que comprueba el asiento contra esa única verdad (lo que construyeron en P2) lo rechaza: el comprador ve un mensaje molesto y nadie pierde su entrada.
Diseñar con consistencia eventual
Elegir consistencia eventual para un dato no termina la decisión: la traslada a la interfaz. Si la vista puede ir atrasada, hay que decir qué ve el usuario mientras tanto.
“Su compra está en proceso; le avisaremos por correo cuando sus entradas estén listas” es una respuesta honesta: describe el estado real, y el comprador sabe qué esperar. Una pantalla que muestra un saldo de puntos de hace una hora, sin ninguna indicación, no lo es: el usuario cree estar viendo el presente.
Tres prácticas, todas baratas:
- Estados intermedios explícitos. La orden está
pending, no “todavía no aparece”. Los estados de la saga de la semana 12 sirven también para esto. - Decir de cuándo es el dato cuando puede ser viejo: “ventas hasta las 10:42”.
- Read-your-writes para quien acaba de escribir: que al menos el propio comprador vea su compra, aunque el reporte del organizador tarde un poco más.
El código de la semana
Todo está en code/week-13/ y se usa dentro del contenedor.
make crea la base de datos arq_w13 y borra el stream; el encabezado del
Makefile lista todos los objetivos.
| Carpeta | Qué tiene |
|---|---|
db/, shared/ |
El esquema; la conexión a PostgreSQL; todo lo que la semana sabe de NATS (bus.ts); el evento OrderPaid; los puntos de caída (crash.ts) |
errors/ |
Lo que está mal a propósito: la escritura doble y el consumidor de puntos sin idempotencia |
lab/ |
Los tres archivos que completan en el laboratorio (outbox.ts, relay.ts, points.ts), con sus pruebas |
consumers/ |
El consumidor del reporte (idempotente), la dead letter y la reconstrucción |
tools/ |
Los programas de los experimentos: una compra, el relay, un consumidor, las cuentas |
demos/ |
Las cuatro demostraciones de JetStream: demo-ack, demo-order, demo-max-deliveries, demo-limits |
es/, ordering/, consensus/ |
Event sourcing y la proyección; versiones contra el desorden; la aritmética de las mayorías |
test/ |
Las pruebas de lo que afirma este capítulo |
make test revisa los tipos y corre las pruebas de todo lo que ya está
completo; usa su propia base de datos y su propio stream, y no necesita nada
corriendo. Varias pruebas matan procesos de verdad, por eso tardan unos
segundos:
$ make test
…
ℹ tests 42
ℹ suites 0
ℹ pass 42
ℹ fail 0
make test-lab corre las pruebas de lab/. Con los archivos como vienen,
ocho de las once fallan; el laboratorio termina cuando pasan todas.
Laboratorio: outbox y consumidor idempotente con NATS JetStream
En parejas, dentro del contenedor, en code/week-13/. Empiecen con make.
Lleven una tabla con una fila por paso: qué esperaban ver, qué vieron y qué
garantía explica la diferencia.
- Primer contacto. Creen el stream
W13_ORDERSconnats stream add, publiquen tres mensajes connats puby léanlos con un consumer, como en NATS JetStream: un log que también sabe ser cola. Connats stream infoynats consumer info, ubiquen los mensajes guardados, los entregados y los pendientes de confirmación. Dejen un mensaje sin confirmar y esperen: ¿cuándo vuelve y con qué número de intento? - Log o cola. Dos consumers independientes (
make worker C=reader-ayC=reader-b), y después dos terminales con el mismo (C=shared). El paso muestra que el modelo lo decide la forma de leer, no el stream. - La escritura doble.
CRASH_BETWEEN=1 make dual-write N=100ymake counts. Repitan conCRASH_BETWEEN=0.5y conPUBLISH_FIRST=1. El paso muestra que ningún orden de las dos escrituras es correcto. - Outbox. Completen
lab/outbox.tsylab/relay.tshasta que pasen sus pruebas (make test-lab). Antes de escribir el relay, hagan la tabla de Lo que el relay garantiza: duplicados por su cuenta: qué queda si el proceso muere en cada línea. Después repitan el paso 3 conmake outboxymake relay-once: las cuentas deben coincidir. - Duplicados.
makede nuevo, tres compras,CRASH_AFTER_PUBLISH=1 make relay-once, y otra vezmake relay-once. ¿Cuántas veces está ese evento en el stream? ¿Qué garantía de entrega tiene su outbox? - Consumidor no idempotente.
make consumer C=points-naiveymake status: ¿cuántos puntos tiene la compradora y cuántos debería? Después hagan idempotentelab/points.ts, con el consumidor del reporte como modelo. Para repetir el experimento, vacíenloyalty_pointsy borren el consumerpointsconnats consumer rm. - Reintentos y dead letter.
POISON_ORDER=3 make consumer C=points: observen qué pasa con ese mensaje y con los siguientes, y miren el consumer conmake info. Después, conMAX_DELIVER=3. ¿Qué habría pasado con los mensajes 4 y 5 si el consumidor exigiera orden estricto? - Reprocesar.
make consumer C=report, y despuésmake replay. Comparen las dos tablas y leanconsumers/replay.ts. Escriban qué tendría que cumplir un consumidor para que reprocesarlo sea seguro, y digan si el consumidor de un correo de confirmación lo cumple.
La aplicación del laboratorio no es Tinkuy, y es a propósito: en P4 la técnica es la misma y las decisiones (qué eventos, qué consumidores, qué se hace con una dead letter de pagos) son suyas.
Resumen
- Un broker desacopla en el tiempo: el productor no necesita que el consumidor esté arriba ni que sea rápido. Cuesta un componente más, y que quien publica no sabe cuándo se procesó su mensaje. Toda cola tiene un límite: se elige descartar, o frenar al productor (backpressure).
- Cola: el broker reparte y borra; sirve para repartir tareas. Log: los mensajes se conservan y cada lector lleva su offset; sirve para el orden por clave, para varios lectores y para reprocesar. En JetStream lo decide cómo se lee: un consumer por sistema, varios procesos por consumer.
- Confirmar antes de procesar es at-most-once (se pierde); confirmar después, at-least-once (se repite). Exactly-once es un efecto: at-least-once más un consumidor idempotente. El broker no lo da solo.
- El orden solo está garantizado con un único lector y sin reintentos que se adelanten. Se diseña para el desorden: efectos conmutativos, versiones, o una clave de partición por entidad.
- La outbox convierte la escritura doble en una transacción local; el relay publica y después marca, y por eso duplica en vez de perder. El consumidor idempotente guarda el id del evento en la misma transacción que el efecto. Lo que agota sus entregas va a una dead letter que alguien mira.
- Event sourcing: el estado es el fold de eventos que no se modifican. CQRS: un modelo para escribir y vistas para leer, que van atrasadas. No van siempre juntos, y ninguno es un estilo por defecto.
- Linealizable: como si hubiera una sola copia. Cuesta latencia siempre y disponibilidad durante una partición; eso es lo que dice el teorema CAP, que no clasifica bases de datos. El consenso necesita una mayoría, se usa a través de un componente y se reserva para pocos datos.
Ejercicios
- Para cada caso, digan si conviene una cola o un log y qué propiedad lo decide: (a) generar el PDF de cada entrada vendida; (b) que el sistema de reportes, el de puntos y uno antifraude que todavía no existe conozcan cada compra; (c) actualizar el estado de una orden según sus eventos.
- Un consumidor tarda entre 10 y 40 segundos por mensaje y su consumer tiene
ack_waitde 30 segundos. Describan qué ocurre con un mensaje que tarda 35, qué venats consumer infoy dos maneras de evitarlo, con su costo. - Un stream recibe 500 mensajes por segundo durante la apertura de una venta y su consumidor procesa 200 por segundo. La apertura dura diez minutos. ¿Cuántos mensajes esperan al final y cuánto espera el último antes de procesarse? ¿Qué cambia si se agregan dos procesos al mismo consumer, y qué se pierde?
- En
errors/dual-write.ts, alguien propone envolver la publicación en untryy, si falla, borrar la orden. Encuentren el entrelazado en que esa versión deja una orden sin evento, y otro en que deja un evento sin orden. - El consumidor de correo envía el mensaje y después inserta el id del evento
en
processed_events. ¿En qué caída se repite el correo? ¿Se arregla invirtiendo el orden? Propongan un diseño y digan qué garantía alcanza. - Los eventos
OrderPaid(versión 1) yOrderRefunded(versión 2) de una orden llegan al consumidor de puntos, que suma 10 al pagar y resta 10 al devolver. ¿Importa el orden de llegada para el saldo final? ¿Y si la regla fuera “el saldo nunca baja de cero”? Relacionen su respuesta con las tres técnicas de Diseñar para el desorden. - Corran
make esy agreguen al agregado un comandoCancelReservation, válido solo en estadoreserved, con su evento. ¿Qué archivos cambian? ¿Qué le pasa a la proyección con los eventos que ya estaban guardados? - La vista
es_concert_salesva tres segundos atrasada. Para cada pantalla, digan si eso es aceptable y qué mostrarían: (a) el panel del organizador; (b) “sus entradas”, justo después de pagar; (c) el contador “quedan 12 entradas” en la página del concierto. - Clasifiquen estos datos de un sistema de venta de entradas según necesiten linealizabilidad o no, y digan qué se rompe con un valor de hace dos segundos: quién compró un asiento, el precio de una sección, el saldo de puntos al canjearlos, la lista de conciertos.
- Un cluster de cinco nodos con consenso queda partido en grupos de 3 y 2. ¿Qué puede hacer cada grupo? Repitan con seis nodos partidos en 3 y 3. ¿Qué dice el teorema CAP de cada grupo, y qué no dice?
- Alguien del equipo afirma: “usamos PostgreSQL con una réplica asíncrona, que es CP”. Escriban la respuesta, de tres o cuatro líneas, con un experimento del laboratorio de la semana 10 que la sostenga.