Apuntes · Capítulo 14Fallas, operación y evolución
Diseñar para las fallas: resiliencia y observabilidad
Diseñar para las fallas: resiliencia y observabilidad
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): Fallar es lo normal; de Lento es peor que caído, Una pasarela lenta en Tinkuy y La cadena completa; de Timeout, Toda llamada remota tiene un tiempo máximo; y de SLI, SLO y error budget, El error budget.
- En clase: Sesión A: Fallar es lo normal, Lento es peor que caído, El caso de la semana: una tienda y su courier, Timeout, Retry, Circuit breaker, Bulkhead y load shedding, Degradar y Comprobar que las defensas funcionan. Sesión B: Monitorear y observar, Logs estructurados, Métricas, Trazas y propagación del contexto, SLI, SLO y error budget, Alertas y health checks y Lo que cuesta observar. Laboratorio: Laboratorio: una pasarela de pagos lenta y caída, con Toxiproxy.
- Después de clase: el Resumen y los Ejercicios. Antes de empezar P5 vale la pena releer Todas las defensas, bajo la misma carga y Del log al SLI. Opcionales: Deadline propagado, El presupuesto de reintentos, Decisiones al diseñar un circuit breaker y El código de la semana.
Las tres semanas anteriores trataron de lo que pasa cuando una operación cruza de un sistema a otro: una transacción que ya no alcanza, una saga con sus compensaciones, mensajes que llegan dos veces o en desorden. En todas quedó pendiente la misma pregunta. En la semana 5 vimos que, ante una llamada remota sin respuesta, quien llama solo sabe que no sabe. En la semana 12, que una transacción que espera a un servicio externo retiene una conexión durante toda la espera, y el recuadro sobre Tinkuy terminaba con una advertencia: mientras la pasarela responde en 80 ms casi no se nota. Esta semana la pasarela deja de responder en 80 ms.
El capítulo tiene dos mitades, una por sesión. La primera es sobre resiliencia: qué le pasa a un sistema cuando una de sus dependencias se pone lenta, por qué eso es peor que si se cayera, y los cinco patrones con los que se diseña para que la falla de una parte no se lleve al resto: timeout, retry con backoff y jitter, circuit breaker, bulkhead y load shedding. Cada uno evita un problema y trae un riesgo, y los dos se van a ver medidos. La segunda mitad es sobre observabilidad: qué tiene que emitir un sistema para que se pueda entender qué le pasa (logs, métricas y trazas), y cómo se convierte “¿qué tan confiable tiene que ser?” en un número que se puede vigilar y negociar: el SLO y su error budget.
El problema lo vamos a ver en Tinkuy, tal como está hoy, con mediciones. Los remedios los vamos a estudiar en un sistema más pequeño, hecho para esta semana: una tienda en línea, Chaski, que le pide a un courier la tarifa de cada envío. Aplicarlos a Tinkuy es el trabajo de P5, que se publica esta semana.
Lectura. Sesión A: Michael Nygard, Release It! (2.ª ed.), cap. 4 Stability Antipatterns y cap. 5 Stability Patterns. Lecturas libres: Site Reliability Engineering, cap. 21, Handling Overload, y cap. 22, Addressing Cascading Failures; Marc Brooker, Exponential Backoff And Jitter (AWS, 2015). Complementarias: Martin Fowler, CircuitBreaker; Azure Architecture Center, Circuit Breaker, Bulkhead y Retry; Software Architecture in Practice, cap. 4 Availability, repaso de las tácticas; Principles of Chaos Engineering.
Sesión B: Site Reliability Engineering, cap. 4, Service Level Objectives, y cap. 6, Monitoring Distributed Systems; OpenTelemetry, Signals. Complementarias: The Site Reliability Workbook, cap. 2, Implementing SLOs; Software Architecture in Practice, cap. 5 Deployability y cap. 12 Testability. Para el laboratorio, Toxiproxy.
El código de este capítulo está en code/week-14/. Todas las salidas que se muestran son de ejecuciones reales en el contenedor del curso, en una laptop con Apple Silicon, dentro de Docker, mientras la máquina atendía otras cargas. Cada medición se repitió al menos tres veces; los números cambian de una corrida a otra y de una máquina a otra, y lo que se traslada es la comparación entre dos diseños medidos en la misma.
Fallar es lo normal
Faltas y fallas
Conviene separar dos palabras que en la conversación diaria se mezclan. Una falta (fault) es algo que sale mal dentro del sistema o en lo que lo rodea: un disco que se llena, un proceso que muere, un paquete que se pierde, un servicio externo que tarda. Una falla (failure) es lo que ve quien usa el sistema cuando este deja de hacer lo que debía: la compra que no se completa, la página que no carga.
La diferencia importa porque las faltas no se pueden evitar y las fallas, en buena parte, sí. La resiliencia es la capacidad de un sistema de seguir dando lo esencial mientras ocurren faltas, y de recuperarse solo cuando pasan. Se diseña, igual que el rendimiento o la modificabilidad: es la disponibilidad de la semana 2 vista desde adentro, y las tácticas de esta semana son las que hacen que una falta no se convierta en una falla.
Con muchas partes, alguna está fallando
En la semana 5 calculamos la disponibilidad de una cadena de llamadas síncronas: si un pedido necesita que respondan componentes, la cadena está disponible . Con diez componentes de 99,9 % cada uno:
Es decir, 99,0 %: diez partes que fallan una hora cada mil dan un sistema que falla diez. El cálculo supone que una parte caída tumba a todo el pedido, y esa suposición es la que esta semana vamos a romper.
Leída al revés, la cuenta dice otra cosa: en un sistema con cientos de procesos, discos y enlaces, el estado normal no es “todo funciona”, sino “algo está fallando ahora mismo, y casi nadie lo nota”.
Puntos de integración
Las faltas entran, sobre todo, por un lugar: cada llamada que sale del
proceso. Una consulta a la base de datos, un fetch a otro servicio, un
mensaje al broker. A cada uno se le llama punto de integración, y la
lista de puntos de integración de un sistema es la lista de lugares donde hay
que decidir qué pasa cuando el otro lado no se comporta.
Y el otro lado puede no comportarse de varias maneras, que quien llama ve de forma muy distinta:
| Lo que hace la dependencia | Lo que ve quien llama | Cuánto tarda en enterarse |
|---|---|---|
| Rechaza la conexión (el proceso no está) | Un error de conexión | Milisegundos |
| Responde con un error (un 503) | Una respuesta de error | Lo que tarda una respuesta |
| Corta la conexión a la mitad | Un error de conexión, sin saber si el pedido se procesó | Lo que haya tardado hasta el corte |
| Acepta la conexión y responde tarde | Nada, hasta que responde | Todo lo que tarde, si nadie pone un límite |
| Acepta la conexión y no responde nunca | Nada | Para siempre, si nadie pone un límite |
| Responde algo incorrecto con un 200 | Una respuesta que parece buena | No se entera |
Las tres primeras filas son fallas rápidas: el error llega pronto y quien llama puede decidir qué hacer. Las dos siguientes son fallas lentas, y son las que hacen daño. La última queda fuera de esta semana: contra una respuesta incorrecta solo sirve validar. En Tinkuy hay tres puntos de integración (PostgreSQL, la pasarela de pagos y el servidor de correo), y ninguno tiene hoy una decisión tomada sobre qué pasa si tarda.
Lento es peor que caído
Una pasarela lenta en Tinkuy
Empecemos por medir. El código de la semana trae un Makefile que copia
Tinkuy a build/tinkuy (el original no se toca) y lo levanta con una pieza
nueva en medio: Toxiproxy, un proxy TCP al que se le puede pedir que
estropee las conexiones que pasan por él. Tinkuy cree que habla con la
pasarela; en realidad habla con el proxy, que le pasa todo a la pasarela.
Eso hace make tinkuy-up, y Tinkuy no cambia en nada: lee la dirección de la
pasarela de la variable GATEWAY_URL (está en src/config.ts), y el script
lo arranca con GATEWAY_URL=http://localhost:4001, el puerto del proxy.
make tinkuy-load corre a la vez las dos pruebas de carga que ya conocen,
durante 30 segundos: load/sale.js (200 compradores sobre el evento 1) y
load/browse.js (hasta 50 personas mirando el catálogo). Mientras corren,
anota cada dos segundos en qué estado están las conexiones a PostgreSQL.
Primero, con la pasarela sana:
$ make tinkuy-load
== Compras (load/sale.js)
    orders_error...................: 101    3.206712/s
    orders_paid....................: 1360   43.179493/s
    http_req_duration..............: avg=122.25ms min=5.28ms   med=67.57ms p(90)=304.59ms p(95)=375.21ms p(99)=533.26ms max=831.76ms
    http_req_failed................: 1.86%  101 out of 5417
== Catálogo (load/browse.js)
    ✗ GET /events responde 200
      ↳  99% — ✓ 521 / ✗ 2
    …
    duration_events_list...........: avg=568.7ms  min=59.53ms med=428.74ms p(90)=1.08s    p(95)=2.07s    p(99)=2.26s    max=2.37s
    http_req_failed................: 0.12%  2 out of 1569
== Conexiones a PostgreSQL durante la carga (una fila cada 2 s)
   hora   | idle_in_transaction | active | total | max_connections
 07:04:11 |                   0 |      1 |     1 | 100
 07:04:13 |                  21 |      2 |    23 | 100
 07:04:15 |                  17 |      1 |    20 | 100
 …
No es una línea de base limpia, y ya lo sabían: con 200 compradores, el Tinkuy inicial roza el límite de conexiones de PostgreSQL y pierde algunas compras (aquí, el 1,86 %). Pero el catálogo responde casi siempre, y las conexiones ocupadas se mueven entre 20 y 50 de las 100 que PostgreSQL acepta.
Ahora, el tóxico. Una sola orden le dice al proxy que demore 5 segundos todo lo que la pasarela responda:
$ make tinkuy-slow
toxiproxy-cli toxic add -t latency -a latency=5000 gateway
Added downstream latency toxic 'latency_downstream' on proxy 'gateway'
La pasarela sigue viva, acepta cada conexión y aprueba cada cobro. Solo tarda. Y la misma carga da esto:
$ make tinkuy-load
== Compras (load/sale.js)
    orders_error...................: 2424   66.739593/s
    orders_paid....................: 594    16.354504/s
    http_req_duration..............: avg=995.96ms min=545.08µs med=2.33ms p(90)=5.26s p(95)=5.34s p(99)=5.44s max=5.59s
    http_req_failed................: 75.34% 2424 out of 3217
== Catálogo (load/browse.js)
    ✗ GET /events responde 200
      ↳  6% — ✓ 50 / ✗ 672
    …
    duration_events_list...........: avg=56.09ms min=554.37µs med=2.39ms  p(90)=179.7ms  p(95)=313.43ms p(99)=662.94ms max=1.05s
    http_req_failed................: 85.59% 1854 out of 2166
== Conexiones a PostgreSQL durante la carga (una fila cada 2 s)
   hora   | idle_in_transaction | active | total | max_connections
 07:04:44 |                   0 |      1 |     1 | 100
 07:04:46 |                  99 |      1 |   100 | 100
 07:04:48 |                  99 |      1 |   100 | 100
 …
Tres de cada cuatro compras fallan, lo que se podía esperar. Lo que no se
esperaba está en el segundo bloque: GET /events, que no llama a la
pasarela, que no cobra nada, que solo lee el catálogo, pasó de fallar 2 veces
de 523 a fallar 672 veces de 722. Hicimos cada medición cuatro veces. Con la
pasarela lenta, el catálogo perdió entre el 78 % y el 87 % de sus pedidos.
Con la pasarela sana perdió el 1 % o menos en tres corridas y el 13 % en la
otra, que coincidió con un momento de más carga en la máquina: la línea de
base de este Tinkuy es frágil, pero está lejos de lo que pasa con el tóxico.
El log de Tinkuy dice con qué error. En esa sesión, POST /orders respondió
5 074 veces 500 error: sorry, too many clients already, y los tres
endpoints del catálogo, entre 1 199 y 1 325 veces cada uno, con el mismo
mensaje.
La cadena completa
La tabla de conexiones cuenta la historia. Con la pasarela lenta hay 99
conexiones en el estado idle in transaction, y la número 100 es el propio
psql que las está contando. Ese estado significa que la conexión tiene una
transacción abierta y no está ejecutando nada: PostgreSQL está esperando a
que la aplicación le mande la siguiente sentencia. Y la aplicación no se la
manda porque está esperando a otro. Este es el tramo de createOrder que lo
explica, tal como está en src/orders/create-order.ts:
  const outcome = await withClient<Outcome>(async (client) => {
    await client.query('BEGIN');
    try {
      const seats = await findSeatsForSale(client, input.seatIds);
      // … valida los asientos, inserta la orden y sus ítems …

      const result = await charge({
        amountCents: totalCents,
        reference: `orden-${order.id}`,
        payment: input.payment,
      });
      await insertPayment(client, { /* … */ });
      // … marca los asientos, emite las entradas, envía el correo …
      await client.query('COMMIT');
La cadena, paso a paso:
- Una compra abre una conexión a PostgreSQL, hace
BEGIN, inserta la orden y llama acharge, que hace unfetcha la pasarela. - La pasarela tarda 5 segundos. Durante esos 5 segundos, la compra no hace
nada: tiene una conexión abierta, con una transacción abierta, esperando.
El
fetchdechargeno tiene tiempo máximo, así que esperaría igual 50 segundos. - Mientras tanto siguen llegando compras. Cada una abre su conexión y se queda en el mismo punto. Con 200 compradores, en menos de dos segundos hay 99 conexiones detenidas ahí.
- PostgreSQL acepta 100 conexiones (
max_connections). La siguiente recibesorry, too many clients already. GET /eventsnecesita una conexión para leer los eventos. No la hay. Tinkuy responde 500.
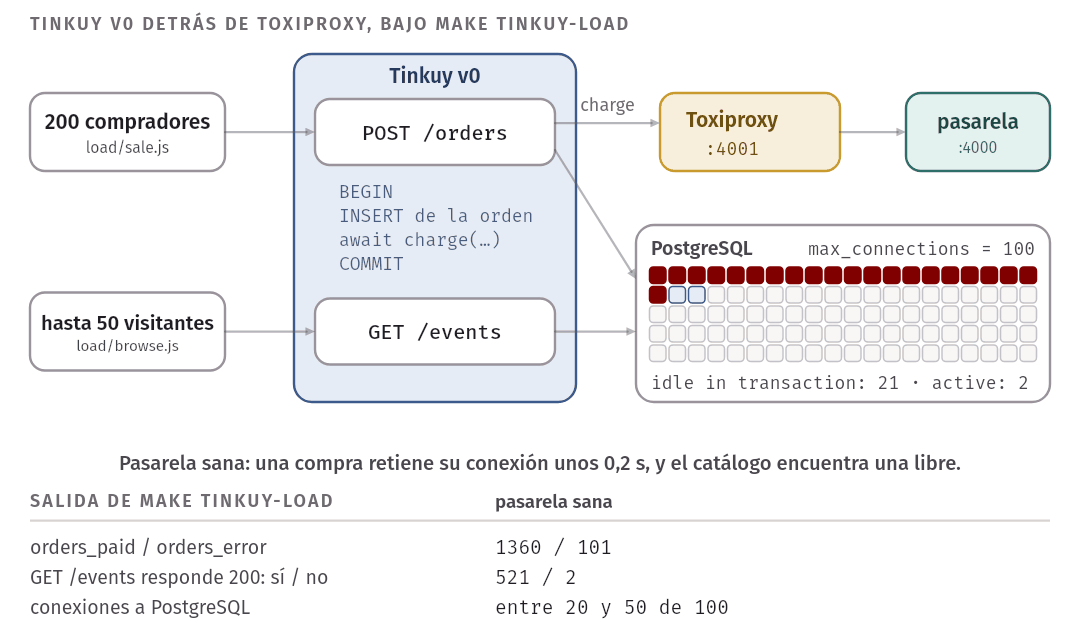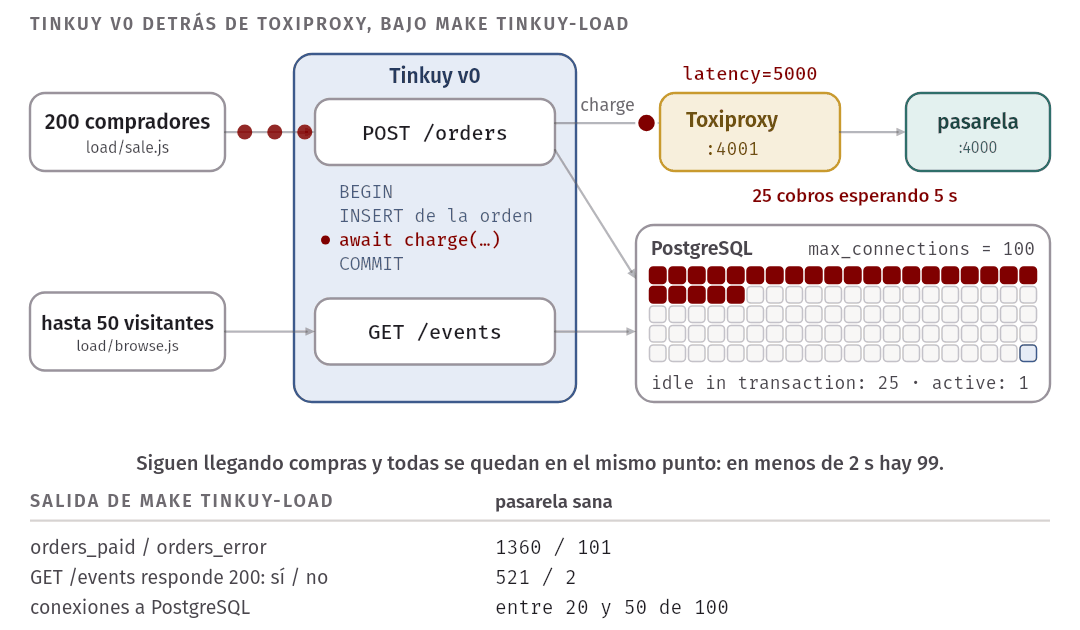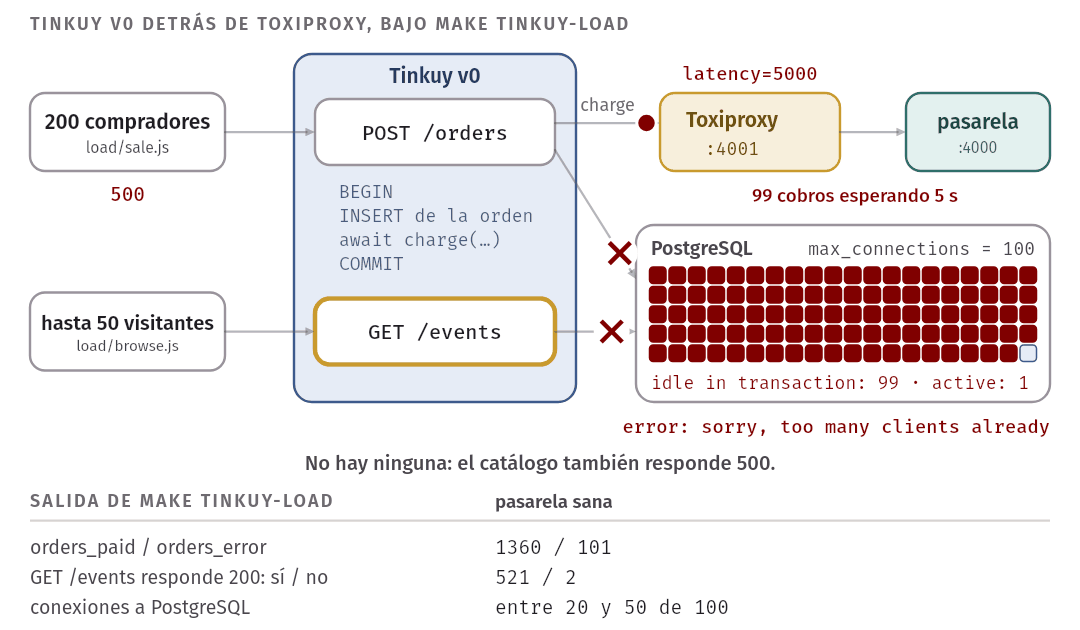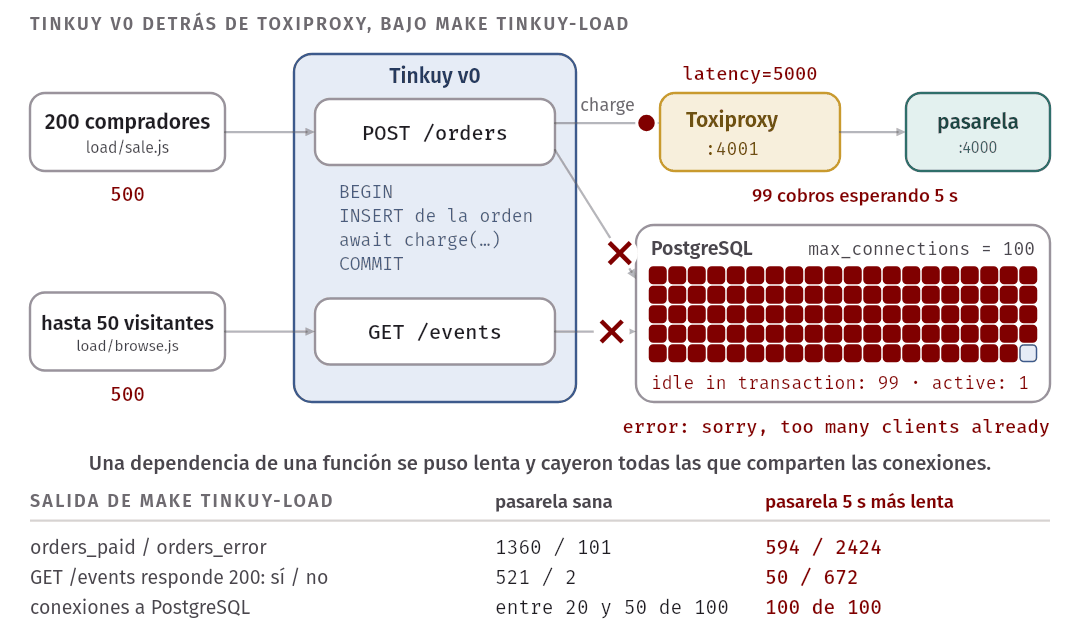
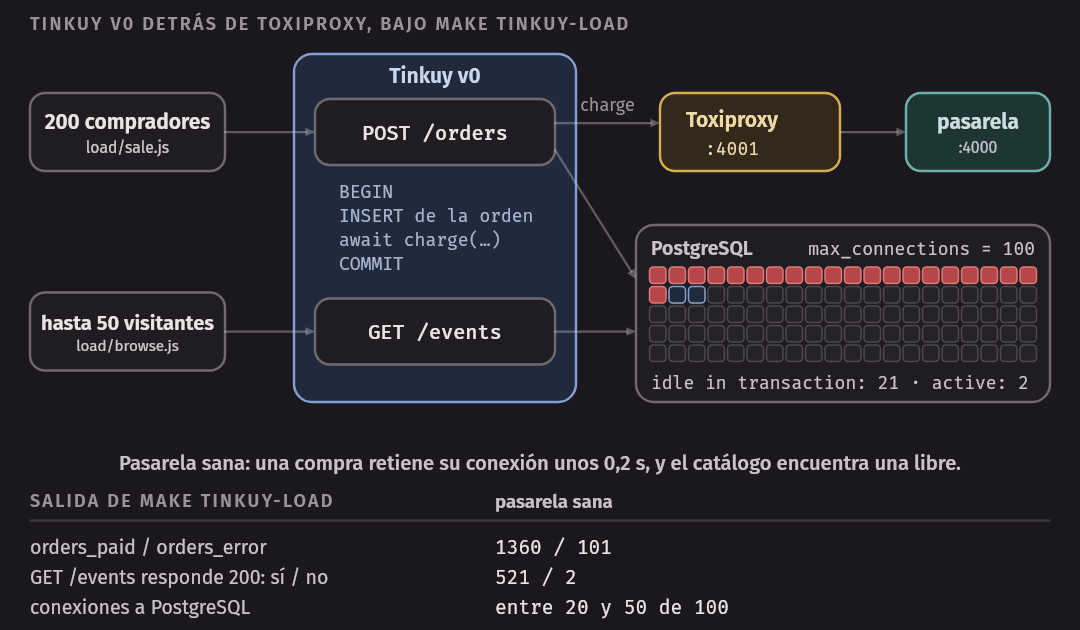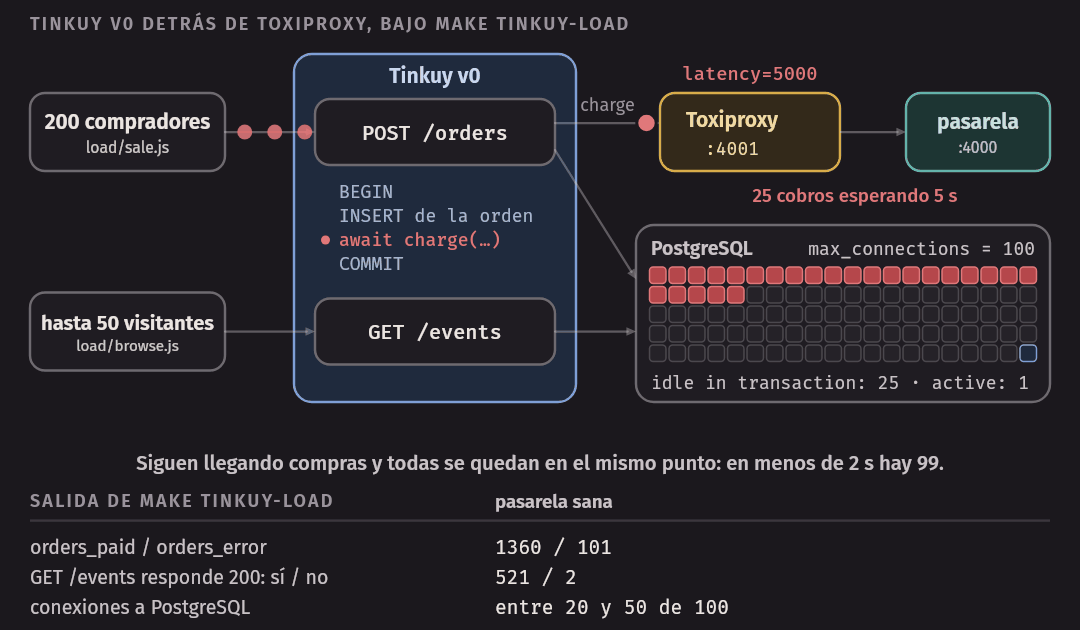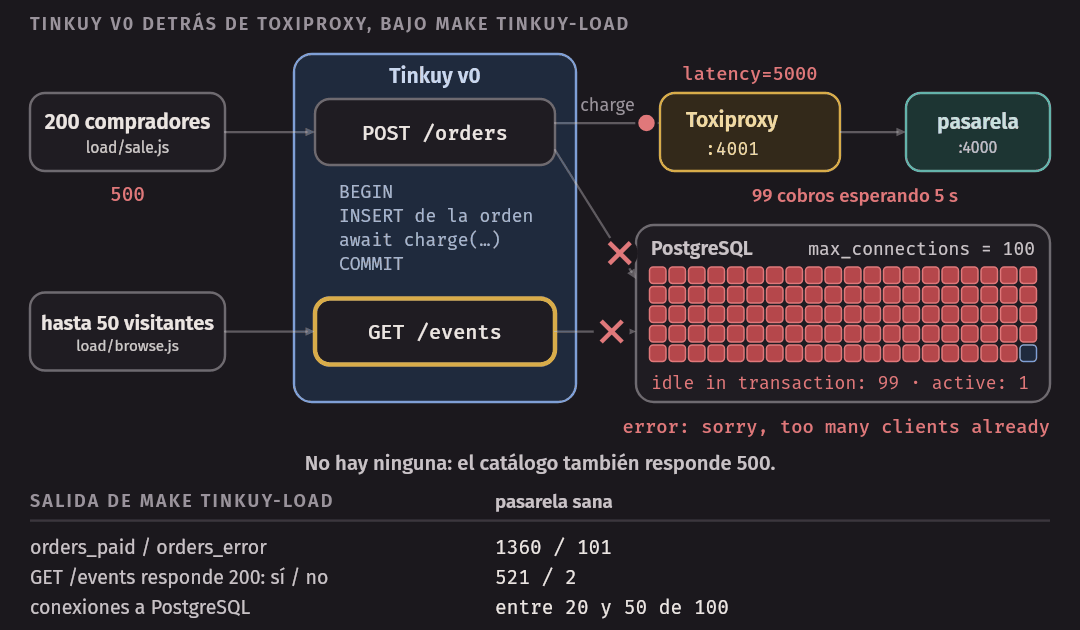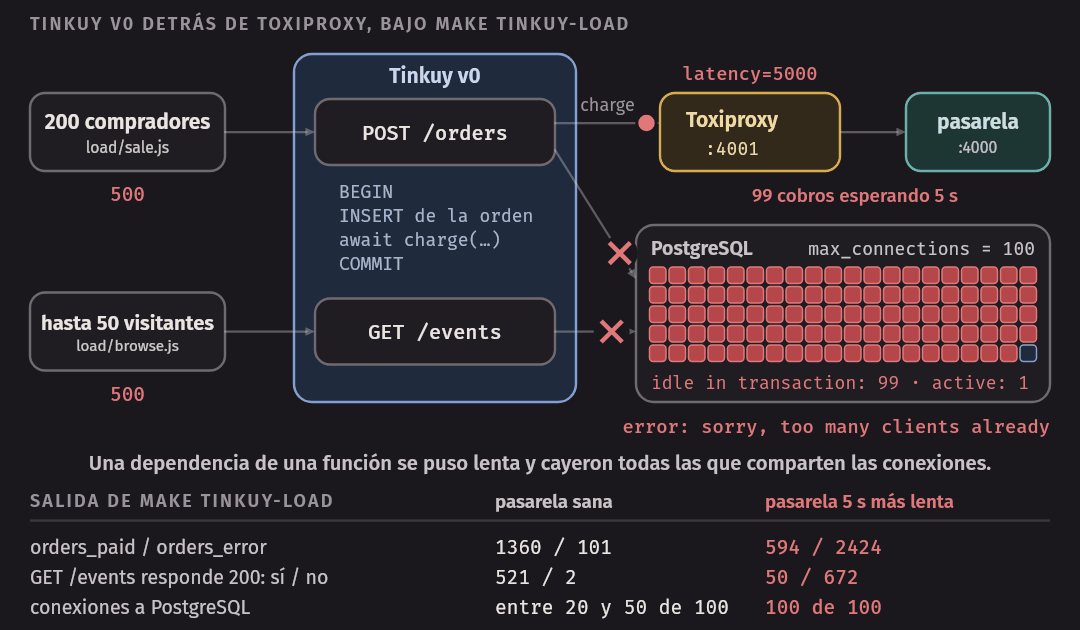
Una dependencia de una función se puso lenta, y se cayeron todas las que comparten un recurso con ella. Ese recurso compartido, aquí las conexiones a PostgreSQL, es el camino por el que se propaga la falla.
Comparen con lo que habría pasado si la pasarela se hubiera caído del todo.
Cada fetch habría fallado en un par de milisegundos, la transacción habría
hecho ROLLBACK y la conexión se habría liberado. Las compras habrían
fallado todas, y el catálogo ni se habría enterado.
Idea clave. Una dependencia caída libera a quien la llama en milisegundos. Una dependencia lenta lo retiene, y con él retiene todo lo que tenía tomado en ese momento: una conexión, una transacción, memoria, un lugar en una cola. Por eso lento es peor que caído.
Hay una cuenta sencilla detrás. Si llegan pedidos por segundo y cada uno retiene un recurso durante segundos, en promedio hay
recursos ocupados a la vez (es la ley de Little, de la teoría de colas). La dependencia lenta no cambia : cambia . En Tinkuy, una compra retiene su conexión mientras cobra y envía el correo, unos 0,2 s; con el tóxico, más de 5 s. se multiplica por unas 25, y con él la cantidad de conexiones que hacen falta para la misma carga. Ningún límite está dimensionado para eso.
Miren también un detalle de la segunda medición que engaña: la mediana de
GET /events bajó, de 428 ms a 2,39 ms. El catálogo no mejoró; es que
casi todos sus pedidos fallan, y fallar es rápido. Quien mire solo la
latencia verá un sistema más veloz que nunca. Volveremos a esto al hablar de
qué medir.
En Tinkuy. En el Tinkuy inicial la falla del catálogo es un error rápido, un 500, porque no hay pool: cada consulta abre su conexión y PostgreSQL la rechaza en el acto. Si su Tinkuy ya tiene un pool de conexiones, van a ver el otro síntoma, el que describe la guía de la semana: los pedidos del catálogo no fallan, esperan a que alguien devuelva una conexión, y el catálogo deja de responder. Es la misma falla con otra cara, y es la que vamos a ver en el caso de la semana.
Falla en cascada
Lo que acaban de ver tiene nombre: falla en cascada (cascading failure). Es una falla que crece con el tiempo porque se alimenta a sí misma: una parte del sistema falla, y eso aumenta la probabilidad de que fallen otras.
En Tinkuy la cascada tuvo un solo escalón, de la pasarela al catálogo. En un sistema con más servicios sigue subiendo: quien llame a Tinkuy sin tiempo máximo se queda esperando con sus propios recursos tomados, y quien lo llama a él, igual. La falla sube desde la dependencia más lenta hasta el usuario, y en cada capa se lleva funciones que no tenían nada que ver.
La otra forma clásica es por carga: de cuatro instancias cae una, su tráfico se reparte entre las tres que quedan, una de ellas no aguanta, y las dos restantes reciben el doble de lo normal. El mecanismo es el mismo, una realimentación positiva, y las defensas también.
El caso de la semana: una tienda y su courier
Para estudiar los remedios sin tocar Tinkuy usamos un par de servicios pequeños, en code/week-14/chaski/:
- El courier (
courier.ts) es la dependencia. Calcula la tarifa de un envío (GET /rates) y tarda unos 40 ms. Cuenta cada pedido que recibe, para poder comparar lo que la tienda cree que pidió con lo que de verdad llegó. - La tienda (
shop.ts) es quien llama. Tiene un catálogo (GET /products), que solo usa PostgreSQL, y cotiza envíos (POST /quotes): lee el producto, le pide la tarifa al courier y guarda la cotización. Usa un pool de 10 conexiones.
Entre los dos va un proxy de Toxiproxy, igual que en Tinkuy. Y la tienda, sin defensas, tiene el mismo defecto: llama al courier con una transacción abierta y sin tiempo máximo.
    const client = await pool.connect();
    try {
      await client.query('BEGIN');
      const product = (await client.query<{ weight_grams: number }>(select, [productId])).rows[0];
      if (!product) throw new InvalidInput(`No existe el producto ${String(productId)}`);
      const shipping = await shippingFor(district, product.weight_grams, context);
      const saved = await client.query<{ id: string }>(insert, [productId, district, shipping.cents, shipping.estimated]);
      await client.query('COMMIT');
Cada defensa de este capítulo es una opción de la tienda que se enciende con
una variable de entorno, para poder medir qué aporta cada una por separado.
La carga es siempre la misma, load/mixed.js:
40 usuarios que piden cotizaciones y 10 que miran el catálogo, durante 15
segundos. make cascade levanta todo, corre la carga para cada variante y
resume cada ruta en una línea (V= elige variantes; todos los bloques del
capítulo son de una misma corrida completa). Estas son las dos primeras: el
courier sano y el courier 5 segundos más lento, ambos sin defensas.
$ make cascade V="healthy none"
== healthy
POST /quotes    201: 1110   503: 0   otros: 0   p50 45 ms   p95 51 ms   máx 342 ms
GET  /products  200: 730   otros: 0   p50 1 ms   p95 16 ms   máx 267 ms
== none
POST /quotes    201: 40   503: 0   otros: 10   p50 15186 ms   p95 19998 ms   máx 19998 ms
GET  /products  200: 20   otros: 0   p50 12550 ms   p95 14979 ms   máx 14985 ms
Con el courier sano, una cotización tarda 45 ms y el catálogo, 1 ms. Con el courier lento, 10 cotizaciones retienen las 10 conexiones del pool y todo lo demás hace cola detrás: el catálogo pasa de 1 ms a más de 12 segundos de mediana, y solo se atendieron 20 de sus pedidos, contra 730. Los 10 “otros” son pedidos que k6 abandonó a los 20 segundos sin respuesta. Es la cascada de Tinkuy con el síntoma del pool: nadie recibe un error, todos esperan.
Timeout
Toda llamada remota tiene un tiempo máximo
El primer remedio es el más simple y el que más se olvida: decidir cuánto se está dispuesto a esperar. Un timeout es el tiempo máximo que quien llama espera una respuesta; cumplido ese tiempo, deja de esperar y trata la llamada como fallida.
Sin timeout, quien decide cuánto dura una llamada es el otro. Y entonces la capacidad del sistema, cuántos pedidos puede tener en curso, deja de depender de sus propios recursos y pasa a depender de su dependencia más lenta. Es lo que dice : sin un tope para , no hay tope para .
fetch no tiene tiempo máximo por omisión. En Node.js se le pone con una
señal de cancelación, AbortSignal.timeout
(resilience/timeout.ts):
export async function fetchWithTimeout(url: string, init: RequestInit, timeoutMs: number): Promise<Response> {
  try {
    const signal = timeoutMs > 0 ? AbortSignal.timeout(timeoutMs) : undefined;
    return await fetch(url, { ...init, signal });
  } catch (error) {
    if (error instanceof Error && error.name === 'TimeoutError') throw new TimeoutError(timeoutMs);
    // Conexión rechazada o cortada: fetch dice "fetch failed" y guarda la causa.
    const cause = error instanceof Error && error.cause instanceof Error ? error.cause.message : String(error);
    throw new DependencyError(`No se pudo completar la llamada (${cause})`);
  }
}
AbortSignal.timeout(1000) crea una señal que se dispara al segundo; cuando
se dispara, fetch rechaza con un error de nombre TimeoutError y cierra el
socket. La función traduce los dos finales malos a dos errores propios,
porque quien llama necesita distinguirlos. Y recuerden la semana 5: un
timeout no cancela nada del otro lado. Protege a quien llama, no a quien es
llamado.
Lo que cambia, medido
La misma carga y el mismo courier lento, ahora con un tiempo máximo de un
segundo en la llamada (SHOP_TIMEOUT_MS=1000):
$ make cascade V=timeout
== timeout (SHOP_TIMEOUT_MS=1000)
POST /quotes    201: 0   503: 0   otros: 180   p50 3520 ms   p95 4014 ms   máx 4040 ms
GET  /products  200: 59   otros: 0   p50 2810 ms   p95 2828 ms   máx 3788 ms
Tres cosas, y ninguna es la que uno espera de “poner un timeout”:
- Ninguna cotización salió bien. Las 180 respondieron 504. Es correcto: si el courier tarda 5 segundos y la tienda espera uno, no hay cotización posible. El timeout cambia una espera larga por un error.
- El error no llegó al segundo, sino a los 3,5. Cada cotización esperó primero una conexión del pool y recién después su segundo de timeout.
- El catálogo mejoró, de 12 segundos a 2,8, y sigue mal. Las conexiones se retienen un segundo en vez de cinco, y siguen sin alcanzar.
El timeout puso un tope a . No cambió el hecho de que, mientras se espera
al courier, hay una conexión a la base de datos ocupada sin hacer nada. Eso
se arregla de otra manera: no esperando a la red con una transacción abierta.
Es la regla de la semana 12, y en la tienda es otra opción
(SHOP_OUTSIDE_TX=1): pedir la tarifa antes de tomar la conexión, y usar
la base de datos solo para leer el producto y para guardar el resultado.
$ make cascade V=outside-tx
== outside-tx (SHOP_OUTSIDE_TX=1)
POST /quotes    201: 120   503: 0   otros: 0   p50 5063 ms   p95 5099 ms   máx 5102 ms
GET  /products  200: 750   otros: 0   p50 1 ms   p95 3 ms   máx 38 ms
Sin ningún timeout, el catálogo volvió a 1 ms. Las cotizaciones tardan sus 5 segundos, pero ya no retienen nada que el catálogo necesite. Esta variante corta el camino de la cascada; el timeout solo lo acortaba.
Trade-off. Sacar la llamada de la transacción cuesta atomicidad. En la tienda no importa: pedir una tarifa es una lectura. Cuando la llamada cambia algo del otro lado (un cobro), ya no hay una transacción que cubra las dos cosas, y hace falta lo de la semana 12: estados intermedios, compensaciones y una clave de idempotencia. La alternativa, dejarla dentro con un timeout corto, conserva la simplicidad y deja el recurso compartido expuesto durante ese tiempo.
Las dos cosas se necesitan. Fuera de la transacción y sin timeout, la tienda sigue acumulando pedidos en curso mientras el courier esté lento, y el recurso que se agota ya no es el pool: es el proceso.
Cómo se elige el valor
Un timeout demasiado corto corta llamadas que iban a salir bien: convierte la cola normal de la latencia en errores. Uno demasiado largo no protege. Se elige mirando dos números, y ninguno se inventa:
- Por abajo, la latencia normal de la dependencia, en un percentil alto. Si el p99 del courier es 80 ms, un timeout de 100 ms cortará a más del 1 % de las llamadas sanas en cuanto haya un poco de ruido. Un margen de varias veces el p99 deja pasar la cola normal.
- Por arriba, lo que la respuesta todavía vale. Si quien pidió la cotización se va de la página a los 3 segundos, esperar 10 al courier es trabajar para nadie. Y más arriba todavía está el límite de recursos: con un timeout y llamadas por segundo, una dependencia colgada retiene llamadas a la vez.
Entre esos dos números hay casi siempre un rango amplio. En la tienda, el courier sano responde en unos 45 ms y pusimos 1 000 ms: muy holgado por abajo, y aceptable por arriba solo porque otras defensas limitan cuántas llamadas pueden estar esperando.
Error común. Subir el timeout “para que no falle”. Si las llamadas están dando timeout es porque la dependencia tarda más de lo que se decidió esperar; subir el límite no la acelera. Se cambia un error rápido por uno lento, que es peor: cada llamada retiene sus recursos más tiempo, y la cascada llega antes. La variante
long-timeout, con un tiempo máximo de 10 segundos para un courier que tarda 5, dio lo mismo que no tener timeout: 40 cotizaciones en 15 segundos y el catálogo con una mediana de 10 segundos. “No falla” quería decir “falla más tarde, y junto con todo lo demás”.
Deadline propagado
Un timeout por llamada no basta cuando hay varias en cadena. Supongan que el navegador espera 3 segundos, que la tienda ya gastó 2,7, y que ahora llama al courier con su timeout de siempre, 2 segundos. A los 300 ms el usuario ya se fue; la tienda y el courier trabajan 1,7 segundos más para nadie.
La solución es que el límite sea de la petición. Un deadline es el instante en que la respuesta deja de servir; se fija una vez, donde entra la petición, y viaja con ella. Cada servicio calcula cuánto queda y no espera más que eso:
donde es el timeout que ese servicio usaría por su cuenta
y es el deadline. En el ejemplo, ms. Y si la
resta da cero o menos, la llamada ni se hace. Es la función
remainingBudget de
resilience/timeout.ts.
La tienda lee el tiempo que le queda a quien la llama de una cabecera,
x-deadline-ms, y lo respeta: una de las pruebas le manda una cotización con
150 ms de plazo, con el courier tardando 3 segundos y un timeout propio de
2,5, y la tienda responde 504 a los 150 ms, no a los 2,5 segundos. HTTP no
tiene una cabecera estándar para esto; gRPC sí lo trae en el protocolo.
Es lo que recomienda el capítulo 22 del libro de SRE de Google, Addressing Cascading Failures: fijar el deadline arriba y propagarlo, en vez de inventar uno en cada llamada. Su ejemplo: si el servidor A eligió un deadline de 30 segundos y lleva 7 procesando cuando llama a B, la llamada a B sale con 23.
Retry
Qué arregla y qué no
Muchas faltas son transitorias: un paquete perdido, una conexión que se cortó, una instancia que se estaba reiniciando. Si se repite el pedido, sale bien. Un retry es eso: ante una falla, volver a intentar.
Para medirlo, Toxiproxy tiene un tóxico que corta conexiones, reset_peer, y
cada tóxico tiene una toxicidad: la probabilidad de que se aplique a una
conexión. Con un tercio, una de cada tres conexiones se corta.
make retries hace 900 llamadas al courier a través de ese proxy, con cuatro
políticas:
$ make retries
1. Toxiproxy corta una de cada tres conexiones (900 llamadas, 30 a la vez)
variante                         bien    mal  intentos  llegaron    tiempo
1 intento                         604    296       900       900    529 ms
3 intentos, sin espera            868     32      1296      1296    644 ms
3 intentos, backoff               868     32      1315      1315   1445 ms
3 intentos, backoff + jitter      864     36      1290      1290   1148 ms
Con un solo intento falla un tercio de las llamadas, como era de esperar. Con hasta tres intentos, falla el 4 %. La cuenta: si cada intento falla con probabilidad y las fallas son independientes, una llamada con intentos falla solo si fallan los :
De 900 llamadas, eso son unas 33; en las tres filas con reintentos se midieron 32, 32 y 36. El precio está en la columna de intentos. Cada llamada hace un intento, más otro si el primero falló, más otro si fallaron los dos:
Para 900 llamadas, 1 300 intentos; se midieron 1 296. Un retry compra confiabilidad con carga: aquí, un 44 % más de pedidos al courier.
Miren las tres últimas filas juntas: con y sin espera, el resultado es el mismo. Cuando las faltas son independientes, esperar antes de reintentar no cambia cuántas llamadas salen bien; solo tarda más. El backoff sirve para otra cosa, que veremos en un momento.
Lo que un retry no arregla es una falta que no es transitoria: si el courier está caído, tres intentos dan tres fallas y el triple de carga. De ahí salen los tres riesgos del patrón.
Solo sobre operaciones idempotentes
Hay una columna de la tabla anterior que todavía no miramos: llegaron. Es el contador del courier, y coincide con los intentos de la tienda en las cuatro filas. Es decir, todos los pedidos llegaron al courier y se procesaron, también los 296 que la tienda vio fallar. El tóxico cortó la conexión en el camino de vuelta: el courier hizo su trabajo y la respuesta se perdió.
Es el caso de la semana 5: “no llegó” y “llegó y la respuesta se perdió” se
ven igual desde quien llama. Con una tarifa no importa, porque es una
lectura. Pero el courier tiene otra operación, POST /pickups, que programa
el recojo de un pedido: crea algo.
errors/retry-not-idempotent.ts
programa el recojo de 10 pedidos, con la respuesta del primer intento de
cada uno perdida en el camino y un retry de hasta tres intentos:
$ make errors
Sin clave de idempotencia:
  pedidos de la tienda con respuesta   10
  peticiones que recibió el courier    20
  recojos que el courier programó      20
Con clave de idempotencia:
  pedidos de la tienda con respuesta   10
  peticiones que recibió el courier    20
  recojos que el courier programó      10
…
La tienda está conforme en los dos casos: pidió 10 recojos y tiene 10
respuestas. En el primero, el courier va a mandar 20 motos. En el segundo, la
tienda envía en cada intento la misma cabecera idempotency-key (una por
pedido, no una por intento) y el courier reconoce la repetición.
Error común. Reintentar una operación que no es idempotente. Si la operación es un cobro, el resultado es un cobro doble, y nadie se entera hasta que reclama el comprador: del lado de quien llama, todo salió bien. Antes de agregar un retry hay que poder responder qué pasa si el intento anterior sí se hizo. Si la respuesta no es “nada”, primero va la clave de idempotencia (semana 12) y después el retry.
Backoff exponencial y jitter
El segundo riesgo aparece cuando las faltas no son independientes: cuando la dependencia falla para todos a la vez, durante un rato. Una instancia que se reinicia, un despliegue, una sobrecarga.
Si todos reintentan de inmediato, sus reintentos caen dentro de la misma falla, y le llegan a la dependencia justo cuando menos puede atenderlos. La primera corrección es esperar antes de reintentar, y cada vez más: con backoff exponencial, la espera antes del reintento (contando desde ) es
con una base y un tope . Con ms: 200, 400, 800, 1 600 ms. La espera crece rápido para darle aire a la dependencia, y el tope evita que crezca sin límite.
Pero el backoff solo no alcanza. Si cien clientes fallaron en el mismo instante, los cien esperan exactamente 200 ms y vuelven a llegar juntos; fallan, esperan 400 ms, y llegan juntos de nuevo. La segunda corrección es agregar azar, jitter: esperar un tiempo al azar entre 0 y ese valor.
Las dos están en resilience/retry.ts:
exponentialBackoff y fullJitter.
La segunda parte de make retries lo mide. El courier responde 503 durante
800 ms y después se recupera; 100 clientes lo llaman en el mismo instante,
con hasta 5 intentos cada uno. El courier anota cuándo llega cada pedido, y
la última columna es el mayor número de reintentos que recibió dentro de
una misma ventana de 50 ms:
2. El courier responde 503 durante 800 ms; 100 clientes llaman a la vez (base del backoff: 200 ms)
variante                         bien    mal  llegaron  reintentos  pico de reintentos en 50 ms
1 intento                           0    100       100           0                            0
5 intentos, sin espera              0    100       500         400                          200
5 intentos, backoff               100      0       400         300                          100
5 intentos, backoff + jitter 92 8 440 340 42- Sin espera: los 5 intentos de cada cliente se gastan en pocos milisegundos, dentro de la caída. Ninguna llamada sale bien, y el courier, que estaba mal, recibió cinco veces la carga. Es el peor resultado: más carga que sin reintentar y las mismas fallas.
- Con backoff: los intentos salen a los 0, 200, 600 y 1 400 ms; el cuarto cae después de la caída y las 100 llamadas salen bien. Pero los reintentos llegan en tres olas de 100: todos juntos.
- Con backoff y jitter: los reintentos se reparten y el pico baja a 42. A cambio, 8 clientes tuvieron mala suerte: sus esperas al azar sumaron menos de 800 ms y gastaron los 5 intentos dentro de la caída.
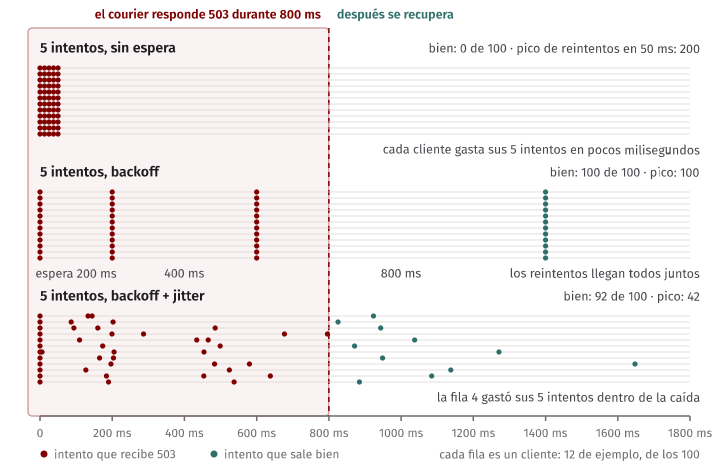
En las tres corridas, el pico con jitter estuvo entre 42 y 43 y las llamadas fallidas entre 4 y 8; las otras tres filas salieron idénticas.
Trade-off. El jitter cambia golpes sincronizados por una carga repartida, que es lo que la dependencia necesita para recuperarse, y lo paga con esperas menos predecibles para cada cliente. Con muchos clientes y una dependencia sobrecargada, lo que importa es la dependencia.
En la industria. El artículo de Marc Brooker en el blog de arquitectura de AWS, Exponential Backoff And Jitter (2015), simula clientes que compiten por actualizar la misma fila con control de concurrencia optimista y compara el backoff sin jitter con tres variantes con jitter. La fórmula de arriba es la que el artículo llama Full Jitter. Su conclusión: el backoff sin jitter es el claro perdedor, y con 100 clientes el jitter redujo las llamadas a menos de la mitad.
La tormenta de reintentos
El tercer riesgo es el más grave, y aparece cuando hay más de una capa: un
servicio llama a otro, que llama a otro, y cada uno, con buena intención,
reintenta tres veces. make storm arma esa cadena, con tres capas y al
final un servicio que siempre responde 503, manda 100 peticiones de usuario
y cuenta cuántas le llegan al último:
$ make storm
100 peticiones de usuario; el último servicio falla siempre
quién reintenta                                 le llegan al último  por petición
nadie reintenta                                                 100          1.00
solo la capa 3 reintenta (3 intentos)                           300          3.00
las tres capas, 3 intentos cada una                            2700         27.00
las tres capas, 4 intentos cada una                            6400         64.00
las tres, 3 intentos y presupuesto del 10 %                     130          1.30
Con tres capas de tres intentos, cada petición del usuario se convierte en 27. No es una suma, es un producto: la capa 3 hace 3 intentos por cada pedido que recibe; la capa 2 le manda 3 pedidos por cada uno que recibe ella; la capa 1, igual. Con capas y intentos por capa:
Y con cuatro intentos, . El servicio de abajo estaba saturado, y la reacción del sistema fue multiplicarle la carga por 27. Esa es la tormenta de reintentos (retry storm), y es la razón por la que un servicio caído por sobrecarga muchas veces no logra levantarse.
Las reglas que la evitan:
- Reintentar en una sola capa: la que está pegada a la dependencia que falla, que es la que sabe qué error recibió. Las de arriba pasan el error sin insistir. En la tabla: 3 pedidos por petición en vez de 27.
- Un número máximo de intentos, siempre.
- Distinguir lo reintentable. Un 400 o un 422 va a fallar igual la
segunda vez. En la tienda,
isTransientsolo deja reintentar timeouts, errores de conexión y respuestas 5xx. - Un presupuesto de reintentos, que es la última fila de la tabla.
El presupuesto de reintentos
Un número máximo de intentos limita lo que hace una llamada. No limita lo que hace el cliente en total: con tres intentos, si todo falla, el cliente manda el triple. Un presupuesto de reintentos (retry budget) limita la proporción: este cliente puede gastar en reintentos, como mucho, una fracción de lo que manda.
La clase RetryBudget lo hace con fichas: cada petición deposita fichas
y cada reintento gasta una.
Mientras las fallas son pocas, el presupuesto no se nota: hay fichas de sobra. Cuando la dependencia se cae, las fichas se acaban y los reintentos paran solos. La carga extra de una capa queda acotada a veces la normal, y con capas:
Para 100 peticiones, como mucho 133 pedidos al último servicio; se midieron 130 (cada capa necesita juntar unas diez peticiones antes de tener su primera ficha; once en la práctica, porque diez veces 0,1 no llega a 1 en punto flotante). De 27 veces la carga a 1,3 veces, sin dejar de reintentar las fallas aisladas.
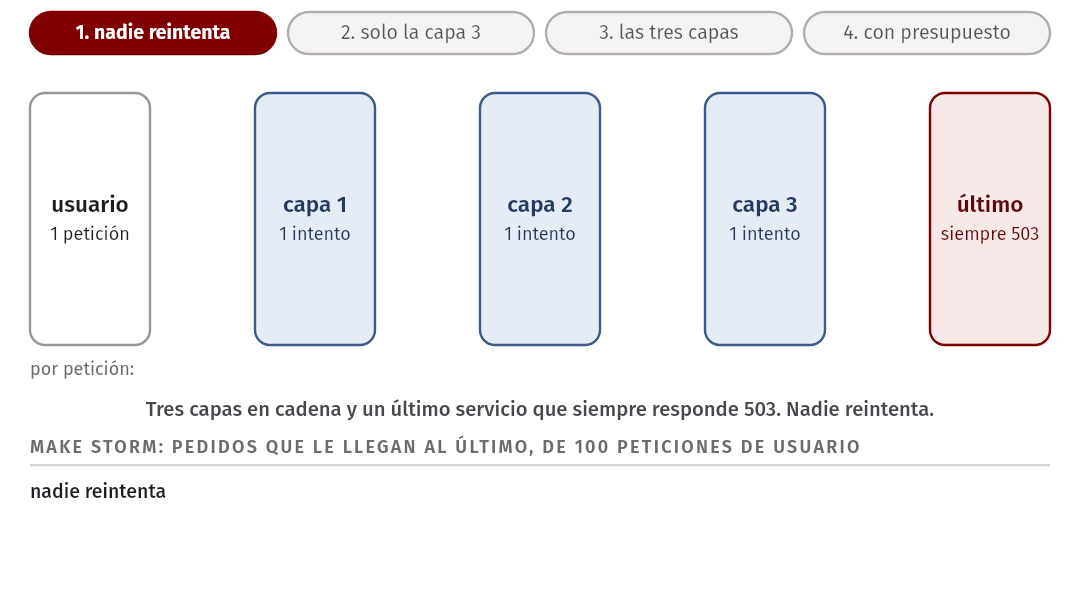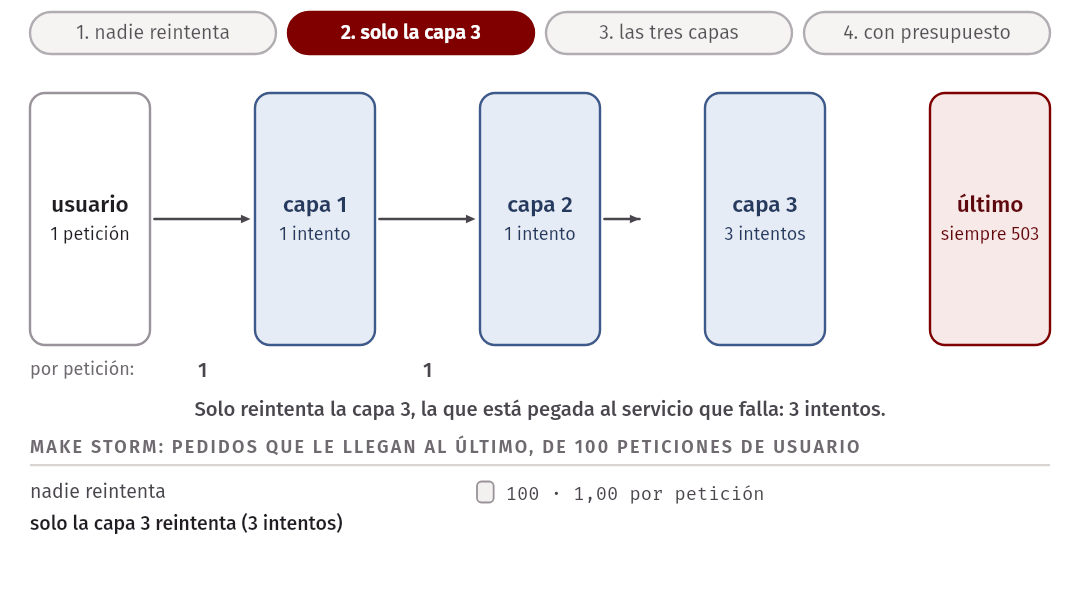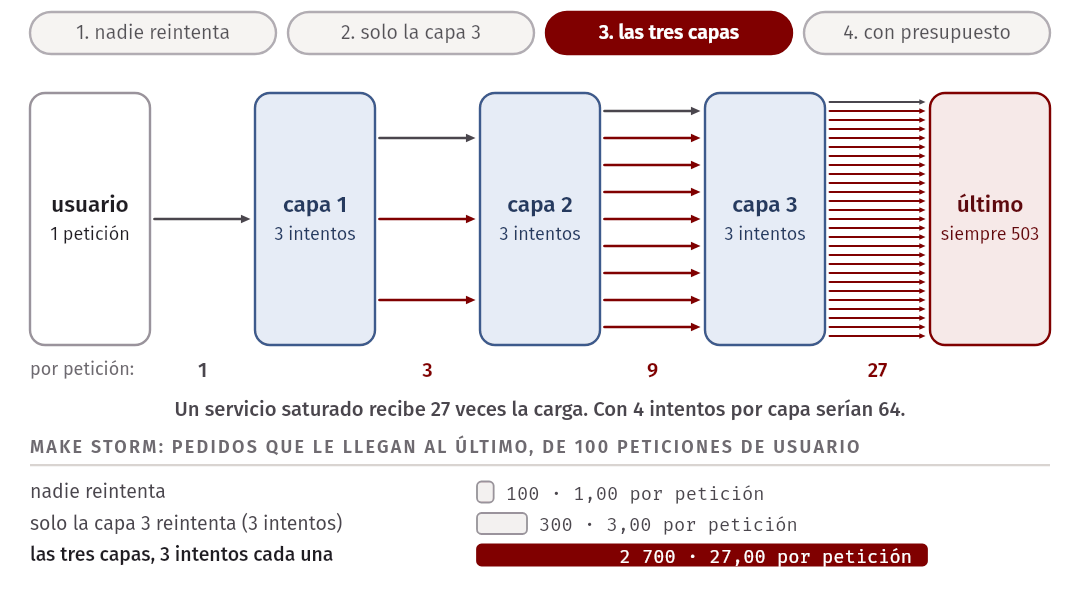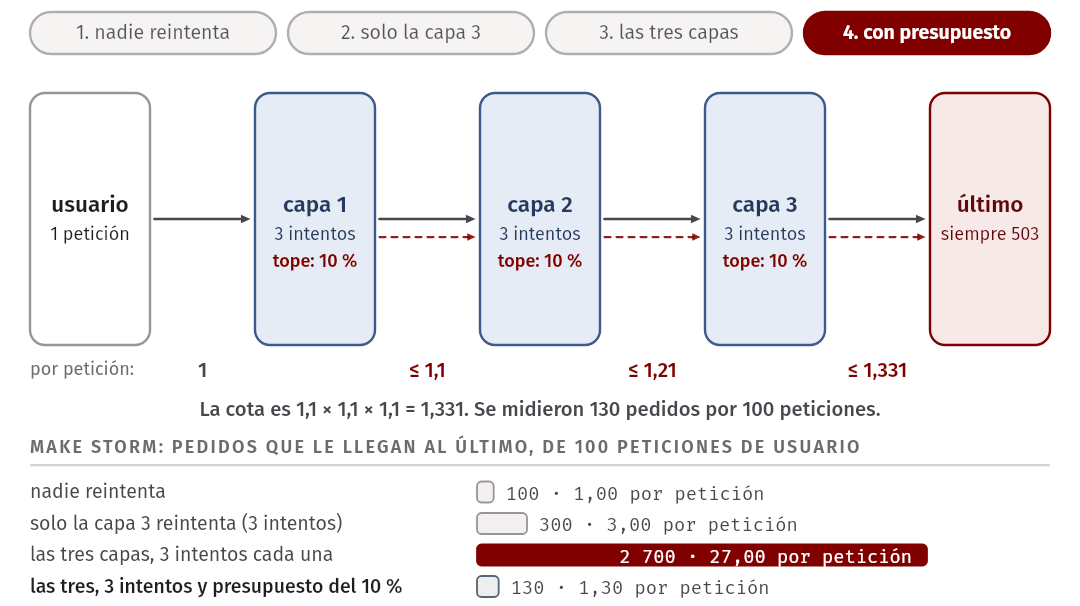
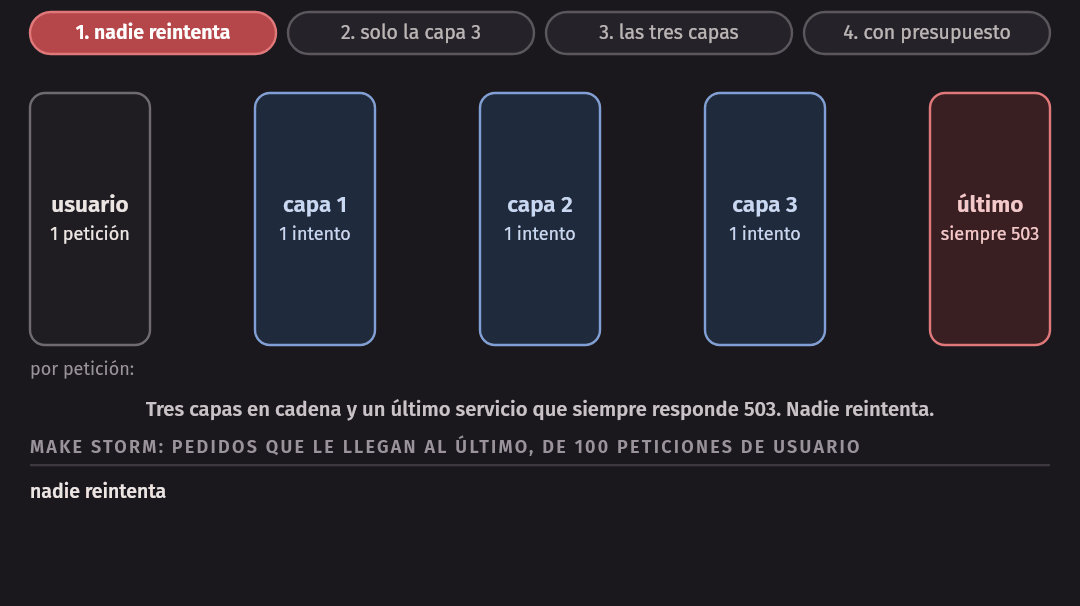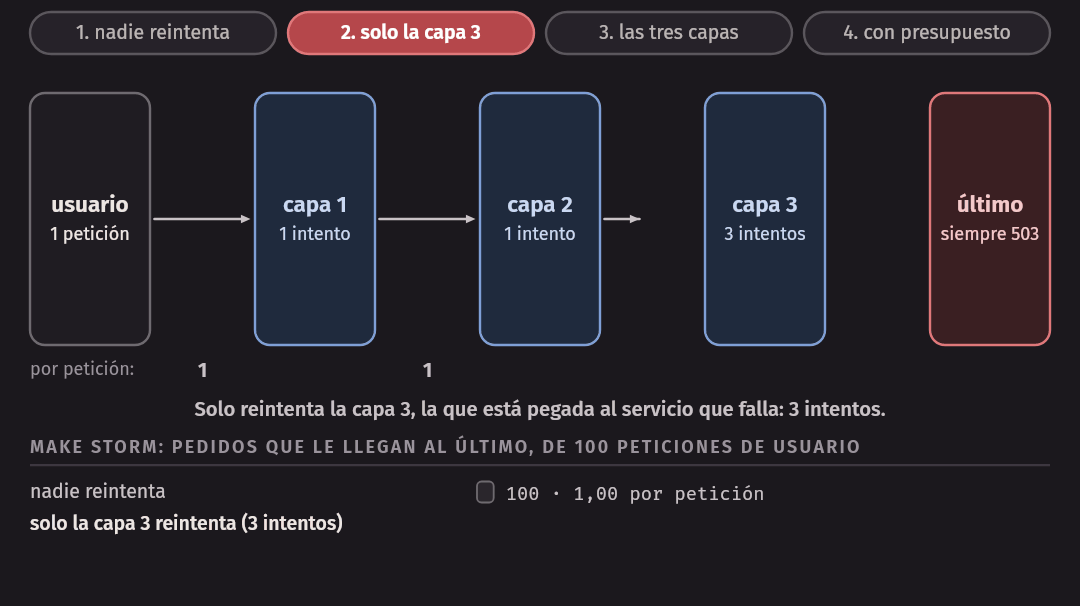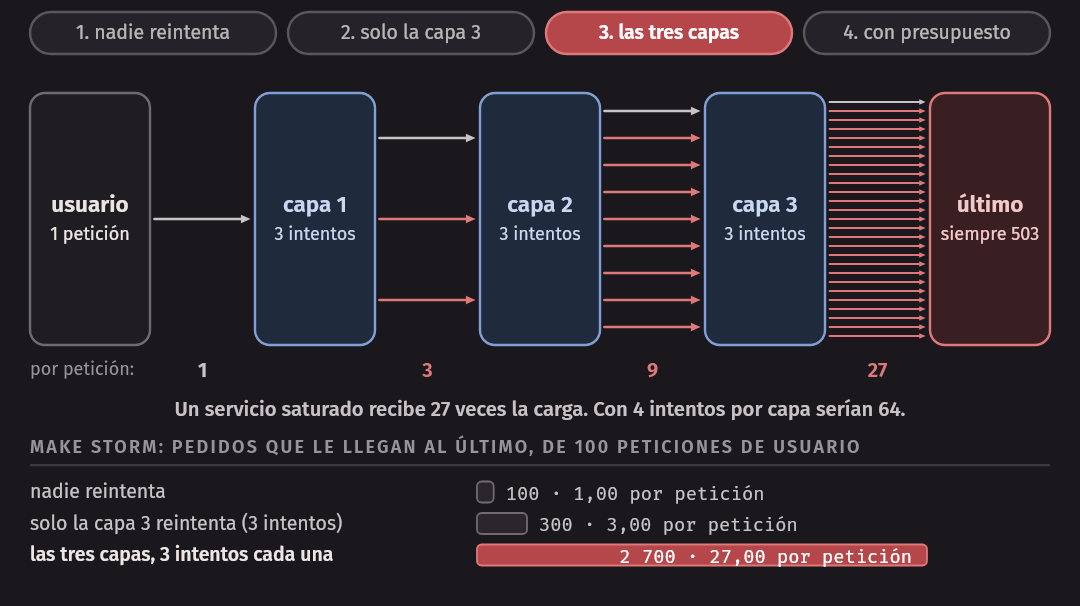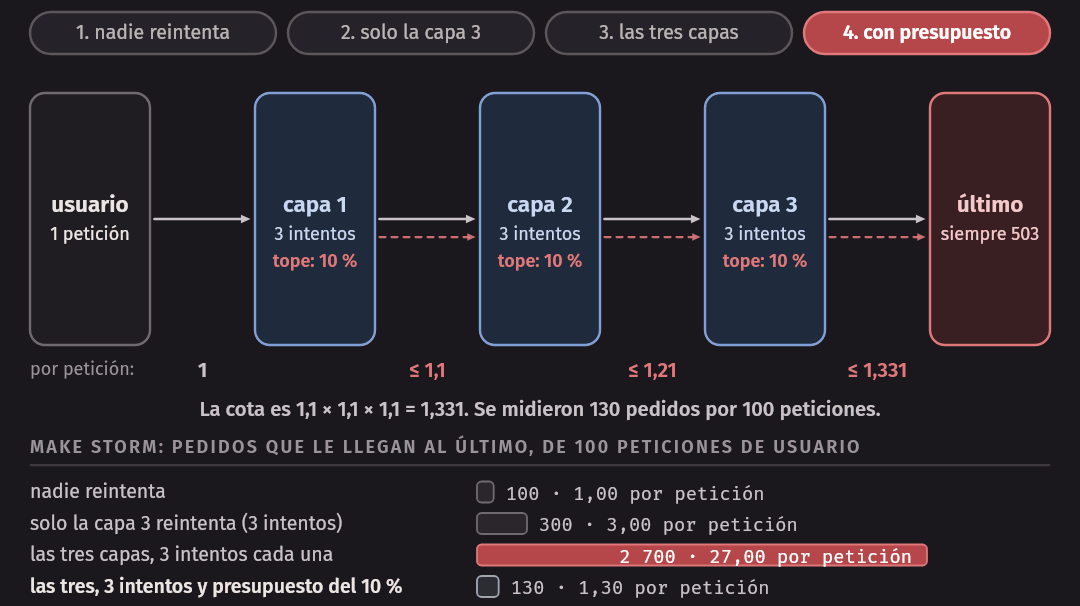
En la industria. El capítulo 21 del libro de SRE, Handling Overload, describe las dos cotas juntas: un presupuesto por petición de hasta tres intentos, y un presupuesto por cliente por el que una petición solo se reintenta mientras los reintentos sean menos del 10 % de lo que el cliente manda. Según el capítulo, sin el segundo la carga puede crecer hasta casi tres veces, y con él queda en 1,1 veces en el caso general. También da la regla de la capa única: reintentar solo en la capa inmediatamente superior a la que rechaza. El capítulo 22 hace la cuenta de arriba con cuatro intentos y tres capas: 64 intentos sobre la base de datos por una sola acción del usuario.
Circuit breaker
Tres estados
Timeout y retry deciden qué hacer con una llamada. Ninguno recuerda nada: la llamada número mil a un courier que lleva un minuto sin responder espera su segundo de timeout igual que la primera.
Un circuit breaker agrega esa memoria. Es un componente que envuelve las llamadas a una dependencia, cuenta cómo salen y, cuando las fallas pasan de un umbral, deja de llamar: durante un tiempo, toda llamada falla de inmediato, sin tocar la dependencia. El nombre viene del tablero eléctrico: cuando algo anda mal, el circuito se abre y corta la corriente.
Tiene tres estados:
| Estado | Qué hace con una llamada | Qué lo saca de ahí |
|---|---|---|
Cerrado (closed) |
La deja pasar y anota si salió bien o mal | Las fallas llegan al umbral: pasa a abierto |
Abierto (open) |
La rechaza de inmediato, sin llamar a la dependencia | Pasa el tiempo de espera: pasa a semiabierto |
Semiabierto (half-open) |
Deja pasar una llamada de prueba; las demás se rechazan | La prueba sale bien: cerrado. La prueba falla: abierto otra vez, y la espera empieza de nuevo |
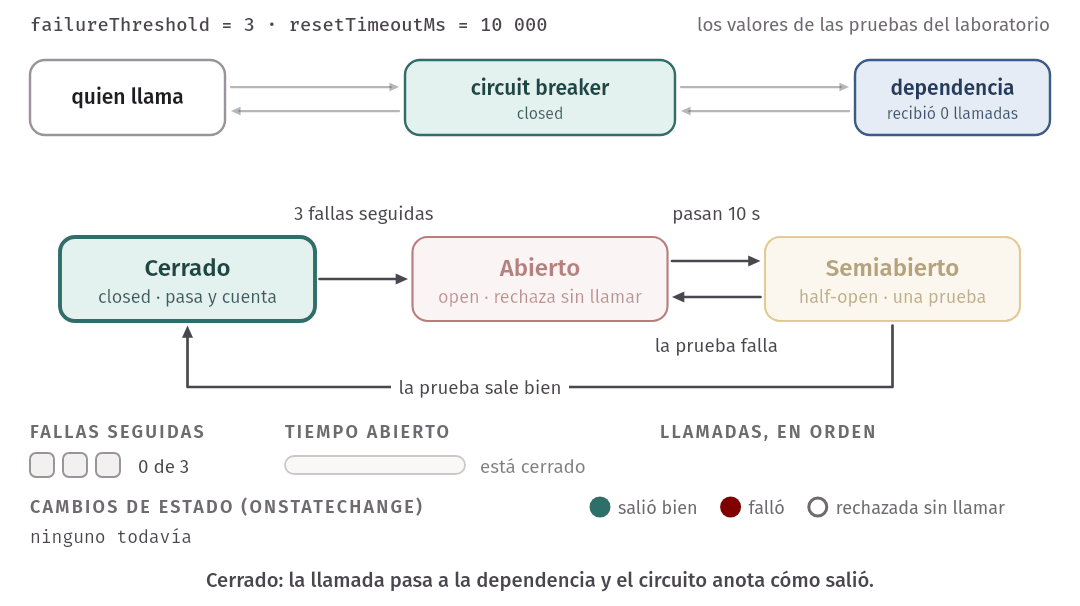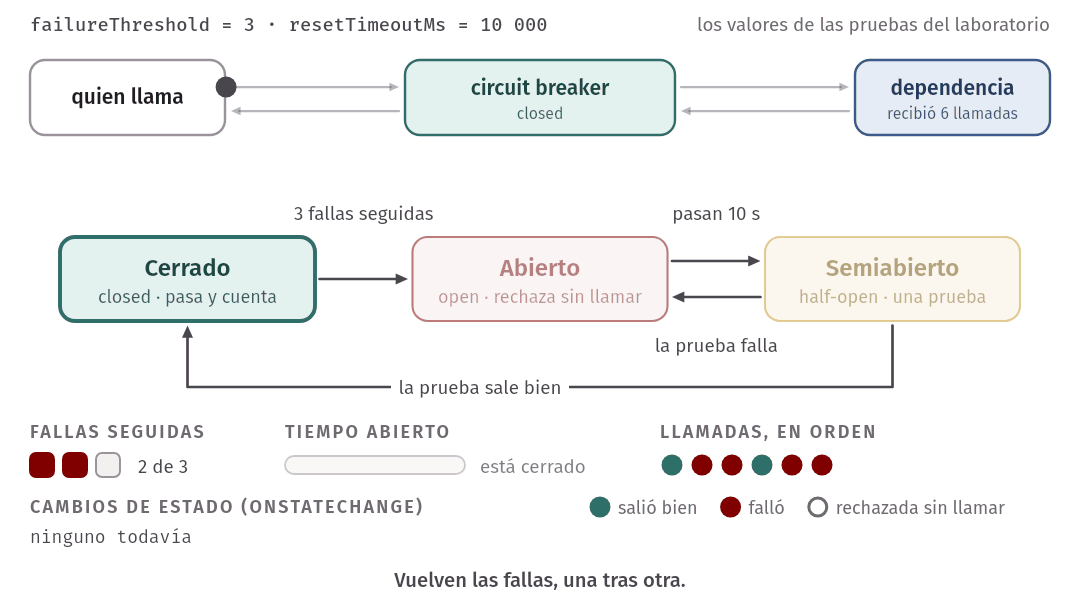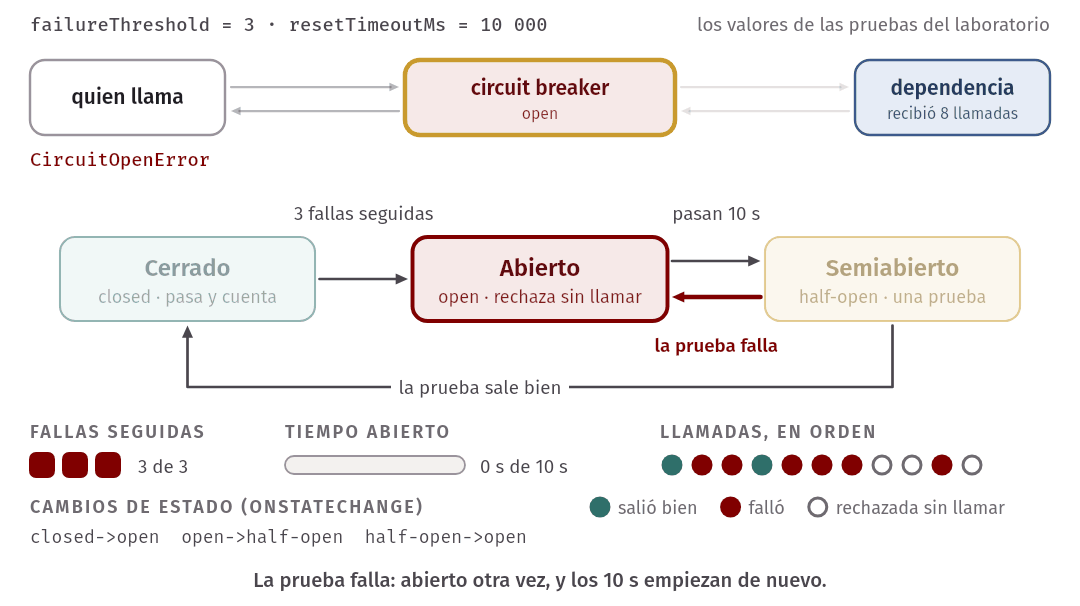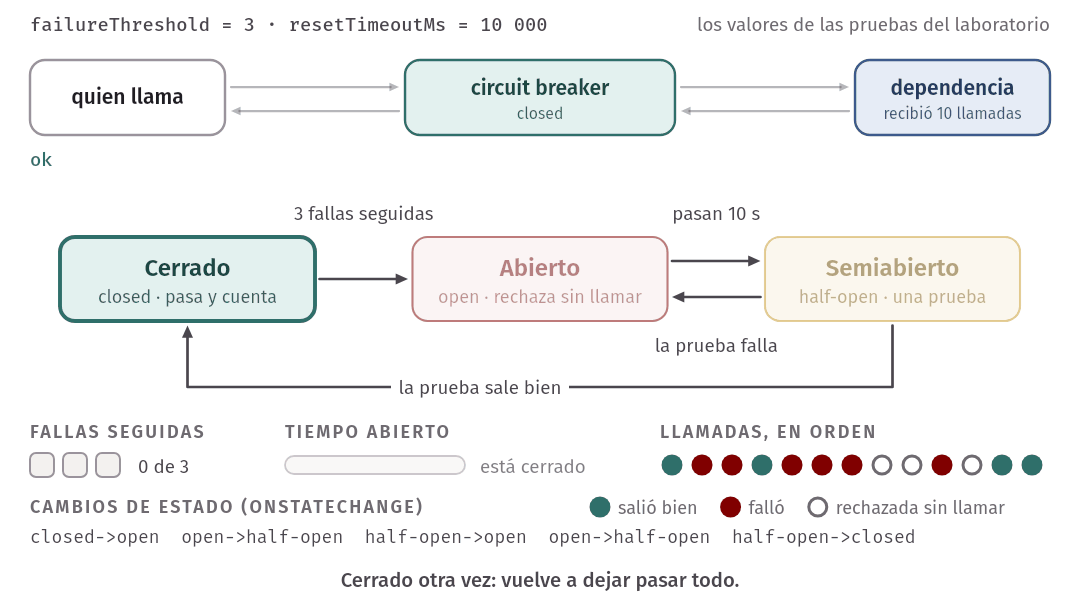
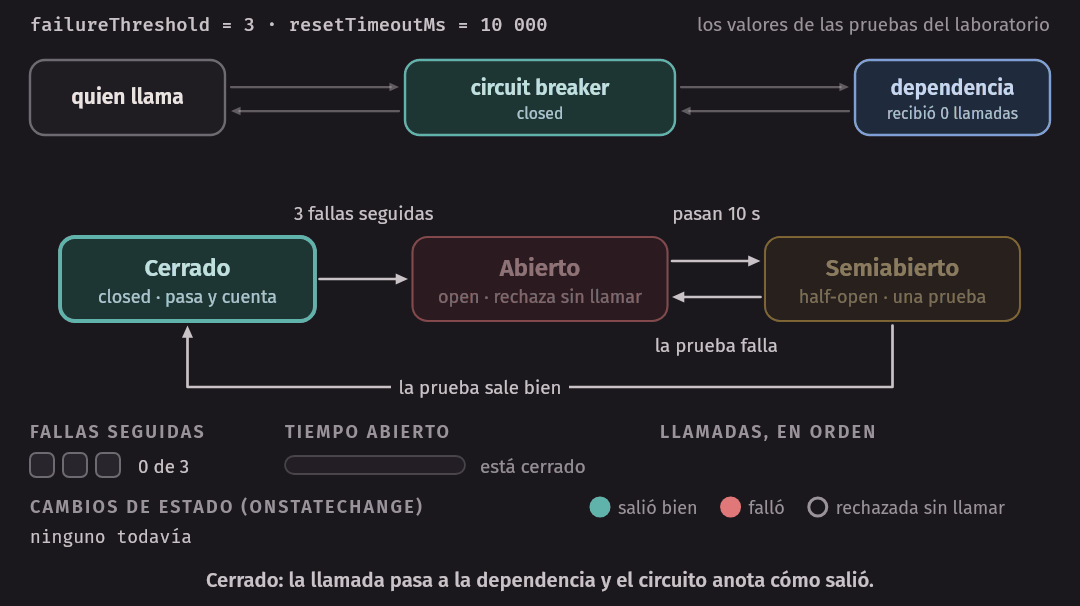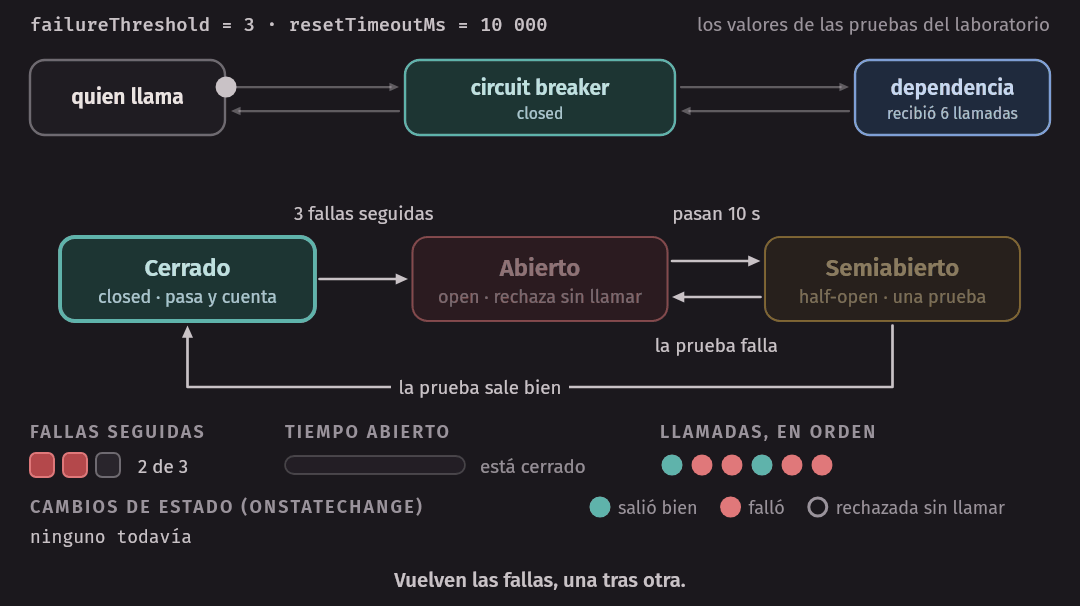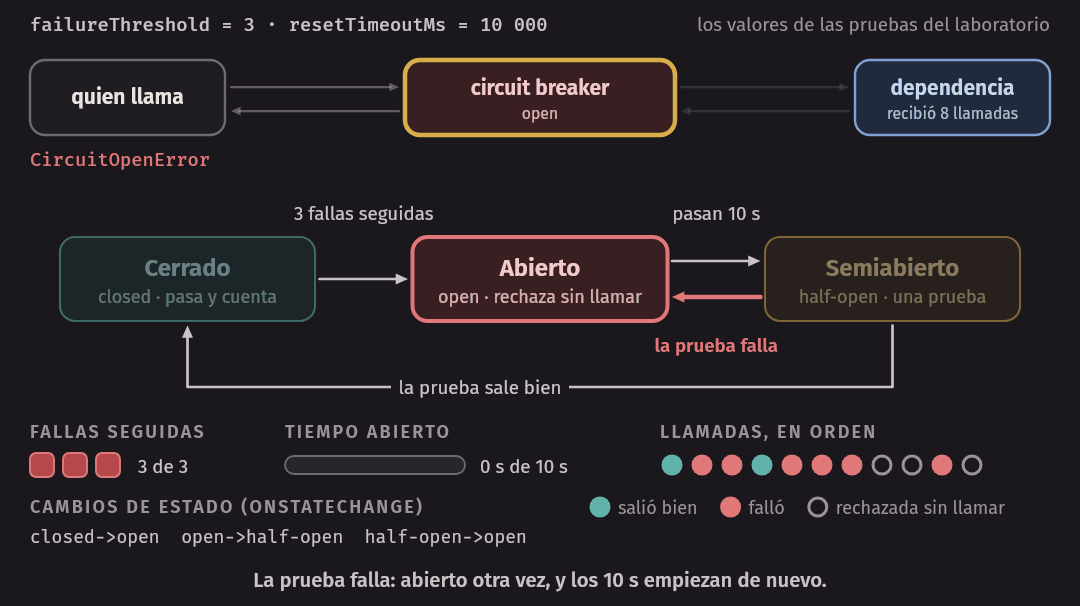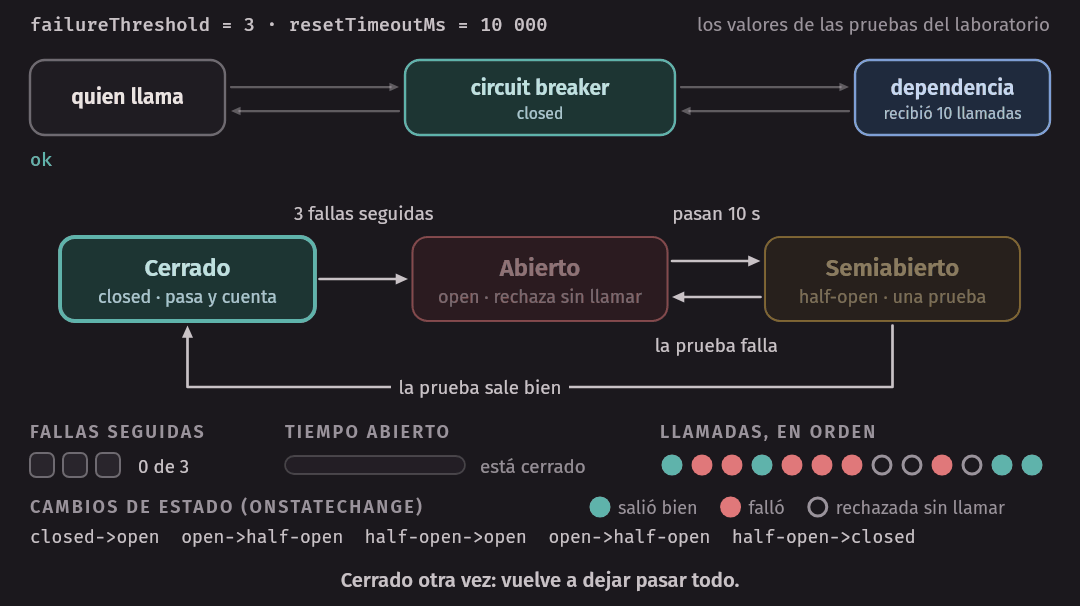
Las palabras van al revés de una puerta: cerrado es el estado normal, con la corriente pasando, y abierto es el circuito cortado. El estado semiabierto es lo que permite que se cierre solo, sin mandarle toda la carga de golpe a una dependencia que quizá sigue mal.
Un circuit breaker protege a dos partes. A quien llama, porque falla rápido: no retiene conexiones ni hace esperar a nadie para llegar a un error que ya se conocía. Y a la dependencia, porque deja de recibir carga justo cuando está mal, que es lo que necesita para recuperarse.
El circuito, llamada por llamada
Implementar uno es el paso 6 del laboratorio, así que aquí no hay código:
están sus tipos y la firma de la clase, en
lab/circuit-breaker.ts, y lo que
se ve desde afuera.
make breaker hace llamadas al courier, de una en una, con un circuito de 5
fallas seguidas y 3 segundos de espera, y un timeout de un segundo, mientras
el courier pasa por cuatro situaciones. Cada línea es una llamada: cuándo se
hizo, en qué estado estaba el circuito, cómo salió y cuánto tardó.
$ make breaker
tiempo   circuito   resultado                    duración
1. El courier está sano
  0.1 s  closed     tarifa recibida                60 ms
  0.3 s  closed     tarifa recibida                82 ms
  0.4 s  closed     tarifa recibida                47 ms
2. El courier tarda 5 s más en responder
  1.5 s  closed     timeout                      1001 ms
  …
  4.8 s  closed     timeout                      1002 ms
  6.0 s  -- el circuito pasa de closed a open
  6.0 s  closed     timeout                      1001 ms
  6.1 s  open       rechazada por el circuito     0.2 ms
  6.2 s  open       rechazada por el circuito     0.1 ms
  6.3 s  open       rechazada por el circuito     0.1 ms
3. El courier vuelve a responder
  6.4 s  open       rechazada por el circuito     0.0 ms
  6.9 s  open       rechazada por el circuito     0.1 ms
  …
  8.9 s  open       rechazada por el circuito     0.7 ms
  9.4 s  -- el circuito pasa de open a half-open
  9.4 s  -- el circuito pasa de half-open a closed
  9.4 s  half-open  tarifa recibida                47 ms
4. El courier rechaza la conexión
  9.9 s  closed     error de conexión             1.3 ms
  …
 10.3 s  -- el circuito pasa de closed a open
 10.3 s  closed     error de conexión             1.5 ms
 10.4 s  open       rechazada por el circuito     0.1 ms
  …
El courier recibió 9 pedidos de los 26 que se intentaron.
Síganlo por partes.
En la parte 2, las cinco primeras llamadas pagan el timeout completo, un segundo cada una. La quinta abre el circuito, y las siguientes fallan en una décima de milisegundo: unas diez mil veces más rápido. Para el servicio, es la diferencia entre retener recursos un segundo por pedido y no retener nada.
En la parte 3, el courier ya se recuperó (a los 6,4 s) y el circuito sigue rechazando hasta los 9,4. Es el costo del patrón: mientras espera, no se entera de que la dependencia volvió. Pasados los 3 segundos deja pasar una llamada de prueba, que sale bien, y se cierra.
En la parte 4, el courier rechaza la conexión. Aquí el circuito casi no cambia la latencia, de 1,5 ms a 0,1 ms, porque una conexión rechazada ya era una falla rápida. Y la última línea: de 26 llamadas, el courier recibió 9; las otras 17 no salieron de la tienda.
Idea clave. Un circuit breaker vale lo que vale la diferencia entre fallar lento y fallar rápido. Contra una dependencia lenta, esa diferencia es enorme. Contra una que rechaza la conexión, es pequeña para quien llama, y lo que se gana es dejar tranquila a la dependencia.
Decisiones al diseñar un circuit breaker
El patrón cabe en una tabla de tres filas, pero al implementarlo hay que decidir varias cosas, y cada una tiene alternativa.
| Decisión | En el laboratorio | Alternativa, y cuándo conviene |
|---|---|---|
| Qué cuenta como falla | Timeouts, errores de conexión y 5xx (isFailure) |
Nunca un 4xx: abrir el circuito por los pedidos mal hechos de un cliente deja sin servicio a todos |
| Cómo se cuenta | Fallas seguidas: un éxito pone la cuenta en cero | Una proporción de fallas en una ventana, con un mínimo de llamadas. Detecta una dependencia que falla la mitad de las veces, que con fallas seguidas nunca llega al umbral; tiene más parámetros |
| Cuánto dura abierto | Un tiempo fijo | Que crezca con backoff cada vez que la prueba falla. Muy corto, las pruebas le caen a una dependencia que no se recuperó; muy largo, se rechaza de más |
| Cuántas pruebas | Una llamada | Varios éxitos seguidos antes de cerrar: decide con más de una muestra |
| Alcance | Un circuito por dependencia, en la memoria de cada proceso | Con cuatro instancias hay cuatro circuitos, y cada uno descubre la caída por su cuenta |
Queda una decisión de composición: dónde va respecto del retry. En la tienda
el orden es este
(chaski/courier-client.ts):
// bulkhead ( circuit breaker ( retry ( timeout ( fetch ) ) ) )El timeout es por intento. El retry va dentro del circuito: el circuito
cuenta una falla cuando la llamada falló también después de reintentar, y
con el circuito abierto no se reintenta nada. Y todo cambio de estado tiene
que quedar en el log y en una métrica, porque significa que una función dejó
de atender; para eso está onStateChange.
En la industria. El artículo de Martin Fowler, CircuitBreaker (2014), describe el patrón con los mismos tres estados y con un contador que los éxitos devuelven a cero. Señala varias de las decisiones de arriba: que no todos los errores deben abrir el circuito, que un diseño más elaborado puede mirar la frecuencia de errores o usar umbrales distintos según el tipo de error, y que todo cambio de estado debe registrarse y el circuito debe exponer su estado para el monitoreo.
Qué se responde con el circuito abierto
El circuito decide no llamar. Qué decirle al usuario es una decisión de negocio, y hay al menos tres respuestas posibles.
- Un error claro, pronto. La tienda responde 503 con la cabecera
retry-after. Es honesto y no promete nada. - Un valor por defecto. Una tarifa plana marcada como estimada. El usuario sigue comprando; el negocio asume la diferencia.
- Aceptar y hacerlo después. Guardar el pedido en una cola y procesarlo cuando la dependencia vuelva, con todo lo de la semana 13: el trabajo queda pendiente y hay que poder decir en qué estado está.
Cuál conviene depende de qué se rompe si la respuesta es aproximada o llega tarde. Una tarifa estimada es tolerable. Un cobro “estimado” no existe.
Trade-off. Un circuit breaker cambia errores lentos por errores rápidos, y entre los rápidos hay algunos que no hacían falta: los de los pedidos rechazados cuando la dependencia ya había vuelto. Agrega estado, parámetros que ajustar y un modo de falla nuevo que diagnosticar (“el courier está bien, ¿por qué la tienda responde 503?”). Sin él, una dependencia lenta cuesta el timeout completo en cada pedido. Conviene con mucho tráfico; sobra en una llamada que se hace una vez por hora.
Bulkhead y load shedding
Bulkhead: que agotar un recurso no agote los demás
El casco de un barco está dividido en compartimentos estancos: si se abre un agujero, se inunda uno y el barco sigue a flote. En inglés, la pared que los separa es un bulkhead, y el patrón toma el nombre: separar los recursos por dependencia o por tipo de trabajo, para que agotar uno no hunda a los demás.
La cascada de la tienda pasó porque las cotizaciones y el catálogo compartían un solo recurso, el pool de 10 conexiones. Un bulkhead le pone a cada uno su parte. Hay dos maneras habituales:
- Recursos separados: un pool de conexiones para las cotizaciones y otro para el catálogo. Lo que pase con uno no toca al otro.
- Un límite de concurrencia: un tope a cuántas llamadas al courier pueden estar en curso a la vez. Si el tope es menor que el pool, las cotizaciones nunca pueden tomarlo entero.
La tienda usa la segunda: la clase Bulkhead de
resilience/bulkhead.ts es un
contador de trabajos en curso, con una cola de espera opcional y con límite.
Con maxQueue en cero, que es el valor por omisión, lo que no cabe no
espera: recibe un error en el acto. La misma carga y el mismo courier lento,
con un máximo de 5 llamadas concurrentes al courier (SHOP_MAX_CONCURRENT=5)
y ninguna otra defensa: ni timeout, ni la llamada fuera de la
transacción.
$ make cascade V=bulkhead
== bulkhead (SHOP_MAX_CONCURRENT=5)
POST /quotes    201: 15   503: 1010   otros: 0   p50 2 ms   p95 150 ms   máx 5292 ms
GET  /products  200: 716   otros: 0   p50 1 ms   p95 57 ms   máx 170 ms
El catálogo está sano: 716 pedidos atendidos, mediana de 1 ms. Las cotizaciones siguen llamando al courier con la transacción abierta, pero nunca hay más de 5 a la vez, y las otras 5 conexiones del pool quedan para el catálogo. De las cotizaciones, 15 entraron y esperaron sus 5 segundos, y 1 010 recibieron un 503 en 2 ms.
El número se elige con la misma cuenta de antes. Si el courier sano responde en 45 ms y llegan 74 cotizaciones por segundo (las 1 110 de la corrida sana, en 15 segundos), en promedio hay llamadas en curso. Un límite de 5 deja margen para el funcionamiento normal y se llena en cuanto el courier se pone lento, que es cuando tiene que actuar.
Trade-off. Un bulkhead reserva capacidad, y la capacidad reservada no se presta: con el tope en 5 y el catálogo vacío, la sexta cotización se rechaza aunque sobren conexiones. Se paga eficiencia en el caso normal para comprar aislamiento en el malo. Un solo pool compartido aprovecha mejor los recursos y deja que cualquier trabajo se los lleve todos.
Load shedding: rechazar pronto para atender bien
Los 1 010 rechazos de la tabla anterior son el otro patrón del título. Cuando llega más trabajo del que se puede atender, hay tres cosas que un servicio puede hacer con el exceso:
- Aceptarlo todo y atenderlo a medida que pueda. El trabajo se acumula en una cola, la latencia crece sin tope, y cuando por fin se atiende un pedido, quien lo hizo ya se fue. El servicio trabaja al máximo para producir respuestas que nadie lee.
- Rechazar una parte de inmediato. Quienes entran reciben un servicio normal; quienes no, lo saben enseguida.
- Caerse.
La segunda opción es load shedding. Parece la peor para el usuario y es la mejor de las tres, porque las otras dos terminan en lo mismo para todos. La variante sin defensas era la opción 1.
Rechazar bien tiene dos condiciones: que sea barato (el rechazo sale antes de hacer cualquier trabajo caro) y que sea claro (un código que diga “estoy sobrecargado”, 503 o 429 si es un límite por cliente, y cuándo volver). Esta es la respuesta de la tienda a una cotización que no entró:
$ curl -s -i -X POST localhost:3100/quotes -H "content-type: application/json" -d '{"productId":7,"district":"cusco"}'
HTTP/1.1 503 Service Unavailable
…
retry-after: 1
…
{"error":{"code":"OVERLOADED","message":"Demasiadas cotizaciones en curso; intenten en un momento"}}
Hay tres conceptos vecinos que se confunden:
| Concepto | Qué limita | Quién decide |
|---|---|---|
| Load shedding | La carga total que el servicio acepta | El servicio, según su propio estado |
| Rate limiting | Lo que puede pedir cada cliente (100 pedidos por minuto) | El servicio, por una regla fija |
| Backpressure | El ritmo de quien produce | El consumidor le avisa al productor que baje el ritmo |
El rate limiting protege de un cliente abusivo, no de mil clientes correctos que llegan a la vez. El backpressure solo funciona si quien produce puede frenar: un consumidor de un stream, sí; un comprador en una apertura, no.
Error común. Una cola sin límite no es ninguna de las tres. No elimina la sobrecarga: la esconde. Mientras la cola crece, la latencia crece con ella, y el sistema se entera del problema cuando se acaba la memoria. Toda cola tiene un límite y una decisión sobre qué pasa cuando se llena; si nadie la tomó, la toma el sistema operativo.
En la industria. El capítulo 22 del libro de SRE, Addressing Cascading Failures, propone como forma simple de load shedding responder HTTP 503 a todo pedido que llegue cuando hay más de cierto número de pedidos en curso, que es lo que hace la tienda. Sobre las colas, dice que los pedidos encolados consumen memoria y aumentan la latencia, y que suele convenir una cola corta, para rechazar pronto cuando no se puede sostener el ritmo. El capítulo 21 advierte del límite: rechazar también cuesta, y un servidor puede saturarse aunque dedique casi todo su CPU a rechazar.
Todas las defensas, bajo la misma carga
Esta es la corrida completa de make cascade, resumida. El courier tarda 5
segundos más en todas las filas salvo la primera; la carga es la misma en
todas.
| Variante | Cotizaciones: 201 / 503 / otros | Cotizaciones: p50 | Catálogo: atendidos | Catálogo: p50 |
|---|---|---|---|---|
| Courier sano, sin defensas | 1 110 / 0 / 0 | 45 ms | 730 | 1 ms |
| Sin defensas | 40 / 0 / 10 | 15 186 ms | 20 | 12 550 ms |
| Timeout de 10 s | 40 / 0 / 10 | 15 188 ms | 10 | 10 016 ms |
| Timeout de 1 s | 0 / 0 / 180 | 3 520 ms | 59 | 2 810 ms |
| Bulkhead de 5 | 15 / 1 010 / 0 | 2 ms | 716 | 1 ms |
| Llamada fuera de la transacción | 120 / 0 / 0 | 5 063 ms | 750 | 1 ms |
| Todo junto, con circuit breaker | 0 / 1 179 / 7 | 1 ms | 737 | 1 ms |
La última fila es la variante all: timeout de un segundo, llamada fuera de
la transacción, bulkhead de 5 y un circuit breaker de 5 fallas y 5 segundos.
Lean la tabla por columnas.
El catálogo se salva con tres de las defensas, por tres razones distintas: el bulkhead le reserva conexiones, sacar la llamada de la transacción deja de ocuparlas, y todo junto hace las dos cosas. El timeout solo no lo salva.
Las cotizaciones no se salvan con ninguna. El courier tarda 5 segundos; ninguna defensa de la tienda lo hace más rápido. Lo que cambia es cómo fallan: esperando 15 segundos, esperando 5, o recibiendo un error en un milisegundo. En la última fila, 7 pedidos pagaron el timeout de un segundo (los 5 que abrieron el circuito y las llamadas de prueba) y los otros 1 179 recibieron su respuesta de inmediato.
Ninguna defensa sola alcanza. El bulkhead protege al catálogo y deja 15 cotizaciones colgadas 5 segundos. Sacar la llamada de la transacción protege al catálogo y deja crecer los pedidos en curso. El timeout acota la espera y no evita la cola. Se combinan porque cada una tapa el hueco de otra.
Idea clave. Las defensas de esta semana no hacen que la función afectada funcione. Hacen que falle rápido, que falle sola y que el resto del sistema no se entere. Para que la función afectada siga dando algo, hace falta lo que viene ahora.
Degradar
Degradar es seguir dando un servicio reducido cuando no se puede dar el completo, y decidir por adelantado qué se reduce. La diferencia con fallar es que alguien lo pensó antes: qué parte del sistema es esencial, qué parte es prescindible, y qué recibe el usuario cuando la prescindible no está.
La tienda tiene una degradación posible, la tarifa plana. Con el circuito
abierto, en vez de un 503 responde una cotización con un monto fijo y el
campo estimated en true:
== degrade (SHOP_TIMEOUT_MS=1000 SHOP_OUTSIDE_TX=1 SHOP_MAX_CONCURRENT=5 SHOP_BREAKER=1 SHOP_BREAKER_IMPL=solution SHOP_FALLBACK=1)
POST /quotes    201: 1186   503: 0   otros: 0   p50 3 ms   p95 65 ms   máx 1039 ms
GET  /products  200: 734   otros: 0   p50 1 ms   p95 18 ms   máx 83 ms
Las 1 186 cotizaciones respondieron 201, con el courier igual de lento que antes, y ninguna tiene la tarifa real. Si eso es aceptable lo decide el negocio, que es quien paga la diferencia. A la arquitectura le toca que la opción exista, que esté marcada en la respuesta y que se pueda contar cuántas veces se usó.
En Tinkuy. La pregunta para Tinkuy es qué se apaga primero. Sin reportes de ventas se puede vender. Sin el correo de confirmación, también: la entrada existe aunque el correo llegue después. Sin la pasarela no se puede cobrar, pero se puede seguir mostrando el catálogo. Hoy, en el Tinkuy inicial, las tres cosas tumban la compra o algo peor. Decidir qué hace Tinkuy en cada caso, y demostrarlo, es parte de P5.
Comprobar que las defensas funcionan
Todas las tablas de este capítulo salieron de romper algo a propósito. Es la única manera de saber si una defensa funciona: un timeout que nunca se cumplió y un circuito que nunca se abrió son código sin probar, y el día en que hagan falta será la primera vez que se ejecuten.
Inyectar fallas es producir a propósito las faltas que el sistema dice tolerar (latencia, cortes, errores, una dependencia caída) y medir el escenario de calidad mientras ocurren. La herramienta del curso es Toxiproxy, y ya vieron cómo funciona: un proxy TCP entre quien llama y su dependencia, al que se le agregan tóxicos.
$ bash proxy.sh courier 4101 4100
Proxy courier: 127.0.0.1:4101 -> 127.0.0.1:4100, sin tóxicos.
$ toxiproxy-cli toxic add -t latency -a latency=5000 courier
Added downstream latency toxic 'latency_downstream' on proxy 'courier'
$ toxiproxy-cli inspect courier
latency_downstream	type=latency	stream=downstream	toxicity=1.00	attributes=[	jitter=0	latency=5000	]
$ toxiproxy-cli toggle courier
Proxy courier is now disabled
Los que usa el capítulo:
| Orden | Qué simula | Qué ve quien llama |
|---|---|---|
toxic add -t latency -a latency=5000 |
Una dependencia lenta | Respuestas 5 s más tarde |
toxic add -t reset_peer --tox 0.33 -a timeout=0 |
Conexiones que se cortan, una de cada tres | Un error de conexión, con el pedido quizá ya procesado |
toggle |
Una dependencia caída | Conexión rechazada, en milisegundos |
Dos detalles que ahorran una tarde de confusión. Los tóxicos se aplican
por conexión, no por pedido: si el cliente reutiliza conexiones (y
fetch lo hace), “una de cada tres” deja de serlo; el courier de la semana
cierra la conexión después de cada respuesta para que cada pedido use una
nueva. Y un tóxico downstream actúa sobre lo que vuelve de la
dependencia: el pedido llega y se procesa, y lo que se demora o se pierde es
la respuesta.
El tóxico es solo la mitad. La otra mitad es decir antes qué debería pasar: “con la pasarela 5 segundos más lenta, el catálogo sigue respondiendo el 99 % de sus pedidos en menos de 300 ms”. Eso es un escenario de calidad de disponibilidad con sus seis partes, y el experimento lo confirma o lo refuta. Sin hipótesis escrita antes, cualquier resultado parece razonable.
En la industria. Los Principles of Chaos Engineering llevan esta idea a producción: definir primero un estado estable medible del sistema, formular la hipótesis de que ese estado se mantiene, introducir eventos del mundo real (servidores que mueren, redes que fallan) y buscar la diferencia. El libro de SRE, en el capítulo 22, pide además probar los componentes hasta que se rompan y más allá. En el curso lo hacemos en una laptop; el método es el mismo.
Monitorear y observar
La segunda mitad del capítulo empieza con una pregunta: ¿cómo supimos lo que pasaba? En Tinkuy, mirando una tabla de PostgreSQL que hubo que saber que existía y a la que casi no pudimos entrar. En la tienda, porque la escribimos para que contara lo que hace.
Monitorear es vigilar las preguntas que ya se conocen: ¿está arriba?, ¿cuántos errores hay?, ¿cuánto disco queda? Funciona para las fallas que alguien anticipó.
Un sistema es observable si se puede entender qué le está pasando mirando lo que emite, incluso cuando lo que le pasa no lo previó nadie. Nadie tenía una alarma para “el catálogo falla porque la pasarela está lenta y las compras retienen las conexiones”. Para llegar a esa frase hay que poder hacerle al sistema preguntas nuevas.
En un monolito, observar puede ser leer un archivo de log. En un sistema distribuido una compra pasa por varios procesos, cada uno con su log, y si nada los une no hay forma de reconstruir qué le pasó a esa compra. Por eso la observabilidad es un atributo de calidad con consecuencias de arquitectura: obliga a que cada servicio emita ciertas cosas, con cierto formato, y a que cada llamada y cada mensaje lleven cierto contexto. No se agrega al final.
Lo que un sistema emite se agrupa en tres señales, y cada una responde una pregunta distinta:
| Señal | Qué es | Qué pregunta responde | Qué cuesta |
|---|---|---|---|
| Logs | Un registro por cada cosa que pasó | ¿Qué pasó en este caso? | Crece con el tráfico: una línea o más por pedido |
| Métricas | Números agregados en el tiempo | ¿Cuánto, y con qué tendencia? | Poco: no depende del tráfico, sino de cuántas series hay |
| Trazas | El recorrido de un pedido por todos los servicios | ¿Dónde se fue el tiempo? | Mucho, si se guardan todas; por eso se muestrean |
Ninguna reemplaza a otra. Una métrica dice que el p95 de las cotizaciones subió a 5 segundos; no dice cuáles. Un log dice qué le pasó a una cotización; no dice si es la única. Una traza dice en qué llamada se fue su tiempo; no dice cuántas más hay así.
En la industria. OpenTelemetry es el estándar abierto para producir y transportar estas señales, y su documentación las define en una línea cada una: una traza es el camino de un pedido a través de la aplicación, una métrica es una medición tomada en ejecución y un log es el registro de un evento. La misma página lista una cuarta señal, baggage (contexto que viaja entre las otras), y dos en desarrollo. En el curso usamos sus nombres, no sus bibliotecas.
Logs estructurados
De frases a campos
Estos son los logs del Tinkuy inicial durante una compra:
GET /events/1/seats 200
pasarela: cobro ch_00000001 approved para orden-1304
pasarela: cobro ch_00000002 approved para orden-1305
…
POST /orders 201
Son frases para que las lea una persona, y con una compra a la vez alcanzan.
Con 200 compradores, no: no dicen a qué hora pasó cada cosa, ni cuánto tardó,
ni cuál de las líneas pasarela: corresponde a cuál POST /orders. Para
responder “¿cuántas compras tardaron más de un segundo?” no hay nada que
contar.
Un log estructurado es un registro con campos: cada línea es un objeto, normalmente JSON, con nombres fijos. Esta es la línea que escribe la tienda por una cotización:
{"ts":"2026-11-16T07:06:48.536Z","level":"info","service":"shop","msg":"request","request_id":"8178a60f-4675-43f7-9402-1f049aa4ba34","trace_id":"9dcd3a0e039e1c3db0d18876f9b2e364","span_id":"b7c89f72710a8233","route":"POST /quotes","status":201,"duration_ms":65,"outcome":"ok","courier_attempts":1}Es menos cómoda de leer y mucho más útil, porque una máquina puede filtrarla y sumarla. Lo mínimo que lleva la línea de un pedido atendido:
- Cuándo (
ts), en UTC y con milisegundos. - Quién la escribe (
service) y con qué gravedad (level). - Qué pedido (
route), cómo terminó (status, y unoutcomeque distingue un timeout de un rechazo por sobrecarga, aunque los dos sean 5xx) y cuánto tardó (duration_ms). - El identificador de la petición (
request_id).
El logger son veinte líneas
(observability/logger.ts), y
tiene una decisión de diseño: una línea por pedido, al terminar, con
todo. La alternativa, varias líneas por pedido (“llegó”, “llamando al
courier”, “respondió”), obliga a juntarlas después para saber cuánto tardó.
Con campos, las preguntas se responden con herramientas comunes. Después de
la corrida de la variante all:
$ jq -r 'select(.msg == "request" and .route == "POST /quotes") | .outcome' build/logs/all.jsonl | sort | uniq -c
   1109 circuit_open
     70 shed
      7 timeout
$ jq -c 'select(.msg == "breaker_state_change") | {ts, from, to}' build/logs/all.jsonl | head -4
{"ts":"2026-11-16T07:02:42.312Z","from":"closed","to":"open"}
{"ts":"2026-11-16T07:02:47.319Z","from":"open","to":"half-open"}
{"ts":"2026-11-16T07:02:48.319Z","from":"half-open","to":"open"}
{"ts":"2026-11-16T07:02:53.342Z","from":"open","to":"half-open"}
La primera respuesta separa lo que el código de estado junta: de los 1 179 pedidos que recibieron 503, 1 109 fueron rechazados por el circuito y 70 por el bulkhead. La segunda muestra al circuito probando cada 5 segundos, con un segundo de por medio: el timeout de la llamada de prueba.
El identificador de la petición
El campo que convierte un montón de líneas en la historia de un pedido es el
identificador de la petición (request id). Se genera una vez, en el
primer servicio que recibe el pedido; se escribe en cada línea de log de ese
pedido; se envía en una cabecera (x-request-id) en cada llamada que se
haga por él; y se devuelve en la respuesta.
Con eso, la misma cotización se puede seguir en el log del courier:
{"ts":"2026-11-16T07:06:48.527Z","level":"info","service":"courier","msg":"request","request_id":"8178a60f-4675-43f7-9402-1f049aa4ba34","trace_id":"9dcd3a0e039e1c3db0d18876f9b2e364","span_id":"d7196c3c7fee1d0c","parent_span_id":"b7c89f72710a8233","route":"GET /rates","status":200,"duration_ms":43}El mismo request_id en dos servicios. De los 65 ms que tardó la cotización
en la tienda, 43 fueron del courier.
Error común. Registrar datos personales o de pago. La línea de log que más ayuda a depurar es la que tiene todo el pedido, y el pedido tiene el correo del comprador y el número de su tarjeta. Lo que se escribe en un log se copia a muchos lugares y casi nunca se borra.
errors/log-personal-data.tsmuestra la misma línea de las dos maneras.La regla es escribir identificadores, no datos: el id de la orden, no el nombre de quien compró. Y decidir campo por campo qué entra al log, en vez de volcar el objeto entero.
Métricas
Contadores, medidores e histogramas
Una métrica es un número que se va midiendo en el tiempo. No guarda qué le pasó a cada pedido: guarda cuántos hubo. Por eso es barata, y por eso es lo que se usa para los tableros y las alertas.
Hay tres tipos, y casi todas las herramientas usan los mismos nombres:
- Un contador (counter) solo sube: pedidos atendidos, errores. Lo que interesa de él es su ritmo de cambio (pedidos por segundo).
- Un medidor (gauge) sube y baja: llamadas en curso, conexiones ocupadas, estado del circuito. Interesa su valor ahora.
- Un histograma cuenta observaciones por rangos: cuántos pedidos tardaron hasta 25 ms, hasta 50, hasta 100. Es la forma de guardar una distribución sin guardar cada valor, y de ahí salen los percentiles (semana 2).
La tienda expone las suyas en GET /metrics, en el formato de texto que lee
Prometheus. Después de unos pocos pedidos con el courier lento:
$ curl -s localhost:3100/metrics
http_requests_total{route="POST /quotes",status="201"} 1
http_requests_total{route="POST /quotes",status="503"} 2
http_requests_total{route="POST /quotes",status="504"} 4
http_requests_total{route="POST /quotes",status="422"} 1
http_requests_total{route="GET /products",status="200"} 1
db_pool_in_use 0
db_pool_waiting 0
courier_in_flight 0
http_request_duration_ms_bucket{route="POST /quotes",le="25"} 3
…
http_request_duration_ms_bucket{route="POST /quotes",le="1000"} 4
http_request_duration_ms_bucket{route="POST /quotes",le="2500"} 8
…
http_request_duration_ms_bucket{route="POST /quotes",le="+Inf"} 8
http_request_duration_ms_sum{route="POST /quotes"} 4082
http_request_duration_ms_count{route="POST /quotes"} 8
Los rangos del histograma son acumulados: le="1000" cuenta los pedidos que
tardaron 1 000 ms o menos, y de ahí sale una fracción: 4 de 8 cotizaciones
respondieron dentro del segundo. Lo que un histograma no puede dar es un
valor que no esté en sus límites (cuántas tardaron menos de 750 ms). Los
límites se eligen antes, y por eso uno es el umbral que le importa al negocio.
Las cuatro señales doradas
¿Qué métricas hacen falta? El punto de partida más usado son cuatro, para cualquier servicio que atiende pedidos:
| Señal | Qué mide | En la tienda |
|---|---|---|
| Latencia | Cuánto tarda en atenderse un pedido | http_request_duration_ms, por ruta |
| Tráfico | Cuánta demanda recibe | El ritmo de http_requests_total |
| Errores | Qué fracción de los pedidos falla | http_requests_total con estado 5xx, sobre el total |
| Saturación | Qué tan lleno está el recurso más escaso | db_pool_in_use, db_pool_waiting, courier_in_flight |
La saturación es la que señala la causa. Durante la carga, una muestra de
GET /metrics con el courier sano dio db_pool_in_use 8 y
db_pool_waiting 0; con el courier lento y sin defensas, db_pool_in_use 10
y db_pool_waiting 40 en tres muestras seguidas: el pool entero ocupado y
cuarenta pedidos esperando una conexión. Cada recurso con límite (un pool, un
bulkhead, una cola) debería tener su medidor.
Sobre la latencia hay dos cuidados. Se mira por percentiles, no por
promedio. Y no se mezcla la de las respuestas buenas con la de los errores:
con la pasarela lenta, la mediana de GET /events en Tinkuy bajó de 428
ms a 2,39 ms, porque el 85 % de los pedidos fallaba y fallar es rápido.
En la industria. Las cuatro señales vienen del capítulo 6 del libro de SRE, Monitoring Distributed Systems. Al definir la latencia, el capítulo insiste en distinguir la de los pedidos exitosos de la de los fallidos, y agrega que un error lento es todavía peor que uno rápido. Su definición de error incluye los errores “por política”: si el compromiso es responder en un segundo, todo pedido que tarde más cuenta como error. Esa idea es la base del SLI que viene.
Cardinalidad
Cada combinación distinta de valores de las etiquetas de una métrica es una
serie aparte, que el sistema de monitoreo guarda por separado. La métrica
http_requests_total de arriba, con dos rutas y cuatro estados, son cinco
series. Agregarle una etiqueta con el id del usuario parece inofensivo y crea
una serie por usuario; una de las pruebas de la semana lo muestra con mil
pedidos de mil usuarios: una serie sin la etiqueta, mil con ella.
A esa cantidad de valores distintos se le llama cardinalidad, y es lo que
determina el costo de una métrica. La regla: las etiquetas son de pocos
valores y conocidos de antemano (ruta, estado, dependencia). Lo que tiene
muchos valores (el id de la petición o el del usuario) va al log o a la
traza. Por eso la tienda agrupa en other toda ruta que no conoce.
Trazas y propagación del contexto
Una traza es el recorrido de un pedido a través de todos los servicios que tocó. Está hecha de spans: cada span es una operación con un inicio, una duración y un padre. El span raíz es el pedido completo y sus hijos son las llamadas que se hicieron para atenderlo. El resultado es un árbol con tiempos, y responde lo que ninguna otra señal responde bien: de los 5 segundos que tardó esta compra, ¿dónde se fueron?
Para armar ese árbol hacen falta dos identificadores, y los dos tienen que
viajar. El trace_id es el mismo en todos los servicios por los que
pasa el pedido. El span_id es de cada operación; cuando un servicio llama a
otro, le manda el suyo, y el otro lo anota como su padre.
El formato estándar para llevarlos en HTTP es la cabecera traceparent, de
la recomendación Trace Context del
W3C:
traceparent: 00-0af7651916cd43dd8448eb211c80319c-b7ad6b7169203331-01Son cuatro campos separados por guiones: la versión (00), el trace-id
(32 dígitos hexadecimales), el parent-id (16 dígitos: el span de quien hace
la llamada) y las flags (01 quiere decir que la traza se está guardando).
Lo que hace cada servicio con ella son dos funciones
(observability/traceparent.ts):
al recibir un pedido, continúa la traza que viene en la cabecera o empieza
una si no viene; al llamar a otro, manda el mismo trace-id con su propio
span como padre.
Vuelvan a las dos líneas de log de la sección anterior. La de la tienda
tiene "span_id":"b7c89f72710a8233"; la del courier, el mismo trace_id y
"parent_span_id":"b7c89f72710a8233". Con esos tres campos y las duraciones
ya se puede armar el árbol:
| Span | Servicio | Operación | Duración | Padre |
|---|---|---|---|---|
b7c89f72710a8233 |
shop | POST /quotes |
65 ms | (raíz) |
d7196c3c7fee1d0c |
courier | GET /rates |
43 ms | b7c89f72710a8233 |
Un sistema de trazas hace esto con todos los spans de todos los servicios, y lo dibuja como una cascada de barras.
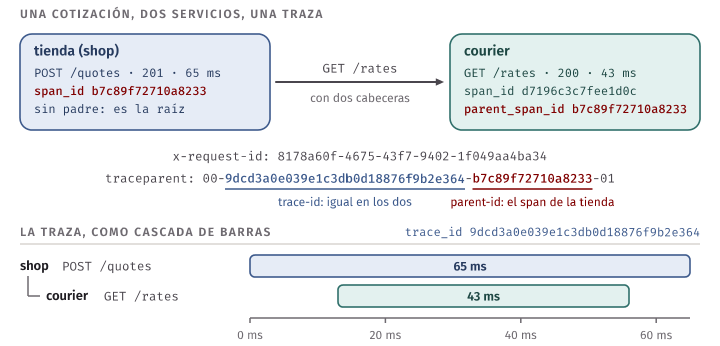
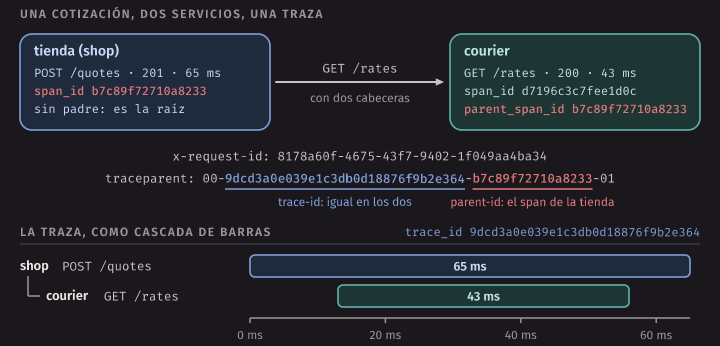
Dos consecuencias de arquitectura:
- Si un servicio no propaga el contexto, la traza se corta ahí. Todo lo que pase después de él aparece como trazas sueltas, sin relación con el pedido original. La propagación es un requisito para todos los servicios, incluidos los que no son de uno.
- Con mensajería, el contexto va en el mensaje. Cuando una compra publica un evento y un consumidor lo procesa diez segundos después, no hay una llamada HTTP que lleve la cabecera. El identificador de la traza viaja como un campo o una cabecera del mensaje, y el consumidor continúa la traza desde ahí. Si no, la traza de la compra termina en la publicación, y lo que más interesa saber (¿se envió el correo?) queda fuera.
SLI, SLO y error budget
SLI: buenos sobre válidos
En la semana 2 vieron las tres siglas. Aquí las vamos a usar para calcular.
Un SLI (service level indicator) es el indicador que se mide. La forma más útil de definirlo es como una proporción de eventos:
Para la tienda: cotizaciones que respondieron bien en menos de un segundo, sobre el total de cotizaciones. Hay que precisar dos palabras.
Válido es un evento que el servicio debía atender. Una cotización mal formada, que recibe un 422, no es válida: contarla como mala castigaría al servicio por los errores de sus clientes, y contarla como buena inflaría el indicador.
Bueno es un evento válido que cumplió lo que el usuario necesita: una respuesta sin error y a tiempo. Una cotización que responde 201 a los 5 segundos no es buena. Juntar las dos condiciones evita el engaño de antes, donde la latencia mejoraba mientras todo fallaba. Y como proporción, todo SLI queda entre 0 % y 100 %, mida lo que mida.
SLO y SLA
Un SLO (service level objective) es el objetivo sobre un SLI en una ventana de tiempo: el 99 % de las cotizaciones válidas responde bien en menos de un segundo, medido sobre 28 días. Tiene tres partes, y las tres se discuten: el indicador, el número y la ventana.
Un SLA (service level agreement) es un contrato: un SLO con una consecuencia pactada si no se cumple. Y un SLO es un escenario de calidad de la semana 2, vigilado en producción: el estímulo es el tráfico real, y la medida de la respuesta es el SLI.
El error budget
Un SLO de 99 % dice que el 99 % de los eventos tiene que ser bueno. Dicho al revés: el 1 % puede ser malo. Ese 1 % es el error budget: lo que el SLO permite fallar.
donde es la cantidad de eventos válidos de la ventana. Con un SLO de 99,5 % y un millón de compras al mes:
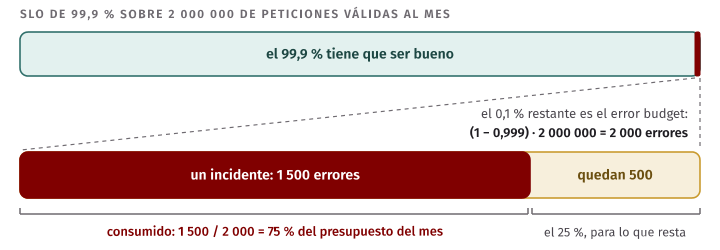
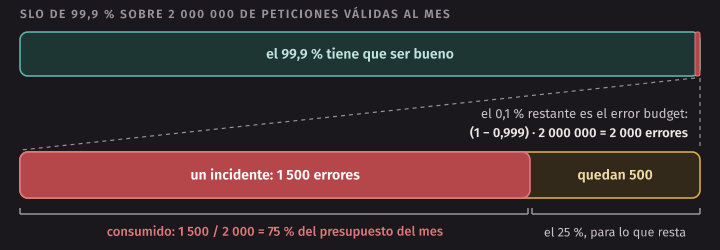
Cinco mil compras pueden fallar o tardar de más en el mes, y el servicio sigue cumpliendo su objetivo. Un incidente se mide contra ese presupuesto. Con un SLO de 99,9 % sobre 2 millones de peticiones al mes, un incidente que produjo 1 500 errores:
Un solo incidente se llevó tres cuartas partes del presupuesto del mes. Quedan 500 errores para lo que resta.
Si el SLI se mide en tiempo y no en eventos (la fracción de minutos en que el servicio estuvo bien), el presupuesto sale en minutos. Una ventana de 28 días tiene minutos:
| SLO | Error budget, como fracción | En 28 días |
|---|---|---|
| 99 % | min (6 h 43 min) | |
| 99,5 % | min (3 h 22 min) | |
| 99,9 % | min | |
| 99,99 % | min |
Cada nueve que se agrega divide el presupuesto entre diez. De 99,9 % a 99,99 % se pasa de poder tener un incidente de media hora al mes a no poder tener ninguno que una persona alcance a atender.
Para qué sirve un presupuesto
El número cambia una discusión. Sin él, la conversación entre quien quiere lanzar funciones y quien quiere que el sistema no se caiga es de opiniones. Con él, las dos partes miran la misma cifra:
- Mientras queda presupuesto, se despliega, se experimenta y se hacen migraciones. El presupuesto está para gastarse: un servicio que termina el mes con todo su presupuesto fue más cuidadoso de lo que le pedían, y lo pagó en velocidad.
- Cuando se acaba, la prioridad pasa a ser la confiabilidad: se detienen los cambios riesgosos y el trabajo va a lo que consumió el presupuesto.
Es una regla que se acuerda antes, y que convierte “¿qué tan confiable tiene que ser?” en un número que negocian producto y operación.
De ahí sale también por qué 100 % es el objetivo equivocado. Deja un presupuesto de cero: ningún despliegue ni experimento puede fallar nunca. Cada nueve cuesta más que el anterior. Y el usuario no nota la diferencia: entre él y el servicio están su celular, su red y su operador, que fallan bastante más que una vez cada diez mil.
En la industria. The Site Reliability Workbook, en el capítulo Implementing SLOs, recomienda tratar el SLI como el cociente de dos números, eventos buenos sobre el total de eventos, y define el error budget como 100 % menos el SLO. Su ejemplo: con un SLO de 99,9 %, un servicio que recibe 3 millones de peticiones en cuatro semanas tiene un presupuesto de 3 000 errores, y un solo incidente de 1 500 errores cuesta el 50 % del presupuesto. El mismo capítulo afirma que, en la experiencia de sus autores, 100 % de confiabilidad es el objetivo equivocado.
Del log al SLI
Con logs estructurados, el SLI se calcula a partir de lo que el servicio ya
escribe: es la función computeSli de
observability/sli.ts.
make cascade deja el log de cada variante en build/logs/, y make sli
calcula el SLI y lo compara con un SLO de 99 % sobre una ventana de 100 000
cotizaciones, es decir, un presupuesto de
cotizaciones malas. Para la variante con todas las defensas:
$ make sli V=all
SLI: POST /quotes que respondieron bien en menos de 1000 ms
  peticiones a la ruta   1186
  no válidas (4xx)       0
  válidas                1186
  buenas                 0
  malas                  1186 (1186 con error 5xx, 0 lentas)
  SLI                    0 / 1186 = 0.00 %
SLO de 99 % sobre una ventana de 100000 peticiones válidas
  error budget           1000 peticiones malas
  consumido aquí         1186 / 1000 = 118.60 %
  queda                  nada: el SLO de la ventana ya no se cumple (se pasó por 186)
Quince segundos con el courier lento, y el presupuesto de la ventana se fue entero. La variante que degrada a una tarifa estimada tuvo 1 179 buenas de 1 186: un SLI de 99,41 %, y 7 malas (las que esperaron el timeout de un segundo antes de recibir su tarifa estimada), el 0,7 % del presupuesto. La tabla completa:
| Variante | Válidas | Buenas | SLI | Malas | Presupuesto consumido |
|---|---|---|---|---|---|
| Courier sano | 1 110 | 1 110 | 100,00 % | 0 | 0,0 % |
| Sin defensas | 60 | 0 | 0,00 % | 60 | 6,0 % |
| Timeout de 1 s | 180 | 0 | 0,00 % | 180 | 18,0 % |
| Bulkhead de 5 | 1 025 | 0 | 0,00 % | 1 025 | 102,5 % |
| Fuera de la transacción | 120 | 0 | 0,00 % | 120 | 12,0 % |
| Todo junto | 1 186 | 0 | 0,00 % | 1 186 | 118,6 % |
| Todo junto, degradando | 1 186 | 1 179 | 99,41 % | 7 | 0,7 % |
Hay dos lecturas, y la segunda corrige a la primera.
La columna del SLI dice lo que ya sabíamos: sin una respuesta degradada, ninguna variante da una sola cotización buena mientras el courier esté lento. Las defensas protegieron al catálogo, que este SLI no mide: hace falta un SLO por función para ver que una se cayó y la otra no.
La columna del presupuesto parece decir que defenderse es peor: la variante sin defensas consumió el 6 % y la que tiene todas, el 118,6 %. Es un efecto de cómo se generó la carga. Los usuarios virtuales de k6 esperan cada respuesta antes de pedir de nuevo, así que cuando la tienda tarda 15 segundos en responder, cada uno alcanza a hacer un pedido; cuando responde 503 en un milisegundo, hace treinta. La variante sin defensas no tuvo menos fallas: tuvo menos pedidos, porque frenó a quien la medía. Es la omisión coordinada de la semana 2, vista desde el log.
Los usuarios reales no esperan a que el servicio se desocupe para llegar. A la tienda sana le llegaron 1 110 cotizaciones en 15 segundos; a ese ritmo, 15 segundos con un SLI de 0 % son unas 1 110 cotizaciones malas en cualquiera de las variantes, el 111 % del presupuesto.
Error común. Comparar el presupuesto consumido entre dos experimentos hechos con carga de modelo cerrado. El número de eventos malos depende de cuántos eventos hubo, y un servicio que responde lento recibe menos. Entre experimentos se compara el SLI, que es una proporción, o se usa carga de modelo abierto, que llega al mismo ritmo pase lo que pase.
Alertas y health checks
Alertar por síntomas, no por causas
Una alerta interrumpe a una persona. Para decidir cuáles lo valen sirve separar dos cosas: un síntoma es algo que el usuario nota (las compras fallan, el catálogo tarda); una causa es algo que puede producirlo (el CPU está al 90 %, el pool está lleno, la pasarela está lenta).
Alertar por causas parece prudente y funciona mal. No se pueden enumerar todas: nadie habría puesto una alerta para la cascada de este capítulo. Y muchas no producen ningún síntoma: un CPU al 90 % puede ser un servidor bien aprovechado.
Alertar por síntomas es alertar cuando el SLI se aleja del SLO: “las compras están consumiendo el error budget diez veces más rápido de lo sostenible”. Cubre todas las causas, también las que nadie imaginó, y solo suena cuando el usuario está afectado. Las causas van a los tableros, que es donde se mira después de que suena la alerta.
La otra regla es que cada alerta pide una acción humana. Si la respuesta es siempre “esperar a que pase” o “reiniciar el proceso”, lo primero es ruido y lo segundo se automatiza. Las alertas que no piden nada cansan, y una guardia cansada termina ignorando también la que importaba.
En la industria. El capítulo 6 del libro de SRE lo resume así: cada vez que suena el aviso de guardia hay que poder reaccionar con urgencia, y eso solo se puede hacer unas pocas veces al día antes de fatigarse; toda alerta debe ser accionable y requerir inteligencia; y si merece una respuesta mecánica, no debería ser una alerta. El mismo capítulo distingue las dos preguntas del monitoreo: qué está roto (el síntoma) y por qué (la causa).
Liveness y readiness
Un health check es un endpoint que le dice a la plataforma, no al usuario, cómo está una instancia. Hay dos preguntas distintas, y mezclarlas trae problemas.
- Liveness: ¿el proceso está vivo? Si no, la plataforma lo reinicia. Responde por algo que solo un reinicio arregla: un proceso colgado.
- Readiness: ¿esta instancia puede atender pedidos ahora? Si no, el load balancer deja de enviarle tráfico, sin reiniciarla. Sirve mientras arranca, mientras se apaga o cuando perdió algo que necesita.
En la tienda son GET /health, que responde sin mirar nada, y GET /ready,
que hace un SELECT 1 contra su base de datos y no comprueba al courier:
si el courier cae, la tienda sigue sirviendo el catálogo.
Error común. Un health check que comprueba todas las dependencias. Si
/readyrespondiera “no” cuando el courier no contesta, el día que el courier se caiga todas las instancias de la tienda dirían que no pueden atender, el load balancer las sacaría a todas, y la caída de una dependencia que solo afecta a las cotizaciones dejaría sin servicio también al catálogo: una falla en cascada fabricada por el mecanismo que debía evitarla. Y en el de liveness, la plataforma además reiniciaría todas las instancias sin arreglar nada. El estado de una dependencia compartida se informa (aquí, en el campocourierBreaker); no se usa para sacar la instancia de servicio.
Lo que cuesta observar
Nada de esto es gratis, y conviene saber dónde se paga.
- Latencia y CPU. Cada línea de log se arma y se escribe; cada span se crea y se envía.
- Almacenamiento y dinero. Una línea de 300 bytes por pedido, a 1 000 pedidos por segundo, son unos 26 GB al día ( bytes), y los servicios de observabilidad cobran por volumen y por serie.
- Código. La propagación del contexto toca cada llamada y cada mensaje.
Por eso las trazas se muestrean: se guarda una de cada cien, o todas las
que terminaron en error y una fracción de las demás. Para eso está el último
campo de traceparent: la decisión se toma una vez, al comienzo, y viaja con
el pedido, para que todos los servicios guarden los spans de las mismas
trazas. Y en las métricas se cuida la cardinalidad.
Trade-off. Más detalle guardado es más preguntas que se pueden responder después, y más costo todos los días. Menos detalle es barato hasta el incidente en que falta justo el dato que no se guardó. La división habitual: métricas de todo, logs de cada pedido con retención corta, y trazas muestreadas.
En Tinkuy. Hoy los logs de Tinkuy son frases sueltas, sin hora, sin identificador de la petición y sin duración, y no hay métricas: para saber cuántas compras se completaron hay que consultar la base de datos, que es justo lo que deja de estar disponible. P5 pide tres cosas: logs estructurados con el identificador de la petición; las métricas del SLO de compra; y la traza de una compra a través del monolito, el broker y el servicio de pagos que construyeron en P4, lo que obliga a llevar el contexto dentro de los mensajes.
El código de la semana
Todo está en code/week-14/ y se usa dentro del contenedor
del curso. make crea la base de datos arq_w14, inicia Toxiproxy y copia
Tinkuy en build/tinkuy.
| Carpeta | Qué hay |
|---|---|
chaski/ |
La tienda (shop.ts, main.ts), el cliente del courier con las defensas (courier-client.ts) y el courier (courier.ts) |
resilience/ |
timeout.ts, retry.ts (con backoff, jitter y presupuesto) y bulkhead.ts |
lab/ |
circuit-breaker.ts, por completar, y sus pruebas |
observability/ |
logger.ts, traceparent.ts, metrics.ts, sli.ts y sli-report.ts |
experiments/ |
Los scripts de make cascade, make retries, make storm y make breaker |
errors/ |
El retry sobre una operación no idempotente y el log con datos personales |
tinkuy/ |
Los scripts que levantan la copia de Tinkuy detrás del proxy y la miden |
proxy.sh, load/mixed.js |
El script que crea un proxy de Toxiproxy y la carga de k6 |
Las variables que encienden cada defensa están al comienzo de
chaski/main.ts.
make test revisa los tipos y corre las pruebas, que levantan la tienda y el
courier dentro del mismo proceso y no necesitan Toxiproxy:
$ make test
…
ℹ tests 54
…
ℹ pass 53
ℹ fail 0
…
ℹ skipped 1
…
Cada prueba lleva en el nombre la afirmación del capítulo que comprueba: tres capas con 3 intentos cada una: 27 pedidos al último por cada petición del usuario; con el pool agotado por cotizaciones lentas, el catálogo espera; con el bulkhead, no. La prueba que aparece como omitida es la del circuit breaker dentro de la tienda: se activa cuando el suyo esté hecho.
Las pruebas que dependen del tiempo usan cotas amplias o no dependen del reloj: las del retry reemplazan la espera por una función que solo anota cuánto se habría esperado, y las del circuit breaker usan un reloj que la prueba adelanta a mano.
Laboratorio: una pasarela de pagos lenta y caída, con Toxiproxy
El laboratorio se hace en parejas, sobre su copia de Tinkuy, con el material de code/week-14/. Necesitan tres terminales en el mismo contenedor: una para la pasarela, una para Tinkuy y una para las cargas y Toxiproxy. Lleven una tabla con una fila por paso y, en cada una, el p95 y los errores de la compra y del catálogo. Las mediciones del capítulo son del Tinkuy inicial; las suyas van a ser distintas, y hay que explicar en qué.
Paso 1: preparar. Inicien Toxiproxy (svc start toxiproxy) y creen el
proxy entre Tinkuy y la pasarela con bash proxy.sh gateway 4001 4000, desde
la carpeta de la semana. Levanten la pasarela como siempre y Tinkuy con
GATEWAY_URL=http://localhost:4001. Hagan una compra con curl y
comprueben que pasa por el proxy: apáguenlo con toxiproxy-cli toggle gateway, repitan la compra, y vuelvan a encenderlo. Si su Tinkuy ya llama a
un servicio de pagos propio, decidan entre qué dos procesos va el proxy y
anoten por qué.
Paso 2: línea de base. Corran make load-sale y make load-browse a la
vez y anoten p95 y errores de cada una. Repitan una vez sin cambiar nada,
para saber cuánto varía sola la medición, con make db antes de cada una.
Paso 3: la pasarela lenta. Agreguen un tóxico de latencia de 5 segundos
y repitan las dos cargas. Antes de lanzarlas, abran en otra terminal
psql -d tinkuy -f tinkuy/connections.sql (el archivo está en la carpeta de
la semana): si esperan a que el problema aparezca, psql ya no va a poder
conectarse. Respondan por escrito: ¿qué le pasa a la compra?, ¿y a
GET /events, que no usa la pasarela?, ¿qué estado tienen las conexiones?
Expliquen la cadena completa, del tóxico al catálogo, sin saltarse eslabones.
Paso 4: timeout. Pónganle un tiempo máximo a la llamada a la pasarela
con AbortSignal.timeout y hagan que la espera ocurra sin una transacción
abierta. Repitan el paso 3. ¿Qué mejoró para el catálogo? ¿Qué ve ahora
quien compra, y con qué código de estado? Justifiquen el valor que eligieron
con dos números: la latencia de la pasarela sana y lo que un comprador está
dispuesto a esperar. Este paso muestra la diferencia entre acotar la espera
y dejar de retener el recurso compartido.
Paso 5: retry. Agreguen reintentos con el módulo
resilience/retry.ts, primero sin espera y después con backoff exponencial y
jitter. Cambien el tóxico de latencia por uno que corte una de cada tres
conexiones (toxiproxy-cli toxic add -t reset_peer --tox 0.33 -a timeout=0 gateway). Para cada variante midan cuántas compras terminan bien y cuántas
peticiones recibe la pasarela (tendrán que encontrar cómo contarlas).
Respondan: ¿por qué esto solo es seguro si el cobro lleva una clave de
idempotencia? Busquen en su base de datos una prueba de lo que pasa cuando no
la lleva. Los tóxicos se aplican por conexión: comprueben que de verdad se
corta una de cada tres llamadas, y si no, averigüen por qué.
Paso 6: circuit breaker. Completen lab/circuit-breaker.ts hasta que
pasen sus pruebas (make lab) y envuelvan con él la llamada a la pasarela.
Midan cuánto tarda una compra con el circuito cerrado y con el circuito
abierto en dos situaciones: con la pasarela caída (toxiproxy-cli toggle gateway) y con la pasarela lenta (el tóxico del paso 3). ¿En cuál cambia
más la latencia, y por qué? Vuelvan a levantar la pasarela y observen, en el
log, cuándo se cierra.
Paso 7: bulkhead y load shedding. Limiten a 20 las llamadas concurrentes
a la pasarela, con resilience/bulkhead.ts, y respondan 503 de inmediato a
las que excedan. Repitan el paso 3 y comparen la latencia del catálogo con la
de los pasos 3 y 4. ¿Por qué 20? Calculen, con y sus
mediciones del paso 2, cuántas llamadas concurrentes hay con la pasarela
sana, y digan qué pasaría con un límite de 5 y con uno de 500.
Paso 8: observar. Cambien los console.log de la compra por una línea
JSON por pedido, con identificador de la petición, duración y resultado
(observability/logger.ts sirve tal cual). Repitan los pasos 3, 4 y 7
guardando el log de cada uno, y calculen con
node observability/sli-report.ts <log> --route "POST /orders" el SLI
“compras que respondieron bien en menos de 1 s”. Digan cuánto error budget de
un SLO de 99 % consumió cada experimento y qué ventana supusieron, y por qué
ese número no se puede comparar directamente entre experimentos.
Guarden el código de cada paso: es el punto de partida de P5.
Resumen
- Una falta es lo que sale mal dentro del sistema; una falla es lo que ve el usuario. Las faltas no se evitan. La resiliencia es que no se conviertan en fallas, y se diseña en cada punto de integración.
- Lento es peor que caído. Una dependencia caída libera a quien la llama en milisegundos; una lenta lo retiene con todo lo que tenía tomado. Los recursos ocupados son , y la dependencia lenta multiplica .
- En Tinkuy, con la pasarela 5 segundos más lenta, 99 de las 100 conexiones
quedaron
idle in transactiony el catálogo perdió entre el 78 % y el 87 % de sus pedidos. Es una falla en cascada, y se propaga por el recurso compartido. - Timeout: toda llamada remota tiene un tiempo máximo, elegido entre la latencia normal de la dependencia y lo que la respuesta todavía vale. Acota la espera; no evita la cola si mientras se espera hay un recurso retenido. Con varias llamadas en cadena, el límite es un deadline que se propaga.
- Retry: recupera de faltas transitorias a cambio de carga. Solo sobre operaciones idempotentes, con un máximo de intentos, con backoff exponencial para dar tiempo y con jitter para no llegar todos juntos.
- Tres capas con tres intentos multiplican la carga por . Se reintenta en una sola capa y con un presupuesto de reintentos.
- Circuit breaker: cerrado deja pasar y cuenta; abierto rechaza de inmediato; semiabierto deja pasar una prueba. Vale lo que vale la diferencia entre fallar lento y fallar rápido.
- Bulkhead: separar recursos para que agotar uno no agote los demás. Load shedding: rechazar pronto una parte para atender bien al resto.
- Ninguna defensa arregla la función afectada: hacen que falle rápido y sola. Para que siga dando algo hay que degradar. Y toda defensa se ejerce inyectando fallas.
- Observabilidad: entender qué le pasa al sistema mirando lo que emite. Logs estructurados con identificador de la petición (qué pasó en este caso), métricas (cuánto y con qué tendencia) y trazas (dónde se fue el tiempo), con el contexto propagado en cada llamada y cada mensaje.
- Las cuatro señales doradas: latencia, tráfico, errores y saturación. La latencia de los errores se mide aparte: fallar es rápido.
- SLI = eventos buenos sobre eventos válidos. SLO = el objetivo en una ventana. Error budget = : con 99,5 % y un millón de compras, 5 000. Mientras queda, se experimenta; cuando se acaba, manda la confiabilidad. 100 % no deja presupuesto y nadie lo nota.
- Se alerta por síntomas, y cada alerta pide una acción. Liveness reinicia; readiness quita tráfico; ninguno comprueba una dependencia compartida.
Ejercicios
-
Corran
make tinkuy-up,make tinkuy-load,make tinkuy-slowymake tinkuy-load, y guarden las dos salidas. Con la pasarela lenta, la mediana deGET /eventsbaja. Expliquen por qué con los números de su corrida, y propongan dos métricas del catálogo que, miradas en vez de esa mediana, sí habrían mostrado el problema. -
Un servicio de reservas llama a un servicio de precios cuyo p50 es 20 ms y cuyo p99 es 200 ms. El timeout configurado es de 30 segundos y llegan 50 llamadas por segundo. (a) Calculen cuántas llamadas hay en curso, en promedio, cuando el servicio de precios está sano, y cuántas puede llegar a haber si deja de responder. (b) Propongan un timeout y justifíquenlo con dos números. (c) Con su valor, ¿qué fracción de las llamadas sanas se cortaría? ¿Qué les falta saber para responder con precisión?
-
El navegador le da 2 segundos a
POST /quotes. La tienda tarda 150 ms en leer el producto, llama al courier con un timeout propio de 1 segundo y hasta 3 intentos con backoff de base 100 ms sin jitter, y necesita 50 ms para guardar la cotización. Si el courier no responde nunca, ¿en qué instante sale cada intento, cuándo responde la tienda y qué recibe el usuario? Repitan el cálculo con el deadline propagado y digan cuántos intentos alcanzan a salir. -
Corran
make retriestres veces. (a) En la primera tabla, calculen para cada corrida la fracción de llamadas con 3 intentos que falló y compárenla con ; ¿cuánto varía entre corridas? (b) Repitan la cuenta teórica para un tóxico que corta la mitad de las conexiones y 4 intentos: ¿qué fracción falla y cuántos intentos por llamada hay? (c) En la segunda tabla, expliquen por qué la variante con jitter recibe más pedidos que la de backoff sin jitter, y por qué aun así es preferible para el courier. -
En
experiments/storm.ts, agreguen un caso en el que solo la capa 1 (la más alejada de la dependencia) reintenta 3 veces. Antes de correrlo, predigan cuántos pedidos le llegan al último servicio. Después respondan: si el resultado es igual al del caso “solo la capa 3 reintenta”, ¿por qué la regla dice que reintente la capa pegada a la dependencia? Den dos razones que el conteo no muestra. -
Un circuit breaker con umbral de 5 fallas seguidas protege una dependencia que, por un defecto, responde bien y mal de forma alternada: una sí, una no. (a) ¿Se abre alguna vez? (b) Diseñen, en papel, una regla basada en una proporción de fallas sobre una ventana que sí lo abra, y digan qué parámetros tiene. (c) Con su regla, ¿qué pasa si en la ventana solo hubo dos llamadas y las dos fallaron? Corrijan la regla si hace falta.
-
Un servicio de compras tiene un SLO de 99,5 % de compras buenas sobre una ventana de 28 días y recibe unas 400 000 compras válidas en esa ventana. (a) Calculen el error budget. (b) El día 9 hubo un incidente de 40 minutos en el que falló el 30 % de las compras; el tráfico es parejo a lo largo del día. ¿Cuántas compras malas produjo y qué fracción del presupuesto consumió? (c) El equipo quiere hacer una migración que, según su estimación, hará fallar unas 600 compras. ¿Queda presupuesto? ¿Qué decidirían, y qué dato pedirían antes?
-
Con los logs que deja
make cascade, calculen conmake sliel SLI deGET /productsen las variantesnone,timeoutybulkhead, con un umbral de 300 ms (tendrán que mirar las opciones deobservability/sli-report.ts). Después expliquen por qué un SLO único para “la tienda”, que mezcle las dos rutas, habría sido engañoso en la variantebulkhead, y en qué dirección. -
La tienda de la semana tiene cuatro instancias detrás de un load balancer. Alguien propone que
GET /readyresponda 503 cuando el circuito del courier esté abierto, “para no mandar tráfico a una instancia que no puede cotizar”. Describan paso a paso qué pasa cuando el courier se cae. Luego propongan qué debería hacer la plataforma con la información de que el circuito está abierto, si no es sacar la instancia. -
Para el Tinkuy que entregaron en P4, escriban un SLO para la compra con sus tres partes (indicador, objetivo y ventana), precisando qué es un evento válido y qué es uno bueno. Después escriban el escenario de calidad de disponibilidad, con sus seis partes, que dice qué debe pasar con el catálogo cuando la pasarela tarda 5 segundos. No lo implementen: digan qué experimento, con qué tóxico y con qué carga, lo confirmaría o lo refutaría, y qué número mirarían.