Apuntes · Capítulo 16Fallas, operación y evolución
Arquitecturas reales y cierre del curso
Arquitecturas reales y cierre del curso
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos, además del caso que eligió su equipo): de Cómo se lee un caso, Las cinco preguntas, Lo que el texto dice y lo que uno infiere y Un caso es una foto con fecha; y la sección del caso que les tocó (Stack Overflow (2016): mucho tráfico en pocas máquinas, Discord (2023): una partición caliente y una migración o Figma (2024): de una base de datos a sharding horizontal), después de haber leído el texto original, no en su lugar.
- En clase: Sesión A: Cómo se lee un caso, los tres casos, Los tres casos, lado a lado, El recorrido del curso en una página y El rol de quien hace arquitectura. Sesión B: Cómo se presenta una arquitectura y Cómo se critica y cómo se defiende una arquitectura. Laboratorio: Laboratorio: defensa oral del proyecto, con Una falla elegida en el momento a la mano.
- Después de clase: el Resumen y los Ejercicios. Antes de la presentación conviene releer Responder un «¿qué pasa si…?» y «Una de cada tres» es por conexión. Opcionales: los dos casos que no leyó su equipo, El rol de quien hace arquitectura y El código de la semana.
La semana pasada cerramos los temas del curso: cómo se protege una arquitectura con fitness functions, cómo se reconoce y se paga la deuda, cómo se saca un servicio de un monolito sin detenerlo, y qué cambia cuando una de las piezas del sistema es un modelo de lenguaje. Con eso, cada equipo tiene un Tinkuy que pasó por seis entregas y un conjunto de decisiones escritas.
Esta semana no hay técnica nueva. Hay dos cosas que hasta ahora hicimos poco y que son buena parte del trabajo de arquitectura fuera de un curso: leer la arquitectura de un sistema ajeno y explicar la de uno propio.
La primera sesión es de lectura. Tres equipos de ingeniería publicaron cómo estaba construido su sistema en un momento dado: Stack Overflow en 2016, Discord en 2023 y Figma en 2024. Son textos escritos por quienes operaban esos sistemas, con números y con problemas. Los vamos a leer con las herramientas del semestre (escenarios, alternativas, trade-offs, mediciones) y con una disciplina que el curso todavía no había pedido de forma explícita: separar lo que el texto afirma de lo que uno deduce. Al final de esa sesión está el mapa del curso en una página y una nota sobre el rol de quien hace arquitectura.
La segunda sesión y el laboratorio son suyos: cada equipo presenta su Tinkuy y lo defiende. El capítulo no dice cómo debe ser ese Tinkuy, porque eso es el trabajo de cada equipo y no hay dos iguales. Dice cómo se presenta una arquitectura, cómo se responde una pregunta que empieza con «¿qué pasa si…?», y trae un script para aplicar una falla elegida en el momento a cualquier dependencia HTTP.
Una advertencia sobre las palabras, la misma de la semana 5. En Tinkuy un evento es un concierto o un partido. En este capítulo casi no aparecen eventos de mensajería; cuando aparezca la palabra sin más, es el concierto.
Lectura. Sesión A, una de estas tres, a elección (cada equipo lee una y la presenta en diez minutos): Nick Craver, Stack Overflow: The Architecture — 2016 Edition; Bo Ingram, How Discord Stores Trillions of Messages (2023); Sammy Steele, How Figma’s databases team lived to tell the scale (2024). Complementarias: The Architecture of Open Source Applications, vol. 2, nginx; Kirsten Westeinde, Deconstructing the Monolith (Shopify, 2019); Software Architecture in Practice, cap. 24 The Role of Architects in Projects y cap. 25 Architecture Competence; Martin Fowler, Who Needs an Architect?. El código de la semana está en code/week-16/.
Cómo se lee un caso
Un caso es la descripción de la arquitectura de un sistema real, escrita casi siempre por alguien que trabajó en él. Los hay de muchos tipos: una entrada en el blog de ingeniería de una empresa, un capítulo de libro, una charla, un postmortem. Los tres de esta semana son entradas de blog.
Leer un caso se parece poco a leer un libro de texto. Un libro ordena las ideas para enseñarlas; un caso cuenta lo que pasó, en el orden en que le conviene a quien lo cuenta, y con un propósito que rara vez es enseñar. Quien escribe quiere mostrar un buen trabajo, atraer a gente que quiera trabajar ahí (dos de los tres textos terminan con un aviso de que están contratando) o dejar documentado algo para su propio equipo. Nada de eso lo vuelve falso. Lo vuelve incompleto de una manera predecible: cuenta más la solución que el costo.
Por eso un caso se lee con preguntas preparadas, no de corrido.
Las cinco preguntas
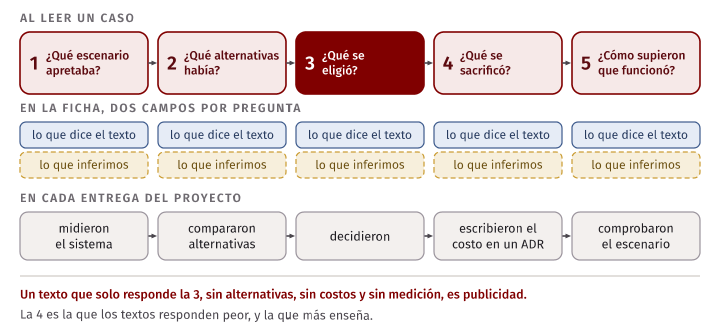
Son las mismas que el curso hizo de cada decisión de Tinkuy, aplicadas a un sistema ajeno:
- ¿Cuál era el escenario que apretaba? Qué atributo de calidad estaba en riesgo y con qué estímulo: más carga, más datos, una falla que se repetía, cambios que tardaban cada vez más. Si el texto da números, el escenario se puede escribir con sus seis partes (semana 2). Si no los da, se anota qué parte falta.
- ¿Qué alternativas había? Qué otras cosas se pudieron hacer, incluida la de no hacer nada. Una decisión sin alternativas no fue una decisión.
- ¿Qué se eligió? La decisión, en una o dos frases, y las piezas que la implementan. Aquí conviene traducir al vocabulario del curso: el texto puede no decir «hot spot» o «modular monolith» y estar describiendo uno.
- ¿Qué se sacrificó? Qué atributo empeoró, qué dejó de poder hacerse, qué se volvió más caro de operar. Es la pregunta que los textos responden peor, y la que más enseña.
- ¿Cómo supieron que funcionó? Qué midieron antes y después. «Ahora es mucho más rápido» no es una respuesta; «el p99 de insertar un mensaje pasó de un rango de 5 a 70 ms a 5 ms» sí lo es.
Idea clave. Un texto que solo responde la tercera pregunta, sin alternativas, sin costos y sin medición, no es un caso: es publicidad. Se puede leer, pero no se puede aprender de él a decidir, porque no muestra ninguna decisión.
Las cinco preguntas son el ciclo del proyecto visto desde afuera. En cada entrega ustedes midieron el sistema, compararon alternativas, decidieron, escribieron lo que costaba en un ADR y comprobaron el escenario. Un buen caso deja ver ese mismo ciclo; uno malo solo deja ver el resultado.
Lo que el texto dice y lo que uno infiere
La segunda disciplina es no mezclar dos cosas que al leer se mezclan solas:
- Lo que el texto afirma. «En Cassandra las lecturas son más caras que las escrituras», «el p99 quedó en 15 ms», «tardamos nueve meses en la primera tabla». Son afirmaciones de quien estuvo ahí. Se citan con su fuente y su fecha.
- Lo que uno infiere. «Esto es un bulkhead», «seguro tenían un problema de costos», «por eso no usaron microservicios». Puede ser una buena lectura, pero es de quien lee. Se dice como inferencia: «el texto no lo llama así, pero…».
La diferencia importa por tres razones. La primera es de honestidad: atribuir a un equipo algo que no dijo es inventar una fuente. La segunda es práctica: las inferencias son justamente donde uno se equivoca, y si están marcadas se pueden discutir. La tercera es que el hueco entre las dos columnas es información: cuando para responder una pregunta todo lo que se tiene es inferencia, el texto no la respondió.
Un ejemplo de cómo se resbala. El texto de Stack Overflow no usa en ningún lugar la palabra «monolito». Describe una aplicación principal que atiende todos los sitios de preguntas y respuestas, varias aplicaciones separadas y un nivel de servicios internos. Decir «Stack Overflow es un monolito» es una inferencia razonable sobre esa aplicación principal, y se presenta así; «el texto dice que es un monolito» es falso.
Error común. Completar el caso con lo que uno sabe por otras fuentes (una charla, un hilo en una red social, lo que «todo el mundo sabe» de esa empresa) y presentarlo como si estuviera en el texto. Si se usa otra fuente, se cita aparte, con su propia fecha. En estos apuntes, todo lo que se dice de cada sistema sale del texto indicado y de ningún otro lugar.
Un caso es una foto con fecha
Los tres textos describen su sistema en el momento en que se escribieron. El de Stack Overflow da las estadísticas de un día concreto, el 9 de febrero de 2016. El de Discord se publicó en marzo de 2023 y cuenta una migración que terminó en mayo de 2022. El de Figma es de marzo de 2024 y dice de forma explícita que el trabajo no ha terminado y que piensan reevaluar la decisión central.
Ninguno dice cómo es el sistema hoy, y estos apuntes tampoco. Lo que se puede aprender de una foto es el razonamiento: con esa carga, ese equipo y esas herramientas, eligieron esto y pagaron aquello. Por eso en una ficha de lectura la fecha es un campo obligatorio, y por eso todas las frases sobre estos sistemas van en pasado.
Trade-off. Leer un caso reciente o uno antiguo. El reciente usa tecnología que ustedes pueden encontrar hoy, pero todavía no se sabe cómo envejeció la decisión. El antiguo deja ver las consecuencias (el texto de Discord de 2023 empieza corrigiendo las expectativas de uno suyo de 2017), pero sus números y sus herramientas ya no son los de ahora. Para aprender a decidir, el segundo suele enseñar más: muestra una decisión con su desenlace.
La ficha de lectura
Para que la lectura deje algo, cada equipo llena una ficha. El template está
en case-worksheet-template.md:
los datos del texto (con su fecha), las cinco preguntas con dos campos cada
una, y tres secciones finales.
## 4. Lo que se sacrificó

- **Lo que dice el texto:** <qué costo reconoce: qué dejó de poder hacerse, qué se volvió más difícil>
- **Lo que inferimos:** <costos que el texto no menciona y que la decisión trae>
Las tres secciones finales son Lo que el texto no dice (lo que haría falta saber para evaluar la decisión), Semanas del curso (qué temas ilustra el caso) y Qué no copiaríamos sin su contexto.
Hay una ficha llena de ejemplo, sobre una de las lecturas complementarias
para no hacerles el trabajo de las tres principales: el texto de Shopify de
2019 sobre cómo pasaron de un monolito a un modular monolith
(example/case-worksheet-shopify.md).
Así quedó la cuarta pregunta:
## 4. Lo que se sacrificó

- **Lo que dice el texto:** poco. Reconoce que el cambio masivo de archivos hizo que
  GitHub perdiera buena parte del historial (los movimientos quedaron como borrados y
  creaciones), que el equipo que empezó no pudo aislar todos los componentes porque hacían
  falta expertos de cada dominio, y que los límites todavía no se hacen cumplir: Wedge
  reporta, no bloquea.
- **Lo que inferimos:** sigue habiendo un solo despliegue, así que el despliegue acoplado
  y los recursos compartidos del monolito no cambian. Y medir violaciones sin bloquear el
  build deja que el número vuelva a crecer si nadie lo mira.
El primer campo empieza con «poco», y eso también es una respuesta. El texto de Shopify explica muy bien el problema y las alternativas y casi no habla de costos; la ficha lo deja a la vista en vez de rellenar el campo con suposiciones.
El revisor check-doc.ts comprueba la forma de la ficha, como
scenario-check.ts hacía con los escenarios en la semana 2:
$ make check
node check-doc.ts worksheet example/case-worksheet-shopify.md
✔ example/case-worksheet-shopify.md
En errors/ hay una ficha mal hecha a propósito, sobre el texto de Discord.
Cuenta la solución y casi nada más:
$ make errors
✖ errors/worksheet-only-solution.md
    El texto: falta el campo "Qué describe"
    El texto: la fecha no dice el año: un caso describe su sistema en un momento
    1. El escenario que apretaba: falta el campo "Lo que dice el texto"
    1. El escenario que apretaba: falta el campo "Lo que inferimos"
    2. Las alternativas: falta la sección
    4. Lo que se sacrificó: falta la sección
    Lo que el texto no dice: falta la sección
    Semanas del curso: no nombra ninguna semana ("semana 11")
    Qué no copiaríamos sin su contexto: falta la sección
check-doc terminó con código 1
Cada línea del reporte corresponde a una de las ideas de esta sección. La fecha decía «hace unos años». El escenario decía «tenían muchísimos mensajes y la base de datos no escalaba», sin separar qué afirma el texto. Faltaban justo las dos preguntas que distinguen un caso de un anuncio, las alternativas y el costo. Y en las semanas del curso decía «todas», que es la forma de no haber pensado en ninguna.
Como todo revisor del curso, este comprueba la forma y no el fondo. Una ficha puede pasar y estar mal leída: atribuir al texto algo que no dice, o dar por medición lo que es un ejemplo. Eso se revisa como se revisaron los escenarios de la semana 2, intercambiando la ficha con otro equipo que leyó el mismo texto.
Stack Overflow (2016): mucho tráfico en pocas máquinas
Nick Craver, que entonces trabajaba en la infraestructura de Stack Overflow, publicó el texto el 17 de febrero de 2016. Es el primero de una serie y él mismo lo presenta como un panorama logístico: qué piezas hay y cómo se conectan, con el detalle de cada una prometido para entradas posteriores. Eso define qué se le puede pedir. Es un inventario comentado, no la historia de una decisión, y varias de las cinco preguntas van a quedar a medio responder.
Lo que dice el texto
La carga. El texto abre con las estadísticas de un día, el 9 de febrero de 2016: 209 420 973 pedidos HTTP al load balancer, de los cuales 66 294 789 fueron cargas de página; 504 816 843 consultas SQL solo desde pedidos HTTP; y 5 831 683 114 accesos a Redis. Una página de pregunta se generaba en 22,71 ms en promedio, y la página principal en 11,80 ms.
Las máquinas. Para eso lista, entre otras: 4 servidores de SQL Server, 11 servidores web con IIS, 2 servidores de Redis, 3 servidores para el motor de tags, 3 de Elasticsearch y 4 load balancers con HAProxy. Frente a la lista de 2013, dice, casi no hubo cambios aparte de renovar equipos. Y agrega un dato que el autor acompaña de una advertencia: después de las optimizaciones y del hardware nuevo, Stack Overflow podía funcionar con un solo servidor web; lo habían comprobado sin querer algunas veces, y aclara que decir que funciona no es decir que sea buena idea.
Todo es redundante. Antes de describir las piezas da unas reglas generales: todo servidor tiene un par en otro rack, dos fuentes de poder y al menos dos enlaces de 10 Gbps, y todo está duplicado en un segundo centro de datos, en Colorado; el texto habla sobre todo del de Nueva York.
La aplicación. De los 11 servidores web, 9 son los principales y 2 son de pruebas y de los sitios meta. La aplicación principal de preguntas y respuestas es multi-tenant: una sola aplicación atiende los pedidos de todos los sitios de la red. Otras aplicaciones (Careers, las API) corren aparte. Detrás hay un nivel de servicios internos con el motor de tags, que responde qué preguntas corresponden a un tag, en 3 servidores: el texto explica que cargar todas las preguntas con sus tags cada dos minutos es caro, que no querían hacerlo nueve veces en el nivel web, y que tres «es suficiente y nos da suficiente seguridad».
La cache. Usan Redis para una cache de dos niveles. L1 es la cache en memoria de cada servidor web; L2 es Redis. Cuando un servidor no encuentra un valor en ninguna de las dos, lo trae del origen (una consulta, una llamada) y lo guarda en ambas; el siguiente servidor que lo necesite quizá no lo tenga en L1, pero lo encuentra en L2 y se ahorra la consulta. Redis sirve también de canal: cuando un servidor borra una entrada, publica un mensaje para que los demás la quiten de su L1. Según el texto, Redis atendía unos 160 000 millones de operaciones al mes con cada instancia por debajo de 2 % de CPU.
La base de datos. SQL Server es «la única fuente de verdad»: todo lo que hay en Elasticsearch y en Redis sale de ahí. Son dos clústeres; cada uno tiene un principal, que recibe casi toda la carga, una réplica en Nueva York y otra en Colorado, y todas las réplicas son asíncronas. Las máquinas son grandes: las del primer clúster tienen 384 GB de RAM y las del segundo 768 GB. Del uso que hacen de SQL, el texto dice que es simple, y que «lo simple es rápido»: una biblioteca propia y delgada para las consultas (Dapper) y un solo procedimiento almacenado en toda la base de datos.
Medir. Los load balancers registran, para cada pedido, datos de rendimiento que el nivel web les envía en cabeceras. Entre las bibliotecas que publican está MiniProfiler, que describe como un profiler que corre en cada página.
Las cinco preguntas
| Pregunta | Lo que dice el texto | Lo que inferimos |
|---|---|---|
| El escenario que apretaba | No cuenta un problema: describe un sistema que funciona. Da la carga de un día y el tiempo promedio por página, y dice que «el rendimiento sigue siendo una funcionalidad» | El escenario implícito es de rendimiento: con unos 209 millones de pedidos al día, la página de una pregunta se genera en decenas de milisegundos. Da promedios, no percentiles: la medida del escenario quedaría incompleta |
| Las alternativas | Solo en decisiones puntuales: Elasticsearch en vez de la búsqueda de texto de SQL Server (porque las CPU de SQL son caras) y en vez de Solr (porque entonces no permitía buscar en toda la red); websockets en vez de polling | No discute la alternativa que más interesa en el curso, repartir la aplicación en servicios o los datos en shards. Que no la discuta no dice que no la evaluaran |
| Lo que se eligió | Una aplicación multi-tenant sobre pocos servidores, SQL Server como única fuente de verdad con réplicas asíncronas, cache en dos niveles, máquinas con mucha memoria y redundancia en todo | Es un monolito con algunos servicios alrededor, más cerca del estilo service-based de la semana 5 que de los microservicios; y escala hacia arriba en los datos (máquinas más grandes) antes que hacia los lados |
| Lo que se sacrificó | Casi nada explícito. Que el nivel web está sobredimensionado a propósito (despliegues graduales, holgura y redundancia). Que no han podido actualizar Elasticsearch porque exige reindexar todo. Que los websockets agotan puertos y descriptores en el load balancer | Hardware propio en dos centros de datos, que alguien tiene que comprar y mantener. Un principal por clúster: las escrituras no se reparten. Y una afinación fina (el texto cuenta que fijan procesos a sockets de CPU) que depende de gente que conoce cada detalle |
| Cómo supieron que funcionó | Las cifras del día y la comparación con noviembre de 2013: 61 millones de pedidos más al día y, aun así, el tiempo total de procesamiento en la aplicación bajó de 757 a 447 horas, por el hardware nuevo y por la afinación | La comparación mezcla dos cambios, hardware y código, sin separar cuánto aportó cada uno |
Dos comentarios sobre esta tabla.
El primero es sobre la columna del medio en la fila de costos. El texto es un inventario escrito con orgullo y casi no dice qué pagaron. Eso no lo invalida, pero limita lo que se puede concluir. La frase «Stack Overflow demuestra que un monolito escala» va más allá del texto: lo que el texto muestra es que, en febrero de 2016, esa carga se atendía con esas máquinas.
El segundo es sobre «escalar hacia arriba». El texto no lo enuncia como principio. Lo que hay son hechos que apuntan en esa dirección (servidores de base de datos con cientos de GB de RAM, un principal por clúster, un nivel web que cabría en una máquina) y un nivel web de nueve servidores que existe por redundancia y por los despliegues, no por capacidad. La lectura es nuestra.
Idea clave. Lo que este caso sostiene, leído con cuidado, es más modesto y más útil que el eslogan: el estilo no determina la escala. Una aplicación en un solo despliegue, con una base de datos relacional y una cache bien puesta, atendía cientos de millones de pedidos al día. Quien proponga distribuir un sistema mucho más chico que ese «para que escale» tiene que decir qué escenario concreto no cumple el diseño simple.
Las semanas que ilustra
- Semana 2. El texto mide: pedidos, consultas, tiempo por página. También muestra el límite que vimos entonces: son promedios. No se sabe cómo le iba al pedido más lento de cada cien.
- Semana 4. Un monolito no es un big ball of mud, y un sistema puede ser un monolito en su parte central y tener servicios donde hay una razón (el motor de tags se separó porque su carga de cómputo es distinta y no hacía falta repetirla en cada servidor web).
- Semana 6. Tácticas de rendimiento (cache, reducir el trabajo por pedido) y de disponibilidad (redundancia en cada nivel, un segundo centro de datos).
- Semana 10. Replicación con un líder y réplicas asíncronas, una de ellas en otro centro de datos para recuperarse de un desastre.
- Semana 11. Cache en dos niveles con invalidación por mensajes: cuando un servidor borra un valor, avisa a los demás. Es la respuesta de este sistema al problema de los datos viejos en una cache local.
En Tinkuy. El Tinkuy inicial se parecía a este sistema en la forma (un proceso, una base de datos relacional) y en casi nada más: no tenía cache, abría una conexión por pedido y
GET /eventshacía una consulta por cada evento de la lista. Tener la forma de un sistema que escala no da su rendimiento. Lo que Stack Overflow tenía, además de la forma, era años de medir cada pedido y afinar.
Discord (2023): una partición caliente y una migración
Bo Ingram, ingeniero de Discord, publicó el texto el 6 de marzo de 2023. Continúa uno de 2017, en el que el mismo equipo contaba cómo había pasado sus mensajes de MongoDB a Cassandra buscando una base de datos escalable, tolerante a fallas y de poco mantenimiento. El de 2023 empieza reconociendo que esa última expectativa no se cumplió. A diferencia del de Stack Overflow, este sí cuenta una decisión completa, con su antes y su después.
Lo que dice el texto
El problema. En 2017 el clúster de mensajes tenía 12 nodos de Cassandra. A comienzos de 2022 tenía 177 nodos y guardaba billones de mensajes (el texto dice trillions, que en español son billones: millones de millones). Era, en sus palabras, un sistema de mucho trabajo manual: llamaban seguido a quien estaba de guardia, la latencia era impredecible y habían tenido que recortar operaciones de mantenimiento que se volvieron demasiado caras.
El esquema. Los mensajes se guardan con una clave de partición formada por el canal y un bucket, que es una ventana fija de tiempo. Todos los mensajes de un canal en una ventana quedan juntos y se replican en tres nodos. El texto señala la consecuencia: un servidor de Discord con un grupo pequeño de amigos envía órdenes de magnitud menos mensajes que uno con cientos de miles de personas, así que hay particiones muchísimo más pedidas que otras.
La partición caliente. En Cassandra, explica, leer es más caro que escribir. Muchas lecturas concurrentes sobre una misma partición la convertían en lo que llaman una hot partition. Y el daño no se quedaba ahí: el nodo se atrasaba, las demás consultas a ese nodo también se demoraban, y como leían y escribían con quórum, todas las consultas a los nodos que servían esa partición sufrían. A eso se sumaban el mantenimiento (las compactaciones se atrasaban y encarecían aún más las lecturas) y las pausas del recolector de basura de la JVM.
Las dos decisiones. La primera fue cambiar de motor: ScyllaDB, compatible con Cassandra y escrito en C++, sin recolector de basura. Para 2020 habían migrado todas sus bases de datos menos una, la de mensajes. La segunda fue no confiar en que un motor nuevo lo arreglara todo: el texto dice que las particiones calientes también pueden ocurrir en ScyllaDB, y que querían proteger la base de datos desde antes.
Los servicios de datos. Entre su API (a la que el texto llama un monolito) y las bases de datos pusieron servicios intermedios, escritos en Rust, con más o menos un endpoint gRPC por consulta y sin lógica de negocio. Lo que aportan es unir pedidos idénticos (request coalescing): si varios usuarios piden la misma fila al mismo tiempo, el primero lanza una tarea que consulta la base de datos y los demás se suscriben a esa tarea; la base de datos recibe una consulta y todos reciben la respuesta. Delante agregaron enrutamiento por hash consistente con el identificador del canal como clave, para que todos los pedidos de un canal lleguen a la misma instancia del servicio y la unión funcione mejor. El texto es franco sobre el resultado: ayudó mucho, pero las particiones calientes siguieron apareciendo en Cassandra, solo que menos seguido. Les dio tiempo.
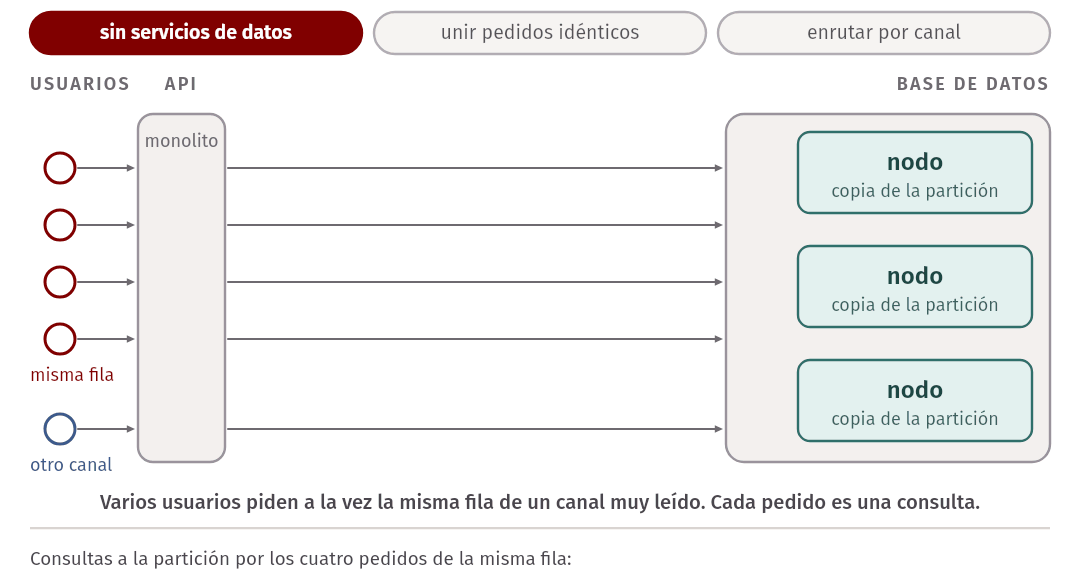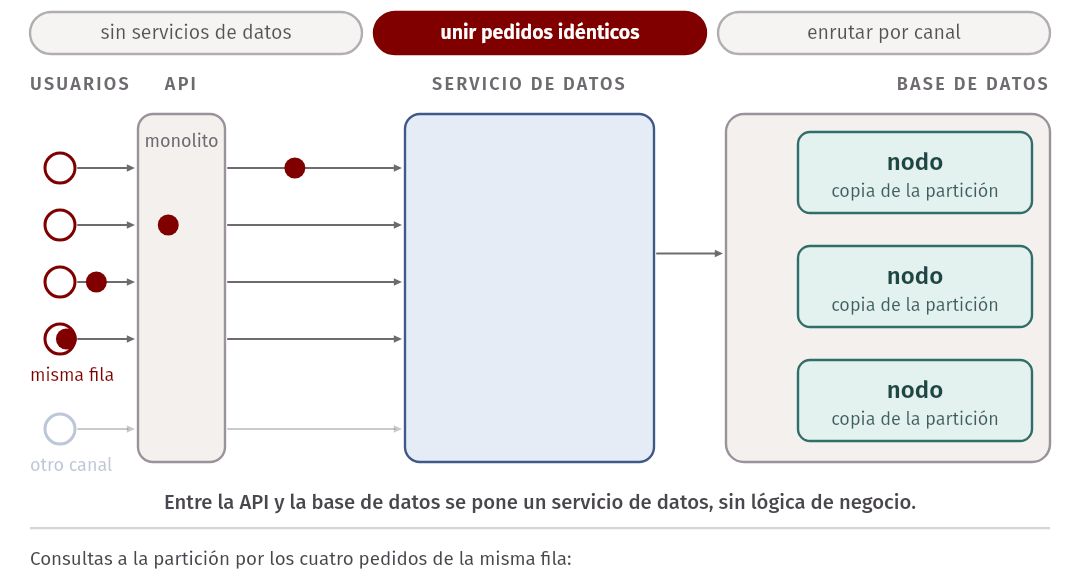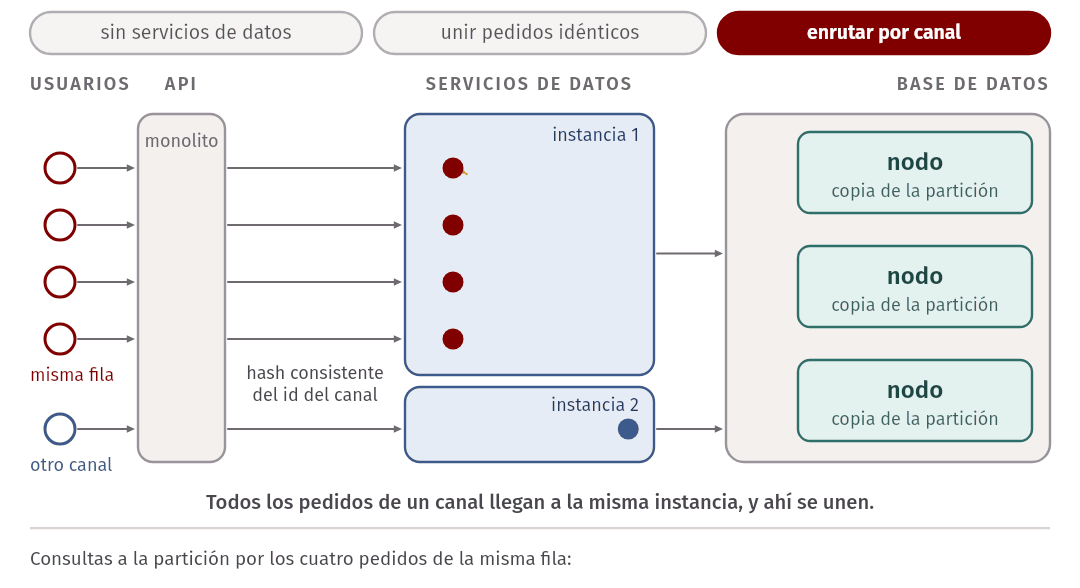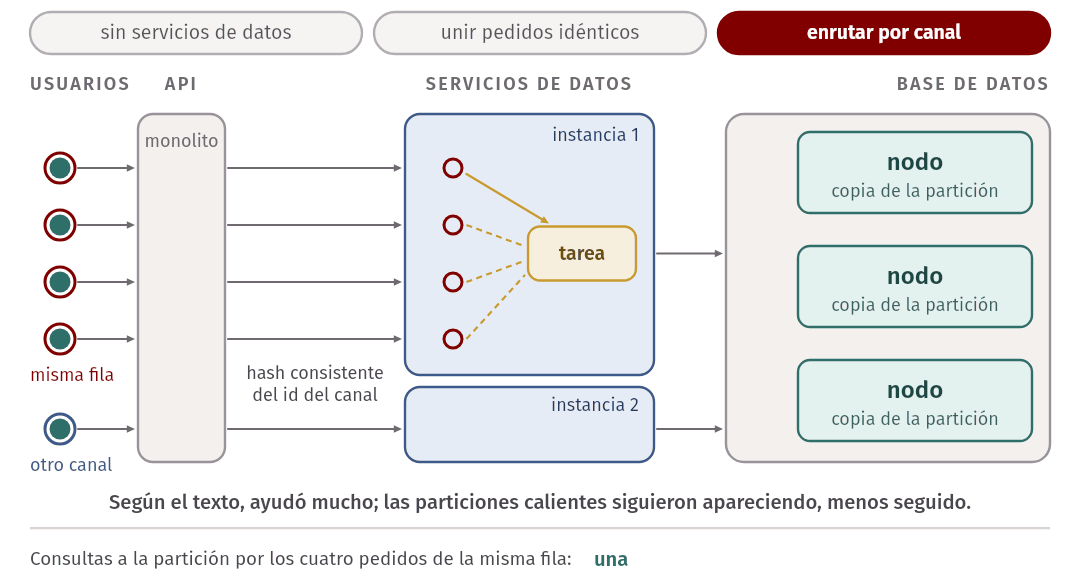
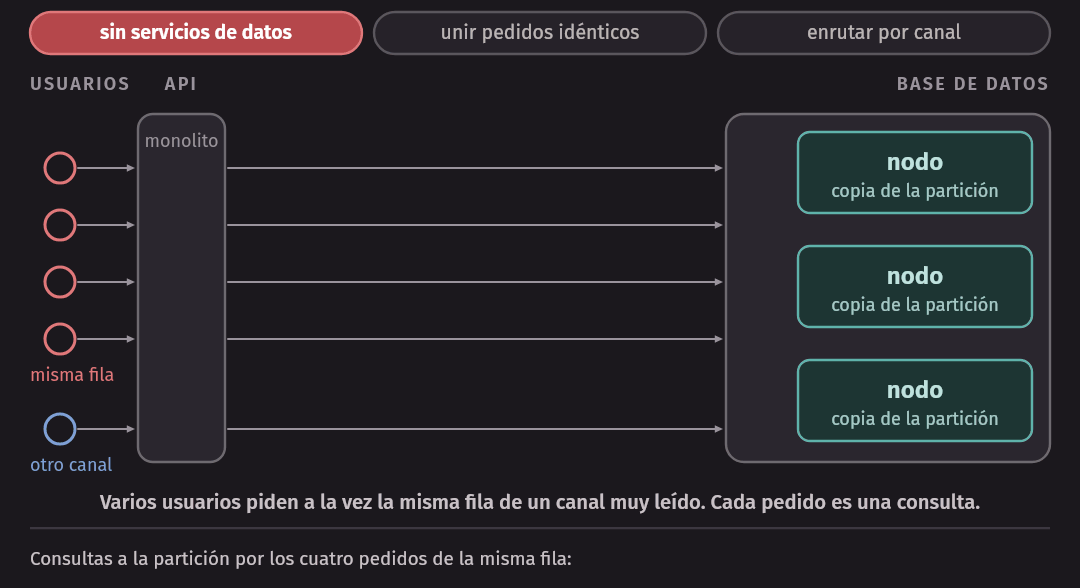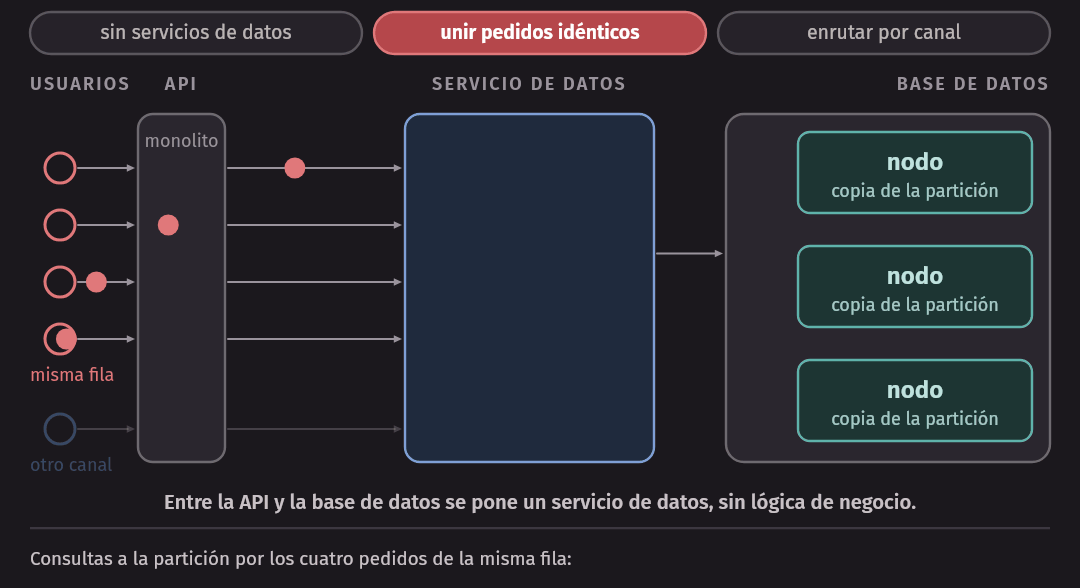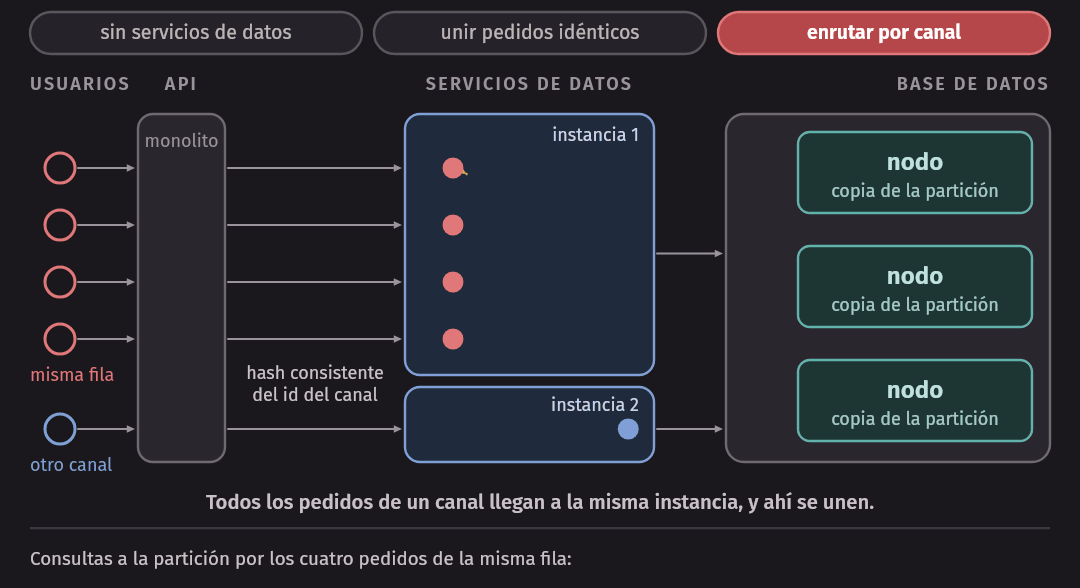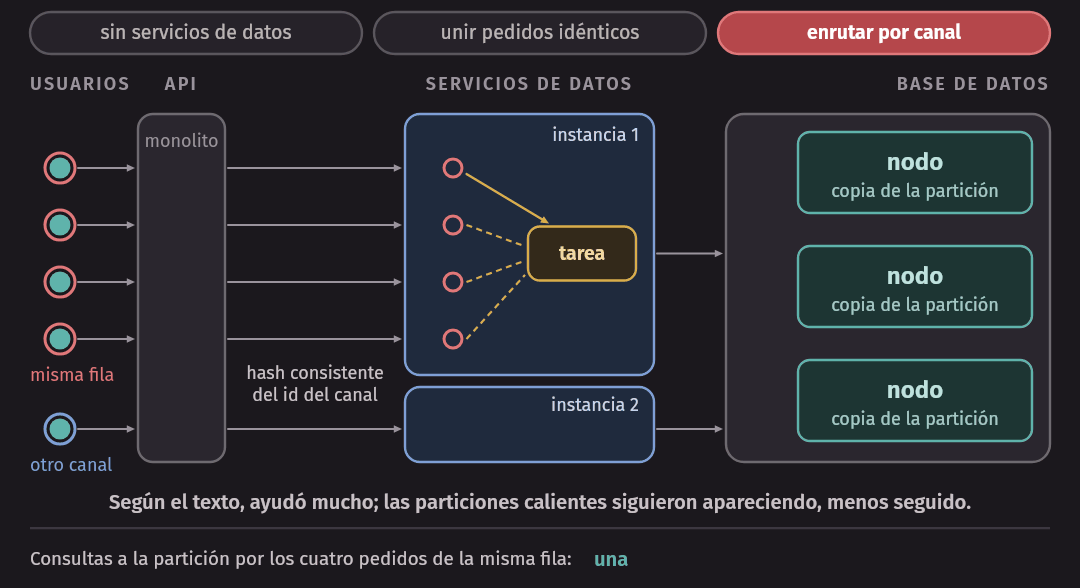
La migración. El requisito era migrar billones de mensajes sin detener el servicio. El primer plan era gradual: usar ScyllaDB para los datos nuevos a partir de una fecha de corte y migrar los históricos por detrás. Empezaron a escribir cada mensaje nuevo en las dos bases de datos y prepararon el migrador que venía con ScyllaDB, cuya estimación fue de tres meses. Entonces extendieron su propia biblioteca de servicios de datos para migrar: lee rangos de la base de datos, guarda el avance en un archivo local y escribe en ScyllaDB. La nueva estimación fue de nueve días, y con eso abandonaron el plan por fecha de corte y decidieron cambiar todo de una vez. La migración llegó a 3,2 millones de mensajes por segundo y se detuvo en 99,9999 %: los últimos rangos tenían cantidades enormes de tombstones que Cassandra nunca había compactado. Compactaron ese rango y terminó. Antes del cambio enviaron una pequeña fracción de las lecturas a las dos bases de datos y compararon los resultados.
El resultado. Cambiaron en mayo de 2022. El texto compara: de 177 nodos de Cassandra a 72 de ScyllaDB (con 9 TB de disco por nodo en vez de 4 TB en promedio); el p99 de traer mensajes históricos, de entre 40 y 125 ms a 15 ms; el p99 de insertar un mensaje, de entre 5 y 70 ms a 5 ms. Y cuenta la final del mundial de fútbol de fines de 2022, cuyos goles se veían en el gráfico de mensajes enviados sin que el sistema se inmutara.
Las cinco preguntas
| Pregunta | Lo que dice el texto | Lo que inferimos |
|---|---|---|
| El escenario que apretaba | Latencia impredecible y guardias frecuentes: una partición muy leída degradaba a todo el clúster, y el mantenimiento empeoraba con el tamaño | Dos escenarios, no uno. De rendimiento: muchos usuarios leen un mismo canal a la vez y los demás canales no deben notarlo. Y de operación: el esfuerzo de mantener el clúster no debe crecer con los datos |
| Las alternativas | Seguir con Cassandra y afinarla (lo hicieron durante años: sacar nodos de rotación para que compactaran, ajustar el recolector de basura). Para la migración, el plan por fecha de corte con el migrador existente | No nombra otros motores ni la opción de cambiar la clave de partición para repartir los canales grandes, que es la primera que sugiere la semana 11. No sabemos si la evaluaron |
| Lo que se eligió | Servicios de datos que unen pedidos idénticos, enrutados por hash consistente del canal; y ScyllaDB para los mensajes, con doble escritura, un migrador propio y validación comparando lecturas | Unir pedidos es el remedio contra la estampida de la semana 11 (que uno solo consulte y los demás esperen), puesto delante de la base de datos en vez de delante de una cache |
| Lo que se sacrificó | Poco explícito: que ScyllaDB «no está libre de problemas», que tuvieron que esperar a que mejorara un tipo de consulta que necesitaban, y que la base de datos de mensajes fue la última en migrar, unos dos años después que las demás | Una capa más entre la API y los datos: un salto de red más y un servicio más que operar y del que todo depende. La doble escritura sin transacción puede dejar las dos bases de datos distintas; por eso la validación |
| Cómo supieron que funcionó | Nodos, p99 de lectura y de escritura, antes y después, y un pico real de carga (la final del mundial) | La comparación de nodos no es a igual capacidad: los nuevos tienen más del doble de disco. Y no separa cuánto aportó el motor y cuánto los servicios de datos, que llegaron juntos |
Tres comentarios.
El hot spot no se resolvió con la función de hash. En la semana 11 vimos que una clave que concentra la carga no se arregla repartiendo mejor las claves, porque el problema es una sola clave. Este caso lo confirma con un sistema real: la clave de partición (canal y ventana de tiempo) reparte bien los canales entre los nodos, y aun así un canal enorme es una partición enorme de pedidos. La respuesta de Discord no fue cambiar el reparto, sino reducir cuántas veces se le pregunta lo mismo a esa partición.
Lo que el texto dice sobre limitar la concurrencia. El texto plantea el objetivo con esas palabras: si pudieran controlar la cantidad de tráfico concurrente hacia las particiones calientes, protegerían a la base de datos. Los mecanismos que describe para lograrlo son dos, unir pedidos idénticos y enrutar por canal. No describe un límite de llamadas concurrentes ni un pool separado por canal, que es lo que en la semana 14 llamamos bulkhead. Lo que sí muestra, y muy bien, es el problema que un bulkhead ataca: un recurso compartido (los nodos que sirven una partición) que, al saturarse por un cliente, degrada a todos los demás.
La migración terminó siendo menos gradual de lo planeado. El plan original repartía el riesgo en el tiempo; el que ejecutaron copió todo en días y cambió de una vez. Lo que hizo aceptable ese cambio no fue la gradualidad sino otras tres cosas que el texto sí cuenta: la doble escritura (la base de datos nueva recibía los mensajes nuevos desde antes), la copia con puntos de control (se podía retomar) y la validación con lecturas reales antes de cambiar. El texto no dice si mantuvieron Cassandra como vuelta atrás después del cambio ni por cuánto tiempo.
Trade-off. Unir pedidos idénticos reduce la carga sobre la base de datos justo cuando más duele, cuando muchos piden lo mismo. A cambio, todos esos pedidos dependen de una sola consulta: si esa consulta es lenta o falla, es lenta o falla para todos los que esperaban. Y solo ayuda cuando los pedidos son de verdad idénticos; mil usuarios leyendo mil canales distintos pasan todos.
Las semanas que ilustra
- Semana 11, sharding. Clave de partición compuesta, hot spots que el hash no arregla, y enrutamiento por hash consistente (en los servicios de datos).
- Semana 11, cache. La estampida: muchos pedidos por el mismo dato al mismo tiempo, y el remedio de que uno solo vaya al origen.
- Semana 10. Factor de replicación tres, y lecturas y escrituras con quórum; aquí se ve un costo de los quórums que no habíamos medido: un nodo lento afecta a toda consulta que lo necesite para completar el suyo.
- Semana 14. Falla en cascada por latencia: el nodo se atrasa, atiende peor, se atrasa más.
- Semana 9. Migrar sin detener: escribir en lo viejo y en lo nuevo, copiar lo histórico, mover las lecturas. Es la secuencia expandir, migrar y contraer aplicada a una base de datos entera.
- Semana 2. El resultado se reporta con p99, no con promedios.
Figma (2024): de una base de datos a sharding horizontal
Sammy Steele, líder técnica del equipo de bases de datos de Figma, publicó el texto el 14 de marzo de 2024. Es, de los tres, el que más se parece a un ADR largo: enumera los criterios, nombra las alternativas, dice por qué descartó cada una y termina con una lista de lo que queda pendiente.
Lo que dice el texto
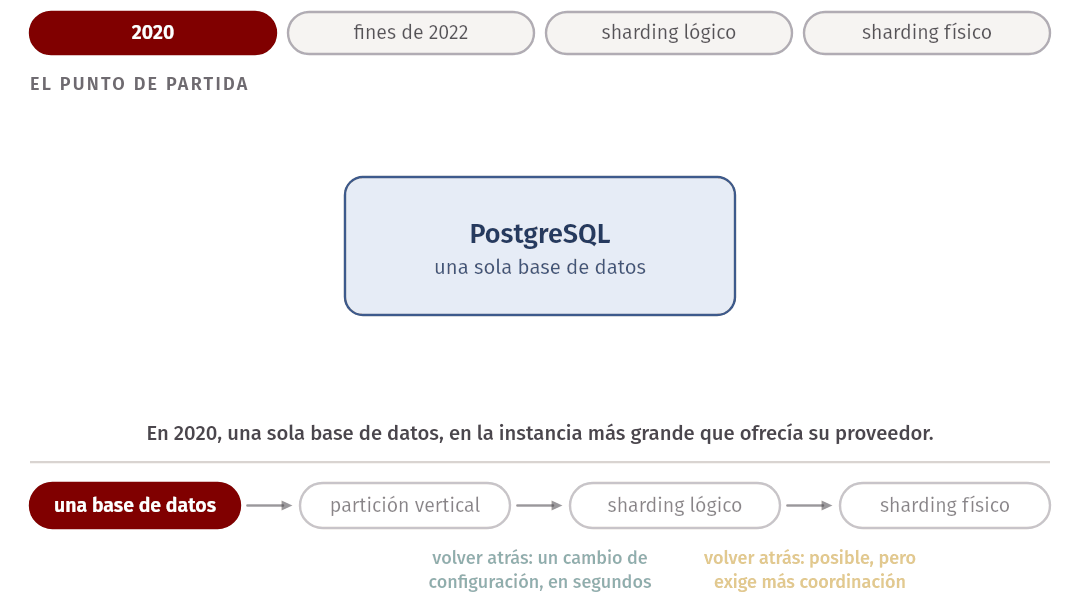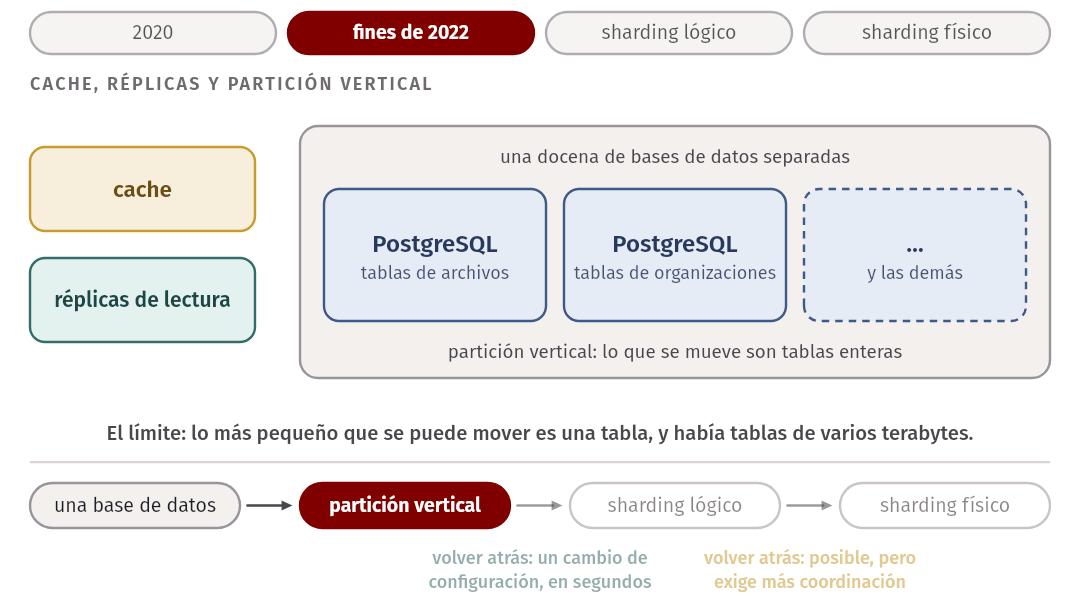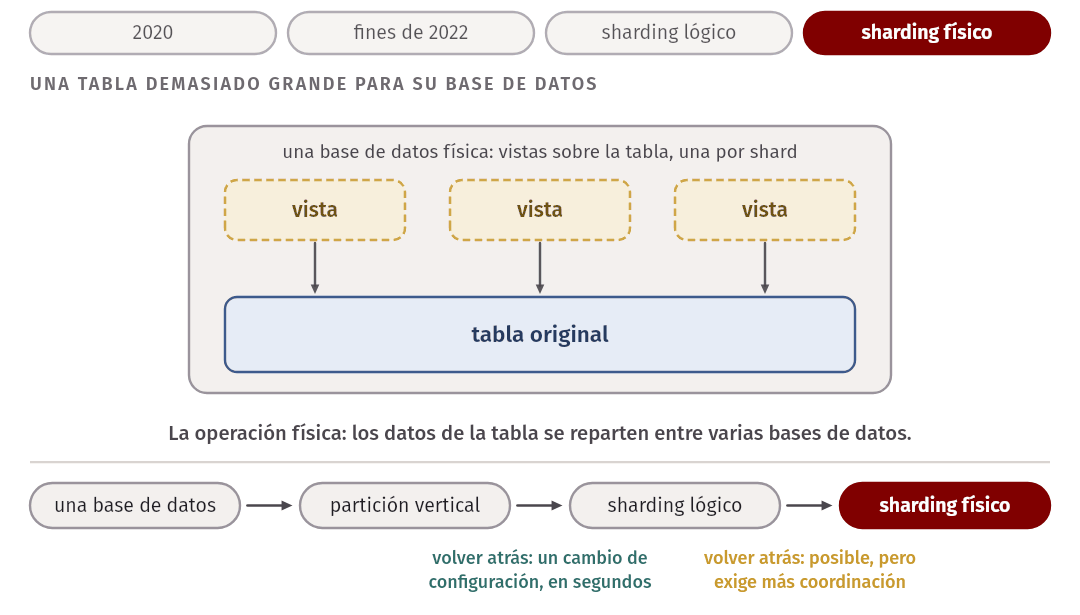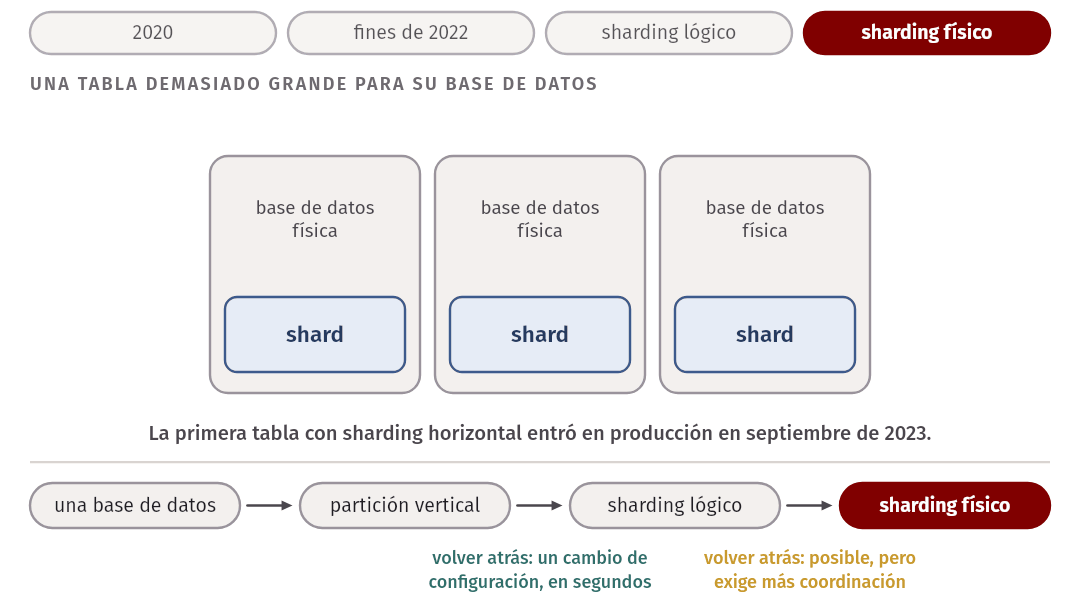
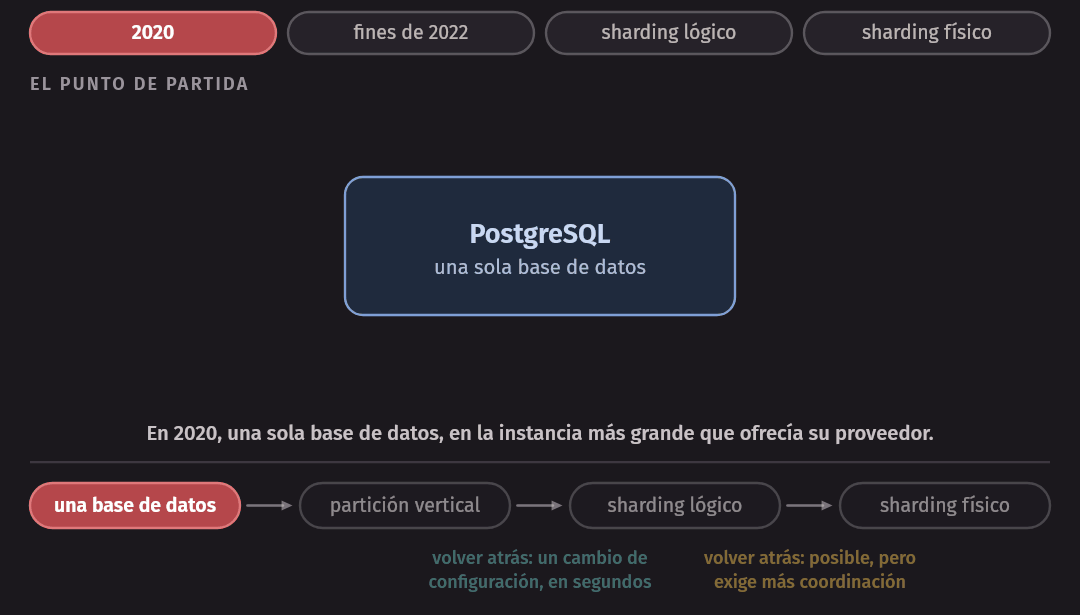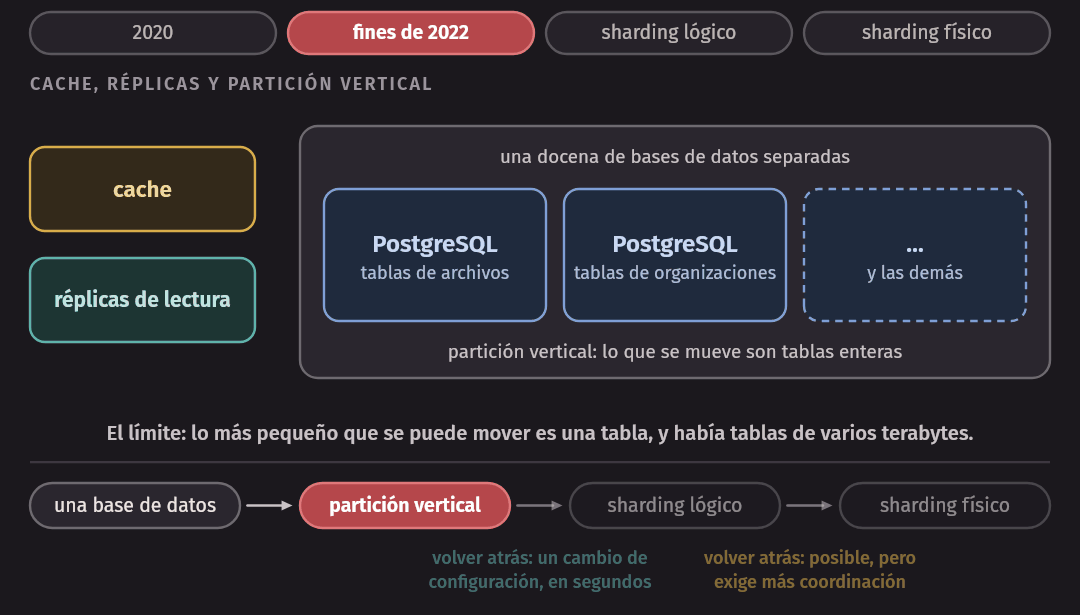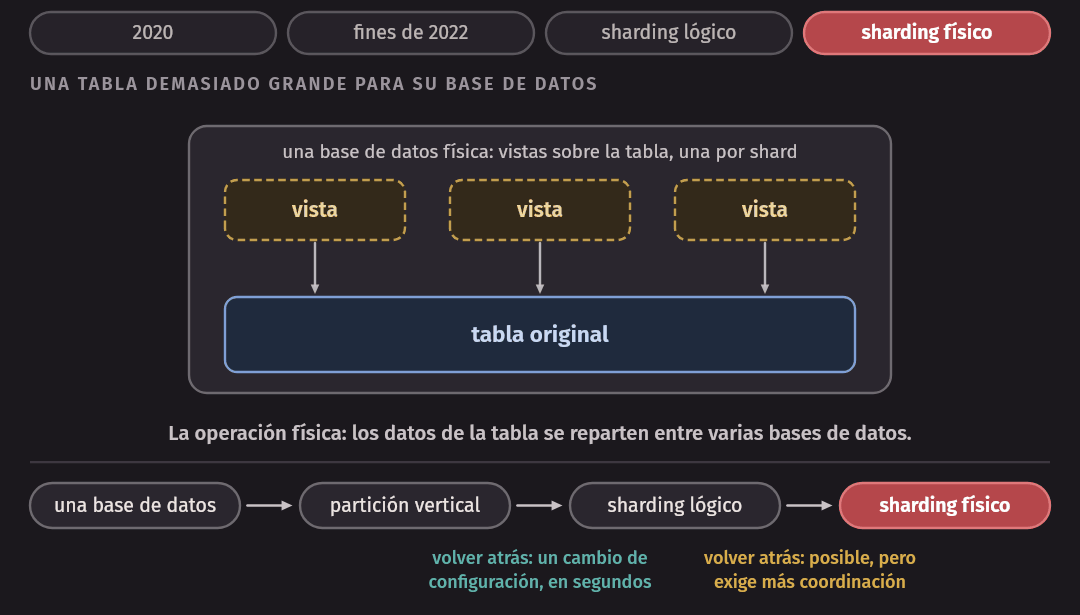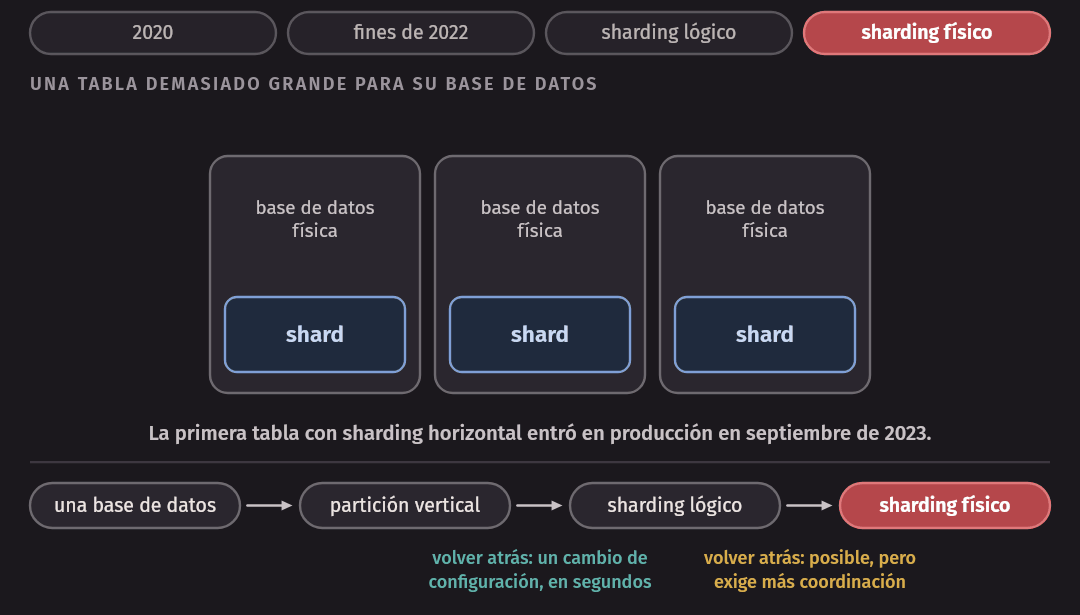
El punto de partida. En 2020, Figma corría sobre una sola base de datos PostgreSQL, en la instancia física más grande que ofrecía su proveedor. Para fines de 2022 tenía cache, réplicas de lectura y una docena de bases de datos separadas por partición vertical: grupos de tablas relacionadas (las de archivos, las de organizaciones) movidos cada uno a su propia base de datos. El texto dice que el conjunto creció casi cien veces desde 2020.
El límite. La partición vertical tiene un piso: la unidad más pequeña que se puede mover es una tabla. Y había tablas de varios terabytes y miles de millones de filas que ya eran demasiado grandes para una sola base de datos: los vacuums de PostgreSQL empezaban a afectar la confiabilidad, y las tablas con más escrituras iban a superar pronto el máximo de operaciones de disco por segundo que soportaba su servicio de base de datos. Les quedaban, dice, meses de margen.
Los criterios. Antes de las opciones, el texto lista lo que una solución debía cumplir. Entre otros: afectar poco a quienes desarrollan el producto; no exigir copias masivas de datos, que habrían tomado meses; poder avanzar de a pocos; evitar migraciones de un solo sentido, es decir, poder volver atrás incluso después de completar una operación; y mantener una consistencia fuerte, para lo cual querían evitar soluciones como la doble escritura, difíciles de implementar sin detener el servicio o sin ceder consistencia.
Las alternativas. Evaluaron bases de datos con sharding horizontal ya resuelto (nombra CockroachDB, TiDB, Spanner y Vitess). Las descartaron porque cambiar de motor exigía una migración compleja entre dos almacenes y perder la experiencia acumulada operando PostgreSQL, con meses de margen: prefirieron, dice, soluciones conocidas y de bajo riesgo antes que opciones quizá más fáciles pero más inciertas. Descartaron NoSQL porque su modelo de datos es relacional y complejo, y habría que reescribir casi todo el backend. Eligieron construir el sharding horizontal sobre lo que ya tenían. El texto reconoce el riesgo de esa opción (un equipo pequeño no debería reimplementar una base de datos distribuida genérica) y la respuesta: no hacerla genérica, sino a la medida de Figma, con muchas menos funciones.
Lo que construyeron.
- Varias claves de sharding, no una. No había una sola clave buena para
todas las tablas, y agregar una habría exigido una columna nueva en cada
tabla y copias masivas. Eligieron un puñado (el usuario, el archivo, la
organización) y agruparon las tablas que comparten clave en colos:
dentro de un colo se pueden hacer
JOINy transacciones completas siempre que se limiten a un valor de la clave. La mayor parte del código ya consultaba así. - Hash de la clave. Muchas de esas claves eran identificadores autoincrementales o con prefijo de tiempo, que habrían concentrado los datos en un shard. En vez de cambiar los identificadores, enrutan por el hash de la clave. El costo, que el texto nombra: las consultas por rango sobre la clave son menos eficientes; lo aceptaron porque ese patrón era poco común en su código.
- Sharding lógico antes que físico. Separaron la preparación de una tabla en la aplicación (que todas las lecturas y escrituras se comporten como si ya estuviera repartida) de la operación física de repartir los datos. Para lo primero usaron vistas de PostgreSQL sobre la tabla original, una por shard. Así probaron todo el camino con los datos todavía en una sola máquina, activándolo por porcentaje con feature flags; volver atrás era un cambio de configuración que tomaba segundos. Volver atrás de la operación física, dice, es posible pero exige más coordinación.
- Un proxy con un motor de consultas. Un servicio nuevo, DBProxy, se ubica entre la aplicación y la base de datos: analiza cada consulta SQL, deduce a qué shard lógico va y la envía a la base de datos física correspondiente. También hace load shedding. Una consulta que no trae la clave de sharding tiene que ir a todos los shards y juntar las respuestas (scatter-gather), y el texto advierte que cada una de esas carga a todas las bases de datos tanto como antes de repartir.
- Probar con tráfico real antes de decidir. Para saber qué consultas soportar, corrieron la planificación «en sombra» sobre el tráfico de producción con distintas claves posibles y analizaron el resultado. Con eso definieron un subconjunto de SQL que cubría el 90 % más común de las consultas y dejaba fuera los peores casos.
Lo que costó, dicho por el texto. No hay transacciones atómicas entre
shards (una escritura puede quedar hecha en un shard y fallar en otro, y el
código del producto tiene que tolerarlo); los JOIN solo se permiten dentro
de un colo y por la clave; PostgreSQL ya no puede hacer cumplir claves
foráneas ni índices únicos globales; los cambios de esquema hay que
coordinarlos en todos los shards; las vistas agregan un costo que midieron,
mínimo en la mayoría de los casos y menor de 10 % en los peores. Y el
tiempo: nueve meses para repartir la primera tabla.
El resultado. La primera tabla con sharding horizontal entró en producción en septiembre de 2023. El cambio físico tuvo diez segundos de disponibilidad parcial en los principales y ninguno en las réplicas, y no vieron regresiones de latencia ni de disponibilidad. El texto cierra con lo pendiente (cambios de esquema, identificadores únicos globales, transacciones atómicas entre shards para los casos críticos) y con una frase poco común en este tipo de textos: cuando tengan margen, van a reevaluar si seguir con su solución propia o pasar a una de código abierto o administrada.
Las cinco preguntas
| Pregunta | Lo que dice el texto | Lo que inferimos |
|---|---|---|
| El escenario que apretaba | Crecimiento: tablas que ya no cabían en una base de datos, vacuums que afectaban la confiabilidad y un límite de escrituras por segundo a meses de distancia | Es un escenario de escalabilidad con plazo. El plazo es parte del escenario: con dos años de margen, la alternativa de cambiar de motor se habría evaluado distinto |
| Las alternativas | Cuatro motores con sharding incorporado, NoSQL y sharding propio; y dentro de la elegida, una clave única o varias, identificadores aleatorios o hash, esquemas separados o vistas | Es el caso que mejor responde esta pregunta. No discute subir el límite por otra vía (por ejemplo, archivar datos antiguos), quizá porque no alcanzaba |
| Lo que se eligió | Sharding horizontal propio sobre PostgreSQL: colos, hash de la clave, sharding lógico con vistas antes del físico, y un proxy que enruta | Sharding por hash con la clave elegida según cómo consulta el código (semana 11), y una migración en la que el paso reversible va primero |
| Lo que se sacrificó | Transacciones entre shards, parte de SQL, claves foráneas e índices únicos globales, consultas por rango eficientes, y nueve meses para la primera tabla | Un proxy propio por el que pasa toda consulta: una pieza crítica nueva que el equipo tiene que mantener. El texto lo insinúa cuando dice que reevaluarán la decisión |
| Cómo supieron que funcionó | Antes del cambio: pruebas de carga con y sin vistas y lecturas en sombra comparadas. Después: diez segundos de disponibilidad parcial y ninguna regresión | A la fecha del texto solo habían repartido tablas «relativamente simples»; las bases de datos con decenas de tablas quedaban por delante. El resultado es de la primera etapa |
Dos comentarios.
La tabla de costos casi no necesita la tercera columna. Es la marca de un buen caso: quien lo escribió ya hizo el trabajo de decir qué se perdió. Comparen esa fila con la misma fila de Stack Overflow.
Figma y Discord resolvieron la migración de formas opuestas, y las dos tienen sentido. Discord escribió cada mensaje en las dos bases de datos durante la migración. Figma puso entre sus criterios evitar justamente la doble escritura, porque quería consistencia fuerte. La diferencia está en los datos. Un mensaje de chat se escribe una vez y casi no se modifica: escribirlo en dos lugares y comparar después es manejable. Las tablas de Figma son un modelo relacional con transacciones entre tablas: una escritura que entra en una base de datos y no en la otra rompe invariantes. La misma técnica, buena en un contexto y descartada en el otro.
Idea clave. Los criterios de Figma (avanzar de a pocos, poder volver atrás, no reescribir la aplicación, usar lo que el equipo ya sabe operar) no son técnicos en el sentido estrecho: son sobre el riesgo. Entre una solución mejor en el papel y una que el equipo podía construir, probar y deshacer con meses de margen, eligieron la segunda y lo dejaron escrito, junto con la promesa de revisarla.
Las semanas que ilustra
- Semana 11. Casi completa: cuándo hace falta sharding (cuando ya no queda otra táctica), la elección de la clave por los patrones de consulta, hash contra rango con su costo, hot spots por identificadores secuenciales, y el costo de las consultas que no traen la clave.
- Semana 12. Lo que se pierde al repartir: no hay transacción entre shards, y una operación puede quedar a medias.
- Semanas 9 y 15. Migrar de forma incremental: primero el cambio que se deshace con una configuración, después el que cuesta deshacer; activar por porcentaje con feature flags; comparar en sombra antes de confiar.
- Semana 7. Decidir con criterios explícitos y alternativas nombradas, y dejar escrito bajo qué condición se revisa.
- Semana 14. Load shedding, aquí en el proxy de la base de datos.
Los tres casos, lado a lado
| Stack Overflow (2016) | Discord (2023) | Figma (2024) | |
|---|---|---|---|
| Qué tipo de texto es | Un inventario del sistema | La historia de un problema y su solución | Una decisión con criterios, alternativas y pendientes |
| Lo que apretaba | Nada urgente: describe un sistema estable | Latencia y operación de un clúster que crecía | Tablas que dejaban de caber, con plazo |
| La respuesta | Pocas máquinas grandes, cache en dos niveles, todo redundante | Una capa de servicios delante de los datos y un cambio de motor | Sharding horizontal propio sobre lo que ya tenían |
| Dónde viven los datos | Relacional, un principal por clúster y réplicas asíncronas | Almacén distribuido, partición por canal y tiempo, tres copias | Relacional, repartido por dominio y luego por hash de una clave |
| Lo que el texto reconoce que costó | Casi nada | Poco | Mucho, con detalle |
| La evidencia | Cifras de un día y comparación con 2013 | p99 y nodos, antes y después | Pruebas previas y el resultado del primer cambio |
¿Qué tienen en común? Menos de lo que uno quisiera para armar una moraleja, y conviene decir solo lo que los tres textos sostienen:
- Los tres miden. Con distinta calidad (promedios en uno, p99 en otro, pruebas en sombra en el tercero), pero ninguno argumenta con adjetivos.
- Los tres prefieren lo que su equipo ya sabía operar. Stack Overflow dice que lo simple es rápido. Discord esperó dos años, hasta tener experiencia con ScyllaDB en producción, antes de mover su base de datos más grande. Figma descartó cuatro motores para quedarse con PostgreSQL.
- En los dos que cuentan un cambio, el cambio respondió a un problema observado, no a una preferencia: guardias y latencia en Discord, límites medidos en Figma. Y en ambos el sistema siguió atendiendo durante la migración.
- Ninguno presenta su arquitectura como la arquitectura correcta. El de Figma promete revisarla; el de Discord corrige a su propio texto de 2017.
Y en qué difieren, que es igual de instructivo:
- Stack Overflow no cuenta ninguna migración: dice que en dos años casi nada cambió. Es un caso sobre no cambiar.
- La migración de Discord terminó haciéndose de una vez; la de Figma fue gradual por diseño, con la vuelta atrás como requisito.
- Discord usó doble escritura; Figma la descartó de forma explícita.
Error común. Copiar la arquitectura de un caso sin su contexto. La de Discord responde a billones de mensajes y a un clúster de 177 nodos que ya no podían mantener; poner servicios de datos en Rust delante de una base de datos de un millón de filas agrega una capa y no resuelve nada. La de Stack Overflow responde a una carga dominada por lecturas y a un equipo que conocía cada detalle de sus máquinas; con un equipo que rota cada año, esa afinación se pierde. La de Figma responde a tablas de terabytes y a un plazo de meses; con tablas de gigabytes, la partición vertical y una réplica dan años de margen. Lo que se copia de un caso es la forma de decidir, no la decisión.
En la industria. No todos los casos son de empresas que cuentan su producto. The Architecture of Open Source Applications reúne capítulos escritos por quienes mantienen proyectos de código abierto. El de nginx, de Andrew Alexeev, parte de un escenario de concurrencia: un servidor web que crea un proceso o un hilo por conexión gasta memoria por cada cliente conectado, y con miles de conexiones simultáneas y clientes lentos ese costo domina. La respuesta de nginx fue una arquitectura modular, dirigida por eventos y sin bloqueo, con pocos procesos de un solo hilo que atienden cada uno miles de conexiones. El capítulo también dice el costo de la otra opción: un servidor de propósito general con muchas funciones paga con más CPU y memoria por conexión. Es un buen cuarto caso para quien quiera uno sobre un solo proceso y no sobre una flota.
El recorrido del curso en una página
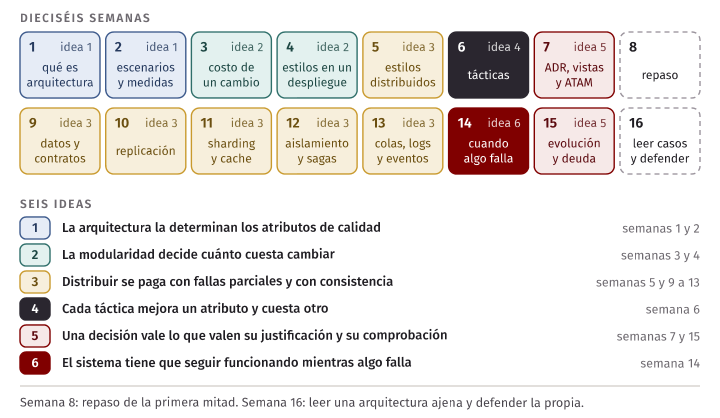
El curso tuvo una sola pregunta, la que estaba en la primera página del programa: en arquitectura no hay respuestas correctas sin contexto, así que ¿cómo se decide? Cada semana agregó una pieza para responderla.
| Semana | La pregunta | Lo que quedó |
|---|---|---|
| 1 | ¿Qué es la arquitectura y qué la determina? | Las estructuras que permiten razonar sobre el sistema y las decisiones que cuesta cambiar. La determinan los requisitos significativos, no la funcionalidad |
| 2 | ¿Cómo se dice qué tan bien debe funcionar? | Un escenario de seis partes con su medida. Percentiles en vez de promedios. Los atributos compiten: decidir es elegir qué se sacrifica |
| 3 | ¿Cuánto cuesta un cambio? | Depende de cuántos módulos toca. Ocultamiento de información, cohesión, acoplamiento, y dependencias que una herramienta revisa |
| 4 | ¿Cómo se organiza un sistema en un solo despliegue? | Capas, modular monolith, pipeline, microkernel. Un estilo da sus propiedades solo si sus restricciones se hacen cumplir |
| 5 | ¿Cuándo se distribuye? | Cuando un escenario lo exige. Al cruzar la red aparecen las fallas parciales; cada estilo distribuido renuncia a algo del monolito |
| 6 | ¿Con qué se mejora un atributo? | Con tácticas. Cada una mejora un atributo y cuesta otro, y se comprueba midiendo antes y después |
| 7 | ¿Cómo se registra y se evalúa una decisión? | ADR, vistas (C4, arc42) y una evaluación con escenarios (ATAM) antes de construir |
| 9 | ¿Qué cambia cuando los datos son el problema? | Sistemas transaccionales y analíticos; esquemas y contratos que evolucionan sin romper a quien los usa: expandir, migrar, contraer |
| 10 | ¿Cómo se sobrevive a la caída de una máquina con datos? | Replicación. Síncrona o asíncrona, con su retraso; un líder, varios o ninguno, con quórums |
| 11 | ¿Y cuando no cabe en una máquina, o se lee demasiado? | Sharding (con sus hot spots) y cache (con sus datos viejos y sus estampidas) |
| 12 | ¿Cómo se mantiene correcto lo que ocurre a la vez? | Transacciones y niveles de aislamiento en una base de datos; sagas, idempotencia y outbox entre servicios |
| 13 | ¿Cómo se comunican las partes sin esperarse? | Colas y logs, garantías de entrega y orden; event sourcing y CQRS; qué promete la consistencia |
| 14 | ¿Qué pasa cuando algo falla? | Timeouts, retries, circuit breaker, bulkhead, load shedding; y observabilidad para saber qué pasó |
| 15 | ¿Cómo se mantiene todo esto en el tiempo? | Fitness functions, deuda de arquitectura, strangler fig, ley de Conway; y las mismas preguntas cuando una pieza es un modelo de lenguaje |
| 16 | ¿Cómo se lee una arquitectura ajena y se defiende la propia? | Las cinco preguntas, lo que el texto dice y lo que uno infiere, y criticar con escenarios |
La semana 8 fue el repaso de la primera mitad.
Seis ideas
Si la tabla se tuviera que reducir, quedarían seis ideas. Cada una se vio en Tinkuy y se vuelve a ver en los casos de esta semana.
- La arquitectura la determinan los atributos de calidad (semanas 1 y 2). Lo que el sistema hace se puede construir de muchas formas; lo que decide entre ellas es cuánta carga, cuánta disponibilidad, cuánto cambio. Ninguno de los tres casos habla de funcionalidades: hablan de latencia, de operación y de crecimiento.
- La modularidad decide cuánto cuesta cambiar (semanas 3 y 4). Un límite bien puesto hace que un cambio probable toque un módulo. Y un límite solo existe si algo lo comprueba: ustedes lo hicieron con dependency-cruiser desde P1; Shopify, con su propia herramienta.
- Distribuir se paga con fallas parciales y con consistencia (semanas 5 y 9 a 13). Cada vez que algo se separó (una réplica, una cache, un servicio, un shard) apareció una pregunta nueva sobre qué ve quién y cuándo. Figma lo dice con todas sus letras: al repartir una tabla se pierden propiedades que una base de datos sola daba sin pedirlas.
- Cada táctica mejora un atributo y cuesta otro (semana 6). No hay táctica gratis. La cache de Stack Overflow necesita mensajes de invalidación; unir pedidos en Discord ata muchos pedidos a una consulta; el hash de Figma encarece las consultas por rango.
- Una decisión vale lo que valen su justificación y su comprobación (semanas 7 y 15). Un ADR sin alternativas no registra una decisión, y una decisión que nadie comprueba se deshace sola con los cambios siguientes. El texto de Figma es, en la práctica, un ADR con sus pruebas.
- El sistema tiene que seguir funcionando mientras algo falla (semana 14). No se diseña para el día en que todo anda. La partición caliente de Discord era un sistema que funcionaba bien hasta que una parte se degradaba y arrastraba al resto.
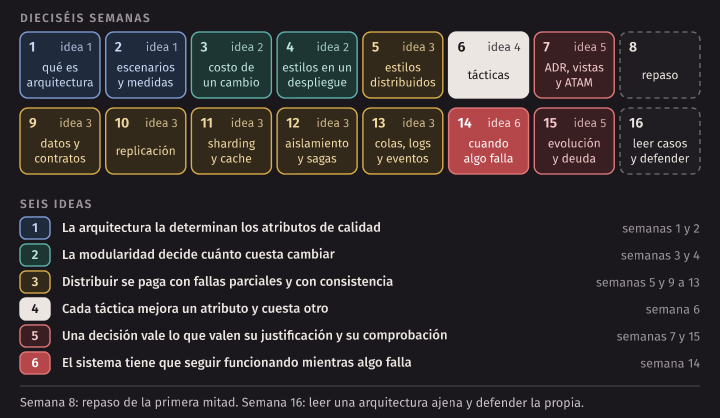
Idea clave. Las seis ideas caben en una: decidir con evidencia y dejar escrito lo que se pagó. Un escenario dice qué se necesita; una medición dice si se cumple; las alternativas dicen qué más se pudo hacer; el ADR dice qué se eligió y qué costó; la fitness function avisa si deja de cumplirse. Las tecnologías del curso (PostgreSQL, Redis, NATS, Toxiproxy) van a cambiar. Ese ciclo, no.
Lo que el curso no cubrió
Un semestre alcanza para una parte. Lo que quedó afuera, y por dónde sigue:
- El despliegue y la operación en detalle. Pipelines de integración y despliegue continuo, infraestructura como código, orquestación de contenedores. El curso corrió todo en un contenedor a propósito, para mirar la arquitectura y no la plataforma; un sistema en producción necesita lo otro. El libro Site Reliability Engineering, citado en el programa, es un buen comienzo y es de lectura libre.
- La arquitectura en la nube y sus costos. Qué servicio administrado reemplaza a qué pieza, cuánto cuesta y qué tan difícil es salir de él. En el curso ninguna decisión tuvo precio en dinero; afuera, casi todas lo tienen, y el costo es un atributo de calidad más. El caso de Figma lo roza cuando un límite de su proveedor se vuelve el límite de su arquitectura.
- Los algoritmos de los sistemas distribuidos. Vimos qué promete el consenso y para qué sirve un quórum, no cómo se implementa un protocolo de consenso ni cómo se ordenan eventos sin un reloj común. Es materia de un curso de sistemas distribuidos; los apuntes de Kleppmann citados en el programa son la continuación natural.
- El diseño de la interfaz de usuario. Tinkuy fue una API. La arquitectura de un frontend, su estado y su relación con el backend tienen sus propios estilos y trade-offs.
- La seguridad más allá de las tácticas. La semana 6 dio el vocabulario; modelar amenazas y diseñar la autenticación y la autorización de un sistema real es un tema entero.
En Tinkuy. Una buena forma de ver estos huecos es preguntarse qué le falta a su Tinkuy para atender a compradores de verdad. La respuesta no está en ninguna entrega, y es la sexta pregunta de repaso de la guía de la semana: nombrar un tema que el curso no cubrió y que su sistema necesitaría para salir a producción.
El rol de quien hace arquitectura
Durante el semestre nadie en su equipo tuvo el cargo de arquitecto, y aun así se tomaron decisiones de arquitectura cada dos o tres semanas. Eso describe bien cómo ocurre en muchos equipos: la arquitectura es una actividad antes que un cargo. En un equipo pequeño la hace todo el equipo; en uno grande puede haber personas dedicadas, pero lo que hacen es lo mismo.
Arquitectura es lo que el equipo considera importante
Martin Fowler escribió en 2003 una columna breve, Who Needs an Architect?, que sigue siendo la mejor entrada al tema. Empieza admitiendo que «arquitecto» y «arquitectura» son palabras muy gastadas, y cita una respuesta de Ralph Johnson en una lista de correo que da dos ideas.
La primera: la arquitectura es el entendimiento compartido que los desarrolladores con más experiencia tienen del diseño del sistema. Qué entra en ese entendimiento no lo decide una definición, sino el grupo: es arquitectura lo que el equipo considera importante. La base de datos es arquitectura en un sistema de negocio y puede no serlo en un programa de imágenes médicas, donde lo difícil está en otra parte.
La segunda es la que usamos desde la semana 1: arquitectura son las decisiones que uno quisiera acertar temprano, porque son difíciles de cambiar.
De ahí Fowler distingue dos formas de ejercer el rol. En una, el arquitecto toma todas las decisiones importantes, temprano, para que los demás tengan un plan que seguir. En la otra, que es la que defiende, el arquitecto está metido en el proyecto: programa con el equipo por la mañana, participa en una reunión de requisitos por la tarde para explicar qué cuesta cada idea, y sobre todo sube el nivel de los demás, porque un equipo que entiende las decisiones depende menos de una sola persona.
Reducir lo irreversible
La columna termina con la idea que más nos sirve para cerrar el curso. Si arquitectura son las decisiones difíciles de cambiar, entonces una de las tareas más importantes de quien hace arquitectura es quitar arquitectura: encontrar la forma de que una decisión deje de ser irreversible. El ejemplo de Fowler es el esquema de la base de datos. En un proyecto suyo, alguien construyó la forma de cambiar el esquema y migrar los datos con facilidad; desde ese momento, el esquema dejó de ser una decisión que había que acertar al principio.
Johnson agrega el límite, en la misma columna: se puede hacer que cualquier aspecto del software sea fácil de cambiar, pero no todos a la vez, porque cada cosa que se vuelve fácil de cambiar agrega complejidad. Elegir cuáles vale la pena es el trabajo.
Ustedes hicieron esto varias veces sin llamarlo así:
- El medio de pago como plug-in (P1) volvió reversible la decisión de qué medios de pago se aceptan.
- La secuencia expandir, migrar y contraer (semana 9) vuelve reversible un cambio de contrato hasta el último paso.
- El sharding lógico de Figma, con vistas, existe solo para que el paso más riesgoso se pueda ensayar y deshacer.
Trade-off. Volver reversible una decisión tiene precio: una interfaz más, una capa de indirección, una migración en tres pasos en vez de uno. Se paga cuando el cambio es probable y equivocarse es caro. Hacer todo reversible «por si acaso» es la versión arquitectónica de los puntos de extensión que nadie usa, que vimos con el microkernel en la semana 4.
Lo que el rol exige
De lo anterior y de lo que vivieron en el proyecto sale una lista corta de lo que la actividad exige, sea quien sea que la haga:
- Entender el negocio lo suficiente para saber qué atributo importa. Sin eso no hay utility tree: no se puede decir si pesa más que la venta no se caiga o que el reporte salga rápido.
- Conocer muchas opciones más que una a fondo. Para comparar alternativas hay que saber que existen. Nadie del equipo tiene que ser experto en ScyllaDB; alguien tiene que saber que hay bases de datos que reparten los datos solas y qué se paga por eso.
- Comunicar. La mayor parte del trabajo es explicar y negociar: escribir el ADR, dibujar el diagrama que otro pueda leer, decirle a quien pide una funcionalidad qué cuesta. Es la razón por la que esta semana termina con una presentación y no con un examen de código.
- Seguir cerca del código. Una decisión tomada lejos del código se
separa de la realidad sin que nadie lo note: el diagrama dice una cosa y
los
importdicen otra. En el curso lo evitamos con herramientas que leen el código; en un equipo también hace falta alguien que lo lea.
En la industria. Los textos de esta semana muestran el rol en acción sin nombrarlo. El de Figma agradece al final a una veintena de personas del equipo de bases de datos y a otras de equipos vecinos; el de Shopify cuenta que la lista de componentes salió de consultar a gente de cada área de la empresa, y que la decisión de partir el código se tomó a partir de una encuesta a los desarrolladores. En ninguno hay una persona que decide sola.
Cómo se presenta una arquitectura
La Sesión B es de ustedes. Cada equipo presenta el Tinkuy que entrega con P5, y la guía de la semana dice qué se presenta: el recorrido desde el punto de partida, las tres decisiones más importantes del semestre, una decisión que hoy tomarían distinto, una demostración en vivo y la deuda que queda. Esta sección no agrega requisitos a esa lista. Explica cómo hacer bien cada parte, porque presentar una arquitectura es una habilidad distinta de construirla, y también se aprende.
El orden: problema, decisiones, tecnología
La forma más común de presentar un sistema es empezar por la tecnología: «usamos PostgreSQL, Redis y NATS, y tenemos tres servicios». Es también la peor, por una razón que a estas alturas conocen: la tecnología es la respuesta, y nadie puede evaluar una respuesta sin la pregunta.
El orden que funciona es el del ciclo del proyecto:
- Primero el problema y los escenarios. Qué tenía que lograr el sistema, dicho con dos o tres escenarios de calidad con su medida. Con eso, quien escucha ya sabe contra qué va a juzgar todo lo que sigue.
- Después las decisiones. Para cada escenario, qué se decidió, qué más se pudo hacer y qué costó.
- Al final la tecnología. Cuando aparece, ya tiene un porqué: «para ese escenario necesitábamos que el catálogo no dependiera del principal, y por eso hay una réplica».
Error común. Presentar en orden cronológico: «en P0 hicimos esto, en P1 esto otro…». El orden de las entregas es el orden en que llegaron los requisitos, no el orden que mejor explica el sistema. El recorrido de antes y después se muestra una vez, con dos diagramas; el resto de la presentación se organiza por decisiones.
Un diagrama por idea
Un diagrama en una presentación responde una pregunta. Si responde tres, quien escucha no sabe cuál mirar. Algunas reglas que salen de la semana 1 y de la semana 7:
- Cada diagrama dice qué tipo de vista es. Contenedores (lo que corre) y módulos (lo que se importa) no se mezclan en el mismo dibujo.
- Toda caja dice qué es y con qué tecnología; toda flecha dice qué lleva y por qué protocolo. Es la regla del formato del curso, y vale igual dibujado. Una flecha sin etiqueta obliga a preguntar.
- Con leyenda. Si hay dos colores o dos tipos de línea, se dice qué significan.
- El antes y el después, con la misma disposición. Para el recorrido, las cajas que no cambiaron van en el mismo lugar en los dos diagramas, y lo nuevo se resalta. Así la diferencia se ve sin leer.
- Una decisión, un recorte. Para explicar una decisión no hace falta el diagrama completo: bastan las tres o cuatro cajas que esa decisión tocó.
Los diagramas que entregaron como texto (docs/c4/) son la fuente. Para
presentar se dibujan a partir de ellos, y vale la pena volver a pasarles
check-c4.ts, de la semana 1, después del último cambio: un diagrama que
no coincide con el sistema es lo primero que una pregunta descubre.
Qué se muestra de una decisión
De cada una de las tres decisiones se muestran cinco cosas, que son los campos del template:
- El escenario que la motivó, con su medida.
- Las alternativas descartadas, cada una con su razón en una frase. Es la parte que más se omite y la que más dice: muestra que hubo una decisión.
- La decisión, en una frase, y en qué ADR está.
- Lo que costó: qué atributo empeoró, qué se volvió más difícil de operar o de cambiar.
- La medición de antes y después, con el comando y la máquina.
Sobre la medición valen las reglas de todo el curso. Se muestra tal como salió. Se dice en qué máquina se midió. Se compara el mismo sistema antes y después del cambio, en la misma máquina, y lo que se afirma es la comparación, no el número. Si la decisión no mejoró lo que esperaban, se dice: es lo más interesante que pueden contar.
Elegir tres es parte del trabajo. En el semestre tomaron más de tres decisiones. Elegir cuáles presentar obliga a responder cuáles definieron el sistema. Un criterio que suele servir: las tres que más costaría deshacer hoy. Otro: las tres que un equipo vecino resolvió distinto.
La decisión que tomarían distinto
Esta parte incomoda, y es la que más distingue a un equipo que entendió su sistema. No pide confesar un error; pide mostrar que saben qué aprendieron. Una buena respuesta tiene tres partes:
- Qué sabían cuando decidieron. La decisión pudo ser razonable con la información de ese momento.
- Qué saben ahora que entonces no sabían: una medición, un requisito que llegó después, un costo de operación que no anticiparon.
- Qué harían, y qué costaría hacerlo hoy.
«Elegimos mal» no dice nada. «Elegimos la opción más simple porque el escenario de ese momento no pedía más; dos entregas después llegó un requisito que esa opción no aguantaba, y cambiarla nos costó tocar cuatro módulos» dice mucho, y es exactamente lo que hizo Discord con su texto de 2017.
La demostración en vivo
Una demostración convence más que cualquier lámina, y falla más que cualquier lámina. Tres cuidados:
- Decir antes qué se va a ver. «Voy a poner la dependencia lenta; lo que esperamos es que la venta responda dentro del umbral y que en el log aparezca esta línea». Una demostración sin predicción es una anécdota: si no dijeron qué esperaban, cualquier resultado parece bueno.
- Señalar la evidencia. No basta con que «no se cayó». Se muestra la línea de log, el contador, el percentil. La semana 14 fue sobre eso: saber qué pasó mirando lo que el sistema dice de sí mismo.
- Tener un plan si falla. La salida guardada de una corrida anterior, con su fecha. Y si la demostración falla en vivo, explicar por qué falló vale tanto como que funcione: es una defensa con una falla real.
La deuda, escrita como deuda
Todo sistema entregado tiene cosas pendientes. La diferencia entre deuda y descuido es que la deuda está escrita: qué es, qué cuesta hoy (el interés del que habló la semana 15) y qué la volvería urgente. «Falta mejorar el rendimiento» no es deuda, es una queja. «El reporte de ventas lee del principal; con el doble de eventos compite con la venta; lo moveríamos a la réplica» es deuda: se puede priorizar.
El guion
El template presentation-template.md
es un guion, no la presentación: la lista de lo que van a decir y mostrar,
en el orden de esta sección. Un fragmento:
### Decisión 1: <título, como el de su ADR>

- **Escenario:** <el escenario que la motivó, con su medida>
- **Alternativas descartadas:** <cuáles y por qué: una frase por alternativa>
- **Decisión:** <qué se hizo, en una frase, y en qué ADR está>
- **Lo que costó:** <qué atributo empeoró o qué se volvió más difícil>
- **Medición:** <antes y después, con el comando, la máquina y el archivo donde está el resumen>
check-doc.ts presentation comprueba que estén las seis secciones, que el
recorrido tenga su antes y su ahora, que haya exactamente tres decisiones
con sus cinco campos, que cada medición tenga al menos un número, que
ninguna decisión diga que no hubo alternativas, que la demostración tenga
su predicción y su plan, y que la deuda sea una lista. No comprueba nada de
lo que importa de verdad (si el escenario es el correcto, si la alternativa
se descartó por una buena razón), pero evita llegar a la presentación con
una sección vacía.
Cómo se critica y cómo se defiende una arquitectura
Después de cada presentación hay preguntas, y en el laboratorio hay una defensa. Las dos cosas se hacen con la misma herramienta que el ATAM de la semana 7: escenarios.
Criticar con escenarios
Hay dos formas de objetar un diseño.
- Con una preferencia: «yo habría usado Kafka», «¿por qué no microservicios?», «eso está sobrediseñado». No se puede responder, porque no dice qué saldría mal. Lleva a una discusión de gustos.
- Con un escenario: «¿qué pasa con este diseño si se abre la venta de cien conciertos a la misma hora?», «¿qué pasa si el servicio de pagos responde, pero tarda diez segundos?», «¿qué hay que tocar para agregar un segundo país con otra moneda?». Se puede responder recorriendo el diseño, y la respuesta se puede comprobar.
Cuando les toque preguntar a otro equipo, conviertan la preferencia en escenario antes de abrir la boca. Detrás de «yo habría usado otra cosa» casi siempre hay un escenario que uno teme que el diseño no cumpla; díganlo. Si no encuentran ninguno, la objeción era solo una preferencia.
Idea clave. Una crítica útil tiene la forma de un escenario: un estímulo concreto, sobre una parte concreta, y la pregunta de cuál sería la respuesta. Es útil para quien la recibe, porque o bien su diseño la aguanta y lo puede mostrar, o bien no, y acaba de encontrar un riesgo.
Responder un «¿qué pasa si…?»
Las preguntas de la defensa son casi todas de esta forma. Un procedimiento de cuatro pasos sirve para cualquiera:
- Repetir la pregunta como escenario. «Entonces: cien conciertos abren a la vez, con carga normal en lo demás, y quieren saber si la compra sigue dentro del umbral». Esto da unos segundos, confirma que entendieron y fija el entorno, que es la parte que quien pregunta suele dejar abierta. Si falta un dato, se pregunta: «¿los cien son del mismo local o de varios?».
- Recorrerlo sobre el diagrama. Señalar por dónde entra el estímulo y seguirlo caja por caja. No se responde de memoria: se responde mirando el diseño. Aquí aparecen los recursos compartidos, que es donde casi siempre está la respuesta.
- Decir qué aguanta, qué no y por qué. Las tres partes. Una respuesta que solo dice lo que aguanta es propaganda; una que solo dice lo que no, se rinde antes de tiempo. Cuando haya una medición propia que respalde una parte, se cita.
- Decir qué decisión habría que revisar. Con el número del ADR si lo recuerdan. Es la mejor forma de terminar: muestra que saben de qué decisión depende cada propiedad del sistema.
Tres cosas más, que valen para cualquier pregunta.
«No lo sé» es una respuesta válida si viene con cómo lo averiguarían. «No lo medimos. Lo comprobaría con una prueba de carga con cien conciertos en la semilla, mirando el p95 de la compra y las conexiones activas en la base de datos» es una buena respuesta. Inventar un número no lo es, y se nota en la pregunta siguiente.
Distinguir lo medido de lo esperado. Es la misma disciplina de la lectura de casos, aplicada a ustedes. «Lo medimos y dio esto» y «creemos que aguantaría porque…» son afirmaciones distintas, y quien pregunta tiene derecho a saber cuál está escuchando.
No defender lo indefendible. Si la pregunta encontró un hueco, se dice: «con ese escenario la venta se detiene; no lo consideramos, y es deuda». Todos los sistemas tienen huecos. Lo que se evalúa en una defensa, en un curso o en un trabajo, es si el equipo conoce los de su sistema.
Preguntas típicas
No hay una lista cerrada, pero las preguntas de una defensa de arquitectura caen en pocas familias. Para cada una conviene tener ensayado el recorrido, no la respuesta.
| Familia | Ejemplos | Qué se mira para responder |
|---|---|---|
| Más carga | «¿Y con diez veces más compradores?», «¿y cien conciertos a la vez?» | Los recursos compartidos (conexiones, un lock, una clave caliente) y qué se satura primero |
| Una dependencia falla | «¿Y si la pasarela tarda diez segundos?», «¿y si Redis se cae?» | Qué llamadas esperan a esa dependencia, con qué timeout, y qué deja de funcionar y qué no |
| Una falla a la mitad | «¿Y si el proceso muere después de cobrar y antes de emitir la entrada?» | En qué orden se escriben las cosas, qué es atómico y qué se repara después |
| Datos viejos | «¿Puede alguien ver un asiento libre que ya se vendió?» | De dónde lee cada pantalla (principal, réplica, cache) y cuánto puede tardar en enterarse |
| Un cambio de requisito | «Se agrega un segundo país con otra pasarela», «ahora hay entradas sin asiento numerado» | Qué módulos toca, qué contrato cambia y qué decisión se tomó suponiendo lo contrario |
| La decisión misma | «¿Por qué no la otra alternativa?», «¿qué los haría cambiar de opinión?» | El ADR: sus alternativas y el contexto que se dio por cierto |
| La evidencia | «¿Cómo saben que eso es así?» | La medición o la prueba, y qué pasaría si se quitara la defensa |
La última familia es la más corta y la más importante. Detrás de cada afirmación sobre su sistema tiene que haber algo que se pueda correr.
En Tinkuy. Varias de estas preguntas tienen respuesta conocida para el Tinkuy inicial, y sirven para ensayar el procedimiento sin revelar nada de su entrega. «¿Y si la pasarela tarda diez segundos?»: la llamada a la pasarela se hace con
fetchsin timeout y dentro de la transacción de la compra, así que cada compra en curso retiene una conexión a la base de datos todo ese tiempo; con suficientes compras a la vez las conexiones se agotan, y entonces también falla el catálogo, que no usa la pasarela. La decisión por revisar: cobrar dentro de la transacción. Para su Tinkuy actual, la respuesta es la que hayan construido y medido.
Una falla elegida en el momento
En el cuarto paso del laboratorio, el docente elige una falla y el equipo la
aplica a su sistema y explica lo que se observa. La carpeta de la semana
trae un script para eso, fault.ts, que sirve para cualquier sistema que
llame a una dependencia HTTP a través de Toxiproxy, y un ejemplo mínimo
para ver cómo se ve cada falla antes de probarla en el sistema propio.
Toxiproxy, que usaron en la semana 14, es un proxy TCP programable: el sistema se conecta al proxy en vez de a la dependencia, y al proxy se le dice cómo estropear el tráfico. A cada forma de estropearlo la llama un tóxico.
El ejemplo: un servicio y su dependencia
El ejemplo de demo/ tiene dos piezas, a propósito
sin relación con Tinkuy:
- La dependencia (
demo/dependency.ts), un servicio de precios en el puerto 4600. RespondeGET /prices/:idy cuenta cuántos pedidos le llegaron. - El servicio (
demo/caller.ts), en el puerto 4602. RespondeGET /quotes/:idpidiéndole el precio a la dependencia, a la que llama por el proxy (puerto 4601) con un timeout.
El servicio tiene una sola defensa, el timeout, y escribe una línea de log en JSON por pedido:
async function fetchPrice(url: string, timeoutMs: number): Promise<{ outcome: Outcome; body?: unknown }> {
  try {
    const response = await fetch(url, { signal: AbortSignal.timeout(timeoutMs) });
    if (!response.ok) {
      await response.arrayBuffer();
      return { outcome: 'dependency_error' };
    }
    return { outcome: 'ok', body: await response.json() };
  } catch (error) {
    // AbortSignal.timeout rechaza con un error de nombre TimeoutError; lo demás
    // (conexión rechazada, conexión cerrada) es que la dependencia no está.
    const timedOut = error instanceof Error && error.name === 'TimeoutError';
    return { outcome: timedOut ? 'dependency_timeout' : 'dependency_unavailable' };
  }
}
No tiene retry, circuit breaker ni respuesta alternativa. Es deliberado: el ejemplo existe para que se vea la falla, no la defensa. Las defensas son las de su sistema.
Cuatro fallas
fault.ts deja puesta una falla por vez; antes de poner la nueva quita la
anterior, para que lo que se observe tenga una sola causa.
| Comando | Qué hace en Toxiproxy | Qué simula |
|---|---|---|
node fault.ts latency 2000 |
Un tóxico latency en el camino de vuelta |
Una dependencia que responde, pero tarde |
node fault.ts slow-third 2000 |
El mismo tóxico con probabilidad de un tercio | Una dependencia lenta solo a veces |
node fault.ts cut |
Deshabilita el proxy: deja de escuchar | Una dependencia caída: la conexión se rechaza |
node fault.ts blackhole |
Un tóxico timeout sin límite en el camino de ida |
Una dependencia que acepta la conexión y no responde |
Más setup (crea el proxy), status (qué hay puesto), clear (quita
todo) y remove (borra el proxy).
La guía de la semana nombra tres fallas: latencia, corte y respuestas lentas en una de cada tres llamadas. El script trae cuatro porque «corte» puede querer decir dos cosas que un sistema vive de forma muy distinta, y conviene saber cuál se está pidiendo:
- En
cut, nadie escucha en el puerto. El sistema operativo rechaza la conexión y quien llama se entera en milisegundos. - En
blackhole, alguien acepta la conexión y después no pasa nada. Quien llama no recibe ningún error: solo silencio, hasta que se cumpla su propio timeout, si lo tiene.
La primera es la falla amable. La segunda es la que tumba sistemas, porque cada llamada retiene sus recursos mientras espera.
Lo que ve quien llama
make demo levanta las dos piezas, crea el proxy y aplica una falla tras
otra. Después de cada una hace una ronda de pedidos al servicio y muestra
lo que vio quien llama, cuántos pedidos llegaron de verdad a la dependencia
y la línea de log del pedido más lento. El servicio espera a su dependencia
500 ms como máximo. Esta es una corrida, en el contenedor del curso, en una
laptop con Apple Silicon:
$ make demo
El servicio espera a la dependencia 500 ms como máximo.

== dependency: 127.0.0.1:4601 -> 127.0.0.1:4600 · sin fallas
  12 pedidos: 200 × 12 · p50 4 ms, p95 16 ms, máx 16 ms
  pedidos que llegaron a la dependencia: 12 de 12
  pedidos que tardaron más de 150 ms: 0 de 12
  log del más lento: {"route":"/quotes/7","status":200,"outcome":"ok","ms":8}

== dependency: 127.0.0.1:4601 -> 127.0.0.1:4600 · latencia de 200 ms en todas las conexiones (downstream)
  12 pedidos: 200 × 12 · p50 204 ms, p95 206 ms, máx 206 ms
  pedidos que llegaron a la dependencia: 12 de 12
  pedidos que tardaron más de 150 ms: 12 de 12
  log del más lento: {"route":"/quotes/7","status":200,"outcome":"ok","ms":205}

== dependency: 127.0.0.1:4601 -> 127.0.0.1:4600 · latencia de 1000 ms en todas las conexiones (downstream)
  12 pedidos: 503 × 12 · p50 503 ms, p95 526 ms, máx 526 ms
  pedidos que llegaron a la dependencia: 12 de 12
  pedidos que tardaron más de 150 ms: 12 de 12
  log del más lento: {"route":"/quotes/7","status":503,"outcome":"dependency_timeout","ms":524}

== dependency: 127.0.0.1:4601 -> 127.0.0.1:4600 · corte (proxy deshabilitado: conexión rechazada)
  12 pedidos: 503 × 12 · p50 3 ms, p95 15 ms, máx 15 ms
  pedidos que llegaron a la dependencia: 0 de 12
  pedidos que tardaron más de 150 ms: 0 de 12
  log del más lento: {"route":"/quotes/7","status":503,"outcome":"dependency_unavailable","ms":12}

== dependency: 127.0.0.1:4601 -> 127.0.0.1:4600 · no entrega nada (upstream)
  12 pedidos: 503 × 12 · p50 503 ms, p95 506 ms, máx 506 ms
  pedidos que llegaron a la dependencia: 0 de 12
  pedidos que tardaron más de 150 ms: 12 de 12
  log del más lento: {"route":"/quotes/7","status":503,"outcome":"dependency_timeout","ms":503}
…
Los milisegundos exactos cambian de una corrida a otra y de una máquina a otra. Lo que se repite en todas, y lo que hay que saber leer, es la forma de cada bloque.
Latencia por debajo del timeout (200 ms). Todo responde 200, y todo tarda la demora inyectada más lo de siempre. Desde afuera el servicio «anda bien»; quien solo mire la tasa de errores no ve nada. Se ve en la latencia, y por eso el SLI de la semana 14 contaba como buenas solo las compras que respondían bien y dentro de un tiempo.
Latencia por encima del timeout (1 000 ms). Todo responde 503, a los 500 ms: el servicio se rinde al cumplirse su timeout, sin esperar el segundo completo. La línea que más importa del bloque es la segunda: los 12 pedidos llegaron a la dependencia. El tóxico demora la respuesta, no el pedido, así que la dependencia hizo su trabajo doce veces y el servicio respondió doce veces que no pudo. Es lo que la semana 5 llamó una falla parcial: un timeout no cancela nada. Aquí la dependencia solo lee un precio. Si cobrara, habría doce cobros y doce compradores a los que se les dijo que falló.
Corte. 503 otra vez, pero en 3 ms y con otro resultado en el log,
dependency_unavailable. Y esta vez a la dependencia no le llegó nada. Es
la única falla de las cuatro en la que quien llama sabe con certeza que el
trabajo no se hizo.
Blackhole. Desde el servicio se ve exactamente igual que la latencia
alta: 503 a los 500 ms y dependency_timeout en el log. Pero a la
dependencia no le llegó ningún pedido. Los dos bloques son indistinguibles
para quien llama, y en uno el trabajo se hizo doce veces y en el otro
ninguna.
Idea clave. Con un timeout, quien llama no puede saber si la dependencia hizo el trabajo. La demostración lo muestra con dos fallas que producen el mismo log y dejan a la dependencia en estados opuestos. Por eso un retry después de un timeout solo es seguro si la operación es idempotente (semana 12), y por eso no basta con mirar los logs de un solo lado.
Trade-off. El valor del timeout. Con 500 ms, el servicio aguantó una dependencia 200 ms más lenta y abandonó una de 1 000 ms. Un timeout más corto libera antes los recursos y devuelve el error antes, pero convierte en errores las respuestas que solo venían algo lentas. Uno más largo tolera más y, cuando la dependencia se cuelga, retiene cada pedido más tiempo. No hay valor correcto en general: se elige mirando la distribución de latencia de la dependencia cuando está sana y cuánto puede esperar quien llama al servicio.
«Una de cada tres» es por conexión
La tercera falla de la guía es la más interesante de explicar, porque no hace lo que su nombre sugiere. La demostración continúa así:
== dependency: 127.0.0.1:4601 -> 127.0.0.1:4600 · latencia de 200 ms en 33 % de las conexiones (downstream)
  30 pedidos: 200 × 30 · p50 7 ms, p95 205 ms, máx 207 ms
  pedidos que llegaron a la dependencia: 30 de 30
  pedidos que tardaron más de 150 ms: 2 de 30
  log del más lento: {"route":"/quotes/7","status":200,"outcome":"ok","ms":205}

== la misma falla, por conexión: 8 conexiones al proxy, 6 pedidos por cada una
  conexión 1:    1    1    2    1    1    1  ms
  conexión 2:    3    3    1    0    1    3  ms
  conexión 3:  207  210  203  205  202  202  ms
  conexión 4:  211  203  202  205  210  203  ms
  conexión 5:    2    1    3    1   17    2  ms
  conexión 6:    8    4    2    1    1    1  ms
  conexión 7:    1    1    1    1    1    1  ms
  conexión 8:    2    3    1    1    1    0  ms
El segundo bloque explica el primero. Toxiproxy aplica un tóxico con cierta probabilidad (la llama toxicity), y el sorteo se hace por conexión, no por pedido. Una conexión a la que le tocó el tóxico es lenta en todos sus pedidos; una a la que no le tocó es normal en todos. En la corrida de arriba, dos de las ocho conexiones salieron lentas, y dentro de cada fila no hay mezcla. Una prueba de la semana lo comprueba: con doce conexiones y cuatro pedidos por cada una, ninguna conexión mezcla pedidos lentos y normales.
Ahora el primer bloque. El servicio usa fetch, que reutiliza las
conexiones a la dependencia. Con seis pedidos a la vez abre unas pocas
conexiones y manda por ellas los treinta pedidos. Solo 2 de 30 fueron
lentos, muy lejos de un tercio (en tres corridas seguidas fueron 2, 1 y 3).
La razón es que una conexión lenta también es una conexión que atiende
pocos pedidos: mientras despacha uno en 200 ms, las conexiones normales
despachan decenas. El tercio es de conexiones, y las conexiones lentas
llevan una parte pequeña de los pedidos.
Con una conexión nueva por pedido y los pedidos uno tras otro, en cambio, cada pedido tiene su propio sorteo, y ahí sí cerca de un tercio sale lento: en dos rondas de 120 pedidos directos al proxy fueron 39 y 45. Una prueba de la semana lo comprueba con 90 pedidos y límites amplios, porque es un sorteo. Con doce pedidos a la vez la proporción se volvió errática: en cinco rondas de 120 salieron 53, 26, 24, 39 y 29 pedidos lentos, y en una corrida de las pruebas, 11. No sabemos a qué se debe y no lo vamos a suponer; lo anotamos porque es otra razón para no prometer «un tercio».
¿Qué significa esto para la defensa?
- Si su sistema reutiliza conexiones a la dependencia (es lo normal, y es lo
que hace
fetch),slow-thirdno produce «uno de cada tres pedidos lento». Produce algunas conexiones lentas, y cuántos pedidos caen en ellas depende de cuántas conexiones hay abiertas y de cómo se reparte el trabajo. - Con una sola conexión abierta, el resultado es todo o nada: o le tocó, o no. Si aplican la falla y no ven nada, puede ser eso.
- Lo que conviene mirar no es el promedio sino la cola: el p95 y el máximo saltan aunque el p50 no se mueva. En el bloque de arriba el p50 es 7 ms y el p95 es 205 ms. Es el caso de la semana 2 en el que el promedio no describe a nadie.
Error común. Dar por hecho lo que hace una herramienta por su nombre o por cómo se la describe de palabra. «Lenta en una de cada tres llamadas» suena a un sorteo por llamada, y la herramienta sortea por conexión. Antes de explicar frente a otros lo que hace una falla, aplíquenla a un sistema de dos piezas y mírenla. Para eso está
demo/.
Usarlo con su sistema
El script no sabe nada del ejemplo: lee tres variables de entorno.
svc start toxiproxy
export FAULT_PROXY=gateway              # el nombre que quieran
export FAULT_LISTEN=127.0.0.1:4001      # adonde va a llamar su sistema
export FAULT_UPSTREAM=127.0.0.1:4000    # donde escucha la dependencia real
node /work/code/week-16/fault.ts setup
Después se configura el sistema para que llame a la dependencia por la
dirección de FAULT_LISTEN. Si en la semana 14 o en P5 ya crearon un proxy
con otro nombre, basta poner ese nombre en FAULT_PROXY: setup no lo
vuelve a crear, lo deja habilitado y sin tóxicos.
Mientras practican con el ejemplo, make up deja las dos piezas corriendo
en segundo plano y el log del servicio en build/caller.log. Una sesión a
mano se ve así:
$ make up
toxiproxy listo.
dependency: 127.0.0.1:4601 -> 127.0.0.1:4600 · sin fallas
servicio en http://127.0.0.1:4602/quotes/7 · su log, en build/caller.log
$ node fault.ts latency 800
dependency: 127.0.0.1:4601 -> 127.0.0.1:4600 · latencia de 800 ms en todas las conexiones (downstream)
$ node probe.ts http://127.0.0.1:4602/quotes/7 10
10 pedidos: 200 × 10 · p50 805 ms, p95 811 ms, máx 811 ms
$ node fault.ts cut
dependency: 127.0.0.1:4601 -> 127.0.0.1:4600 · corte (proxy deshabilitado: conexión rechazada)
$ node probe.ts http://127.0.0.1:4602/quotes/7 10
10 pedidos: 503 × 10 · p50 2 ms, p95 8 ms, máx 8 ms
$ node fault.ts clear
dependency: 127.0.0.1:4601 -> 127.0.0.1:4600 · sin fallas
En make up el servicio corre con su timeout por defecto, de un segundo;
por eso la latencia de 800 ms todavía responde 200. Queda cerca: una demora
inyectada a 200 ms del timeout deja poco margen, y en una máquina ocupada
algún pedido lo va a cruzar. Vale la pena probar también ese caso, porque
los errores intermitentes son más difíciles de explicar que los totales.
Cada comando imprime una línea que dice qué falla quedó puesta. En la defensa, léanla en voz alta antes de mirar el sistema: es la mitad de la predicción.
Tres consejos para el momento:
- Empezar y terminar en
clear. Antes de aplicar la falla, muestren el sistema sano; al final, quiten la falla y muestren que se recupera. La recuperación es parte del escenario, y un circuit breaker que no vuelve a cerrarse es un hallazgo. - Carga mientras dura la falla. Una falla sin tráfico no muestra nada.
Tengan corriendo la prueba de carga de su entrega, o al menos
probe.tscon concurrencia. - Dos ventanas a la vista: los logs del sistema y la métrica que eligieron. La explicación sale de ahí, no de lo que recuerdan que debería pasar.
El código de la semana
La carpeta code/week-16/ es pequeña. No enseña una técnica: trae lo necesario para las tres actividades de la semana.
| Archivo | Para qué |
|---|---|
case-worksheet-template.md |
Template de la ficha de lectura de un caso |
example/case-worksheet-shopify.md |
Una ficha llena, sobre una lectura complementaria |
errors/worksheet-only-solution.md |
Una ficha que solo cuenta la solución; el revisor la rechaza |
presentation-template.md |
Template del guion de la presentación final |
defence-checklist.md |
Lista de lo que conviene haber ensayado antes de la defensa |
check-doc.ts |
Revisa la forma de los tres documentos |
fault.ts |
Aplica una falla a una dependencia HTTP por Toxiproxy |
probe.ts |
Hace una ronda de pedidos y resume lo que vio quien llama |
demo/ |
Un servicio, su dependencia y la demostración completa |
Los objetivos del Makefile:
make             # inicia Toxiproxy
make test        # revisa los tipos y corre las pruebas
make check       # revisa la ficha de ejemplo
make errors      # revisa la ficha mal hecha (falla a propósito)
make demo        # la demostración de las fallas, unos 20 s
make up          # deja el ejemplo corriendo para aplicarle fallas a mano
make down        # lo detiene
make clean       # borra build/
make test corre 25 pruebas en dos archivos. Las de check-doc.test.ts
comprueban el revisor con los archivos de la carpeta: que la ficha de
ejemplo pasa, que los templates sin llenar no pasan y llenos sí, y que la
ficha de errors/ produce justo el reporte que citamos arriba. Las de
fault.test.ts comprueban contra el ejemplo lo que este capítulo afirma de
cada falla:
$ make test
…
✔ sin fallas, el proxy deja pasar todo y el servicio responde 200 (61.649125ms)
✔ latency: la respuesta se demora, pero el pedido sí llegó a la dependencia (1020.560459ms)
✔ latency por debajo del timeout del servicio: responde 200, más lento (780.011167ms)
✔ latency por encima del timeout: 503 al cumplirse el timeout, y la dependencia hizo el trabajo igual (1218.414168ms)
✔ cut: error de conexión enseguida, y a la dependencia no le llega nada (15.416917ms)
✔ blackhole: la conexión se acepta, nadie responde y el pedido no llega a la dependencia (1438.448625ms)
✔ slow-third: con una conexión nueva por pedido, uno tras otro, cerca de un tercio son lentos (2976.430168ms)
✔ slow-third: el sorteo es por conexión; por una misma conexión, todos lentos o todos normales (6091.067336ms)
✔ cada comando deja una sola falla, y clear vuelve al estado normal (31.076666ms)
✔ una demora que no es un entero positivo se rechaza antes de tocar el proxy (3.536ms)
✔ si el proxy no existe, el error dice qué correr (1.017209ms)
✔ percentil por rango más cercano, como en la semana 2 (0.219458ms)
ℹ tests 25
ℹ pass 25
ℹ fail 0
Se muestran las pruebas de las fallas y el total; la salida completa trae antes las trece del revisor y, entre el total y los aprobados, otras líneas de resumen.
Dos detalles de implementación que vale la pena mirar.
Cómo se aplica una falla. Toxiproxy tiene una API HTTP en el puerto
8474, y fault.ts la usa directamente con fetch: crear un proxy es un
POST /proxies, agregar un tóxico es un POST /proxies/<nombre>/toxics, y
deshabilitar el proxy es un POST con enabled: false. Es lo mismo que
hace toxiproxy-cli; tenerlo en un script evita equivocarse de argumento
con público delante.
  } else if (kind === 'blackhole') {
    await addToxic(config, { name: 'fault', type: 'timeout', stream: 'upstream', toxicity: 1, attributes: { timeout: 0 } });
  } else {
    const disabled = await api(config, 'POST', `/proxies/${config.name}`, { enabled: false });
    await (await expectOk(disabled, 'deshabilitar el proxy')).arrayBuffer();
  }
El campo stream dice en qué sentido actúa el tóxico. latency va en
downstream (la respuesta, de la dependencia hacia quien llama), y por eso
el pedido llega a tiempo. blackhole va en upstream (el pedido, hacia la
dependencia), y por eso no llega. Cambiar ese campo cambia qué lado hizo el
trabajo: es la diferencia entre los dos bloques de la demostración que se
veían iguales.
Cómo se controla la conexión. probe.ts usa node:http con un Agent
explícito en vez de fetch, porque necesita decidir si cada pedido abre
una conexión o reutiliza una. Sin ese control no se habría podido mostrar
que el sorteo de slow-third es por conexión.
Laboratorio: defensa oral del proyecto
El laboratorio es la defensa. Cada equipo responde preguntas sobre su
entrega, y cualquier integrante puede recibir cualquiera. La guía de la
semana lista cinco pasos; aquí va qué muestra cada uno y cómo prepararlo.
No hay nada que resolver en code/week-16/: el material es su propio
repositorio.
La lista defence-checklist.md
reúne lo que conviene haber hecho antes. Cada integrante la copia y la
marca por su cuenta:
$ node check-doc.ts checklist defence-checklist.md
✖ defence-checklist.md
    El recorrido de una compra: pendiente: Puedo seguir una compra sobre el diagrama de contenedores sin leer notas
    El recorrido de una compra: pendiente: Para cada paso sé decir qué pasa si falla y dónde queda registrado
    El recorrido de una compra: pendiente: Comprobé el diagrama contra el sistema corriendo: no hay cajas de más ni de menos
    Los ADR: pendiente: Abrí cada ADR del equipo, no solo los que escribí
…
Paso 1: recorrer una compra sobre el diagrama de contenedores. Qué componente interviene en cada paso, qué pasa si ese paso falla y dónde quedaría registrado. Muestra si el diagrama es del sistema que corre o de uno que existió hace dos entregas, y si el equipo pensó en las fallas a la mitad. Para prepararlo: hagan una compra real con el sistema levantado y sigan cada salto en los logs; después, repítanla deteniendo una pieza por vez. La tercera pregunta (dónde queda registrado) es la que más se olvida, y su respuesta tiene que ser un lugar concreto: una tabla, una línea de log con su campo, un mensaje en un stream.
Paso 2: un ADR al azar. El contexto, por qué se descartó cada alternativa y qué tendría que cambiar para revisar la decisión. Muestra si los ADR son del equipo o de quien los escribió. La tercera parte es la más difícil: obliga a decir qué supuesto del contexto sostiene la decisión («mientras haya una sola pasarela», «mientras el catálogo quepa en memoria»). Para prepararlo: que cada integrante explique en voz alta un ADR que no escribió, y que quien lo escribió solo corrija.
Paso 3: make fitness, y romper una comprobación a propósito. Correr
las comprobaciones del equipo y explicar qué decisión protege cada una.
Después, romper una y mostrar qué reporta. Muestra dos cosas: que cada
fitness function está atada a una decisión (una comprobación que nadie sabe
para qué está termina desactivada), y que de verdad falla cuando debe. Una
comprobación que nunca se vio fallar no se sabe si funciona; es la misma
idea de la semana 14 sobre las defensas que nunca se ejercieron. Para
prepararlo: elijan de antemano cómo romper cada una con un cambio de una
línea, y vean el mensaje. Si el mensaje no dice qué regla se violó ni
dónde, mejórenlo: ese mensaje es para quien rompa la regla dentro de seis
meses.
Paso 4: una falla elegida en el momento. Con Toxiproxy, aplicar la
falla que el docente elija y explicar lo que se observa con los logs y las
métricas del equipo. Es la sección anterior. Muestra si las defensas de P5
funcionan fuera de las condiciones exactas en que las probaron, y si la
observabilidad alcanza para explicar lo que pasa sin leer el código. Para
prepararlo: prueben las cuatro fallas de fault.ts contra su sistema, con
carga, y para cada una anoten qué esperaban y qué vieron. Donde no
coincidan hay algo que entender antes de la defensa, no durante.
Paso 5: un cambio de requisito propuesto en el momento. Por ejemplo, «se venderán entradas de cien eventos a la vez» o «se agrega un segundo país con otra pasarela»: qué partes de la arquitectura lo aguantan, cuáles no y qué decisión habría que revisar. Es el procedimiento de Responder un «¿qué pasa si…?», y muestra lo que el curso quiso enseñar desde la primera semana: razonar sobre un cambio antes de hacerlo. No se puede preparar la respuesta, porque no se conoce la pregunta. Se puede ensayar el procedimiento: que un integrante invente un requisito de cada familia de la tabla de preguntas típicas y los demás lo recorran sobre el diagrama, en voz alta, con los cuatro pasos.
Error común. Repartirse la defensa: «tú respondes lo de la base de datos, yo lo de los pagos». Cualquier integrante puede recibir cualquier pregunta, y además es mala preparación para un equipo real, donde quien está de guardia a las tres de la mañana no elige qué parte falla. El ensayo que sirve es el contrario: cada quien explica la parte que menos conoce.
Resumen
- Un caso se lee con cinco preguntas: qué escenario apretaba, qué alternativas había, qué se eligió, qué se sacrificó y cómo supieron que funcionó. Un texto que solo responde la tercera es publicidad.
- Al leer se separa lo que el texto afirma de lo que uno infiere, y se anota la fecha: un caso describe su sistema en el momento en que se escribió, no hoy.
- Stack Overflow (2016) describe una aplicación multi-tenant sobre pocos servidores, SQL Server como única fuente de verdad con réplicas asíncronas, cache en dos niveles y redundancia en todo, atendiendo unos 209 millones de pedidos HTTP al día. El texto es un inventario: casi no nombra alternativas ni costos. Lo que sostiene es que el estilo no determina la escala.
- Discord (2023) cuenta un clúster de 177 nodos en el que una partición muy leída degradaba a todos. La respuesta fue doble: servicios de datos que unen pedidos idénticos y enrutan por canal, y un cambio de motor con doble escritura, migrador propio y validación. El hot spot no se arregló con el hash, sino preguntando menos veces lo mismo.
- Figma (2024) cuenta cómo agotó la partición vertical y construyó sharding horizontal propio sobre PostgreSQL, con criterios explícitos (avanzar de a pocos, poder volver atrás), el paso reversible antes del irreversible, y una lista franca de lo que se perdió: transacciones entre shards, parte de SQL, nueve meses.
- Los tres miden y los tres prefieren lo que su equipo sabe operar. Difieren en casi todo lo demás, incluso en la misma técnica: Discord usó doble escritura y Figma la descartó, cada uno por sus datos. De un caso se copia la forma de decidir, no la decisión.
- El curso en seis ideas: los atributos de calidad determinan la arquitectura; la modularidad decide cuánto cuesta cambiar; distribuir se paga con fallas parciales y consistencia; cada táctica mejora un atributo y cuesta otro; una decisión vale lo que su justificación y su comprobación; y el sistema tiene que seguir funcionando mientras algo falla.
- La arquitectura es una actividad antes que un cargo. Exige entender el negocio, conocer muchas opciones, comunicar y seguir cerca del código. Según Fowler (2003), una de sus tareas más importantes es reducir lo irreversible, y eso también tiene costo.
- Una arquitectura se presenta en este orden: problema y escenarios, decisiones, tecnología. Un diagrama por idea. De cada decisión: escenario, alternativas, decisión, costo y medición.
- Se critica con escenarios, no con preferencias. Un «¿qué pasa si…?» se responde repitiéndolo como escenario, recorriéndolo sobre el diagrama, diciendo qué aguanta y qué no, y nombrando la decisión por revisar. «No lo sé, lo averiguaría así» es una respuesta válida.
- Cuatro fallas sobre una dependencia: latencia, lentitud en parte de las conexiones, corte (rechazo inmediato) y blackhole (silencio). Con un timeout, quien llama no sabe si la dependencia hizo el trabajo: la latencia alta y el blackhole dejan el mismo log y estados opuestos.
- En Toxiproxy, la probabilidad de un tóxico se sortea por conexión: un sistema que reutiliza conexiones no ve «un pedido lento de cada tres».
Ejercicios
-
Tomen el texto que leyó su equipo y busquen tres frases suyas sobre el caso (de su ficha o de su presentación) que empiecen con «el texto dice». Para cada una, ubiquen el párrafo exacto que la respalda. Si no lo encuentran, reescríbanla como inferencia y digan en qué se apoya.
-
El texto de Stack Overflow da el tiempo promedio de generar una página de pregunta. Expliquen qué no se puede saber con ese número y qué dato pedirían para escribir la medida de un escenario de rendimiento. ¿Qué mostraba la semana 2 sobre un promedio que mezcla dos poblaciones?
-
Escriban, con sus seis partes, el escenario de calidad principal del caso que leyó su equipo. Marquen cada parte con «del texto» o «supuesto». Revisen el resultado con
scenario-check.tsde la semana 2. -
En el caso de Discord, los servicios de datos enrutan todos los pedidos de un canal a la misma instancia. (a) ¿Por qué eso mejora la unión de pedidos idénticos? (b) ¿Qué problema nuevo puede traer para un canal muy grande? (c) El texto no dice cómo lo manejan: propongan dos opciones y el costo de cada una.
-
Figma descartó la doble escritura y Discord la usó. Para cada uno de estos datos de un sistema de venta de entradas, digan si migrarían con doble escritura o sin ella, y por qué: (a) el historial de correos enviados; (b) los asientos y su estado; (c) el registro de visitas a la página de un concierto.
-
Corran
make demotres veces y anoten, del bloque deslow-third, cuántos pedidos tardaron más de 150 ms en cada corrida. Después cambien endemo/run.tsla concurrencia de esa ronda de 6 a 1 y repitan. Expliquen la diferencia con lo que saben de cómo sortea Toxiproxy. -
En la demostración, la latencia de 1 000 ms y el blackhole producen la misma línea de log en el servicio. (a) ¿Qué habría que agregar, y en qué pieza, para distinguirlas? (b) Si la dependencia cobrara en vez de leer un precio, ¿en cuál de las dos fallas sería peligroso un retry, y qué haría falta para que no lo fuera?
-
Conviertan cada una de estas objeciones en un escenario que se pueda responder recorriendo un diagrama: (a) «eso no va a escalar»; (b) «deberían haber usado una cola»; (c) «hay demasiados servicios»; (d) «¿y la seguridad?».
-
Elijan una decisión de su Tinkuy. Escriban qué cambio en el contexto (carga, equipo, negocio) los haría revisarla, y qué harían para que revisarla fuera más barato de lo que es hoy. ¿Vale la pena pagar ese costo ahora? Justifiquen con la probabilidad del cambio.
-
Fowler dice que una de las tareas más importantes de quien hace arquitectura es eliminar irreversibilidad. Den un ejemplo de su proyecto en el que volvieron reversible una decisión y otro en el que decidieron no hacerlo. Para el segundo, digan qué habría costado.
-
Un equipo vecino presenta así: «Tenemos cuatro servicios, usamos Redis para la cache y NATS para los eventos, y todo pasa las pruebas». Escriban cinco preguntas con forma de escenario, una de cada una de cinco familias distintas de la tabla de preguntas típicas, que le harían a ese equipo.
-
Lean una de las lecturas complementarias (nginx o Shopify) o busquen un caso publicado por otra empresa, y llenen la ficha con
case-worksheet-template.mdhasta quecheck-doc.ts worksheetpase. Después intercambien la ficha con otro equipo: ¿encuentran en la de ellos alguna afirmación atribuida al texto que el texto no hace?